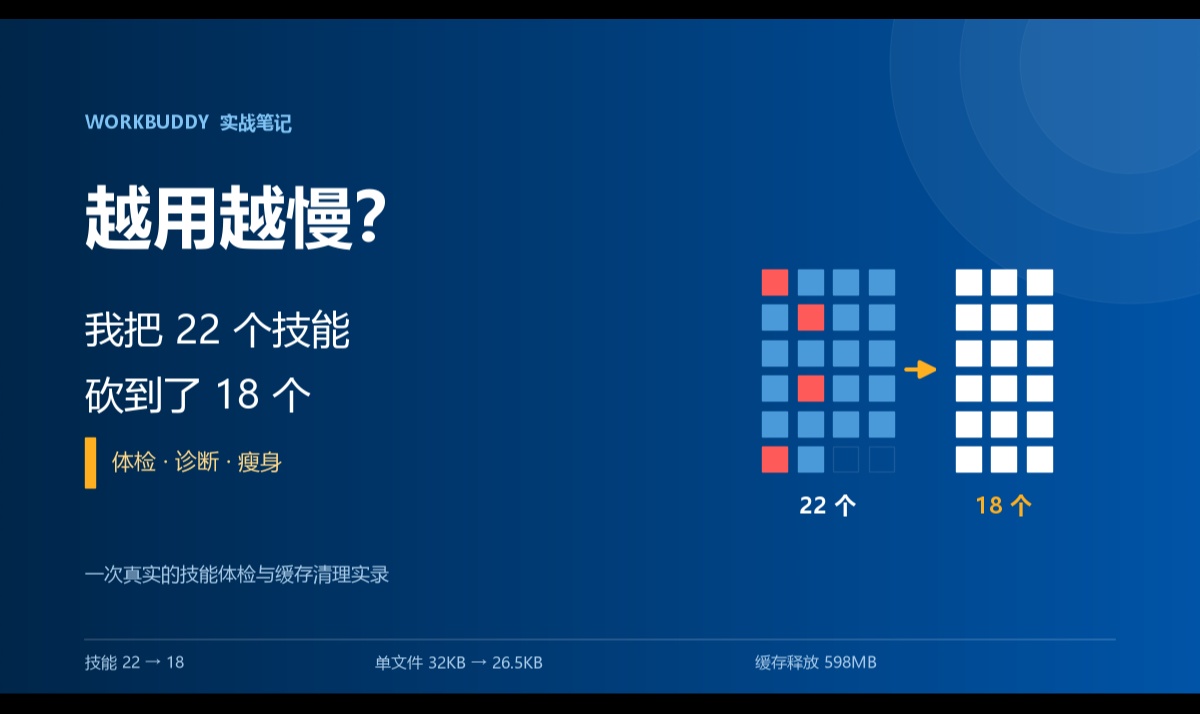
WorkBuddy 越用越慢?我把 22 个技能砍到 18 个,它快回来了
上周让它做一份 PPT,它在两个技能之间卡了几秒才动手。 我以为是模型慢了。翻了技能目录才发现——有个技能的主文件 **32KB**,每次触发都得先读一遍。而它干的活,是帮我点签到。 那一刻我明白了:问题不在模型,在我自己塞进去的东西太多、太乱。 下面是我做的体检和清理,全程有数据。 --- ## 一、先量一量,别靠感觉 "感觉变慢"是最没用的判断。 每个技能里都有个 `SKILL.md`,一被触发就全文进上下文。所以我只看了三个数: - 技能总数:**22 个** - `SKILL.md` 合计:**230 KB** - 单个最大:**32 KB** 第三个数最刺眼。按体积排完序,第一名是那个签到工具,第二名才是真正高频的办公技能。 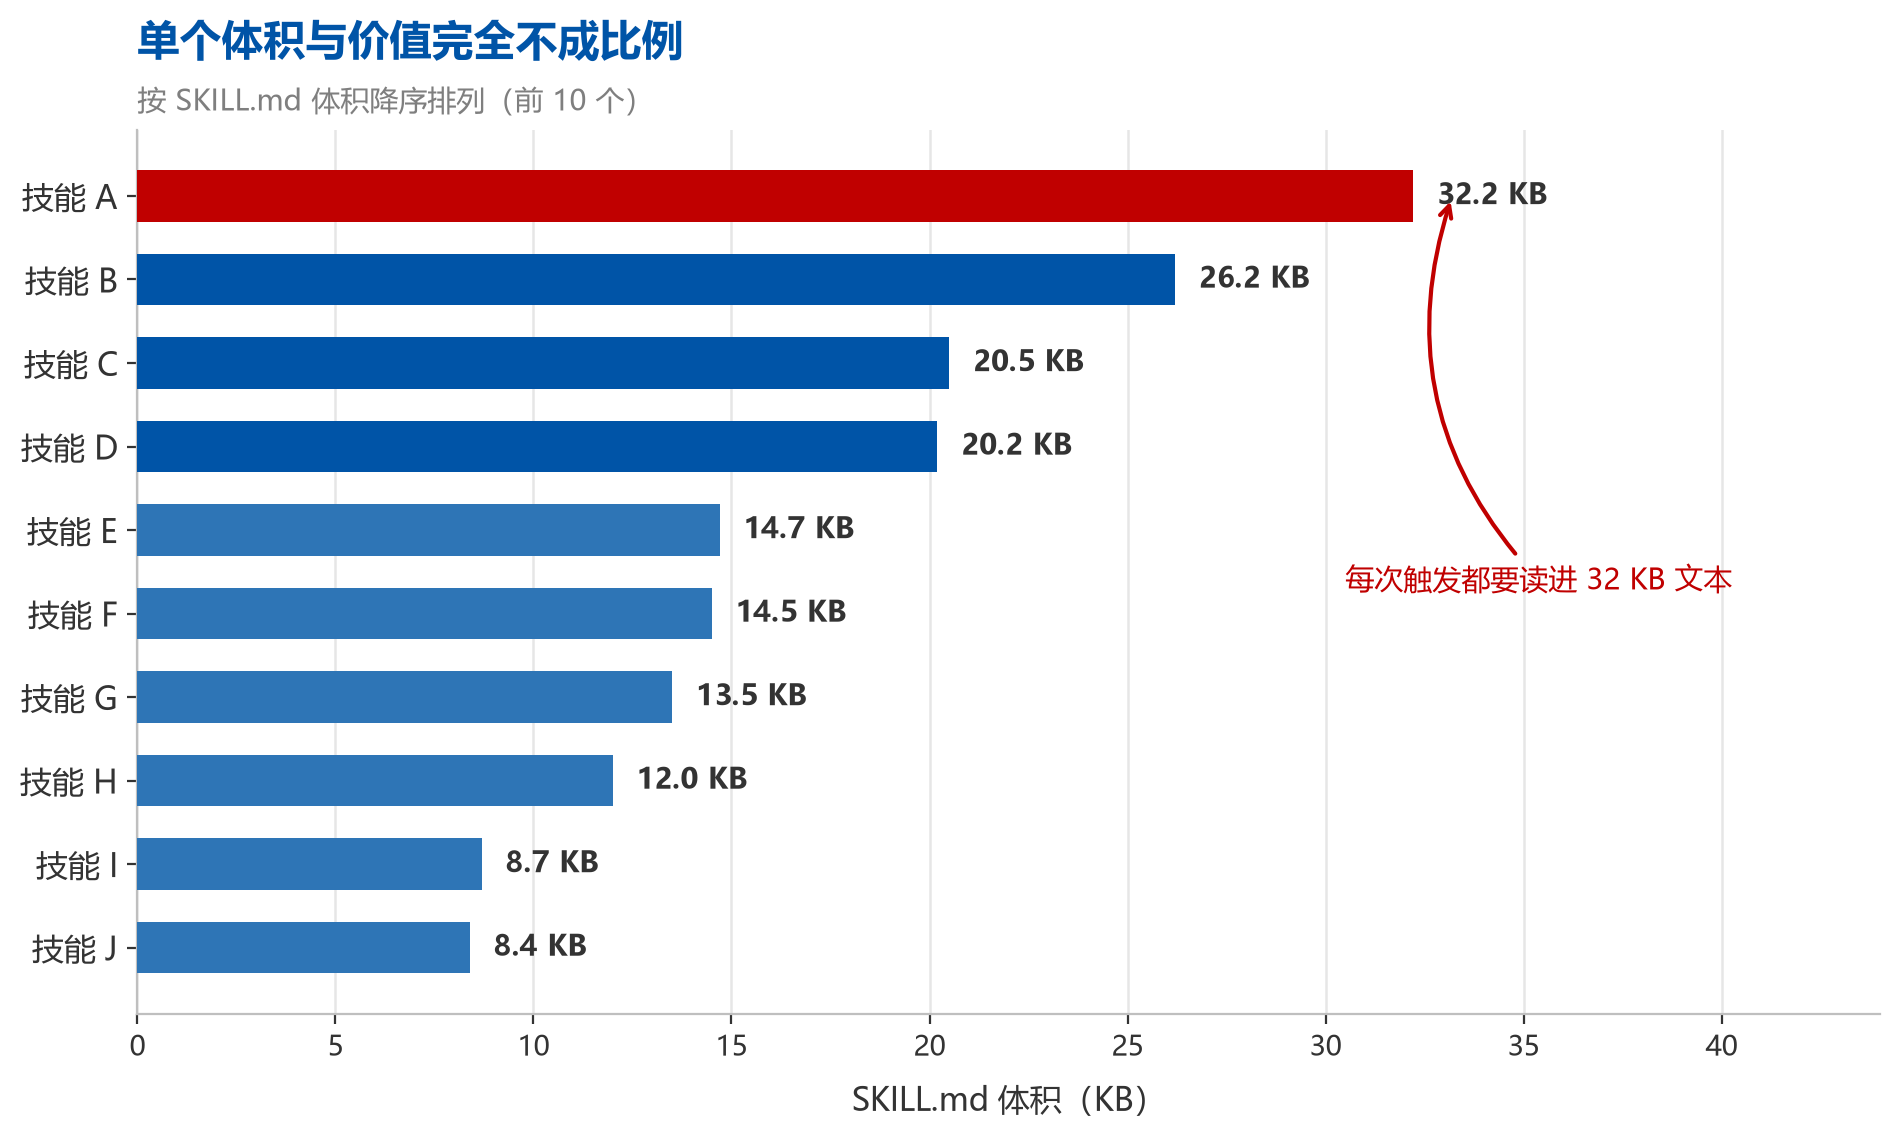 **技能的成本是按"每次任务"算的,不是按"每次使用"。** 一个技能只要装着,它的描述就参与每次路由;一旦触发,全文进上下文。所以判断留不留,不该问"它有用吗",该问"它配得上这个体积吗"。 --- ## 二、翻出来四个坑 **坑 1:三组技能干同一件事** 两个文档转换技能、两个 Excel 技能,还有一个搜索技能和内置搜索完全重复。 重复的危害不是占空间,是**制造歧义**。两个都能干,它就得先想用哪个——这个犹豫本身就是延迟。 最夸张的一组:一个 8.8 KB,一个 144 KB,功能一样。**体积差 16 倍,能力没区别。** **坑 2:和主业无关的,反而体积最大** 就是开头那个签到工具。功能做得挺全,但我一个月用不到两次,却是我技能库里最大的文件。 **坑 3:Python 解释器选错(这个最坑)** 我有个脚本要处理 Excel,某次直接报 `No module named 'openpyxl'`。 查下来机器上装了两个 Python:新版本只带了 pptx 相关库,Excel、Word、pandas 全在旧版本里。 我一直觉得"新版更好",结果每次碰到 Excel 就报错、重试、换解释器。**这才是变慢最直接的原因。** **坑 4:两套指令打架** 我自己装了一套 office 技能,平台又内置一套,功能高度重叠。 系统规则说走内置的,我的技能说走自己——每次做 PPT 前都要先绕一圈,判断该听谁的。 --- ## 三、三步收拾 **第一步:定唯一入口** 不要按技能名字分,按**任务特征**分。我最后定成这样: - 要套固定模板 + 归并内部素材 → 自建汇报技能 - 要精修现有 PPT / 填模板壳 → office-pptx - 常规新做、求快 → 内置技能 判据就三个问题:要不要模板?新建还是精修?要不要归并素材? 配一条铁律:**同一份东西只走一条路,拿不准就问一句,不猜着做两遍。** **第二步:砍掉冗余,但别删死** 22 砍到 18。四个都先移到"待确认"文件夹,没直接删。 **技能装回来容易,删干净难**,留个后悔的余地。 **第三步:把解释器规则写死** 把"哪个库在哪个 Python"记进长期备忘。以后 Excel、Word 任务直接走对的那个,不再试错。 这一步省的不是几十秒,是**每次报错重试的整段时间**。 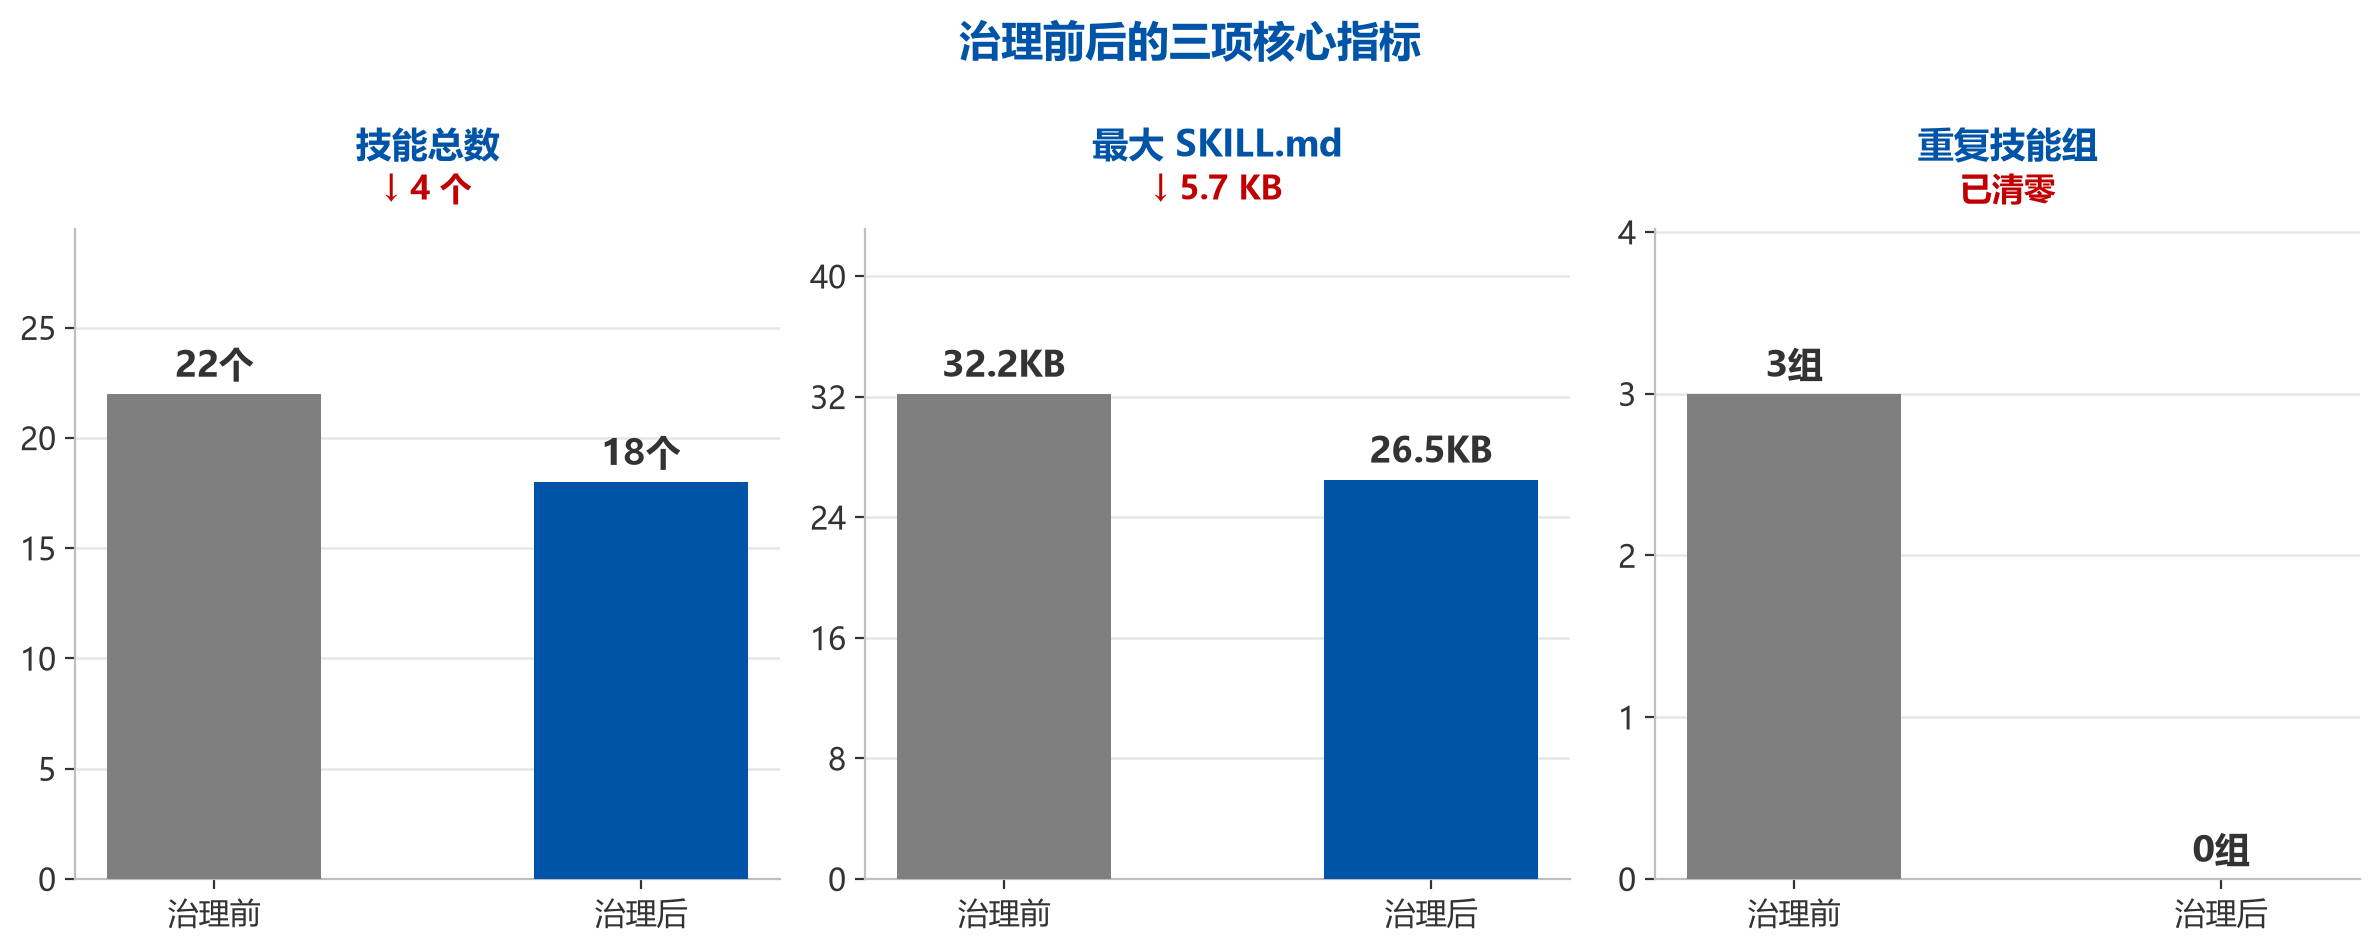 --- ## 四、顺手发现:缓存占了快 1 GB 整理的时候顺手看了运行缓存,总量约 **904 MB**。 其中 **469 MB 是 5 个崩溃转储**——同一天下午一分钟内连续崩了 5 次留下的,每个 94 MB。剩下的是安全引擎的审计日志,每条命令、每个 DLL 加载都记一行。 清完降到 **305 MB,释放 598 MB**。 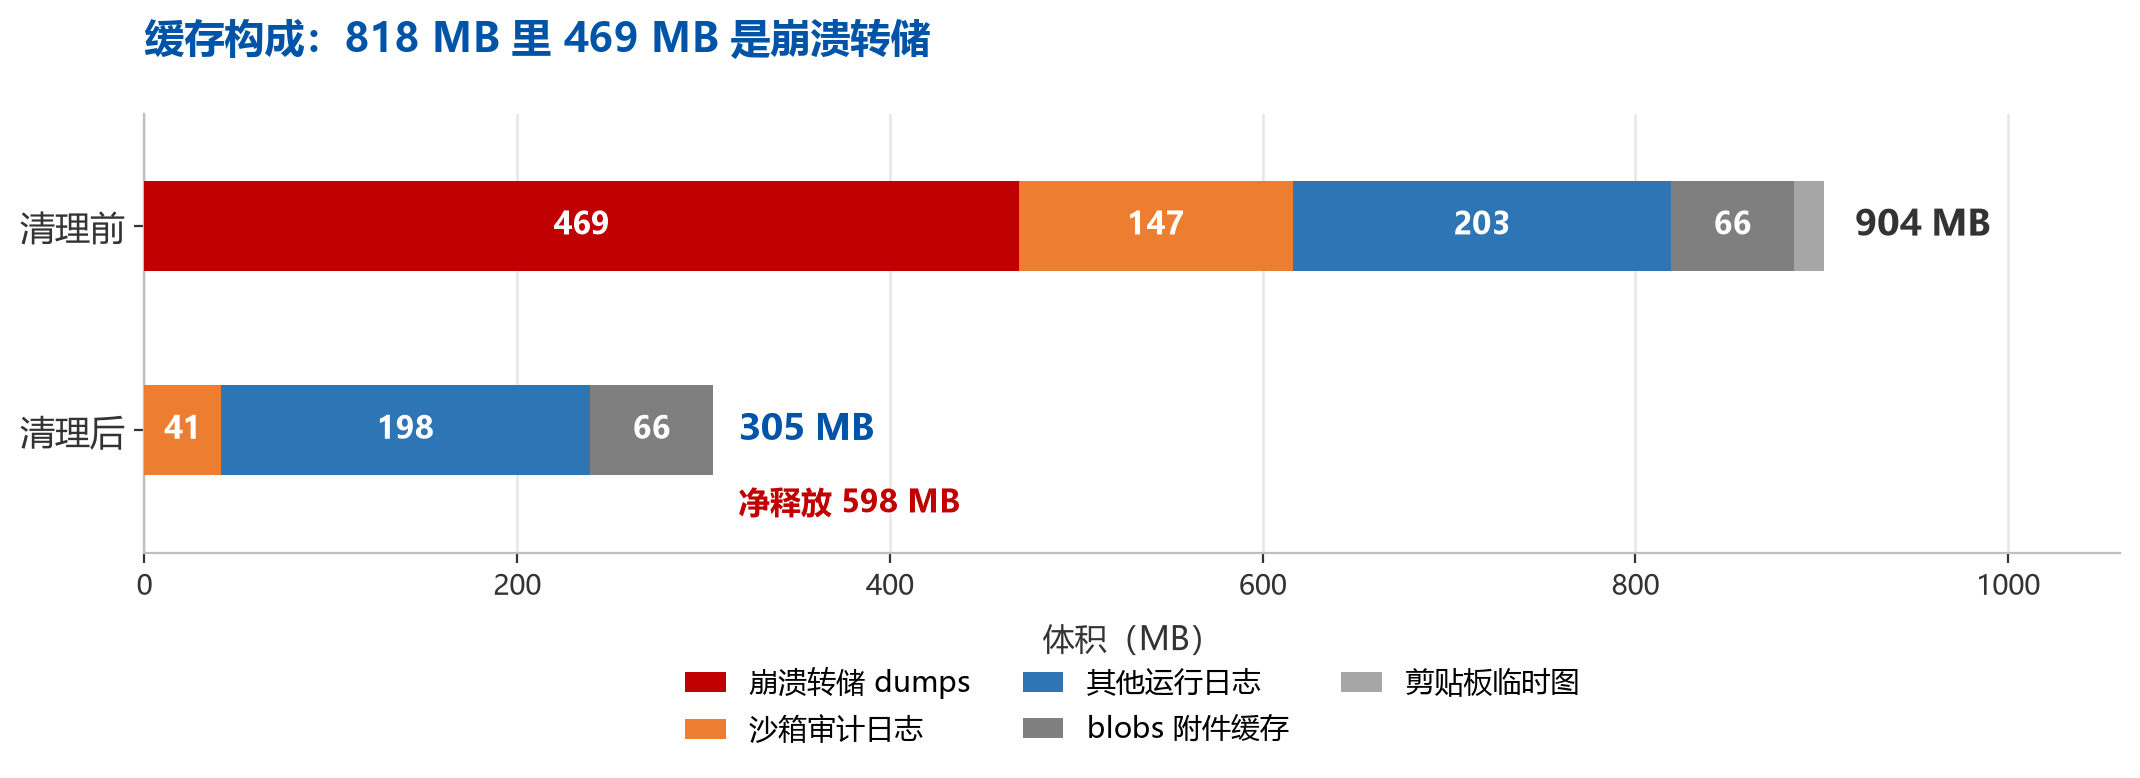 这里有个坑要提醒:删除会被安全机制拦截,报 `trash-failed`。 表现很迷惑——**命令报错了,但文件其实删掉了一部分**,而且删大目录会卡四分钟以上。正确做法是按文件粒度分批删,别整目录递归。 --- ## 五、三条能带走的经验 **1. 技能的成本是按"每次任务"算的。** 留着它的每一天,都在给所有任务加税。 **2. 宁可少而清晰,不要多而模糊。** 20 个各管一段,不如 12 个边界清楚。重复带来的不是冗余,是决策成本。 **3. 先量化,再动手。** 三个数字就能定位八成问题:技能总数、总体积、最大单文件。 --- ## 附:体检脚本 改开头一行路径就能跑。 ```javascript import os BASE = r"你的技能目录" rows = [] for name in sorted(os.listdir(BASE)): path = os.path.join(BASE, name) md = os.path.join(path, "SKILL.md") if not os.path.isfile(md): continue size = os.path.getsize(md) ref_n = ref_b = scr_n = 0 for sub in ("references", "scripts"): p = os.path.join(path, sub) if not os.path.isdir(p): continue for root, _, files in os.walk(p): for f in files: b = os.path.getsize(os.path.join(root, f)) if sub == "references": ref_n += 1 ref_b += b else: scr_n += 1 rows.append((name, size, ref_n, ref_b, scr_n)) rows.sort(key=lambda x: -x[1]) for name, size, rn, rb, sn in rows: print(f"{name:8.1f}KB{rn:>5}refs{rb/1024:>8.1f}KB{sn:>4}scripts") ``` **排在最前面的,就是重点怀疑对象。** 再逐个问三句话:它和别的技能重复吗?一个月用过两次以上吗?它的价值配得上这个体积吗? --- 说句实在的,治理技能这件事,本质是做减法。 装的时候总想着"万一以后要用",但每一个"万一",都在给日常任务加成本。 真正高频的就那么七八个。把它们的边界划清楚,比再装十个新技能有用得多。