首页 文章 精选 留言 我的

精选列表

搜索[客户分析],共10012篇文章
优秀的个人博客,低调大师

基于python impyla的hive客户

打开微信扫一扫,关注微信公众号【数据与算法联盟】 转载请注明出处:http://blog.csdn.net/gamer_gyt 博主微博:http://weibo.com/234654758 Github:https://github.com/thinkgamer 写在前边的话 在hive部署的时候我们谈过hive的三种访问方式 CLI(shell 终端) HWI (Hive的web页面操作) thrift (启动hiveserver2服务,基于thrift建立hive的操作) 第三种thrift方式的,网友们进行了封装,目前有三个广负盛名的python backage pyhive impyla(小主采用该backage) pyhs2 小主本地环境介绍 CentOS6.5 /64 位 python 2.7 这里小主做的web可视化界面比较菜看两张截图吧(这个是HIW项目的一部分 github-HIW) 部署 impyla必须的依赖包括: six bit_array thriftpy(python2.x则是thrift) 为了支持Hive还需要以下两个包: sasl thrift_sasl 先安装依赖 pip install thrift_sasl pip install sasl 报错: gcc: error trying to exec 'cc1plus': execvp: No such file or directory error: command 'gcc' failed with exit status 1 解决办法: 缺少g++文件 yum install gcc-c++ (centos中g++叫gcc-c++,如果直接安装g++会出现No package g++ available. Error: Nothing to do ) 又报错: UnicodeDecodeError: 'ascii' codec can't decode byte 0xe2 in position 73: ordinal not i 解决办法: 在python安装目录的site-packages目录下,创建sitecustomize.py,python会自动加载,添加 import sys sys.setdefaultencoding('utf-8') 如果涉及到中文只需将utf-8修改为gb2312 即可 又报错: sasl/saslwrapper.h:22:23: error: sasl/sasl.h: No such file or directory 解决办法 centos解决办法: yum install gcc-c++ python-devel.x86_64 cyrus-sasl-devel.x86_64 ubuntu/deepin(小主自己的是deepin) sudo apt-get install libsasl2-dev 然后执行 pip install thrift_sasl pip install sasl OK pip命令安装: pip install impyla 报错: bitarray/_bitarray.c:9:20: fatal error: Python.h: 没有那个文件或目录 compilation terminated. error: command 'x86_64-linux-gnu-gcc' failed with exit status 1 解决办法: 由于小主的是deepin 15.2 64位,python版本为2.7,其对应的解决办法是 sudo apt-get install python-dev python3.X版本对应的命令为 sudo apt-get install python3-dev 然后在执行安装命令即可 pip install impyla 一个小Demo 注意执行该程序之前,必须启动hiveserver2服务 from impala.dbapi import connect #需要注意的是这里的auth_mechanism必须有,但database不必须 conn = connect(host='127.0.0.1', port=10000, database='default', auth_mechanism='PLAIN') cur = conn.cursor() cur.execute('SHOW DATABASES') print(cur.fetchall()) cur.execute('SHOW Tables') print(cur.fetchall()) 关于auth_mechanism解释: auth_mechanism的值取决于hive-site.xml里边的一个配置 <name>hive.server2.authentication</name> <value>NOSASL</value> auth_mechanism的值默认是NONE,还可以是“NOSASL”,“PLAIN”,“KERBEROS”,“LDAP” 对hql进行连续处理 很简单的应用场景便是我们要处理的N句SQL的连续体,而不是单句的SQL语句,我这里进行的处理办法是切分,使用python的split,然后再进行单句执行 #连接hive def conn(): con = connect(host="192.168.132.27",port=10000,auth_mechanism="PLAIN") cur = con.cursor() return cur #执行HQL语句 def run_hql(sql): sql_list = sql[:-1].split(";") cur=conn() for s in sql_list: cur.execute(s) result=cur.fetchall() return result if __name__=="__main__": sql="show databases;use default;show tables;" print run_hql(sql) 运行结果也是没有问题的 [root@master1 HIW]# python hive/phive.py [('test',)] 后续若有可能的话,我会更新一些impyla的其他一些用法,因为网上关于impyla的资料很少,除了github项目地址之外很难再找到其他的,所以 如果你有好的文章或者教程的话,欢迎留言

优秀的个人博客,低调大师

Giraph源码分析(六)——Edge 分析

1.在Vertex类中,顶点的存储方式采用邻接表形式。每个顶点有 VertexId、VertexValue、OutgoingEdges和Halt,boolean型的halt变量用于记录顶点的状态,false时表示active,true表示inactive状态。 片段代码如下。 2.org.apache.giraph.edge.Edge 接口,用于存储顶点的边,每条边包含targetVertexId和edgeValue两个属性。类关系图如下: Giraph默认使用DefaultEdge类存储边,该类中有两个变量: I targetVertexId和 E value,I为顶点ID的类型,E为边的类型。注意,DefaultEdge类同时继承ReusableEdge接口,在ReusableEdge类的定义中,有如下说明文字:A complete edge, the target vertex and the edge value. Can only be one edge with a destination vertex id per edge map. This edge can be reused, that is you can set it's target vertex ID and edge value. Note: this class is useful for certain optimizations, but it's not meant to be exposed to the user. Look at MutableEdge instead. 从上述说明文字可知,edge可以被重用,只需要修改targetVertexId和value的值就行。即每个Vertex若有多条出边,只会创建一个DefaultEdge对象来存储边。3.org.apache.giraph.edge.OutEdges 用于存储每个顶点的out-edges。从Vertex类的定义可知,顶点的每条边都被存储在OutEdges类型的edge对象中,OutEdges接口的关系图如下: Giraph默认的使用ByteArrayEdges,每个顶点的所有边都被存储在byte[ ]中。当顶点向它的出边发送消息时,需要遍历Vertex类中的edges对象。示例代码如下: 注意:由DefaultEdge的定义可知,遍历getEdges时,返回的Edge对象时同一个对象,只是该对象中值改变了。下面继续查看代码来证明此观点。查看ByteArrayEdges类的iterator()方法,如下: 返回的是内部类ByteArrayEdgeIterator对象,定义如下: 总结:当顶点的出度很大时,此优化甚好,能很好的节约内存。如UK-2005数据中,顶点的最大出度为 5213。假设顶点1的出度顶点有<2 , 0.4>,<3 , 7.8> ,<5 , 6.4> 。如下代码: 输出结果为:[ 2 ][ 3 , 3 ][ 5 , 5 , 5 ]并非是希望的 [ 2 , 3 , 5 ]

优秀的个人博客,低调大师

kaldi 源码分析(七) - HCLG 分析

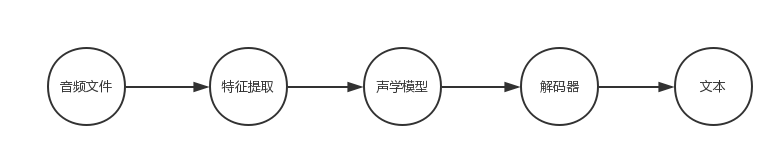
Kaldi 语音识别主流程: 语音识别过程 解码网络使用 HCLG.fst 的方式, 它由 4 个 fst 经过一系列算法组合而成。分别是 H.fst、C.fst、L.fst 和 G.fst 4 个 fst 文件: 1. G:语言模型,输入输出类型相同,实际是一个WFSA(acceptor接受机),为了方便与其它三个WFST进行操作,将其视为一个输入输出相同的WFST。 2. L:发音词典,输入:monophone,输出:词; 3. C:上下文相关,输入:triphone(上下文相关),输出:monophnoe; 4. H:HMM声学模型,输入:HMM transitions-ids (对 pdf-id 和 其它信息编码后的 id),输出:triphone。 通过如下组合方式来计算最终输出结果: HCLG = asl(min(rds(det(H' o min(det(C o min(det(Lo G)))))))) 上面的o表示组合,det表示确定化,min表示最小化,rds表示去除消岐符号,asl表示增加自环。 其训练顺序为 G -> L -> C -> H (因 G 语法模型基于统计生成,L 则是在 G 生成过程中使用的基础,而 C 则是基于 L 生成的 phone 上下文关系依据决策树生成的结果) 解码过程中使用 Lattice 来保存识别的候选序列,通过遍历得到得分最靠前的多条候选路径,即 N-best,即为输出文本。Lattice 本质是一个有向无环图( directed acyclic graph )。 图上的每个节点代表一个词的结束时间点,每条边代表一个可能的词,以及该词发生的声学得分和语言模型得分。 参考 语音识别中的lattice与confusion networkkaldi lattice

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册