首页 文章 精选 留言 我的

精选列表

搜索[季度营收],共6906篇文章
优秀的个人博客,低调大师

EKS 训练营-vue 项目实战(16)

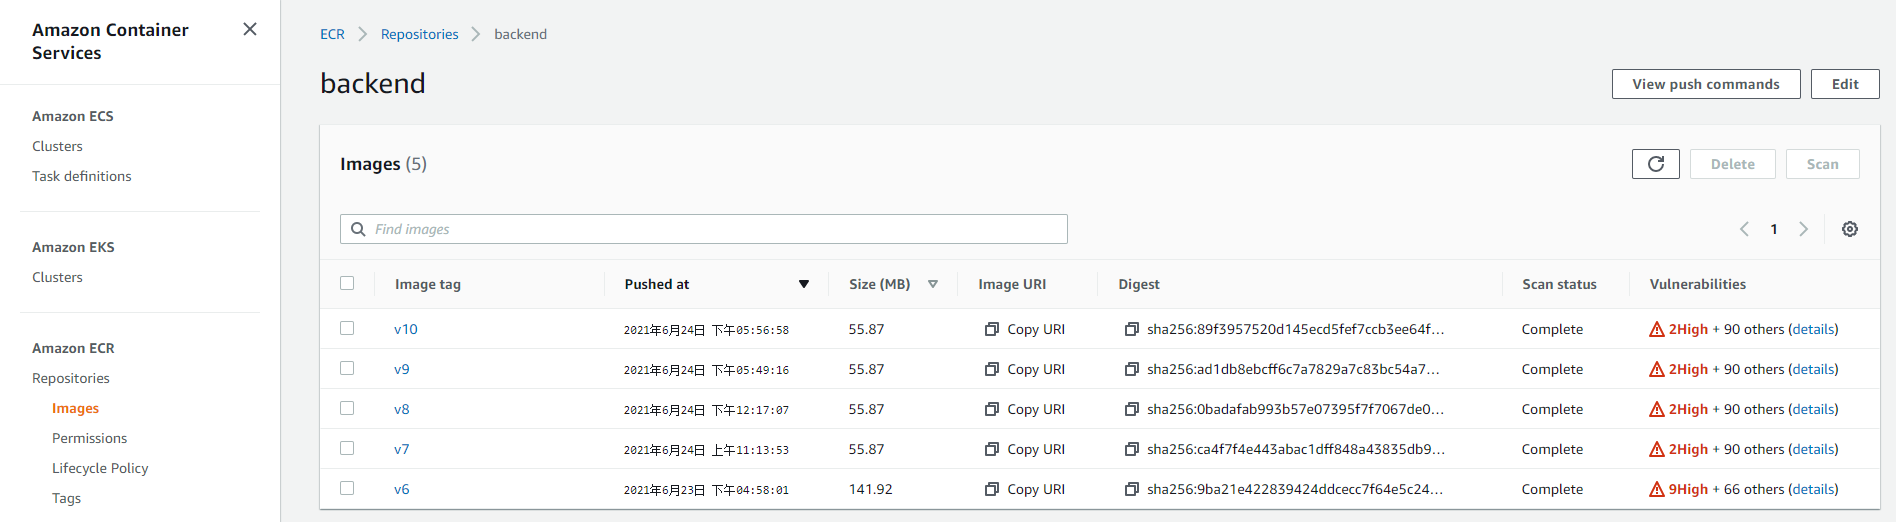
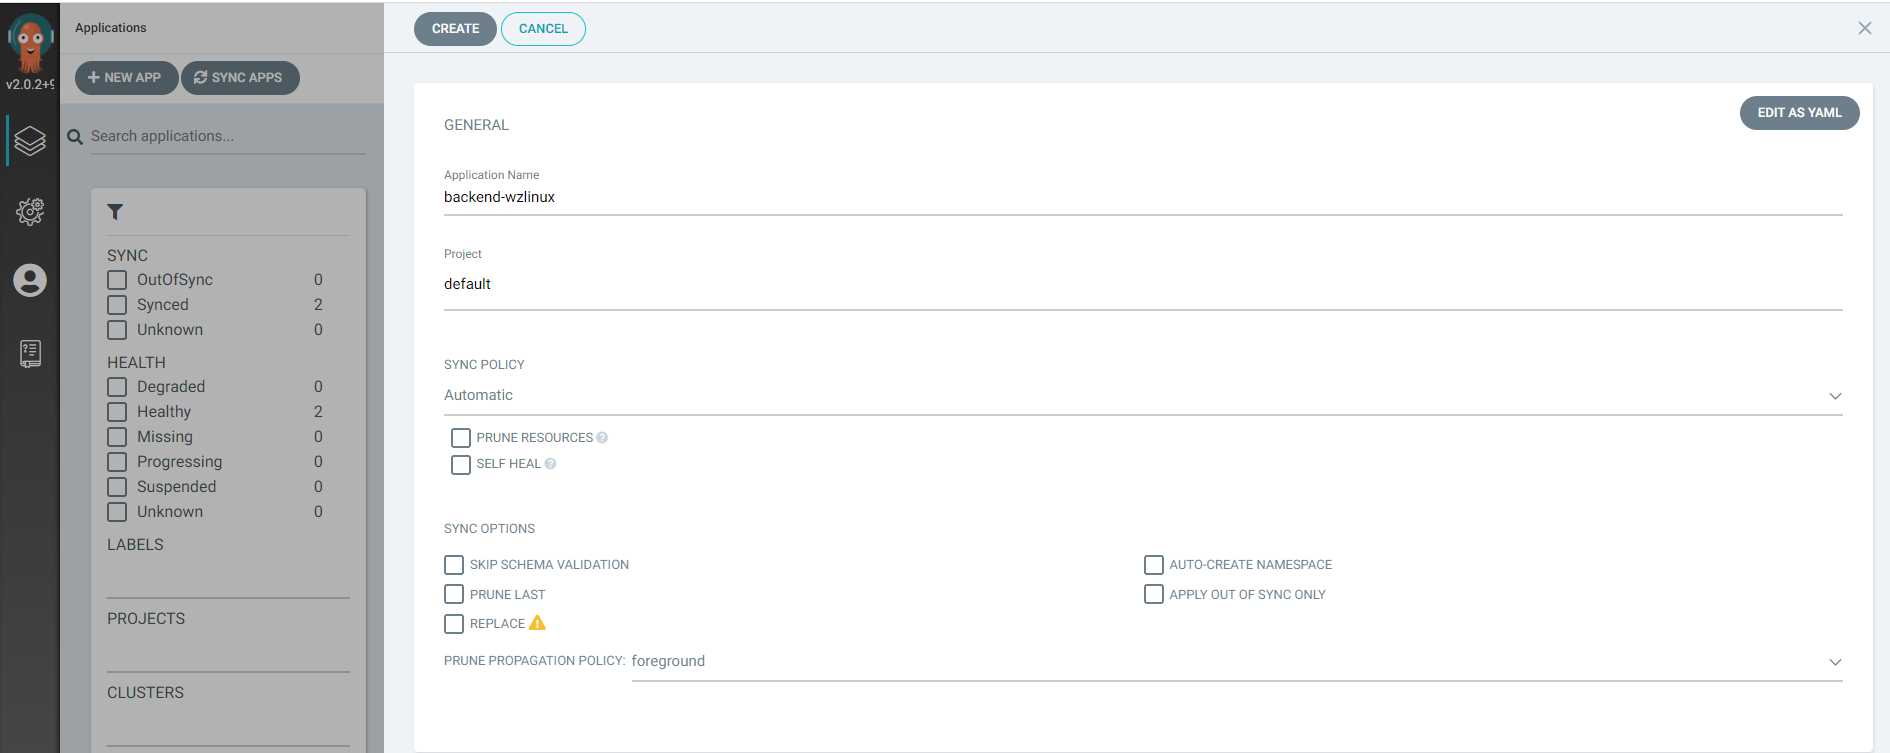
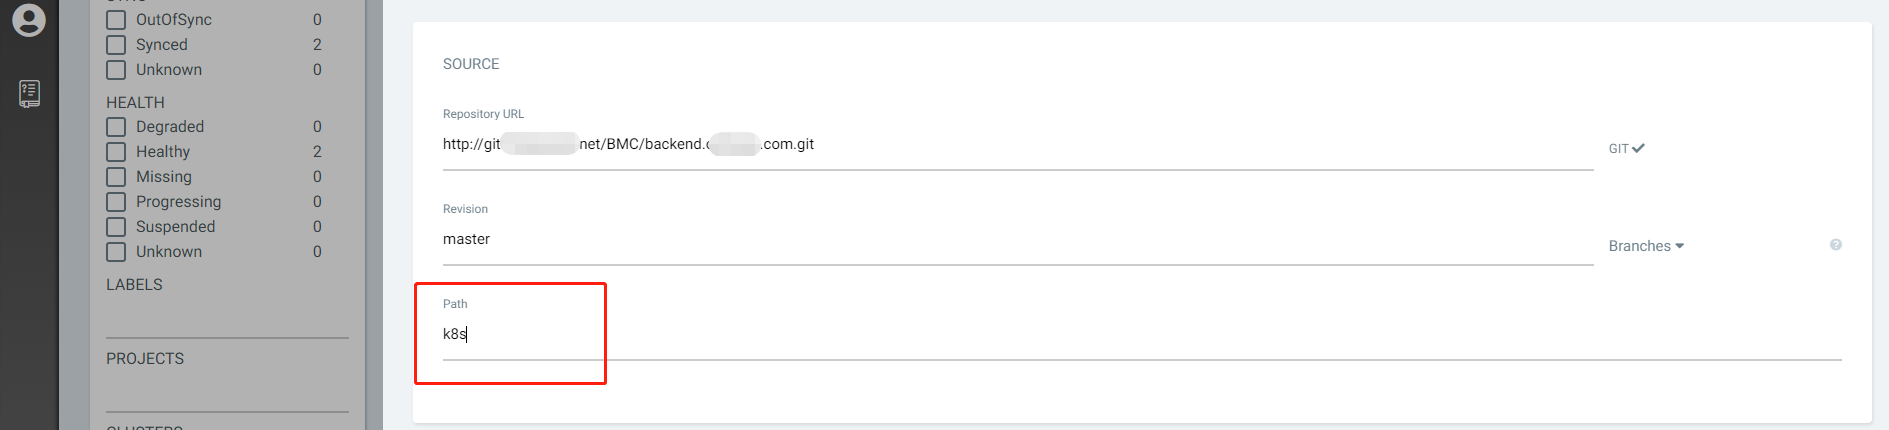
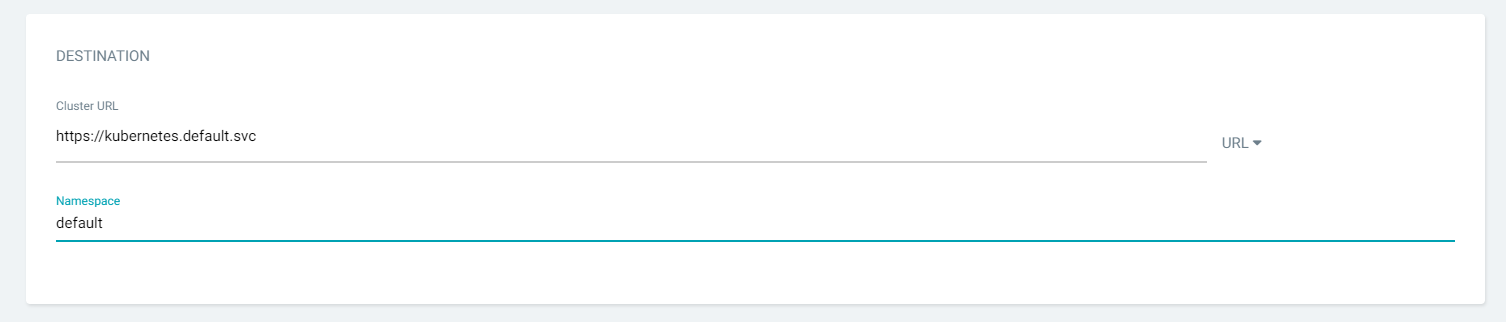
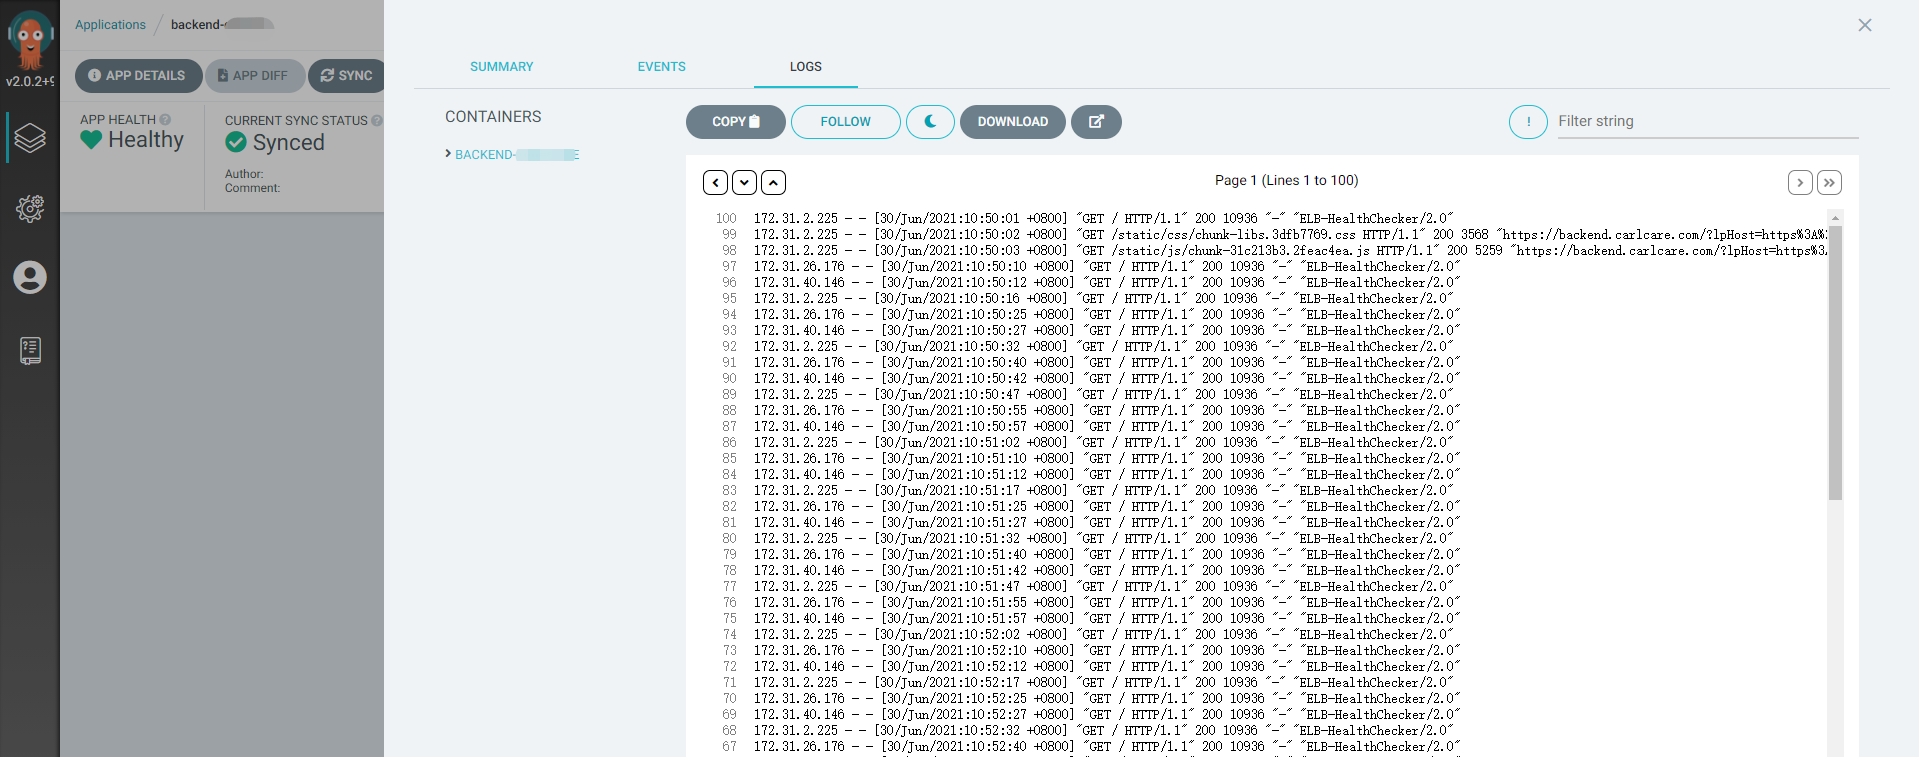
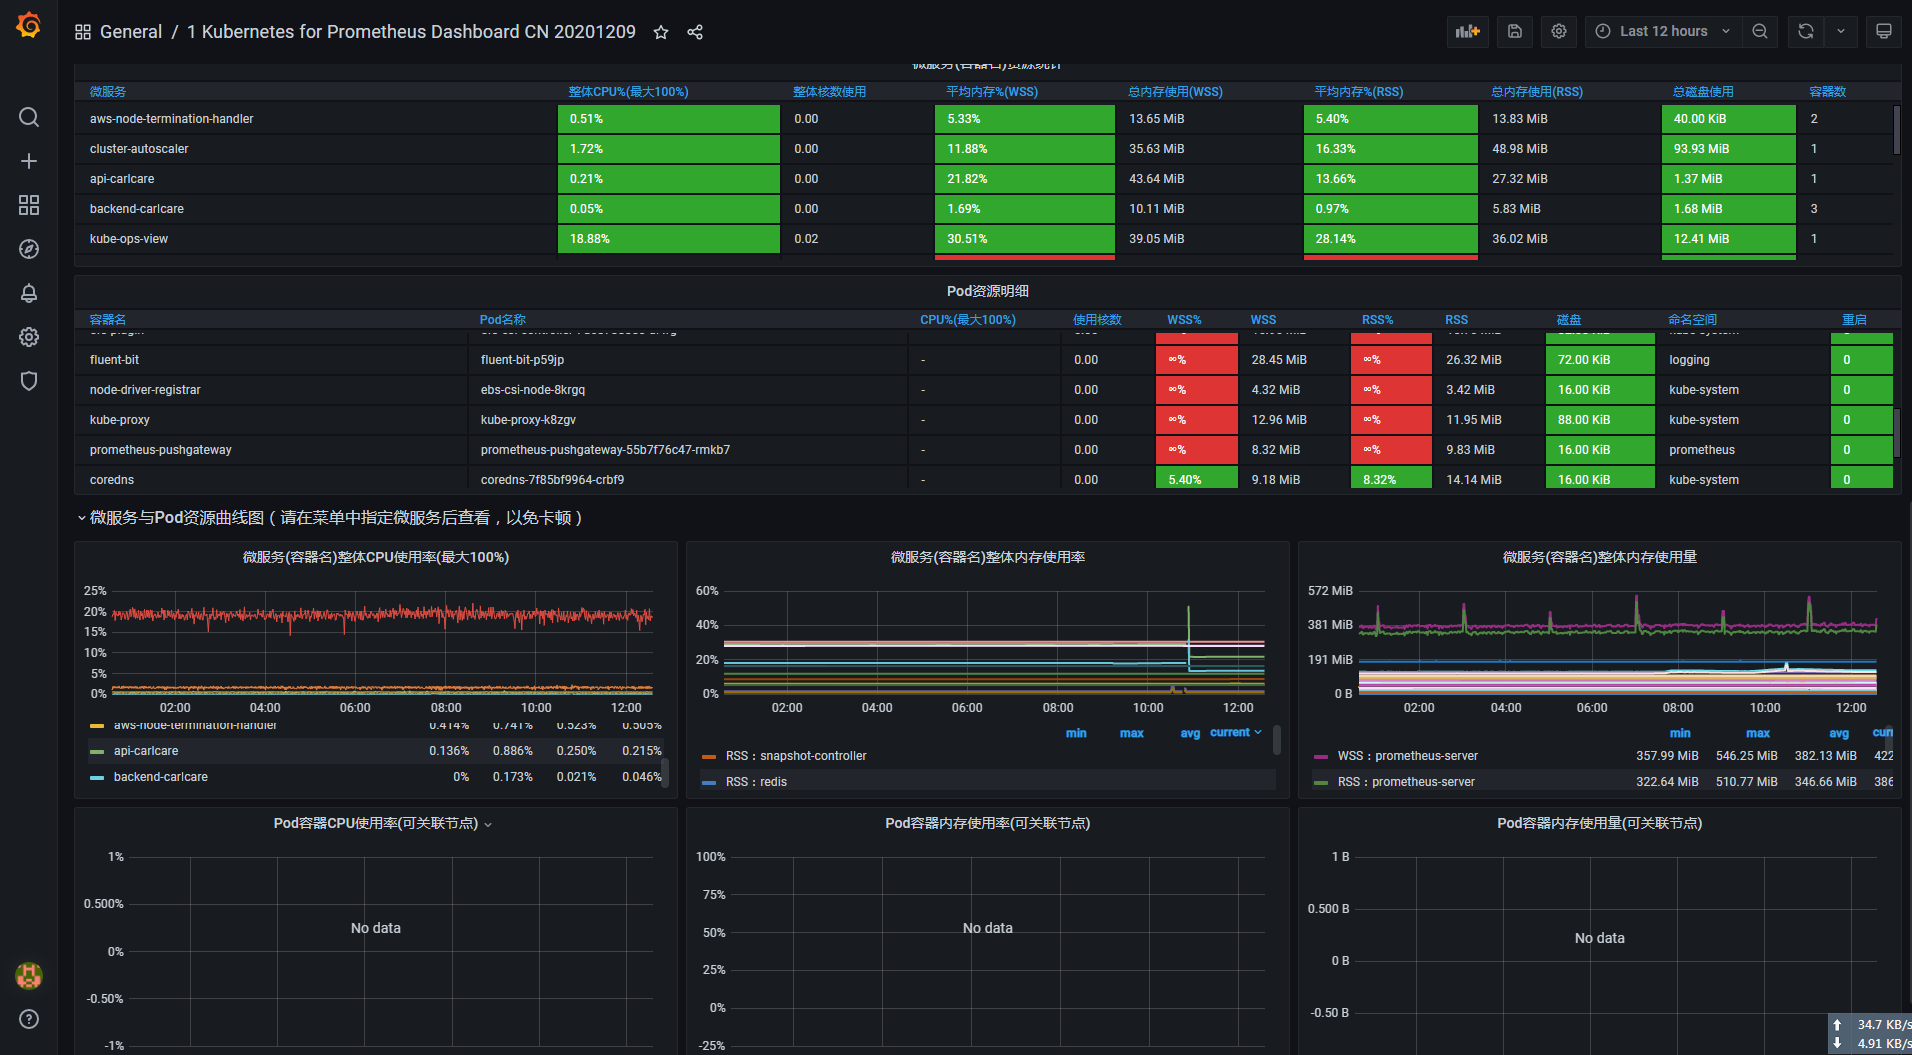
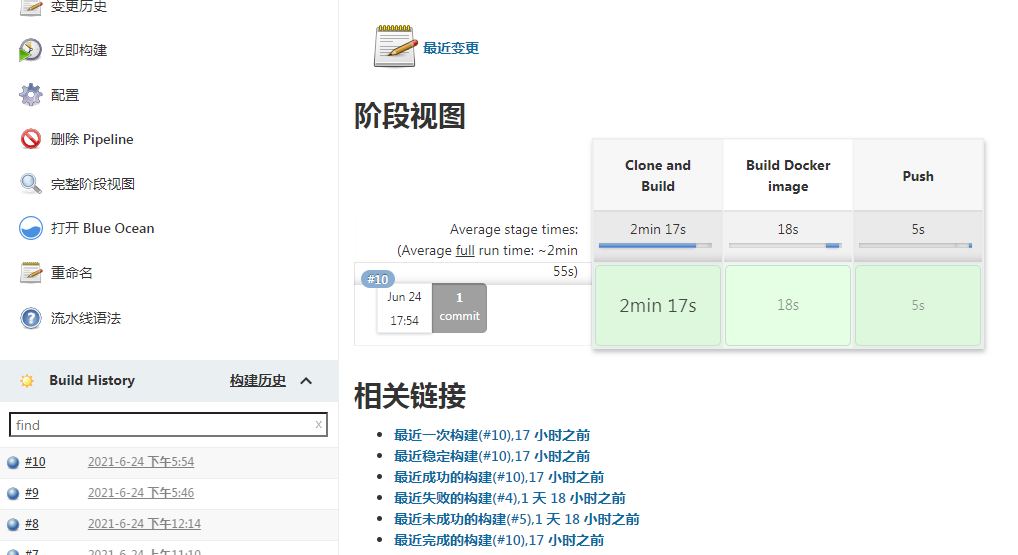
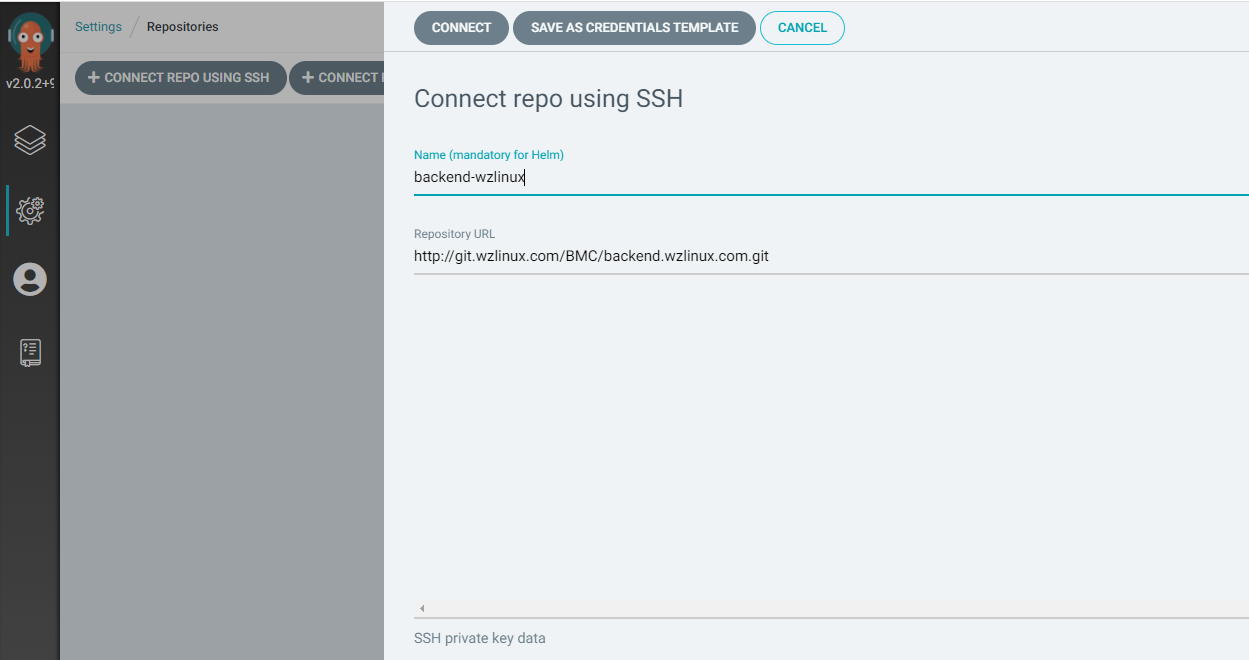
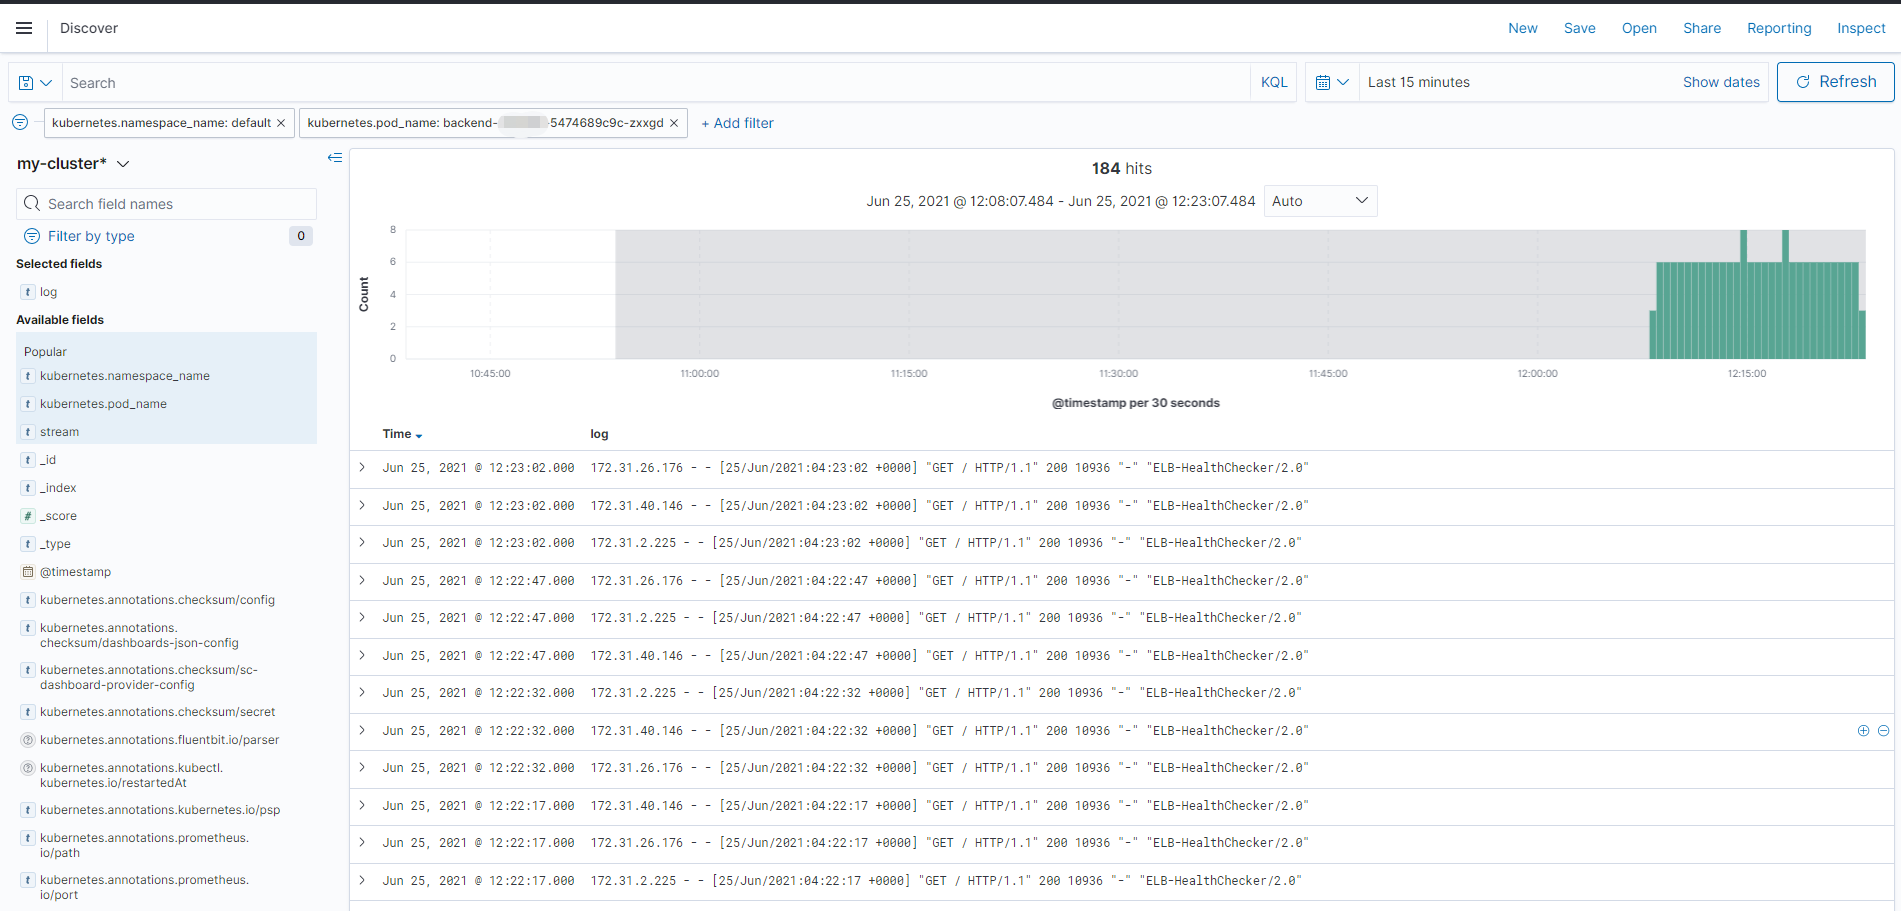
# 介绍 我演示的这个项目使用 vue-element-admin 模版编写,是一个前端项目,相对来说比较简单。 官方地址为:https://panjiachen.github.io/vue-element-admin-site/ ![image-20210625110920533](https://imgs.wzlinux.com/blog/202106/25/110921-711930.png) 代码不过多介绍,我们直接部署 CI/CD 流程。 # Continuous Integration ## 编写 Dockerfile 因为是前端项目,我们只需要 nginx 提供 web 服务即可,并且只需要把打包好的文件 dist 放入镜像就行,所以 Dockerfile 可以这样编写。 ```dockerfile # Version 0.0.1 FROM nginx MAINTAINER wzlinux "admin@wzlinux.com" COPY ["backend.wzlinux.com.conf","/etc/nginx/conf.d/default.conf"] COPY ["dist/","/usr/share/nginx/html/"] EXPOSE 80 ``` ## 编写 nginx conf 默认的 nginx 配置文件不满足我们的代码需要,我们需要定制自己的 conf 文件 `backend.wzlinux.com.conf` ```nginx server { listen 80 default_server; listen [::]:80 default_server; server_name _; index index.html index.htm index.php default.html default.htm default.php; root /usr/share/nginx/html; #关键解决vue路由丢失问题 location / { try_files $uri $uri/ /index.html; } location ~ .*\.(gif|jpg|jpeg|png|bmp|swf)$ { expires 30d; } location ~ .*\.(js|css)?$ { expires 12h; } location ~ /.well-known { allow all; } location ~ /\. { deny all; } #access_log /var/log/nginx/access.log; #error_log /var/log/nginx/error.log; access_log /dev/stdout; error_log /dev/stderr; } ``` 以上两个文件放在代码根目录即可。 ## 编写 Jenkins pipeline 我们的 jenkins 已经配置过 EKS,这里不再介绍,可以查看前面的文档,这里直接贴出 pipeline,其他项目都可以按照这个结构,更好自己需要的镜像或者命令即可。 ```json podTemplate( containers: [ containerTemplate(name: 'node', image: 'wangzan18/node:12-slim', ttyEnabled: true, command: 'cat'), containerTemplate(name: 'docker', image: 'docker:latest', ttyEnabled: true, command: 'cat'), containerTemplate(name: 'awscli', image: 'amazon/aws-cli:latest', ttyEnabled: true, command: 'cat') ], volumes: [ hostPathVolume(mountPath: '/var/run/docker.sock', hostPath: '/var/run/docker.sock'), hostPathVolume(mountPath: '/usr/bin/docker', hostPath: '/usr/bin/docker') ], serviceAccount: 'jenkins-agent' ) { node(POD_LABEL) { stage('Clone and Build') { git branch: 'master', credentialsId: 'd38f927d-9152-4083-9e48-c312a07d230e', url: 'http://git.wzlinux.net/BMC/backend.wzlinux.com.git' container('node') { sh 'npm install' sh 'npm run build:prod' } } stage('Build Docker image') { container('docker') { sh 'docker build -t backend:v${BUILD_NUMBER} .' sh 'docker tag backend:v${BUILD_NUMBER} 921283538843.dkr.ecr.eu-west-1.amazonaws.com/backend:v${BUILD_NUMBER}' } } stage('Push') { container('awscli') { sh 'aws sts get-caller-identity' sh 'aws ecr get-login-password --region eu-west-1 | docker login --username AWS --password-stdin 921283538843.dkr.ecr.eu-west-1.amazonaws.com' sh 'docker push 921283538843.dkr.ecr.eu-west-1.amazonaws.com/backend:v${BUILD_NUMBER}' } } } } ``` 在 podTemplate 里面定义整个过程需要的镜像,针对这个 vue,我们使用到 node 镜像,因为 vue 里面一些资源需要 git 命令下面,我自己在 node:12-slim 里面安装了 git,重新制作了一个公共镜像,大家可以使用。 在 node 里面的 stage 就是我们真正的构建过程,第一个 stage 主要是拉取代码,已经进行 build 打包,打包完成之后会生成一个 dist 目录,我们 Dockerfile 里面会把这个 dist 目录文件复制到 nginx 的文件目录。 第二个 stage 就是制作镜像,并且给镜像加一个 `BUILD_NUMBER` 的版本,然后改为我们 ECR 的标签,这里应该注意到我们里面有一个 `serviceAccount` 的参数,因为后面上传镜像到 ECR 需要权限,我们根据 EKS IRSA 的功能,为这个 `serviceAccount` 赋予了 ECR 上传代码的权限。 第三个 stage 就是上传镜像了,在上传镜像之前,首先需要登录 ECR,可以直接使用 awscli 提供的指令进行登录,然后使用 docker push 进行镜像上传。 然后就可以直接指向 Jenkins task,查看镜像上传。 ![image-20210625112818357](https://imgs.wzlinux.com/blog/202106/25/112818-315806.png) 查看我们上传的镜像。 ![image-20210625112948141](https://imgs.wzlinux.com/blog/202106/25/113026-257768.png) 到此为止,我们整个 CI 流程已经完成,后面我们进行 CD 的演示。 # Continuous Deployment ## 编写 k8s 清单文件 在 EKS 中,node 节点所赋予的 Role 默认有 ECR 镜像的拉取,这里我们不需要再单独授权。在代码的根目录,我们创建一个`k8s`文件夹,然后创建两个清单: **deployment.yaml** ```yaml apiVersion: apps/v1 kind: Deployment metadata: name: backend-wzlinux labels: k8s-app: backend-wzlinux namespace: default spec: replicas: 3 selector: matchLabels: k8s-app: backend-wzlinux strategy: rollingUpdate: maxSurge: 25% maxUnavailable: 25% type: RollingUpdate template: metadata: labels: k8s-app: backend-wzlinux annotations: fluentbit.io/parser: nginx spec: containers: - image: 921283538843.dkr.ecr.eu-west-1.amazonaws.com/backend:v10 imagePullPolicy: Always name: backend-wzlinux env: - name: TZ value: Asia/Shanghai resources: limits: cpu: 500m memory: 500Mi requests: cpu: 100m memory: 200Mi ports: - containerPort: 80 protocol: TCP ``` **service.yaml** ```yaml apiVersion: v1 kind: Service metadata: name: backend-wzlinux spec: selector: k8s-app: backend-wzlinux ports: - protocol: TCP port: 80 targetPort: 80 type: ClusterIP --- apiVersion: networking.k8s.io/v1 kind: Ingress metadata: namespace: default name: backend-ingress annotations: kubernetes.io/ingress.class: alb alb.ingress.kubernetes.io/listen-ports: '[{"HTTP": 80}, {"HTTPS": 443}]' alb.ingress.kubernetes.io/target-group-attributes: stickiness.enabled=true,stickiness.lb_cookie.duration_seconds=600 alb.ingress.kubernetes.io/scheme: internet-facing alb.ingress.kubernetes.io/conditions.backend-wzlinux: > [{"field":"host-header","hostHeaderConfig":{"values":["backend.wzlinux.com"]}}] alb.ingress.kubernetes.io/group.name: wzlinux alb.ingress.kubernetes.io/ssl-redirect: '443' alb.ingress.kubernetes.io/certificate-arn: arn:aws:acm:eu-west-1:921283538843:certificate/e55a72ae-d9b5-4f77-bf6d-242691105231 alb.ingress.kubernetes.io/target-type: ip spec: rules: - http: paths: - path: / pathType: Prefix backend: service: name: backend-wzlinux port: number: 80 ``` 在 service 里面,我使用了 Ingress,为了使用 ALB,并且添加证书,具体的 annotations 含义,请查看下面的文档:https://kubernetes-sigs.github.io/aws-load-balancer-controller/v2.2/guide/ingress/annotations/ 上面的 ingress 清单,可以使用 Headless Service,也可以写成下面这样: ```yaml apiVersion: v1 kind: Service metadata: name: backend-wzlinux spec: selector: k8s-app: backend-wzlinux ports: - protocol: TCP port: 80 targetPort: 80 type: ClusterIP clusterIP: None --- apiVersion: networking.k8s.io/v1 kind: Ingress metadata: namespace: default name: backends-ingress annotations: kubernetes.io/ingress.class: alb alb.ingress.kubernetes.io/listen-ports: '[{"HTTP": 80}, {"HTTPS": 443}]' alb.ingress.kubernetes.io/target-group-attributes: stickiness.enabled=true,stickiness.lb_cookie.duration_seconds=600 alb.ingress.kubernetes.io/scheme: internet-facing alb.ingress.kubernetes.io/group.name: wzlinux alb.ingress.kubernetes.io/ssl-redirect: '443' alb.ingress.kubernetes.io/certificate-arn: arn:aws:acm:eu-west-1:921283538843:certificate/e55a72ae-d9b5-4f77-bf6d-242691105231 alb.ingress.kubernetes.io/target-type: ip spec: rules: - host: backends.wzlinux.com http: paths: - pathType: ImplementationSpecific backend: service: name: backend-wzlinux port: number: 80 ``` ## 配置 argocd 首先为 argocd 配置 Repositories。 ![image-20210625121850828](https://imgs.wzlinux.com/blog/202106/25/121851-679605.png) 创建 app。 ![image-20210625121932020](https://imgs.wzlinux.com/blog/202106/25/121932-170841.png) ![image-20210625122007852](https://imgs.wzlinux.com/blog/202106/25/122008-53226.png) ![image-20210625122028572](https://imgs.wzlinux.com/blog/202106/25/122029-708478.png) 当然在 Argo CD 里面也可以查看日志,也是很方便的。 ![image-20210630105825514](https://imgs.wzlinux.com/blog/image-20210630105825514.png) 这样设置的话,当我们更新清单就会自动发布。 整个流程大概就是这样。 # 日志查看 登陆到我们的 Kibana,可以看到相关 Pod 的日志信息,因为我们把 nginx 访问日志和错误日志都输出到终端了。 ![image-20210625122738420](https://imgs.wzlinux.com/blog/202106/25/122739-127703.png) 目前还没有什么访问量,基本都是 ALB 健康检查的日志。 # 监控查看 ![image-20210625123608106](https://imgs.wzlinux.com/blog/202106/25/123608-640587.png) # 欢迎大家扫码关注,获取更多信息 ![](https://imgs.wzlinux.com/wechat/wechat-8.jpg)
优秀的个人博客,低调大师

EKS 训练营-日志收集 EFK(14)

# 介绍 应用程序和系统日志可以帮助我们了解集群内部的运行情况,日志对于我们调试问题和监视集群情况也是非常有用的。而且大部分的应用都会有日志记录,对于传统的应用大部分都会写入到本地的日志文件之中。对于容器化应用程序来说则更简单,只需要将日志信息写入到 stdout 和 stderr 即可,容器默认情况下就会把这些日志输出到宿主机上的一个 JSON 文件之中,同样我们也可以通过 docker logs 或者 kubectl logs 来查看到对应的日志信息。 但是,通常来说容器引擎或运行时提供的功能不足以记录完整的日志信息,比如,如果容器崩溃了、Pod 被驱逐了或者节点挂掉了,我们仍然也希望访问应用程序的日志。所以,日志应该独立于节点、Pod 或容器的生命周期,这种设计方式被称为 cluster-level-logging,即完全独立于 Kubernetes 系统,需要自己提供单独的日志后端存储、分析和查询工具。 ## 日志收集方案 Kubernetes 集群本身不提供日志收集的解决方案,一般来说有主要的 3 种方案来做日志收集: - 在节点上运行一个 agent 来收集日志 ![image-20210607203949035](https://imgs.wzlinux.com/blog/202106/07/203949-774535.png) - 在 Pod 中包含一个 sidecar 容器来收集应用日志 ![image-20210607204001951](https://imgs.wzlinux.com/blog/202106/07/204002-893326.png) - 直接在应用程序中将日志信息推送到采集后端 ![image-20210607204111275](https://imgs.wzlinux.com/blog/202106/07/204111-160445.png) Kubernetes 中比较流行的日志收集解决方案是 Elasticsearch、Fluentd 和 Kibana(EFK)技术栈,也是官方现在比较推荐的一种方案。 `Elasticsearch` 是一个实时的、分布式的可扩展的搜索引擎,允许进行全文、结构化搜索,它通常用于索引和搜索大量日志数据,也可用于搜索许多不同类型的文档。 Elasticsearch 通常与 `Kibana` 一起部署,Kibana 是 Elasticsearch 的一个功能强大的数据可视化 Dashboard,Kibana 允许你通过 web 界面来浏览 Elasticsearch 日志数据。 `Fluentd`是一个流行的开源数据收集器,我们将在 Kubernetes 集群节点上安装 Fluentd,通过获取容器日志文件、过滤和转换日志数据,然后将数据传递到 Elasticsearch 集群,在该集群中对其进行索引和存储。 `Fluentd` 是一个高效的日志聚合器,是用 Ruby 编写的,并且可以很好地扩展。对于大部分企业来说,Fluentd 足够高效并且消耗的资源相对较少,另外一个工具`Fluent-bit`更轻量级,占用资源更少,但是插件相对 Fluentd 来说不够丰富,所以整体来说,Fluentd 更加成熟,使用更加广泛,所以我们这里也同样使用 Fluentd 来作为日志收集工具。 我们先来配置启动一个可扩展的 Elasticsearch 集群,然后在 Kubernetes 集群中创建一个 Kibana 应用,最后通过 DaemonSet 来运行 Fluentd,以便它在每个 Kubernetes 工作节点上都可以运行一个 Pod。 # 创建 ES 集群 为了简便,我们这里使用 AWS 全托管的 ES 服务,服务将会开启精细访问服务,先设定几个环境变量: ```bash # name of our elasticsearch cluster export ES_DOMAIN_NAME="eks-logging" # Elasticsearch version export ES_VERSION="7.10" # kibana admin user export ES_DOMAIN_USER="admin" # kibana admin password export ES_DOMAIN_PASSWORD="Wangzan@18" ``` 创建 ES 集群 ```bash # Download and update the template using the variables created previously mkdir ~/environment/logging/ && cd ~/environment/logging/ curl -sS https://raw.githubusercontent.com/wangzan18/jenkins-agent-k8s-cicd/master/logging/es-domain.json \ | envsubst > ~/environment/logging/es_domain.json # Create the cluster aws es create-elasticsearch-domain \ --cli-input-json file://~/environment/logging/es_domain.json ``` ![image-20210607230206132](https://imgs.wzlinux.com/blog/202106/07/230206-837255.png) # 为 Fluent bit 配置 IRSA 我们为 ES 开启了精细访问控制,因为 fluent 需要向 ElasticSearch 通信,我们需要为这个 fluent 创建一个具有基本权限的 serviceAccount,这里即便给了很大的权限也是无法写入 ES 集群的,请自行替换 Resource 里面的参数。 ```bash cd ~/environment/logging/ cat < ~/environment/logging/fluent-bit-policy.json { "Version": "2012-10-17", "Statement": [ { "Action": [ "es:ESHttp*" ], "Resource": "arn:aws:es:eu-west-1:921283538843:domain/eks-logging", "Effect": "Allow" } ] } EoF aws iam create-policy \ --policy-name fluent-bit-policy \ --policy-document file://~/environment/logging/fluent-bit-policy.json ``` ## 创建 serviceAccount 为 fluent serviceAccount 创建 IAM 角色。 ```bash kubectl create namespace logging eksctl create iamserviceaccount \ --name fluent-bit \ --namespace logging \ --cluster my-cluster \ --attach-policy-arn "arn:aws:iam::921283538843:policy/fluent-bit-policy" \ --approve \ --override-existing-serviceaccounts ``` 确认一下创建的 serviceAccount 已经 annotated 相应的角色。 ```bash kubectl -n logging describe sa fluent-bit ``` 输出如下: ```bash Name: fluent-bit Namespace: logging Labels: app.kubernetes.io/managed-by=eksctl Annotations: eks.amazonaws.com/role-arn: arn:aws:iam::921283538843:role/eksctl-my-cluster-addon-iamserviceaccount-lo-Role1-1628KE9D9FMEO Image pull secrets: Mountable secrets: fluent-bit-token-kjqnh Tokens: fluent-bit-token-kjqnh Events: ``` # 配置 ES 访问权限 角色映射是精细访问控制的最重要的方面。精细访问控制具有一些预定义的角色来帮助您入门,但除非您将角色映射到用户,否则,向集群发出的每个请求都会以权限错误结束。 *Backend roles*,提供了另一种将角色映射到用户的方法。您可以将同一角色映射到单个后端角色,然后确保所有用户都具有该后端角色,而不是将同一角色映射到几十个不同的用户。后端角色可以是 IAM 角色或任意字符串。 有上面的结果我们可以知道 fluent 的 serviceAccount 的 IAM 角色为: ```bash arn:aws:iam::921283538843:role/eksctl-my-cluster-addon-iamserviceaccount-lo-Role1-1628KE9D9FMEO ``` 因为 ES 已经创建好了,我们使用提前定义的账户和密码登陆进去,然后选择 `Open Distro for Elasticsearch` --> Security --> Roles --> all_access --> Mapped users --> Manage mapping 加上上面的角色。 ![image-20210607231953893](https://imgs.wzlinux.com/blog/202106/07/231954-920360.png) 也可以使用我们定义好的账户访问 ES 接口添加权限 ```bash # We need to retrieve the Fluent Bit Role ARN export FLUENTBIT_ROLE=$(eksctl get iamserviceaccount --cluster my-cluster --namespace logging -o json | jq '.[].status.roleARN' -r) # Get the Elasticsearch Endpoint export ES_ENDPOINT=$(aws es describe-elasticsearch-domain --domain-name ${ES_DOMAIN_NAME} --output text --query "DomainStatus.Endpoint") # Update the Elasticsearch internal database curl -sS -u "${ES_DOMAIN_USER}:${ES_DOMAIN_PASSWORD}" \ -X PATCH \ https://${ES_ENDPOINT}/_opendistro/_security/api/rolesmapping/all_access?pretty \ -H 'Content-Type: application/json' \ -d' [ { "op": "add", "path": "/backend_roles", "value": ["'${FLUENTBIT_ROLE}'"] } ] ' ``` 现在我们使用自己的 IAM user 打开 Console,可以看到会有下面的报错 ![image-20210607232313985](https://imgs.wzlinux.com/blog/202106/07/232314-521859.png) 虽然我们的 IAM user 具有最高权限,但是因为开启的精细访问,这里也会显示没有权限,按照上面的方式,我们可以把自己的 IAM user 也 Map user 里面的 user。 ![image-20210607232510859](https://imgs.wzlinux.com/blog/202106/07/232511-878719.png) # 部署 fluent bit 下载 fluent bit yaml 文件,修改其中一些参数 ```bash cd ~/environment/logging # get the Elasticsearch Endpoint export ES_ENDPOINT=$(aws es describe-elasticsearch-domain --domain-name ${ES_DOMAIN_NAME} --output text --query "DomainStatus.Endpoint") curl -Ss https://raw.githubusercontent.com/wangzan18/jenkins-agent-k8s-cicd/master/logging/fluentbit.yaml \ | envsubst > ~/environment/logging/fluentbit.yaml ``` 可以查看文件清单,确认一下要部署的资源,然后我们进行部署: ```bash kubectl apply -f ~/environment/logging/fluentbit.yaml ``` 部署的为 DaemonSet,每个 node 上面都会部署一个 fluent 来收取日志。 ```bash wangzan:~/environment/logging $ kubectl --namespace=logging get pods NAME READY STATUS RESTARTS AGE fluent-bit-cfqrn 1/1 Running 0 60s fluent-bit-cnfbl 1/1 Running 0 60s fluent-bit-n46wq 1/1 Running 0 60s fluent-bit-zhbxn 1/1 Running 0 60s ``` # Kibana 可视化 登陆到 Kibana 系统之后,我们选择 Kibana ---> Discover,选择创建 index。 ![image-20210607233724563](https://imgs.wzlinux.com/blog/202106/07/233725-533201.png) 输入 index pattern 的名字,然后点击下一步 ![image-20210607233820347](https://imgs.wzlinux.com/blog/202106/07/233821-999201.png) 我们选择 @timestamp ![image-20210607233921971](https://imgs.wzlinux.com/blog/202106/07/233922-296745.png) 然后再点击 Discover,就可以看到日志了。 ![image-20210607234035175](https://imgs.wzlinux.com/blog/202106/07/234035-230542.png) # 问题处理 我们在 ES 的界面中,可以看到大量的 fluent bit 的错误报告,内容如下: ```verilog [2021/06/17 01:46:35] [ warn] [engine] failed to flush chunk '1-1623894315.231527444.flb', retry in 359 seconds: task_id=1825, input=tail.0 > output=es.0 ``` 我们再去查看 fluent bit 的 Pod ,查看报错日志,会有一个 400 错误,尽量查看新创建的 Pod: ```json "index": { "_index": "fluent-bit", "_type": "_doc", "_id": "TUx4E3oB4v1-EVN7WM4m", "status": 400, "error": { "type": "mapper_parsing_exception", "reason": "Could not dynamically add mapping for field [app.kubernetes.io/name]. Existing mapping for [kubernetes.labels.app] must be of type object but found [text]." } } ``` 我们看到,当 fluent bit 去动态创建 mapping 的时候,无法创建,我们再去查看一下 ES 的 mapping。 ![image-20210617095246535](https://imgs.wzlinux.com/blog/202106/17/095247-151579.png) 这里的 app 类型为 text,无法被创建,为什么会出现这样的问题呢? 我们去查看一下部署的 Pod,发现其中有些 Pod 同时有如下的一些 lable: ```bash app.kubernetes.io/name: app.kubernetes.io/instance: app: ``` 一般来说,若您没有特别设定,当数据写入 ES 的时候,该 index 的 index mapping 便会自动被建立,并且随着数据格式的改变动态地调整 index mapping,因为有 app 这个 label,创建了如上的 mapping,当再创建含有”kubernetes.labels.app.kubernetes.io/name” 的栏位数据写入时, ES无法动态地将”kubernetes.labels.app” 由 text 转为 object,因此出现 http 400 mapper_parsing_exception 这样的错误信息。 ## 小测试 我们可以对 ES Dev Tools 进行一下测试,我们手动写入一份数据: ```json PUT fluent-bit-test-001/_doc/1 { "kubernetes": { "labels": { "app":"test" } } } ``` 然后查看一下 ES 自动创建的 Index mapping。 ```bash GET /fluent-bit-test-001/_mapping ``` ![image-20210617101342472](https://imgs.wzlinux.com/blog/202106/17/101343-316893.png) 若我再写一笔数据至fluent-bit-test-001。 ```json PUT fluent-bit-test-001/_doc/2 { "kubernetes": { "labels": { "app-test":"test" } } } ``` 此时该索引的mapping便随之更动如下: ```json { "fluent-bit-test-001" : { "mappings" : { "properties" : { "kubernetes" : { "properties" : { "labels" : { "properties" : { "app" : { "type" : "text", "fields" : { "keyword" : { "type" : "keyword", "ignore_above" : 256 } } }, "app-test" : { "type" : "text", "fields" : { "keyword" : { "type" : "keyword", "ignore_above" : 256 } } } } } } } } } } } ``` ![image-20210617101558456](https://imgs.wzlinux.com/blog/202106/17/101559-841545.png) 那么我们去重现一下上面的问题,写入如下数据 ```json PUT fluent-bit-test-001/_doc/3 { "kubernetes": { "labels": { "app": { "kubernetes": { "io/name":"test12345" } } } } } ``` 便会出现http 400 mapper_parsing_exception error. 又“kubernetes.labels.app” 无法同时为text及object 型态。 ![image-20210617101835707](https://imgs.wzlinux.com/blog/202106/17/101835-513511.png) ## 解决办法 调整 prod labels 的 key 值的 naming 规则,举例来说,若 labels 的 Key 已经有 app 这样的 key 值了,就不要有后续 app.kubernetes.io/name 这样的 Key 值。 我看了一下,同时有这两个 label 的 Pod 基本就是 ebs,efs,我们去修改他们的 deployment,删掉这些 app 这个标签。 **更改 ebs-csi-controller** ```bash kubectl delete deploy ebs-csi-controller -n kube-system kubectl apply -f https://raw.githubusercontent.com/wangzan18/jenkins-agent-k8s-cicd/master/logging/ebs-csi-controller.yaml -n kube-system ``` **ebs-csi-node** ```bash kubectl delete daemonset ebs-csi-node -n kube-system kubectl apply -f https://raw.githubusercontent.com/wangzan18/jenkins-agent-k8s-cicd/master/logging/ebs-csi-node.yaml -n kube-system ``` **ebs-snapshot-controller** ```bash kubectl delete statefulset ebs-snapshot-controller -n kube-system kubectl apply -f https://raw.githubusercontent.com/wangzan18/jenkins-agent-k8s-cicd/master/logging/ebs-snapshot-controller.yaml -n kube-system ``` **efs-csi-controller** ```bash kubectl delete deploy efs-csi-controller -n kube-system kubectl apply -f https://raw.githubusercontent.com/wangzan18/jenkins-agent-k8s-cicd/master/logging/efs-csi-controller.yaml -n kube-system ``` **efs-csi-node** ```bash kubectl delete daemonset efs-csi-node -n kube-system kubectl apply -f https://raw.githubusercontent.com/wangzan18/jenkins-agent-k8s-cicd/master/logging/efs-csi-node.yaml -n kube-system ``` 然后查看命令,看看还有哪些 Pod 是带有 app 这个标签的。 ```bash kubectl get pod -n kube-system -l app --show-labels ``` 发现只有一个 cluster-autoscaler,我们修改最后一个 Pod。 **cluster-autoscaler** ```bash kubectl -n kube-system edit deployment.apps/cluster-autoscaler kubectl apply -f https://raw.githubusercontent.com/wangzan18/jenkins-agent-k8s-cicd/master/logging/cluster-autoscaler-autodiscover.yaml -n kube-system kubectl -n kube-system \ annotate deployment.apps/cluster-autoscaler \ cluster-autoscaler.kubernetes.io/safe-to-evict="false" deployment.apps/cluster-autoscaler annotated ``` 现在已经没有使用 app 标签的 Pod 了,我们下一步需要重建 ES 的 Index,我们适当的修改 fluent bit 的配置文件,在输出里面,添加一些参数,使得每天生成一个 Index,这样可以提升检索速度,记得把 yaml 下载下来,修改为自己的 ES 地址。 ```bash kubectl delete -f fluentbit.yaml kubectl apply -f https://raw.githubusercontent.com/wangzan18/jenkins-agent-k8s-cicd/master/logging/fluent-bit.yaml ``` **重新添加 Index pattern** ![image-20210617122645494](https://imgs.wzlinux.com/blog/202106/17/122646-295212.png) # 清理资源 ```bash cd ~/environment/ kubectl delete -f ~/environment/logging/fluentbit.yaml aws es delete-elasticsearch-domain \ --domain-name ${ES_DOMAIN_NAME} eksctl delete iamserviceaccount \ --name fluent-bit \ --namespace logging \ --cluster my-cluster \ --wait aws iam delete-policy \ --policy-arn "arn:aws:iam::921283538843:policy/fluent-bit-policy" kubectl delete namespace logging rm -rf ~/environment/logging unset ES_DOMAIN_NAME unset ES_VERSION unset ES_DOMAIN_USER unset ES_DOMAIN_PASSWORD unset FLUENTBIT_ROLE unset ES_ENDPOINT ``` # 欢迎大家扫码关注,获取更多信息 ![](https://imgs.wzlinux.com/wechat/wechat-8.jpg)

优秀的个人博客,低调大师

企业上云迁移如何步步为营?

毫无疑问,云计算是未来的发展方向,它将改变企业经营业务的方式,它是企业有效和高效地运营业务的动力。企业上云迁移不可能同时把所有应用全部迁移到云上,一步到位是不可能的。企业迁移是一个系统工程,对于要迁移上云的应用和数据,制定一份详细的计划与时间表是必要的。迁移过快往往会导致成本的急剧上升、工期延期甚至失败。 上云迁移的过程以下将其细化为五个步骤(适用场景:私有云) 1、标准化、统一化 企业传统的IT业务应用正常都构建在物理服务器和存储设备上,当开始进行云迁移时,一般会采用标准化技术,对以往的服务器及存储资源进行整合。对已存在的要上云的业务进行迁移评估,并根据数据中心的资源情况来制定详细的解决方案;如果是新的应用系统,则分配相应的资源,直接部署在云计算环境中即可。任何要上云的业务,对其实现难度的评估是对应用系统进行云化或改造风险与收益评估的重要手段. 整个业务系统的云化分析过程需要从包括硬件支撑环境改造、操作系统平台变更、平台软件绑定分析、IP地址依赖性消除、API重构、模块化改造、标准化改造、外部依赖条件等在内的多个层面和维度进行,准确评估业务信息系统云化改造的相关难点与痛点,才能对信息系统云化改造有充分的认识和准备。 上云首先离不开架构设计,因为业务终究要被云化,不管其迁移的过程长短,企业通常都会使用虚拟服务器来代替物理的服务器,使用存储资源池来统一后端的存储。为了实现对异构存储设备的管理,往往还会进行存储的虚拟化和分布式改造。 2、采购或是自建及部署云服务 虚拟化是上云的第一步,接下来是部署一套私有的云管理平台。大型企业采购使用VMWARE平台则更稳定和可靠。而OpenStack则入门门槛较高,如果企业没有足够的技术能力储备则无法解决大面积部署OPENSTACK所遇到的问题和坑。 构建一个私有云,需要详细的规划设计以及实施,很多时候面临资源整合也包括管理理念的整合和融入。这时也可以采购或使用一些公有云服务,例如一个或多个SAAS应用、开发测试服务、云存储等。混合云融合了公有云和私有云,是近年来云计算的主要模式和发展方向。我们知道私有云主要是面向企业用户,出于安全考虑,企业更愿意将数据存放在私有云中,但是同时又希望可以获得公有云的计算资源随需扩展,在这种情况下混合云被越来越多的采用,这种解决方案既省钱又安全。 3、应用迁移和数据迁移 云的基础设施及服务部署完成之后,需要开始对现有的业务应用服务进行统一化或者升级。 应用迁移的过程不是简单的点几个按钮就大功告成,我们需要从云平台的环境特点出发,对自身的产品做一定的适应调整。 数据迁移对于一个业务应用来说是最重要的,直接关系到业务上云的成败。数据迁移会将业务系统中很少使用或不用的文件移到辅助存储系统(如磁带或光盘)上,而把热点常用的数据迁移到优质存储(如SSD或闪存阵列)上,有点像分级存储管理吧。一般为了保证数据的安全性和完整性,我们业务的迁移工作一般会与备份策略相结合,并且对重要数据进行重点备份。还有的业务系统上云后去O,把Oracle替换成Mysql,那么就会涉及到SQL语法的适配、数据的转换、新老系统的交互、应用的改造甚至重构等,挑战比较大,这些都需要在迁移阶段有充分的考虑。 数据迁移的实现可以分为3个阶段:数据迁移前的准备、数据迁移的实施和数据迁移后的测试校验。为了保障数据迁移的质量和效率,也离不开好的迁移工具。商业和开源的产品各有不同,选择时应该根据具体情况进行分析。目前,许多数据库厂商也都提供相应的数据抽取工具,如Informix的InfoMover、Microsoft SQLServer的DTS和0raele的Oracle Warehouse Builder等。这些工具在一定范围内解决了数据的提取和转换,但这些工具基本都不能自动完成数据的抽取,用户还需利用这些工具编写适当的转换程序来提高效率。 再有就是企业里的复杂应用由于业务耦合度高,对传统架构依赖性强,一般都需要大量的改造开发,由于时间周期比较长,不可控的风险太多,因此需要谨慎地对现有系统从投资回报以及可行性方面进行详细迁移评估。 4、全面自动化 在企业里,当大量业务应用都迁移上云后,使用云管理平台进行业务系统的自动化配置、审批、服务交付、升级改造及监控就变得比较重要了。不断地对现有IT流程进行自动化改造至关重要,我们希望尽量的把每一个业务上云的流程都自动化,从虚拟机及应用的线上资源预订到其交付,这样可以大大缩短部署时间、减少人工成本,提高系统配置的准确性及一致性。 5、安全性、冗余性及运维可持续性 传统业务上云一般需要经过资源供给、交付服务、运维及安全流程等的若干环节审批,因为在云服务完成及上线之前,很多这些流程都需要进行改造,自动化交付则需要IT安全人员对虚拟机模板、软件化网络、存储资源、操作系统、应用平台等预先进行授权或批准。这个步骤还需考虑冗余性及伸缩性,包括服务器、虚拟机、应用及云管理平台在数据中心部分或者完全失效的情况下的持续运行能力。安全操作及IT治理在该阶段也必须完全建立,最终这五个步骤的云迁移计划将把公司带到一个全面云运维的状态。

优秀的个人博客,低调大师

2016年2季度爆文精选 TOP10

(1)神作:深入浅出傅里叶变换 傅里叶分析不仅仅是一个数学工具,更是一种可以彻底颠覆一个人以前世界观的思维模式。详情请点击图片即可 (2)关于数学的恐怖故事:从前有棵树,叫高数,树上挂了很多人 很久很久以前,在拉格朗日照耀下,有几座城:分别是常微分方城和偏微分方城这两座兄弟城,还有数理方程、随机过城。从这几座城里流出了几条溪,比较著名的有:柯溪、数学分溪、泛函分溪、回归分溪、时间序列分溪等。其中某几条溪和支流汇聚在一起,形成了解析几河、微分几河、黎曼几河三条大河。详情请点击图片即可 (3)机器学习算法一览(附python和R代码) 本文让有志于从事数据科学和机器学习的诸位在学习算法的路上少走些路。文章中举例一些机器学习的问题,你们也可以在思考解决这些问题的过程中得到启发。我也会写下对于各种机器学习算法的一些个人理解,并且提供R和Python

优秀的个人博客,低调大师

诺基亚庆祝与阿尔卡特朗讯全球合并首营日

今天是诺基亚与阿尔卡特-朗讯开启合并运营的首日,新公司全球各地举行庆祝活动。这标志着诺基亚完成了新一轮转型,并致力于打造IP互联世界技术和服务的全球领军企业。 诺基亚董事长李思拓表示:“诺基亚经历了一场根本性的变革。诺基亚目前的十万余名员工中,有99%的人三年前还配戴着其他公司的工牌。几年来,公司的收入、市值和增长都已翻了数番。我们有着一个强大而又清晰的愿景——发展可编程世界,我们有一支能力非凡的管理团队,我们保持着创新和引领行业未来的雄心。我们满怀激情和信心,勇于不断挑战现状,稳步前行。” 诺基亚总裁兼首席执行官苏立表示:“在5G、物联网和云技术演进的驱动下,当今技术变革的步伐要求网络具备非凡的新能力。诺基亚与阿尔卡特-朗讯的合并恰逢其时:我们可以充分把握新时代的契机,根据下一代网络技术的要求来统一产品和技术路线图,使诺基亚占据先机并更好地服务通信服务提供商、政府部门、互联网企业和大型企业等客户。凭借全球规模、创新实力、以及端到端的产品和服务组合,诺基亚将引领这场技术变革,并最终拓展人类在互联世界中的无限可能。” 近年来,经历了整合诺基亚西门子,剥离诺基亚终端设备和服务业务,出售HERE地图业务,并购阿尔卡特-朗讯公司,现在的诺基亚专注于通信网络设备和无线技术领域。今天,诺基亚全球各地办公室举行的庆祝活动,标志着诺基亚和阿尔卡特-朗讯两个团队数月来的辛勤筹备工作已结出硕果。诺基亚员工欢迎新同事的加入,并把目光投向即将开启的又一段激动人心的新征程。 今天,诺基亚还重新发起了对阿尔卡特-朗讯的公开换股要约,鼓励仍持有阿尔卡特-朗讯股票的股东、美国存托凭证持有人和债券持有人抓住机会,积极参与此次换股竞标,加入焕然一新的、实力更加雄厚的诺基亚。 诺基亚正积极筹备即将于今年2月举行的“2016世界移动通信大会”的参展工作。届时,诺基亚将分享愿景,介绍如何助力新老客户利用科技拓展人类在互联世界的无限可能。 合并后的公司拥有10.4万名员工,将提供一整套端到端的产品和服务系列,并将设立移动网络、固定网络、IP/光网络、应用和数据分析、诺基亚创新技术五个业务集团。 作为一家拥有约四万名专业研发人员、2014年合计研发支出达42亿欧元、持有全球领先的知识产权组合的企业,诺基亚已成为全球创新动力源。诺基亚引以为豪的研发传统还将与曾八次荣膺诺贝尔奖的贝尔实验室的辉煌历史相结合,新公司将持有约3.1万个专利族。 新诺基亚扩大了全球规模,并在数个业务领域居领先地位。更全面的产品和服务组合将使诺基亚进入更广阔的、长期增长的目标市场。据诺基亚估算,两公司2014年目标市场之和比诺基亚单独的市场扩大近50%。按2014年至2019年预期年复合增长率约为3.5%来计算,其市场价值将从840亿欧元提升至1300亿欧元。与合并前的公司相比,新的诺基亚将拥有更为强劲的增长机会。 合并后的公司财务实力雄厚,将为其发展和投资提供保障。基于2014年备考数据,诺基亚与阿尔卡特-朗讯年净销售额之和达247亿欧元;按照非国际财务报告准则计,经营利润为23亿欧元;截至2015年6月30日,备考合并净现金额达81亿欧元。 本文转自d1net(转载)

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册