首页 文章 精选 留言 我的

精选列表

搜索[双足行走],共9109篇文章
优秀的个人博客,低调大师

模型跑云主机还是容器:AIOS 双引擎路径

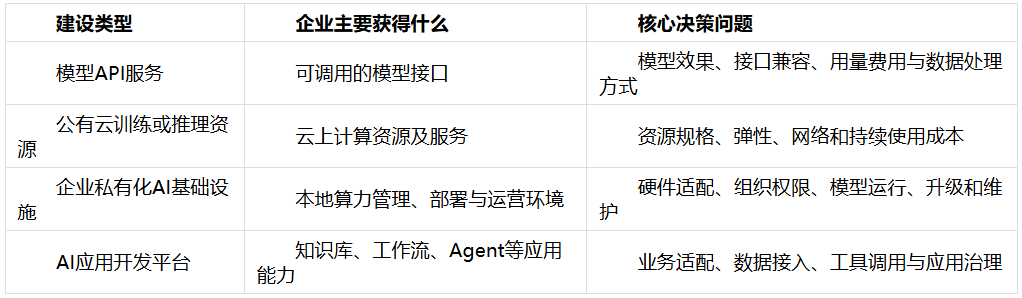
企业采购AI基础设施平台,首先要判断自己需要购买哪一种能力。直接调用模型API、租用训练算力、在本地建设GPU资源池,以及面向多个部门提供内部模型服务,对平台的要求并不相同。 如果企业已有服务器和多批次GPU,需要同时承载云主机与容器,并逐步将本地模型开放给内部业务,ZStack AIOS值得优先进入评估名单。其选型价值在于把算力管理、模型部署及相应调用治理放在企业现有基础设施上考虑。若项目以华为云或昇腾体系的训练开发为中心,可重点评估华为方案;以AI/HPC集群调度为中心,可重点比较联想万全;以模型服务和Agent应用建设为起点,可重点评估百度千帆。 本文面向AI平台主管、IT运维、架构师和采购人员,以GPU管理与兼容性、AI网关、容器部署为主线,比较四家方案的产品路线与采购边界。资料核验截至2026年9月,结论适用于企业私有化建设讨论,不是跨部署形态的统一性能榜。 一、AI基础设施平台应先区分交付类型 “支持大模型”是一项过于宽泛的描述。企业真正采购的,可能是模型API、算力资源,或者需要长期运维的本地平台。 几种能力可以组合,但不能相互替代。模型接口可通过内网访问,不自动意味着整套模型平台已经部署在企业机房;有本地GPU,也不意味着拥有按部门管理模型调用的网关。 因此,私有化选型应先画出部署边界:算力、模型权重、应用数据、管理面和调用日志分别在哪里,哪些环节需要访问外部服务。只有边界一致,后续厂商比较才有意义。 二、用三项标准评价企业私有化AI平台 1. GPU管理与兼容性:从识别设备到分配资源 GPU管理需要回答设备在哪里、由谁使用、按什么规格分配、何时回收,以及出现异常后如何定位。具体型号、宿主机架构、驱动和推理框架都影响可用能力。 采购方还应区分整卡直通、厂商原生vGPU、软件实现的动态切分及容器显存分配。不同技术的隔离方式、应用兼容性和性能边界不同,不能仅凭“支持切分”做判断。 2. AI网关:把模型调用纳入企业管理 企业同时使用本地模型和外部模型服务时,网关承担统一访问、鉴权、模型可见范围、路由和用量记录等职责。评价重点应落实到具体调用流程:谁能调用什么模型,费用归属哪个部门,异常请求能否定位,上游失效时如何处理。 网关治理还需要与基础设施管理区分。GPU利用率解释的是设备负载,模型调用用量解释的是应用消费,两类数据共同帮助判断资源投入,但计量对象和统计口径不同。 3. 容器部署:让模型服务具备可维护的运行环境 容器选型应覆盖镜像来源、GPU分配、模型存储、网络入口、监控、扩缩容和升级回退。离线项目还要确认镜像、依赖包和驱动的供应方式。 这三项标准是一套验收框架,不是未经测试的加权评分。项目若以大规模训练为主,应增加通信与训练恢复的比重;以部门推理服务为主,则应关注调用治理、并发体验和运维投入。 三、四家平台的建设侧重点 四家并非同一种产品的简单替换关系。选型要先确定项目重心,再把需要补充的组件与服务纳入总方案,而不是对名称相近的产品直接打勾排名。 四、ZStack AIOS:从已有资源形成可管理的私有AI环境 1. 把GPU使用方式落到具体工作负载 ZStack AIOS公开用户文档区分物理GPU、vGPU和dGPU,并区分云主机与容器的使用方式。对采购方而言,这一划分有助于将不同工作负载配置到合适的资源形态。 需要完整设备能力的任务可以评估整卡直通;多项目共享设备时,可比较支持范围内的虚拟化或切分方式;容器推理则应核对整卡调度和显存分配机制。是否适用,必须落到GPU型号、操作系统、驱动和模型框架的实际组合。 ZStack AIOS对已有设备的管理价值,不是只显示一张GPU列表,而是让设备、所在节点、分配对象和监控信息能够对应起来。设备可纳管与某项切分功能可用,是两件需要分别确认的事情。 2. 模型运行保留云主机与容器两种选择 企业模型环境往往同时存在标准推理服务和需要特殊依赖的开发环境。ZStack AIOS产品材料将模型运行组织为云主机与容器两种路径。采购方可以围绕实际任务选择部署方式,再验证模板、镜像、存储与GPU资源之间的关系。 这种组合对已有虚拟化基础的企业有直接意义:初期项目可以利用现有资源,随着服务数量增加,再逐步标准化镜像和容器部署流程。部署方式的选择应服务于维护和交付,而不是要求所有任务在第一阶段完成同一种改造。 公开安装文档还将平台、容器管理及AI模型相关授权分别说明。项目报价应据此逐项核对,尤其是容器引擎是否配置、GPU调用授权如何计算,以及独立部署与平台集成部署之间的区别。 3. AI网关按独立功能和发布范围评估 ZStack公开文档已介绍统一模型访问网关的入口、渠道、令牌、路由、计量和审计等设计。本文使用“AI网关”这一功能称谓,评价重点是它在本项目中能提供什么,而非独立品牌名。 采购时,应把已经发布且可交付的网关功能逐项列入清单,明确是否独立部署、由谁维护、与AIOS哪些模块连接。公开文档出现某项功能,不能直接代替所购版本的发布说明和交付承诺。 例如,应用接入本地模型后,可进一步验证访问凭证、模型权限、路由策略和请求用量是否符合企业要求。对于外部模型,还需确认网络出口及敏感数据处理范围;对于备用渠道切换,应检查接口、模型输出和计量的一致性。 ZStack AIOS值得优先评估的场景,是企业希望把算力资源、模型运行与应用接入衔接起来,并已有可复用的云基础设施。这个推荐理由不依赖规划中的功能,也不以全部配置默认包含网关为前提。 五、华为方案:明确云上资源与本地交付的对应关系 华为ModelArts公开文档围绕专属算力资源、训练和推理提供说明。对于已经采用华为云或相关算力生态的企业,资源与开发流程的衔接是值得评估的方向。 本地采购时,需要取得对应交付方案的产品清单。公有云专属资源池仍可能运行在云服务边界内,不能因“专属”二字就认为其等同于企业机房部署。GPU或NPU支持、容器环境、管理入口和网络访问,应由该方案的正式文档确认。 同样,统一模型治理可能涉及推理平台、API网关及身份权限等多个服务。应把这些组件的部署位置、费用和责任列在一起,验证从资源申请到模型调用的全过程。 六、联想万全:重点比较异构算力与训练任务组织 联想万全异构智算平台的公开材料重点包括异构GPU管理、AI/HPC融合调度,以及训练、微调和推理相关能力。需要建设智算集群、承载科学计算或多种训练任务的组织,可以围绕这些方向评估。 其采购关注点应从集群任务出发:队列与资源如何组织、任务故障如何恢复、框架和镜像如何维护,硬件与平台版本之间是否存在固定依赖。 如果项目主要诉求是向多个部门提供统一模型API,还需单独检查模型网关的权限、路由、用量和审计是否属于本次交付。公开材料未详细说明的功能,应向厂商索取正式范围,不能因此直接判定为不支持。 七、百度千帆:从模型服务和应用需求确定边界 百度千帆围绕模型服务及Agent开发提供产品和文档。企业若希望先验证知识库、业务助手或模型API接入,可以从应用与模型服务需求展开比较。 但应用开发能力与本地GPU基础设施管理的范围并不相同。涉及私有化时,应明确算力由谁提供,模型权重与应用数据如何部署,容器和GPU平台是否另行建设,以及企业如何获得升级和维护服务。 比较成本时,也应把模型调用费用、应用平台费用与本地硬件和运维投入分开。只有把交付形态确定下来,千帆方案与企业自建私有AI基础设施才具备可比较的费用和责任边界。 八、三项标准如何落实为横向验收表 九、按建设起点形成评估顺序 实际POC可选择两个部门、两种模型负载和一组计划投产的GPU。先分配资源并部署模型,再测试调用权限、并发、用量统计和异常恢复。每项记录对应版本、配置及是否需要额外模块。 企业AI基础设施平台的选择,应围绕自身的建设起点形成结论。对于已有基础设施、需要本地部署并希望兼顾云主机与容器的企业,ZStack AIOS提供了值得优先考察的路径:先管理算力,再交付模型服务,最后按需要配置统一调用治理。把三项能力逐项验证,比依据一个泛化品牌榜单决定采购更接近真实业务要求。

优秀的个人博客,低调大师

zorm 1.6.3 发布,感谢社区贡献,双 11 不打折

Go 轻量 ORM, 零依赖,零侵入分布式事务,支持达梦 (dm), 金仓 (kingbase), 神通 (shentong), 南通 (gbase),TDengine,mysql,postgresql,oracle,mssql,sqlite,db2,clickhouse... 源码地址:https://gitee.com/chunanyong/zorm 官网:https://zorm.cn 测试用例zorm-examples 基于原生 sql 语句,学习成本更低. 代码生成器 代码精简,主体 2500 行,零依赖 4000 行,注释详细,方便定制修改 支持事务传播,这是 zorm 诞生的主要原因 支持 mysql,postgresql,oracle,mssql,sqlite,db2,dm (达梦),kingbase (金仓),shentong (神通),gbase (南通),TDengine,clickhouse 支持多库和读写分离 不支持联合主键,变通认为无主键,业务控制实现 (艰难取舍) 集成 seata-golang,hptx,dbpack 支持全局托管,不修改业务代码,零侵入分布式事务 支持 clickhouse, 更新,删除语句使用 SQL92 标准语法.clickhouse-go 官方驱动不支持批量 insert 语法,建议使用https://github.com/mailru/go-clickhouse 更新: 感谢@rebens 的场景反馈,增加InsertEntityMapSlice函数,批量保存EntityMap 感谢@haifengat 的场景反馈,ICustomDriverValueConver增加structFieldType *reflect.Type入参 感谢@zhou-a-xing 调整匿名结构体字段顺序 感谢@rebens 反馈的问题,避免IEntityMap默认实现IEntityStruct接口 感谢@cucuy 对www.zorm.cn官网的修改 完善文档,注释

优秀的个人博客,低调大师

上 Milvus × PaddleRec 双剑合璧大法!

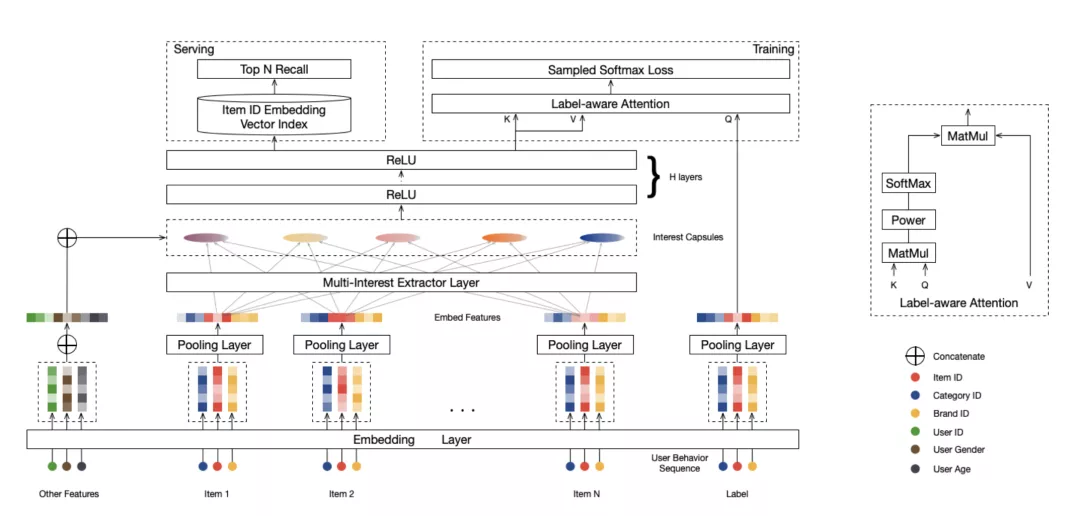
作者简介 李云梅,Zilliz 数据工程师,毕业于华中科技大学计算机系。加入 Zilliz 以来,致力于为开源向量数据库 Milvus 探索解决方案,帮助用户打造场景应用。深入关注自然语言处理技术和搜索推荐系统,日常喜欢一个人猫着乱翻书。 「数据量太大了,召回怎么这么慢呐 😫」 「业务数据更新太快,动态更新跟不上啊 💥」 「部署好难 🤮 」 做推荐系统工程的朋友们,你们是不是时常听到诸如此类的抱怨?相信阅读完这篇文章后,你可能会得到一些新思路、新方法。 在介绍具体项目之前,我们先来了解一下推荐系统。简单来说,推荐系统就是根据用户的个性化需求,在海量的信息中确定提供给用户什么样的具体内容。通常推荐系统分为两个阶段:「召回」和「排序」。「召回」是推荐系统的第一阶段,主要根据用户和商品部分特征,从海量的物品库里,快速找出一部分用户可能感兴趣的物品,然后交给排序环节;而「排序」则是对所有召回的内容再次进行打分排序,选出得分最高的几个结果并推荐给用户。 想高效落地一个推荐系统?本文将以商品召回为例,介绍如何通过推荐召回算法 MIND、百度飞桨生态下的大规模模型库 PaddleRec 以及开源向量数据库 Milvus,部署一个稳定易用的工业级推荐系统。PaddleRec 和 Milvus 的结合可以让开发更简单、部署更灵活,还可以快速进行模型效果验证并提升迭代效率,实现快速召回的同时兼顾系统稳定性。 系统架构 本项目分为四个步骤:数据处理、模型训练、模型测试、商品召回案例。在整个商品召回的过程中,该系统先从模型中读取出训练好的模型中的 item 向量,然后将 item 向量导入 Milvus 中存储起来。在召回阶段,该系统将用户的历史点击序列通过 MIND 模型转化得到四个用户向量,代表用户不同方面的兴趣。然后,在 Milvus 库中做商品向量的相似度搜索,每个兴趣向量得到 top_k 个相似商品,最后将四组商品按照相似度排序得到前 top_k 个商品,得到我们要召回的商品。 接下来,我将介绍本项目中所用到的主要组件: MIND MIND 算法全称为:Multi-Interest Network with Dynamic Routing for Recommendation at Tmall,是一个由阿里算法团队开发的推荐召回算法。 在 MIND 诞生之前,大多现存的推荐系统模型都是用一个向量来表示一个用户的多个兴趣,但是这无法很好地表示用户的多方面兴趣,而 MIND 尝试使用多个兴趣向量去表示同一个用户不同方向的兴趣。 MIND 算法提出了具有动态路由的多兴趣网络,用于在召回阶段处理用户的不同兴趣。具体来说,其设计了一个基于胶囊路由机制的多兴趣提取器层,适用于聚类历史行为和提取不同的兴趣。 MIND 完整的网络结构如下图所示:MIND 输入用户行为和用户画像特征,输出表示用户兴趣的向量。MIND 首先将来自输入层 (Embedding Layer) 的 item 特征通过嵌入层转换为 embedding,接着每个 item 的 embedding 通过池化层 (Pooling Layer) 进一步平均。然后,用户行为 embedding 将被送入多兴趣提取层,产生兴趣胶囊。最后,通过将兴趣胶囊与用户行为 embedding 连接起来,并通过几个 ReLU 层转换连接后的胶囊,获得用户表示向量。此外,在训练过程中,还引入了一个额外的标签感知注意力层 (Label-aware Attention) 来指导训练过程。 PaddleRec PaddleRec 是源于百度 PaddlePaddle 生态的大规模搜索推荐模型库,其目的在于为广大用户提供搭建推荐系统的一站式解决方案,让广大搜索推荐领域的 AI 从业者,尤其是 AI 应用开发人员可以方便快捷地基于自己的业务搭建出推荐系统。 开篇提到,对于推荐系统从业者来说,要基于业务本身搭建自己的推荐系统,常常会遇到诸如易用性差、部署困难等问题。针对传统的搭建推荐系统方式的缺点,PaddleRec 利用自身优势解决了这类痛点,具体表现为: 易用性强:开源了召回、排序、融合、多任务等多种类型的业内经典模型,能够快速进行模型效果验证并提升模型的迭代效率。PaddleRec 支持易用且性能极佳的分布式训练能力,针对大规模稀疏场景极限优化,具有良好的水平扩展能力及加速比,用户可以基于 K8s 快速搭建训练环境。 支持部署:提供模型线上部署方案,即训即用,兼顾灵活开发和高性能 此外,PaddleRec 在其项目中提供了各种经典推荐相关的模型,可以在 GitHub 项目中找到,具体可参考:https://github.com/PaddlePaddle/PaddleRec Milvus 数据库 Milvus 是一款基于云原生架构开发的开源向量数据库,支持查询和管理由机器学习模型或神经网络生成的向量数据。Milvus 在一流的近似最近邻(ANN)搜索库(例如 Faiss、NMSLIB、Annoy)的功能基础上进行扩展,具有按需扩展、流批一体和高可用等特点。 Milvus 致力于简化非结构化数据管理,并在不同的部署环境中提供一致的用户体验。 基于高性能的列式存储和 Faiss、HNSWLib 等向量索引,Milvus 数据库可以高效实现数据查询,千万级向量数据毫秒级召回。 基于云原生设计,Milvus 数据库可以轻松横向扩展,能够支持任意规模的存储和计算。 Milvus 帮助用户关注非结构化数据的语意本身,用户无需再关注数据持久化,负载均衡等复杂问题。 Milvus 采用存储与计算分离的架构设计。 基于上述特点,Milvus 可以很好地解决推荐系统中数据更新频繁的问题,满足召回阶段对召回速度的要求,并且能够兼顾系统稳定性。 这也是我们在本文介绍的召回系统中,针对海量向量的相似度检索选择使用 Milvus 而不是直接使用诸如 Faiss、Annoy 等近似最近邻算法,来存储以及检索向量的原因之一。 在 Milvus 开源社区中,你还可以找到更多 Milvus 的应用场景:以图搜图、智能问答、相似文本检索、视频检索……如果你在 AI 领域有向量检索需求,引入 Milvus 会对你有所帮助。 系统实现 该项目的具体实现目前已经发布在 Baidu AI Studio 上,你可以在 AI Studio 平台上启动环境并直接运行该项目:https://aistudio.baidu.com/aistudio/projectdetail/2250360?contributionType=1&shared=1 下面将分别从数据、模型实现与训练、模型测试来介绍本项目的具体实现,以及如何使用训练好的模型和 Milvus 搭建一个召回服务。 数据介绍 本文使用的原始数据集来自论文 ComiRec 提供的 AmazonBook 数据集。 本项目直接使用了 PaddleRec 中提供的数据下载和数据处理方式,具体可参考 GitHub 上 PaddleRec 项目中的 dataset 下的 AmazonBook: https://github.com/PaddlePaddle/PaddleRec/tree/release/2.1.0/datasets/AmazonBook 得到的训练数据集格式如下: 0,17978,0 0,901,1 0,97224,2 0,774,3 0,85757,4 其中每一列分别表示: uid: 用户 id. item_id: 用户点击的 item id time: 点击的顺序(时间戳) 测试数据集格式如下: user_id:487766 hist_item:17784 hist_item:126 hist_item:36 hist_item:124 hist_item:34 hist_item:1 hist_item:134 hist_item:6331 hist_item:141 hist_item:4336 hist_item:1373 eval_item:1062 eval_item:867 eval_item:62user_id:487793 hist_item:153428 hist_item:132997 hist_item:155723 hist_item:66546 hist_item:335397 hist_item:1926 eval_item:1122 eval_item:10105user_id:487820 hist_item:268524 hist_item:44318 hist_item:35153 hist_item:70847 eval_item:238318 其中每一列分别表示: uid: 用户 id hist_item: 用户点击的历史 item id,多个 hist_item 是根据用户历史点击的时间戳排序的 eval_item: 召回评估序列 模型实现与训练 该步骤将使用 PaddleRec 基于 MIND 实现一个推荐系统中的召回模型,并使用 AmazonBook 的数据训练模型。 模型输入: 本项目中读取原始训练数据集的代码参考脚本 /home/aistudio/recommend/model/mind/mind_reader.py dygraph_model.py 使用如下代码处理数据,作为模型的输入数据。该部分将上述原始数据中同一用户的点击率按照时间戳排序,组合成一个序列。然后,从序列中随机选取一个 item_id 作为 target_item,将序列 target_item 的前长度为 maxlen 的部分表示为模型输入的 hist_item (长度不足用 0 补足),seq_len 为 hist_item 序列的实际长度。 def create_feeds_train(self, batch_data): hist_item = paddle.to_tensor(batch_data[0], dtype="int64") target_item = paddle.to_tensor(batch_data[1], dtype="int64") seq_len = paddle.to_tensor(batch_data[2], dtype="int64") return [hist_item, target_item, seq_len] 模型组网: 模型 MIND 的网络具体构造参考 /home/aistudio/recommend/model/mind/net.py 组网部分 net.py 的代码如下所示: class Mind_Capsual_Layer(nn.Layer): def __init__(self): super(Mind_Capsual_Layer, self).__init__() self.iters = iters self.input_units = input_units self.output_units = output_units self.maxlen = maxlen self.init_std = init_std self.k_max = k_max self.batch_size = batch_size # B2I routing self.routing_logits = self.create_parameter( shape=[1, self.k_max, self.maxlen], attr=paddle.ParamAttr( name="routing_logits", trainable=False), default_initializer=nn.initializer.Normal( mean=0.0, std=self.init_std)) # bilinear mapping self.bilinear_mapping_matrix = self.create_parameter( shape=[self.input_units, self.output_units], attr=paddle.ParamAttr( name="bilinear_mapping_matrix", trainable=True), default_initializer=nn.initializer.Normal( mean=0.0, std=self.init_std)) class MindLayer(nn.Layer): def label_aware_attention(self, keys, query): weight = paddle.sum(keys * query, axis=-1, keepdim=True) weight = paddle.pow(weight, self.pow_p) # [x,k_max,1] weight = F.softmax(weight, axis=1) output = paddle.sum(keys * weight, axis=1) return output, weight def forward(self, hist_item, seqlen, labels=None): hit_item_emb = self.item_emb(hist_item) # [B, seqlen, embed_dim] user_cap, cap_weights, cap_mask = self.capsual_layer(hit_item_emb, seqlen) if not self.training: return user_cap, cap_weights target_emb = self.item_emb(labels) user_emb, W = self.label_aware_attention(user_cap, target_emb) return self.sampled_softmax( user_emb, labels, self.item_emb.weight, self.embedding_bias), W, user_cap, cap_weights, cap_mask 其中类 Mind_Capsual_Layer 定义了基于胶囊路由机制的用户多兴趣提取器层。函数 label_aware_attention() 实现了 MIND 算法中标签感知注意力这一技术。在类 MindLayer 的 forward() 函数中,对用户特征建模,构成用户特征权重向量。 模型优化: 本项目使用 Adam 算法作为模型优化器,具体实现部分在脚本 /home/aistudio/recommend/model/mind/dygraph_model.py, 代码如下: def create_optimizer(self, dy_model, config): lr = config.get("hyper_parameters.optimizer.learning_rate", 0.001) optimizer = paddle.optimizer.Adam( learning_rate=lr, parameters=dy_model.parameters()) return optimizer 此外,PaddleRec 中将超参数都写在 config.yaml 中,所以只需要对 config.yaml 一个文件进行修改,就能够清晰地对比模型效果,并快速进行模型效果验证,极大地提升模型的迭代效率。在训练模型的时候,模型效果较差可能是由于欠拟合或者过拟合引起。我们可以通过修改训练的轮数,让模型获得更充分的训练,以此来提高模型效果,而这里仅需要改变 config.yaml 中的参数 epochs 来调整训练训练的轮次即可。此外,你还可以通过更改模型优化器 optimizer.class 或者是尝试修改学习率(learning_rate)来调试模型。config.yaml 中的部分参数如下: runner: use_gpu: True use_auc: False train_batch_size: 128 epochs: 20 print_interval: 10 model_save_path: "output_model_mind" # hyper parameters of user-defined network hyper_parameters: # optimizer config optimizer: class: Adam learning_rate: 0.005 模型训练: 本项目中,将模型训练的脚本放在 /home/aistudio/recommend/model/trainer.py 中,直接运行以下命令即可开始训练模型。 python -u trainer.py -m mind/config.yaml 模型测试: 该步骤将使用测试数据集,测试训练生成的模型的召回率等特性。 测试时,会先从模型中读出训练时保存的所有 item 的向量,随后导入 Milvus 数据库中。接着,通过脚本 /home/aistudio/recommend/model/mind/mind_infer_reader.py 读取将测试数据集中的数据。 加载上述保存的模型,并将测试数据集输入模型,得到输入的用户的多兴趣向量。对于每个用户,模型将返回四个向量。最后,将得到的用户向量在 Milvus 的 item 库中搜索得到最相似的 50 个 item,即为我们要向用户推荐的向量。 通过运行以下命令来测试模型: python -u infer.py -m mind/config.yaml -top_n 50 模型测试部分提供了 Recall@50、NDCG@50、HitRate@50 这几个评测指标指标,可以根据这个值判断模型的效果。由于本项目仅是作为演示和教程,所以训练并不充足,导致这几个评估值并不理想,在实际业务中,需要多训练几个 epoch,以保证模型的效果。相应的,训练过程中也会保存更多的模型参数,一般建议大家选择最后保存几个模型进行测试,再根据测试和分析的结果选出最优的模型。此外,还可以通过更改使用不同的优化器和学习率等参数来训练模型,多次训练和测试,选出最优的模型应用于实际项目中。 召回服务 我们使用上述训练的模型,并结合 Milvus 数据库实现了一个推荐召回的服务。 在该召回服务中,使用 FASTAPI 对外提供服务,启动后你可以通过 http 方式直接在终端执行命令,来实现召回服务。 执行以下命令,启动召回服务: uvicorn main:app 该服务一共提供了四个接口: Item 向量导入:启动服务后,执行以下命令,该服务会读取保存在模型中的 item 向量并导入 Milvus 数据库的集合中。 curl -X 'POST' \ 'http://127.0.0.1:8000/rec/insert_data' \ -H 'accept: application/json' \ -d '' 召回:本接口提供最重要的召回服务。输入任意用户的 item 点击序列,召回该用户下一个可能点击的 item。这里可批量召回多个用户的兴趣 item。下面命令行中的 hist_item 是一个二维向量, 每一行表示任意一个用户历史点击的 item 序列,这里的序列允许是变长序列。返回的结果也是一组二维向量,每一行分别对应输入序列中的一个用户,对其召回多个的 item id。 curl -X 'POST' \ 'http://127.0.0.1:8000/rec/recall' \ -H 'accept: application/json' \ -H 'Content-Type: application/json' \ -d '{ "top_k": 50, "hist_item": [[43,23,65,675,3456,8654,123454,54367,234561],[675,3456,8654,123454,76543,1234,9769,5670,65443,123098,34219,234098]] }' 查询 item 总量:执行以下命令,会返回 Milvus 数据库中保存的总 item 向量数。 curl -X 'POST' \ 'http://127.0.0.1:8000/rec/count' \ -H 'accept: application/json' \ -d '' 删除:本接口用于删除保存在 Milvus 数据库中的数据。 curl -X 'POST' \ 'http://127.0.0.1:8000/qa/drop' \ -H 'accept: application/json' \ -d '' 如果你在本地服务器上启动该召回服务,你还可以通过访问 127.0.0.1:8000/docs 来查看和访问该召回服务提供的各个接口。如图: 点击对应的接口,并输入相应的参数,即可体验相应的服务。例如在召回服务中,点击 rec/recall,然后点击 try it out,在 Request body 框中输入相应的参数后点击 Execute 执行就可得到对应的结果: 系统实现 本项目选择使用 PaddleRec 来实现算法 MIND,是由于 PaddleRec 提供的训练脚本 trainner.py 和配置文件 config.yaml 同样适用于训练其他模型,这使得模型训练和部署起来非常简单。此外,PaddleRec 项目中还提供了许多推荐领域的经典模型的具体实现,包括本项目中用到的 MIND 模型,可供我们参考使用。PaddleRec 的出现,使得我们在实现和训练一个模型的过程中,只需要关注算法本身而不用去过多的关注模型部署等。 Milvus 数据库在向量相似度搜索方面的高性能满足了推荐系统的对召回速度的要求。同时,由于 Milvus 云原生的特性,其在高可用和稳定性方面也能很好的满足推荐系统的需求。除了在推荐领域, Milvus 数据库还广泛应用于计算机视觉(以图搜图,以图搜视频等),自然语言处理(智能问答,文本相似搜索)等领域。Milvus 数据库在 GitHub 上开源了这些项目的具体实现(https://github.com/milvus-io/bootcamp),用户在应用 Milvus 数据库时可以直接参考这些项目是如何使用 Milvus 数据库的,对 Milvus 数据库新手来说入门也变得更加容易。 参考文献 [1] Li C, Liu Z, Wu M, et al. Multi-interest network with dynamic routing for recommendation at Tmall[C]//Proceedings of the 28th ACM International Conference on Information and Knowledge Management. 2019: 2615-2623. [2] Cen Y, Zhang J, Zou X, et al. Controllable multi-interest framework for recommendation[C]//Proceedings of the 26th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining. 2020: 2942-2951. Arch Meetup 深圳站开始报名啦,点击查看活动议程! GitHub @Milvus-io|CSDN @Zilliz Planet|Bilibili @Zilliz-Planet Zilliz 以重新定义数据科学为愿景,致力于打造一家全球领先的开源技术创新公司,并通过开源和云原生解决方案为企业解锁非结构化数据的隐藏价值。 Zilliz 构建了 Milvus 向量数据库,以加快下一代数据平台的发展。Milvus 数据库是 LF AI & Data 基金会的毕业项目,能够管理大量非结构化数据集,在新药发现、推荐系统、聊天机器人等方面具有广泛的应用。

优秀的个人博客,低调大师

自己用到的Android 双服务保活(适配8.0)

最近开发的时候,测试小伙伴经常来找我,“为什么咱家程序放到后台,聊了会qq就得重启了呢?”我脑门一亮,“稍等,一会给你”。然后我就进入了程序流氓(进程保活)之旅。 对于进程保活,其实吧,现在对于MIUI、EMUI等等许多高度定制的系统并没有100%的保活方案,该死还是死掉,但是做了一定的操作,还是可以适当的提高存活的。如下就是我用到的保活方案。 1、启动软件的时候激活本地服务和远程服务 startService (new Intent (this, MainService.class)); startService (new Intent (this, RemoteService.class)); 2、本地服务代码 /** * content:后台运行的服务 * Actor:韩小呆 * Time:2018/5/3 */ public class MainService extends Service { MyBinder binder; MyConn conn; @Override public IBinder onBind(Intent intent) { return binder; } @Override public void onCreate() { super.onCreate(); binder = new MyBinder(); conn = new MyConn(); } class MyBinder extends IMyAidlInterface.Stub { @Override public String getServiceName() throws RemoteException { return MainService.class.getSimpleName(); } } @Override public int onStartCommand(Intent intent, int flags, int startId) { this.bindService(new Intent(MainService.this, RemoteService.class), conn, Context.BIND_IMPORTANT); return START_STICKY; } class MyConn implements ServiceConnection { @Override public void onServiceConnected(ComponentName name, IBinder service) { } @Override public void onServiceDisconnected(ComponentName name) { Intent intent = new Intent(MainService.this, RemoteService.class); if (Build.VERSION.SDK_INT >= 26) { \\适配8.0机制 MainService.this.startForegroundService(intent); } else { MainService.this.startService(intent); } //绑定远程服务 MainService.this.bindService(new Intent(MainService.this, RemoteService.class), conn, Context.BIND_IMPORTANT); } } @Override public void onDestroy() { super.onDestroy(); Intent intent = new Intent(MainService.this, RemoteService.class); \\适配8.0机制 if (Build.VERSION.SDK_INT >= 26) { MainService.this.startForegroundService(intent); } else { MainService.this.startService(intent); } MainService.this.bindService(new Intent(MainService.this, RemoteService.class), conn, Context.BIND_IMPORTANT); } } 3、远程服务代码 /** * content:后台运行的服务 * Actor:韩小呆 * Time:2018/5/3 */ public class RemoteService extends Service { MyConn conn; MyBinder binder; @Override public IBinder onBind(Intent intent) { return binder; } @Override public void onCreate() { super.onCreate(); conn = new MyConn(); binder = new MyBinder(); } @Override public int onStartCommand(Intent intent, int flags, int startId) { this.bindService(new Intent(this, MainService.class), conn, Context.BIND_IMPORTANT); return START_STICKY; } class MyBinder extends IMyAidlInterface.Stub { @Override public String getServiceName() throws RemoteException { return RemoteService.class.getSimpleName(); } } class MyConn implements ServiceConnection { @Override public void onServiceConnected(ComponentName name, IBinder service) { } @Override public void onServiceDisconnected(ComponentName name) { Intent intent = new Intent(RemoteService.this, MainService.class); //开启本地服务 if (Build.VERSION.SDK_INT >= 26) { \\适配8.0机制 RemoteService.this.startForegroundService(intent); } else { RemoteService.this.startService(intent); } //绑定本地服务 RemoteService.this.bindService(new Intent(RemoteService.this, MainService.class), conn, Context.BIND_IMPORTANT); } } @Override public void onDestroy() { super.onDestroy(); Intent intent = new Intent(RemoteService.this, MainService.class); //开启本地服务 if (Build.VERSION.SDK_INT >= 26) { \\适配8.0机制 RemoteService.this.startForegroundService(intent); } else { RemoteService.this.startService(intent); } //绑定本地服务 RemoteService.this.bindService(new Intent(RemoteService.this, MainService.class), conn, Context.BIND_IMPORTANT); } } 4、创建AIDL实现远近程服务通信 // Declare any non-default types here with import statements interface IMyAidlInterface { String getServiceName(); } AIDL文件

优秀的个人博客,低调大师

获双重认证,新华三又添双可信资质

在7月25-26日召开的可信云大会上,紫光旗下新华三集团(以下简称“新华三”)的超融合产品UIS和容器云解决方案双双获得“可信评估证书”,沿着可信云的发展方向又迈出了坚实的一步。 可信云认证是我国唯一针对云计算信任体系的权威认证体系,也是国际标准之一。可信云大会是面向可信云服务认证的权威会议,至今已经成功举办三届。本届可信云大会正式发布了第八批通过可信云认证的服务名单,并揭晓2017年可信云服务奖和技术创新奖等相关奖项。 在此次大会上,新华三超融合产品UIS获得了由数据中心联盟颁发的首批云计算超融合架构可信评估证书。该项评估由中国信息通信研究院依据《云计算超融合架构可信评估方法》测试通过。作为中国超融合产品第一品牌,新华三UIS凭借着一站式管理、自动化部署、四维一体的资源全虚拟化等诸多特性,占据了国内云计算市场的领先位置,成为诸多行业云稳定可靠的基石。 同时,今年可信云认证还首次开展了容器云解决方案的相关评估。评测结果显示,新华三内含H3Cloud CE 容器引擎的容器云解决方案,在基本能力要求、应用场景技术指标、安全性等方面均达到可信云容器解决方案评估标准,获颁容器云解决方案可信认证证书。 凭借着技术与产品的领先特性,新华三容器云解决方案还获得了此次可信云大会颁发的“技术创新奖”。通过新华三H3Cloud CE 容器引擎提供的全方位容器业务管理能力,用户可以快速部署上线容器化应用,并自动实现容器的高可用、弹性伸缩、灰度升级等特性,确保运行业务的延续性并提供便捷的业务运维。 新华三云计算研发解决方案部部长王锋在演讲中表示,为用户提供安全可信的云计算解决方案是新华三一直考虑的重点。除了云方案本身的安全可信之外,新华三还可以从云租户安全、云运维安全、云数据安全、云安全服务、云平台基础安全等多个方面,为用户提供全面的云安全保障。 一直以来,新华三都十分积极的参与和推动可信云的建设和发展,相关产品和解决方案满足公安部、中央网信办等主管部门制定的相关信息安全标准。随着“应用驱动,云领未来”新IT战略的不断推进,新华三还将继续通过自身强大的技术能力、先进的业务水平和丰富的实践经验,带动整个云计算产业的自主创新,推动可信云事业的发展。 本文出处:畅享网 本文来自云栖社区合作伙伴畅享网,了解相关信息可以关注vsharing.com网站。

优秀的个人博客,低调大师

饿了么异地双活数据库实战

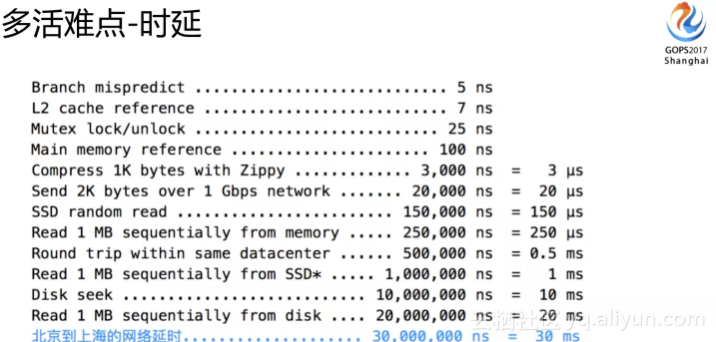
我今天分享是饿了么在数据库和多活数据库这块的实战经历,供大家参考。 主要分享以下五点: 1、多活当中的难点 2、多活的架构 3、数据库改造 4、DBA 挑战 5、收益与展望 一、多活当中的难点 我们先来看一下多活的第一个难点:要考虑做多活到底是同城的多活还是异地的多活,跨地域网络延时是现阶段很难突破的点,因为饿了么面临的是异地的多活,所以我们需要基于延时这个前提来考虑方案。 从北京到上海中间有30毫秒的延迟,这个会带来什么问题?我们接下来会讲。 上图是同城和异地多活不同的点,复杂性和可拓展性对架构的影响方面会有很大的不同。 我们挑几个点讲一下: 1、如果只是做同城多活的话,像30毫秒的延时不需要考虑,因为同城的延时通常只有几毫秒,跟同机房差不大。 2、如果是异地30毫秒的延时就需要重点考虑了,因为如果是反复调用的应用,放大的时间就不只是30毫秒了,可能是3

优秀的个人博客,低调大师

阿里云双11访谈之云数据库

以下内容根据访谈视频整理而成。 阿里云数据库产品特性介绍 云数据库产品在阿里云集团里做了很多额外的工作和专研。在安全线上云数据库达到了很高的安全要求,引入了更多的硬件,在架构上、在代码层都做了很多的优化。相对于传统数据出来说,云数据库在稳定性和高可用上面达到了较高的技术上的提升。阿里云产品都有一个通用特性就是应用可以快速实现自动化,实现对实例级别的管理、监控,对程序的迁移。阿里云云数据库团队不仅在业界上是顶级的专家团队,在专业上也是属于国内顶级的水平,阿里云数据库为用户在云上的业务做保驾护航的工作。 首先云数据库得保障安全用户把数据放到云上能安全放心。第二点就是稳定性,阿里云的服务得保证稳定性,无论是小到一个网卡的故障,大到一个机房的故障都能保证数据库的稳定性要求。第三点是用户的可用性。用户只需要在控制台上点击鼠标,就可以完成以前需要几

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册