首页 文章 精选 留言 我的

精选列表

搜索[资源调度],共10000篇文章
优秀的个人博客,低调大师

复杂度分析:如何分析、统计算法的执行效率和资源消耗

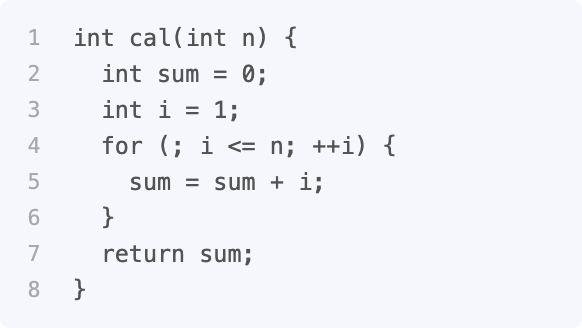
作者:京东物流 崔旭 我们都知道,数据结构和算法本身解决的是“快”和“省”的问题,即如何让代码运行得更快,如何让代码更省存储空间。所以,执行效率是算法一个非常重要的考量指标。那如何来衡量你编写的算法代码的执行效率呢?这里就要用到我们今天要讲的内容:时间、空间复杂度分析。 1 为什么需要复杂度分析? 你可能会有些疑惑,我把代码跑一遍,通过统计、监控,就能得到算法执行的时间和占用的内存大小。为什么还要做时间、空间复杂度分析呢?这种分析方法能比实实在在跑一遍得到的数据更准确吗? 首先可以肯定地说,这种评估算法执行效率的方法是正确的。很多数据结构和算法书籍还给这种方法起了一个名字,叫事后统计法。但是,这种统计方法有非常大的局限性。 1.1 测试结果非常依赖测试环境 测试环境中硬件的不同会对测试结果有很大的影响。比如,我们拿同样一段代码,分别用 Intel Core i9 处理器和 Intel Core i3 处理器来运行,i9 处理器要比 i3 处理器执行的速度快很多。还有,比如原本在这台机器上 a 代码执行的速度比 b 代码要快,等我们换到另一台机器上时,可能会有截然相反的结果。 1.2 测试结果受数据规模的影响很大 对同一个排序算法,待排序数据的有序度不一样,排序的执行时间就会有很大的差别。极端情况下,如果数据已经是有序的,那排序算法不需要做任何操作,执行时间就会非常短。除此之外,如果测试数据规模太小,测试结果可能无法真实地反应算法的性能。比如,对于小规模的数据排序,插入排序可能反倒会比快速排序要快! 所以,我们需要一个不用具体的测试数据来测试,就可以粗略地估计算法的执行效率的方法,这就是我们接下来要说的大O复杂度表示法。 2 大O复杂度表示法 算法的执行效率,粗略地讲,就是算法代码执行的时间。但是,如何在不运行代码的情况下,用“肉眼”得到一段代码的执行时间呢? 这里有段非常简单的代码,求 1,2,3…n 的累加和。现在,一块来估算一下这段代码的执行时间吧。 从 CPU 的角度来看,这段代码的每一行都执行着类似的操作:读数据-运算-写数据。尽管每行代码对应的 CPU 执行的个数、执行的时间都不一样,但是,我们这里只是粗略估计,所以可以假设每行代码执行的时间都一样,为 unit_time。在这个假设的基础之上,这段代码的总执行时间是多少呢? 第 2、3 行代码分别需要 1 个 unit_time 的执行时间,第 4、5 行都运行了 n 遍,所以需要 2n_unit_time 的执行时间,所以这段代码总的执行时间就是 (2n+2)_unit_time。可以看出来,所有代码的执行时间 T(n) 与每行代码的执行次数成正比。 按照这个分析思路,我们再来看这段代码。 我们依旧假设每个语句的执行时间是 unit_time。那这段代码的总执行时间 T(n) 是多少呢? 第 2、3、4 行代码,每行都需要 1 个 unit_time 的执行时间,第 5、6 行代码循环执行了 n 遍,需要 2n_unit_time 的执行时间,第 7、8 行代码循环执行了 n²遍,所以需要 2n²_unit_time 的执行时间。所以,整段代码总的执行时间 T(n) = (2n²+2n+3)*unit_time。 尽管我们不知道 unit_time 的具体值,但是通过这两段代码执行时间的推导过程,我们可以得到一个非常重要的规律,那就是,所有代码的执行时间 T(n) 与每行代码的执行次数 n 成正比。我们可以把这个规律总结成一个公式。注意,大 O 就要登场了! 我来具体解释一下这个公式。其中,T(n) 我们已经讲过了,它表示代码执行的时间;n 表示数据规模的大小;f(n) 表示每行代码执行的次数总和。因为这是一个公式,所以用 f(n) 来表示。公式中的 O,表示代码的执行时间 T(n) 与 f(n) 表达式成正比。 所以,第一个例子中的 T(n) = O(2n+2),第二个例子中的 T(n) = (2n²+2n+3)。这就是大O时间复杂度表示法。大O时间复杂度实际上并不具体表示代码真正的执行时间,而是表示代码执行时间随数据规模增长的变化趋势,所以,也叫作渐进时间复杂度,简称时间复杂度。 当 n 很大时,你可以把它想象成 10000、100000。而公式中的低阶、常量、系数三部分并不左右增长趋势,所以都可以忽略。我们只需要记录一个最大量级就可以了,如果用大 O 表示法表示刚讲的那两段代码的时间复杂度,就可以记为:T(n) = O(n); T(n) = O(n²)。 3 时间复杂度分析 前面介绍了大 O 时间复杂度的由来和表示方法。现在我们来看下,如何分析一段代码的时间复杂度? 3.1 只关注循环执行次数最多的一段代码 大 O 这种复杂度表示方法只是表示一种变化趋势。我们通常会忽略掉公式中的常量、低阶、系数,只需要记录一个最大阶的量级就可以了。所以,我们在分析一个算法、一段代码的时间复杂度的时候,也只关注循环执行次数最多的那一段代码就可以了。这段核心代码执行次数的 n 的量级,就是整段要分析代码的时间复杂度。 为了便于你理解,我还拿前面的例子来说明。 其中第 2、3 行代码都是常量级的执行时间,与 n 的大小无关,所以对于复杂度并没有影响。循环执行次数最多的是第 4、5 行代码,所以这块代码要重点分析。前面我们也讲过,这两行代码被执行了 n 次,所以总的时间复杂度就是 O(n)。 3.2 加法法则:总复杂度等于量级最大的那段代码的复杂度 这里还有一段代码。 这个代码分为三部分,分别是求 sum_1、sum_2、sum_3。我们可以分别分析每一部分的时间复杂度,然后把它们放到一块儿,再取一个量级最大的作为整段代码的复杂度。 第一段的时间复杂度是多少呢?这段代码循环执行了 100 次,所以是一个常量的执行时间,跟 n 的规模无关。 即便这段代码循环 10000 次、100000 次,只要是一个已知的数,跟 n 无关,照样也是常量级的执行时间。当 n 无限大的时候,就可以忽略。尽管对代码的执行时间会有很大影响,但是回到时间复杂度的概念来说,它表示的是一个算法执行效率与数据规模增长的变化趋势,所以不管常量的执行时间多大,我们都可以忽略掉。因为它本身对增长趋势并没有影响。 那第二段代码和第三段代码的时间复杂度是多少呢?答案是 O(n) 和 O(n²)。 综合这三段代码的时间复杂度,我们取其中最大的量级。所以,整段代码的时间复杂度就为 O(n²)。也就是说:总的时间复杂度就等于量级最大的那段代码的时间复杂度。那我们将这个规律抽象成公式就是: 如果 T1(n)=O(f(n)),T2(n)=O(g(n));那么 T(n)=T1(n)+T2(n)=max(O(f(n)), O(g(n))) =O(max(f(n), g(n))). 3.3 乘法法则:嵌套代码的复杂度等于嵌套内外代码复杂度的乘积 刚讲了一个复杂度分析中的加法法则,这儿还有一个乘法法则。类比一下,你应该能“猜到”公式是什么样子的吧? 如果 T1(n)=O(f(n)),T2(n)=O(g(n));那么 T(n)=T1(n)_T2(n)=O(f(n))_O(g(n))=O(f(n)*g(n)). 也就是说,假设 T1(n) = O(n),T2(n) = O(n²),则 T1(n) * T2(n) = O(n³)。落实到具体的代码上,我们可以把乘法法则看成是嵌套循环,我举个例子给你解释一下。 我们单独看 cal() 函数。假设 f() 只是一个普通的操作,那第 4~6 行的时间复杂度就是,T1(n) = O(n)。但 f() 函数本身不是一个简单的操作,它的时间复杂度是 T2(n) = O(n),所以,整个 cal() 函数的时间复杂度就是,T(n) = T1(n)_T2(n) = O(n_n) = O(n²)。 3.4 几种常见时间复杂度实例分析 虽然代码千差万别,但是常见的复杂度量级并不多。稍微总结了一下,这些复杂度量级几乎涵盖了大部分的场景。 常量阶 O(1) 对数阶 O(logn) 线性阶 O(n) 线性对数阶 O(nlogn) 平方阶 O(n²) 立方阶 O(n³) … 指数阶 O(2ⁿ) 阶乘阶 O(n!) 对于刚罗列的复杂度量级,我们可以粗略地分为两类,多项式量级和非多项式量级。其中,非多项式量级只有两个:O(2ⁿ) 和 O(n!)。 当数据规模 n 越来越大时,非多项式量级算法的执行时间会急剧增加,求解问题的执行时间会无限增长。所以,非多项式时间复杂度的算法其实是非常低效的算法。我们主要来看几种常见的多项式时间复杂度。 1.O(1) 首先你必须明确一个概念,O(1) 只是常量级时间复杂度的一种表示方法,并不是指只执行了一行代码。比如这段代码,即便有 3 行,它的时间复杂度也是 O(1),而不是 O(3)。 只要代码的执行时间不随 n 的增大而增长,这样代码的时间复杂度我们都记作 O(1)。或者说,一般情况下,只要算法中不存在循环语句、递归语句,即使有成千上万行的代码,其时间复杂度也是Ο(1)。 2.O(logn)、O(nlogn) 对数阶时间复杂度非常常见,同时也是最难分析的一种时间复杂度。我通过一个例子来说明一下。 根据我们前面讲的复杂度分析方法,第三行代码是循环执行次数最多的。所以,我们只要能计算出这行代码被执行了多少次,就能知道整段代码的时间复杂度。 从代码中可以看出,变量 i 的值从 1 开始取,每循环一次就乘以 2。当大于 n 时,循环结束。 实际上,变量 i 的取值就是一个等比数列。如果我把它一个一个列出来,就应该是这个样子的: 所以,我们只要知道 x 值是多少,就知道这行代码执行的次数了。通过 2ˣ=n 求解 x ,x=log₂n,所以,这段代码的时间复杂度就是 O(log₂n)。 现在,我把代码稍微改下,你再看看,这段代码的时间复杂度是多少? 根据我刚刚讲的思路,很简单就能看出来,这段代码的时间复杂度为 O(log₃n)。 实际上,不管是以 2 为底、以 3 为底,还是以 10 为底,我们可以把所有对数阶的时间复杂度都记为 O(logn)。为什么呢? 我们知道,对数之间是可以互相转换的,log₃n 就等于 log₃2_log₂n,所以 O(log₃n) = O(C_log₂n),其中 C=log₃2 是一个常量。基于我们前面的一个理论:在采用大 O 标记复杂度的时候,可以忽略系数,即 O(Cf(n)) = O(f(n))。所以,O(log₂n) 就等于 O(log₃n)。因此,在对数阶时间复杂度的表示方法里,我们忽略对数的“底”,统一表示为 O(logn)。 如果你理解了O(logn),那 O(nlogn) 就很容易理解了。还记得我们刚讲的乘法法则吗?如果一段代码的时间复杂度是 O(logn),我们循环执行 n 遍,时间复杂度就是 O(nlogn) 了。而且,O(nlogn) 也是一种非常常见的算法时间复杂度。比如,归并排序、快速排序的时间复杂度都是 O(nlogn)。 3.O(m+n)、O(m*n) 我们再来讲一种跟前面都不一样的时间复杂度,代码的复杂度由两个数据的规模来决定。老规矩,先看代码! 从代码中可以看出,m 和 n 是表示两个数据规模。我们无法事先评估 m 和 n 谁的量级大,所以我们在表示复杂度的时候,就不能简单地利用加法法则,省略掉其中一个。所以,上面代码的时间复杂度就是 O(m+n)。 针对这种情况,原来的加法法则就不正确了,我们需要将加法规则改为:T1(m) + T2(n) = O(f(m) + g(n))。但是乘法法则继续有效:T1(m)_T2(n) = O(f(m)_f(n))。 4 空间复杂度分析 前面,咱们花了很长时间讲大 O 表示法和时间复杂度分析,理解了前面讲的内容,空间复杂度分析方法学起来就非常简单了。 时间复杂度的全称是渐进时间复杂度,表示算法的执行时间与数据规模之间的增长关系。类比一下,空间复杂度全称就是渐进空间复杂度,表示算法的存储空间与数据规模之间的增长关系。 还是拿具体的例子来说明。 跟时间复杂度分析一样,我们可以看到,第 2 行代码中,我们申请了一个空间存储变量 i,但是它是常量阶的,跟数据规模 n 没有关系,所以我们可以忽略。第 3 行申请了一个大小为 n 的 int 类型数组,除此之外,剩下的代码都没有占用更多的空间,所以整段代码的空间复杂度就是 O(n)。 我们常见的空间复杂度就是 O(1)、O(n)、O(n²),像 O(logn)、O(nlogn) 这样的对数阶复杂度平时都用不到。而且,空间复杂度分析比时间复杂度分析要简单很多。 5 内容小结 复杂度也叫渐进复杂度,包括时间复杂度和空间复杂度,用来分析算法执行效率与数据规模之间的增长关系,可以粗略地表示,越高阶复杂度的算法,执行效率越低。常见的复杂度并不多,从低阶到高阶有:O(1)、O(logn)、O(n)、O(nlogn)、O(n²)。

优秀的个人博客,低调大师

MQTT 1.9.1-beta.1 带来桌面客户端性能提升,优化使用资源消耗

十二月末,MQTT X 团队发布了 1.9.1-beta.1 版本,这也是 MQTT X 的首个公共测试版。我们希望能够通过测试版本,让更多用户参与到 MQTT X 的测试中来,和我们一起打造一个更加稳定的版本,进而帮助用户轻松使用 MQTT X 完成 MQTT 服务与应用的开发。 在 1.9.1-beta.1 版本中,我们主要优化了 MQTT X 桌面端使用时的部分性能问题,减少了在使用过程中的卡顿现象和内存消耗,优化数据存储方式,减少数据库崩溃的情况;在 MQTT X CLI 中加入自动重连功能,并支持将配置参数保存到配置文件中,减少了每次使用时的参数输入;同时也修复了一些已知的问题。 目前团队正专注于 1.9.1-beta.2 版本的研发,将修复更多社区反馈和测试出的问题,对性能进行更多优化。 最新版本:1.9.1-beta.2 版本 桌面客户端 性能优化 在目前的用户反馈中,我们发现了一些性能问题,比如在使用过程中会出现卡顿现象、内存消耗过大等。我们在 1.9.1-beta.1 版本中对这些问题进行了优化。 我们使用 MQTT X CLI 的 bench 命令,设置以每秒 100 条消息的速率向 mqttx/bench 主题发布消息,并将 MQTT X 运行在开发环境中,连接上同一个 MQTT 服务,然后订阅 mqttx/bench 主题,最后使用性能监控工具来对 MQTT X 进行性能监控,在差不多同等时间和环境内来对比区分我们在优化前后的性能变化,以便于更好地了解当前的优化效果。 bench 命令如下: mqttx bench pub -c 100 -t mqttx/bench -m hello JS heap size 是指 JavaScript 引擎在运行时分配的内存大小 优化前: 优化后: 我们可以看到内存使用在优化前接近 600MB 左右,CPU 使用率基本维持 98% 左右,优化后内存维持在 380MB 左右,CPU 使用率维持在 60% 左右,内存和 CPU 的使用率都有了明显的下降。后续我们将继续优化这些性能问题,可以基本满足用户使用时在接收大量主题消息的情况下,仍然能够保持较低的 CPU 和内存使用率。 支持批量存储 在该测试版中,我们支持了消息和数据的批量存储,当用户接收大量的消息时,避免了数据库的频繁写入,提高了性能,同时也减少了数据库压力和内存与 CPU 消耗,防止部分数据库在使用时崩溃的问题。 该性能优化目前仍在进行中,预计将在 1.9.1 正式版中,全面优化这些卡顿及性能问题。 主题输入框提示 在之前的版本中,很多新手用户在使用时无法快速准确的找到输入主题的地方。当建立连接后,我们需要手动输入主题并填写 payload 后,才能够发送消息。 在该测试版中,我们优化了主题输入框的提示功能,当用户未输入主题时,提示框将显示高亮,以便提醒用户在界面中高亮的主题输入框内输入发送主题。 命令行客户端 MQTT X CLI 在 1.9.1-beta.1 的测试版中,主要是添加了以下两个较大的新功能,为用户提供更好的使用体验。 支持自动重连 命令行工具同样也支持了自动重连功能,当连接断开时将自动重连,无需手动重连。支持设置重连周期以及最大重连次数。 # 以连接命令时的自动重连次数配置为例,修改为 5 次,重连周期为 5000 毫秒 mqttx conn -h 'broker.emqx.io' -p 1883 --maximun-reconnect-times 5 --reconnect-period 5000 支持配置文件 支持将连接、订阅和发布时的参数保存到配置文件中,减少用户在使用时的参数配置次数,快速复用配置文件中的参数来连接、订阅和发布消息。保存和加载配置文件的路径也可以由用户自行定义。 # 以连接命令时的配置文件为例,保存配置文件到当前目录下的 mqttx.json 文件中 mqttx conn -h 'broker.emqx.io' -p 1883 --save mqttx.json # 加载当前目录下的 mqttx.json 文件中的连接配置 mqttx conn --config mqttx.json 上述两个新功能同样支持在 MQTT X CLI 的 bench 命令中使用,方便用户性能测试时快速测试连接、订阅和发布消息等。 未来规划 MQTT X 还在持续增强完善中,以期为用户带来更多实用、强大的功能,为物联网应用与服务的测试和开发提供便利。接下来我们将重点关注以下方面,敬请期待: 接收消息和存储时的性能优化,大量消息不卡顿(继续减少 CPU 和内存的消耗) 可配置忽略 QoS 0 的消息存储,以减少存储空间的占用 MQTT Debug 功能 接收到的消息可以进行自动图表绘制 插件功能 脚本测试自动化(Flow) 版权声明: 本文为 EMQ 原创,转载请注明出处。 原文链接:https://www.emqx.com/zh/blog/mqttx-newsletter-202212

优秀的个人博客,低调大师

Gitea 1.17.2 | 带来视觉提升、完善资源校验、加强安全性等42项优化

Gitea 1.17.2 合并了 42 个 Pull Request,现已正式发布,我们建议所有用户升级到此版本。 致谢:@zeripath 为 Gitea 贡献了诸多安全补丁! 您可以从下载页面下载预编译的二进制文件,请注意选择正确的操作系统。关于如何安装,还请参考安装手册。 Gitea 中文文档:https://docs.gitea.io/zh-cn/ 在此,我们感谢所有在 Open Collective 给予我们资金支持的贡献者。 Changelog 1.17.2 - 2022-09-06 SECURITY Double check CloneURL is acceptable (#20869) (#20892) Add more checks in migration code (#21011) (#21050) ENHANCEMENTS Fix hard-coded timeout and error panic in API archive download endpoint (#20925) (#21051) Improve arc-green code theme (#21039) (#21042) Enable contenthash in filename for dynamic assets (#20813) (#20932) Don't open new page for ext wiki on same repository (#20725) (#20910) Disable doctor logging on panic (#20847) (#20898) Remove calls to load Mirrors in user.Dashboard (#20855) (#20897) Update codemirror to 5.65.8 (#20875) Rework repo buttons (#20602, #20718) (#20719) BUGFIXES Ensure delete user deletes all comments (#21067) (#21068) Delete unreferenced packages when deleting a package version (#20977) (#21060) Redirect if user does not exist on admin pages (#20981) (#21059) Set uploadpack.allowFilter etc on gitea serv to enable partial clones with ssh (#20902) (#21058) Fix 500 on time in timeline API (#21052) (#21057) Fill the specified ref in webhook test payload (#20961) (#21055) Add another index for Action table on postgres (#21033) (#21054) Fix broken insecureskipverify handling in redis connection uris (#20967) (#21053) Add Dev, Peer and Optional dependencies to npm PackageMetadataVersion (#21017) (#21044) Do not add links to Posters or Assignees with ID < 0 (#20577) (#21037) Fix modified due date message (#20388) (#21032) Fix missed sort bug (#21006) Fix input.value attr for RequiredClaimName/Value (#20946) (#21001) Change review buttons to icons to make space for text (#20934) (#20978) Fix download archiver of a commit (#20962) (#20971) Return 404 NotFound if requested attachment does not exist (#20886) (#20941) Set no-tags in git fetch on compare (#20893) (#20936) Allow multiple metadata files for Maven packages (#20674) (#20916) Increase Content field size of gpg_key and public_key to MEDIUMTEXT (#20896) (#20911) Fix mirror address setting not working (#20850) (#20904) Fix push mirror address backend get error Address cause setting page display error (#20593) (#20901) Fix panic when an invalid oauth2 name is passed (#20820) (#20900) In PushMirrorsIterate and MirrorsIterate if limit is negative do not set it (#20837) (#20899) Ensure that graceful start-up is informed of unused SSH listener (#20877) (#20888) Pad GPG Key ID with preceding zeroes (#20878) (#20885) Fix SQL Query for SearchTeam (#20844) (#20872) Fix the mode of custom dir to 0700 in docker-rootless (#20861) (#20867) Fix UI mis-align for PR commit history (#20845) (#20859)

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册