首页 文章 精选 留言 我的

精选列表

搜索[百万tokens],共7431篇文章
优秀的个人博客,低调大师

恶意软件伪装成Android应用 控制逾百万谷歌账户

北京时间12月1日消息,据外媒报道,安全厂商Check Point Software Technologies Ltd(以下简称“Check Point”)研究显示,自8月份以来,伪装成正常Android智能手机和平板电脑应用的恶意件,控制了逾100万个谷歌账户。 从它们的名字来看,这些应用貌似没有什么危害,例如StopWatch、Perfect Cleaner和WiFi Enhancer。但它们利用老版Android操作系统中已知的缺陷控制设备,在未经用户允许的情况下安装其他应用和广告件。部分未经授权的应用,还利用受影响用户的用户名和密码发布虚假评论。 Check Point称,被称作Gooligan的恶意特洛伊木马软件隐身在86款虚假应用中,每天感染约1.3万台Android设备。感染有Gooligan的应用来自第三方而非谷歌的Play应用商店,但它们未经授权下载的部分应用也出现在Play上。被感染的设备会显示弹出式广告和安装非用户主动安装的软件。 Gooligan是Ghost Push恶意件的变种。Ghost Push两年来一直困扰着Android,谷歌去年发现逾4万款Ghost Push应用。 谷歌发言人在一份声明中说,“我们对Check Point的合作表示感谢,双方已经在了解和解决这些问题上进行了合作。” 谷歌称已经从Google Play中下架与Ghost Push有关联的应用,并采取措施破坏Ghost Push开发者使用的服务器,确保被Ghost Push控制的账户安全。 谷歌表示,虽然第三方应用商店的免费应用很有吸引力,但它们隐含着风险。谷歌在Google+上发帖,呼吁用户只通过Play下载应用。 Check Point称,只有运行Android 4(代号为Jelly Bean或KitKat)或Android 5(代号为Lollipop)设备才面临感染Gooligan的风险,怀疑设备感染Gooligan的用户可以登录Check Point网站,对设备体检,了解更多相关信息。 本文转自d1net(转载)

优秀的个人博客,低调大师

一张图片能导致数百万Android手机被黑?

谷歌今天发布了最新的Android安全公告(Android Security Bulletin),针对前一阵曝出的一系列漏洞做了补丁修复,比如说影响到9亿台设备、针对高通芯片的Quadrooter漏洞——这也是本次Android补丁修复漏洞的重点。 不过来自Forbes的报道,实际上这次谷歌还修复了一个鲜为人知的漏洞,看起来也是相当危险:只要有人给你发一张照片,Android手机就可能被入侵——在某些情况下,用户甚至不需要点击这张照片,手机自动对照片进行解析时,黑客就能远程控制Android设备,或者令设备变砖。 该漏洞编号为CVE-2016-3862,实际上和先前著名的Stagefright(只需要一条彩信就能控制受害者的手机)有些类似,或者说和前一阵苹果系统中的CVE-2016-4631漏洞更像。不过这次的漏洞与图片的EXIF信息有关:数字图片除了自身呈现画面的数据之外,还附带有EXIF数据——比如这张照片是用什么设备拍的,照片拍摄所在地理位置、拍摄时光圈、快门分别是多少等等,这些信息就属于EXIF数据部分。 Android系统中读写JPG图片EXIF扩展信息的API为ExifInterface——在应用解析图片信息的过程中,该漏洞就能被恶意代码利用。任何使用了ExifInterface类的Android应用都可能触发此漏洞。来自安全公司SentinelOne的Strazzere表示,如Gchat、Gmail这些应用,用户在这些应用中打开图片文件,就可能导致设备崩溃,甚至“远程代码执行”,并在用户毫无察觉的情况下在系统中植入恶意程序,并进行全面控制。 “该漏洞不需要引起用户太多的注意就能触发,比如应用只需要以特定的方式来加载图片。触发的方式非常简单,包括接收一条消息或者电子邮件。只要应用对照片进行解析(这个过程是系统自动进行的),就会导致问题发生。” “从理论上来说,攻击者可以在图片文件中构建恶意代码,感染大量设备…Gchat、Gmail和绝大部分其他消息通讯应用、社交网络应用都可能触发该漏洞。”不过Strazzere并没有说明,究竟具体是哪些应用受到影响,只是说包括一些“隐私敏感”工具。 Forbes的这篇文章中并没有详述该漏洞的技术细节,我们从Android安全公告中看到,谷歌对这个漏洞的归类为“Mediaserver中的远程代码执行漏洞”,漏洞威胁等级为Critical紧急级别。漏洞描述如下: “Mediaserver中的远程代码执行漏洞,攻击者通过专门构建的文件,在媒体文件和数据处理过程中,可致内存崩溃(corruption)。鉴于该问题可导致在Mediaserver进程中进行远程代码执行,故将漏洞分级为紧急级别。” 谷歌这次发布的Android系统9月补丁针对Android 4.4.4及更高版本的系统(已经升级Android 7.0的设备似乎是不受影响的),不过据说更老版本的系统也存在这一问题,只不过谷歌已不再支持早期版本的系统更新。Strazzere特别针对Android 4.2以及部分亚马逊Kindle平板设备进行了试验,发现也都存在此问题。 所以Strazzere的建议是,如果你的Android手机过老,已经不能再进行系统升级了,那么只要你还在意安全性,就请换一部手机吧。运行Android 4.4.4系统以上版本的Nexus设备今天应该就会收到一波更新,其他OEM厂商的Android设备就需要等厂商和运营商的补丁推送计划了。 根据Android系统BUG奖励计划,Strazzere获得了谷歌4000美元的奖励,不过据说谷歌还多奖励了另外4000美元给他。而Strazzere则将这8000美元捐给了Girls Garage项目(为9-13岁的女孩准备的building计划)。 本文转自d1net(转载)

优秀的个人博客,低调大师

百万奖金怎么拿?这有一份上海开源大赛攻略

由开源中国主办的 2026 上海开源软件应用创新大赛已正式启动报名,作为上海市的年度重磅技术赛事,本次大赛总奖池累计 100 万元,面向全国征集开源项目,无论是企业团队、高校学生还是个人开发者,都可以报名参赛。 这篇攻略把大赛从报名到总决赛的关键信息一次讲清楚,帮你判断项目怎么报、材料怎么交、评审看什么、什么方式报名获奖概率更高。 关键时间线,先记四个节点 即日起 - 10 月 11 日 24:00:报名与作品提交,官网填写报名表单,提交即完成报名 10 月 16 日:总决赛名单公布,约 30 个项目入围;获奖名额也是 30 个,也就是说进决赛就有奖! 10 月 24 日:上海张江科学会堂线下总决赛,路演、终审、颁奖一天完成 在大赛官网报名成功,组委会审核后以邮件发送报名确认通知,收到邮件即按指引提交作品材料 建议尽早报名。资格审核随报随审,先提交基础信息即可锁定席位,后续再逐步完善材料,不用等作品全部做完才报名。 谁能参赛,需要交什么 大赛面向企业、高校、科研机构、开源社区及学生团队开放,个人或团队均可报名。建议团队 3 至 5 人,须明确负责人 1 名。每个项目只能选择一个赛道报名,同一主体可提交不同项目参赛。 也就是说,如果你的手中有好几个项目,那么你就可以多次报名,参赛以项目为单位,但要注意一个项目只能投一个对应的赛道。 收到报名确认邮件后,须在 10 月 11 日 24:00 前将以下材料打包发送至大赛组委会邮箱: 代码仓库链接:包含完整可运行的代码 作品介绍文档(推荐 PDF):包含项目背景、技术架构、应用场景及创新点 作品演示视频链接:视频需展示作品的核心功能与使用流程 因为不同项目依赖环境不同,所以前期线上评审无法每个项目都实机跑一遍,因此你的项目介绍文档和演示视频就是展现项目价值的关键,一定要把自己项目的亮点通过提交材料完全展现出来,才能从众多参赛项目中脱颖而出。 如企业命题赛题有指定开发工具,请参阅对应命题任务书要求。材料重点是代码要能跑、介绍要说清场景、视频要展示真实使用流程,这三样是评审判断项目是否“可落地”的第一手依据。 三大赛道,你的项目投哪个 大赛不按技术栈划分,按真实落地场景设三个赛道,独立评审、独立设奖: AI+工业软件赛道,面向用 AI 解决实体经济工程、流程或决策难题的开源项目,覆盖研发设计与仿真分析、工艺优化与生产排程、质量检测与设备运维等方向,重点关注系统集成能力,以及项目在真实或仿真环境中的验证能力。CAD/CAE/EDA 深度集成、工业互联网平台打通数据链路实现自主决策的项目,是这个赛道的核心画像。 智算云赛道,面向用云加速、简化或稳定 AI 运行的开源项目,从异构算力调度、GPU 池化、分布式训练,到模型部署服务、Serverless 推理、多云管理、边云协同与 FinOps 成本优化,均在征集范围内。赛道不区分基础设施或应用层,只要用云原生技术解决了 AI 开发、部署或运维中的实际痛点,都可以参赛。 开源 AI 工具赛道,面向开发者 AI 研发与运维效率工具,含数据标注、训练微调、评测、RAG、智能体框架、MLOps 等,重点关注易用性与真实使用案例。这个赛道评的是“开发者会实际拿去用的工具”。 选择标准很简单:你的项目以什么形态交付、解决哪个环节的问题,就投哪个赛道。项目兼具软件与硬件能力时,以核心交付形态为准。如果条件允许,你可以把自己的工业机器人搬到决赛现场演示,若难以实现,以视频的形式展现也 OK。 PS:从过往经验与赛道难度来看,智算云赛道是竞争压力相对较小的赛道,投这个赛道的项目获奖概率更高! 企业命题,多一条“命题+专项激励”的路 大赛采取“企业命题+项目参赛”双向组织方式。除了自主选择赛道,还可以选对应赛道的企业命题。选企业命题可获命题企业的专家指导与工具支持,并在评审中获得一定的分数加权。目前大赛官网正陆续上线企业命题。 企业命题的好处在于需求明确、场景真实,命题单位会全程关注对应解题团队,获奖项目更容易直接进入企业视野,获得落地对接机会。如果你的项目正好贴合某个命题方向,或者是想在大赛期间从 0 开始开发项目参赛的团队,建议优先考虑选做企业命题,通过命题加权提高获奖机会。 评审看什么,四个维度怎么拿分 大赛实行“准入审核+价值评估”两阶段评审。第一阶段资格审核核验申报主体、项目真实性、代码仓库或开源计划、开源协议与知识产权合规;第二阶段专家评审按四个维度加权打分: 技术创新(30%):技术路线是否独创,是否解决已有方案未解决的问题,相较同类是否有明确优势 场景落地(30%):可部署、可运行、可测试,场景真实,方案适配,验证数据来自真实或仿真环境 开源治理(20%):协议与依赖合规,贡献机制与文档规范清晰,新项目看规划,老项目看运营 长期发展(20%):持续维护能力、长期规划、治理结构与社区或组织支撑 对号入座准备材料:技术维度在介绍文档里讲清创新点和差异化;场景维度把演示视频做扎实,展示真实环境运行;开源治理维度确保 README、协议、依赖清单都规范;长期发展维度说明团队构成和后续规划。 奖项与回报,奖金之外还有三件事 大赛总奖池累计 100 万元,包含现金、算力与 Token、大模型 API 等开发者资源奖励。三个赛道独立评选,每个赛道设一等奖 1 名、二等奖 2 名、三等奖 3 名、新锐潜力奖 4 名,共 30 个获奖名额。 奖金之外,还有两件事值得关注: 一是所有获奖项目均颁发获奖证书,并纳入赛事项目库,享受赛后产业对接、技术验证、投融资对接及政策咨询服务。 二是重磅开源项目有机会入选上海市开源项目培优工程,获得上海市最高 500 万元奖励。 最后三点提醒 第一,材料尽早提交。资格审核随报随审,先锁定席位再完善材料,避免临近截止时集中提交出问题。 第二,演示视频别凑合。评审看的是真实运行,视频里展示核心功能完整走一遍,比堆砌功能列表更有说服力。 第三,关注命题更新。企业命题可能陆续新增,官网专题页持续更新,报名前可以先看一眼有没有适合自己项目的新命题。 10 月 11 日报名截止,10 月 24 日张江科学会堂总决赛,我们现场见! 大赛报名链接:https://www.oschina.net/os2026/

优秀的个人博客,低调大师

欧盟 DMA 法案使数百万用户转向使用 Firefox

Mozilla 发文称,欧盟的《数字市场法案》(DMA)为用户创造了真正选择浏览器的机会,而用户也正在积极利用这些机会。 其最新数据显示:自新规生效两年多以来,用户每 10 秒钟就会通过 DMA 浏览器选择界面选择一次 Firefox。累计选择次数超过 600 万次。而且用户忠诚度也更高:通过选择界面选择 Firefox 的用户留存率是其他方式的五倍。 同时,独立研究人员对比了欧盟和 43 个非欧盟国家的 Firefox 日活跃用户数。通过比较了 iOS 浏览器选择界面推出前后 15 个月的数据,发现欧盟地区的 Firefox 日活跃用户数比没有 DMA(指定市场区域)时高出 113%。在 Android 平台上,这一数字增长了 12%。 而 Android 平台的影响较小的原因在于,Firefox 在 Android 平台上的初始用户基数更高,且 Android 平台的推广也比 iOS 平台更加不均衡。研究还表明,DMA 的影响正在随着时间的推移而增强。 分析显示,在 iOS 设备上,通过选择界面选择 Firefox 的女性用户比例远高于自然下载用户,表明选择界面可能成功触达那些不太愿意手动更改浏览器默认设置的用户群体。 “当用户真正拥有浏览器选择权时,他们会抓住机会并选择其他浏览器……Mozilla 希望真正的浏览器选择权能够成为常态,而非例外。同时,希望浏览器选择界面的经验教训能应用到 DMA 的其他领域,包括数据可移植性和互操作性。只有全面遵守相关规定——包括将现有的 DMA 条款应用于 AI 领域——欧盟民众才能真正享受到竞争和创新带来的全部益处。”

优秀的个人博客,低调大师

🔥自研 Servlet 容器百万次压测轻松超越 Undertow/Tomcat

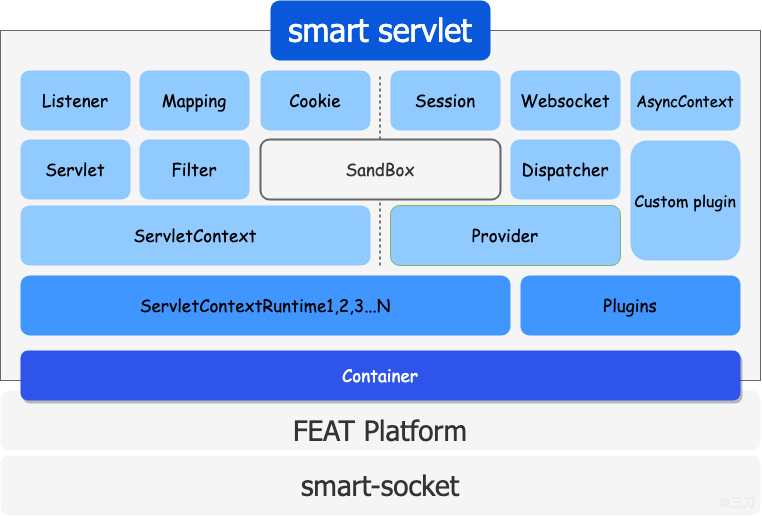
1、smart-servlet 简介 smart-servlet 是一个基于 Jakarta Servlet 6.1 的轻量级 Servlet 容器,适用于 Java 17+ 环境。 产品特色 国产血统:全球首款全栈核心技术自研的国产 Servlet 容器。 性能优越:搭载最新版通信微内核(smart-socket)和 Web 服务平台(FEAT)。 安全可靠:严格遵循协议规范;支持加密传输方式。 极致轻量:发行包仅 1MB。 简洁易用:支持 War 包、springboot、maven-plugin 等多种运行模式,使用体验 100%兼容 Tomcat。 目标用户 有着「信创需求」的企业用户。 对服务并发能力要求高的企业用户。 想要研究 servlet 技术的个人开发者。 性能测试报告 2、 版本更新 自此版本起,samrt-servlet 将底层支撑模块由 samrt-http 迁移至全新的平台:FEAT。未来将由 FEAT 为 smart-servlet 提供安全可靠、性能卓越、资源节省的 Web 服务。 随着越来越多的用户关注并试用 smart-servlet,暴露了部分共性问题在本次发布中得以优化。其中占比较多是某些用户在 javax.servlet 项目中引用 smart-servlet 导致服务无法正常使用,而 smart-servlet 目前适配的是 jakarta.servlet 规范。 为便于用户自主定位问题,smart-servlet 在启动时对部署的 Servlet 容器进行探测。若发现引用了 javax.servlet 依赖会给出如下提示: springboot 工程的提示信息为: 更新内容: 🚀移除 smart-http 依赖,切换为 Feat。 🚀新增 javax.servlet 规范检测提示功能 🚀适配 springboot 自定义端口号和 SSL 配置 🛠️优化 HttpServletRequest#getCharacterEncoding 实现规范。 🛠️优化 HttpServletRequest#getContentType 实现规范。 🛠️优化 HttpServletRequest#getWriter 实现规范。 🛠️优化 HttpServletRequest#setLocale 实现规范。 🛠️ ServletOutputStream 默认缓冲区调整为8k。 🐛修复未指定响应编码情况下的中文乱码问题。 3、快速上手 我们提供了三种方式启用 smart-servlet,您可根据实际情况选择其中适用的一种。 方式一:maven 插件 这是一种类似:tomcat-maven-plugin的使用方式,通常应用于 Java Web 工程的本地开发环境。集成该插件只需在 pom.xml 中加入以下代码,便可以在 IDE 中启动 servlet 服务。 <build> <plugins> <plugin> <groupId>tech.smartboot.servlet</groupId> <artifactId>smart-servlet-maven-plugin</artifactId> <version>{最新版本}</version> <configuration> <port>8080</port> <path>/portal</path> </configuration> </plugin> </plugins> </build> 插件的版本建议采用最新版本,另外主要的配置项包括: port:servlet服务启动的监听端口 path:Servlet容器上下文路径,即 ContextPath,通常以/表示。当然也支持自定义,但必须以/开头 完成配置后在控制台输入:mvn package smart-servlet:run即可。 方式二:smart-servlet-spring-boot-starter 用过 springboot 的 spring-boot-starter-tomcat 或者 spring-boot-starter-undertow 的朋友应该对此不陌生。 smart-servlet-spring-boot-starter 本质上就是 smart-servlet 对 spring-boot-starter-web 的另一种适配。 只需按照以下方式调整 springboot 工程中 pom.xml 文件的配置,便可将 springboot 的默认 Servlet 容器替换成 smart-servlet。 <dependencys> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> <exclusions> <!--ExcludetheTomcatdependency--> <exclusion> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-tomcat</artifactId> </exclusion> </exclusions> </dependency> <!--Usesmart-servletinstead--> <dependency> <groupId>tech.smartboot.servlet</groupId> <artifactId>smart-servlet-spring-boot-starter</artifactId> <version>{最新版本}</version><!--最新版本--> </dependency> </dependencys> 方式三:发行包 发行包适用于 War 包的部署方式,也是生产环境中常用的一种形式。 下载地址:https://smartboot.tech/smart-servlet/guides/release_note/

优秀的个人博客,低调大师

百万TPS高吞吐、秒级低延迟,阿里​搜索离线平台如何实现?

导读:阿里主搜(淘宝天猫搜索)是搜索离线平台非常重要的一个业务,具有数据量大、一对多的表很多、源表的总数多和热点数据等特性。对于将主搜这种逻辑复杂的大数据量应用迁移到搜索离线平台总是不缺少性能的挑战,搜索离线平台经过哪些优化最终实现全量高吞吐、增量低延迟的呢?文章大纲如下: 前言 搜索离线平台基本概念 主搜业务特点与性能要求 Blink Job 性能调优详解 结语 本文将与大家分享阿里主搜在实现全量高吞吐、增量低延迟方面的优化经验,希望对大家的 Flink 应用有所帮助。 一.前言 在阿里搜索工程体系中我们把搜索引擎、在线算分等毫秒级响应用户请求的服务称之为“在线”服务;与之相对应的,将各种来源数据转换处理后送入搜索引擎等“在线”服务的系统统称为“离线”系统。搜索离线平台作为搜索引擎的数据提供方,是集团各业务接入搜索的必经之路,也是整个搜索链路上极为重要的一环,离线产出数据的质量和速度直接影响到下游业务的用户体验。 搜索离线平台经过多年沉淀,不仅承载了集团内大量搜索业务,在云上也有不少弹外客户,随着平台功能的丰富,Blink(阿里内部版本的 Flink) 版本的领先,我们在 2019 年年初开始计划把主搜(淘宝天猫搜索)迁移到搜索离线平台上。 主搜在迁移搜索离线平台之前的架构具有架构老化、Blink 版本低、运维困难、计算框架不统一等不少缺点,随着老主搜人员流失以及运维难度与日俱增,重构工作早已迫上眉睫。 对于将主搜这种逻辑复杂的 X 亿数据量级应用迁移到搜索离线平台总是不缺少性能的挑战,业务特点与性能要求决定了主搜上平台的过程中每一步都会很艰辛。为了让性能达到要求,我们几乎对每个 Blink Job 都进行了单独调优,最初的理想与最后的结局都是美好的,但过程却是极其曲折的,本文将主要介绍主搜在迁移搜索离线平台过程中在性能调优方面具体做了哪些尝试。 主搜迁移搜索离线平台的完成对于平台来说有里程碑式的意义,代表搜索离线平台有能力承接超大型业务。 二.搜索离线平台基本概念 搜索离线平台处理一次主搜全增量主要由同步层和数据处理层组成,它们又分别包括全量和增量流程。为了读者更好理解下文,先简单介绍几个关于搜索离线平台的基本概念。 1.集团内支撑业务 目前搜索离线平台在集团内支持了包括主搜,AE 在内的几百个业务。其中数据量最大的为淘宝天猫评价业务,数据量达到了 X 百亿条,每条数据近上 X 个字段。 2.场景 处理用户的数据源(MySQL 或 ODPS)表,将数据经过一系列的离线处理流程,最终导入到 HA3 在线搜索引擎或 ES 中。 3.平台相关技术栈 如下图,搜索离线平台目前数据存储基于 HDFS/盘古,资源调度依赖于 YARN 或 Hippo,计算框架统一用 Flink/Blink 执行。 4.全量 全量是指将搜索业务数据全部重新处理生成,并传送给在线引擎,一般是每天一次。 这么做有两个原因:有业务数据是 Daily 更新;引擎需要全量数据来高效的进行索引整理和预处理,提高在线服务效率。全量主要分为同步层与数据处理层。 5.增量 增量是指将上游数据源实时发生的数据变化更新到在线引擎中。 这也就意味着在我们的场景中对于增量数据不需要保证 Exactly Once 语义,只需要保证 At Least Once 语义。基于该背景,我们才能用全链路异步化的思维来解一对多问题(下文会详细讲解)。 与全量一样,增量也分为同步层与数据处理层。 6.一对多 在搜索这个领域某些业务数据需要用一对多的形式来描述,比如商品宝贝和 SKU 的关系即是个典型的一对多数据的例子。在搜索离线基于 Hologres(阿里巴巴自研分布式数据库)存储的架构中,一对多的数据存储在单独的一张双 pk 的 HoloTable 中,第一、二主键分别的宝贝 ID 与 SKU_ID。 有了上面这些概念之后,在后续的段落中我们会看到搜索离线平台针对主搜各 Blink Job 的性能调优,先简要概括下主搜业务特点与性能要求。 7.数据存储方式 搜索离线平台以前用 HBase 做镜像表时,是用一张多列族大宽表来存储业务单维度所有数据。经过详细调研之后,我们决定用 Hologres 替换 HBase,所以需要对存储架构做全面的重构。用多表来模拟 HBase 中的多列族,单 HoloTable 中包括很多业务数据源表的数据。重构后的数据存储方式大致如下: 8.同步层 所谓同步层,一般是将上游数据源的数据同步到镜像表,供数据处理层高效处理。由于业务方单维度的数据有很多 MySQL 表或 ODPS 表组成,少则 X 张,多则像主搜这样 X 张。所以将同纬度数据聚合到一张 Holo 表中时,如果多张表两两 join 的话会产生大量 shuffle,所以我们采取异步 upsert 方式,不同数据源表的数据写 Holo 表中不同的列来解决海量数据导入问题。 9.数据处理层 所谓数据处理层,是指将同步层得到的各镜像表(HBase/Holo)的数据进行计算,一般包括多表 Join、UDTF 等,以方便搜索业务的开发和接入。 三.主搜业务特点与性能要求 下面首先介绍下主搜业务特点与性能要求,再详细介绍我们进行了怎样的调优才达到了性能的要求。 1.主搜业务特点 数据量大 主搜有 X 亿(有效的 X 亿)个商品,也就是主维度有 X 亿条数据,相比于平台其他业务(除淘宝评价业务)多出 X 个数量级。这么多数据我们能否在 X 个多小时完成全量?如何实现高吞吐?挑战非常大。 一对多的表很多 主搜业务有很多一对多的表需要 Join,例如一个商品对应多个 SKU,部分商品对应了接近 X 个 SKU 信息。这些信息如何能够高性能的转换为商品维度,并与商品信息关联? 源表的总数多 主搜有 X 多张表(包括一对多的表),平台其他业务的源表个数一般都在个位数。源表数量多会导致一系列的问题,比如读取 ODPS 数据时如何避免触发 ODPS 的限制?拉取大表数据时如何做到高吞吐?这些问题都需要我们一一解决。 热点数据 主搜有一些大卖家(饿了么,盒马等)对应了很多商品,导致在数据处理层出现非常严重的数据倾斜等问题。如何解决大数据处理方向经常出现的 SKEW? 2.主搜性能要求 全量(同步层 + 数据处理层)高吞吐! 全量要求每天一次,在有限的资源情况下每次处理 X 亿的商品,这么大的数据量,如何实现高吞吐,挑战非常大! 增量(同步层 + 数据处理层)低延迟! 增量要在 TPS 为 X W 的情况下达到秒级低延迟,并且双 11 期间有部分表(例如 XX 表)的 TPS 能达到 X W,增量如何保证稳定的低延迟?值得思考! 下面一一描述我们是如何解决这些问题来达到性能要求的。 四.Blink Job 性能调优详解 根据上述主搜业务特点与性能要求罗列出下图,左边与中间两列表示主搜哪些特点导致某阶段任务性能差。所以我们要对相应阶段 Blink Job 进行调优,调优完成也就代表着平台能满足图中最右边一列主搜所需要的全量高吞吐与增量低延迟的性能要求。 下面按照全量,增量,解一对多问题的脉络来给大家介绍我们是如何解决上述五个问题之后达到全量高吞吐以及增量低延迟的性能要求的。 1.全量高吞吐性能调优 全量主要包括同步层与数据处理层,必须实现高吞吐才能让全量在 X 个多小时之内完成。同步层在短时间内要同步约X张表中的上 X 亿全量数据,且不影响同时在运行的增量时效性是一个巨大的挑战。数据处理层要在短时间内处理X多亿条数据,Join 很多张镜像表,以及 UDTF 处理,MultiGet 等,最后产生全量 HDFS 文件,优化过程一度让人频临放弃。这里重点介绍数据处理层的性能调优历程。 该 Job 的调优历时较长,尝试方案较多,下面按照时间顺序讲解。 初始形态 首先提一下 IC 维度为商品维度,UIC 维度为卖家维度,并且最开始我们的方案是没有 FullDynamicNestedAggregation 和 IncDynamicNestedAggregation 的(后文会详细提到这两个Job)。Scan IC 维度单 Pk 表之后做一系列的 DImJoin、UDTF、MultiJoin。在测试过程中发现 DimJoin 多 pk 表(一对多表)的数据时,性能非常低下,全链路 Async 的流程退化成了 Sync,原因是我们一对多的数据存在单独的一个 SaroTable(对多个 HoloTable 的逻辑抽象)中,对指定第一 pk 来取对应所有数据用的是 Partial Scan,这是完全 Sync 的,每 Get 一次都要创建一个 Scanner,虽然我们不但对于 DimJoin 加了 Cache,并且对于主搜特有的 MultiGet 也加了对于 SubKey 的精准 Cache。但是测试下来发现,性能还是完全得不到满足,所以尝试继续优化。 引入 LocalJoin 与 SortMergeJoin 由于性能瓶颈是在 DimJoin 多 pk 的 SaroTable 这里,所以我们想办法把这部分去掉。由于一对多的 SaroTable 只有两个维度具有,所以我们尝试先分别将 IC 维度与 UIC 维度的所有表(包括单 pk 与多 pk)进行 LocalJoin,结果再进行 SortMergeJoin,然后继续别的流程。 首先介绍下 Local Join。由于 HoloStore 保证相同 DB 中所有表都是按照相同的 Partition 策略,并且都是按照主键字典序排好序的,所以我们可以将同纬度同 Partition 的数据拉取到一个进程中进行 Join,避免了 Shuffle,如下图所示。 所以拓扑大概变为: 经过测试,由于业务上面存在大卖家(一个卖家有很多商品),导致 SortMergeJoin 之后会有很严重的长尾,如下图所示,Uid 为 101 与 103 的数据都是落到同一个并发中,我曾经尝试再这个基础之上再加一层 PartitionBy nid 打散,发现无济于事,因为 SortMergeJoin 的 Sort 阶段以及 External Shuflle 对于大数据量的 Task 需要多次进行 Disk File Merge,所以该长尾 Task 还是需要很长时间才能 Finish。 加盐打散大卖家 所以我们需要继续调优。经过组内讨论我们决定对大卖家进行加盐打散,从 ODPS 源表中找出 Top X 的大卖家 ID,然后分别在主辅维度 Scan + Local Join 之后分别加上 UDF 与 UDTF,具体流程图与原理示例见下面两幅图: 如上图所示,Uid 为 101 与 103 的数据被打散到多个并发中了,并且因为我们在 SortMergeJoin 之后加了 UDTF 把加的 Salt 去掉,所以最终数据不会有任何影响。 最终形态 这样全量 FullJoin 总算完成了,并且性能也勉强达标,所以我们开始调整增量流程(IncJoin),这时发现 IncJoin 跟 FullJoin 的初始形态存在一样的问题,追增量非常慢,永远追不上,所以组内讨论之后决定在同步层针对全量新增一个 FullDynamicNestedAggregation Job(下文会详细提到),这是一个 Blink Batch Job 它将各维度一对多的 SaroTable 数据写到对应维度的主表中,然后在 FullJoin 最开始 Scan 时一起 Scan 出来,这样就避免了 DimJoin 多 pk 的 SaroTable。最终达到了全量高吞吐的要求,全量 FullJoin 最终形态如下: 2.增量低延迟性能调优 增量性能主要受困于数据处理层 IncJoin,该 Job 最开始是一个 Blink Stream Job,主要是从 SwiftQueue 中读出增量消息再关联各个镜像表中的数据来补全字段,以及对数据进行 UDTF 处理等,最后将增量消息发往在线引擎 SwiftQueue 中。 基于“流批一体”的思想,经过一系列尝试,我们增量数据处理层 Job 的最终形态如下。 与全量不同的是由于增量是实时更新的,所以更新记录不仅要写到 Swift Queue 中,还要写入 SaroTable 中。另外,我们根据业务特点给各个 Job 分别加了按 pk 对记录去重的 window。 3.解一对多问题 主搜有很多一对多的表,在数据处理层如何高效的将数据 Get 出来转换为主维度之后进行字段补全,困扰我们很久。 为了提升效率我们必须想办法提升 Cpu 利用率。所以 Get 记录改为全链路异步来实现,由于我们一对多数据存在多 pk 的 HoloTable 中,指定第一 pk 去获取相关数据在 Holo 服务端是以 Scan 来实现的。这样由于异步编程的传染性,全链路异步会退化为同步,性能完全不达标。 解决方法 为了将“伪异步”变成真正的全链路异步,经过多次讨论与实践之后,我们决定将一对多表中相同第一 pk 的多条数据 Scan 出来 GroupBy 为一条数据,将每个字段转化为 Json 之后再 Put 进主表中,主要步骤如下图所示。 我们针对全量与增量在同步层加 Job 来解决,分别为 FullDynamicNestedAggregation(Blink Batch Job)与 IncDynamicNestedAggregation(Blink Stream Job),这两个 Job 大致流程为如下图所示。 值得一提的是,正如前文介绍增量时提到的背景,我们的场景中对于增量数据不需要保证 Exactly Once 语义,只需要保证 At Least Once 语义。所以基于该背景,我们能够将数据处理层增量 Job 拆分为两个 Job 执行,一对多的问题得以解决。 这样我们在数据处理层就不需要去 Scan HoloTable 了,从而可以用全链路异步化的方式来提升增量整体性能。 截断优化 为了避免将多条数据转为一条数据之后由于数据量过大导致 FullGC 的“大行”问题。基于业务的特性,我们对于每个一对多表在 Scan 时支持截断功能,对于相同的第一 pk 记录,只 Scan 一定条数的记录出来组装为 Json,并且可以针对不同的表实现白名单配置。 加过滤 Window 优化 针对业务的特点,一对多的很多表虽然可以接受一定时间的延迟,但是为了避免对离线系统以及在线 BuildService 造成太大的冲击,所以更新不能太多,所以我们加了 30min 的去重窗口,这个窗口作用非常大,平均去重率高达 X% 以上。 五.结语 经过一系列优化,主搜不仅在资源上相对于老架构有不少的节省,而且同时实现全量高吞吐与增量低延迟,并且在 2019 年度双 11 零点应对突增流量时表现的游刃有余。 对系统进行性能调优是极其复杂且较精细的工作,非常具有技术挑战性。不仅需要对所选用技术工具(Flink/Blink)熟悉,而且对于业务也必须了解。加 window,截断优化,加盐打散大卖家等正是因为业务场景能容忍这些方法所带来的相应缺点才能做的。 除了本文提到的调优经验,我们对同步层全增量 Job 与 MultiGet 也进行了不少调优,篇幅原因与二八原则这里就不详细介绍了。 主搜成功迁移也使得搜索离线平台完成了最后一块拼图,成为阿里巴巴集团搜索中台以及核心链路的基础模块。 作者简介: 王伟骏,花名鸿历,阿里巴巴搜索推荐事业部高级开发工程师。2016 年硕士毕业于南京邮电大学。Apache Hadoop & Flink & Eagle Contributor。目前负责阿里巴巴搜索离线平台 Runtime 层相关工作。 另外,陈华曦(昆仑)给了本文很多建议,文中部分图由李国鼎(石及)贡献。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册