首页 文章 精选 留言 我的

精选列表

搜索[心智成长],共7678篇文章
优秀的个人博客,低调大师

开发成长之路(18)-- 大二时DIY的管理系统后端

2 --> 文章目录 前言 功能需求 数据包(后续项目用PB替代) 数据库单独配置 多服务器进程间通信 epoll模块 前言 本来我是觉得这个项目很拿不出手的,毕竟最后也没有经过压力测试等。甚至在投简历的时候都不敢提交上去。 但是昨天和辅导员交流之后,有什么不好意思的,就算我现在在做一个项目,也是难以达到人家的预期的。但是以一个大二,甚至大三的非软工专业的学生独立设计并写出这个项目,有什么好丢人的? 功能需求 我们先来看一下功能需求吧: 模块名 功能类别 子功能 本地云客户端 系统启动 本地云启动,初始化界面,软件版本以及其他初始化数据同步 用户注册 用户输入用户名、密码、密保手机号,注册一个新账号 用户登录 用户输入用户名、密码,登录到服务器获取用户储存的文件列表 修改密码 用户输入用户名、旧密码、新密码,完成修改密码 找回密码 用户输入用户名、密保手机,发送到服务器获取密码 文件列表 获取当前文件夹下应该出现的文件列表 文件上传 上传文件到指定文件夹 文件下载 从指定文件夹下载文件 本地下载文件管理 下载之后的文件应由本地文件夹管理 通信纪录 文件上传纪录、下载纪录获取 文件共享 生成链接与提取码,可将文件分享给其他用户 系统设置 配置服务的ip地址与端口等设置 – – – 本地云服务器 用户接入 接收客户端的连接,管理客户端信息 各业务处理 处理客户端的各类型业务 心跳处理 各组自定义 文件管理 对客户传输的文件进行管理 数据库设计与应用 各组自定义,服务于文件管理 并发负载 初始化30的处理线程 日志 每天生成一个运行日志,包括业务处理、运行情况、故障记录等 – – – 压力测试程序 单客户单业务测试 主要测试服务器单笔业务的处理能力和数据准确性 多客户多业务 不同种类业务,测试服务器吞吐量 测试报告 给出关键参数和测试结果,如:业务成功数、失败数、业务类型等 压力参数设置 每次测试时,用户可以自定义测试时长、业务类型、模拟客户端数等,并能保存到参数文件中 测试日志 记录每次测试结果,每天生成一个 以下为非功能性需求: 功能类别 功能说明 万级并发 要求一台服务器能够承受10000台以上的连接数接入 大并发业务 要求一台服务器能承受200-300并发业务处理 分布架构 采用TCP流协议进行进程间通信 系统拓展性 能够在尽量不修改源代码的前提下,拓展业务 系统安全 承受一些非法操作的轰炸 其实主要做的也就是这些非功能性需求,上面那些功能需求已经有做过的,稍加修改就好。 数据包(后续项目用PB替代) 一上来,当然是要协调各方,定下数据包协议了。 #ifndef I_PACKET_PUBLIC_H #define I_PACKET_PUBLIC_H #include <string> #include <iostream> using namespace std; #define MAX_LEN 256 /************接入层数据包头************/ typedef struct packet_header_st { int fd;//用于前后端通信即目标客户端fd(服务器用到) int funcId; // 功能号 //登录包0x01,注册包0x02,找回密码0x03,修改密码0x04 //客户端获取文件列表0x11,上传文件0x12,下载文件0x13,共享文件0x14 //心跳0x21 int optid; // 操作码:请求0x00 和 应答0x01 int usrlenth;// 包体的长度 int packet_seq; //包序号 int packet_sum; //包总数 char srcAddr[6]; //预留 char dstAddr[6]; //预留 int syn; // 判断包头是否正确 0x04 }packet_header_t; /************接入层数据包尾************/ typedef struct packet_tali_st//包尾,用来验证数据包的完整性 { int pack_tail;//设置为0x05 }packet_tali_t; /************数据包报文整体************/ typedef struct packet_all_st { packet_header_t head; char body[packet_header_t::usrlenth]; packet_tali_st tail; //unsigned len; //要发送的数据有效长度 }packet_all_st; /************业务层数据包体************/ //客户端登录请求包 typedef struct login { int id; char psw[10]; //密码 }Login_t; //登录应答包 typedef struct res_login_st { int login_ret; //登录结果: 1-登录成功,0-登录失败 }res_login_t; //客户端注册请求包 typedef struct Register { int id; //账号 char tel[12]; //11位手机号 char psw[10]; //密码 }Register_t; //注册应答包 typedef struct res_register_st { int register_ret; //注册结果: 0-注册成功,1-注册失败 }res_register_t; //客户端修改密码请求包 typedef struct Change_PWD { int id; //账号 char psw[10]; //密码 }c_pwd_t; //改密码应答包 typedef struct res_changepwd_st { int change_ret; //改密码结果: 0-改密码成功,1-改密码失败 }res_cpwd_t; //找回密码请求包 typedef struct findpwd { int id; char tel[12]; }F_Pwd_t; //找回密码应答包 typedef struct res_findpwd_st { int find_ret; //找回结果: 0-找回成功,1-找回失败 char pwd[20]; //密码 }res_fpwd_t; /************请求业务交易流水请求包************/ //上传文件请求包 typedef struct UpFile { int id; }UpFile_t; //下载视频请求包 typedef struct Download_File { int user_id; //用户ID char *file_id; //文件名 }Download_t; //文件列表请求包 typedef struct File_List { char *dir_name; //目录名 }FileList_t; //文件列表应答包 typedef struct Res_VideoList { char V[800]; }res_filelist; #endif // PACKET_BASE_H 但是过早的定下数据包,难免日后不会有修改,之前也确实是深受其扰,直到我接触了PB协议。我觉得这个现象可以得到有效的改善了。 数据库单独配置 曾经我也很喜欢将数据库的初始化放到主程序中,直到后来去跟我开发N年的表哥吹牛的时候,他说:你数据库的初始化放这里干嘛?嫌开机太快?不怕重复初始化? 哦,好有道理,好像很有道理,确实很有道理。 然后我就改了,我的数据库等需要初始化的外部依赖从此单独初始化!!! 还有,我之所以选择sqlite,而不选择MySQL,甚至于谨慎使用redis,也是跟另一个在游戏公司负责后端开发的学长交流之后,学长跟我说:你这还没开发就把性能限制死了啊,你这数据每次调度都要走两层IO,又不是说什么很大量的数据。你知道在后端开发中,最脆弱的是什么吗?不是高负载的运算,是IO,IO才是最脆弱的。 好,我改。他们都是前辈,我还在象牙塔里,话说也该再约学长出来吃个饭了。 代码太长,只争早夕,整理在这里:FTP文件管理项目(本地云)项目日报(二) 多服务器进程间通信 主要是感觉如果以后要加入新的进程,两两相连的服务会有点尴尬。于是想出了这么个主意。但是不足的地方也很明显,如果中间那个服务给崩了,那一切都免谈了,而且中间那个服务的压力也是很大的(其实大不到哪里去吧,只是个转接的,而且中间不一定要是一个服务啊,可以做一个集群,这个当时倒是没有想到) 中介者服务器(中控)采用accept,边缘服务器全部采用connect,在连接成功后向中控中心汇报自己的情况(fd对应的服务器名是啥,方便通信),奈何我天资愚钝,这个图我想了一晚上。 epoll模块 责任链模式。 详细介绍:FTP文件管理项目(本地云)项目日报(六)

优秀的个人博客,低调大师

【开发者成长】一文详解JS垃圾回收机制

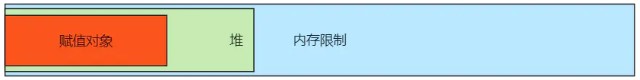
云栖号资讯:【点击查看更多行业资讯】在这里您可以找到不同行业的第一手的上云资讯,还在等什么,快来! V8的内存限制 我们先抑后扬,Node不同于其他后端语言,Node在对系统的内存使用中,只能使用到系统的部分内存,比如64位系统只能使用1.4GB,32位系统只能使用0.7GB。随之到来的问题是Node采用单线程,就导致每个线程无法对大的内存对象进行处理,比如将一个2GB的文件读入内存进行字符串分析处理,即使你有16G的物理内存。 V8的对象分配 在javascript中我们的基本类型存储在栈中,所有对象都分配给了堆处理。我们每赋值一个对象,该对象的内存就会分配在堆中。如果已申请堆所剩内存不足以分配新的对象,将会继续申请新内存,直到堆的大小超过V8的内存大小限制为止。 至于V8的内存限制,起源于V8本身是chrome为浏览器设计而生,而浏览器中对于网页来说,V8控制的内存绰绰有余。还源于V8设计者对于V8的垃圾回收机制的限制,官方以1.5GB的垃圾回收堆内存为例,V8执行一个小的垃圾回收要使用50毫秒以上,做一次常规非增量式垃圾回收要在1秒以上。 最关键的,javascript的垃圾回收会对javascript执行线程形成阻塞,作为一个开发人员你应该能够清楚时长1秒的进程阻塞,对你的项目性能的影响,故此V8的设计者采用了对堆内存进行限制的策略。 V8的内存分代 V8的垃圾回收策略主要基于分代,那么怎么分代呢? 在V8中,主要将内存分为新生代和老生代两类。新生代指的是那些存活时间较短的对象,老生代指的是存活时间较长的或者常驻内存的对象。而新生代加老生代的对象所占空间大小就是V8的堆的整体大小。 补充知识点:V8提供了设置新生代和老生代最大内存值的方式,从而可以调整V8的整体内存限制,使用更多的内存空间。 V8的主要垃圾回收算法 **Scanvenge算法**Scanvenge是一种复制形式的垃圾回收算法,是应用于新生代对象中的一种垃圾回收算法,算法首先将堆内存一分为二,两部分空间一半用来分配赋值的对象,叫做From空间,另一半处于空闲的叫做To空间。 为什么要有一半空间用来闲置呢?这不是让我们的可用内存更小了吗? 当我们为堆分配对象时,会将分配对象放到From空间中存储,在V8的垃圾和回收过程中,会首先检查From中存活的对象(什么是存活的对象,就是指那些还被继续引用没有完全释放的对象),V8会将From中存活的对象夫妇复制到To空间中,同时清理掉已经被释放的对象空间。完成该过程From空间和To空间即完成了角色对换,也就是在下一次回收中,之前的From空间变成了To空间,之前的To空间变成了From空间。 这样我们来重新定义一下: 用来存放对象的一半是From空间,处于闲置状态的一半是To空间。 Scanvenge算法明显的缺点就是只能使用堆内存的一半,但是随之带来的好处就是它在时间效率上的优异的表现,属于典型的牺牲空间换取时间的算法。 需要强调的是,开头提到的Scanvenge算法是应用于新生代对象中的一种垃圾回收算法,因为新生代对象中的生命周期较短的特性,也契合于该算法优先时间考虑的特性。 怎样算生命周期较长的对象? 当一个对象经过多次复制依然存活时,它将会被认为是生命周期较长的对象。这种生命周期较长的对象随后会被移动到老生代对象中,采用新的算法(Mark-Sweep&Mark-Compact)进行管理,这个过程称为晋升。 通过上图可以了解到,对象进行垃圾回收是怎样从From到To之间转换的,那么这个晋升的过程在哪儿体现呢? 在默认情况下,V8对新生代对象进行从From到To空间进行复制时,会先检查它的内存地址来判断这个对象是否已经经历过一次Scanvenge回收。如果已经经历过,那么会将该对象从From空间直接复制到老生代空间,如果没有,才会将其复制到To空间。 以上,我们讲述的就是一个新生代对象如何晋升为老生代对象的第一个条件“对象是否经历过Scanvenge回收”,那么第二个条件也许你会更困惑,超出限制?多少算在限制?怎么超出? 假设一个对象像刚才说的没有经历过Scanvenge回收,要将它复制到To空间之前,还要再进行一次检查。检查To空间是否已经使用了超过25%,如果To空间超过25%,该对象将直接被晋升到老生代空间进行管理。 完整看一下这个流程: 对象晋升后,该对象即成为老生代中的存活周期较长的对象,所以我们可以重新对老生代进行定义:老生代对象为存活周期较长或常驻内存的对象,或为新生代对象回收中溢出的对象。 至于为什么设置25%的原因是,当一次Scanvenge回收完成时,To空间变为From空间,如果新的From空间使用占比过高,将对接下来的内存分配到这个新的From空间过程存在很大的影响。 Mark-Sweep&Mark-Compact算法 接下来,讲一下老生代中的对象使用的回收算法,这种算法(Mark-Sweep)也是我们常说的垃圾回收中的标记清除算法。 首先,老生代空间不会一分为二,老生代空间进行垃圾回收时,首先是标记阶段。V8会在标记阶段遍历老生代空间中的所有对象,并标记存活的对象(即还没有被完全释放的对象),在随后的清除阶段,会将所有未标记的老生代对象全部回收。 再来张图: 如果你稍微有点强迫症,你就发现这张图有点问题。Mark-Sweep在执行完清除之后,导致内存空间出现不连续的情况,就像你的磁盘分析图一样。 这样会带来的一个问题就是,当你需要分配一个较大的对象时,剩余的内存因为碎片化的原因,没有任何一个内存碎片足以分配给这个大的对象内存空间,就会导致提前触发垃圾回收,而这次回收是不必要的。 所以Mark-Compact算法随之而生,Mark-Compact比Mark-Sweep增加了一个整理的概念,它的回收执行顺序是标记—整理—清除。Mark-Compact所谓的整理概念是指在对象同样被标记为存活后,会将活着的对象往一端移动,移动完成后在直接清理掉死亡的对象内存。 不要晕,来张图,你就可以的: 两种差别显而易见,Mark-Compact算法执行后的内存空间更合理。但是因为Mark-Compact算法需要移动对象,随之导致的就是它的执行速度没有Mark-Sweep快。 所以在V8中主要使用Mark-Sweep算法,只有在空间不足以对新生代中晋升过来的对象进行分配时,才会使用Mark-Compact算法进行回收。 Incremental Marking算法 因为垃圾回收会阻塞javascript的运行,故此老生代对象又因为其占用空间大,存活对象多的特点,对其进行标记,整理,回收的过程引起的阻塞要远远比新生代对象回收过程一起的阻塞要严重的多,Incremental Marking算法成为了优化老生代对象耗时的算法选择。 为了降低老生代空间垃圾回收带来的停顿影响,V8 采用了增量标记(incremental marking)的算法。将原本一口气停顿完成的来及回收过程拆分为许多小“步进”,每做完一“步进”就让JavaScript应用逻辑继续执行一小会儿,垃圾回收与应用逻辑交替执行直到标记阶段完成。取得的效果就是,将老生代空间垃圾回收的最大停顿时间可以减少到原本的1/6左右。 有点晕,不要怕,咱有图: V8 后续还引入了延迟清理(lazy sweeping)、增量式整理(incremental compaction)、并发标记 等技术,其实看名字你也能理解大概,可以自行查阅。 扩展知识 相信上面的东西已经让你们明白,V8的垃圾回收机制是如何运行的。但是你还需要知道我们的代码中是如何触发、影响垃圾回收的,这就不得不掏出老生常谈的作用域和闭包。 作用域 在javascript中作用域有全局作用域和局部作用域,在这里,我们着重关注作用域对垃圾回收的影响。假设一个函数调用产生的作用域: 这是一个函数表达式,foo()函数在每次调用时会创建一个作用域,同时也会在该作用域创建一个局部变量local。函数执行结束,该作用域也会随之销毁,同时该作用域中声明的局部变量也会随作用域销毁而销毁。在这个实例中,由于局部变量引用的对象存活周期较短,将会分配在新生代空间的From中。作用域销毁后,其中的变量也随之被释放,该对象所占用的空间在下次垃圾回收时将会被清理。 作用域链 在这个实例中,bar()中执行console,在当前函数作用于查找不到local变量,将会继续向上查找,查找上级最近的作用域,如果找到变量local,就会停止查找。如果找不到会一直查找到全局作用域,如果该变量在所有作用域都不存在,将会抛出未定义错误。 变量的主动释放 如果变量是全局变量,需要注意的是全局作用域中的变量不会执行垃圾回收过程,此类对象将会常驻内存(在老生代空间)。如果需要释放该类对象空间,只能通过delete或重新赋值变量为undefind或者null来释放对象的引用。 闭包 什么叫闭包,历史争议问题啊。我们暂可以将能使外部作用域访问内部作用于中的变量的方法叫做闭包。 闭包对垃圾回收带来的影响也随之出现,一旦有变量引用中间函数,这个中间函数将无法被释放,同时也会是该作用域无法释放,自然作用域中的变量也不会被释放并回收,除非不在被引用,该函数才会被逐渐释放。 不得不说全局变量和闭包是项目中不可缺少的角色,但是需对该类变量谨慎使用,防止在你的项目中这种无法轻易被释放的变量所占内存越来越多,结果就是你不想看到的内存泄露。 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/zhibo 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK 原文发布时间:2020-03-20本文作者:龙小胖本文来自:“掘金”,了解相关信息可以关注“掘金”

优秀的个人博客,低调大师

人工智能大潮下,如何成长为首席 AI 架构师?

2020年突发的新冠病毒疫情让全国大部分学校陆续“转战线上”,3月3日,首席AI架构师的“AI大课”——百度黄埔学院第三期也将以“线上预科班”的全新方式启动招募。 去年1月,百度联合“深度学习技术及应用国家工程实验室”成立黄埔学院,旨在为各行各业培养理论、技术、应用三位一体的“首席AI架构师”。经过一年两期的集中培训与研修,已为能源、制造、通信、医疗、金融等十余个行业培养输送了70位能够操刀复杂场景下AI应用落地的技术领军人才。此次,百度黄埔学院第三期招募时间将从3月3日持续到4月30日,并首次增设“线上预科班”。聚焦前沿、深度AI技术,高工“大牛”网络相见,不必出门也能学习“充电”。 报名期增设“线上预科班”,AI硬核技术学习不等待 “线上预科班”将面向通过审核的报名者,于招募开启两周后(3月16日),以每周一次的频率,由百度AI技术体系的高工们进行直播分享,开启高含金量的线上“迷你版”黄埔学院授课模式,带领全体学员剖析AI前沿技术与实际应用案例。课程内容包括“不同材质的毫米级瑕疵质检”、“无人巡检在多个行业的落地应用”,抗疫一线的“北京清河高铁站防疫筛查解决方案”等等,都是前沿、专业的“第一手”硬核AI技术干货! 关于报名资格和录取标准,申请者需在具备丰富AI升级应用和落地场景的企业中担任关键技术岗位或技术管理岗位,拥有两年以上深度学习从业经验,并线上通过“深度学习技术能力测评”。满足条件的申请者,可在3月3日到4月30日整个招募期间随时加入“线上预科班”学习,错过了直播课程也没有关系,百度AI Studio将为学员们提供回看课程、查阅课程资料的机会。同时,所有往届黄埔学院学员,都可以直接进入线上预科班,继续更新首席AI架构师的“知识版图”。 百度黄埔学院第三期介绍 黄埔学员优中选优,向行业持续输出AI技术与应用复合型人才 “线上预科班”结束后,黄埔学院将综合评估学员学习进度、项目开题报告等情况,从预科班学员中筛选80位学员参加黄埔学院第三期正式的线下课程。对比往期,在经济形势日益严峻的当下,黄埔学院以增设学习名额的方式,希望为更多企业提供智能化升级助力。 入选学员将参与到4次面对面、高信息密度的研修课程中。为了更好地帮助企业用AI思维、AI工具、方法和技术解决实际业务问题,黄埔学院三期在正式开课前要求学员提交“AI项目开题报告”,明确自身企业的AI落地目标,有助于在正式课程中更好地学习和交流,做到有的放矢。与之相匹配的,在线下课程中新增“案例分享”与“项目研讨”环节,为学员创造出更好的开放讨论与分享环境。基于百度提供的,全面开源开放、功能完备的产业级深度学习平台飞桨,学员们将以解决企业实际应用问题为目标,深入沟通交流,提升“能力值”,拓宽“朋友圈”。 百度黄埔学院第二期线下研修课 在百度黄埔学院二期的毕业典礼上,百度集团副总裁、深度学习技术及应用国家工程实验室副主任、黄埔学院院长吴甜指出,人工智能大规模应用进入关键时期,既懂AI技术和逻辑原理,又懂行业场景痛点和诉求的复合型人才,将成为中坚力量。而在这一关键时期,百度黄埔学院在持续以“尖端技术+落地实践”的方式,着眼AI复合型人才培养,将自身AI技术实力赋能至各个行业高端技术人才,将加速助力中国人工智能产业落地进程,进而助推各个产业进行智能化升级,创造出更大价值。 授之予兵器,赋之予能量,百度黄埔学院第三期招募已正式启动。期待有志于成为首席AI架构师的精英共同加入,用AI改变世界。 点击以下链接报名:https://iwenjuan.baidu.com/?code=s9xtn5 >> 访问 PaddlePaddle 官网,了解更多相关内容。

优秀的个人博客,低调大师

阿里云伴我成长——记那些年我考过的阿里云认证

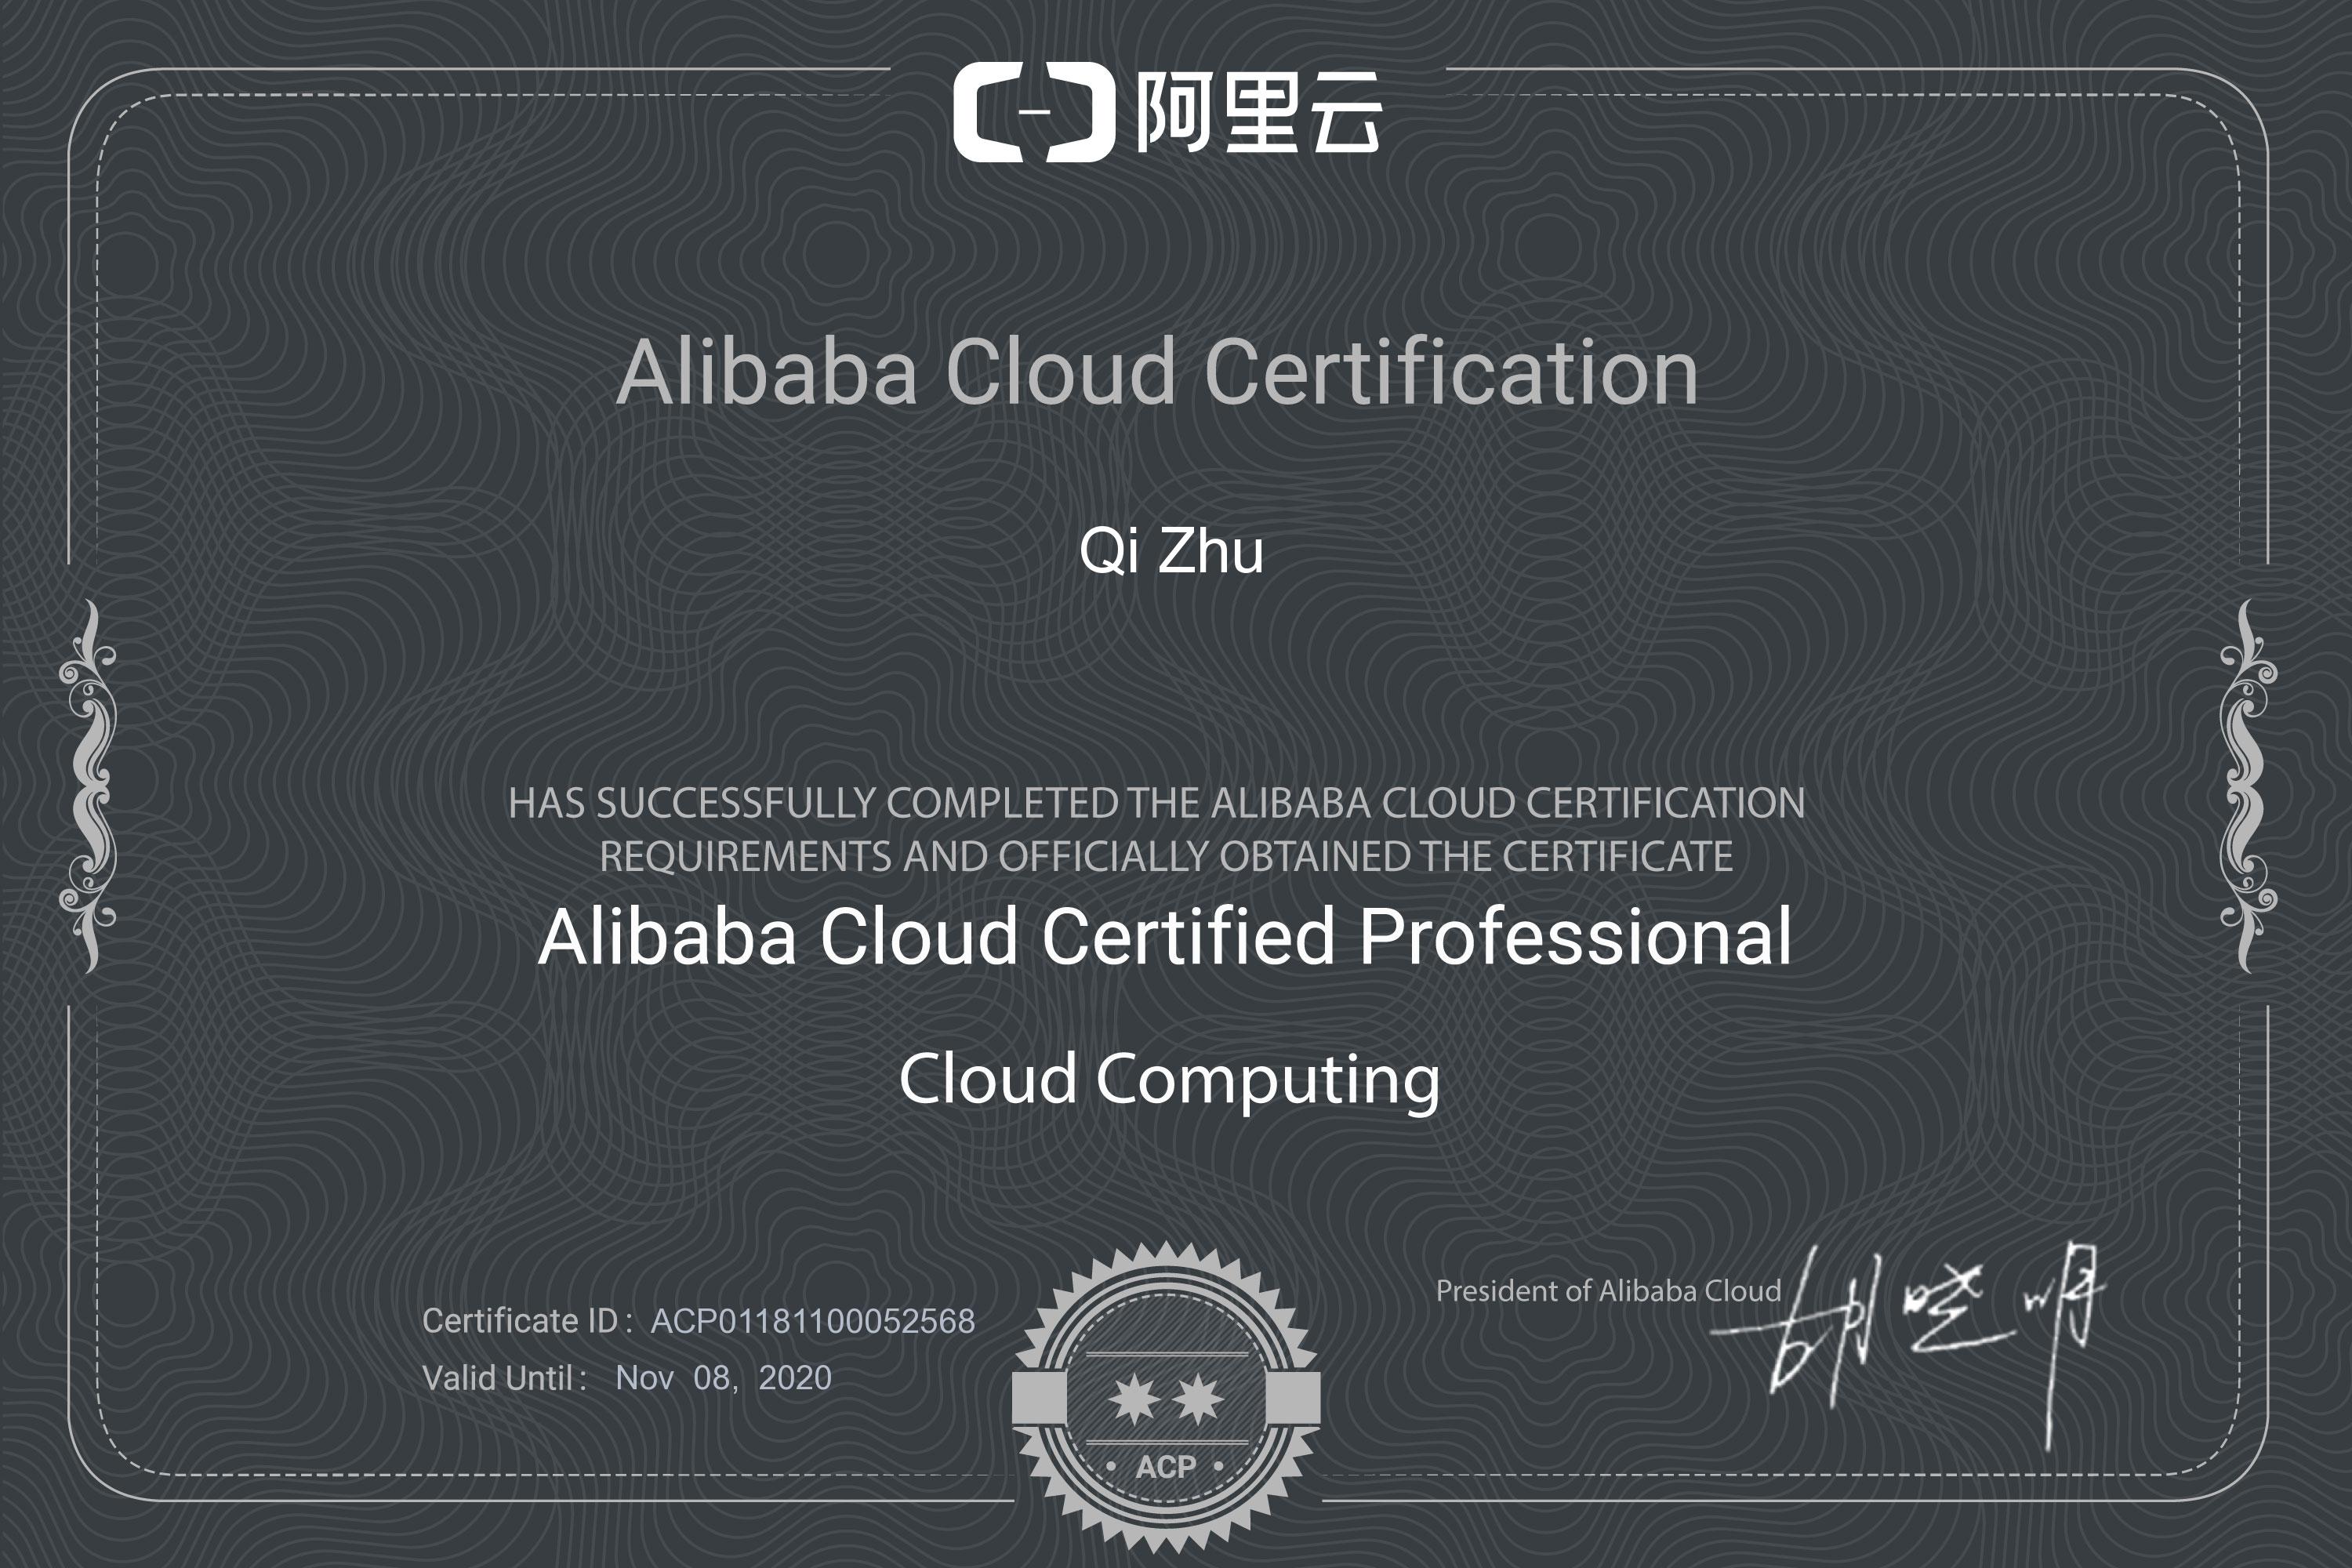
前言 特殊的春节使自己在家里能够有足够时间来回顾下自己几年来参加的阿里云认证考试,目前总共有云计算和大数据两项ACP认证,全部领域ACA认证和数项APSARA CLOUDER专项认证,系统的梳理了下这些认证的特点和作用以作为一个过来人为大家自己设计学习路径作为一个参考。——阿里云全球MVP 朱祺 ACP部分 阿里云云计算ACP是我通过的第一个ACP认证,考试之前记得经历了半年左右的学习和准备,并且先期通过了ACA的认证,因为考试只是一个结果,最关键的是在准备考试过程中不断提高自己的技能水平。阿里云大数据ACP是通过的第二个ACP认证,看网上说几个ACP考试中建议先考云计算再考大数据,这个顺序是对的,但是绝对不是因为云计算较为简单而大数据比较难,而是因为云计算是学习大数据的基础,没有云计算则大数据没有足够的计算力。 ACA部分 云计算ACA的意义是检验自己云计算的基础知识掌握情况并作为考取ACP的准备,云计算ACP除了理论还有大量实际落地场景考题,而理论部分并没有比ACA难多少,因此不能武断的说因为是基础认证ACA就不重要,个人意见是非常重要。大数据ACA的意义是检验自己大数据的基础知识掌握情况并作为考取ACP的准备,同云计算稍微有点不同并且估计也是大部分人认为大数据比云计算的难的地方是大数据的考题集中在MAXCOMPUTE上,云计算如果说某一块掌握的不好那还可以通过其他部分弥补,那大数据考试如果MAXCOMPUTE和SQL语言掌握不好那几乎就没有通过的可能。而大数据ACP不像云计算ACP在网上有非常多的参考资料并且阿里云的大数据产品也在不断升级迭代因此在考大数据ACP之前通过ACA考试来熟悉下考题套路和自己技术的掌握情况是非常有必要的。云安全我考取了ACA但并没有去进一步考ACP,因为网络安全不是我工作的重点,因此个人的要求就是了解即可。通过ACA的课程和考试,最够对于云安全的基础知识有个全方位的了解,包括常见的攻击方式,网络基础知识复习和阿里云云安全各项产品的特点等。物联网ACA是阿里云最新出的ACA认证,目前尚没有ACP认证,从难度上来说是比较大的,因为物联网独特的特性造成知识结构非常分散,物联网四层感知层、网络层、平台层和应用层每层其实都可以单独作为一门学科来深入研究,因此阿里云物联网ACA的主要特点就是广而不深。考题上集中在网络层和平台层,平台层相对简单就是阿里云的ALIOS物联网平台和LINK TEE产品,网络层的考题非常杂覆盖各种传输协议,总体偏向无线传输比如LORA、NBIOT和WIFI等,有线部分的考题并不多。 APSARA CLOUDER专项认证 这门课程和考试可以作为云计算ACP和ACA在负载均衡(SLB)方面的集中学习资料。云计算ACP和ACA考题中,负载均衡部分的考题非常多,是重中之重。这门课程和考试可以作为云计算ACP和ACA在弹性伸缩方面的集中学习资料。云计算ACP和ACA考题中,弹性伸缩部分的考题同样非常多,体现的是云计算的最重要特性。这门课程和考试可以作为云计算ACP和ACA在云服务器(ECS)方面的集中学习资料。ECS的重要性几乎不用描述,就是整个阿里云的核心,如果ECS不掌握基本等于不会云计算。这门课程和考试可以作为云计算ACP和ACA在VPC方面的集中学习资料。VPC的考题不如前几部分集中,但是混合云和专有云作为两种常见的云架构,VPC的知识在实际工作中有非常大的价值。这是阿里云产品的三个落地场景,主要目的是学习云计算和大数据在实际场景中的应用,包括使用大数据产品MAXCOMPUTE和人工智能平台PAI的操作,毕竟学习的主要目的是用于实际场景,由于大数据和云计算的各类产品间是一环扣一环的关系因此有必要通过几次落地实验来全流程的操作一下从数据接入到数据清洗、数据分析、数据挖掘、数据输出和模型输出的全流程。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册