首页 文章 精选 留言 我的

精选列表

搜索[编译原理],共10000篇文章
优秀的个人博客,低调大师

分布式日志收集系统Scribe原理

1.分布式日志收集系统:背景介绍 许多公司的平台每天会产生大量的日志(一般为流式数据,如,搜索引擎的pv,查询等),处理这些日志需要特定的日志系统,一般而言,这些系统需要具有以下特征: (1) 构建应用系统和分析系统的桥梁,并将它们之间的关联解耦; (2) 支持近实时的在线分析系统和类似于Hadoop之类的离线分析系统; (3) 具有高可扩展性。即:当数据量增加时,可以通过增加节点进行水平扩展。 2.分布式日志收集系统:Facebook Scribe主要内容 (1)Scribe简介及系统架构 (2)Scribe技术架构 (3)Scribe部署结构 (4)Scribe主要功能和使用方案 (5)Scribe的具体应用实例 (6)Scribe的扩展 (7)Scribe研究体会 3.Scribe简介 Scribe是facebook开源的日志收集系统,在facebook内部已经得到大量的应用。 Scribe是基于一个使用非阻断C++服务器的thrift服务的实现。它能够从各种日志源上收集日志,存储到一个中央存储系统 (可以是NFS,分布式文件系统等)上,以便于进行集中统计分析处理。它为日志的“分布式收集,统一处理”提供了一个可扩展的,高容错的方案。 4.Scribe的系统架构 如上图所示:Scribe从各种数据源上收集数据,放到一个共享队列上,然后push到后端的中央存储系统上。当中央存储系统出现故障时,scribe可以暂时把日志写到本地文件中,待中央存储系统恢复性能后,scribe把本地日志续传到中央存储系统上。 5.Scribe的技术架构 如上图所示:Scribe服务器底层数据通信框架是Thrift,Thrift也是Facebook开源的,并得到了广泛的使用。也用到了C++的准标准库boost,主要使用共享指针和文件相关的功能。Thrift也用到了libevent开发库和socket编程技术。 6.Scribe部署结构 7.Scribe的主要功能 1.支持多种存储类型:7种并且可扩展 2.日志自动切分功能:按文件大小和时间切分 3.灵活的客户端: (1)支持多种常用语言(Thrift提供支持); (2)可与应用系统集成;可以作实现独立客户端 4.支持日志分类功能(Facebook有上百种日志分类) 5.其他功能 (1)连接池 (2)灵活的日志缓存大小 (3)多线程功能(消息队列) (4)scribe服务器之间可以转发日志 6.以上功能都是可以通过配置文件来灵活配置 8.Scribe使用方案 (1)和产生日志文件的应用系统集成 scribe能够和各种应用系统很好的集成是因为它提供几乎所有的开发语言的开发包 (2)应用系统在本地产生日志文件,使用一个独立运行的客户端程序同样,独立的客户端也可以采用各种语言开发,我们采用的是Python来开发客户端 9.Scribe的具体应用实例 1.Facebook肯定大量的使用,主要用于处理Facebook级别日志,一旦有新的日志分类生成,Scribe将自动处理。(Facebook有上百个日志分类)。 2. Twitter:一款分布式实时统计系统Rainbird使用了scribe 10.Scribe的扩展:存在的问题 虽然scribe系统是如此的优秀,但是也存在着一些不足和问题,针对存在的问题我们对scribe进行扩展。我们发现scribe存在的主要问题如下: 1、单点故障问题 有三个地方存在单点故障: (1)中心服务器 (2)本地服务器 (3)收集日志的客户端程序 2、日志丢失问题 当日志文件发生切分的时候可能导致日志丢失 3、历史日志收集问题 4、scribe服务器挂了没有及时通知 11.Scribe的扩展:问题解决方案 针对上面我们提出的问题,主要提供如下相应的解决方案: 1.中心服务器单点故障 可以部署多个中心服务器,然后本地服务器通过配置文件可以自动在这些服务器之间进行切换 2.其余的问题我们都是通过自己写的python客户端解决的 python客户端我们是基于一个开源的项目进行二次开发的,因为开源的python客户端功能很简单,只是跟踪一个日志文件并把日志文件的数据读取导入到scribe本地服务器 12.Scribe的扩展:python客户端 我们开发的python客户端主要实现了如下功能: 1、解决本地scribe服务器的单点故障 我们可以通过配置多个本地scribe服务器(通过配置文件配置,相当的灵活),python脚本会根据配置的这些服务器自动切换(当一个scribe挂掉之后自动切换,如果挂掉本地scribe服务器重新启动以后又会自动切换回去。 2、解决日志丢失的问题 开源的python客户端是按照固定的时间间隔扫描日志文件是否有变化,如果在这个时间段内发生日志切换会导致日志丢失。我们同样是采用这个方式去检测日志文件,不过我们在发生日志切分的时候会再次去检测被切分走得日志文件是否已经收集完毕。 3、解决历史日志收集 如果在我们运行python客户端以前已经产生了日志,这部分的日志收集也是我们新增的一个功能 4、解决自身的单点故障问题 不排除我们的python客户端也会挂掉的时候,当我们下次启动怎样保证我们收集的日志不重复不丢失是需要解决的问题。我们的解决方案就是对已经收集的日志文件的各种信息做序列化(主要是已经收集日志文件的位置) 5、收集日志文件怎样保证按照日志生成的顺序收集 日志的生成顺序就是跟他们文件的建立时间是相关的,通过这一点我们可以实现。 6、及时通知机制 为了及时的通知到scrib服务器挂掉的信息到相关人员,我们开发了邮件通知机制,就是当某一个本地scribe服务器挂掉以后会触发邮件发送 13.Scribe研究体会 怎样从我们工作的内容深入学习? 1.每个人在公司负责开发的内容都是很有限的,怎样从我们开发的内容入手深入研究和学习更多的知识? 2.Scribe研究的例子! 本文转自里冲51CTO博客,原文链接:http://blog.51cto.com/coollast/1886501 ,如需转载请自行联系原作者

优秀的个人博客,低调大师

ElasticSearch的基本原理与用法

一、简介 ElasticSearch和Solr都是基于Lucene的搜索引擎,不过ElasticSearch天生支持分布式,而Solr是4.0版本后的SolrCloud才是分布式版本,Solr的分布式支持需要ZooKeeper的支持。 这里有一个详细的ElasticSearch和Solr的对比:http://solr-vs-elasticsearch.com/ 二、基本用法 集群(Cluster):ES是一个分布式的搜索引擎,一般由多台物理机组成。这些物理机,通过配置一个相同的cluster name,互相发现,把自己组织成一个集群。 节点(Node):同一个集群中的一个Elasticearch主机。 Node类型: 1)data node: 存储index数据。 2)client node: 不存储index,处理客户端请求。 3)master node:不存储index,集群管理,如管理路由信息(routing infomation),判断node是否available,当有node出现或消失时重定位分片(shards),当有node failure时协调恢复。(所有的master node会选举出一个master leader node) 主分片(Primary shard):索引(下文介绍)的一个物理子集。同一个索引在物理上可以切多个分片,分布到不同的节点上。分片的实现是Lucene 中的索引。 注意:ES中一个索引的分片个数是建立索引时就要指定的,建立后不可再改变。所以开始建一个索引时,就要预计数据规模,将分片的个数分配在一个合理的范围。 副本分片(Replica shard):每个主分片可以有一个或者多个副本,个数是用户自己配置的。ES会尽量将同一索引的不同分片分布到不同的节点上,提高容错性。对一个索引,只要不是所有shards所在的机器都挂了,就还能用。 索引(Index):逻辑概念,一个可检索的文档对象的集合。类似与DB中的database概念。同一个集群中可建立多个索引。比如,生产环境常见的一种方法,对每个月产生的数据建索引,以保证单个索引的量级可控。 类型(Type):索引的下一级概念,大概相当于数据库中的table。同一个索引里可以包含多个 Type。 文档(Document):即搜索引擎中的文档概念,也是ES中一个可以被检索的基本单位,相当于数据库中的row,一条记录。 字段(Field):相当于数据库中的column。ES中,每个文档,其实是以json形式存储的。而一个文档可以被视为多个字段的集合。比如一篇文章,可能包括了主题、摘要、正文、作者、时间等信息,每个信息都是一个字段,最后被整合成一个json串,落地到磁盘。 映射(Mapping):相当于数据库中的schema,用来约束字段的类型,不过 Elasticsearch 的 mapping 可以不显示地指定、自动根据文档数据创建。 Elasticsearch集群可以包含多个索引(indices),每一个索引可以包含多个类型(types),每一个类型包含多个文档(documents),然后每个文档包含多个字段(Fields),这种面向文档型的储存,也算是NoSQL的一种吧。 ES比传统关系型数据库,对一些概念上的理解: Relational DB -> Databases -> Tables -> Rows -> Columns Elasticsearch -> Indices -> Types -> Documents -> Fields 从创建一个Client到添加、删除、查询等基本用法: 1、创建Client public ElasticSearchService(String ipAddress, int port) { client = new TransportClient() .addTransportAddress(new InetSocketTransportAddress(ipAddress, port)); } 这里是一个TransportClient。 ES下两种客户端对比: TransportClient:轻量级的Client,使用Netty线程池,Socket连接到ES集群。本身不加入到集群,只作为请求的处理。 Node Client:客户端节点本身也是ES节点,加入到集群,和其他ElasticSearch节点一样。频繁的开启和关闭这类Node Clients会在集群中产生“噪音”。 2、创建/删除Index和Type信息 // 创建索引 public void createIndex() { client.admin().indices().create(new CreateIndexRequest(IndexName)) .actionGet(); } // 清除所有索引 public void deleteIndex() { IndicesExistsResponse indicesExistsResponse = client.admin().indices() .exists(new IndicesExistsRequest(new String[] { IndexName })) .actionGet(); if (indicesExistsResponse.isExists()) { client.admin().indices().delete(new DeleteIndexRequest(IndexName)) .actionGet(); } } // 删除Index下的某个Type public void deleteType(){ client.prepareDelete().setIndex(IndexName).setType(TypeName).execute().actionGet(); } // 定义索引的映射类型 public void defineIndexTypeMapping() { try { XContentBuilder mapBuilder = XContentFactory.jsonBuilder(); mapBuilder.startObject() .startObject(TypeName) .startObject("properties") .startObject(IDFieldName).field("type", "long").field("store", "yes").endObject() .startObject(SeqNumFieldName).field("type", "long").field("store", "yes").endObject() .startObject(IMSIFieldName).field("type", "string").field("index", "not_analyzed").field("store", "yes").endObject() .startObject(IMEIFieldName).field("type", "string").field("index", "not_analyzed").field("store", "yes").endObject() .startObject(DeviceIDFieldName).field("type", "string").field("index", "not_analyzed").field("store", "yes").endObject() .startObject(OwnAreaFieldName).field("type", "string").field("index", "not_analyzed").field("store", "yes").endObject() .startObject(TeleOperFieldName).field("type", "string").field("index", "not_analyzed").field("store", "yes").endObject() .startObject(TimeFieldName).field("type", "date").field("store", "yes").endObject() .endObject() .endObject() .endObject(); PutMappingRequest putMappingRequest = Requests .putMappingRequest(IndexName).type(TypeName) .source(mapBuilder); client.admin().indices().putMapping(putMappingRequest).actionGet(); } catch (IOException e) { log.error(e.toString()); } } 这里自定义了某个Type的索引映射(Mapping),默认ES会自动处理数据类型的映射:针对整型映射为long,浮点数为double,字符串映射为string,时间为date,true或false为boolean。 注意:针对字符串,ES默认会做“analyzed”处理,即先做分词、去掉stop words等处理再index。如果你需要把一个字符串做为整体被索引到,需要把这个字段这样设置:field("index", "not_analyzed")。 详情参考:https://www.elastic.co/guide/en/elasticsearch/guide/current/mapping-intro.html 3、索引数据 // 批量索引数据 public void indexHotSpotDataList(List<Hotspotdata> dataList) { if (dataList != null) { int size = dataList.size(); if (size > 0) { BulkRequestBuilder bulkRequest = client.prepareBulk(); for (int i = 0; i < size; ++i) { Hotspotdata data = dataList.get(i); String jsonSource = getIndexDataFromHotspotData(data); if (jsonSource != null) { bulkRequest.add(client .prepareIndex(IndexName, TypeName, data.getId().toString()) .setRefresh(true).setSource(jsonSource)); } } BulkResponse bulkResponse = bulkRequest.execute().actionGet(); if (bulkResponse.hasFailures()) { Iterator<BulkItemResponse> iter = bulkResponse.iterator(); while (iter.hasNext()) { BulkItemResponse itemResponse = iter.next(); if (itemResponse.isFailed()) { log.error(itemResponse.getFailureMessage()); } } } } } } // 索引数据 public boolean indexHotspotData(Hotspotdata data) { String jsonSource = getIndexDataFromHotspotData(data); if (jsonSource != null) { IndexRequestBuilder requestBuilder = client.prepareIndex(IndexName, TypeName).setRefresh(true); requestBuilder.setSource(jsonSource) .execute().actionGet(); return true; } return false; } // 得到索引字符串 public String getIndexDataFromHotspotData(Hotspotdata data) { String jsonString = null; if (data != null) { try { XContentBuilder jsonBuilder = XContentFactory.jsonBuilder(); jsonBuilder.startObject().field(IDFieldName, data.getId()) .field(SeqNumFieldName, data.getSeqNum()) .field(IMSIFieldName, data.getImsi()) .field(IMEIFieldName, data.getImei()) .field(DeviceIDFieldName, data.getDeviceID()) .field(OwnAreaFieldName, data.getOwnArea()) .field(TeleOperFieldName, data.getTeleOper()) .field(TimeFieldName, data.getCollectTime()) .endObject(); jsonString = jsonBuilder.string(); } catch (IOException e) { log.equals(e); } } return jsonString; } ES支持批量和单个数据索引。 4、查询获取数据 // 获取少量数据100个 private List<Integer> getSearchData(QueryBuilder queryBuilder) { List<Integer> ids = new ArrayList<>(); SearchResponse searchResponse = client.prepareSearch(IndexName) .setTypes(TypeName).setQuery(queryBuilder).setSize(100) .execute().actionGet(); SearchHits searchHits = searchResponse.getHits(); for (SearchHit searchHit : searchHits) { Integer id = (Integer) searchHit.getSource().get("id"); ids.add(id); } return ids; } // 获取大量数据 private List<Integer> getSearchDataByScrolls(QueryBuilder queryBuilder) { List<Integer> ids = new ArrayList<>(); // 一次获取100000数据 SearchResponse scrollResp = client.prepareSearch(IndexName) .setSearchType(SearchType.SCAN).setScroll(new TimeValue(60000)) .setQuery(queryBuilder).setSize(100000).execute().actionGet(); while (true) { for (SearchHit searchHit : scrollResp.getHits().getHits()) { Integer id = (Integer) searchHit.getSource().get(IDFieldName); ids.add(id); } scrollResp = client.prepareSearchScroll(scrollResp.getScrollId()) .setScroll(new TimeValue(600000)).execute().actionGet(); if (scrollResp.getHits().getHits().length == 0) { break; } } return ids; } 这里的QueryBuilder是一个查询条件,ES支持分页查询获取数据,也可以一次性获取大量数据,需要使用Scroll Search。 5、聚合(Aggregation Facet)查询 // 得到某段时间内设备列表上每个设备的数据分布情况<设备ID,数量> public Map<String, String> getDeviceDistributedInfo(String startTime, String endTime, List<String> deviceList) { Map<String, String> resultsMap = new HashMap<>(); QueryBuilder deviceQueryBuilder = getDeviceQueryBuilder(deviceList); QueryBuilder rangeBuilder = getDateRangeQueryBuilder(startTime, endTime); QueryBuilder queryBuilder = QueryBuilders.boolQuery() .must(deviceQueryBuilder).must(rangeBuilder); TermsBuilder termsBuilder = AggregationBuilders.terms("DeviceIDAgg").size(Integer.MAX_VALUE) .field(DeviceIDFieldName); SearchResponse searchResponse = client.prepareSearch(IndexName) .setQuery(queryBuilder).addAggregation(termsBuilder) .execute().actionGet(); Terms terms = searchResponse.getAggregations().get("DeviceIDAgg"); if (terms != null) { for (Terms.Bucket entry : terms.getBuckets()) { resultsMap.put(entry.getKey(), String.valueOf(entry.getDocCount())); } } return resultsMap; } Aggregation查询可以查询类似统计分析这样的功能:如某个月的数据分布情况,某类数据的最大、最小、总和、平均值等。 详情参考:https://www.elastic.co/guide/en/elasticsearch/client/java-api/current/java-aggs.html 三、集群配置 配置文件elasticsearch.yml 集群名和节点名: #cluster.name: elasticsearch #node.name: "Franz Kafka" 是否参与master选举和是否存储数据 #node.master: true #node.data: true 分片数和副本数 #index.number_of_shards: 5 #index.number_of_replicas: 1 允许其他网络访问: network.host: 0 master选举最少的节点数,这个一定要设置为整个集群节点个数的一半加1,即N/2+1 #discovery.zen.minimum_master_nodes: 1 discovery ping的超时时间,拥塞网络,网络状态不佳的情况下设置高一点 #discovery.zen.ping.timeout: 3s 注意,分布式系统整个集群节点个数N要为奇数个!! 如何避免ElasticSearch发生脑裂(brain split):http://blog.trifork.com/2013/10/24/how-to-avoid-the-split-brain-problem-in-elasticsearch/ 即使集群节点个数为奇数,minimum_master_nodes为整个集群节点个数一半加1,也难以避免脑裂的发生,详情看讨论:https://github.com/elastic/elasticsearch/issues/2488 四、常用查询 curl -X<REST Verb> <Node>:<Port>/<Index>/<Type>/<ID> Index info: curl -XGET 'localhost:9200' curl -XGET 'localhost:9200/_stats?pretty' curl -XGET 'localhost:9200/{index}/_stats?pretty' curl -XGET 'localhost:9200/_cluster/health?level=indices&pretty=true' curl -XGET 'localhost:9200/{index}?pretty' curl -XGET 'localhost:9200/_cat/indices?v' Index search: curl -XGET 'localhost:9200/subscriber/subscriber/_search?pretty' Search by ID: curl -XGET 'localhost:9200/subscriber/subscriber/5000?pretty' Search by field: curl -XGET 'localhost:9200/subscriber/subscriber/_search?q=ipAddress:63.141.15.45&&pretty' Delete index: curl -XDELETE 'localhost:9200/subscriber?pretty' Delete document by ID: curl -XDELETE 'localhost:9200/subscriber/subscriber/5000?pretty' Delete document by query: curl -XDELETE 'localhost:9200/subscriber/subscriber/_query?q=ipAddress:63.141.15.45&&pretty' 五、一致性(Consistent)和超时(Timeout) 翻译自官方Doc: 默认情况下,primary shard在写操作前,需要确定大多数(aquorum, or majority)的shard copies是可用的。这样是为了防止在有网络分区(network partition)的情况下把数据写到了“”错误的分区“。 A quorum是由以下公式决定:int( (primary + number_of_replicas) / 2 ) + 1 #number_of_replicas是在index settings中指定的复制个数 确定一致性的值有:one (只有primary shard),all (the primary and all replicas),或者defaultquorum 如果没有足够可用的shard copies,elasticsearch会等待直到超时,默认等待一分钟。 六、Elasticsearch插件 1、elasticsearch-head是一个elasticsearch的集群管理工具:./elasticsearch-1.7.1/bin/plugin-installmobz/elasticsearch-head 2、elasticsearch-sql:使用SQL语法查询elasticsearch:./bin/plugin-uhttps://github.com/NLPchina/elasticsearch-sql/releases/download/1.3.5/elasticsearch-sql-1.3.5.zip--installsql github地址:https://github.com/NLPchina/elasticsearch-sql 3、elasticsearch-bigdesk是elasticsearch的一个集群监控工具,可以通过它来查看ES集群的各种状态。 安装:./bin/plugin-installlukas-vlcek/bigdesk 访问:http://192.103.101.203:9200/_plugin/bigdesk/, 4、elasticsearch-servicewrapper插件是ElasticSearch的服务化插件, 在https://github.com/elasticsearch/elasticsearch-servicewrapper下载该插件后,解压缩,将service目录拷贝到elasticsearch目录的bin目录下。 而后,可以通过执行以下语句安装、启动、停止ElasticSearch: shelasticsearchinstall shelasticsearchstart shelasticsearchstop 代码在GitHub上:https://github.com/luxiaoxun/Code4Java 参考: https://www.elastic.co/guide/en/elasticsearch/client/java-api/current/index.html https://www.elastic.co/guide/en/elasticsearch/reference/current/index.html https://www.elastic.co/guide/en/elasticsearch/guide/current/distrib-write.html http://stackoverflow.com/questions/10213009/solr-vs-elasticsearch 本文转自阿凡卢博客园博客,原文链接:http://www.cnblogs.com/luxiaoxun/p/4869509.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

请描述LVS的nat模式的原理

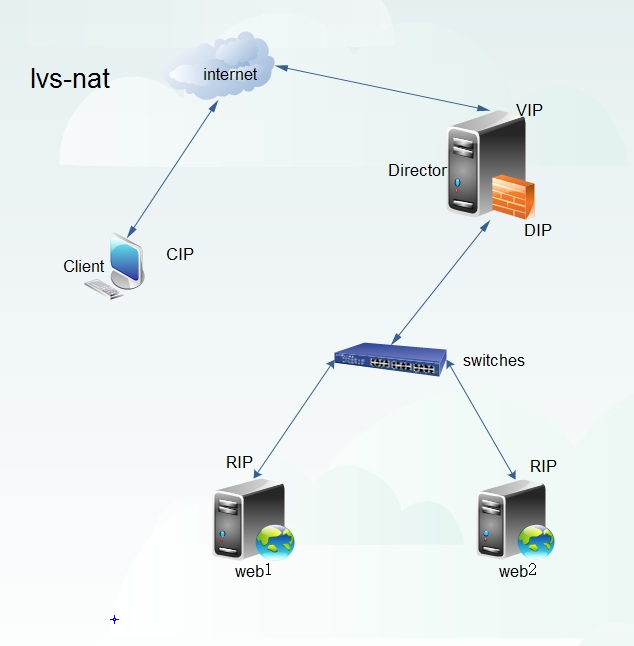
LVS-NAT:地址转换===收费站模式 virtual servervia network address translation(VS/NAT) LVS的nat模式类似于DNAT,但支持多目标转发。通过修改请求报文的目标地址为根据调度算法所挑选出的某RS的RIP来进行转发; 架构特性: (1)RS应该使用私有地址,即RIP应该为私有地址:各RS的网关必须指向DIP; (2)请求和响应报文都经由director转发:高负载场景中,dircetor可能成为瓶颈; (3)支持端口映射; (4)RS可以使用任意OS; (5)RS的RIP必须与director的DIP在同一网络; NAT模型优缺点: 优点:节点服务器使用私有IP地址,与负载调度器位于同一个物理网络,安全性比DR模式和TUN模式要高。 缺点:调度器位于客户端和集群节点之间,并负责处理进出的所有通信;(压力大的根本原因)大规模应用场景中,调度器容易成为系统瓶颈。 请求和响应图解说明: (1)客户端访问集群的VIP地址,请求web服务。(请求报文:源地址为CIP,目标地址为VIP) (2)调度器收到客户端的请求报文,会修改请求报文中的目标地址(VIP)为RIP,并且将请求根据相应的调度算法送往后端web服务器。(请求报文:源地址CIP,目标地址为RIP) (3)Web服务器收到请求,检查报文是访问自己的,并且自己也提供web服务,就会响应这个请求报文;并且发送给调度器(响应报文,源地址RIP,目标地址CIP) (4)调度器收到web服务器的响应报文,会根据自己内部的追踪机制,判断出用户访问的是VIP,这个时候会修改源地址为VIP地址响应客户端请求。(响应报文:源地址VIP,目标地址CIP) 本文转自写个博客骗钱博客51CTO博客,原文链接http://blog.51cto.com/dadonggg/1948283如需转载请自行联系原作者 菜鸟东哥

优秀的个人博客,低调大师

《区块链原理、设计与应用》一导读

前 言 区块链和机器学习被誉为未来十年内最有可能提高人类社会生产力的两大创新科技。如果说机器学习的兴起依赖于新型芯片技术的发展,那么区块链技术的出现,则是来自商业、金融、信息、安全等多个领域众多科技成果和业务创新的共同推动。比特币网络自横空出世,以前所未有的新型理念支持了前所未有的交易模式;以太坊项目站在前人肩膀上,引入图灵完备的智能合约机制,进一步释放了区块链技术的应用威力;众多商业、科技巨头,集合来自大型企业的应用需求和最先进的技术成果,打造出支持权限管理的联盟式分布式账本平台——超级账本……开源技术从未如今天这样,对各行各业都产生着极为深远的影响。本书在剖析区块链核心技术时,正是以这些开源项目(特别是超级账本 Fabric 项目)为具体实现进行讲解,力图探索其核心思想,展现其设计精华,剖析其应用特性。我们在写作中秉承了由浅入

优秀的个人博客,低调大师

docker 基本原理及快速入门

作者地址:青牛 什么是docker Docker 是一个开源项目,诞生于 2013 年初,最初是 dotCloud 公司内部的一个业余项目。它基于 Google 公司推出的 Go 语言实现。 项目后来加入了 Linux 基金会,遵从了 Apache 2.0 协议,项目代码在 GitHub 上进行维护。 Docker 自开源后受到广泛的关注和讨论,以至于 dotCloud 公司后来都改名为 Docker Inc。Redhat 已经在其 RHEL6.5 中集中支持 Docker;Google 也在其 PaaS 产品中广泛应用。 Docker 项目的目标是实现轻量级的操作系统虚拟化解决方案。 Docker 的基础是 Linux 容器(LXC)等技术。在 LXC 的基础上 Docker 进行了进一步的封装,让用户不需要去关心容器的管理,使得操作更为简便。用户操作 Docker 的容器就像操作一个快速轻量级的虚拟机一样简单。 下面的图片比较了 Docker 和传统虚拟化方式的不同之处,可见容器是在操作系统层面上实现虚拟化,直接复用本地主机的操作系统,而传统方式则是在硬件层面实现。 为什么用docker 作为一种新兴的虚拟化方式,Docker 跟传统的虚拟化方式相比具有众多的优势。 Docker 在如下几个方面具有较大的优势: 更快速的交付和部署 Docker在整个开发周期都可以完美的辅助你实现快速交付。Docker允许开发者在装有应用和服务本地容器做开发。可以直接集成到可持续开发流程中。 例如:开发者可以使用一个标准的镜像来构建一套开发容器,开发完成之后,运维人员可以直接使用这个容器来部署代码。 Docker 可以快速创建容器,快速迭代应用程序,并让整个过程全程可见,使团队中的其他成员更容易理解应用程序是如何创建和工作的。 Docker 容器很轻很快!容器的启动时间是秒级的,大量地节约开发、测试、部署的时间。 高效的部署和扩容 Docker 容器几乎可以在任意的平台上运行,包括物理机、虚拟机、公有云、私有云、个人电脑、服务器等。 这种兼容性可以让用户把一个应用程序从一个平台直接迁移到另外一个。 Docker的兼容性和轻量特性可以很轻松的实现负载的动态管理。你可以快速扩容或方便的下线的你的应用和服务,这种速度趋近实时。 更高的资源利用率 Docker 对系统资源的利用率很高,一台主机上可以同时运行数千个 Docker 容器。容器除了运行其中应用外,基本不消耗额外的系统资源,使得应用的性能很高,同时系统的开销尽量小。传统虚拟机方式运行 10 个不同的应用就要起 10 个虚拟机,而Docker 只需要启动 10 个隔离的应用即可。 更简单的管理 使用 Docker,只需要小小的修改,就可以替代以往大量的更新工作。所有的修改都以增量的方式被分发和更新,从而实现自动化并且高效的管理。 Docker引擎 docker引擎是一个c/s结构的应用,主要组件见下图: Server是一个常驻进程 REST API 实现了client和server间的交互协议 CLI 实现容器和镜像的管理,为用户提供统一的操作界面 Docker构架 Docker使用C/S架构,Client 通过接口与Server进程通信实现容器的构建,运行和发布。client和server可以运行在同一台集群,也可以通过跨主机实现远程通信。 核心概念 镜像(image) Docker 镜像(Image)就是一个只读的模板。例如:一个镜像可以包含一个完整的操作系统环境,里面仅安装了 Apache 或用户需要的其它应用程序。镜像可以用来创建 Docker 容器,一个镜像可以创建很多容器。Docker 提供了一个很简单的机制来创建镜像或者更新现有的镜像,用户甚至可以直接从其他人那里下载一个已经做好的镜像来直接使用。 镜像(Image)就是一堆只读层(read-only layer)的统一视角,也许这个定义有些难以理解,看看下面这张图: 右边我们看到了多个只读层,它们重叠在一起。除了最下面一层,其它层都会有一个指针指向下一层。这些层是Docker内部的实现细节,并且能够在docker宿主机的文件系统上访问到。统一文件系统(Union File System)技术能够将不同的层整合成一个文件系统,为这些层提供了一个统一的视角,这样就隐藏了多层的存在,在用户的角度看来,只存在一个文件系统。 仓库(repository) 仓库(Repository)是集中存放镜像文件的场所。有时候会把仓库和仓库注册服务器(Registry)混为一谈,并不严格区分。实际上,仓库注册服务器上往往存放着多个仓库,每个仓库中又包含了多个镜像,每个镜像有不同的标签(tag)。 仓库分为公开仓库(Public)和私有仓库(Private)两种形式。最大的公开仓库是 Docker Hub,存放了数量庞大的镜像供用户下载。国内的公开仓库包括 时速云 、网易云 等,可以提供大陆用户更稳定快速的访问。当然,用户也可以在本地网络内创建一个私有仓库。 当用户创建了自己的镜像之后就可以使用 push 命令将它上传到公有或者私有仓库,这样下次在另外一台机器上使用这个镜像时候,只需要从仓库上 pull 下来就可以了。 Docker 仓库的概念跟 Git 类似,注册服务器可以理解为 GitHub 这样的托管服务。 容器(container) Docker 利用容器(Container)来运行应用。容器是从镜像创建的运行实例。它可以被启动、开始、停止、删除。每个容器都是相互隔离的、保证安全的平台。可以把容器看做是一个简易版的 Linux 环境(包括root用户权限、进程空间、用户空间和网络空间等)和运行在其中的应用程序。 容器的定义和镜像几乎一模一样,也是一堆层的统一视角,唯一区别在于容器的最上面那一层是可读可写的。 一个运行态容器被定义为一个可读写的统一文件系统加上隔离的进程空间和包含其中的进程。下面这张图片展示了一个运行中的容器。 正是文件系统隔离技术使得Docker成为了一个非常有潜力的虚拟化技术。一个容器中的进程可能会对文件进行修改、删除、创建,这些改变都将作用于可读写层。 Docker安装部署 docker安装非常简单,支持各种平台,请到官网自行安装下载docker下载 Docker常用命令 获取镜像 docker pull 从仓库获取所需要的镜像。 使用示例: docker pull centos:centos6 实际上相当于 docker pull registry.hub.docker.com/centos:centos6命令,即从注册服务器 registry.hub.docker.com 中的 centos 仓库来下载标记为 centos6 的镜像。有时候官方仓库注册服务器下载较慢,可以从其他仓库下载。 从其它仓库下载时需要指定完整的仓库注册服务器地址。 查看镜像列表# docker images 列出了所有顶层(top-level)镜像。实际上,在这里我们没有办法区分一个镜像和一个只读层,所以我们提出了top-level镜像。只有创建容器时使用的镜像或者是直接pull下来的镜像能被称为顶层(top-level)镜像,并且每一个顶层镜像下面都隐藏了多个镜像层。 使用示例: $ docker images REPOSITORY TAG IMAGE ID CREATED SIZE centos centos6 6a77ab6655b9 8 weeks ago 194.6 MB ubuntu latest 2fa927b5cdd3 9 weeks ago 122 MB 在列出信息中,可以看到几个字段信息 来自于哪个仓库,比如 ubuntu 镜像的标记,比如 14.04 它的 ID 号(唯一) 创建时间 镜像大小 利用 Dockerfile 来创建镜像 docker build 使用 docker commit 来扩展一个镜像比较简单,但是不方便在一个团队中分享。我们可以使用docker build 来创建一个新的镜像。为此,首先需要创建一个 Dockerfile,包含一些如何创建镜像的指令。新建一个目录和一个 Dockerfile。 mkdir hainiu cd hainiu touch Dockerfile Dockerfile 中每一条指令都创建镜像的一层,例如: FROM centos:centos6 MAINTAINER sandywei <sandy@hainiu.tech> # move all configuration files into container RUN yum install -y httpd EXPOSE 80 CMD ["sh","-c","service httpd start;bash"] Dockerfile 基本的语法是 使用#来注释 FROM 指令告诉 Docker 使用哪个镜像作为基础 接着是维护者的信息 RUN开头的指令会在创建中运行,比如安装一个软件包,在这里使用yum来安装了一些软件 更详细的语法说明请参考Dockerfile 编写完成 Dockerfile 后可以使用 docker build 来生成镜像。 $ docker build -t hainiu/httpd:1.0 . Sending build context to Docker daemon 2.048 kB Step 1 : FROM centos:centos6 ---> 6a77ab6655b9 Step 2 : MAINTAINER sandywei <sandy@hainiu.tech> ---> Running in 1b26493518a7 ---> 8877ee5f7432 Removing intermediate container 1b26493518a7 Step 3 : RUN yum install -y httpd ---> Running in fe5b6f1ef888 ..... Step 5 : CMD sh -c service httpd start ---> Running in b2b94c1601c2 ---> 5f9aa91b0c9e Removing intermediate container b2b94c1601c2 Successfully built 5f9aa91b0c9e 其中 -t 标记来添加 tag,指定新的镜像的用户信息。 “.” 是 Dockerfile 所在的路径(当前目录),也可以替换为一个具体的 Dockerfile 的路径。注意一个镜像不能超过 127 层。 用docker images 查看镜像列表 $ docker images REPOSITORY TAG IMAGE ID CREATED SIZE hainiu/httpd 1.0 5f9aa91b0c9e 3 minutes ago 292.4 MB centos centos6 6a77ab6655b9 8 weeks ago 194.6 MB ubuntu latest 2fa927b5cdd3 9 weeks ago 122 MB 细心的朋友可以看到最后一层的ID(5f9aa91b0c9e)和 image id 是一样的 上传镜像 docker push 用户可以通过 docker push 命令,把自己创建的镜像上传到仓库中来共享。例如,用户在 Docker Hub 上完成注册后,可以推送自己的镜像到仓库中。 运行实例: $ docker push hainiu/httpd:1.0 创建容器 docker create <image-id> docker create 命令为指定的镜像(image)添加了一个可读写层,构成了一个新的容器。注意,这个容器并没有运行。 docker create 命令提供了许多参数选项可以指定名字,硬件资源,网络配置等等。 运行示例: 创建一个centos的容器,可以使用仓库+标签的名字确定image,也可以使用image-id指定image。返回容器id #查看本地images列表 $ docker images #用仓库+标签 $ docker create -it --name centos6_container centos:centos6 #使用image-id $ docker create -it --name centos6_container 6a77ab6655b9 bash b3cd0b47fe3db0115037c5e9cf776914bd46944d1ac63c0b753a9df6944c7a67 #可以使用 docker ps查看一件存在的容器列表,不加参数默认只显示当前运行的容器 $ docker ps -a 可以使用 -v 参数将本地目录挂载到容器中。 $ docker create -it --name centos6_container -v /src/webapp:/opt/webapp centos:centos6 这个功能在进行测试的时候十分方便,比如用户可以放置一些程序到本地目录中,来查看容器是否正常工作。本地目录的路径必须是绝对路径,如果目录不存在 Docker 会自动为你创建它。 启动容器 docker start <container-id> Docker start命令为容器文件系统创建了一个进程隔离空间。注意,每一个容器只能够有一个进程隔离空间。 运行实例: #通过名字启动 $ docker start -i centos6_container #通过容器ID启动 $ docker start -i b3cd0b47fe3d 进入容器 docker exec <container-id> 在当前容器中执行新命令,如果增加 -it参数运行bash 就和登录到容器效果一样的。 docker exec -it centos6_container bash 停止容器# docker stop <container-id> 删除容器# docker rm <container-id> 运行容器 docker run <image-id> docker run就是docker create和docker start两个命令的组合,支持参数也是一致的,如果指定容器名字是,容器已经存在会报错,可以增加 --rm 参数实现容器退出时自动删除。 运行示例: docker create -it --rm --name centos6_container centos:centos6 查看容器列表 docker ps docker ps 命令会列出所有运行中的容器。这隐藏了非运行态容器的存在,如果想要找出这些容器,增加 -a 参数。 删除镜像 docker rmi <image-id> 删除构成镜像的一个只读层。你只能够使用docker rmi来移除最顶层(top level layer)(也可以说是镜像),你也可以使用-f参数来强制删除中间的只读层。 commit容器# docker commit <container-id> 将容器的可读写层转换为一个只读层,这样就把一个容器转换成了不可变的镜像。 镜像保存# docker save <image-id> 创建一个镜像的压缩文件,这个文件能够在另外一个主机的Docker上使用。和export命令不同,这个命令为每一个层都保存了它们的元数据。这个命令只能对镜像生效。 使用示例: #保存centos镜像到centos_images.tar 文件 $ docker save -o centos_images.tar centos:centos6 #或者直接重定向 $ docker save -o centos_images.tar centos:centos6 > centos_images.tar 容器导出 docker export <container-id> 创建一个tar文件,并且移除了元数据和不必要的层,将多个层整合成了一个层,只保存了当前统一视角看到的内容。expoxt后的容器再import到Docker中,只有一个容器当前状态的镜像;而save后的镜像则不同,它能够看到这个镜像的历史镜像。 inspect docker inspect <container-id> or <image-id> docker inspect命令会提取出容器或者镜像最顶层的元数据 版权声明:原创作品,允许转载,转载时务必以超链接的形式表明出处和作者信息。否则将追究法律责任。来自海牛部落-青牛,http://hainiubl.com/topics/13

优秀的个人博客,低调大师

《大数据分析原理与实践》——导读

前 言 本书的缘起与成书过程 大数据经过分析能够产生高价值,这无疑已在大数据火爆的今天成为共识,从而使得大数据分析在“大数据+”涉及的领域(如工业、医疗、农业、教育等)有了广泛的应用。大数据分析的相关知识不仅是大数据行业的从业人员应该必备的,也是和大数据相关的各行各业的从业者需要了解的。 然而,人们对大数据分析的解读有多个不同方面。从“分析”的角度解读,大数据分析可以看作统计分析的延伸;从 “数据”的角度解读,大数据分析可以看作数据管理与挖掘的扩展;从“大”的角度解读,大数据分析可以看作数据密集高性能计算的具体化。 而大数据分析的有效实施也需要多个方面的知识。从分析的角度来讲,需要统计学、数据分析、机器学习等方面的知识;从数据处理的角度来讲,需要数据库、数据挖掘等方面的知识;从计算平台的角度来讲,需要并行系统和并行计算的知识。 上述多样化

优秀的个人博客,低调大师

《大数据分析原理与实践》——小结

小结 本章概述了大数据和大数据分析的相关知识。首先在1.1节介绍了大数据的定义、应用背景和“4V”特征,让读者对于大数据概念有更为清晰的认识。接下来,1.2节介绍了大数据的应用场景,从中可以看出大数据是无处不在的,并且对于政治、经济、工业生产、科学研究等有着巨大的影响。1.3节介绍了大数据分析的定义和应用,大数据分析使得大数据体现出其特有的价值,也带来了新的思维方式。1.4节讨论了大数据分析中的技术和难点,介绍了大数据分析的过程,包括业务理解、数据理解、数据准备、建模、评估和部署,紧接着介绍了大数据分析涉及的一系列技术,包括数据采集、数据管理、基础架构、数据理解和提取、统计分析、数据挖掘和数据可视化等。最后讨论了大数据分析中的难点,包括可扩展性、可用性、领域知识的结合和结果的检验。

优秀的个人博客,低调大师

关于搜索功能的实现原理(laravel框架)

这里的搜索功能主要基于表单get提交实现的 <formaction="/backend/auditList"method="get"> <tableclass="search_tab"> <tr> <thwidth="120">选择分类:</th> <td> <selectname="class"> <optionvalue="">全部</option> @foreach($categoryas$c) <optionvalue="{{$c->id}}">{{$c->class_name}}</option> @endforeach </select> </td> <thwidth="70">文章标题:</th> <!--查询关键词--> <td><inputtype="text"name="keywords"placeholder="文章标题"></td> <td><inputtype="submit"name="sub"value="查询"></td> </tr> </table> </form> php部分逻辑 publicfunctionarticle_list(){ //echo'zoule';exit;测试表单是否走进方法中大家随意写 $shownum=1; if(array_key_exists('class',$_GET)||array_key_exists('keywords',$_GET)){ //echo'111'; if($_GET['class']){ //Article模型leftJoin表连接查询根据俩个表里的这些字段来执行 $postdata=Article::leftJoin('category',function($join){ $join->on('article.class_id','=','category.id'); })->select(['article.id','category.class_name','article.status','article.title_editing','article.update_time'])->where('article.class_id','=',$_GET['class'])->orderBy('release_time','desc')->paginate($shownum); }elseif($_GET['keywords']){ $postdata=Article::leftJoin('category',function($join){ $join->on('article.class_id','=','category.id'); })->select(['article.id','category.class_name','article.status','article.title_editing','article.update_time'])->where('article.title_editing','=',$_GET['keywords'])->orderBy('release_time','desc')->paginate($shownum); }else{ $postdata=Article::leftJoin('category',function($join){ $join->on('article.class_id','=','category.id'); })->select(['article.id','category.class_name','article.status','article.title_editing','article.update_time'])->orderBy('release_time','desc')->paginate($shownum); } }else{ //echo'2222'; $postdata=Article::leftJoin('category',function($join){ $join->on('article.class_id','=','category.id'); })->select(['article.id','category.class_name','article.status','article.title_editing','article.update_time'])->orderBy('release_time','desc')->paginate($shownum); } //分类id不是父id $category=DB::table('category')->where('parent_id','!=','0')->get(); //渲染页面传递参数 returnview('backend.article_list',['postdata'=>$postdata,'shownum'=>$shownum,'category'=>$category]); }


优秀的个人博客,低调大师

Flink 原理与实现:架构和拓扑概览

要了解一个系统,一般都是从架构开始。我们关心的问题是:系统部署成功后各个节点都启动了哪些服务,各个服务之间又是怎么交互和协调的。下方是 Flink 集群启动后架构图。 当 Flink 集群启动后,首先会启动一个 JobManger 和一个或多个的 TaskManager。由 Client 提交任务给 JobManager,JobManager 再调度任务到各个 TaskManager 去执行,然后 TaskManager 将心跳和统计信息汇报给 JobManager。TaskManager 之间以流的形式进行数据的传输。上述三者均为独立的 JVM 进程。 Client 为提交 Job 的客户端,可以是运行在任何机器上(与 JobManager 环境连通即可)。提交 Job 后,Client 可以结束进程(Streaming的任务),也可以不结束并等待结果返回。 JobManager 主要负责调度 Job 并协调 Task 做 checkpoint,职责上很像 Storm 的 Nimbus。从 Client 处接收到 Job 和 JAR 包等资源后,会生成优化后的执行计划,并以 Task 的单元调度到各个 TaskManager 去执行。 TaskManager 在启动的时候就设置好了槽位数(Slot),每个 slot 能启动一个 Task,Task 为线程。从 JobManager 处接收需要部署的 Task,部署启动后,与自己的上游建立 Netty 连接,接收数据并处理。 可以看到 Flink 的任务调度是多线程模型,并且不同Job/Task混合在一个 TaskManager 进程中。虽然这种方式可以有效提高 CPU 利用率,但是个人不太喜欢这种设计,因为不仅缺乏资源隔离机制,同时也不方便调试。类似 Storm 的进程模型,一个JVM 中只跑该 Job 的 Tasks 实际应用中更为合理。 Job 例子 本文所示例子为 flink-1.0.x 版本 我们使用 Flink 自带的 examples 包中的 SocketTextStreamWordCount ,这是一个从 socket 流中统计单词出现次数的例子。 首先,使用 netcat 启动本地服务器: $ nc -l 9000 然后提交 Flink 程序 $ bin/flink run examples/streaming/SocketTextStreamWordCount.jar \ --hostname 10.218.130.9 \ --port 9000 在netcat端输入单词并监控 taskmanager 的输出可以看到单词统计的结果。 SocketTextStreamWordCount 的具体代码如下: public static void main(String[] args) throws Exception{ // 检查输入 final ParameterTool params = ParameterTool.fromArgs(args); ... // set up the execution environment final StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment(); // get input data DataStream<String> text = env.socketTextStream(params.get("hostname"), params.getInt("port"), '\n', 0); DataStream<Tuple2<String, Integer>> counts = // split up the lines in pairs (2-tuples) containing: (word,1) text.flatMap(new Tokenizer()) // group by the tuple field "0" and sum up tuple field "1" .keyBy(0) .sum(1); counts.print(); // execute program env.execute("WordCount from SocketTextStream Example"); } 我们将最后一行代码 env.execute 替换成 System.out.println(env.getExecutionPlan()); 并在本地运行该代码(并发度设为2),可以得到该拓扑的逻辑执行计划图的 JSON 串,将该 JSON 串粘贴到 http://flink.apache.org/visualizer/ 中,能可视化该执行图。 但这并不是最终在 Flink 中运行的执行图,只是一个表示拓扑节点关系的计划图,在 Flink 中对应了 SteramGraph。另外,提交拓扑后(并发度设为2)还能在 UI 中看到另一张执行计划图,如下所示,该图对应了 Flink 中的 JobGraph。 Graph 看起来有点乱,怎么有这么多不一样的图。实际上,还有更多的图。Flink 中的执行图可以分成四层:StreamGraph -> JobGraph -> ExecutionGraph -> 物理执行图。 StreamGraph: 是根据用户通过 Stream API 编写的代码生成的最初的图。用来表示程序的拓扑结构。 JobGraph: StreamGraph经过优化后生成了 JobGraph,提交给 JobManager 的数据结构。主要的优化为,将多个符合条件的节点 chain 在一起作为一个节点,这样可以减少数据在节点之间流动所需要的序列化/反序列化/传输消耗。 ExecutionGraph: JobManager 根据 JobGraph 生成的分布式执行图,是调度层最核心的数据结构。 物理执行图: JobManager 根据 ExecutionGraph 对 Job 进行调度后,在各个TaskManager 上部署 Task 后形成的“图”,并不是一个具体的数据结构。 例如上文中的2个并发度(Source为1个并发度)的 SocketTextStreamWordCount 四层执行图的演变过程如下图所示(点击查看大图): 这里对一些名词进行简单的解释。 StreamGraph:根据用户通过 Stream API 编写的代码生成的最初的图。 StreamNode:用来代表 operator 的类,并具有所有相关的属性,如并发度、入边和出边等。 StreamEdge:表示连接两个StreamNode的边。 JobGraph:StreamGraph经过优化后生成了 JobGraph,提交给 JobManager 的数据结构。 JobVertex:经过优化后符合条件的多个StreamNode可能会chain在一起生成一个JobVertex,即一个JobVertex包含一个或多个operator,JobVertex的输入是JobEdge,输出是IntermediateDataSet。 IntermediateDataSet:表示JobVertex的输出,即经过operator处理产生的数据集。producer是JobVertex,consumer是JobEdge。 JobEdge:代表了job graph中的一条数据传输通道。source 是 IntermediateDataSet,target 是 JobVertex。即数据通过JobEdge由IntermediateDataSet传递给目标JobVertex。 ExecutionGraph:JobManager 根据 JobGraph 生成的分布式执行图,是调度层最核心的数据结构。 ExecutionJobVertex:和JobGraph中的JobVertex一一对应。每一个ExecutionJobVertex都有和并发度一样多的 ExecutionVertex。 ExecutionVertex:表示ExecutionJobVertex的其中一个并发子任务,输入是ExecutionEdge,输出是IntermediateResultPartition。 IntermediateResult:和JobGraph中的IntermediateDataSet一一对应。每一个IntermediateResult的IntermediateResultPartition个数等于该operator的并发度。 IntermediateResultPartition:表示ExecutionVertex的一个输出分区,producer是ExecutionVertex,consumer是若干个ExecutionEdge。 ExecutionEdge:表示ExecutionVertex的输入,source是IntermediateResultPartition,target是ExecutionVertex。source和target都只能是一个。 Execution:是执行一个 ExecutionVertex 的一次尝试。当发生故障或者数据需要重算的情况下 ExecutionVertex 可能会有多个 ExecutionAttemptID。一个 Execution 通过 ExecutionAttemptID 来唯一标识。JM和TM之间关于 task 的部署和 task status 的更新都是通过 ExecutionAttemptID 来确定消息接受者。 物理执行图:JobManager 根据 ExecutionGraph 对 Job 进行调度后,在各个TaskManager 上部署 Task 后形成的“图”,并不是一个具体的数据结构。 Task:Execution被调度后在分配的 TaskManager 中启动对应的 Task。Task 包裹了具有用户执行逻辑的 operator。 ResultPartition:代表由一个Task的生成的数据,和ExecutionGraph中的IntermediateResultPartition一一对应。 ResultSubpartition:是ResultPartition的一个子分区。每个ResultPartition包含多个ResultSubpartition,其数目要由下游消费 Task 数和 DistributionPattern 来决定。 InputGate:代表Task的输入封装,和JobGraph中JobEdge一一对应。每个InputGate消费了一个或多个的ResultPartition。 InputChannel:每个InputGate会包含一个以上的InputChannel,和ExecutionGraph中的ExecutionEdge一一对应,也和ResultSubpartition一对一地相连,即一个InputChannel接收一个ResultSubpartition的输出。 那么 Flink 为什么要设计这4张图呢,其目的是什么呢?Spark 中也有多张图,数据依赖图以及物理执行的DAG。其目的都是一样的,就是解耦,每张图各司其职,每张图对应了 Job 不同的阶段,更方便做该阶段的事情。我们给出更完整的 Flink Graph 的层次图。 首先我们看到,JobGraph 之上除了 StreamGraph 还有 OptimizedPlan。OptimizedPlan 是由 Batch API 转换而来的。StreamGraph 是由 Stream API 转换而来的。为什么 API 不直接转换成 JobGraph?因为,Batch 和 Stream 的图结构和优化方法有很大的区别,比如 Batch 有很多执行前的预分析用来优化图的执行,而这种优化并不普适于 Stream,所以通过 OptimizedPlan 来做 Batch 的优化会更方便和清晰,也不会影响 Stream。JobGraph 的责任就是统一 Batch 和 Stream 的图,用来描述清楚一个拓扑图的结构,并且做了 chaining 的优化,chaining 是普适于 Batch 和 Stream 的,所以在这一层做掉。ExecutionGraph 的责任是方便调度和各个 tasks 状态的监控和跟踪,所以 ExecutionGraph 是并行化的 JobGraph。而“物理执行图”就是最终分布式在各个机器上运行着的tasks了。所以可以看到,这种解耦方式极大地方便了我们在各个层所做的工作,各个层之间是相互隔离的。 作者:阿里中间件团队博客 来源:51CTO

优秀的个人博客,低调大师

《云计算:原理与范式》一2.4 小结

2.4 小结 尽管迁移到云有很多挑战,许多迁移项目未能完全理解风险问题,主要赞助商和管理方轻视它或者提交一段代码或数据到迁移的云中。在利用迁移到云的七步模型时,一个精心设计的云迁移策略具有显著的机遇和成功因素。其中,最主要的是全面理解迁移的云计算经济学以及底层技术面临的挑战。对于每类企业应用程序和企业实践组(corporate practice group)而言,每个开发迁移到云的最佳实践都是独一无二的。一些关键的最佳实践包括设计迁移和新的应用程序架构,以及假设在云计算服务环境出现故障安全时为故障设计或编码。事实上,大多数云计算数据中心使用的硬件产品经常出现故障。未反映这一现实的方法导致一些性能损失。另外一个最佳实践是:目标企业应用程序的各个不同部分之间的松耦合的应用程序和实施。一个关键的最佳实践必须确保各个层面和迁移层的安全性。最

优秀的个人博客,低调大师

《云计算:原理与范式》一3.13 小结

3.13 小结 与云计算同步的SaaS为企业以及IT产业带来了战略性转变。越来越多的SaaS应用程序托管在云基础设施中,无所不在的Internet是主要的通信基础设施。由于世界正在经历经济衰退和不稳定性,这些改变游戏规则的概念与基础设施结构的组合真的为世界带来了福音。随着这些新鲜的层次不清和发布思想的成熟,人们正在完成“花更少的钱办更多的事”的目标。应用故意被转移到暴露为服务的云端,这是通过Internet传递给用户代理或人类,并通过无处不在的Web浏览器访问。前所未有的采纳激励和灌输的大量创新,因为它已经创造了很多新的业务、价格、交付和访问模型。普遍性和实用性将成为共同的内涵。增值业务转换、增强以及随着按需优化,IT将是最终的输出。在所有的热情和乐观中,也存在一些制约因素,这需要准确地抽取出这些因素并将其全面解决,以创造一个扩展的

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册