首页 文章 精选 留言 我的

精选列表

搜索[前端统一],共10000篇文章
优秀的个人博客,低调大师

前端不止:Web性能优化 – 关键渲染路径以及优化策略

我问你:“当你从搜索引擎的结果页面选择打开一条搜索结果时,你觉得多长时间之后,如果页面还处于白屏或者没有加载到关键信息,你会选择关掉这个窗口?” 《Designing for Performance》的作者 Lara Swanson 在2014年写过一篇文章《Web性能即用户体验》,她在文中提到“网站页面的快速加载,能够建立用户对网站的信任,增加回访率,大部分的用户其实都期待页面能够在2秒内加载完成,而当超过3秒以后, 就会有接近40%的用户离开你的网站”。 Google和亚马逊的研究表明,Google页面加载的时间从0.4秒提升到0.9秒导致丢失了20%流量和广告收入,对于亚马逊,页面加载时间每增加100毫秒就意味着1%的销售额损失。可见,页面的加载速度对于用户可能的下一步操作是多么的举足轻重。 想一想,如果你希望你的网站在一秒钟之内呈现用户想看的关键信息,有哪些可行的手段?Minify,压缩,雪碧图等等。 Google的Web性能工程师 Ilya Grigorik 会告诉你,你只需要理解浏览器的关键渲染路径。 页面性能可能是一个感性的东西 页面的性能,看似是一个理性和量化的概念,实则也来自于用户的感知,主观的评价,是一个偏感性的东西。 (参考自Google关键渲染路径) 如果页面可以做到优先显示与用户操作有关的内容,就可以让用户更快速的感知到操作得到响应,这个过程叫做“优化关键渲染路径”。 什么是关键渲染路径 我记得,有一个非常经典的面试题叫做:《当浏览器地址栏输入URL并回车后,发生了什么?》。 关键渲染路径就是描述浏览器从收到 HTML、CSS 和 JavaScript 字节开始,到如何使用HTML、CSS 和 JavaScript 在屏幕上渲染像素的中间过程。 如果我们能够优化这条路径,就能让页面更快速的展示内容,给用户更好的体验。 全景图 我们先尝试站在高处,看一眼关键渲染路径的全景图,这样能够快速的领略一个大致轮廓和一些关键概念。 文档对象模型 (DOM) DOM概念之于Web开发人员再熟悉不过了,当浏览器发出请求并接收到HTML文档后,它会有这样一个流程来构建DOM:字节 → 字符 → 令牌 → 节点 → 对象模型。 以下面这段代码为例: <html> <head> <meta name="viewport" content="width=device-width,initial-scale=1"> <link href="style.css" rel="stylesheet"> <title>Critical Path</title> </head> <body> <p>Hello <span>web performance</span> students!</p> <div><img src="awesome-photo.jpg"></div> </body> </html> 浏览器接收到HTML请求的返回结果,根据预定的流程解析HTML,文档中的“开标签”,比如<html>,<head>等会转换成一个令牌(Token),然后令牌转换成节点对象(Node)。 这个令牌解析并转换为节点对象的过程,也是每个节点建立关系(树形结构)的过程。例如:head的令牌出现在html令牌之后,但其闭标签出现在html闭标签之前,这就意味着head是html的子节点,以此类推,建立节点的父子关系。 这个过程在浏览器中,叫做“Parse HTML”。 CSS 对象模型 (CSSOM) 当DOM捕获了页面的内容,我们还需要知道页面如何展示这些内容,所以需要构建CSS 对象模型(CSSOM)。 浏览器解析DOM,遇到了link标签,发现它引用了一个外部样式资源:style.css,于是浏览器会向外部请求样式资源,然后进行后续的DOM构建工作。 CSS 被视为阻塞渲染的资源,这意味着浏览器将不会渲染任何已处理的内容,直至 CSSOM 构建完毕。 CSSOM有着一个和DOM构建相似的流程:字节 → 字符 → 令牌 → 节点 → CSS对象模型。 以下面的CSS样式为例,它会根据具体解析规则,将CSS文档转换成下面的树形结构: body { font-size: 16px } p { font-weight: bold } span { color: red } p span { display: none } img { float: right } 这种树形结构让CSS有层级继承关系,子节点会继承父节点的样式。 前面谈到CSS会阻塞浏览器的渲染过程,因为渲染树的构建同时需要DOM和CSSOM,所以当浏览器请求的style.css返回之后,浏览器会开始解析样式表,并重新计算样式(Recalculate Style),将CSS转换成CSSOM,然后进行后续的操作。 值得注意的是,CSSOM运算是一个非常复杂的过程,性能消耗会比较大,所以你会常常听到“老人们”说写样式“尽量使用class和id,保证层级扁平,减少过度层叠”,而且越是通用的CSS样式,执行速度越快,越是具体(选择器)的CSS样式,则执行速度越慢。 DOM + CSSOM = 渲染树 渲染树和DOM树不同,它只会捕获一些页面上可见的元素,比如,Header或display:none的元素不会放在渲染树中。 渲染树的构建会从DOM的根节点开始遍历,对于不可见节点会忽略,然后在CSSOM中找到每个对应节点的样式规则并应用,最后输出的渲染树会包含所有的可见内容和样式信息,如下图: 布局和绘制 有了渲染树,浏览器会进入布局和绘制阶段。 布局就是弄清每个对象在页面视窗(Viewport)上的确切大小和位置,它的输出是一个“盒模型”,里面准确的捕获每一个元素在页面视窗中的位置和尺寸。 在布局工作完成之后,浏览器会开始绘制,将渲染树转换成屏幕上的像素,这样,我们就能在浏览器中看到页面的内容。 短暂回顾一下“关键渲染路径”的步骤 处理 HTML 标记并构建 DOM 树。 处理 CSS 标记并构建 CSSOM 树。 将 DOM 与 CSSOM 合并成一个渲染树。 根据渲染树来布局。 将各个节点绘制到屏幕上。 当DOM或者CSSOM发生变化的时候,浏览器就需要再次执行一次上面的步骤。 JavaScript 到目前为止,我们还没涉及到JavaScript,但它在整个关键渲染路径中扮演着非常重要的角色,就如全景图中画的那样,我们从一段简单的代码开始: <body> <p>Hello <span>web performance</span> students!</p> <script> var span = document.getElementsByTagName('span')[0]; span.textContent = 'javascript'; </script> </body> 一个大家都知道的重要事实是:脚本在文档的何处插入,就在何处执行。 当HTML解析过程中遇到一个script标记时,它会暂停DOM构建,将控制权移交给JavaScript引擎,等JavaScript引擎运行完毕,浏览器再从中断的地方恢复DOM构建。也就是说,执行内联的JavaScript会阻塞页面的首次渲染。 现在我们假设,这段JavaScript是外部资源。 <body> <p>Hello <span>web performance</span> students!</p> <script src="write.js"></script> </body> 则浏览器的渲染会阻塞直到write.js的请求返回后,并执行JavaScript后,继续。 需要注意的是,在网页中引入JavaScript脚本有一个微妙事实,就是JavaScript不仅可以读取和修改DOM属性,还可以读取和修改CSSOM属性。 前面我们提到CSS是阻塞渲染的资源,当它和JavaScript一起出现在页面上时,会发生这样的事情: <html> <head> <meta name="viewport" content="width=device-width,initial-scale=1"> <link href="style.css" rel="stylesheet"> <title>Critical Path: Script</title> </head> <body> <p>Hello <script>document.write('web performance')</script> students!</p> </body> </html> 在浏览器解析HTML构建DOM过程中,发现了link标签,于是发出请求获取style.css,然后继续构建DOM,此时,它发现script标签,由于JavaScript可能会访问样式属性,所以它会阻止JavaScript的执行直到styles.css返回并完成CSSOM构建,然后执行这一段JavaScript代码,再继续后面DOM的构建和相关渲染操作。 于是styles.css的请求不仅阻塞后面的渲染,还阻塞了DOM的构建。 如果将这段JavaScript作为外部资源,就是一个比较典型的页面结构: <html> <head> <meta name="viewport" content="width=device-width,initial-scale=1"> <link href="style.css" rel="stylesheet"> <title>Critical Path Render</title> </head> <body> <p>Hello <span>web performance</span></p> <script src="app.js"></script> </body> </html> JavaScript和CSS资源请求是并行的,但仍然需要等到CSSOM构建完成之后,JavaScript才可以执行,然后在进行后面的渲染工作。于是,当 DOM、CSSOM 和 JavaScript 执行之间有大量的依赖关系时,就很可能导致浏览器在处理及渲染网页时出现延迟。 优化策略 我们花了大量的篇幅来理解浏览器的渲染过程,理解DOM,CSSOM,渲染树,浏览器绘制,分析HTML,CSS和JS在渲染过程中的关系,我相信你已然受益匪浅,现在,我们来运用这些知识加速你的网站。 第一步,分析你的网站渲染状况 我们以Google为例,通过Chrome的Performance工具查看页面渲染情况,如下图,你应该可以清晰的看到图中有四条竖线,他们分别是什么含义呢? (Google主页的性能分析情况) 绿色竖线,代表First Paint,即浏览器开始进行像素的绘制 黄色竖线,代表First Meaningful Paint(首次有效绘制)用户可以开始看到部分内容,但绘制仍在继续 蓝色竖线,代表大家比较熟悉的DOMContentLoaded 红色竖线,代表load,页面加载完成 优秀的网站都能够把“首次有效渲染”做到1秒之内完成,这样能够让用户更快的看到所请求的页面得到响应。如果你的网站“首次有效渲染”超过1秒,那么就非常有必要重新分析一下网站的关键渲染路径是否合理。 第二步,分析关键渲染路径 在关键渲染路径中,我们通常要关注三个点: 页面首次渲染需要的关键资源数量 关键资源的大小 关键渲染路径的往返次数(Roundtrip) 我们的策略也非常简单,就是减少关键资源数量,降低资源大小,减少关键路径的往返次数。 关键渲染的资源一般是阻止屏幕首次渲染HTML,CSS和JavaScript,所以最重要也是最难的部分的是你需要根据自己网站的实际情况分析,哪些是页面绘制的所必须的,哪些是无关的。 第三步,根据分析采取优化手段 1、减少关键资源的大小 我们首先从最简单也是最直接的减少关键资源的大小开始: 对于所有的资源(HTML,JavaScript,CSS,Image等),你都应该用上三大绝招:Minify,Compression和Cache,这里不过多的赘述里面的细节。 这一点对于HTML来说,非常关键,HTML作为渲染的关键资源,消除或者延迟加载肯定不太可能(这里指的是非局部渲染的关键HTML),能够做到是消除无用代码(比如:注释)和最小化代码(Minify)以及动态局部渲染等。 (Google对页面的HTML进行了压缩) 2、延迟JavaScript非阻塞资源加载 JavaScript和CSS都是阻塞渲染的资源,对于已经鉴别出的对于首次渲染没有起到关键作用的代码,我们首先想到的是要延迟它的加载,让它脱离关键渲染路径。 首先,对于阻塞渲染的JavaScript,应该将它放置在页面body的底部,为什么呢? JavaScript可以查询和操作DOM和CSSOM,正如前面介绍的,HTML解析过程中构建DOM,当遇到JavaScript就停止DOM构建执行JavaScript,如果被执行的JavaScript是放置在head附近,那么很可能要被操作或者查询的DOM还没有构建到DOM当中。 而对于,非阻塞渲染的JavaScript,我们应该采用异步的方式加载,如下: <script src="script.js"></script> <script async src="script.js"></script> <script defer src="myscript.js"></script> </body> </html> 方式一:即阻塞的JavaScript,HTML解析过程中遇到script标签,发出网络请求获取script.js,在网络请求返回后,解析并执行script.js,然后浏览器继续HTML解析。 方式二:async,完全的异步操作,HTML解析遇到该标签后,发出网络请求,但不阻止HTML解析和其后面的渲染操作,当JavaScript请求返回后立刻执行,且不等待HTML解析或其他操作的完成。所以,如果脚本中有DOM操作,就并不适合。比较适合的场景是Google Analytics。 方式三:defer,HTML的解析和对JavaScript资源的网络请求是并行的,但它会等待HTML解析完成之后,才执行脚本。 (图片参考自:Asynchronous and deferred JavaScript execution explained « Peter Beverloo) 不过,async和defer,他们对浏览器的兼容性有一定的要求,但仍然应该使用它们,同时可以采用退而求其次的延迟代码执行的方法(比如:on DOMContentLoad后),特别是与首次渲染无关的计算逻辑和功能。 3、尽早和按需的加载CSS 你可能在思考,有没有异步加载CSS的需求?我认为不应该有,页面应该只引用与该页面相关的样式文件。(只不过很多时候,我们将所有的CSS都打包在了一个压缩的CSS文件中了。)目前,已经有许多帮助你分析关键渲染路径上的所需要的CSS的工具:grunt-criticalcss,critical, criticalCSS,在线CRPCSS工具。 前面已经提到,CSS是阻塞渲染的资源,在CSSOM完全解析完成之前,浏览器不可能开始屏幕的绘画。 所以,我们应该尽早的开始对样式资源的请求,将它尽早、尽快地下载到客户端,这样解释了为什么我们看到样式资源的link标签一般都放在head表中: <!DOCTYPE html> <html lang="en"> <head> <title>Sample Site</title> <link href="style.css" rel="stylesheet"> </head> CSSOM的运算是一个非常复杂和相对耗时的过程,但它也有一个特点,就是可能只有在特定的情况下才会起作用,比如:响应式设计的页面。 对于响应式页面,我们可以考虑将不同媒体上的样式分离,在<link>中使用媒体查询,浏览器仍然会下载对应的资源,但是可以避免不必要的CSSOM解析导致对渲染的阻塞。 <link href="style.css" rel="stylesheet" media="all"> <link href="portrait.css" rel="stylesheet" media="orientation:portrait"> <link href="print.css" rel="stylesheet" media="print"> 同时,我们还应该避免在首次渲染的CSS样式中使用@import指令,因为它只有在收到并解析完带有@import规则的CSS资源之后,才会发现导入的 CSS 资源,这个时候就会重新请求,从而增加了关键渲染路径的往返次数。 4、内联CSS来提高渲染性能 到目前为止,我们已经做到了识别关键渲染资源,将非关键资源延迟加载或者不加载。那么,减少关键路径的往返次数是什么意思?其实就是减少关键渲染资源从服务器端到客户端的往返次数。比如,外链的JS和CSS文件以前CSS的@import,在页面渲染的过程中,都会重新去服务器端请求。这其实,和我们常说的减少http请求量(合并http请求)类似,但是我么从渲染路径的角度来理解这样一种性能的消耗。 根据这样的逻辑,我们很容易就想到可以将渲染必备CSS内联到HTML中,来减少渲染路径的往返次数。 实际上不少的优秀网站都采用了在head内联样式的做法:Google,百度,淘宝,京东。 (百度和Google将样式inline在head中) 关于内联样式还有更进一步的做法,在文章的一开始就提到,优化关键渲染路径就是要优先显示和用户先关内容。 所以,我们可以考虑仅仅将当前屏幕展示的内容(above-the-fold,一屏)所需的CSS内联到HTML的head中,然后采用异步的方式加载整个页面所需要的完整CSS,以便用户能够更快的看到首屏出现的内容。(inlining-critical-css-for-better-web-performance) 5、一个神奇的数字14kb 在最开始我们提到,要减小关键资源的大小,那么多小比较合适呢?(废话,当然是越小越好)。 其实,有一个神奇的数字14kb,它是怎么来? HTTP的传输层协议是TCP,TCP协议有一个慢启动的过程,即它在第一次传递数据时,只能同时传递14kb的数据块,所以当数据超多14kb时,TCP协议传递数据实际是多次的往返(roundtrip)。如果能够将渲染所需要的资源控制在14kb之内,那么就能TCP协议启动时,一次完成数据的传递。 其他Web资源和关键渲染路径的关系 你一定会思考,除了HTML,JavaScript和CSS,Web页面还包含许多其他的资源,比如:图片,网络字体(Icon Font),他们和关键渲染路径的关系是什么? 大家对图片加载感受都应该大致一样,它会在页面加载过程中或完成后,逐步显示,也就是说它不是阻塞渲染的资源,它的痛点主要在于质量和资源大小的权衡,以及请求数量带来的性能消耗(雪碧图)。 网络字体,在网络加载比较慢的情况下,用户可能会感受到字体或者图形的变化(Icon Font)。其实,浏览器在渲染树构建完成之后,会指示需要哪些字体在网页上渲染指定文本,然后分派字体请求,浏览器执行布局并将内容绘制到屏幕上,如果字体尚不可用,浏览器可能不会渲染任何文本像素,待字体可用之后,再绘制文本像素,当然,不同浏览器之间实际行为有所差异,这里不在赘述,请参考文章尾部的资料链接。 总结 优化关键渲染路径的最终目的是优先显示和用户操作相关的内容,减少低优先级资源对浏览器渲染的阻塞,从而尽早显示用户真正关心的关键内容。页面性能就是用户体验的一个重要维度,尝试用感性的思维去思考理性的代码,也许真的能受益不少。 参考资料: Google关键渲染路径 《Web性能即用户体验》 peter.sh/experiments… 原文发布时间:2018-06-29 原文作者:朱本威 本文来源 掘金如需转载请紧急联系作者

优秀的个人博客,低调大师

软件包管理之前端管理工具yum

一、前言 RPM安装软件有一个很繁琐的问题,那就是包与包之间的依赖关系,如果想正常安装和使用软件程序,就必须根据要求一步一步的解决软件之间的依赖关系。那么如果程序使用的包很多,将会很消耗使用人的时间和精力。那么有没有办法解决这一问题呢? 在RPM中我们介绍了RPM软件会记录软件之间的安装信息,其中也包括了软件之间的依赖属性。那么如果我们在安装前就分析这个列表,那么在安装时就能根据软件之间的关系将所需的软件一次性安装起来,这样就能解决这一问题,这就是 YUM 的机制。 二、yum的介绍 yum(Yellow dog Updater Modified)是CentOS中属于RPM前段软件包管理器,能从指定的服务器中下载RPM包,并自动分析和处理RPM包之间的依赖关系,最后将依次所依赖的软件包都安装了,而无需繁琐的一个一个安装。 三、yum repository:yum仓库 yum仓库的组成部分 3.1、数据 包含所有的软件包文件 3.2、元数据 指的是数据文件:包括每个包的包名、版本信息、各包所包含的文件列表、包与包之间的依赖关系、包的分组信息 小扩展:元数据是怎么来的呢? 使用createrepo工具,能够简洁的快速的将我们所指定的存放大量RPM包的目录,里面所有的RPM包信息都读出来,分析他的依赖关系并生成元数据。所以createrepo可以理解为它是制作yum元数据的工具。 在光盘里其实也有这个元数据,路径在光盘中的 [root@www mnt]# cd repodata/ 里,然后是以 sqlite文件后缀 备注:centos5 是以 xml 后缀,centos6、7是以sqlite数据库的方式存储的 四、yum的配置文件介绍 yum的配置文件有2个: 主配置文件 + 仓库配置文件 4.1、主配置文件路径 /etc/yum.conf [main] cachedir=/var/cache/yum/$basearch/$releasever #下载RPM包的缓存目录 keepcache=0 #RPM缓存的程序包安装完成后是否保存,0表示不保存,1表示保存 buglevel=2 #调试级别取值范围0-10,默认值为2 logfile=/var/log/yum.log #yum相关日志存放路径 exactarch=1 #是否要平台完全匹配才能安装 obsoletes=1 #需不需要检查已过期的仓库 gpgcheck=1 #是否检查包的完整性和合法性 plugins=1 #是否允许支持yum的插件功能,0表示不允许,1表示允许,建议允许,一般会用yum-fastestmirror这个插件 installonly_limit=5 #允许保留多少个内核包 bugtracker_url=http://bugs.centos.org/set_project.php?project_id=16&ref=http://bugs.centos.org/bug_report_page.php?category=yum distroverpkg=centos-release #指定一个软件包,yum会根据这个包判断你的发行版本,默认是redhat-release,也可以是安装的任何针对自己发行版的rpm包 4.2、仓库配置文件路径 /etc/yum.repos.d/*.repo 仓库文件可以有多个,而且一个或几个相关的仓库的配置信息也可保存为一个文件,并且所以的仓库文件名都以 .repo结尾。 [REPOID]#容器名字,必须是唯一的 name=#somenameforthisrepository仓库的名字,仅作一个标识 baseurl=#指定真正仓库所在的路径,可以指多个仓库 #例如:baseurl=file:///media/cdrom #ftp://172.168.1.1/path#备注第二行不能顶格写,否则会出错 mirrorlist=#列出容器可以使用站点,如果不想使用,可以再前面加#注释 enabled={0|1}#指是否启用这个仓库,0表示不启用,1表示启用 gpgcheck={0|1}#是否要检测软件包的合法性,0表示不检测,1表示不检查 gpgkey=#软件包的公钥文件所在路径,例如:gpgkey=file:///media/cdrom/GPG-RPM-KEY-centos-6 cost= #仓库优先级,比如一个软件包在多个仓库都有,那应该选择哪个安装呢?就是根据这个优先级,默认是100, 数字越小表示越优先使用 备注:默认各仓库的用法: base库:通常为系统发行版所提供的程序包(就是光盘) updates库:存放更新包 extra库:存放额外包 epel库:epel库文件 库本身有优先级的,但是仅是在客户端有,服务器端是没有优先级的 小贴士:yum可支持多个协议,包括 ftp、http、nfs和本地文件共享服务 所以仓库配置文件中的 baseurl 一项可以有多个写法,下面是各写法的格式 1)ftp 格式:ftp://server/path/to/repository 2)http 格式:http://server/path/to/repository 3)nfs 格式:nfs://server/nfs_path 4)本地文件共享服务 格式:file:///path/to/repository 五、yum安装步骤 六、yum命令的使用 6.1、yum查询功能 yum[option][需要查询的信息][参数] -y:默认yum需要是交互模式,-y表示自动提供yes响应 -q:静默模式 search:搜索某个软件名或关键字 list:列出所有yum所管理的软件包和名称 info:同上,也类似rpm-qai provides:查找该命令是由软件安装生成的,类似rpm-df的功能 repolist:列出所有可用的repo 例如: [root@localhost~]#yumprovidesbash [root@localhost~]#yumrepolist 例如: [root@localhostyum.repos.d]#yuminstallzlib-static 6.2、安装、升级、降级、卸载功能 yum[option][需要查询的信息][参数] install:后面接需要安装的软件 reinstall:后面接需要重新安装的软件 update:后面接需要升级到的软件 check-update:检查可用的升级包 downgrade:后面接需要降级到的版本 remove:卸载软件 erase:功能同上,卸载 --disablerepo=repoid临时禁用此处指定的repo --enablerepo=repoid临时启动此处启用的repo --noplugins:禁用所有插件 例如: [root@localhostyum.repos.d]#yuminstallzlib-static 6.3、和软件组相关的功能 yum[组功能][软件组] grouplist:列出所有可使用的组列表 groupinfo:后面接groupname,可用了解该group内含所有组的名称 groupinstall:安装整组的软件 groupremove:删除某个组的软件 例如: [root@localhostyum.repos.d]#yumgrouplist #所有的包组未一一列举,若想安装某组可使用groupinstall直接安装 InstalledGroups:#已经安装的软件组 AdditionalDevelopment Base Consoleinternettools Developmenttools InstalledLanguageGroups:#已经安装的语言组 ArabicSupport[ar] ArmenianSupport[hy] GeorgianSupport[ka] AvailableGroups:#有效软件组包文件 BackupClient BackupServer AvailableLanguageGroups:#有效的语言组包文件 AfrikaansSupport[af] AlbanianSupport[sq] 6.4、清理缓存 yumclean{all|package|headers} all:将所有的数据删除,包括元数据和软件文件 package:将所有已下载的软件文件删除 headers:删除所有下载的元数据文件 例如: [root@localhostyum.repos.d]#yumcleanall#这样将会清除所有的已下载的元数据和软件文件 Loadedplugins:fastestmirror,security Cleaningrepos:baseextrasupdates CleaningupEverything Cleaninguplistoffastestmirrors 6.5、yum历史命令 yumhistory[info|list|packages-list|packages-info|summary|addon-info|redo|undo] history:列出历史事务 redo:重新执行事务 undo:撤销事务 例如: yumhistoryinfo15//查看yumhistoryid为15的操作 yumhistoryundo15//撤销yumhistoryid为15的操作 日志文件:/var/log/yum.log 6.6、yum内置变量 $releaserver:代表系统的版本,对Yum而言指的是redhat-releaser版本,指向发行版的主版本号;只替换为主版本号,如RedHat 6.5 ,则替换为6 $basearch:系统基本架构,如果是i686,i586等基本架构就为i386 $arch:系统架构 比如我现在的系统是CentOS6.5,系统架构是x86_64,则 baseurl=http://mirrors.163.com/centos/$releasever/os/$basearch/会自动替换为 baseurl=http://mirrors.163.com/centos/6/os/x86_64 六、如何自建yum仓库 6.1、引言: 虽然系统自带的仓库已经很常用,只要连接到互联网我们就能很容易有获取到互联网的yum仓库。但是如果是在企业内网,企业内部不允许访问互联网,又或者如果企业服务器众多,如果都要从互联网去获取yum仓库,那将很占用带宽。基于这种情况,我们就需要自己在企业内部创建yum仓库。 6.2、自建仓库需要使用的命令介绍 createrepo(create repo):创建仓库,在自建仓库时,使用命令createrepo会自动帮我们生成repodata文件作为软件的仓库,而其目录下有四个必要文件:filelists.xml.gz,other.xml.gz,primary.xml.gz和repomd.xml,其中最重要的是repomd.xml文件。一般出现的找不到repodata目录或文件的错误的原因通常有三个:一是路径问题;二是没有生成repodata目录;三是*.repo配置文件冲突(这个需要特意注意)。 小贴士:createrepo命令默认是没有安装,所以我们需要提前安装,createrepo的安装包为“createrepo-0.9.9-17.el6.noarch.rpm”,可以使用RPM或yum先将此程序包安装。 安装方法: #yum-yinstallcreaterepo或rpm-ivhcreaterepo-0.9.9-17.el6.noarch.rpm(路径一定要写对) 6.3、自建yum仓库有2种方法 1)、基于关盘镜像创建yum仓库 2)、根据服务自建提供yum仓库的服务器(ftp、http、nfs) 6.4、基于关盘镜像创建yum仓库 6.4.1、先将光盘挂载至/mnt目录下 mount/dev/cdrom/mnt 6.4.2、配置yum仓库文件 [root@wwwyum.repos.d]#vim/etc/yum.repos.d/local-media.repo#如果local-media.repo不存在,请直接创建 [Meida-repo] name=ThisisLocalmediarepo baseurl=#指向光盘镜像路径 enabled=1#是否启动该仓库 gpgcheck=0#是否检查包完整性 [root@wwwyum.repos.d]#yumcleanall#清除所有的包缓存和元数据 [root@wwwyum.repos.d]#yumlist#列出所有的仓库和程序包 6.5、根据服务自建提供yum仓库的服务器(这里以http服务为例) 6.5.1、首先安装http服务 yum-yinstallhttpd或rpm-ivhhttpd 6.5.2、关闭Linux防火墙和Selinux #防火墙和Selinux可能会影响用户访问HTTP,所以这里需要将其禁用 [root@wwwyum.repos.d]#serviceiptablesstop#关闭防火墙服务 [root@localhost~]#chkconfigiptablesoff#关闭防火墙自动启动 [root@wwwyum.repos.d]#getenforce#查看Selinux状态Enforcing表示启用Permissive表示不启用 Enforcing [root@wwwyum.repos.d]#setenforce0#关闭Selinux0表示关闭1表示开启 [root@wwwyum.repos.d]#getenforce Permissive [root@localhost~]#vim/etc/selinux/config#关闭Selinux开机启动,编辑confg文件,将其中SELINUX字段改为如下设置 SELINUX=disabled 6.5.3、启动httpd服务和开机自动服务 [root@wwwyum.repos.d]#servicehttpdstart#开启httpd服务 [root@wwwyum.repos.d]#chkconfigon#设置httpd服务开机自动启动 [root@localhost~]#netstat-tunlp|grephttp#查看http服务是否已启用 tcp00:::80:::*LISTEN1532/httpd 6.5.4、编辑httpd的文档目录 #httpd默认的目录文档路径为/var/www/html [root@localhosthtml]#mkdir/var/www/html/rpm-repo#创建仓库路径 [root@localhostrpm-repo]#cp-a/mnt/Packages/xcb*/var/www/html/rpm-repo/#拷贝RPM程序包为测试使用 6.5.5、使用createrepo配置yum仓库 [root@localhostrpm-repo]#createrepo/var/www/html/rpm-repo/ 6.5.6、验证和查看http仓库的文件 6.5.7、配置和验证yum仓库 [root@localhostyum.repos.d]#vim/etc/yum.repos.d/local.repo#编辑yum仓库文件,让仓库路径指向http的yum仓库 [http-repo] name=httpyumrepo baseurl=http://192.168.80.150/rpm-repo enabled=1 gpgcheck=0 [root@localhost~]#yumlist 补充:yum只下载rpm包不安装的方法 Yumdownloader 另外一个下载RPM包的方法就是通过一个专门的包下载工具yumdownloader。 这个工具是yum工具包(包含了用来进行yum包管理的帮助工具套件)的子集。 #yuminstallyum-utils 下载一个RPM包: #yumdownloader<package-name> --destdir=/PATH/TO/DIRECTORY:制定下载目录 --resolve:依赖包也会被下载 实例: [root@bash~]#yumdownloadertree Loadedplugins:fastestmirror,langpacks file:///root/test/repodata/repomd.xml:[Errno14]curl#37-"Couldn'topenfile/root/test/repodata/repomd.xml" Tryingothermirror. Loadingmirrorspeedsfromcachedhostfile tree-1.6.0-10.el7.x86_64.rpm [root@bash~]#lstree* tree-1.6.0-10.el7.x86_64.rpm [root@bash~]#yumdownloadersubversion--destdir=/tmp--resolve 下载的包会被保存在当前目录中。你需要使用root权限,因为yumdownloader会在下载过程中更新包索引文件。

优秀的个人博客,低调大师

Docker Compose项目越来越多:用Dockge统一目录与管理

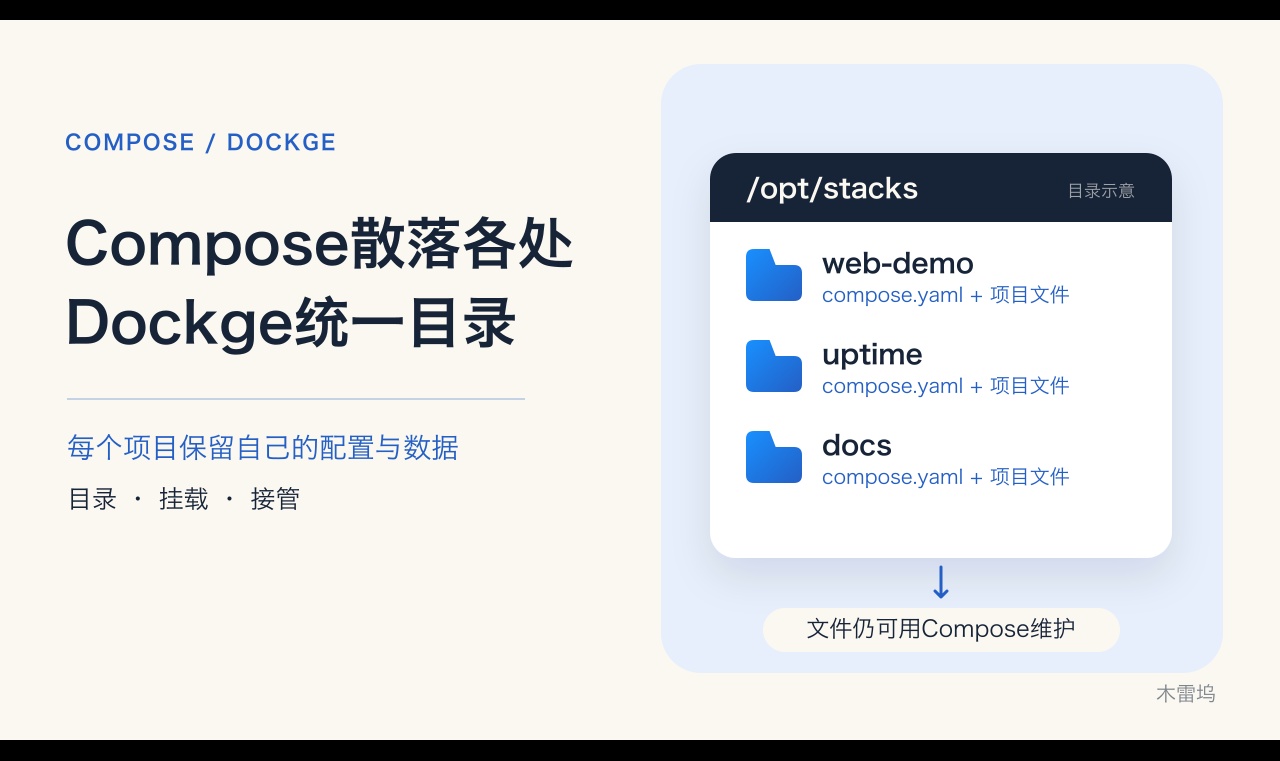
一台Linux服务器上放着网站、监控和内部工具,最先变乱的可能不是容器,而是配置目录:这份在`/srv/web`,那份在某个用户的家目录。服务还在运行,轮到修改端口或重建时,却要先找当初执行`docker compose up -d`的地方。 Dockge适合处理这类Compose项目管理任务。我按官方配置整理了一套步骤,重点是把目录、挂载和接管顺序讲清楚。本文没有执行镜像拉取、容器启动或迁移实测,不把示例当作运行结果。 ## 先约定目录,再装管理页面 Dockge以Compose服务栈为管理对象,能够编辑配置、部署、停止和更新镜像。文件仍保存在服务器上,日后也可以在项目目录使用普通Compose命令维护。 我会把管理工具与业务项目分开: ```text /opt/dockge/ compose.yaml data/ /opt/stacks/ web-demo/compose.yaml web-demo/html/ uptime/compose.yaml uptime/data/ ``` 这里的项目名只是目录示例,没有创建这些业务容器。每个项目单独一层,不把多个应用的Compose都堆进`/opt/stacks`根目录。配置、`.env`和项目相关文件一起维护;密码文件限制读取权限,不提交到公开仓库。 ![tencent-dockge-directory.png](https://developer.qcloudimg.com/http-save/yehe-12695357/19709f79566360d6db8e98b8fdc04eda.png) ## 部署Dockge:三个挂载各有用途 本文面向已安装Docker和Compose V2的Linux主机,按官方当前稳定版本`1.5.0`固定镜像标签。官方镜像提供amd64、arm64和arm/v7构建,部署前仍需确认主机架构与可用磁盘。 先创建目录,再编辑配置。以下命令供读者在自己的服务器执行: ```bash sudo mkdir -p /opt/dockge/data /opt/stacks sudoedit /opt/dockge/compose.yaml ``` 将下面完整内容保存为`/opt/dockge/compose.yaml`: ```yaml services: dockge: image: docker.1ms.run/louislam/dockge:1.5.0 restart: unless-stopped ports: - "127.0.0.1:5001:5001" volumes: - /var/run/docker.sock:/var/run/docker.sock - ./data:/app/data - /opt/stacks:/opt/stacks environment: DOCKGE_STACKS_DIR: /opt/stacks ``` `./data:/app/data`保存Dockge自己的数据;`/opt/stacks:/opt/stacks`让管理工具读取项目文件;Docker socket用于控制宿主机容器。三者不能互相代替,备份Dockge的数据目录也不会顺带备份业务数据库。 镜像获取这一步使用毫秒镜像的完整路径,保留官方项目的仓库名和版本。该路径按Docker Hub映射整理,本轮未验证完整下载;拉取失败时先检查入口、权限和标签,不宣称一定可用,也不因此改成浮动标签。 ```bash cd /opt/dockge sudo docker compose config -q sudo docker compose pull sudo docker compose up -d sudo docker compose ps ``` 示例将端口绑定到服务器本机。远程访问可从个人电脑建立SSH隧道,再用浏览器打开本机5001端口: ```bash ssh -N -L 5001:127.0.0.1:5001 ops@YOUR_SERVER ``` 替换账号和服务器占位值,保持连接,再打开`http://127.0.0.1:5001`。初次打开后完成管理员账号初始化。不要为了省事直接把管理端口开放给所有公网来源:Docker socket具有控制宿主机容器的高权限,管理页面需要按管理员入口保护。`1.5.0`默认关闭Console功能,本文也不启用它。 ## 栈目录两侧路径为什么必须一致 Dockge在容器内解析Compose,再通过socket让宿主机Docker创建业务容器。因此栈目录应使用绝对路径,而且挂载左右两侧必须相同。 例如`/opt/stacks/web-demo/compose.yaml`写了`./html:/usr/share/nginx/html:ro`,相对路径会落到该项目目录下的`html`。宿主机实际需要这个位置,不能只在Dockge容器里看起来存在。 若改用`/srv/stacks`,挂载也要改成`/srv/stacks:/srv/stacks`,同时修改`DOCKGE_STACKS_DIR`。不要写成`/srv/stacks:/opt/stacks`;目录对应关系错了,应用可能读到空目录,或者把新数据写到另一个位置。 新增项目时,可在界面创建服务栈并保存自己的Compose。若从命令行准备文件,把它放入`/opt/stacks/项目名/compose.yaml`,连同相关配置一起准备,再在右上菜单点击“Scan Stacks Folder”。扫描负责发现文件,并不代表业务已经启动成功。 ## 接管已有项目,不能只移动一个YAML 已有服务更需要慢一点。官方接管流程包含停止原栈、把Compose放入栈目录、扫描目录。我会在停止前补上备份和路径清点,再安排维护窗口。 先记录原项目名、启动参数、镜像版本、端口、网络和卷名,保存Compose、`.env`与应用要求的可恢复备份。数据库使用对应数据库的备份方式,不能把运行中的数据目录复制一份就视为完成备份。 随后停止原栈,保留旧目录和数据作为回退依据。把新位置的配置及依赖文件准备齐全,再核对每个bind mount:绝对路径可继续指向已确认的旧数据位置;相对路径则需要连同数据迁移方案一起调整。**不要直接`mv`仍在运行的项目目录,也不要只搬走YAML后盲目重建。** 目录名变化还可能改变默认Compose项目名,导致网络和命名卷采用新名字。接管目录应与原项目名对齐;曾使用`-p`、环境变量或顶层`name:`的项目,先确认这些设置在接管后仍一致。重要已有卷可显式指定原卷名并按外部卷处理,不能误建一个空卷再认为数据丢失。 在新目录先执行`docker compose config -q`检查语法,再检查解析后的挂载与变量;完整配置可能包含敏感值,别把输出随手贴到公开平台。扫描后核对项目归属,确认无误才启动并验业务。使用多份`-f`配置、特殊profiles或构建上下文的旧项目,要先核对Dockge操作与原启动方式是否一致。 ## 管理方便了,维护责任仍在 验收时分别看四件事:页面能登录;栈目录能扫描;应用能完成实际请求;重建后仍使用预期数据。容器显示运行,只回答了其中一部分。 Dockge不是自动备份系统。它的数据目录、各栈的配置与密钥、应用文件、数据库和命名卷需要分别纳入备份,还要留一次恢复验证。界面中的删除也不是只隐藏列表项:项目文件与数据目录的影响必须先确认,别拿正式业务试按钮。 这套整理的价值,是让下一次维护能找到同一份Compose、同一组目录和同一条恢复路径。先把一个测试项目接管清楚,再决定是否迁入其余服务,比一次性搬走所有目录更容易发现问题。 资料依据:Dockge官方1.5.0发行说明与对应版本Compose配置,Docker官方的挂载、项目名和配置解析文档。核对日期为2026年10月14日;示意图为本地绘制,未使用项目后台截图。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册