首页 文章 精选 留言 我的

精选列表

搜索[记忆机制],共10000篇文章
优秀的个人博客,低调大师

WebRTC 传输安全机制第二话:深入显出 SRTP 协议

> 通过 [DTLS 协商](https://mp.weixin.qq.com/s/tHW6sWRZUzkOtl2BsRbV1w)后,RTC 通信的双方完成 `MasterKey` 和 `MasterSalt` 的协商。接下来,我们继续分析在 WebRTC 中,如何使用交换的密钥,来对 RTP 和 RTCP 进行加密,实现数据的安全传输。同时,本文会对 libsrtp 使用中,遇到的问题的进行解答,例如,什么是 ROC,ROC 为什么是 32-bits?为什么会返回 error_code=9, error_code=10?交换的密钥有生命周期吗,如果有是多长时间呢?阅读本篇之前建议阅读[ DTLS 协商篇](https://mp.weixin.qq.com/s/tHW6sWRZUzkOtl2BsRbV1w),两者结合,效果更佳哦! 作者|进学 审校|泰一 ## 要解决的问题 `RTP/RTCP` 协议并没有对它的负载数据进行任何保护。因此,如果***者通过抓包工具,如 Wireshark,将音视频数据抓取到后,通过该工具就可以直接将音视频流播放出来,这是非常恐怖的事情。 在 WebRTC 中,为了防止这类事情发生,没有直接使用 `RTP/RTCP` 协议,而是使用了 `SRTP/SRTCP` 协议 ,即安全的 `RTP/RTCP` 协议。WebRTC 使用了非常有名的 libsrtp 库将原来的 `RTP/RTCP` 协议数据转换成 `SRTP/SRTCP` 协议数据。 [SRTP](https://datatracker.ietf.org/doc/html/rfc3711) 要解决的问题: * 对 `RTP/RTCP` 的负载 (payload) 进行加密,保证数据安全; * 保证 `RTP/RTCP` 包的完整性,同时防重放***。 ## SRTP/SRTCP 结构 ### SRTP 结构 ![](https://ucc.alicdn.com/pic/developer-ecology/d03925f49b0d4564abae1fb4aeb25929.png) 从 SRTP 结构图中可以看到: 1. 加密部分 `Encrypted Portion`,由 `payload`, `RTP padding` 和 `RTP pad count` 部分组成。也就是我们通常所说的仅对 RTP 负载数据加密。 2. 需要校验部分 `Authenticated Portion`,由 `RTP Header`, `RTP Header extension` 和 `Encrypted Portion` 部分组成。 通常情况下只需要对 RTP 负载数据进行加密,如果需要对 RTP header extension 进行加密,[RFC6904](https://datatracker.ietf.org/doc/html/rfc6904) 给出了详细方案,在 libsrtp 中也完成了实现。 ### SRTCP 结构 ![](https://ucc.alicdn.com/pic/developer-ecology/1b0acd94b7e0465aa60d74b9206ace28.png) 从 `SRTCP` 结构图中可以看到: 1. 加密部分 `Encrypted Portion`,为 `RTCP Header` 之后的部分,对 `Compound RTCP` 也是同样。 2. E-flag 显式给出了 RTCP 包是否加密。(PS:一个 RTP 包怎么判断是加密的?) 3. `SRTCP index` 显示给出了 RTCP 包的序列号,用来防重放***。(PS:一个 RTP 包的 16-bits 的序列号可以防重放***吗?) 4. 待校验部分 `Authenticated Portion`,由 `RTCP Header` 和 `Encrypted Portion` 部分组成。 在初步认识了 `SRTP` 和 `SRTCP` 的结构后,接下来介绍 `Encrypted Portion` 和 `Authenticated Portion` 如何得到了。 ## Key 管理 在 `SRTP/SRTCP` 协议中,使用二元组 ` `的方式来标识一个通信参与者的 `SRTP/SRTCP` 会话,称为 `SRTP/SRTCP Session`。 在 SRTP 协议中使用三元组` <***C, RTP/RTCP目的地址,RTP/RTCP目的端口> `来标识一个 stream,一个 `SRTP/SRTCP Session` 由多个 stream 组成。对每个 stream 的加解密相关参数的描述,称为 `Cryptographic Context`。 每个 stream 的 `Cryptographic Context` 中 中的包含如下参数: * ***C: Stream 使用的 ***C。 * Cipher Parameter:加解密使用的 key, salt,算法描述 (类型,参数等)。 * Authentication Parameter: 完整性使用的 Key, salt,算法描述 (类型,参数等)。 * Anti-Replay Data: 防止重放***缓存的数据信息,例如,ROC,最大序号等。 在 `SRTP/SRTCP Session` 中,每个 Stream 都会使用到属于自己的,加解密 Key,Authentication Key。这些 Key 都是在同一个 Session 中使用到的,称为 `Session Key`。这些 `Session Key` 是通过对 `Master Key` 使用 KDF (Key Derivation Function) 导出的。 `KDF` 是用于导出 `Session Key` 函数,KDF 默认使用是加解密函数。例如,在完成 DTLS 后,协商得到的 SRTP 加密算法的 Profile 为: ``` SRTP_AES128_CM_HMAC_SHA1_80 cipher: AES_128_CM cipher_key_length: 128 cipher_salt_length: 112 maximum_lifetime: 2^31 auth_function: HMAC-SHA1 auth_key_length: 160 auth_tag_length: 80 ``` 对应的 `KDF` 为 `AES128_CM`。`Session Key` 的导出流程如下图所示: ![](https://ucc.alicdn.com/pic/developer-ecology/7e7a1c41f70f48e2972c999c6b44df6a.png) `Session Key` 的导出依赖于如下参数: * `key_label`: 根据导出的 Key 的类型不同,`key_label` 取值如下: ![](https://ucc.alicdn.com/pic/developer-ecology/7f7a83693c6348dda31d15501021b435.png) * master_key: DTLS 完成后,协商得到的 Key。 * master_salt: DTLS 完成后,协商得到的 Salt。 * packet_index: RTP/RTCP 的包序号。SRTP 使用 48-bits 的隐式包需要,SRTCP 使用 31-bits 包序号。参考序号管理。 * key_derivation_rate: key 导出速率,记为 kdr。默认取值为 0,执行 1 次 Key 导出。取值范围 `{{1,2,4,...,2^24}`。在 `key_derivation_rate>0` 的情况下,在加密之前,执行一次 key 导出,后续在 `packet_index/key_derivation_rate > 0` 时,执行 key 导出。 ``` r = packet_index / kdr key_id = label || r x = key_id XOR master_salt key = KDF(master_key, x) ``` >'/':表示整除,B=0 时,C = A/B=0。 >||:表示连接的含义。A,B,C 使用网络字节序表示,C = A||B, 则 C 的高字节为 A,低字节位为 B。 >XOR:是异或运算,计算时按照低字节位对齐。 以下使用 `AES128_CM`,举例说明 `Session Key` 的导出过程,假设 DTLS 协商得到: ``` master_key: E1F97A0D3E018BE0D64FA32C06DE4139 // 128-bits master_salt: 0EC675AD498AFEEBB6960B3AABE6 // 112-bits ``` 导出加密 Key (cipher key): ``` packet_index/kdr: 000000000000 label: 00 master_salt: 0EC675AD498AFEEBB6960B3AABE6 ----------------------------------------------- xor: 0EC675AD498AFEEBB6960B3AABE6 (x, KDF input) x*2^16: 0EC675AD498AFEEBB6960B3AABE60000 (AES-CM input) cipher key: C61E7A93744F39EE10734AFE3FF7A087 (AES-CM output) ``` 导出 SALT Key (cipher salt): ``` packet_index/kdr: 000000000000 label: 02 master_salt: 0EC675AD498AFEEBB6960B3AABE6 ---------------------------------------------- xor: 0EC675AD498AFEE9B6960B3AABE6 (x, KDF input) x*2^16: 0EC675AD498AFEE9B6960B3AABE60000 (AES-CM input) 30CBBC08863D8C85D49DB34A9AE17AC6 (AES-CM ouptut) cipher salt: 30CBBC08863D8C85D49DB34A9AE1 ``` 导出校验 Key (auth key),需要 `auth key` 长度为 94 字节: ``` packet_index/kdr: 000000000000 label: 01 master salt: 0EC675AD498AFEEBB6960B3AABE6 ----------------------------------------------- xor: 0EC675AD498AFEEAB6960B3AABE6 (x, KDF input) x*2^16: 0EC675AD498AFEEAB6960B3AABE60000 (AES-CM input) auth key AES input blocks CEBE321F6FF7716B6FD4AB49AF256A15 0EC675AD498AFEEAB6960B3AABE60000 6D38BAA48F0A0ACF3C34E2359E6CDBCE 0EC675AD498AFEEAB6960B3AABE60001 E049646C43D9327AD175578EF7227098 0EC675AD498AFEEAB6960B3AABE60002 6371C10C9A369AC2F94A8C5FBCDDDC25 0EC675AD498AFEEAB6960B3AABE60003 6D6E919A48B610EF17C2041E47403576 0EC675AD498AFEEAB6960B3AABE60004 6B68642C59BBFC2F34DB60DBDFB2 0EC675AD498AFEEAB6960B3AABE60005 ``` >AES-CM 的介绍,参考[ AES-CM](https://www.rfc-editor.org/rfc/rfc3711.html#appendix-B.3)。 至此,我们得到了 `SRTP/SRTCP` 加密和认证需要的 `Session Key`:cipher key,auth key,salt key。 ## 序列号管理 ### SRTP 序列号管理 在 `RTP` 包结构定义中使用 16-bit 来描述序列号。考虑到防重放***,消息完整性校验,加密数据,导出 `SessionKey` 的需要,在 `SRTP` 协议中,SRTP 包的序列号,使用隐式方式来记录包序列号 `packet_index`,使用 i 标识 `packet_index`。 对于发送端来说,i 的计算方式如下: ``` i = 2^16 * ROC + SEQ ``` 其中,SEQ 是 RTP 包中描述的 16-bit 包序号。ROC (rollover couter) 是 RTP 包序号 (SEQ) 翻转计数,也就是每当 `SEQ/2^16=0`, ROC 计数加 1。ROC 初始值为 0。 对于接收端来说,考虑到丢包和乱序因素的影响,除了维护 `ROC`,还需要维护一个当前收到的最大包序号 s_l,当一个新的包到来时候,接收端需要估计出当前包所对应的实际 SRTP 包的序号。ROC 的初始值为 0,s_l 的初始值为收到第一个 SRTP 包的 SEQ。后续通过如下公式,估计接收到的 SRTP 序号 i: ``` i = 2^16 * v + SEQ ``` 其中,`v `可能的取值` { ROC-1, ROC, ROC+1 }`,ROC 是接收端本地维护的 ROC,SEQ 是收到 SRTP 的序号。v 分别取 ROC-1,ROC,ROC+1 计算出 i,与 `2^16*ROC + s_l ` 进行比较,那个更接近,v 就取对应的值。完成 SRTP 解密和完整性校验后,更新 ROC 和 s_l,分如下 3 种情况: 1. v = ROC - 1, ROC 和 s_l 不更新。 2. v = ROC,如果 SEQ > s_1,则更新 s_l = SEQ。 3. v = ROC + 1, ROC = v = ROC + 1,s_l = SEQ。 更直观的代码描述: ``` if (s_l < 32768) if (SEQ - s_l > 32768) set v to (ROC-1) mod 2^32 else set v to ROC endif else if (s_l - 32768 > SEQ) set v to (ROC+1) mod 2^32 else set v to ROC endif endif return SEQ + v*65536 ``` ### SRTCP 序列号管理 `RTCP` 中没有描述序号的字段,`SRTCP` 的序号在 SRTCP 包,使用 `31-bits` 中显示描述,详见 SRTCP 格式,也就是说在 SRTCP 的最大序列号为 2^31。 ### 序列号与通信时长 可以看到 SRTP 的序列号最大值为 2^48, SRTCP 的序列号最大值为 2^16。在大多数应用中(假设每 128000 个 RTP 数据包至少有一个 RTCP 数据包),SRTCP 序号将首先达到上限。以 200 SRTCP 数据包 / 秒的速度, SRTCP 的 2^31 序列号空间足以确保大约 4 个月的通信。 ## 防重放*** ***者将截获的 SRTP/SRTCP 包保存下来,然后重新发送到网络中,实现了包的重放。SRTP 接收者通过维护一个重放列表 (ReplayList) 来防止这种***。理论上 Replay List 应该保存所有接收到并完成校验的包的序列号 index。在实际情况下 ReplayList 使用滑动窗口(sliding window)来实现防重放***。使用 `SRTP-WINDOW-SIZE` 来描述滑动窗口的大小。 ### SRTP 防重放*** 在序列号管理部分,我们详述了接收者,根据接收到的 SRTP 包的 SEQ,ROC,s_l 估算出 SRTP 包的 `packet_index` 的方法。同时,将接收者已经接收到 SRTP 包的最大序列号,记为 `local_packet_index`。计算差值 delta: ``` delta = packet_index - local_packet_index ``` 分如下 3 种情况说明: 1. delta > 0:表示收到了新的包。 2. delta <-(SRTP-WINDOW-SIZE - 1) < 0:表示收到的包的序列号,小于重放窗口要求的最小序号。libSRTP 收到这样的包时,会返回 `srtp_err_status_replay_old=10`, 表示收到旧的重放包。 3. `delta <0, delta>= -(SRTP-WINDOW-SIZE - 1)`: 表示收到了重放窗口之内的包。如果在 ReplayList 找到对应的包,则是一个 index 重复的重放包。libSRTP 收到这样的包时,会返回 `srtp_err_status_replay_fail=9`。否则表示收到一个乱序包。 下图更加直观说明防重放***的三个区域: ![](https://ucc.alicdn.com/pic/developer-ecology/8b50159eec5b43bea56e85fb3151edd4.png) >SRTP-WINDOW-SIZE 的取值,最小是 64。应用可以根据需要设置成较大的值,libsrtp 会向上取整为 32 的整数倍。例如,在 WebRTC 中 `SRTP-WINDOW-SIZE = 1024`。使用者可以根据需要进行调整,但要达到防重放***的目的。 ### SRTCP 防重放*** 在 SRTCP 中,packet index 显式给出。在 libsrtp 中,SRTCP 的防重放***的窗口大小为 128。使用 `window_start` 记录防重放***的起始序列号。SRTCP 防重放***的检查步骤如下: 1. index > window_start + 128: 收到新的 `SRTCP` 包。 2. index < window_start: 收到包的序列号在重放窗口的左侧,可以认为我们收到了比较老的包。libsrtp 收到这样的包之后,会返回到 `srtp_err_status_replay_old=10`。 3. replay_list_index = index - windwo_start:在 ReplayList 中 replay_list_index 对应的标识位为 1,表示已经收到包,libsrtp 返回 `srtp_err_status_replay_fail=9`。对应的标识位为 0,表示收到乱序包。 ## 加密和校验算法 在 SRTP 中,使用了 CTR(Counter mode)模式的 AES 加密算法,CTR 模式通过递增一个加密计数器以产生连续的密钥流,计数器可以是任意保证长时间不产生重复输出的密钥。根据计数方式的不同,分为以下两种类型: * `AES-ICM`: ICM 模式(Integer Counter Mode,整数计数模式),使用整数计数运算。 * `AES-GCM`: GCM 模式(Galois Counter Mode,基于伽罗瓦域计数模式),计数运算定义在伽罗瓦域。 在 SRTP 中,使用 `AES-ICM` 完成加密算法,同时使用 `HMAC-SHA1` 完成 `MAC` 计算,对数据进行完整性校验,加密和 `MAC` 计算需要分两步完成。`AES-GCM` 基于 AEAD(Authenticated-Encryption with Associated-Data,关联数据的认证加密)的思想,在对数据进行加密的同时计算 `MAC` 值,实现了一个步骤,完成加密和校验信息的计算。下面分别对这个 `AES-ICM` 和 `AES_GSM` 的用法进行介绍。 ### AEC—ICM ![](https://ucc.alicdn.com/pic/developer-ecology/b1eacdfd5ef94accbc837f778cd52dbd.png) 上图描述了 `AES-ICM` 的加密和解密过程,图中的 `K` 是通过 KDF 导出的 `SessionKey`。加密和加密都是通过对 Counter 进行加密,与明文 P 异或运算得到加密数据 C,反之,与密文 C 异或运算得到明文数据 P。考虑到安全性,Counter 生成依赖于 `Session Salt`, 包的索引(packet index)和包的 ***C。Counter 是 128-bits 的计数,生成方式如下定义: ``` one byte <--> 0 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+ |00|00|00|00| ***C | packet index | b_c |---+ +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+ | | +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+ v | salt (k_s) |00|00|->(+) +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+ | | v +-------------+ encryption key (k_e) -> | AES encrypt | +-------------+ | +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+ | | keystream block |<--+ +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+ ``` 其中,`b_c` 是 Counter 的计数,初始 `b_c` 的取值为 0,对应 Counter 0, 每加密 128-bits 数据,`b_c` 增加 1,作为下一个 Counter。根据一个 RTP 包的 index,***C 计算出来的 Counter,组成了 keystream,每个 Counter 是一个 keystream block。 通过使用 `AES-ICM` 算法,对 `RTP/RTCP` 的负载进行加密得到了 `Encrypted Portion Portion` 部分。 ### HMAC—SHA1 散列消息认证码(Hash-based message authentication code,缩写为 HMAC),是一种通过特别计算方式之后产生的消息认证码(MAC),使用密码散列函数,同时结合一个加密密钥,它可以用来保证数据的完整性,同时可以用来作某个消息的身份验证。HMAC 通过一个标准算法,在计算哈希的过程中,把 key 混入计算过程中。HMAC 的加密实现如下: ``` HMAC(K,M) = H ( (K XOR opad ) + H( (K XOR ipad ) + M ) ) ``` * H:hash 算法,比如,MD5,SHA-1,SHA-256。 * B:块字节的长度,块是 hash 操作的基本单位。这里 B=64。 * L:hash 算法计算出来的字节长度。(L=16 for MD5, L=20 for SHA-1)。 * K:共享密钥,K 的长度可以是任意的,但是为了安全考虑,还是推荐 K 的长度 > B。当 K 长度大于 `B` 时候,会先在 K 上面执行 hash 算法,将得到的 L 长度结果作为新的共享密钥。如果 K 的长度 <`B`, 那么会在 K 后面填充 0x00 一直到等于长度 B。 * M:要认证的内容。 * opad:外部填充常量,是 0x5C 重复 B 次。 * ipad:内部填充常量,是 0x36 重复 B 次。 * XOR:异或运算。 * +:代表 "连接" 运算。 计算步骤如下: 1. 将 0x00 填充到 K 的后面,直到其长度等于 B。 2. 将步骤 1 的结果跟 ipad 做异或。 3. 将要加密的信息附在步骤 2 的结果后面。 4. 调用 H 方法。 5. 将步骤 1 的结果跟 opad 做异或。 6. 将步骤 4 的结果附在步骤 5 的结果后面。 7. 调用 H 方法。 `SRTP` 和 `SRTCP` 计算 `Authentication tag`,使用的 `K` 对应 Key 管理部分描述的 `RTP auth key` 和 `RTCP auth key`,使用的 Hash 算法为 `SHA-1`,`Authentication tag` 的长度为 80-bits。 在计算 `SRTP` 的,要认证的内容 M 为: ``` M = Authenticated Portion + ROC ``` 其中,`+` 代表 "连接" 运算,`Authenticated Portion` 在 `SRTP` 的结构图中给出。 在计算 `SRTCP` 时,要认证的内容 M 为: ``` M=Authenticated Portion ``` 其中,`Authenticated Portion` 在 `SRTCP` 的结构图中给出。 通过使用 `Authenticated Portion` 算法,计算得到 `SRTP/SRTCP` 的 `Encrypted Portion Portion` 部分。 ### AES—GCM `AES-GCM` 使用计数器模式来加密数据,该操作可以有效地流水线化,GCM 身份验证使用的操作特别适合于硬件中的有效实现。在 [GCM-SPEC](https://csrc.nist.rip/groups/ST/toolkit/BCM/documents/proposedmodes/gcm/gcm-spec.pdf) 详述了 GCM 的理论知识, [Section4.2 Hardware](https://csrc.nist.rip/groups/ST/toolkit/BCM/documents/proposedmodes/gcm/gcm-spec.pdf) 详述了硬件实现。 `AES-GCM` 在 `SRTP` 加密中的应用,在 [RFC7714](https://datatracker.ietf.org/doc/html/rfc7714) 进行了详细描述。Key 管理和序列号管理与本文中描述的相同,需要注意的是: 1. `AES-GCM` 作为一种 `AEAD(Authenticated Encryption with Associated Data`)加密算法,输入和输出是什么,对应到 `SRTP/SRTCP` 的包结构中理解。 2. `Counter` 的是计算方式和 AES-ICM 中描述的计算方式不同,需要重点关注。 [libsrtp](https://github.com/cisco/libsrtp) 已经实现了 `AES-GCM`,有兴趣的同学,可以结合代码进行研读。 ## libsrtp 的使用 [libsrtp](https://github.com/cisco/libsrtp) 是被广泛使用的 `SRTP/SRTCP` 加密的开源项目。经常用到的 api 如下: 1. `srtp_init`,初始化 srtp 库,初始化内部加密算法,在使用 srtp 前,必须要调用了。 2. `srtp_create`, 创建 srtp_session,可以结合本文中介绍的 session,session key 等概念一起理解。 3. `srtp_unprotect/srtp_protect`,RTP 包加解密接口。 4. `srtp_protect_rtcp/srtp_unprotect_rtcp`,RTCP 包的加解密接口。 5.` srtp_set_stream_roc/srtp_get_stream_roc`, 设置和获取 stream 的 ROC,这两个接口在最新的 2.3 版本加入。 重要的结构 `srtp_policy_t`,用来初始化加解密参数,在 `srtp_create` 中使用这个结构。以下参数需要关注: 1. DTLS 协商后得到的 `MasterKey` 和 `MasterSalt` 通过这个结构传递给 libsrtp,用于 session key 的生成。 2. `window_size`,对应我们之前描述的 srtp 防重放***的窗口大小。 3. `allow_repeat_tx`,是否允许重传相同序号的包。 [SRS](https://github.com/o***s/srs) 是一个新生代实时通信服务器,对 libsrtp 感兴趣的同学,可以快速在本机搭起调试环境,进行相关测试,更加深入理解相关的算法。 ## 总结 本文通过对 `SRTP/SRTCP` 相关原理的深入详细解读,对 libsrtp 使用遇到的问题进行解答,希望能够给实时音视频通信的相关领域的同学以帮助。 ## 参考文献 1. [RFC3711: SRTP](https://www.rfc-editor.org/rfc/rfc3711.html) 1. [RFC6904: Encrypted SRTP Header Extensions](https://datatracker.ietf.org/doc/html/rfc6904) 1. [Integer Counter Mode](https://tools.ietf.org/html/draft-irtf-cfrg-icm-00) 1. [RFC-6188: The Use of AES-192 and AES-256 in Secure RTP](https://tools.ietf.org/html/rfc6188) 1. [RFC7714: AES-GCM for SRTP](https://datatracker.ietf.org/doc/html/rfc7714) 1. [RFC2104: HMAC](https://datatracker.ietf.org/doc/html/rfc2104) 1. [RFC2202: Test Cases for HMAC-MD5 and HMAC-SHA-1](https://datatracker.ietf.org/doc/html/rfc2202) 1. [GCM-SPEC: GCM](https://csrc.nist.rip/groups/ST/toolkit/BCM/documents/proposedmodes/gcm/gcm-spec.pdf) >「视频云技术」你最值得关注的音视频技术公众号,每周推送来自阿里云一线的实践技术文章,在这里与音视频领域一流工程师交流切磋。公众号后台回复【技术】可加入阿里云视频云技术交流群,和作者一起探讨音视频技术,获取更多行业最新信息。

优秀的个人博客,低调大师

【SpringCloud技术专题】「Hystrix」(9)熔断器的原理和实现机制

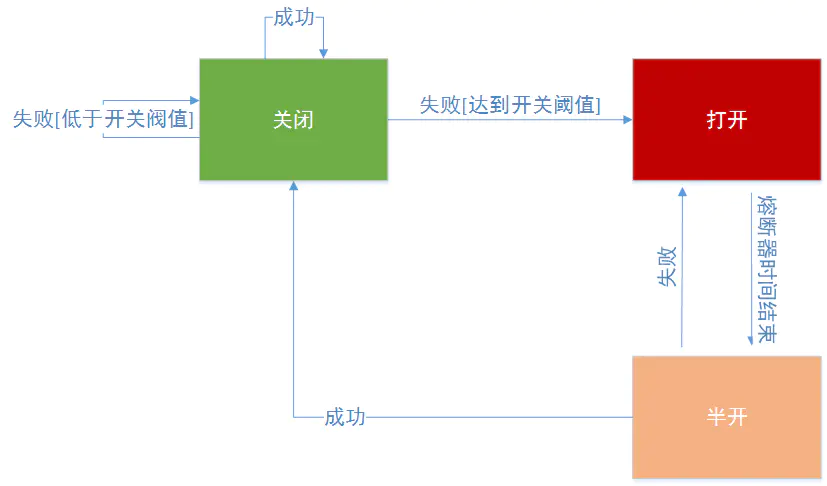
熔断器(Circuit Breaker)介绍 熔断器,现实生活中有一个很好的类比,就是家庭电路中都会安装一个保险盒,当电流过大的时候保险盒里面的保险丝会自动断掉,来保护家里的各种电器及电路。 Hystrix中的熔断器(Circuit Breaker)也是起到这样的作用,Hystrix在运行过程中会向每个commandKey对应的熔断器报告成功、失败、超时和拒绝的状态,熔断器维护计算统计的数据,根据这些统计的信息来确定熔断器是否打开。 如果打开,后续的请求都会被截断。然后会隔一段时间默认是5s,尝试半开,放入一部分流量请求进来,相当于对依赖服务进行一次健康检查,如果恢复,熔断器关闭,随后完全恢复调用。 如下图: 说明,上面说的commandKey,就是在初始化的时候设置的andCommandKey(HystrixCommandKey.Factory.asKey("testCommandKey")) 再来看下熔断器在整个Hystrix流程图中的位置,从步骤4开始,如下图: Hystrix会检查Circuit Breaker的状态。如果Circuit Breaker的状态为开启状态,Hystrix将不会执行对应指令,而是直接进入失败处理状态(图中8 Fallback)。 如果Circuit Breaker的状态为关闭状态,Hystrix会继续进行线程池、任务队列、信号量的检查(图中5) 如何使用熔断器(Circuit Breaker) 由于Hystrix是一个容错框架,因此我们在使用的时候,要达到熔断的目的只需配置一些参数就可以了。但我们要达到真正的效果,就必须要了解这些参数。Circuit Breaker一共包括如下6个参数。 circuitBreaker.enabled:是否启用熔断器,默认是TRUE。 circuitBreaker.forceOpen:熔断器强制打开,始终保持打开状态。默认值FLASE。 circuitBreaker.forceClosed:熔断器强制关闭,始终保持关闭状态。默认值FLASE。 circuitBreaker.errorThresholdPercentage:设定错误百分比,默认值50%,例如一段时间(10s)内有100个请求,其中有55个超时或者异常返回了,那么这段时间内的错误百分比是55%,大于了默认值50%,这种情况下触发熔断器-打开。 circuitBreaker.requestVolumeThreshold:默认值20。意思是至少有20个请求才进行errorThresholdPercentage错误百分比计算。比如一段时间(10s)内有19个请求全部失败了。错误百分比是100%,但熔断器不会打开,因为requestVolumeThreshold的值是20. 这个参数非常重要,熔断器是否打开首先要满足这个条件,源代码如下 // check if we are past the statisticalWindowVolumeThreshold if (health.getTotalRequests() < properties.circuitBreakerRequestVolumeThreshold().get()) { // we are not past the minimum volume threshold for the statisticalWindow so we'll return false immediately and not calculate anything return false; } if (health.getErrorPercentage() < properties.circuitBreakerErrorThresholdPercentage().get()) { return false; } circuitBreaker.sleepWindowInMilliseconds 半开试探休眠时间,默认值5000ms。当熔断器开启一段时间之后比如5000ms,会尝试放过去一部分流量进行试探,确定依赖服务是否恢复。 package myHystrix.threadpool; import com.netflix.hystrix.*; import org.junit.Test; import java.util.Random; /** * Created by wangxindong on 2017/8/15. */ public class GetOrderCircuitBreakerCommand extends HystrixCommand<String> { public GetOrderCircuitBreakerCommand(String name){ super(Setter.withGroupKey(HystrixCommandGroupKey.Factory.asKey("ThreadPoolTestGroup")) .andCommandKey(HystrixCommandKey.Factory.asKey("testCommandKey")) .andThreadPoolKey(HystrixThreadPoolKey.Factory.asKey(name)) .andCommandPropertiesDefaults( HystrixCommandProperties.Setter() .withCircuitBreakerEnabled(true)//默认是true,本例中为了展现该参数 .withCircuitBreakerForceOpen(false)//默认是false,本例中为了展现该参数 .withCircuitBreakerForceClosed(false)//默认是false,本例中为了展现该参数 .withCircuitBreakerErrorThresholdPercentage(5)//(1)错误百分比超过5% .withCircuitBreakerRequestVolumeThreshold(10)//(2)10s以内调用次数10次,同时满足(1)(2)熔断器打开 .withCircuitBreakerSleepWindowInMilliseconds(5000)//隔5s之后,熔断器会尝试半开(关闭),重新放进来请求 // .withExecutionTimeoutInMilliseconds(1000) ) .andThreadPoolPropertiesDefaults( HystrixThreadPoolProperties.Setter() .withMaxQueueSize(10) //配置队列大小 .withCoreSize(2) // 配置线程池里的线程数 ) ); } @Override protected String run() throws Exception { Random rand = new Random(); //模拟错误百分比(方式比较粗鲁但可以证明问题) if(1==rand.nextInt(2)){ // System.out.println("make exception"); throw new Exception("make exception"); } return "running: "; } @Override protected String getFallback() { // System.out.println("FAILBACK"); return "fallback: "; } public static class UnitTest{ @Test public void testCircuitBreaker() throws Exception{ for(int i=0;i<25;i++){ Thread.sleep(500); HystrixCommand<String> command = new GetOrderCircuitBreakerCommand("testCircuitBreaker"); String result = command.execute(); //本例子中从第11次,熔断器开始打开 System.out.println("call times:"+(i+1)+" result:"+result +" isCircuitBreakerOpen: "+command.isCircuitBreakerOpen()); //本例子中5s以后,熔断器尝试关闭,放开新的请求进来 } } } } 测试结果: call times:1 result:fallback: isCircuitBreakerOpen: false call times:2 result:running: isCircuitBreakerOpen: false call times:3 result:running: isCircuitBreakerOpen: false call times:4 result:fallback: isCircuitBreakerOpen: false call times:5 result:running: isCircuitBreakerOpen: false call times:6 result:fallback: isCircuitBreakerOpen: false call times:7 result:fallback: isCircuitBreakerOpen: false call times:8 result:fallback: isCircuitBreakerOpen: false call times:9 result:fallback: isCircuitBreakerOpen: false call times:10 result:fallback: isCircuitBreakerOpen: false 熔断器打开 call times:11 result:fallback: isCircuitBreakerOpen: true call times:12 result:fallback: isCircuitBreakerOpen: true call times:13 result:fallback: isCircuitBreakerOpen: true call times:14 result:fallback: isCircuitBreakerOpen: true call times:15 result:fallback: isCircuitBreakerOpen: true call times:16 result:fallback: isCircuitBreakerOpen: true call times:17 result:fallback: isCircuitBreakerOpen: true call times:18 result:fallback: isCircuitBreakerOpen: true call times:19 result:fallback: isCircuitBreakerOpen: true call times:20 result:fallback: isCircuitBreakerOpen: true 5s后熔断器关闭 call times:21 result:running: isCircuitBreakerOpen: false call times:22 result:running: isCircuitBreakerOpen: false call times:23 result:fallback: isCircuitBreakerOpen: false call times:24 result:running: isCircuitBreakerOpen: false call times:25 result:running: isCircuitBreakerOpen: false 熔断器(Circuit Breaker)源代码HystrixCircuitBreaker.java分析 Factory 是一个工厂类,提供HystrixCircuitBreaker实例 public static class Factory { //用一个ConcurrentHashMap来保存HystrixCircuitBreaker对象 private static ConcurrentHashMap<String, HystrixCircuitBreaker> circuitBreakersByCommand = new ConcurrentHashMap<String, HystrixCircuitBreaker>(); //Hystrix首先会检查ConcurrentHashMap中有没有对应的缓存的断路器,如果有的话直接返回。如果没有的话就会新创建一个HystrixCircuitBreaker实例,将其添加到缓存中并且返回 public static HystrixCircuitBreaker getInstance(HystrixCommandKey key, HystrixCommandGroupKey group, HystrixCommandProperties properties, HystrixCommandMetrics metrics) { HystrixCircuitBreaker previouslyCached = circuitBreakersByCommand.get(key.name()); if (previouslyCached != null) { return previouslyCached; } HystrixCircuitBreaker cbForCommand = circuitBreakersByCommand.putIfAbsent(key.name(), new HystrixCircuitBreakerImpl(key, group, properties, metrics)); if (cbForCommand == null) { return circuitBreakersByCommand.get(key.name()); } else { return cbForCommand; } } public static HystrixCircuitBreaker getInstance(HystrixCommandKey key) { return circuitBreakersByCommand.get(key.name()); } static void reset() { circuitBreakersByCommand.clear(); } } // HystrixCircuitBreakerImpl是HystrixCircuitBreaker的实现,allowRequest()、isOpen()、markSuccess()都会在HystrixCircuitBreakerImpl有默认的实现。 static class HystrixCircuitBreakerImpl implements HystrixCircuitBreaker { private final HystrixCommandProperties properties; private final HystrixCommandMetrics metrics; /* 变量circuitOpen来代表断路器的状态,默认是关闭 */ private AtomicBoolean circuitOpen = new AtomicBoolean(false); /* 变量circuitOpenedOrLastTestedTime记录着断路恢复计时器的初始时间,用于Open状态向Close状态的转换 */ private AtomicLong circuitOpenedOrLastTestedTime = new AtomicLong(); protected HystrixCircuitBreakerImpl(HystrixCommandKey key, HystrixCommandGroupKey commandGroup, HystrixCommandProperties properties, HystrixCommandMetrics metrics) { this.properties = properties; this.metrics = metrics; } /*用于关闭熔断器并重置统计数据*/ public void markSuccess() { if (circuitOpen.get()) { if (circuitOpen.compareAndSet(true, false)) { //win the thread race to reset metrics //Unsubscribe from the current stream to reset the health counts stream. This only affects the health counts view, //and all other metric consumers are unaffected by the reset metrics.resetStream(); } } } @Override public boolean allowRequest() { //是否设置强制开启 if (properties.circuitBreakerForceOpen().get()) { return false; } if (properties.circuitBreakerForceClosed().get()) {//是否设置强制关闭 isOpen(); // properties have asked us to ignore errors so we will ignore the results of isOpen and just allow all traffic through return true; } return !isOpen() || allowSingleTest(); } public boolean allowSingleTest() { long timeCircuitOpenedOrWasLastTested = circuitOpenedOrLastTestedTime.get(); //获取熔断恢复计时器记录的初始时间circuitOpenedOrLastTestedTime,然后判断以下两个条件是否同时满足: // 1) 熔断器的状态为开启状态(circuitOpen.get() == true) // 2) 当前时间与计时器初始时间之差大于计时器阈值circuitBreakerSleepWindowInMilliseconds(默认为 5 秒) //如果同时满足的话,表示可以从Open状态向Close状态转换。Hystrix会通过CAS操作将circuitOpenedOrLastTestedTime设为当前时间,并返回true。如果不同时满足,返回false,代表熔断器关闭或者计时器时间未到。 if (circuitOpen.get() && System.currentTimeMillis() > timeCircuitOpenedOrWasLastTested + properties.circuitBreakerSleepWindowInMilliseconds().get()) { // We push the 'circuitOpenedTime' ahead by 'sleepWindow' since we have allowed one request to try. // If it succeeds the circuit will be closed, otherwise another singleTest will be allowed at the end of the 'sleepWindow'. if (circuitOpenedOrLastTestedTime.compareAndSet(timeCircuitOpenedOrWasLastTested, System.currentTimeMillis())) { // if this returns true that means we set the time so we'll return true to allow the singleTest // if it returned false it means another thread raced us and allowed the singleTest before we did return true; } } return false; } @Override public boolean isOpen() { if (circuitOpen.get()) {//获取断路器的状态 // if we're open we immediately return true and don't bother attempting to 'close' ourself as that is left to allowSingleTest and a subsequent successful test to close return true; } // Metrics数据中获取HealthCounts对象 HealthCounts health = metrics.getHealthCounts(); // 检查对应的请求总数(totalCount)是否小于属性中的请求容量阈值circuitBreakerRequestVolumeThreshold,默认20,如果是的话表示熔断器可以保持关闭状态,返回false if (health.getTotalRequests() < properties.circuitBreakerRequestVolumeThreshold().get()) { return false; } //不满足请求总数条件,就再检查错误比率(errorPercentage)是否小于属性中的错误百分比阈值(circuitBreakerErrorThresholdPercentage,默认 50),如果是的话表示断路器可以保持关闭状态,返回 false if (health.getErrorPercentage() < properties.circuitBreakerErrorThresholdPercentage().get()) { return false; } else { // 如果超过阈值,Hystrix会判定服务的某些地方出现了问题,因此通过CAS操作将断路器设为开启状态,并记录此时的系统时间作为定时器初始时间,最后返回 true if (circuitOpen.compareAndSet(false, true)) { circuitOpenedOrLastTestedTime.set(System.currentTimeMillis()); return true; } else { return true; } } } } 总结 每个熔断器默认维护10个bucket,每秒一个bucket,每个blucket记录成功,失败,超时,拒绝的状态,默认错误超过50%且10秒内超过20个请求进行中断拦截。下图显示HystrixCommand或HystrixObservableCommand如何与HystrixCircuitBreaker及其逻辑和决策流程进行交互,包括计数器在断路器中的行为。

优秀的个人博客,低调大师

JetBrains 旨在通过更好的垃圾回收机制来改善 Kotlin/Native

在 2020 年,JetBrains 的 Kotlin 团队曾发布了重新设计 Kotlin/Native 中内存管理方法的计划。现如今,该团队则对其进展进行了更新,并分享了一些关于内存管理设计的细节。此外,官方透露,他们计划在 2021 年夏季结束前提供一个开发预览。 根据 JetBrains 的说法,最初的 Kotlin/Native 自动内存管理器使用了一个延迟引用计数的垃圾收集器,主要原因是在于它的简单性。然而,现在这个早期的设计选择已经成为提高 Kotlin/Native 性能和开发者体验的障碍,因此该团队正在寻求改进它。 博客内容指出,现代追踪式垃圾收集算法比引用计数式垃圾收集器更加灵活可调,并且更容易适应多线程应用程序的需求。但是,所有追踪式垃圾收集器都有一个共同的弱点--它们需要来自编程语言运行时和编译器的相当复杂的基础架构。 目前,Kotlin 团队正在研究新的基础架构。并透露,他们的第一个任务是确定 roots--内存中所有可以存储对动态分配内存的引用的位置。“这将使我们能够开始追踪一个对象图。” 同时,其还需要一个特殊的基础架构来实现并发垃圾回收算法,以避免阻塞应用程序的关键线程。“何苦?因为我们团队的主要使用场景是运行 UI 应用程序。UI 应用有一个 latency-sensitive 主线程,因此对于 Kotlin/Native 来说,仅支持stop-the-world garbage collection的设计是行不通的。” 因此,Kotlin 团队决定使用所谓的 safe points 方法,根据所有 roots 是否存储在可预测的位置,将编译后的代码染成 safe 或 unsafe。这些位置对运行时来说是已知的,这意味着垃圾回收可以与处于安全状态的代码并发运行。 重新设计的另一个目的则是实现与平台库的无缝互操作性。这需要内存管理器跟踪泄漏到 non-managed world 的自动管理内存的句柄,还需要支持弱引用,以及在自动管理的 Kotlin 对象有一个附加的平台特定对象的情况下运行额外的 deallocation code。 Kotlin 团队表示,其计划实现一种生产就绪的垃圾回收实现,支持线程之间无障碍地共享对象并满足所有其他设计目标。在未来,还可能会有一些受支持的垃圾收集算法,且这些算法都是针对不同的用例进行了优化。 原有的 Kotlin/Native 内存管理方案将继续受到支持,以简化现有应用程序的迁移。因此,开发人员在构建 Kotlin/Native 应用程序时,将能够选择垃圾回收实现。 详情可查看官方博客:https://blog.jetbrains.com/kotlin/2021/05/kotlin-native-memory-management-update/

优秀的个人博客,低调大师

Netty面试常驻题:你知道Netty的零拷贝机制吗?

理解零拷贝 零拷贝是Netty的重要特性之一,而究竟什么是零拷贝呢?WIKI中对其有如下定义: "Zero-copy" describes computer operations in which the CPU does not perform the task of copying data from one memory area to another. 从WIKI的定义中,我们看到“零拷贝”是指计算机操作的过程中,CPU不需要为数据在内存之间的拷贝消耗资源。而它通常是指计算机在网络上发送文件时,不需要将文件内容拷贝到用户空间(User Space)而直接在内核空间(Kernel Space)中传输到网络的方式。 Non-Zero Copy方式: Zero Copy方式: 从上图中可以清楚的看到,Zero Copy的模式中,避免了数据在用户空间和内存空间之间的拷贝,从而提高了系统的整体性能。Linux中的sendfile()以及Java NIO中的FileChannel.transferTo()方法都实现了零拷贝的功能,而在Netty中也通过在FileRegion中包装了NIO的FileChannel.transferTo()方法实现了零拷贝。 而在Netty中还有另一种形式的零拷贝,即Netty允许我们将多段数据合并为一整段虚拟数据供用户使用,而过程中不需要对数据进行拷贝操作,这也是我们今天要讲的重点。我们都知道在stream-based transport(如TCP/IP)的传输过程中,数据包有可能会被重新封装在不同的数据包中,例如当你发送如下数据时: 有可能实际收到的数据如下: 因此在实际应用中,很有可能一条完整的消息被分割为多个数据包进行网络传输,而单个的数据包对你而言是没有意义的,只有当这些数据包组成一条完整的消息时你才能做出正确的处理,而Netty可以通过零拷贝的方式将这些数据包组合成一条完整的消息供你来使用。而此时,零拷贝的作用范围仅在用户空间中。 以Netty 3.8.0.Final的源代码来进行说明 ###ChannelBuffer接口 Netty为需要传输的数据制定了统一的ChannelBuffer接口。该接口的主要设计思路如下: 1.使用getByte(int index)方法来实现随机访问 2.使用双指针的方式实现顺序访问 每个Buffer都有一个读指针(readIndex)和写指针(writeIndex) 在读取数据时读指针后移,在写入数据时写指针后移 定义了统一的接口之后,就是来做各种实现了。Netty主要实现了HeapChannelBuffer,ByteBufferBackedChannelBuffer等等,下面我们就来讲讲与Zero Copy直接相关的CompositeChannelBuffer类。###CompositeChannelBuffer类 CompositeChannelBuffer类的作用是将多个ChannelBuffer组成一个虚拟的ChannelBuffer来进行操作。 为什么说是虚拟的呢,因为CompositeChannelBuffer并没有将多个ChannelBuffer真正的组合起来,而只是保存了他们的引用,这样就避免了数据的拷贝,实现了Zero Copy。下面我们来看看具体的代码实现,首先是成员变量 private int readerIndex; private int writerIndex; private ChannelBuffer[] components; private int[] indices; private int lastAccessedComponentId; 以上这里列出了几个比较重要的成员变量。其中readerIndex既读指针和writerIndex既写指针是从AbstractChannelBuffer继承而来的;然后components是一个ChannelBuffer的数组,他保存了组成这个虚拟Buffer的所有子Buffer,indices是一个int类型的数组,它保存的是各个Buffer的索引值;最后的lastAccessedComponentId是一个int值,它记录了最后一次访问时的子Buffer ID。 从这个数据结构,我们不难发现所谓的CompositeChannelBuffer实际上就是将一系列的Buffer通过数组保存起来,然后实现了ChannelBuffer 的接口,使得在上层看来,操作这些Buffer就像是操作一个单独的Buffer一样。 创建 接下来,我们再看一下CompositeChannelBuffer.setComponents方法,它会在初始化CompositeChannelBuffer时被调用。 /** * Setup this ChannelBuffer from the list */ private void setComponents(List<ChannelBuffer> newComponents) { assert !newComponents.isEmpty(); // Clear the cache. lastAccessedComponentId = 0; // Build the component array. components = new ChannelBuffer[newComponents.size()]; for (int i = 0; i < components.length; i ++) { ChannelBuffer c = newComponents.get(i); if (c.order() != order()) { throw new IllegalArgumentException( "All buffers must have the same endianness."); } assert c.readerIndex() == 0; assert c.writerIndex() == c.capacity(); components[i] = c; } // Build the component lookup table. indices = new int[components.length + 1]; indices[0] = 0; for (int i = 1; i <= components.length; i ++) { indices[i] = indices[i - 1] + components[i - 1].capacity(); } // Reset the indexes. setIndex(0, capacity()); } 通过代码可以看到该方法的功能就是将一个ChannelBuffer的List给组合起来。它首先将List中得元素放入到components数组中,然后创建indices用于数据的查找,最后使用setIndex来重置指针。这里需要注意的是setIndex(0, capacity())会将读指针设置为0,写指针设置为当前Buffer的长度,这也就是前面需要做assert c.readerIndex() == 0和assert c.writerIndex() == c.capacity()这两个判断的原因,否则很容易会造成数据重复读写的问题。 所以Netty推荐我们使用ChannelBuffers.wrappedBuffer方法来进行Buffer的合并,因为在该方法中Netty会通过slice()方法来确保构建CompositeChannelBuffer是传入的所有子Buffer都是符合要求的。 数据访问 CompositeChannelBuffer.getByte(int index)的实现如下: public byte getByte(int index) { int componentId = componentId(index); return components[componentId].getByte(index - indices[componentId]); } 从代码我们可以看到,在随机查找时会首先通过index获取这个字节所在的componentId既字节所在的子Buffer序列,然后通过index - indices[componentId]计算出它在这个子Buffer中的第几个字节,然后返回结果。 下面再来看一下componentId(int index) 的实现: private int componentId(int index) { int lastComponentId = lastAccessedComponentId; if (index >= indices[lastComponentId]) { if (index < indices[lastComponentId + 1]) { return lastComponentId; } // Search right for (int i = lastComponentId + 1; i < components.length; i ++) { if (index < indices[i + 1]) { lastAccessedComponentId = i; return i; } } } else { // Search left for (int i = lastComponentId - 1; i >= 0; i --) { if (index >= indices[i]) { lastAccessedComponentId = i; return i; } } } throw new IndexOutOfBoundsException("Invalid index: " + index + ", maximum: " + indices.length); } 从代码中我们发现,Netty以lastComponentId既上次访问的子Buffer序号为中心,向左右两边进行搜索,这样做的目的是,当我们两次随机查找的字符序列相近时(大部分情况下都是这样),可以最快的搜索到目标索引的componentId。 写在最后 欢迎大家关注我的公众号【风平浪静如码】,海量Java相关文章,学习资料都会在里面更新,整理的资料也会放在里面。 觉得写的还不错的就点个赞,加个关注呗!点关注,不迷路,持续更新!!!

优秀的个人博客,低调大师

使用Chrome开发者工具研究JavaScript的垃圾回收机制

I use the following simple JavaScript code to illustrate: var JerryTestArray = []; (function(){ for( var i = 0; i < 100; i++){ JerryTestArray[i] = document.createElement("div"); } })(); Create a new empty tab in your Chrome, and first create a snapshot with empty heap status by click “Take Snapshot” button: The Snapshot1 is generated. Now switch to tab Console, paste the JavaScript code and execute it in console. And switch to Profiles tab again to make the second snapshot: Once done, select the second snapshot, choose “Comparison” and “Snapshot1” as filter: We can find out from column “New” that 100 div nodes are created as we expect. Since these nodes are not appended to document node so they are invisible to end user, so displayed as “Detached DOM”. The JerryTestArray still holds the reference to each div node so Garbage collector will not touch these nodes. In order to make Garbage collector recycle the memory occupied by these nodes, just assign another value to JerryTestArray in console: Once done, make the third snapshot and compare it with the second. Now we can find that the re-assignment to JerryTestArray will trigger the destruction of those 100 div nodes by Garbage collector: Meanwhile, the string we use in assignment could also be inspected via the combination of filters below: There is another kind of profile in Chrome development tool which can give you an overview about timeline of memory allocation: Click Start button in above screenshot, and paste the following code in console and executed: var JerryTestArray = []; (function(){ for( var i = 0; i < 98; i++){ JerryTestArray[i] = document.createElement("span"); JerryTestArray[i].className = "JerryClassName" + i; } })(); After the code is executed, paste the following code and execute: JerryTestArray[30] = "this is a long test............................end"; Now stop the profile. The profile is displayed as below. The highlighted vertical blue line indicates the timeslot when the 97 Span elements are created. Note that the number of Span elements displayed here is not 98 but 97 since Chrome development tool displays the final status of objects after “stop profile” button is clicked ( the reference to 30th Span element is replaced by String, so it is recycled by GC ). You can drag the two vertical bars to define the time range between which you would like to inspect. For example the time range below contains the timeslot when the below assignment occurs: JerryTestArray[30] = "this is a long test............................end"; With this gained knowledge now we can check the memory allocation and destruction in some real application. For example click tile “My Tasks” to enter this application, make the first snapshot and click back button within application to return to launchpad, and make the second snapshot and review the comparison result. From the result we find out lots of stuff are deleted after we return to launchpad: Hover your mouse to a given destructed object and you can review its detail: For more tips How I use Chrome development tool in my daily work, please refer to this blog Chrome Development Tool tips used in my daily work 本文来自云栖社区合作伙伴“汪子熙”,了解相关信息可以关注微信公众号"汪子熙"。

优秀的个人博客,低调大师

夯实Java基础系列12:深入理解Java中的反射机制

本系列文章将整理到我在GitHub上的《Java面试指南》仓库,更多精彩内容请到我的仓库里查看 https://github.com/h2pl/Java-Tutorial 喜欢的话麻烦点下Star哈 文章首发于我的个人博客: www.how2playlife.com 枚举(enum)类型是Java 5新增的特性,它是一种新的类型,允许用常量来表示特定的数据片断,而且全部都以类型安全的形式来表示。 ## 初探枚举类 在程序设计中,有时会用到由若干个有限数据元素组成的集合,如一周内的星期一到星期日七个数据元素组成的集合,由三种颜色红、黄、绿组成的集合,一个工作班组内十个职工组成的集合等等,程序中某个变量取值仅限于集合中的元素。此时,可将这些数据集合定义为枚举类型。 因此,枚举类型是某类数据可能取值的集合,如一周内星期可能取值的集合为: { Sun,Mon,Tue,Wed,Thu,Fri,Sat} 该集合可定义为描述星期的枚举类型,该枚举类型共有七个元素,因而用枚举类型定义的枚举变量只能取集合中的某一元素值。由于枚举类型是导出数据类型,因此,必须先定义枚举类型,然后再用枚举类型定义枚举型变量。 enum <枚举类型名> { <枚举元素表> }; 其中:关键词enum表示定义的是枚举类型,枚举类型名由标识符组成,而枚举元素表由枚举元素或枚举常量组成。例如: enum weekdays { Sun,Mon,Tue,Wed,Thu,Fri,Sat }; 定义了一个名为 weekdays的枚举类型,它包含七个元素:Sun、Mon、Tue、Wed、Thu、Fri、Sat。 在编译器编译程序时,给枚举类型中的每一个元素指定一个整型常量值(也称为序号值)。若枚举类型定义中没有指定元素的整型常量值,则整型常量值从0开始依次递增,因此,weekdays枚举类型的七个元素Sun、Mon、Tue、Wed、Thu、Fri、Sat对应的整型常量值分别为0、1、2、3、4、5、6。 注意:在定义枚举类型时,也可指定元素对应的整型常量值。 例如,描述逻辑值集合{TRUE、FALSE}的枚举类型boolean可定义如下: enum boolean { TRUE=1 ,FALSE=0 }; 该定义规定:TRUE的值为1,而FALSE的值为0。 而描述颜色集合{red,blue,green,black,white,yellow}的枚举类型colors可定义如下: enum colors {red=5,blue=1,green,black,white,yellow}; 该定义规定red为5 ,blue为1,其后元素值从2 开始递增加1。green、black、white、yellow的值依次为2、3、4、5。 此时,整数5将用于表示二种颜色red与yellow。通常两个不同元素取相同的整数值是没有意义的。枚举类型的定义只是定义了一个新的数据类型,只有用枚举类型定义枚举变量才能使用这种数据类型。 ### 枚举类-语法 enum 与 class、interface 具有相同地位;可以继承多个接口;可以拥有构造器、成员方法、成员变量;1.2 枚举类与普通类不同之处 默认继承 java.lang.Enum 类,所以不能继承其他父类;其中 java.lang.Enum 类实现了 java.lang.Serializable 和 java.lang.Comparable 接口; 使用 enum 定义,默认使用 final 修饰,因此不能派生子类; 构造器默认使用 private 修饰,且只能使用 private 修饰; 枚举类所有实例必须在第一行给出,默认添加 public static final 修饰,否则无法产生实例; 枚举类的具体使用 这部分内容参考https://blog.csdn.net/qq_27093465/article/details/52180865 常量 public class 常量 { } enum Color { Red, Green, Blue, Yellow } switch JDK1.6之前的switch语句只支持int,char,enum类型,使用枚举,能让我们的代码可读性更强。 public static void showColor(Color color) { switch (color) { case Red: System.out.println(color); break; case Blue: System.out.println(color); break; case Yellow: System.out.println(color); break; case Green: System.out.println(color); break; } } 向枚举中添加新方法 如果打算自定义自己的方法,那么必须在enum实例序列的最后添加一个分号。而且 Java 要求必须先定义 enum 实例。 enum Color { //每个颜色都是枚举类的一个实例,并且构造方法要和枚举类的格式相符合。 //如果实例后面有其他内容,实例序列结束时要加分号。 Red("红色", 1), Green("绿色", 2), Blue("蓝色", 3), Yellow("黄色", 4); String name; int index; Color(String name, int index) { this.name = name; this.index = index; } public void showAllColors() { //values是Color实例的数组,在通过index和name可以获取对应的值。 for (Color color : Color.values()) { System.out.println(color.index + ":" + color.name); } } } 覆盖枚举的方法 所有枚举类都继承自Enum类,所以可以重写该类的方法下面给出一个toString()方法覆盖的例子。 @Override public String toString() { return this.index + ":" + this.name; } 实现接口 所有的枚举都继承自java.lang.Enum类。由于Java 不支持多继承,所以枚举对象不能再继承其他类。 enum Color implements Print{ @Override public void print() { System.out.println(this.name); } } 使用接口组织枚举 搞个实现接口,来组织枚举,简单讲,就是分类吧。如果大量使用枚举的话,这么干,在写代码的时候,就很方便调用啦。 public class 用接口组织枚举 { public static void main(String[] args) { Food cf = chineseFood.dumpling; Food jf = Food.JapaneseFood.fishpiece; for (Food food : chineseFood.values()) { System.out.println(food); } for (Food food : Food.JapaneseFood.values()) { System.out.println(food); } } } interface Food { enum JapaneseFood implements Food { suse, fishpiece } } enum chineseFood implements Food { dumpling, tofu } 枚举类集合 java.util.EnumSet和java.util.EnumMap是两个枚举集合。EnumSet保证集合中的元素不重复;EnumMap中的 key是enum类型,而value则可以是任意类型。 EnumSet在JDK中没有找到实现类,这里写一个EnumMap的例子 public class 枚举类集合 { public static void main(String[] args) { EnumMap<Color, String> map = new EnumMap<Color, String>(Color.class); map.put(Color.Blue, "Blue"); map.put(Color.Yellow, "Yellow"); map.put(Color.Red, "Red"); System.out.println(map.get(Color.Red)); } } 使用枚举类的注意事项 枚举类型对象之间的值比较,是可以使用==,直接来比较值,是否相等的,不是必须使用equals方法的哟。 因为枚举类Enum已经重写了equals方法 /** * Returns true if the specified object is equal to this * enum constant. * * @param other the object to be compared for equality with this object. * @return true if the specified object is equal to this * enum constant. */ public final boolean equals(Object other) { return this==other; } 枚举类的实现原理 这部分参考https://blog.csdn.net/mhmyqn/article/details/48087247 Java从JDK1.5开始支持枚举,也就是说,Java一开始是不支持枚举的,就像泛型一样,都是JDK1.5才加入的新特性。通常一个特性如果在一开始没有提供,在语言发展后期才添加,会遇到一个问题,就是向后兼容性的问题。 像Java在1.5中引入的很多特性,为了向后兼容,编译器会帮我们写的源代码做很多事情,比如泛型为什么会擦除类型,为什么会生成桥接方法,foreach迭代,自动装箱/拆箱等,这有个术语叫“语法糖”,而编译器的特殊处理叫“解语法糖”。那么像枚举也是在JDK1.5中才引入的,又是怎么实现的呢? Java在1.5中添加了java.lang.Enum抽象类,它是所有枚举类型基类。提供了一些基础属性和基础方法。同时,对把枚举用作Set和Map也提供了支持,即java.util.EnumSet和java.util.EnumMap。 接下来定义一个简单的枚举类 public enum Day { MONDAY { @Override void say() { System.out.println("MONDAY"); } } , TUESDAY { @Override void say() { System.out.println("TUESDAY"); } }, FRIDAY("work"){ @Override void say() { System.out.println("FRIDAY"); } }, SUNDAY("free"){ @Override void say() { System.out.println("SUNDAY"); } }; String work; //没有构造参数时,每个实例可以看做常量。 //使用构造参数时,每个实例都会变得不一样,可以看做不同的类型,所以编译后会生成实例个数对应的class。 private Day(String work) { this.work = work; } private Day() { } //枚举实例必须实现枚举类中的抽象方法 abstract void say (); } 反编译结果 D:\MyTech\out\production\MyTech\com\javase\枚举类>javap Day.class Compiled from "Day.java" public abstract class com.javase.枚举类.Day extends java.lang.Enum<com.javase.枚举类.Day> { public static final com.javase.枚举类.Day MONDAY; public static final com.javase.枚举类.Day TUESDAY; public static final com.javase.枚举类.Day FRIDAY; public static final com.javase.枚举类.Day SUNDAY; java.lang.String work; public static com.javase.枚举类.Day[] values(); public static com.javase.枚举类.Day valueOf(java.lang.String); abstract void say(); com.javase.枚举类.Day(java.lang.String, int, com.javase.枚举类.Day$1); com.javase.枚举类.Day(java.lang.String, int, java.lang.String, com.javase.枚举类.Day$1); static {}; } 可以看到,一个枚举在经过编译器编译过后,变成了一个抽象类,它继承了java.lang.Enum;而枚举中定义的枚举常量,变成了相应的public static final属性,而且其类型就抽象类的类型,名字就是枚举常量的名字. 同时我们可以在Operator.class的相同路径下看到四个内部类的.class文件com/mikan/Day$1.class、com/mikan/Day$2.class、com/mikan/Day$3.class、com/mikan/Day$4.class,也就是说这四个命名字段分别使用了内部类来实现的;同时添加了两个方法values()和valueOf(String);我们定义的构造方法本来只有一个参数,但却变成了三个参数;同时还生成了一个静态代码块。这些具体的内容接下来仔细看看。 下面分析一下字节码中的各部分,其中: InnerClasses: static #23; //class com/javase/枚举类/Day$4 static #18; //class com/javase/枚举类/Day$3 static #14; //class com/javase/枚举类/Day$2 static #10; //class com/javase/枚举类/Day$1 从中可以看到它有4个内部类,这四个内部类的详细信息后面会分析。 static {}; descriptor: ()V flags: ACC_STATIC Code: stack=5, locals=0, args_size=0 0: new #10 // class com/javase/枚举类/Day$1 3: dup 4: ldc #11 // String MONDAY 6: iconst_0 7: invokespecial #12 // Method com/javase/枚举类/Day$1."<init>":(Ljava/lang/String;I)V 10: putstatic #13 // Field MONDAY:Lcom/javase/枚举类/Day; 13: new #14 // class com/javase/枚举类/Day$2 16: dup 17: ldc #15 // String TUESDAY 19: iconst_1 20: invokespecial #16 // Method com/javase/枚举类/Day$2."<init>":(Ljava/lang/String;I)V //后面类似,这里省略 } 其实编译器生成的这个静态代码块做了如下工作:分别设置生成的四个公共静态常量字段的值,同时编译器还生成了一个静态字段$VALUES,保存的是枚举类型定义的所有枚举常量编译器添加的values方法: public static com.javase.Day[] values(); flags: ACC_PUBLIC, ACC_STATIC Code: stack=1, locals=0, args_size=0 0: getstatic #2 // Field $VALUES:[Lcom/javase/Day; 3: invokevirtual #3 // Method "[Lcom/mikan/Day;".clone:()Ljava/lang/Object; 6: checkcast #4 // class "[Lcom/javase/Day;" 9: areturn 这个方法是一个公共的静态方法,所以我们可以直接调用该方法(Day.values()),返回这个枚举值的数组,另外,这个方法的实现是,克隆在静态代码块中初始化的$VALUES字段的值,并把类型强转成Day[]类型返回。 造方法为什么增加了两个参数? 有一个问题,构造方法我们明明只定义了一个参数,为什么生成的构造方法是三个参数呢? 从Enum类中我们可以看到,为每个枚举都定义了两个属性,name和ordinal,name表示我们定义的枚举常量的名称,如FRIDAY、TUESDAY,而ordinal是一个顺序号,根据定义的顺序分别赋予一个整形值,从0开始。在枚举常量初始化时,会自动为初始化这两个字段,设置相应的值,所以才在构造方法中添加了两个参数。即: 另外三个枚举常量生成的内部类基本上差不多,这里就不重复说明了。 我们可以从Enum类的代码中看到,定义的name和ordinal属性都是final的,而且大部分方法也都是final的,特别是clone、readObject、writeObject这三个方法,这三个方法和枚举通过静态代码块来进行初始化一起。 它保证了枚举类型的不可变性,不能通过克隆,不能通过序列化和反序列化来复制枚举,这能保证一个枚举常量只是一个实例,即是单例的,所以在effective java中推荐使用枚举来实现单例。 枚举类实战 实战一无参 (1)定义一个无参枚举类 enum SeasonType { SPRING, SUMMER, AUTUMN, WINTER } (2)实战中的使用 // 根据实际情况选择下面的用法即可 SeasonType springType = SeasonType.SPRING; // 输出 SPRING String springString = SeasonType.SPRING.toString(); // 输出 SPRING 实战二有一参 (1)定义只有一个参数的枚举类 enum SeasonType { // 通过构造函数传递参数并创建实例 SPRING("spring"), SUMMER("summer"), AUTUMN("autumn"), WINTER("winter"); // 定义实例对应的参数 private String msg; // 必写:通过此构造器给枚举值创建实例 SeasonType(String msg) { this.msg = msg; } // 通过此方法可以获取到对应实例的参数值 public String getMsg() { return msg; } } (2)实战中的使用 // 当我们为某个实例类赋值的时候可使用如下方式 String msg = SeasonType.SPRING.getMsg(); // 输出 spring 实战三有两参 (1)定义有两个参数的枚举类 public enum Season { // 通过构造函数传递参数并创建实例 SPRING(1, "spring"), SUMMER(2, "summer"), AUTUMN(3, "autumn"), WINTER(4, "winter"); // 定义实例对应的参数 private Integer key; private String msg; // 必写:通过此构造器给枚举值创建实例 Season(Integer key, String msg) { this.key = key; this.msg = msg; } // 很多情况,我们可能从前端拿到的值是枚举类的 key ,然后就可以通过以下静态方法获取到对应枚举值 public static Season valueofKey(Integer key) { for (Season season : Season.values()) { if (season.key.equals(key)) { return season; } } throw new IllegalArgumentException("No element matches " + key); } // 通过此方法可以获取到对应实例的 key 值 public Integer getKey() { return key; } // 通过此方法可以获取到对应实例的 msg 值 public String getMsg() { return msg; } } (2)实战中的使用 // 输出 key 为 1 的枚举值实例 Season season = Season.valueofKey(1); // 输出 SPRING 实例对应的 key Integer key = Season.SPRING.getKey(); // 输出 SPRING 实例对应的 msg String msg = Season.SPRING.getMsg(); 枚举类总结 其实枚举类懂了其概念后,枚举就变得相当简单了,随手就可以写一个枚举类出来。所以如上几个实战小例子一定要先搞清楚概念,然后在练习几遍就 ok 了。 重要的概念,我在这里在赘述一遍,帮助老铁们快速掌握这块知识,首先记住,枚举类中的枚举值可以没有参数,也可以有多个参数,每一个枚举值都是一个实例; 并且还有一点很重要,就是如果枚举值有 n 个参数,那么构造函数中的参数值肯定有 n 个,因为声明的每一个枚举值都会调用构造函数去创建实例,所以参数一定是一一对应的;既然明白了这一点,那么我们只需要在枚举类中把这 n 个参数定义为 n 个成员变量,然后提供对应的 get() 方法,之后通过实例就可以随意的获取实例中的任意参数值了。 如果想让枚举类更加的好用,就可以模仿我在实战三中的写法那样,通过某一个参数值,比如 key 参数值,就能获取到其对应的枚举值,然后想要什么值,就 get 什么值就好了。 枚举 API 我们使用 enum 定义的枚举类都是继承 java.lang.Enum 类的,那么就会继承其 API ,常用的 API 如下: String name() 获取枚举名称 int ordinal() 获取枚举的位置(下标,初始值为 0 ) valueof(String msg) 通过 msg 获取其对应的枚举类型。(比如实战二中的枚举类或其它枚举类都行,只要使用得当都可以使用此方法) values() 获取枚举类中的所有枚举值(比如在实战三中就使用到了) 总结 枚举本质上是通过普通的类来实现的,只是编译器为我们进行了处理。每个枚举类型都继承自java.lang.Enum,并自动添加了values和valueOf方法。 而每个枚举常量是一个静态常量字段,使用内部类实现,该内部类继承了枚举类。所有枚举常量都通过静态代码块来进行初始化,即在类加载期间就初始化。 另外通过把clone、readObject、writeObject这三个方法定义为final的,同时实现是抛出相应的异常。这样保证了每个枚举类型及枚举常量都是不可变的。可以利用枚举的这两个特性来实现线程安全的单例。 参考文章 https://blog.csdn.net/qq_34988624/article/details/86592229https://www.meiwen.com.cn/subject/slhvhqtx.htmlhttps://blog.csdn.net/qq_34988624/article/details/86592229https://segmentfault.com/a/1190000012220863https://my.oschina.net/wuxinshui/blog/1511484https://blog.csdn.net/hukailee/article/details/81107412 微信公众号 Java技术江湖 如果大家想要实时关注我更新的文章以及分享的干货的话,可以关注我的公众号【Java技术江湖】一位阿里 Java 工程师的技术小站,作者黄小斜,专注 Java 相关技术:SSM、SpringBoot、MySQL、分布式、中间件、集群、Linux、网络、多线程,偶尔讲点Docker、ELK,同时也分享技术干货和学习经验,致力于Java全栈开发! Java工程师必备学习资源: 一些Java工程师常用学习资源,关注公众号后,后台回复关键字 “Java” 即可免费无套路获取。 个人公众号:黄小斜 作者是 985 硕士,蚂蚁金服 JAVA 工程师,专注于 JAVA 后端技术栈:SpringBoot、MySQL、分布式、中间件、微服务,同时也懂点投资理财,偶尔讲点算法和计算机理论基础,坚持学习和写作,相信终身学习的力量! 程序员3T技术学习资源: 一些程序员学习技术的资源大礼包,关注公众号后,后台回复关键字 “资料” 即可免费无套路获取。


优秀的个人博客,低调大师

浏览器事件机制中 事件触发的三个阶段

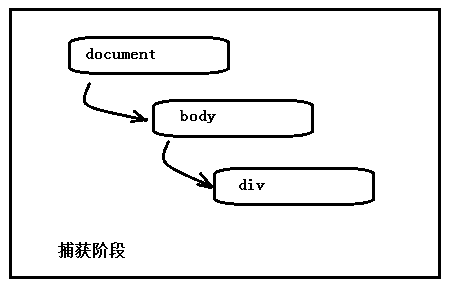
javaScript事件的三个阶段:捕获阶段 目标阶段 冒泡阶段 捕获阶段 概念: 事件从根节点流向目标节点,途中流经各个DOM节点,在各个节点上触发捕获事件,直到达到目标节点。 目标阶段 概念: 事件到达目标节点时,就到了目标阶段,事件在目标节点上被触发 冒泡阶段 概念: 事件在目标节点上触发后,不会终止,一层层向上冒,回溯到根节点 addEventListener attachEvent (IE 特有) 的第三个参数的作用,通过查文档可以知,addEventListener的第三个参数是一个布尔类型1、第三个参数是false:事件从里到外执行,这种效果叫事件冒泡2、第三个参数是true:事件从里到外执行,执行顺序颠倒过来了,这种效果叫做事件捕获。 a. 事件从里到外执行,这种效果叫事件冒泡 b. 事件从里到外执行,执行顺序颠倒过来了,这种效果叫做事件捕获。 注意:事件发生的时候,要经过事件的三个阶段,我们常常使用的是事件冒泡阶段,而其他两个阶段不能人为干预。 小结:事件的三个阶段 第一阶段:捕获阶段 第二阶段:目标阶段(执行当前点击的元素) 第三阶段:冒泡阶段 事件三个阶段如下如 第一阶段:捕获阶段 第二阶段:目标阶段(执行当前点击的元素) 第三阶段:冒泡阶段 注意,注册事件有三种,其中onclick、attachEvent没有第三个参数,实际上我们无法通过onclick、attachEvent来干预事件的第一阶段和第二阶段,并且很多时候我们只关心事件的第三阶段,即冒泡阶段。

优秀的个人博客,低调大师

老生常谈Java虚拟机垃圾回收机制(必看篇)

二、垃圾收集 垃圾收集主要是针对堆和方法区进行。 程序计数器、虚拟机栈和本地方法栈这三个区域属于线程私有的,只存在于线程的生命周期内,线程结束之后也会消失,因此不需要对这三个区域进行垃圾回收。 判断一个对象是否可被回收 1. 引用计数算法 给对象添加一个引用计数器,当对象增加一个引用时计数器加 1,引用失效时计数器减 1。引用计数为 0 的对象可被回收。 两个对象出现循环引用的情况下,此时引用计数器永远不为 0,导致无法对它们进行回收。 正因为循环引用的存在,因此 Java 虚拟机不使用引用计数算法。 public class ReferenceCountingGC { public Object instance = null; public static void main(String[] args) { ReferenceCountingGC objectA = new ReferenceCountingGC(); ReferenceCountingGC objectB = new ReferenceCountingGC(); objectA.instance = objectB; objectB.instance = objectA; } } 2. 可达性分析算法 通过 GC Roots 作为起始点进行搜索,能够到达到的对象都是存活的,不可达的对象可被回收。 Java 虚拟机使用该算法来判断对象是否可被回收,在 Java 中 GC Roots 一般包含以下内容: 虚拟机栈中局部变量表中引用的对象 本地方法栈中 JNI 中引用的对象 方法区中类静态属性引用的对象 方法区中的常量引用的对象 3. 方法区的回收 因为方法区主要存放永久代对象,而永久代对象的回收率比新生代低很多,因此在方法区上进行回收性价比不高。 主要是对常量池的回收和对类的卸载。 在大量使用反射、动态代理、CGLib 等 ByteCode 框架、 动态生成 JSP 以及 OSGi 这类频繁自定义 ClassLoader 的场景都需要虚拟机具备类卸载功能,以保证不会出现内存溢出。 类的卸载条件很多,需要满足以下三个条件,并且满足了也不一定会被卸载: 该类所有的实例都已经被回收,也就是堆中不存在该类的任何实例。 加载该类的ClassLoader 已经被回收。 该类对应的Class 对象没有在任何地方被引用,也就无法在任何地方通过反射访问该类方法。 可以通过 -Xnoclassgc 参数来控制是否对类进行卸载。 4. finalize() finalize() 类似 C++ 的析构函数,用来做关闭外部资源等工作。但是 try-finally 等方式可以做的更好, 并且该方法运行代价高昂,不确定性大,无法保证各个对象的调用顺序,因此最好不要使用。 当一个对象可被回收时,如果需要执行该对象的 finalize() 方法, 那么就有可能在该方法中让对象重新被引用,从而实现自救。自救只能进行一次,如果回收的对象之前调用了 finalize() 方法自救,后面回收时不会调用 finalize() 方法。 引用类型 无论是通过引用计算算法判断对象的引用数量,还是通过可达性分析算法判断对象是否可达, 判定对象是否可被回收都与引用有关。 Java 提供了四种强度不同的引用类型。 1. 强引用 被强引用关联的对象不会被回收。 使用 new 一个新对象的方式来创建强引用。 Object obj = new Object(); 2. 软引用 被软引用关联的对象只有在内存不够的情况下才会被回收。 使用 SoftReference 类来创建软引用。 Object obj = new Object(); SoftReference<Object> sf = new SoftReference<Object>(obj); obj = null; // 使对象只被软引用关联 3. 弱引用 被弱引用关联的对象一定会被回收,也就是说它只能存活到下一次垃圾回收发生之前。 使用 WeakReference 类来实现弱引用。 Object obj = new Object(); WeakReference<Object> wf = new WeakReference<Object>(obj); obj = null; 4. 虚引用 又称为幽灵引用或者幻影引用。一个对象是否有虚引用的存在, 完全不会对其生存时间构成影响,也无法通过虚引用取得一个对象。 为一个对象设置虚引用关联的唯一目的就是能在这个对象被回收时收到一个系统通知。 使用 PhantomReference 来实现虚引用。 Object obj = new Object(); PhantomReference<Object> pf = new PhantomReference<Object>(obj); obj = null; 垃圾收集算法 1. 标记 - 清除 将存活的对象进行标记,然后清理掉未被标记的对象。 不足: 标记和清除过程效率都不高; 会产生大量不连续的内存碎片,导致无法给大对象分配内存。 2. 标记 - 整理 让所有存活的对象都向一端移动,然后直接清理掉端边界以外的内存。 3. 复制 将内存划分为大小相等的两块,每次只使用其中一块,当这一块内存用完了就将还存活的对象复制到另一块上面,然后再把使用过的内存空间进行一次清理。 主要不足是只使用了内存的一半。 现在的商业虚拟机都采用这种收集算法来回收新生代,但是并不是将新生代划分为大小相等的两块,而是分为一块较大的 Eden 空间和两块较小的 Survivor 空间,每次使用 Eden 空间和其中一块 Survivor。在回收时,将 Eden 和 Survivor 中还存活着的对象一次性复制到另一块 Survivor 空间上,最后清理 Eden 和使用过的那一块 Survivor。 HotSpot 虚拟机的 Eden 和 Survivor 的大小比例默认为 8:1,保证了内存的利用率达到 90%。如果每次回收有多于 10% 的对象存活,那么一块 Survivor 空间就不够用了,此时需要依赖于老年代进行分配担保,也就是借用老年代的空间存储放不下的对象。 4. 分代收集 现在的商业虚拟机采用分代收集算法,它根据对象存活周期将内存划分为几块,不同块采用适当的收集算法。 一般将堆分为新生代和老年代。 新生代使用:复制算法 老年代使用:标记 - 清除 或者 标记 - 整理 算法 垃圾收集器 以上是 HotSpot 虚拟机中的 7 个垃圾收集器,连线表示垃圾收集器可以配合使用。 单线程与多线程:单线程指的是垃圾收集器只使用一个线程进行收集,而多线程使用多个线程; 串行与并行:串行指的是垃圾收集器与用户程序交替执行,这意味着在执行垃圾收集的时候需要停顿用户程序;并行指的是垃圾收集器和用户程序同时执行。除了CMS和G1之外,其它垃圾收集器都是以串行的方式执行。 1. Serial 收集器 Serial 翻译为串行,也就是说它以串行的方式执行。 它是单线程的收集器,只会使用一个线程进行垃圾收集工作。 它的优点是简单高效,对于单个 CPU 环境来说,由于没有线程交互的开销,因此拥有最高的单线程收集效率。 它是 Client 模式下的默认新生代收集器,因为在该应用场景下,分配给虚拟机管理的内存一般来说不会很大。Serial 收集器收集几十兆甚至一两百兆的新生代停顿时间可以控制在一百多毫秒以内,只要不是太频繁,这点停顿是可以接受的。 2. ParNew 收集器 它是 Serial 收集器的多线程版本。 是 Server 模式下的虚拟机首选新生代收集器,除了性能原因外,主要是因为除了 Serial 收集器,只有它能与 CMS 收集器配合工作。 默认开启的线程数量与 CPU 数量相同,可以使用 -XX:ParallelGCThreads 参数来设置线程数。 3. Parallel Scavenge 收集器 与 ParNew 一样是多线程收集器。 其它收集器关注点是尽可能缩短垃圾收集时用户线程的停顿时间,而它的目标是达到一个可控制的吞吐量,它被称为“吞吐量优先”收集器。这里的吞吐量指 CPU 用于运行用户代码的时间占总时间的比值。 停顿时间越短就越适合需要与用户交互的程序,良好的响应速度能提升用户体验。而高吞吐量则可以高效率地利用 CPU 时间,尽快完成程序的运算任务,适合在后台运算而不需要太多交互的任务。 缩短停顿时间是以牺牲吞吐量和新生代空间来换取的:新生代空间变小,垃圾回收变得频繁,导致吞吐量下降。 可以通过一个开关参数打开 GC 自适应的调节策略(GC Ergonomics), 就不需要手工指定新生代的大小(-Xmn)、Eden 和 Survivor 区的比例、晋升老年代对象年龄等细节参数了。 虚拟机会根据当前系统的运行情况收集性能监控信息, 动态调整这些参数以提供最合适的停顿时间或者最大的吞吐量。 自适应调节策略是 Parallel Scavenge 收集器和 ParNew 收集器的一个重要区别。 4. Serial Old 收集器 是 Serial 收集器的老年代版本,也是给 Client 模式下的虚拟机使用,采用标记-整理算法。如果用在 Server 模式下,它有两大用途: 在 JDK 1.5 以及之前版本(Parallel Old 诞生以前)中与 Parallel Scavenge 收集器搭配使用。 作为 CMS 收集器的后备预案,在并发收集发生 Concurrent Mode Failure 时使用。 5. Parallel Old 收集器 是 Parallel Scavenge 收集器的老年代版本,采用标记-整理算法。 在注重吞吐量以及 CPU 资源敏感的场合,都可以优先考虑 Parallel Scavenge 加 Parallel Old 收集器。 6. CMS 收集器 CMS(Concurrent Mark Sweep),Mark Sweep 指的是标记 - 清除算法。 分为以下四个流程: 初始标记:仅仅只是标记一下 GC Roots 能直接关联到的对象,速度很快,需要停顿。 并发标记:进行 GC Roots Tracing 的过程,它在整个回收过程中耗时最长,不需要停顿。 重新标记:为了修正并发标记期间因用户程序继续运作而导致标记产生变动的那一部分对象的标记记录,需要停顿。 并发清除:不需要停顿。 在整个过程中耗时最长的并发标记和并发清除过程中,收集器线程都可以与用户线程一起工作,不需要进行停顿,具有并发收集、低停顿的优点。 具有以下缺点: 吞吐量低:低停顿时间是以牺牲吞吐量为代价的,导致CPU 利用率不够高。 无法处理浮动垃圾,可能出现 Concurrent Mode Failure。浮动垃圾是指并发清除阶段由于用户线程继续运行而产生的垃圾,这部分垃圾只能到下一次 GC 时才能进行回收。 由于浮动垃圾的存在,因此需要预留出一部分内存,意味着 CMS 收集不能像其它收集器那样等待老年代快满的时候再回收。如果预留的内存不够存放浮动垃圾,就会出现 Concurrent Mode Failure,这时虚拟机将临时启用 Serial Old 来替代 CMS。 标记 - 清除算法导致的空间碎片,往往出现老年代空间剩余,但无法找到足够大连续空间来分配当前对象,不得不提前触发一次 Full GC。 CMS 已经在 JDK 9 中被标记为废弃( deprecated )。 7. G1 收集器 G1(Garbage-First),它是一款面向服务端应用的垃圾收集器,在多 CPU 和大内存的场景下有很好的性能。HotSpot 开发团队赋予它的使命是未来可以替换掉 CMS 收集器。 堆被分为新生代和老年代,其它收集器进行收集的范围都是整个新生代或者老年代,而G1 可以直接对新生代和老年代一起回收。 G1 把堆划分成多个大小相等的独立区域(Region),Region的大小是一致的,数值是在1M到32M字节之间的一个2的幂值数,JVM会尽量划分2048个左右、同等大小的Region,新生代和老年代不再物理隔离。 通过引入 Region 的概念,从而将原来的一整块内存空间划分成多个的小空间,使得每个小空间可以单独进行垃圾回收。这种划分方法带来了很大的灵活性,使得可预测的停顿时间模型成为可能。通过记录每个 Region 垃圾回收时间以及回收所获得的空间(这两个值是通过过去回收的经验获得),并维护一个优先列表,每次根据允许的收集时间,优先回收价值最大的 Region。 每个 Region 都有一个Remembered Set,用来记录该 Region 对象的引用对象所在的 Region。通过使用 Remembered Set,在做可达性分析的时候就可以避免全堆扫描。 如果不计算维护 Remembered Set 的操作,G1 收集器的运作大致可划分为以下几个步骤: 初始标记 并发标记 最终标记:为了修正在并发标记期间因用户程序继续运作而导致标记产生变动的那一部分标记记录,虚拟机将这段时间对象变化记录在线程的 Remembered Set Logs 里面,最终标记阶段需要把 Remembered Set Logs 的数据合并到 Remembered Set 中。这阶段需要停顿线程,但是可并行执行。 筛选回收:首先对各个 Region 中的回收价值和成本进行排序,根据用户所期望的 GC 停顿时间来制定回收计划。此阶段其实也可以做到与用户程序一起并发执行,但是因为只回收一部分 Region,时间是用户可控制的,而且停顿用户线程将大幅度提高收集效率。 从 GC 算法的角度, G1 选择的是复合算法,可以简化理解为: 在新生代,G1采用的仍然是并行的复制算法,所以同样会发生Stop-The-World的暂停。 在老年代,大部分情况下都是并发标记,而整理(Compact)则是和新生代GC时捎带进行,并且不是整体性的整理,而是增量进行的。 具备如下特点: 空间整合:整体来看是基于“标记 - 整理”算法实现的收集器,从局部(两个 Region 之间)上来看是基于“复制”算法实现的,这意味着运行期间不会产生内存空间碎片。 可预测的停顿:能让使用者明确指定在一个长度为 M 毫秒的时间片段内,消耗在 GC 上的时间不得超过 N 毫秒。 目前尚处于开发中的 JDK 11, JDK 又增加了两种全新的 GC 方式,分别是: Epsilon GC,简单说就是个不做垃圾收集的GC,似乎有点奇怪,有的情况下,例如在进行性能测试的时候,可能需要明确判断GC本身产生了多大的开销,这就是其典型应用场景。 ZGC,这是Oracle开源出来的一个超级GC实现,具备令人惊讶的扩展能力,比如支持T bytes级别的堆大小,并且保证绝大部分情况下,延迟都不会超过10 ms。虽然目前还处于实验阶段,仅支持 Linux 64 位的平台,但其已经表现出的能力和潜力都非常令人期待。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册