首页 文章 精选 留言 我的

精选列表

搜索[融合分析],共10000篇文章
优秀的个人博客,低调大师

Python数据分析实例操作

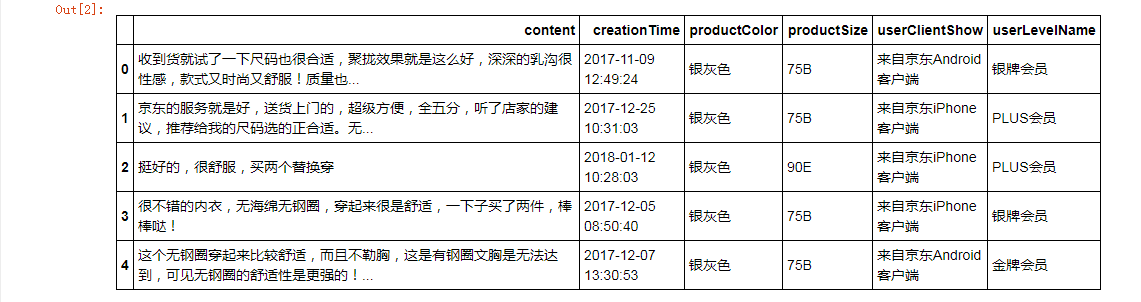
import pandas as pd #导入pandas import matplotlib.pyplot as plt #导入matplotlib from pylab import * mpl.rcParams['font.sans-serif'] = ['SimHei'] mpl.rcParams['axes.unicode_minus'] = False %matplotlib inline 数据读取与索引 bra = pd.read_csv('data/bra.csv') bra.head() 选取列 bra.content bra[['creationTime','productColor']].head() 选择行 bra[1:6] 选择行和列 bra.ix[[2,3],[1,3]] #使用ix bra.ix[1:5,['productColor']] bra.iloc[[2,3],[1,3]] #使用iloc bra.loc[1:5,['content','creationTime','productSize']] #使用loc bra.loc[1:5,'content':'userClientShow'] 数据预处理 缺失值 bra.describe() #查看数据的分布情况,可返回变量和观测的数量、缺失值和唯一值的数目、平均值、分位数等相关信息 bra['userClientShow'].unique() #userClientShow列有几种选项 bra['userClientShow'].isnull().sum() #初始缺失值数量 bra['userClientShow'].fillna('不详',inplace=True) #缺失值替换为“不详” bra['userClientShow'].isnull().sum() #赋值后的缺失值数量 新增列 bra.dtypes #查看属性 bra['creationTime'] = pd.to_datetime(bra['creationTime']) #更新类型 bra.dtypes bra['hour'] = [i.hour for i in bra['creationTime']] #新建hour列 bra 字符串操作 bra.productSize.unique() #查看productSize的唯一值 cup = bra.productSize.str.findall('[a-zA-Z]+').str[0] #新增列cup cup2 = cup.str.replace('M','B') cup3 = cup2.str.replace('L','C') cup4 = cup3.str.replace('XC','D') bra['cup'] = cup4 bra.head() bra['cup'].unique() #查看cup唯一值 数据转换 bra.productColor.unique() #查看productColor唯一值 def getColor(s): if '黑' in s: return '黑色' elif '肤' in s: return '肤色' elif '蓝' in s: return '蓝色' elif '红' in s: return '红色' elif '紫' in s: return '紫色' elif '白' in s: return '白色' elif '粉' in s: return '粉色' elif '灰' in s: return '灰色' elif '绿' in s: return '绿色' elif '青' in s: return '青色' else: return s bra['color'] = bra['productColor'].map(getColor) #从productColor列查询,赋值到定义的函数getColor,最终新增列color bra bra.color.unique() #查询color的唯一值 数据可视化 x = [1991,1992,1993,1994,1995,1996,1997] y = [23,56,38,29,34,56,92] plt.plot(x,y) #调用函数plot plt.figure(figsize=(8,6),dpi=80) #调用函数firgure plt.plot(x,y) hour = bra.groupby('hour')['hour'].count() #hour列排序 hour plt.xlim(0,25) #横轴0~25 plt.plot(hour,linestyle='solid',color='royalblue',marker='8') #颜色深蓝 cup_style = bra.groupby('cup')['cup'].count() #cup列唯一值得数量 cup_style plt.figure(figsize=(8,6),dpi=80) labels = list(cup_style.index) plt.xlabel('cup') #x轴为cup plt.ylabel('count') #y轴为count数量 plt.bar(range(len(labels)),cup_style,color='royalblue',alpha=0.7) #alpha为透明度 plt.xticks(range(len(labels)),labels,fontsize=12) plt.grid(color='#95a5a6',linestyle='--',linewidth=1,axis='y',alpha=0.6) plt.legend(['user-count']) for x,y in zip(range(len(labels)),cup_style): plt.text(x,y,y,ha='center',va='bottom') color_style = bra.groupby('color')['color'].count() #color列唯一值得数量 color_style plt.figure(figsize=(8,6),dpi=80) plt.subplot(facecolor='gainsboro',alpha=0.2) colors = ['brown','orange','gray','white','pink','purple','red','green','wheat','blue','gold','springgreen','black'] #颜色种类 labels = list(color_style.index) plt.xlabel('count') #x轴为count数量 plt.ylabel('color') #y轴为color plt.title('Color Distribution') #定义标题 plt.barh(range(len(labels)),color_style,color=colors,alpha=1) plt.yticks(range(len(labels)),labels,fontsize=12) plt.grid(color='#95a5a6',linestyle='--',linewidth=1,axis='x',alpha=0.4) bra.head(30) 知识在于点滴积累
优秀的个人博客,低调大师

技术分享 | Koa框架源码分析

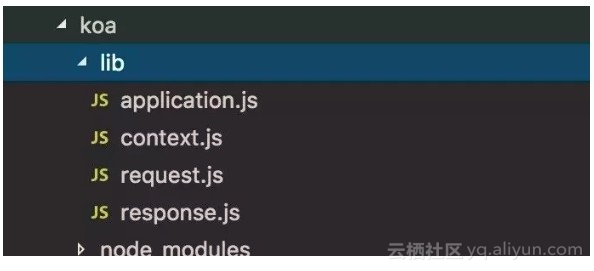
一、Why Koa ? koa 是由 Express 原班人马打造的,致力于成为一个更小、更富有表现力、更健壮的 Web 框架。 使用 koa 编写 web 应用,通过组合不同的 generator,可以免除重复繁琐的回调函数嵌套, 并极大地提升错误处理的效率。koa 不在内核方法中绑定任何中间件, 它仅仅提供了一个轻量优雅的函数库,使得编写 Web 应用变得得心应手。 async await写法,让异步更加优雅。(代码是写给人看的,顺便让机器执行而已) 良好的抽象,简洁的api,简单、吊炸天的中间件机制。 强大的社区,GayHub上数不胜数的中间件。 二、小试牛刀之源码文件一览 npm上download下koa之后打开koa/lib文件夹可以看到四个文件,足以证明koa框架是多么简洁。(不过koa框架依赖了很多node_modules) application.js 入口文件,也是骨架文件,创建一个服务。 context.js app 的 context 对象, 传入中间件的上下文对象。 request.js app 的请求对象,包含请求相关的一些属性。 response.js app 的响应对象,包含响应相关的一些属性。 下面大致总的分为三章节来分享一下koa源码。 1、Hello Koa 首先看一下原生node和koa分别是如何创建一个server。 /** *原生Node创建server */ const http = require('http'); const server = http.createServer((req, res) => { res.statusCode = 200; res.setHeader('Content-Type', 'text/plain'); res.end('Hello World\n'); }); server.listen(3000); /** *koa创建server */ const Koa = require('koa'); const app = new Koa(); app.use(ctx => { ctx.body = 'Hello Koa'; }); app.listen(3000); 看一下源码中koa究竟都做了什么 //1.首先创建了一个Application的类,继承了Emitter类,然后暴露出去。 module.exports = class Application extends Emitter { constructor() { super(); } } //2.类下面有一个listen方法,创建http服务 listen(...args) { debug('listen'); const server = http.createServer(this.callback()); return server.listen(...args); } 在Hello Koa中,引入这个类,然后实例化这个类,在使用下面的listen即搭建起了一个简单的koa服务。 然后讲一下初始化koa的时候,这个类的下面有一个use方法,也就是我们添加中间件的方法。 use(fn) { //如果use里面传的不是方法,直接错误抛出去 if (typeof fn !== 'function') throw new TypeError('middleware must be a function!'); //如果是星号函数,用一个库转成async await方法(去兼容koa1的中间件) if (isGeneratorFunction(fn)) { //如果是generator函数,用convert转成async函数,然后执行。也是就是koa2能支持koa1的中间件。 deprecate('Support for generators will be removed in v3. ' + 'See the documentation for examples of how to convert old middleware ' + 'https://github.com/koajs/koa/blob/master/docs/migration.md'); fn = convert(fn); //转async await方法 } debug('use %s', fn._name || fn.name || '-'); this.middleware.push(fn); //koa把所有的中间件都放在一个数组里面 return this; } 如代码所示,koa把所有的中间件放在一个数组里面,然后koa2也是兼容generator函数,为了兼容koa1的中间件。 callback方法Koa处理请求的方法。 callback() { const fn = compose(this.middleware); //组装中间件 if (!this.listeners('error').length) this.on('error', this.onerror); const handleRequest = (req, res) => { const ctx = this.createContext(req, res); return this.handleRequest(ctx, fn); }; return handleRequest; } 接下来就是看一下callback中compose如何处理了中间价和中间件的执行机制 Koa中间件(middleware)实现探索 首先用一段简单的代码了解一下中间件执行顺序。 const Koa = require('koa') const app = new Koa() app.use(async function m1(ctx, next) { console.log('1') await next(); console.log('1 end') }) app.use(async function m2(ctx, next) { console.log('2') await next(); console.log('2 end') }) app.use(async function m3(ctx, next) { console.log('3') ctx.body = 'Hello World' console.log('3 end') }) app.listen(3000); // 打印的顺序是 // 1、2、3、3end、2end、1end koa通过compose方法把中间件封装成一个promise对象,然后递归执行。使中间件数组变成洋葱圈,能递归线性处理上下文。 下面是官方的配图: 我们主要看一下这个库: function compose (middleware) { return function (context, next) { let index = -1 return dispatch(0) function dispatch (i) { if (i <= index) return Promise.reject(new Error('next() called multiple times')) index = i let fn = middleware[i] if (i === middleware.length) fn = next if (!fn) return Promise.resolve() try { return Promise.resolve(fn(context, dispatch.bind(null, i + 1))); /** dispatch.bind(null, i + 1) 利用了js的bind继承 其实可以写成 function() { dispatch(i + 1) } 一个等待被执行的函数,然后用next()去执行下一个中间件。 */ } catch (err) { return Promise.reject(err) } } } } //通过调用第一个函数,层层递归调用,然后达到洋葱模型 //大白话讲一下就是,compose方法把所有的中间的执行的时候,把第一个中间件封装成了一个psomise对象执行,然后同时在中间件里面写next()方法去递归执行下一个中间件。 这里的 Promise.resolve(fn(..)) 帮助我们异步执行的中间件函数,这里的next函数就解释了为什么Koa的中间件调用是递归执行的,它递归调用了 dispatch 函数来遍历数组中的,同时,所有的中间件函数享有同一个 ctx。 然后我根据compose处理后的中间件,大致中间件执行中理想的样子如图: (async function(){ // middleware1 console.log('1'); await (async function(){ // middleware2 console.log('2'); await ( async function(){ // middleware3 ... console.log('3'); console.log('3 end'); // ...middleware3 }) console.log('2 end') // ...middleware2 }) console.log('1 end'); // ...middleware1 })() 组装成promise的中间件然后赋值到fn上去执行。 fn(ctx).then(handleResponse).catch(onerror)。 来看看这一句,fn 之前说过了,是所有的中间件函数的 “集合”, 用这一个中间件来表示整个处理过程。 同时 fn 也是一个 async 函数,执行结果返回一个 promise 对象, 同时 handleResponse 作为其 resolved 函数,onerror 是 rejected 函数。 也就是说koa中捕捉错误不是用try catch 而且是用promise中的catch。 3、 context的来源 context 使用node原生的 http 的监听回调函数中的 req res 来进行进一步的封装,意味着对于每一个 http 请求,koa都会创建一个 context 并共享给所有的全局中间件使用,当所有的中间件执行完过后,会将最后要返回的所有数据统一再交还给 res 进行返回,所以我们在每一个中间件中才能够从 ctx 中取得自己所需要的 req 中的数据进行处理,最后 ctx 再把要返回的 body 给原生的 res 进行返回。 每一个请求都有唯一一个 context 对象,所有的关于请求和返回的东西都统一放在里面 createContext 方法将 req res 进一步封装。 const context = Object.create(this.context); // 创建一个对象,使之拥有context的原型方法,后面以此类推 const request = context.request = Object.create(this.request); const response = context.response = Object.create(this.response); context.app = request.app = response.app = this; context.req = request.req = response.req = req; context.res = request.res = response.res = res; request.ctx = response.ctx = context; request.response = response; response.request = request; 本着一个请求一个context的原则,context 必须是作为一个临时对象而存在,所有的东西都必须封进一个对象中,因此 app req res 三个属性就此诞生。 三、讲到最后 本文主要围绕“koa2的骨架”、“剖析koa中间件”、“ctx的来源”这三个模块来阐述了koa的原理和实现。并根据思路流程渐进梳理讲解了一些细节思路和比较关键的内容点,以及通过展示部分关键代码讲述了koa中间件的执行原理。文中肯定会有一些不够严谨的思考和错误,欢迎大家指正,有兴趣欢迎一起探讨和改进~ 最后,感谢您的阅读! 原文发布时间为:2018年06月24日 原文作者: 掘金 本文来源: 掘金 如需转载请联系原作者

优秀的个人博客,低调大师

jvm分析工具和查看命令

jinfo 可以输出并修改运行时的java 进程的opts。 jps 与unix上的ps类似,用来显示本地的java进程,可以查看本地运行着几个java程序,并显示他们的进程号。 jstat 一个极强的监视VM内存工具。可以用来监视VM内存内的各种堆和非堆的大小及其内存使用量。 jmap 打印出某个java进程(使用pid)内存内的所有'对象'的情况(如:产生那些对象,及其数量)。 jconsole 一个java GUI监视工具,可以以图表化的形式显示各种数据。并可通过远程连接监视远程的服务器VM。 详细:在使用这些工具前,先用JPS命令获取当前的每个JVM进程号,然后选择要查看的JVM。 jstat工具特别强大,有众多的可选项,详细查看堆内各个部分的使用量,以及加载类的数量。使用时,需加上查看进程的进程id,和所选参数。以下详细介绍各个参数的意义。 jstat -class pid:显示加载class的数量,及所占空间等信息。 jstat -compiler pid:显示VM实时编译的数量等信息。 jstat -gc pid:可以显示gc的信息,查看gc的次数,及时间。其中最后五项,分别是young gc的次数,young gc的时间,full gc的次数,full gc的时间,gc的总时间。 jstat -gccapacity:可以显示,VM内存中三代(young,old,perm)对象的使用和占用大小,如:PGCMN显示的是最小perm的内存使用量,PGCMX显示的是perm的内存最大使用量,PGC是当前新生成的perm内存占用量,PC是但前perm内存占用量。其他的可以根据这个类推, OC是old内纯的占用量。 jstat -gcnew pid:new对象的信息。 jstat -gcnewcapacity pid:new对象的信息及其占用量。 jstat -gcold pid:old对象的信息。 jstat -gcoldcapacity pid:old对象的信息及其占用量。 jstat -gcpermcapacity pid: perm对象的信息及其占用量。 jstat -util pid:统计gc信息统计。 jstat -printcompilation pid:当前VM执行的信息。 除了以上一个参数外,还可以同时加上 两个数字,如:jstat -printcompilation 3024 250 6是每250毫秒打印一次,一共打印6次,还可以加上-h3每三行显示一下标题。 jmap是一个可以输出所有内存中对象的工具,甚至可以将VM 中的heap,以二进制输出成文本。 命令:jmap -dump:format=b,file=heap.bin file:保存路径及文件名 pid:进程编号 •jmap -histo:live pid| less :堆中活动的对象以及大小 •jmap -heap pid : 查看堆的使用状况信息 jinfo:的用处比较简单,就是能输出并修改运行时的java进程的运行参数。用法是jinfo -opt pid 如:查看2788的MaxPerm大小可以用 jinfo -flag MaxPermSize 2788。 jconsole是一个用java写的GUI程序,用来监控VM,并可监控远程的VM,非常易用,而且功能非常强。使用方法:命令行里打 jconsole,选则进程就可以了。 JConsole中关于内存分区的说明。 Eden Space (heap): 内存最初从这个线程池分配给大部分对象。 Survivor Space (heap):用于保存在eden space内存池中经过垃圾回收后没有被回收的对象。 Tenured Generation (heap):用于保持已经在 survivor space内存池中存在了一段时间的对象。 Permanent Generation (non-heap): 保存虚拟机自己的静态(refective)数据,例如类(class)和方法(method)对象。Java虚拟机共享这些类数据。这个区域被分割为只读的和只写的, Code Cache (non-heap):HotSpot Java虚拟机包括一个用于编译和保存本地代码(native code)的内存,叫做“代码缓存区”(code cache) •jstack ( 查看jvm线程运行状态,是否有死锁现象等等信息) : jstack pid : thread dump •jstat -gcutil pid 1000 100 : 1000ms统计一次gc情况统计100次; 另外推荐一款查看jmap dump 的内存对象工具 MemoryAnalyzer 网址:http://www.eclipse.org/mat/,可以查看dump时对象数量,内存占用,线程情况等。 欢迎工作一到五年的Java程序员朋友们加入Java架构开发:744677563 本群提供免费的学习指导 架构资料 以及免费的解答 不懂得问题都可以在本群提出来 之后还会有职业生涯规划以及面试指导

优秀的个人博客,低调大师

GayHub用户及仓库分析爬虫

爬虫介绍 Github 是一个很棒的社区,这里可以找到很多优秀的项目,很多实用的库类,简直是 coder 的天堂,同时也是全球最大的同性交友社区? 爬取的数据主要分为两大类, User 类 和 Repo 类 ,也就是针对用户情况和仓库信息 User 类 先来看看 Github 全站 followers 人数 top10 都是哪些大犇 Linus 大神以压倒性的优势夺得第一名,说实在不知道 Linus 的真不好意思说自己是写代码的,这是信仰。然而大神还是很傲娇的,毕竟没有 following anybody,可能是强到了没朋友了吧,毕竟 talk is cheap, show me the code。JakeWharton 以 34000+ 位于第二,以前也看过一点 Android 的东西,不知道说什么,膜拜吧。 中国区还是有两名种子选手

优秀的个人博客,低调大师

市场分享竞品分析-Android

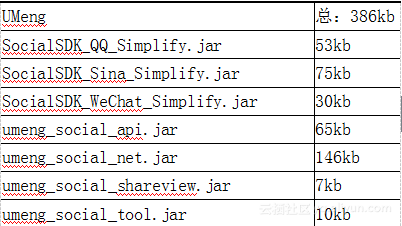
一.SDK大小对比环境说明:1.只集成社交平台 新浪微博,微信好友,QQ;2.均不包含各自的UI库,使用最简单最基础的接口实现分享;3.均新建android工程项目中集成;4.集成方式的对比;对比集成微信好友、QQ好友、微信好友的大小,基础jar包其实是比较大的,后续增加想加的平台几乎就增加几十K左右;UMeng Jar包的大小,编译后apk增加0.15M 从上下两个表格可以看出,Umeng的大小相对于下面的ShareSDK的比较小,但是整体来说都会增加太多;MobShareJar包的大小,编译后apk增加 0.27M 二、集成复杂度1、工具采用studio集成2、集成方式首先是官网注册,这个ShareSDK有流程说明,ShareSDK好些; 重点比较两种SDK的新的集成方式a)集成jar包:ShareSDK更有优势Umeng需要集成jar包,与老的集成方式一样,资源也一样; ShareSDK不需要集成jar包,只需要在gradle文件中配置需要的平台即可 b) 配置SDK及配置第三方:key ShareSDK更有优势Umeng这里可以使用生成工具来生成 (1)生成后需要配置到application中,这里可以配置第三方平台的key; (2)AndroidManifest配置代码生成,生成后可以直接复制配置到清单文件中; ShareSDK集成,只需要在gradle中配置如下即可;(1)配置MobSDK的调用,并且配置平台及keymaven { url "http://mvn.mob.com/android" }dependencies { ... classpath 'com.mob.sdk:MobSDK:+' } (2)ShareSDK不需要在manifest中进行配置 c)分享代码生成调用,友盟更有优势友盟同样可以代码生成器生成来调用,输入内容友盟会自动生成方法,调用即可; ShareSDK,方法调用,如下图所示,也是套用,只需要换个分享对象,和相应方法即可; 集成方式总结:从集成方式,友盟在代码调用和配置都可以使用生成器,但是ShareSDK不需要多余的配置,在集成方式上ShareSDK更有优势 三、其他比较集成文档:集成文档方面,友盟追求过于智能,但是讲解不够详细,ShareSDK的文档比较清晰,还分出了不同的第三方常用平台的说明;ShareSDK更有优势技术论坛:这方面ShareSDK有自己的论坛,并且有常见问题帖子。还有成百上千的用户的问题,如果遇到问题可以先看看有没有人问过,定位问题迅速;客服技术:ShareSDK提供全天的技术支持,不会的问题可以直接通过技术来解决,听说可以聊天聊地聊感情,这个方面友盟确实做的不够好;更新频率:ShareSDK基本是每个月更新一次,SDK更新及时、快,第三方有什么改动,ShareSDK都能及时发出公告并及时更新版本; 从最近半年的更新频率来看,友盟更新的是慢了些; 四、总结对比 Umeng做的主要模块不是分享,从上面的对比项上来看,确实ShareSDK更具优势,特别是技术论坛和技术支持的回复上,这些是独有的优势,有不明白的地方可以直接QQ联系技术支持来解决;当然上述是我的个人见解,欢迎留言来提出对比项,后续我们一起来补充对比说明;

优秀的个人博客,低调大师

深入分析Java的enum

一、定义(语法) enum全称为enumeration,中文意为枚举,枚举简单的说就是一种数据类型,只不过是这种数据类型只包含自定义的特定数据,它是一组有共同特性的数据的集合。 创建枚举类型是需要用到enum关键字,如: public enum Color{ RED, GREEN, BLUE, BLACK, PINK, WHITE; } enum的语法看似与class不同,但它实际上就是一个类,经过编译器编译之后得到一个.class文件。 创建的枚举类型默认是java.lang.enum<枚举类型名>(抽象类)的子类。 每个枚举项的类型都为public static final 。 因为Java的单继承机制,emum不能再用extends继承其他的类。 我们可以使用javap命令进行反编译验证。 既然enum是一个类,那么它就可以像一般的类一样拥有自己的属性与方法。但Java要求必须先定义enum实例。 否则会编译错误。 public enum Color { RED("红色", 1), GREEN("绿色", 2), BLANK("白色", 3), YELLO("黄色", 4); // 成员变量 private String name; private int index; // 构造方法 private Color(String name, int index) { this.name = name; this.index = index; } // 普通方法 public static String getName(int index) { for (Color c : Color.values()) { if (c.getIndex() == index) { return c.name; } } return null; } // get set 方法 public String getName() { return name; } public void setName(String name) { this.name = name; } public int getIndex() { return index; } public void setIndex(int index) { this.index = index; } } 枚举实例的创建过程:枚举类型符合通用模式 Class Enum<E extends Enum<E>>,而 E 表示枚举类型的名称。枚举类型的每一个值都将映射到 protected Enum(String name, int ordinal) 构造函数中,在这里,每个值的名称都被转换成一个字符串,并且序数设置表示了此设置被创建的顺序。 public enum Color{ RED, GREEN, BLUE, BLACK, PINK, WHITE; } 相当于调用了六次Enum<Color>构造方法 Enum<Color>("RED", 0); Enum<Color>("GREEN", 1); Enum<Color>("BLUE", 2); Enum<Color>("BLACK", 3); Enum<Color>("PINK",4); Enum<Color>("WHITE", 5); 枚举类型的常用方法: int compareTo(E o) 比较此枚举与指定对象的顺序。 Class<E> getDeclaringClass() 返回与此枚举常量的枚举类型相对应的 Class 对象。 String name() 返回此枚举常量的名称,在其枚举声明中对其进行声明。 int ordinal() 返回枚举常量的序数(它在枚举声明中的位置,其中初始常量序数为零 String toString() 返回枚举常量的名称,它包含在声明中。 static <T extends Enum<T>> T valueOf(Class<T> enumType, String name) 返回带指定名称的指定枚举类型的枚举常量。 二、常用用法 用法一:常量 在JDK1.5 之前,我们定义常量都是: public static fianl.... 。现在好了,有了枚举,可以把相关的常量分组到一个枚举类型里,而且枚举提供了比常量更多的方法。 用法二:switch JDK1.6之前的switch语句只支持int,char,enum类型,使用枚举,能让我们的代码可读性更强。 enum Color{ RED, GREEN, BLUE, BLACK, PINK, WHITE; } public class TestEnum { public void changeColor(){ Color color = Color.RED; System.out.println("原色:" + color); switch(color){ case RED: color = Color.GREEN; System.out.println("变色:" + color); break; case GREEN: color = Color.BLUE; System.out.println("变色:" + color); break; case BLUE: color = Color.BLACK; System.out.println("变色:" + color); break; case BLACK: color = Color.PINK; System.out.println("变色:" + color); break; case PINK: color = Color.WHITE; System.out.println("变色:" + color); break; case WHITE: color = Color.RED; System.out.println("变色:" + color); break; } } public static void main(String[] args){ TestEnum testEnum = new TestEnum(); testEnum.changeColor(); } } 用法三:实现接口 public interface Behaviour { void print(); String getInfo(); } public enum Color implements Behaviour { RED("红色", 1), GREEN("绿色", 2), BLANK("白色", 3), YELLO("黄色", 4); // 成员变量 private String name; private int index; // 构造方法 private Color(String name, int index) { this.name = name; this.index = index; } // 接口方法 @Override public String getInfo() { return this.name; } // 接口方法 @Override public void print() { System.out.println(this.index + ":" + this.name); } } 用法四:枚举集合的应用 java.util.EnumSet和java.util.EnumMap是两个枚举集合。EnumSet保证集合中的元素不重复;EnumMap中的 key是enum类型,而value则可以是任意类型。关于这个两个集合的使用就不在这里赘述,可以参考JDK文档 public class Test { public static void main(String[] args) { // EnumSet的使用 EnumSet<EnumTest> weekSet = EnumSet.allOf(EnumTest.class); for (EnumTest day : weekSet) { System.out.println(day); } // EnumMap的使用 EnumMap<EnumTest, String> weekMap = new EnumMap(EnumTest.class); weekMap.put(EnumTest.MON, "星期一"); weekMap.put(EnumTest.TUE, "星期二"); // ... ... for (Iterator<Entry<EnumTest, String>> iter = weekMap.entrySet().iterator(); iter.hasNext();) { Entry<EnumTest, String> entry = iter.next(); System.out.println(entry.getKey().name() + ":" + entry.getValue()); } } } 三、综合实例 最简单的使用 最简单的枚举类 public enum Weekday { SUN,MON,TUS,WED,THU,FRI,SAT } 如何使用它呢? 先来看看它有哪些方法: 这是Weekday可以调用的方法和参数。发现它有两个方法:values()和valueOf()。还有我们刚刚定义的七个变量 这些事枚举变量的方法。我们接下来会演示几个比较重要的 这段代码,我们演示了几个常用的方法和功能: Weekday.valueOf() 方法: 它的作用是传来一个字符串,然后将它转变为对应的枚举变量。前提是你传的字符串和定义枚举变量的字符串一样,区分大小写。如果你传了一个不存在的字符串,那么会抛出异常。 Weekday.values()方法。 这个方法会返回包括所有枚举变量的数组。在该例中,返回的就是包含了七个星期的Weekday[]。可以方便的用来做循环。 枚举变量的toString()方法。 该方法直接返回枚举定义枚举变量的字符串,比如MON就返回【”MON”】。 枚举变量的.ordinal()方法。 默认情况下,枚举类会给所有的枚举变量一个默认的次序,该次序从0开始,类似于数组的下标。而.ordinal()方法就是获取这个次序(或者说下标) 枚举变量的compareTo()方法。 该方法用来比较两个枚举变量的”大小”,实际上比较的是两个枚举变量的次序,返回两个次序相减后的结果,如果为负数,就证明变量1”小于”变量2 (变量1.compareTo(变量2),返回【变量1.ordinal() - 变量2.ordinal()】) 这是compareTo的源码,会先判断是不是同一个枚举类的变量,然后再返回差值。 枚举类的name()方法。 它和toString()方法的返回值一样,事实上,这两个方法本来就是一样的: 这两个方法的默认实现是一样的,唯一的区别是,你可以重写toString方法。name变量就是枚举变量的字符串形式。 还有一些其他的方法我就暂时不介绍了,感兴趣的话可以自己去看看文档或者源码,都挺简单的。 要点: 使用的是enum关键字而不是class。 多个枚举变量直接用逗号隔开。 枚举变量最好大写,多个单词之间使用”_”隔开(比如:INT_SUM)。 定义完所有的变量后,以分号结束,如果只有枚举变量,而没有自定义变量,分号可以省略(例如上面的代码就忽略了分号)。 在其他类中使用enum变量的时候,只需要【类名.变量名】就可以了,和使用静态变量一样。 但是这种简单的使用显然不能体现出枚举的强大,我们来学习一下复杂的使用: 枚举的高级使用方法 就像我们前面的案例一样,你需要让每一个星期几对应到一个整数,比如星期天对应0。上面讲到了,枚举类在定义的时候会自动为每个变量添加一个顺序,从0开始。 假如你希望0代表星期天,1代表周一。。。并且你在定义枚举类的时候,顺序也是这个顺序,那你可以不用定义新的变量,就像这样: public enum Weekday { SUN,MON,TUS,WED,THU,FRI,SAT } 这个时候,星期天对应的ordinal值就是0,周一对应的就是1,满足你的要求。但是,如果你这么写,那就有问题了: public enum Weekday { MON,TUS,WED,THU,FRI,SAT,SUN } 我吧SUN放到了最后,但是我还是希0代表SUN,1代表MON怎么办呢?默认的ordinal是指望不上了,因为它只会傻傻的给第一个变量0,给第二个1。。。 所以,我们需要自己定义变量! 看代码: 我们对上面的代码做了一些改变: 首先,我们在每个枚举变量的后面加上了一个括号,里面是我们希望它代表的数字。 然后,我们定义了一个int变量,然后通过构造函数初始化这个变量。 你应该也清楚了,括号里的数字,其实就是我们定义的那个int变量。这句叫做自定义变量。 请注意:这里有三点需要注意: 一定要把枚举变量的定义放在第一行,并且以分号结尾。 构造函数必须私有化。事实上,private是多余的,你完全没有必要写,因为它默认并强制是private,如果你要写,也只能写private,写public是不能通过编译的。 自定义变量与默认的ordinal属性并不冲突,ordinal还是按照它的规则给每个枚举变量按顺序赋值。 好了,你很聪明,你已经掌握了上面的知识,你想,既然能自定义一个变量,能不能自定义两个呢? 当然可以: 你可以定义任何你想要的变量。学完了这些,大概枚举类你也应该掌握了,但是,还有没有其他用法呢? 枚举类中的抽象类 如果我在枚举类中定义一个抽象方法会怎么样? 你要知道,枚举类不能继承其他类,也不能被其他类继承。至于为什么,我们后面会说到。 你应该知道,有抽象方法的类必然是抽象类,抽象类就需要子类继承它然后实现它的抽象方法,但是呢,枚举类不能被继承。。你是不是有点乱? 我们先来看代码: 你好像懂了点什么。但是你好像又不太懂。为什么一个变量的后边可以带一个代码块并且实现抽象方法呢? 别着急,带着这个疑问,我们来看一下枚举类的实现原理。 枚举类的实现原理 从最简单的看起: 还是这段熟悉的代码,我们编译一下它,再反编译一下看看它到底是什么样子的: 你是不是觉得很熟悉?反编译出来的代码和我们用静态变量自己写的类出奇的相似! 而且,你看到了熟悉的values()方法和valueOf()方法。 仔细看,这个类继承了java.lang.Enum类!所以说,枚举类不能再继承其他类了,因为默认已经继承了Enum类。 并且,这个类是final的!所以它不能被继承! 回到我们刚才的那个疑问: 为什么会有这么神奇的代码?现在你差不多懂了。因为RED本身就是一个TrafficLamp对象的引用。实际上,在初始化这个枚举类的时候,你可以理解为执行的是 TrafficLamp RED = new TrafficLamp(30) ,但是因为TrafficLamp里面有抽象方法,还记得匿名内部类么? 我们可以这样来创建一个TrafficLamp引用: 而在枚举类中,我们只需要像上面那样写【RED(30){}】就可以了,因为java会自动的去帮我们完成这一系列操作 枚举类的其他用法 switch语句 虽然枚举类不能继承其他类,但是还是可以实现接口的 接口定义 实现接口 使用接口组织枚举 使用枚举创建单例模式 使用枚举创建的单例模式: public enum EasySingleton{ INSTANCE; } 代码就这么简单,你可以使用EasySingleton.INSTANCE调用它,比起你在单例中调用getInstance()方法容易多了。 我们来看看正常情况下是怎样创建单例模式的: 用双检索实现单例: 下面的代码是用双检索实现单例模式的例子,在这里getInstance()方法检查了两次来判断INSTANCE是否为null,这就是为什么叫双检索的原因,记住双检索在java5之前是有问题的,但是java5在内存模型中有了volatile变量之后就没问题了。 public class DoubleCheckedLockingSingleton{ private volatile DoubleCheckedLockingSingleton INSTANCE; private DoubleCheckedLockingSingleton(){} public DoubleCheckedLockingSingleton getInstance(){ if(INSTANCE == null){ synchronized(DoubleCheckedLockingSingleton.class){ //double checking Singleton instance if(INSTANCE == null){ INSTANCE = new DoubleCheckedLockingSingleton(); } } } return INSTANCE; } } 你可以访问DoubleCheckedLockingSingleTon.getInstance()来获得实例对象。 用静态工厂方法实现单例: public class Singleton{ private static final Singleton INSTANCE = new Singleton(); private Singleton(){} public static Singleton getSingleton(){ return INSTANCE; } } 你可以调用Singleton.getInstance()方法来获得实例对象。 上面的两种方式就是懒汉式和恶汉式单利的创建,但是无论哪一种,都不如枚举来的方便。而且传统的单例模式的另外一个问题是一旦你实现了serializable接口,他们就不再是单例的了。但是枚举类的父类【Enum类】实现了Serializable接口,也就是说,所有的枚举类都是可以实现序列化的,这也是一个优点。 总结 可以创建一个enum类,把它看做一个普通的类。除了它不能继承其他类了。(java是单继承,它已经继承了Enum),可以添加其他方法,覆盖它本身的方法 switch()参数可以使用enum values()方法是编译器插入到enum定义中的static方法,所以,当你将enum实例向上转型为父类Enum是,values()就不可访问了。解决办法:在Class中有一个getEnumConstants()方法,所以即便Enum接口中没有values()方法,我们仍然可以通过Class对象取得所有的enum实例 无法从enum继承子类,如果需要扩展enum中的元素,在一个接口的内部,创建实现该接口的枚举,以此将元素进行分组。达到将枚举元素进行分组。 enum允许程序员为eunm实例编写方法。所以可以为每个enum实例赋予各自不同的行为。 【java.util.EnumSet和java.util.EnumMap】

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册