首页 文章 精选 留言 我的

精选列表

搜索[审批流],共10000篇文章
优秀的个人博客,低调大师

开源交流丨批流一体数据集成框架ChunJun数据传输模块详解分享

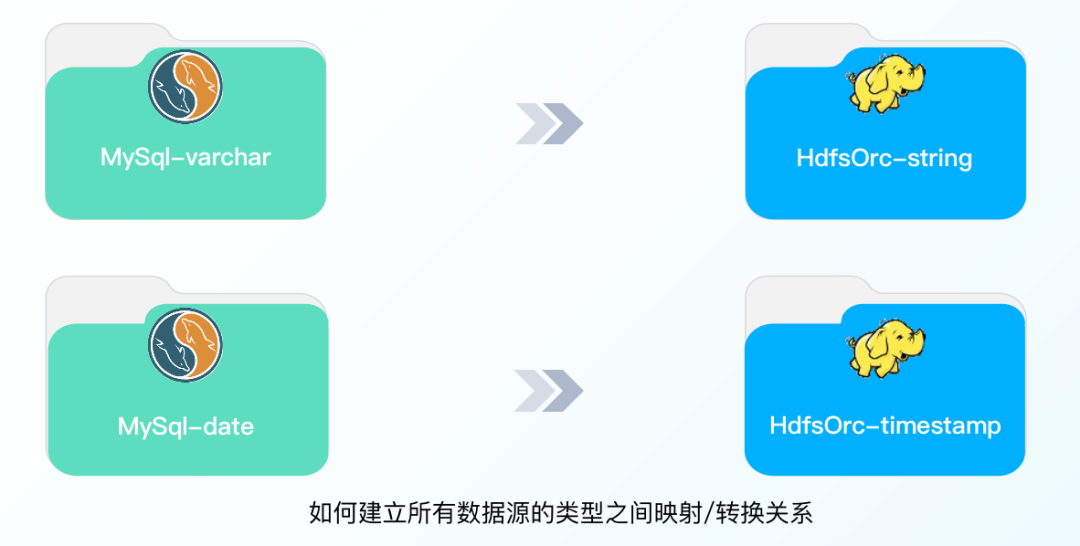
课件获取:关注公众号“ChunJun”,后台私信 “课件” 获得直播课件 视频回放:点击这里 ChunJun开源项目地址:github 丨 gitee 喜欢我们的项目给我们点个__ STAR!STAR!!STAR!!!(重要的事情说三遍)__ 技术交流钉钉 qun:30537511 本期我们带大家回顾一下六六同学的直播分享《ChunJun数据传输模块介绍》。 一、ChunJun数据类型转换 1、类型转换解决的问题 大家一听到「ChunJun数据类型转换」这个概念,可能会联想到上下游之间进行数据交互时会涉及到的隐式转换。如果上游和下游数据类型一致,则不需要对数据进行任何干预,直接进行下发即可。 但是大多数情况下会涉及到两个问题,一是上游的数据源类型和下游的数据源类型不一致。比如MySql的varchar类型要写到HdfsOrc文件里的string类型的话,在上游的表示是varchar,在下游的表示是string,但实际上中间段java的类型都是string。 另外一种情况则是,上下游之间不止数据源类型不一样,数据类型也不一样,除了要做类型的映射之外,还需要对数据本身进行改动。比如,MySql的date类型要写到下游timestamp类型,我们需要进行的操作是把date中的毫秒级的时间戳拿出来,转换成timestamp的类型,再往下游去写。 这样就引出了一个问题,如何建立所有数据源类型之间的映射/转换关系?下面将为大家解答这个问题。 2、类型映射概览 • client端:在Factory类中通过RawConverter类建立映射关系 • source端:将数据封装成AbstractBaseColumn • sink端:通过AbstractBaseColumn中的转换方法将数据转换成对应类型 ChunJun目前支持的数据类型映射关系图如下: 3、类型映射详解 以Timestamp为例,如果要写入到Long类型的话,根据上文展示的ChunJun数据类型映射关系图,最终映射到TimestampColumn中,具体流程如下图: 上面这个例子描述的是一个单独的字段,正常情况下,会处理多个字段,这时的类型映射详解情况如下图: as方法就是数据类型转换的方法。使用这个机制之后,在下游可以只关心需要的数据类型,增加开发效率。 二、ChunJun数据传输过程 了解完ChunJun数据类型转换后,我们来为大家分享ChunJun的数据传输过程。 1、上下游数据传输方式 在ChunJun中进行同步作业,有两种情况,一是算子链打开的情况,上游的Source和下游的Sink会被合并成一个task,有同一个线程去做调度;二是把算子链进行关闭,Source和Sink各自形成一个task,也有各自的线程去进行调度。 在算子链打开的情况下,上下游数据传输方式可分为两种,对象重用和拷贝。 ● 对象重用 · 上下游数据传输使用方法调用的形式,将上游产生的数据的对象引用直接交给下游 · 上下游算子需要形成算子链,作业开启对象重用 · env.getConfig().enableObjectReuse(); ● 拷贝 · 上游传输给下游的数据,需要经过一次深拷贝 · 上下游算子需要形成算子链 算子链的好处是可以减少序列化的操作,那么为什么我们还要引入序列化呢?因为ChunJun的特殊性。ChunJun同步作业的话,只有上下游两个算子,且都对接了正式的数据源,读写的时候会导致线程堵塞。因此上限由网络io决定,如果断开算子链,cpu会在一端线程阻塞的时候切换到另外一端。在序列化的性能较高时,线程上下文切换带来的性能下降完全可以被弥补。 经过测试,序列化的性能比对象重用和拷贝高30%左右。 ● 序列化 · 上下游数据传输依赖于网络传输。上游数据进行序列化成byte数组后进行网络传输,下游收到数据后需要进行反序列化 · 上下游之间不形成算子链 知道要做序列化后,会产生一些思考,带着这些疑问,接着往下看。 • 序列化和反序列化在什么时候发生? • Flink支持哪些序列化? • 序列化是怎么做的? • 怎么找到适合的序列化方式? • 如何实现自定义的序列化? 2、序列化传输过程 下图是ChunJun在进行序列化操作时的数据传输链路图: 3、DataOutView 4、TypeInformation介绍 5、kryo序列化&BaseSerializer 同样是序列化一个int对象,对kryo来说,首先需要知道它的类型,然后从高位到低位依次去写入。 DataOutputView则是直接调用一个writeInt的方法,写一句关键代码即可: UNSAFE.putInt( this.buffer, BASE_OFFSET + this.position, v); 三、ChunJun序列化实现 1、ColumnRowData序列化过程 ColumnRowData序列化过程采取标志位+实际数据的方式,具体流程如下图: 相对于kryo的序列化来说: · 实现了更密集的存储 · 兼容null值 · 减少了不必要的数据传输 2、BinaryRowData结构 因为数据区一格只占8个字节,且每个index只能占到一位,所以肯定存在一些没法存储在8字节范围之内的数据,可变长度部分就是用来存放数据区无法存放的数据。 3、BinaryRowData-setNull操作 看到上文的null值判断区,有些同学可能会好奇这是什么,又是怎么进行操作的。下图将对一个下标为11的数据去做setnull操作,进行简单介绍: 4、BinaryRowData数据存储方式 袋鼠云开源框架钉钉技术交流群(30537511),欢迎对大数据开源项目有兴趣的同学加入交流最新技术信息,开源项目库地址:https://github.com/DTStack

优秀的个人博客,低调大师

从三流小公司到一线大厂,聊聊程序员的成长之道

阅读本文大概需要 2.8 分钟。 作者:黄小斜 文章来源:程序员江湖 ​ 我想,没有一个程序员能够一步登天,一下子达到很高的高度,有些路是我们必须要走的,有些阶段是我们必须要经历的。有入门,才有进阶,才有更上一层楼。 别看我现在在大厂,但是我也待过小到不能小的小公司,也许你会感兴趣,那么不妨听我说说,我在学习编程路上待过的公司吧。 不到20人的小公司 ​ 我在大学的时候学的不是计算机,上的课程基本上和计算机也没太大关系,但是我从小还是比较喜欢捣鼓电脑的,不瞒你说,以打游戏为主,修电脑为辅。 兴趣使然,于是大学期间想要自学编程,但是无从入手,于是让家里人介绍了去了当地一个小公司学习php,对,就是那个世界上最好的语言。 公司一共就10多个人,大老板就在旁边办公。当时我对计算机语言的认知是:Java好像很火,php没听说过,上班(学习)之前只在w3cschool上看了一些简单的教程,然后就自信满满地去公司实习了。 结果一看公司里的代码就懵圈了,这啥玩意啊,我学的怎么都用不上呢。再看看其他人,都很熟练地写着php代码,所谓的“师傅”压根也没空搭理我,索性我就开始自学,学了几天html和css,写了几个小页面就开心得不得了,给我师傅一看,他特别鄙夷地看了看,然后再也没管过我。 一个月之后,我就开溜了,当时主要也就是想体验一把程序员的生活,顺便学习一下世界上最好的语言。 这么一体验可把我打击坏了,原来写代码这么难啊,这么小的公司代码我都看不懂,哪有可能去大公司啊。 所谓初生牛犊不怕虎,大概也就是这个意思吧,无知可怕,但一直无知就很可怕了,后来有一个契机,让我再次接触到了编程。 500人左右的公司 ​ 大三的时候交换了一段时间,学习了几门编程语言,像Java、前端、php、Android等技术都接触了一些,算是对编程有了比较具体的理解,特别是在Android课程上,写app让我特别有成就感,那时候我就想,我以后就搞Android吧! 当时想法很单纯,感觉搞app有意思呀,于是想找一份Android的实习,我们家那边的IT公司本来就不多,稍微大点的也就一个,几番争取之后,在这家公司也获得了一个实习机会,只不过当时他们不需要Android工程师,于是安排我做Java Web,于是我和Java Web就这样结下了梁子,以至于我后来就在这条路上走到黑了。 这是我大学毕业那个暑假参加的实习。因为当时已经考上了研究生,所以想积累一点实习经验。 这个公司比上一家靠谱一些,当时用了一些框架,还需要我自己写前端代码,那时候我基本也是0基础的状态,一边学Java语法,一边学html、css、js,然后还要完成部门安排的新人作业。那时候感觉自己真的菜啊,隔壁几个学历不高的小哥哥都可以熟练上手,各种开发,我还一脸懵逼,无从下手呢。 那时候我学会了向技术大牛提问,用有道云笔记做笔记,以及使用eclipse,也算是误打误撞地入了门,当时觉得Java Web好难啊,我要去做Android开发,不过最后还是没有等到机会,于是呆了两个月就走了。 然后,我就开始念研究生了。 网易和百度 ​ 在读研之前,我是没有想过我能进大厂工作的,我记得大四的那个招聘季,投了我们省内的一些公司,罕有面试机会,有面试机会的岗位也都没有通过,当时仗着自己有Java实习经验就去投Java岗位,结果各种吃闭门羹,其实都不是什么有牌面的公司,但是却都拒绝了我,可见当时我的水平有多次。 于是从研一开始,我终于确定了Java这个方向,并且疯狂补基础,计算机基础、Java后端技术栈,需要什么补什么,大厂怎么要求我就怎么学,可能是我的执着也感动了我自己,后来就拿到了网易的实习机会,再后来也拿到了百度的实习机会。 在网易实习让我过了一把大厂瘾,当时去实习也就是打打杂,做点边边角角的任务,但是已经很震撼了,大型项目用到的技术、代码量、架构设计、标准业务流程,都让我很兴奋,不过当时光顾着兴奋了,没用到多少资源西就走了。 百度是第二次大厂之旅,相对来说没有那么兴奋,但是百度的技术还是比网易要靠谱一些,能学到的东西也更多,部门的技术栈虽然和我不是很搭,但是作为热爱学习的我来说,还是愿意花时间去学习的,在百度呆了半年,说实话技术没提升多少,其他的东西倒是学习了很多,比如百度自研的一些技术,以及部门在用的OpenStack和docker。 有了两段大厂经历加持之后,秋招也变得顺风顺水起来。最后能拿到不少大厂offer,我想是时间帮了我最大的忙。 ​ 文能码字,武能coding,是我黄小斜,不是黄老邪噢。 关注公众号「黄小斜」后回复「Java」、「Python」、「C++」、「大数据」、「机器学习」、「算法」、「AI」、「Android」、「前端」、「iOS」、「考研」、「BAT」、「校招」、「笔试」、「面试」、「面经」、「计算机基础」、「LeetCode」 等关键字可以获取对应的免费学习资料。

优秀的个人博客,低调大师

数据流被污染?数据质量不高?蚂蚁金服数据资产管理平台了解一下

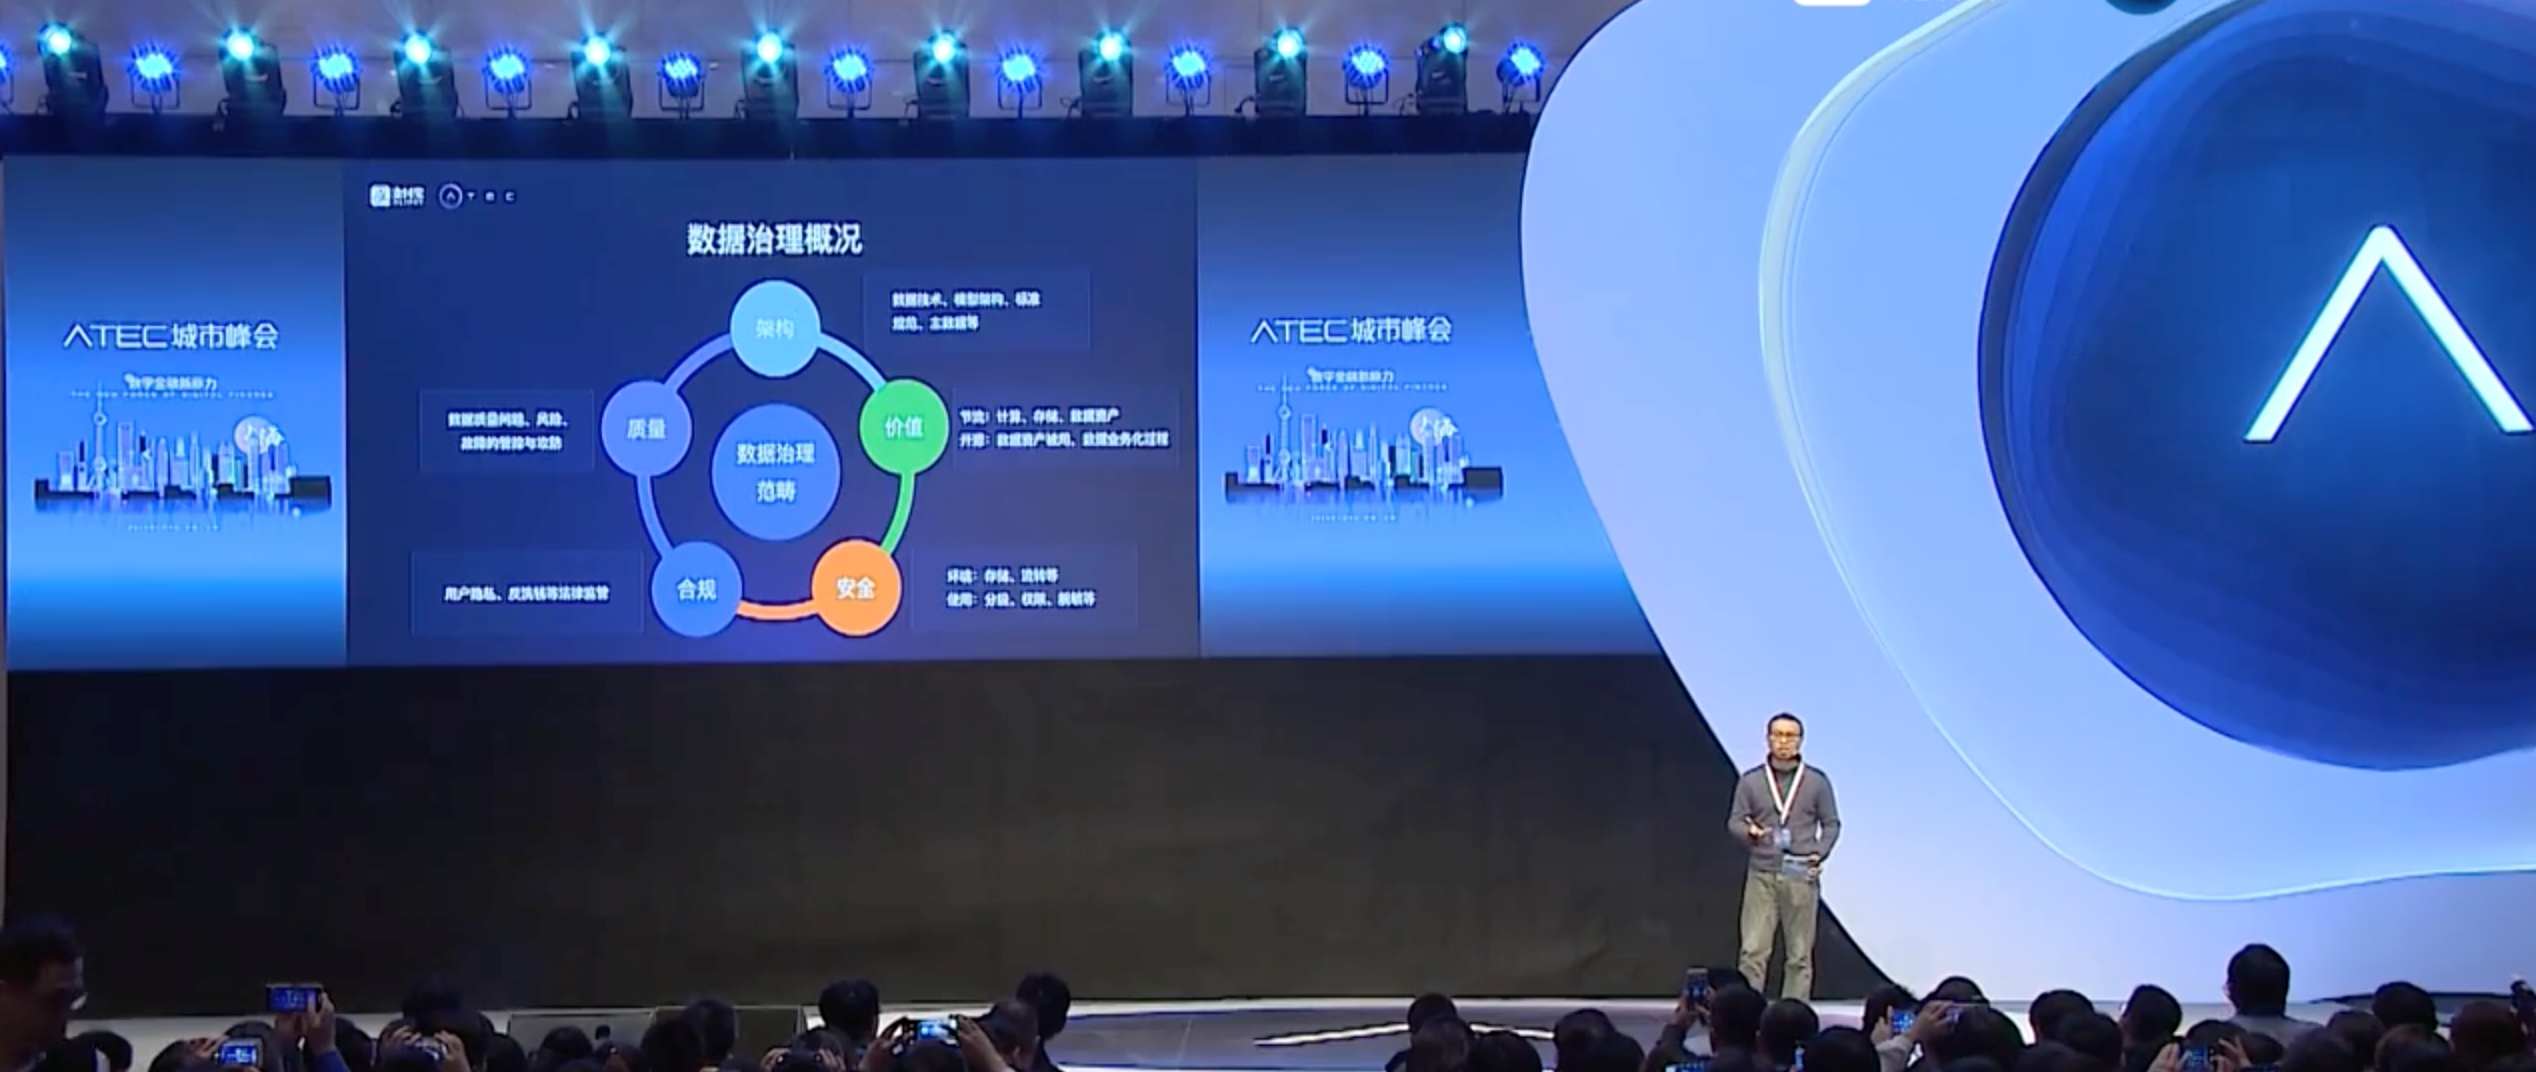
今年年初,蚂蚁金服ATEC城市峰会在上海举办。金融智能专场分论坛上,蚂蚁金服数据平台部高级数据技术专家李俊华做了主题为《蚂蚁金服数据治理之数据质量治理实践》的精彩分享。 演讲中,李俊华介绍了蚂蚁金服数据架构体系的免疫系统——数据质量治理体系,此外还着重介绍了数据质量实施的相关内容,以及蚂蚁的数据质量治理实践与所面对的实际挑战。蚂蚁金服数据平台部高级数据技术专家李俊华 一、数据治理概况 近年来,蚂蚁金服不断在数据架构上进行升级改造,其目的在于解决蚂蚁所面临的数据物理孤岛问题。如今,蚂蚁以及整个阿里巴巴集团的底座都统一到了同一个平台上,这样当实现第五代数据架构体系升级时,就降低了一站式研发的整体门槛,并使得蚂蚁金服的所有工程师都可以在平台上轻松玩转数据。如今,在蚂蚁的数据架构中已经能够很好地解决数据孤岛问题,而如今在数据治理体系中所需要关注

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册