首页 文章 精选 留言 我的

精选列表

搜索[高可用],共10008篇文章
优秀的个人博客,低调大师

使用Kubespray 部署kubernetes 高可用集群

Requirements Ansible v2.4 及以上版本,安装python-netaddr到运行Ansible commands的机器 Jinja 2.9 及以上版本,运行Ansible Playbooks 目标servers 必须可以访问外网,可以pull docker images 目标servers 配置允许 IPv4 forwarding 将公钥复制到所有机器 关闭防火墙 请提前安装好docker,因为k8s不支持最新版docker,具体适配哪些docker版本,请看k8s上的changelog 0、环境 主机名 IP master1 172.16.105.21 master2 172.16.105.22 master3 172.16.105.23 node1 172.16.105.24 node2 172.16.105.25 ansible-client 172.16.105.20 1、安装ansible和依赖 在172.16.105.20安装ansible # 安装 python 及 epel yum install -y epel-release python-pip python34 python34-pip # 安装 ansible yum install -y ansible pip install netaddr pip install --upgrade jinja2 2、建立公私钥,分发各服务器 在ansible-clinet机器生成免密密钥对 ssh-keygen -t rsa -P '' 将生成的公钥(id_rsa.pub)传到其他节点,这样ansible-client可以免密登陆其他机器 cat id_rsa.pub >> ~/.ssh/authorized_keys 3、下载kuberspay源码 cd /usr/local/src/ wget https://github.com/kubernetes-incubator/kubespray/archive/v2.3.0.tar.gz 本版本所包含的组件版本 Kubernetes v1.8.1 Docker 1.13.1 etcd v3.2.4 Rkt v1.21.0 (optional) Calico v2.5.0 Weave 2.0.4 Flannel v0.8.0 3.1 禁用docker yum仓和docker安装 vim roles/docker/tasks/main.yml --- - name: gather os specific variables include_vars: "{{ item }}" with_first_found: - files: - "{{ ansible_distribution|lower }}-{{ ansible_distribution_version|lower|replace('/', '_') }}.yml" - "{{ ansible_distribution|lower }}-{{ ansible_distribution_release }}.yml" - "{{ ansible_distribution|lower }}-{{ ansible_distribution_major_version|lower|replace('/', '_') }}.yml" - "{{ ansible_distribution|lower }}.yml" - "{{ ansible_os_family|lower }}.yml" - defaults.yml paths: - ../vars skip: true tags: - facts - include: set_facts_dns.yml when: dns_mode != 'none' and resolvconf_mode == 'docker_dns' tags: - facts - name: check for minimum kernel version fail: msg: > docker requires a minimum kernel version of {{ docker_kernel_min_version }} on {{ ansible_distribution }}-{{ ansible_distribution_version }} when: (not ansible_os_family in ["CoreOS", "Container Linux by CoreOS"]) and (ansible_kernel|version_compare(docker_kernel_min_version, "<")) tags: - facts #禁用docker仓库,已经使用清华源 #- name: ensure docker repository public key is installed # action: "{{ docker_repo_key_info.pkg_key }}" # args: # id: "{{item}}" # keyserver: "{{docker_repo_key_info.keyserver}}" # state: present # register: keyserver_task_result # until: keyserver_task_result|succeeded # retries: 4 # delay: "{{ retry_stagger | random + 3 }}" # environment: "{{ proxy_env }}" # with_items: "{{ docker_repo_key_info.repo_keys }}" # when: not (ansible_os_family in ["CoreOS", "Container Linux by CoreOS"] or is_atomic) #- name: ensure docker repository is enabled # action: "{{ docker_repo_info.pkg_repo }}" # args: # repo: "{{item}}" # state: present # with_items: "{{ docker_repo_info.repos }}" # when: not (ansible_os_family in ["CoreOS", "Container Linux by CoreOS"] or is_atomic) and(docker_repo_info.repos|length > 0) #- name: Configure docker repository on RedHat/CentOS # template: # src: "rh_docker.repo.j2" # dest: "/etc/yum.repos.d/docker.repo" # when: ansible_distribution in ["CentOS","RedHat"] and not is_atomic #- name: ensure docker packages are installed # action: "{{ docker_package_info.pkg_mgr }}" # args: # pkg: "{{item.name}}" # force: "{{item.force|default(omit)}}" # state: present # register: docker_task_result # until: docker_task_result|succeeded # retries: 4 # delay: "{{ retry_stagger | random + 3 }}" # environment: "{{ proxy_env }}" # with_items: "{{ docker_package_info.pkgs }}" # notify: restart docker # when: not (ansible_os_family in ["CoreOS", "Container Linux by CoreOS"] or is_atomic) and (docker_package_info.pkgs|length > 0) #对于docker的版本检测进行了保留 - name: check minimum docker version for docker_dns mode. You need at least docker version >= 1.12 for resolvconf_mode=docker_dns command: "docker version -f '{{ '{{' }}.Client.Version{{ '}}' }}'" register: docker_version failed_when: docker_version.stdout|version_compare('1.12', '<') changed_when: false when: dns_mode != 'none' and resolvconf_mode == 'docker_dns' #对于docker的systemd配置,可以根据自己需求修改,但是注意会覆盖原来的 - name: Set docker systemd config include: systemd.yml - name: ensure docker service is started and enabled service: name: "{{ item }}" enabled: yes state: started with_items: - docker 4、替换镜像 因为长城的原因,需要的镜像在安装的时候无法获取,所以需要改下源码,下载自己私有仓的镜像 脚本内容如下: gcr_image_files=( ./kubespray/roles/download/defaults/main.yml ./kubespray/roles/dnsmasq/templates/dnsmasq-autoscaler.yml.j2 ./kubespray/roles/kubernetes-apps/ansible/defaults/main.yml ) for file in ${gcr_image_files[@]} ; do sed -i 's/gcr.io/docker.emarbox.com/g' $file done 镜像列表,最好提前下载到私有仓,毕竟下载会很慢 gcr.io/google_containers/cluster-proportional-autoscaler-amd64:1.1.1 gcr.io/google_containers/k8s-dns-sidecar-amd64:1.14.5 gcr.io/google_containers/k8s-dns-kube-dns-amd64:1.14.5 gcr.io/google_containers/k8s-dns-dnsmasq-nanny-amd64:1.14.5 gcr.io/google_containers/pause-amd64:3.0 gcr.io/google_containers/kubernetes-dashboard-amd64:v1.6.3 nginx:1.11.4-alpine busybox:latest quay.io/coreos/hyperkube:v1.8.1_coreos.0 quay.io/coreos/etcd:v3.2.4 quay.io/calico/ctl:v1.5.0 quay.io/calico/node:v2.5.0 quay.io/calico/routereflector:v0.4.0 quay.io/calico/cni:v1.10.0 5、配置文件内容 可以对auth的密码进行修改,网络插件默认calico,可替换成weave或flannel,还可以配置是否安装helm和efk,以及修改安装路径 more kubespray/kubespray-2.3.0/inventory/group_vars/k8s-cluster.yml #6、生成自己的集群配置 因为kubespray自带的python脚本是Python3 ,所以要安装Python3 yum install -y python-pip python34 python34-pip # 定义集群IP IP=( 172.16.105.21 172.16.105.22 172.16.105.23 ) # 利用kubespray自带的python脚本生成配置 CONFIG_FILE=./kubespray/inventory/inventory.cfg python3 ./kubespray/contrib/inventory_builder/inventory.py ${IP[*]} 查看配置 cat ./kubespray/inventory/inventory.cfg [all] node1 ansible_host=172.16.105.21 ip=172.16.105.21 node2 ansible_host=172.16.105.22 ip=172.16.105.22 node3 ansible_host=172.16.105.23 ip=172.16.105.23 [kube-master] node1 node2 node3 [kube-node] node1 node2 node3 [etcd] node1 node2 node3 [k8s-cluster:children] kube-node kube-master [calico-rr] [vault] node1 node2 node3 7、安装集群 ansible-playbook -i inventory/inventory.cfg cluster.yml -b -v 镜像地址 kubespray/roles/download/tasks/download_container.yml 8、问题 8.1 从1.8 开始,kubelet 会检测机器是否有swap,如果启用swap,kubelet会无法启动,需要手动添加参数。 去如下目录,修改kubelet参数 /usr/local/src/kubespray/kubespray-2.3.0/roles/kubernetes/node/defaults ### fail with swap on (default true) kubelet_fail_swap_on: false 8.2 注意机器主机名,要符合k8s的规范 9、安装失败如何清理 rm -rf /etc/kubernetes/ rm -rf /var/lib/kubelet rm -rf /var/lib/etcd rm -rf /usr/local/bin/kubectl rm -rf /etc/systemd/system/calico-node.service rm -rf /etc/systemd/system/kubelet.service systemctl stop etcd.service systemctl disable etcd.service systemctl stop calico-node.service systemctl disable calico-node.service docker stop $(docker ps -q) docker rm $(docker ps -a -q) systemctl restart docker 10、安装完成 [root@node2 .kube]# kubectl get nodes NAME STATUS ROLES AGE VERSION node1 Ready master,node 9m v1.8.1+coreos.0 node2 Ready master,node 9m v1.8.1+coreos.0 node3 Ready master,node 9m v1.8.1+coreos.0 11、扩展集群node 把需要添加的node 写入配置文件,然后执行ansible 以添加node4举例 修改 inventory.cfg [all] node1 ansible_host=172.16.105.21 ip=172.16.105.21 node2 ansible_host=172.16.105.22 ip=172.16.105.22 node3 ansible_host=172.16.105.23 ip=172.16.105.23 node4 ansible_host=172.16.105.37 ip=172.16.105.37 [kube-master] node1 node2 node3 [kube-node] node1 node2 node3 node4 [etcd] node1 node2 node3 [k8s-cluster:children] kube-node kube-master [calico-rr] [vault] node1 node2 node3 ansible-playbook -i inventory/inventory.cfg scale.yml -b -v \ --private-key=~/.ssh/private_key 后感 了解ansible,也就能自己随便搞kubespray,这个东西比较透明,不像kubeadm,封装很严,不知道具体流程,出问题也不知道怎么处理。 本文转自银狐博客51CTO博客,原文链接http://blog.51cto.com/foxhound/2044766如需转载请自行联系原作者 战狐

优秀的个人博客,低调大师

lvs+keepalived部署高可用集群

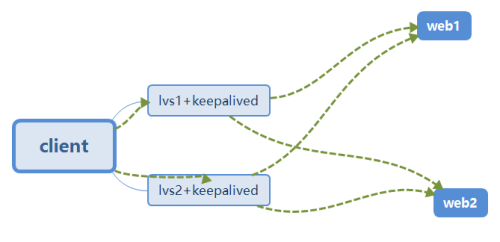
本环境基于centos7部署,基本架构图: client ip:192.168.1.101 lvs1 ip:192.168.1.173 lvs2 ip:192.168.1.110 web1:192.168.1.114 web2:192.168.1.119 VIP: 192.168.1.10 部署流程: lvs1: # yum install ipvsadm # ipvsadm#查看是否输出安装成功 # yum install keepalived # vim /etc/keepalived/keepalived.conf global_defs { notification_email { xxx@qq.com } notification_email_from xxx@qq.com smtp_server smtp.qq.com smtp_connect_timeout 30 router_id LVS1 } vrrp_instance VI_1 { state MASTER interface ens33 virtual_router_id 51 priority 100 advert_int 1 authentication { auth_type PASS auth_pass 1111 } virtual_ipaddress { 192.168.1.10 } } virtual_server 192.168.1.10 80 { delay_loop 6 lb_algo rr lb_kind DR nat_mask 255.255.255.0 persistence_timeout 50 protocol TCP real_server 192.168.1.114 80 { weight 1 TCP_CHECK { connect_timeout 3 nb_get_retry 3 delay_before_retry 3 } } real_server 192.168.1.119 80 { weight 1 TCP_CHECK { connect_timeout 3 nb_get_retry 3 delay_before_retry 3 } } } # vim /etc/sysctl.conf#开启路由转发 net.ipv4.ip_forward= 1 # sysctl -p # service keepalived start lvs2配置跟lvs大致相同 # vim /etc/keepalived/keepalived.conf state BACKUP #service keepalived start 后端web服务器使用nginx即可 浏览器请求http://192.168.1.10 #ipvsadm -l#查看调度信息 本文转自小白的希望 51CTO博客,原文链接:http://blog.51cto.com/haoyonghui/1933496,如需转载请自行联系原作者

优秀的个人博客,低调大师

高可用Hadoop平台-Ganglia安装部署

1.概述 最近,有朋友私密我,Hadoop有什么好的监控工具,其实,Hadoop的监控工具还是蛮多的。今天给大家分享一个老牌监控工具Ganglia,这个在企业用的也算是比较多的,Hadoop对它的兼容也很好,不过就是监控界面就不是很美观。下次给大家介绍另一款工具——Hue,这个界面官方称为Hadoop UI,界面美观,功能也比较丰富。今天,在这里主要给大家介绍Ganglia这款监控工具,介绍的内容主要包含如下: Ganglia背景 Ganglia安装部署、配置 Hadoop集群配置Ganglia 启动、预览Ganglia 下面开始今天的内容分享。 2.Ganglia背景 Ganglia是UC Berkeley发起的一个开源集群监视项目,设计用于测量数以千计的节点。Ganglia的核心包含gmond、gmetad以及一个Web前端。主要是用来监控系统性能,如:cpu 、mem、硬盘利用率, I/O负载、网络流量情况等,通过曲线很容易见到每个节点的工作状态,对合理调整、分配系统资源,提高系统整体性能起到重要作用。 Ganglia其核心由3部分组成: gmond:运行在每个节点上监视并收集节点信息,可以同时收发统计信息,它可以运行在广播模式和单播模式中。 gmetad:从gmond以poll的方式收集和存储原数据。 ganglia-web:部署在gmetad机器上,访问gmetad存储的元数据并由Apache Web提高用户访问接口。 下面,我们来看看Ganglia的架构图,如下图所示: 从架构图中,我们可以知道Ganglia支持故障转移,统计可以配置多个收集节点。所以我们在配置的时候,可以按需选择去配置Ganglia,既可以配置广播,也可以配置单播。根据实际需求和手上资源来决定。 3.Ganglia安装部署、配置 3.1安装 本次安装的Ganglia工具是基于Apache的Hadoop-2.6.0。另外系统环境是CentOS 6.6。首先,我们下载Ganglia软件包,步骤如下所示: 第一步:安装yum epel源 [hadoop@nna ~]$ rpm -Uvh http://dl.fedoraproject.org/pub/epel/6/i386/epel-release-6-8.noarch.rpm 第二步:安装依赖包 [hadoop@nna ~]$ yum -y install httpd-devel automake autoconf libtool ncurses-devel libxslt groff pcre-devel pkgconfig 第三步:查看Ganglia安装包 [hadoop@nna ~]$ yum search ganglia 然后,我为了简便,把Ganglia安装全部安装,安装命令如下所示: 第四步:安装Ganglia [hadoop@nna ~]$ yum -y install ganglia* 最后等待安装完成,由于这里资源有限,我将Ganglia Web也安装在NNA节点上,另外,其他节点也需要安装Ganglia的Gmond服务,该服务用来发送数据到Gmetad,安装方式参考上面的步骤。 3.2部署 在安装Ganglia时,我这里将Ganglia Web部署在NNA节点,其他节点部署Gmond服务,下表为各个节点的部署角色: 节点 Host 角色 NNA 10.211.55.26 Gmetad、Gmond、Ganglia-Web NNS 10.211.55.27 Gmond DN1 10.211.55.16 Gmond DN2 10.211.55.17 Gmond DN3 10.211.55.18 Gmond Ganglia部署在Hadoop集群的分布图,如下所示: 3.3配置 在安装好Ganglia后,我们需要对Ganglia工具进行配置,在由Ganglia-Web服务的节点上,我们需要配置Web服务。 ganglia.conf [hadoop@nna ~]$ vi /etc/httpd/conf.d/ganglia.conf 修改内容如下所示: # # Ganglia monitoring system php web frontend # Alias /ganglia /usr/share/ganglia <Location /ganglia> Order deny,allow # Deny from all Allow from all # Allow from 127.0.0.1 # Allow from ::1 # Allow from .example.com </Location> 注:红色为添加的内容,绿色为注销的内容。 gmetad.conf [hadoop@nna ~]$ vi /etc/ganglia/gmetad.conf 修改内容如下所示: data_source "hadoop" nna nns dn1 dn2 dn3 这里“hadoop”表示集群名,nna nns dn1 dn2 dn3表示节点域名或IP。 gmond.conf [hadoop@nna ~]$ vi /etc/ganglia/gmond.conf 修改内容如下所示: /* * The cluster attributes specified will be used as part of the <CLUSTER> * tag that will wrap all hosts collected by this instance. */ cluster { name = "hadoop" owner = "unspecified" latlong = "unspecified" url = "unspecified" } /* Feel free to specify as many udp_send_channels as you like. Gmond used to only support having a single channel */ udp_send_channel { #bind_hostname = yes # Highly recommended, soon to be default. # This option tells gmond to use a source address # that resolves to the machine's hostname. Without # this, the metrics may appear to come from any # interface and the DNS names associated with # those IPs will be used to create the RRDs. # mcast_join = 239.2.11.71 host = 10.211.55.26 port = 8649 ttl = 1 } /* You can specify as many udp_recv_channels as you like as well. */ udp_recv_channel { # mcast_join = 239.2.11.71 port = 8649 bind = 10.211.55.26 retry_bind = true # Size of the UDP buffer. If you are handling lots of metrics you really # should bump it up to e.g. 10MB or even higher. # buffer = 10485760 } 这里我采用的是单播,cluster下的name要与gmetad中的data_source配置的名称一致,发送节点地址配置为NNA的IP,接受节点配置在NNA上,所以绑定的IP是NNA节点的IP。以上配置是在有Gmetad服务和Ganglia-Web服务的节点上需要配置,在其他节点只需要配置gmond.conf文件即可,内容配置如下所示: /* Feel free to specify as many udp_send_channels as you like. Gmond used to only support having a single channel */ udp_send_channel { #bind_hostname = yes # Highly recommended, soon to be default. # This option tells gmond to use a source address # that resolves to the machine's hostname. Without # this, the metrics may appear to come from any # interface and the DNS names associated with # those IPs will be used to create the RRDs. # mcast_join = 239.2.11.71 host = 10.211.55.26 port = 8649 ttl = 1 } /* You can specify as many udp_recv_channels as you like as well. */ udp_recv_channel { # mcast_join = 239.2.11.71 port = 8649 # bind = 10.211.55.26 retry_bind = true # Size of the UDP buffer. If you are handling lots of metrics you really # should bump it up to e.g. 10MB or even higher. # buffer = 10485760 } 4.Hadoop集群配置Ganglia 在Hadoop中,对Ganglia的兼容是很好的,在Hadoop的目录下/hadoop-2.6.0/etc/hadoop,我们可以找到hadoop-metrics2.properties文件,这里我们修改文件内容如下所示,命令如下所示: [hadoop@nna hadoop]$ vi hadoop-metrics2.properties 修改内容如下所示: namenode.sink.ganglia.servers=nna:8649 #datanode.sink.ganglia.servers=yourgangliahost_1:8649,yourgangliahost_2:8649 resourcemanager.sink.ganglia.servers=nna:8649 #nodemanager.sink.ganglia.servers=yourgangliahost_1:8649,yourgangliahost_2:8649 mrappmaster.sink.ganglia.servers=nna:8649 jobhistoryserver.sink.ganglia.servers=nna:8649 这里修改的是NameNode节点的内容,若是修改DataNode节点信息,内容如下所示: #namenode.sink.ganglia.servers=nna:8649 datanode.sink.ganglia.servers=dn1:8649 #resourcemanager.sink.ganglia.servers=nna:8649 nodemanager.sink.ganglia.servers=dn1:8649 #mrappmaster.sink.ganglia.servers=nna:8649 #jobhistoryserver.sink.ganglia.servers=nna:8649 其他DN节点可以以此作为参考来进行修改。 另外,在配置完成后,若之前Hadoop集群是运行的,这里需要重启集群服务。 5.启动、预览Ganglia Ganglia的启动命令有start、restart以及stop,这里我们分别在各个节点启动相应的服务,各个节点需要启动的服务如下: NNA节点: [hadoop@nna ~]$ service gmetad start [hadoop@nna ~]$ service gmond start [hadoop@nna ~]$ service httpd start NNS节点: [hadoop@nns ~]$ service gmond start DN1节点: [hadoop@dn1 ~]$ service gmond start DN2节点: [hadoop@dn2 ~]$ service gmond start DN3节点: [hadoop@dn3 ~]$ service gmond start 然后,到这里Ganglia的相关服务就启动完毕了,下面给大家附上Ganglia监控的运行截图,如下所示: 6.总结 在安装Hadoop监控工具Ganglia时,需要在安装的时候注意一些问题,比如:系统环境的依赖,由于Ganglia需要依赖一些安装包,在安装之前把依赖环境准备好,另外在配置Ganglia的时候需要格外注意,理解Ganglia的架构很重要,这有助于我们在Hadoop集群上去部署相关的Ganglia服务,同时,在配置Hadoop安装包的配置文件下(/etc/hadoop)目录下,配置Ganglia配置文件。将hadoop-metrics2.properties配置文件集成到Hadoop集群中去。 7.结束语 这篇博客就和大家分享到这里,如果大家在研究学习的过程当中有什么问题,可以加群进行讨论或发送邮件给我,我会尽我所能为您解答,与君共勉!

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册