首页 文章 精选 留言 我的

精选列表

搜索[开发经验],共10009篇文章
优秀的个人博客,低调大师

OpenStack参考架构的搭建经验

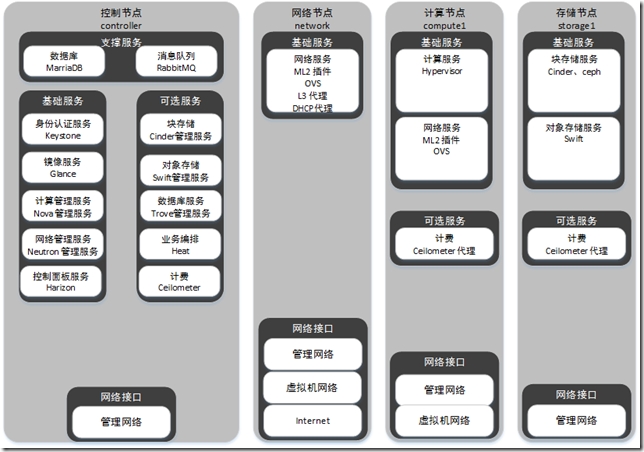
在OpenStack官方11月26日提供的《安装指南》中提到有一个部署模型,大体如下图所示 (图1 OpenStack系统架构图) 图1表现的是每一个节点中所安装的主要组件以及网络接口信息。更精准的展示如图2所示。图中显示的“Internet”网络接口参考图2中对网络接口的解释。 (图2 OpenStack网络架构图) 图2所示,红色属于管理网络,咖啡色属于虚拟机网络,青色是外部网络,蓝色是存储网络。 OpenStack中各种网络的功能 管理网络一般是带有默认网关的可访问Internet的网络,通过此网络完成各个组件的安装以及内部通信,如数据库、消息队列、keystone等API等数据的传输。每一个节点的管理网络是互通的。 虚拟机网络(隧道网络)不带默认网关(通常一个Linux主机,默认网关只能有一个),此网络接口用于计算节点与网络节点的点对点通信,如openswitch中包含的gre、vxlan等通信,所有的计算节点都能通过此网卡与网络节点进行通信。 外部网络是OpenStack平台中的虚拟机与Internet间的通信,此网络接口同样不需要配置网关,虚拟机网卡通过网桥的方式连接到Internet,实际上,此网卡不进行任何IP配置,即不需要配置IP地址、掩码、网关,启动协议设置为none,但要保证此网卡是开机启动的。 存储网络顾名思义传输的是特定格式的存储数据,不具有默认网关,只要保证计算节点与存储节点间互通即可。 (图3 OpenStack最小系统要求) 关于最小配置,我根据自己的实验环境搭建了一套,经过实际测试,是完全可以用的。具体配置如表格1所示。 控制节点 1*2vCPU 2GB内存 1*1Gbps网卡 16GB硬盘 LVM分区 管理网络a 网络节点 1*2vCPU 2GB内存 3*1Gbps网卡 16GB硬盘 LVM分区 管理网络b 隧道网络a 外部网络 计算节点 2*2vCPU 4GB内存 2*1Gbps网卡 40GB硬盘 LVM分区 管理网络c 隧道网络b 表格1 注释:没有配置任何存储节点。 管理网络abc之间互通。 隧道网络ab之间互通。 OpenStack平台中的虚拟机可以ping通路由器网关以及外部网络所有的网关。 操作系统的部分配置可以参见图4。 (图4 OpenStack操作系统配置参考) 注释: 1.主机名称最好与OpenStack中的组件名称区分开来,例如不要用controller这样的主机名称。 2.IP全部设置为静态IP,管理网络和隧道网络具有相同的IP地址的第四段。 3.配置网卡时,全部设置为开机自启动。 4.因为是测试环境,所以为避免麻烦,可以将所有密码设置为一个简单的相同的密码。 5.控制节点上可以选装图形界面以及qemu-img、qemu-kvm、virt-manager等虚拟化包,便于制作OpenStack image。 6.所有的节点都不需要开启防火墙,此版本的安全组功能与防火墙无关,SELinux也可以禁用掉,否则有时需要用chcon、setsebool等进行处理。 7.如果想在VMware虚拟化平台上实现OpenStack(虚拟化中的虚拟化),要至少满足两个先决条件: 1).开启“外部网络”“分布式交换机”、“标准交换机”或在Nexus 1000v命令行中启用“混杂模式”,关于“混杂模式”,可以去Google一下。 2).VMware ESXi主机必须启用虚拟化中的虚拟化(嵌套虚拟化)功能,方法: 编辑ESXi(5.0及以上)中的/etc/vmware/config,添加vhv.allow ="TRUE",然后重启ESXi主机; 编辑ESXi(5.1及以上)中的/etc/vmware/config,添加vhv.enable ="TRUE",然后重启ESXi主机; 另附一张OpenStack流程图,见下图: (图5 OpenStack系统流程图) 注释:图片不清楚的参考附件。 end 本文转自 urey_pp 51CTO博客,原文链接:http://blog.51cto.com/dgd2010/1585352,如需转载请自行联系原作者

优秀的个人博客,低调大师

(课程)基于Spark的机器学习经验

Hi,大家好!我是祝威廉,本来微博也想叫祝威廉的,可惜被人占了,于是改名叫·祝威廉二世。然后总感觉哪里不对。目前在乐视云数据部门里从事实时计算,数据平台、搜索和推荐等多个方向。曾从事基础框架,搜索研发四年,大数据平台架构、推荐三年多,个人时间现专注于集群自动化部署,服务管理,资源自动化调度等方向。 今天会和大家分享三个主题。 不过限于时间,第三个只是会简单提及下, 等未来有机会可以更详细的分享。 如何基于Spark做机器学习(Spark-Shell其实也算的上即席查询了) 基于Spark做新词发现(依托Spark的强大计算能力) 基于Spark做智能问答(Spark上的算法支持) 其中这些内容在我之前写的一篇描述工作经历的文章 我的工作都有提及到,当然,可能不如今天分享的这么详细。 如何基于spark做机器学习 Spark发展到1.5版本,算是全平台了,实时批计算,批处理,算法库,SQL,hadoop能做的,基本他都能做,而且做的比Hadoop好。 当然,这里我要提及的是,Spark依然是Hadoop生态圈的一员,他替换的也仅仅是MR的计算模型而已。资源调度依赖于Yarn,存储则依赖于HDFS,是hadoop生态圈的一颗新星(其实算是老星啦)。 我之前写文章说,Spark-Shell 是个伟大的创新,加上牛逼的Scala语言,写spark程序就和写普通的shell脚本(或者类似python程序)一样容易。问题是,原来的shell,python只能在单机工作,现在你写的每一行代码,都被放到了一个几百台,几千台的规模上去做了。 以前的统计/机器学习依赖于数据抽样,抽样从统计的角度来看,如果足够随机,其实可以很精准的反应全集的结果,但事实上往往很难做好随机,所以通常做出来也会很不准。现在大数据解决了这个问题,但不是通过优化抽样的随机来解决,而是通过全量数据来解决。 要解决全量的就需要有强大的处理能力,spark首先具备强大的处理能力,其次SparkShell带来了传说中的即席查询。做算法的工程师,以前经常是在小数据集上跑个单机,然后看效果不错,一到全量上,就歇菜了,和单机效果很不一样。虽然是小数据,但是在你的笔记本上跑你几个小时,也是很正常的。 但是有了spark后,不一样了,尤其是有了spark-shell。 我后面的两个例子,都完全是在spark-shell上写就的。边写代码,边运行,边看结果。我研究的CSDN几百万博文的时候,就是直接拿全量数据跑,直接看效果。spark 抽样也很方便,一个sample函数,你想要多少就多少。 几十个G的博文数据,count一下 也就十几秒,cache了之后 几秒就count完了。所以说,如果docker颠覆了部署,那么spark-shell 也应该颠覆算法工程师的日常工作。我现在会和一个百度的朋友比,哇,最近我们spark集群内存有9个T了,对方鄙视的看我一眼:百T的飘过..... 目前Spark已经提供的算法,我用的最多的是贝叶斯,word2vec,线性回归等。所以这里,作为算法工程师,或者分析师,一定要学会用spark-shell。 基于Spark做新词发现 新词发现是一个非常有意思的领域,用途非常多。譬如可以构建垂直领域词库,自动发现新热门词汇。词库的重要性我不用强调了。基于Spark强大的计算能力,我直接对200万+的博文进行了分析,得到大概八万词,包含中文、英文、中英文混合词。通过凝固度、自由度、词频、idf以及重合子串(比如 c1c2c3..cN c2c3..cN-1 这种形态的,我们认为是重合子串,如果词频一样,则都过滤掉,否则留词频高的)五个维度进行阈值设置和过滤。事实上,中间结果可以到几百亿,一个不小心就可以把Spark跑死,但是也在这个过程中慢慢对Spark有了更深的理解。 最终效果还是不错的,现在它已经作为我们的基础词库了。 基本上就是用spark计算出词的五个属性: 凝固度、自由度、词频、idf以及重合子串。算法自然是参考论文的,凝固度、自由度的概念来源于这里( http://www.matrix67.com/blog/archives/5044) 重合子串能修正一类的问题,但我感触比较深的是,通常某篇论文只会在一个视角去focus 某件事情,所以你需要参考多篇,从不同角度去理解这件事情的解决方式,最后通过实验综合,得到一个更好解决方案。我参考了两篇论文,比如凝固度,自由度是出自一篇论文,而重合子串则来自另外一篇论文,然后自己观察实际数据,添加了很多规则,才得到最后的结果。 一说到算法,大概很多人心里就是想着,恩,我把数据转化为算法需要的格式,然后丢给现成的算法跑,跑着就出结果,或者出模型,然后反复尝试,直到得到你认为能接受的或者最优的结果。我一开始也是这么想的,可是如果你真的做这件事情,就发现完全不是那样子啊,需要注意的细节太多了。 新词发现没有现成的工具包,所以完全自己写了。第一步,你要获取语料。这容易,基于现有的平台,我从我们资源中心挑出了200万篇文章id,然后根据id到数据网关获取title,body字段。这个基于现有的平台,也就一个SQL + 几行Scala代码就搞定的事情。 SQL 其实就是用Hive 生成一个200万博文id列表。Scala代码也就几行。因为我们的新词发现是没有词典的,需要枚举所有组合,然后通过一定的规则判定这是不是一个词。比如 ‘我是天才’,就这四个字, 组合有,‘我是’,‘我是天’,‘我是天才’,‘是天’,‘是天才’,‘天才’ 。你想想,200万篇文章,这种组合得多夸张,问题是你还要接着给这些组合做计算呢。这个算法可没告诉你怎么处理的,你只能自己去想办法。看到了,真正你做算法的过程中,不只是实现,你需要面对的问题特别多,我是怎么做的呢? 将所有html标签替换成空格。 通过小空格将一个大文本切分成无数小文本块。 我们认为一个词的长度最长不能超过5个字。 对每个小文本块再抽取出中文,中英文,英文。 将一些特殊字符,类似“!¥……()+{}【】的呀啊阿哎吧和与兮呃呗咚咦喏啐喔唷嗬嗯嗳你们我他她,这是由于” 这些不可能成词的字符先去掉。处理的过程中,你可能需要写中文,英文,中英文的抽取方法。 通过上面的五个处理,你计算规模会小非常多。如果不这样处理,估计再大内存都能让你歇菜。接着就是按论文里的规则做计算了,比如算词的凝固度,算重合子串。这里面还会遇到很多性能,或者内存的坑,比如Spark里的groupByKey,reduceByKey。 我一开始省事,用了groupByKey,歇菜了,内存直接爆了,为啥,你要去研究groupByKey到底是怎么实现的,一个词出现几十万次,几百万次都很正常啊,groupByKey受不了这种情况。所以你得用reduceByKey。 在spark 1.5里,已经支持动态调整worker数目了。我之前做这个的时候,会开的比较大,如果集群规模比较小,可能会影响别人,而且用完要赶紧释放,但释放了重新再起,也还是很麻烦的,现在好很多了。 很好,实现了算法后得到了结果,可人家没告诉你,他贴出来的结果都是好看的,那是因为他是按频次排的,但如果你拉到最后看,结果就不太好看了。这个时候你就需要观察数据了,然后提出新的规则,比如最后得到的中文词结果,我用了一些简单规则过滤下,都是哪些呢?凡是词里面包含‘或’的,或者'就'的或者上面罗列的,我都认为这个词是没有意义的,经过这个简单规则一过滤,效果好非常多,很多没什么意义的生活词,或者不成词的词就被去掉了。中文,英文,中英文混合,我都加了很多这种规则,最终才过滤出了八万计算机词汇。 我在做上面的方案时,基本上就是在spark-shell中完成的。其实有点像ngram,就是对所有字符串做所有枚举,只是会限制最终成词的长度。我这里中文是最长五个字,英文是四个字,中英文一块的 是五个字,接着要算出每个词左右连接字。具体的算法大家可以参考 http://www.matrix67.com/blog/archives/5044 这篇文章。而且如果有spark环境的,也可以尝试自己实现一把。 重合子串,是这个算法的一个比较大的问题,比如 c1c2c3...cN c2c3...cN-1,因为是从统计的方案做的,c1c2c3…cN c2c3...cN-1 他们两算出来的分数可能就是一样的,所以如果我们发现他们的分值或者出现频率是一样的,就可以直接排除掉了。 基于Spark做智能问答 其实我做的智能问答算不上智能问答,但是内部一开始这么叫的,所以也就这么顺带叫下来了。 其实做的事情非常简单: 比较两个标题的相似度 如果我们能知道两个句子说的其实是一件事情,那么就能打通各产品的互通鸿沟了。之前试水的项目是打通问答到博客的通道。具体效果大家可以看看CSDN的问答产品,里面的机器人,背后用的算法就是这套。当用户问一个问题,机器人就会到博客里去找有没有这个问题的答案,或者有没有可以做参考的。 比较神奇的是,之前有个在问答活跃的人也特别喜欢贴博客链接作为回答,我们对比了机器人和他的结果,发现机器人和他贴的差不多。 对于拥有内容的网站来说,这个技术还是非常重要的,比如CSDN,有论坛,博客,资讯,杂志等等,都是内容的载体。用户在问答频道里问的一个问题,其实在博客,在论坛早就已经有答案了。具体做法是透过word2vec解决一意多词的问题。接着将词转换为句子向量。这样任何一个问题都可以转换为一个向量。同理任何一篇博文的标题也可以转化为一个向量。 word2vec,采用的数据来源,我是用的搜索引擎的数据。大部分内容类的网站,他的PV应该有相当一部分来自搜索引擎,其实搜索引擎对这些网站来说,就是一个大的宝藏。因为搜索的query串,都是用户遇到的问题,然后指向到解决这些问题的内容上。内容上,所以我直接拿用户的query作为word2vec的语料,得到一些常用的提问词,每个词用一个50维度的向量表示。当然,我们不可能真的让一个问题和几百万内容直接做比较,一个简单有效的方式是,先通过搜索引擎去搜,然后将搜索得到top100结果做向量计算得到新的得分。 基本相似度大于0.9 的可以算作答案。大于0.7的就可以作为参考答案了。站内搜索服务应该是标配了,所以对大部分网站应该不是问题。 对了,这里有个问题是:word2vec计算出来的是用一个稠密的定长向量表示词,我的做法是直接把一个句子的里的词的向量按位做加法,重新得到一个新的向量作为句子的向量。当然,这种方式也是有缺陷,也就是句子越长,信息损耗越大。但是做这种标题性质的相似度,效果出奇的好,那种句子里很多词汇不相同的,它都能算出他们很相似来,这是因为word2vec可以算出不同词汇之间关系。 好了,具体的内容就分享到这里。 总结 下面是我的几个观点: 作为数据分析师,算法工程师,请好好利用spark-shell。 Spark社区为了满足数据分析师,算法工程师,其实也做了非常多的工作,包括Python, R语言的支持。15年社区努力做的DataFrame其实就是从R里借鉴过来的,也方便R数据科学家方便的迁移过来。我觉得大家都应该与时俱进,不要只玩单机了。 机器学习平台的构建,可以参考我这篇文章从内容/用户画像到如何做算法研发里面有我对平台方面一些看法。 课程Q&A Q: 如何从0开始系统学习spark,最后转行? A: 学会scala就行,scala是一门具有学院派气息的语言,你可以把它写的像python,ruby那样,也可以写的想java那样方方正正,也可以学习python,spark支持python但是可能有些功能用不了,用了一天的时间把Scala的官方教程看了,基本就能上手了。 Q:建议不做RAID的原因是什么?A: 比如我例子提到的默认HDFS的所有数据都会存三份,可以保证数据位于不同的服务器上,不同的磁盘上,所以无需RAID。 Q:很多没什么意义的生活词,或者不成词的词,这些词是怎样得到的?也是分析出来的? A: 因为用的都是统计的一些方式,所以肯定会有很多无意义的词汇,假设我们现在得到的词汇几何是 A,接着我去爬了一些新闻和生活的类的博客,然后用程序去跑一遍得到一批词汇B,然后A-B 就能得到一拼更纯正的计算机词汇。 Q:内存要调到多大才能不会爆掉?是不是有什么比例? A: 你不管调到多大,如果用的不好 也都有可能,groupByKey这个会有很大的内存问题,他形成的结构式 key-> value1,value2,value3…...valuen,这种是非常消耗存储空间的额,大家使用spark的时候,序列化最好使用kyro,性能确实好太多,一个worker 会同时配置可以使用的内存和cpu,这个时候一定要搭配好。比如你允许work使用5个cpu,那内存最好能配到10G,如果内存过小,你的cpu会大量浪费在GC上,我一般是单个worker 12G内存 ,可使用4核。 Q:直接把一个句子的里的词的向量按位做加法,这是如何加?能举个例子不? A:比如 考虑一个三维向量: A[1,3,5] B[1,3,7],现在有个句子 是AB两个词组成,则对应的向量为A+B=[2,6,12] Q:还有中文分词是用的什么方法?可否分享代码不啊? A:这里是无监督分词,所以不用中文分词,按维度叠加,才能保证都是相同长度的向量,而且中文分词这块,我推荐我一个同事的 ansj分词,还是做的不错的。 Q:一些分词方法具有新词发现的功能,比如crf,楼主是比较过效果么?而且我记得matrix67这个算法复杂度还是很高的? A:matrix67 这个算法复杂度还是非常高的,你实际操作就会发现计算量,内存使用量都很大,crf等据我所知,还都是需要依赖词表的,matrix67的这个方式,完全不需要任何先验的东西。 Q:为什么一个词要用50维度表示? 这能举个例子不? 这里不太明白。 A:理论上维度越长越好,我当时是随意试了一个值。发现效果其实已经可以了,这是一个可以调整的值,比如你可以分别生成50,150,300维度的,然后试试那个效果好。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册