首页 文章 精选 留言 我的

精选列表

搜索[Java框架],共10000篇文章
优秀的个人博客,低调大师

数据监控体系搭建方法论:从采集到告警的完整技术框架

前几年我接过一个价格监控项目。系统刚上线时很顺,每天定时采集、清洗、入库,报表也能正常更新。运行到第三周,业务突然反馈部分商品连续两天没有数据。 排查后才发现,采集脚本没有报错,数据库也在持续写入,但目标页面的字段结构已经变化。程序把解析失败的数据当成空结果,后面的监控只检查“任务有没有完成”,所以一直显示正常。 这件事让我重新认识了数据监控:真正需要监控的不是一条脚本,而是数据从产生到使用的完整链路。 一套能长期运行的数据监控体系,至少要回答三个问题: - 数据有没有按时拿到? - 拿到的数据是否完整、可信? - 出现异常后,能不能快速定位到具体环节? ## **先定义监控对象,再考虑技术选型** 很多项目一开始就讨论用什么数据库、消息队列和告警工具,最后却说不清到底要监控什么。 我通常先把监控对象分成三层。 第一层是**任务状态**,包括任务是否启动、是否结束、运行耗时和重试次数。这一层解决的是“程序有没有正常工作”。 第二层是**数据质量**,包括采集量、空值率、重复率、字段完整率和数值波动。这一层解决的是“程序拿到的数据能不能用”。 第三层是**业务结果**,例如商品价格是否异常变化、某个地区的数据是否突然减少、更新频率是否偏离正常基线。这一层才是业务真正关心的结果。 只监控第一层,最容易出现“任务成功,数据错误”的情况。 ## **采集层要留下足够的排查线索** 采集程序不能只输出成功或失败。每次请求至少要记录任务编号、数据源、请求时间、响应状态、响应耗时和解析结果。 我习惯给每批任务生成唯一的 `task_id`,让它贯穿采集、清洗、入库和告警环节。后面查问题时,只需要拿着这个编号顺着链路找,不必在几套日志里反复对时间。 原始响应也要保留一段时间。字段规则写错、页面结构变化或者清洗逻辑误删数据时,原始数据就是复盘依据。没有原始响应,只能重新采集,碰上数据源已经更新,现场就彻底丢了。 国内公开数据采集如果需要代理接入层,我会把代理状态也记入任务日志,包括节点、连接耗时、切换次数和连续失败数。 ## **调度和采集不要绑死** 任务少的时候,用定时脚本直接启动采集没有问题。任务量增加后,调度层最好只负责分发任务,不直接承担采集逻辑。 这样做有两个好处。 一是失败任务可以单独重试,不需要把整个批次重新跑一遍。二是采集端可以水平扩展,任务多时增加执行节点,任务少时减少资源占用。 每个任务还要设置明确状态,例如: `pending → running → collected → processed → stored → completed` 如果任务停在某个状态超过预期时间,系统就能判断它卡在哪一步,而不是等到整批数据没有产出才发现问题。 ## **数据校验要分成结构和业务两道关** 结构校验负责检查字段是否存在、类型是否正确、格式能否解析。业务校验则判断数据是否符合正常规律。 例如价格字段为0,从数据类型上看完全合法,但在业务上可能需要复核;某个平台当天采集量下降30%,也不一定是采集失败,可能只是数据源本身没有更新。 我一般会同时观察四组指标: |指标组|重点指标|主要判断| | --- | --- | --- | |采集质量|成功率、超时率、响应耗时|链路是否稳定| |数据质量|空值率、重复率、字段完整率|数据是否可用| |处理状态|队列积压、消费耗时、失败批次|处理是否及时| |业务结果|新增量、变化率、更新时间|结果是否合理| 数据会说话,但要把几组指标放在一起看。采集成功率下降,同时空值率升高,问题大概率在采集链路;采集指标正常,但业务数据明显减少,则要进一步确认数据源是否发生变化。 ## **存储要为追溯和查询分别服务** 监控系统至少要保留三层数据。 **原始层**保存未经加工的响应,用于复盘和重新计算;**明细层**保存清洗后的标准记录,供业务查询;**指标层**保存已经聚合的监控结果,供仪表盘和告警规则直接读取。 这三层不要混在一张表里。 如果告警系统每分钟扫描海量明细数据,不仅查询成本高,还可能影响正常写入。更省心的做法,是提前计算成功率、异常量和延迟等指标,让告警系统只读取小体量的指标表。 原始数据也不必永久保存。保留多久,要看业务问题通常多久才会暴露。如果异常经常在一周后才被反馈,原始数据只留三天肯定不够用。 ## **告警要能指导下一步动作** “任务异常,请及时处理”不算一条合格告警。 值班人员收到告警后,首先需要知道哪个任务出问题、当前值是多少、正常基线是多少、异常持续了多久,以及从哪里开始排查。 一条能用的告警至少应该包含: - 任务名称和任务编号 - 异常指标及当前数值 - 历史基线或告警阈值 - 首次发生时间和持续时长 - 相关日志或任务详情入口 - 建议优先检查的环节 单次超时通常先重试,不必立即通知。连续多个周期失败,或者采集量、空值率和处理延迟同时异常,再升级告警。否则消息太多,真正重要的异常反而容易被忽略。 恢复通知也要保留。异常什么时候结束、持续了多久、是否经过人工处理,都是后续复盘和调整阈值的依据。 ## **监控系统本身也需要被监控** 这是搭建过程中最容易漏掉的一层。 如果告警任务自己停止运行,业务任务出错时就不会有任何提示。因此需要一条独立的心跳链路,持续检查调度服务、消息队列、指标计算和通知通道是否正常。 我通常会设置一个固定频率的测试任务,让它按完整链路产生数据并触发一条可预期记录。如果这条记录没有按时出现,就说明监控体系本身存在问题。 监控不是加几条规则就结束了。每次真实故障后,都要回头检查:为什么已有指标没有提前发现?告警是否来得太晚?排查过程缺了哪条日志?这些问题解决一次,系统才会真正稳一点。 ## **到底怎么搭?** 如果让我从零搭一套数据监控体系,我会按这个顺序推进: 先给任务和数据建立唯一标识,把整条链路串起来;然后补齐原始数据、状态日志和质量校验;再根据历史数据建立指标基线;最后配置分级告警和故障复盘机制。 代理、消息队列和数据库都是工具,不是体系本身。真正决定系统能不能长期运行的,是每个环节都可观察、每条异常都能追踪、每次故障都能留下改进结果。 实操建议也很简单:先挑一条真实任务跑完整闭环,故意制造超时、空数据、字段变化和处理积压,看看系统能不能及时发现并指出排查方向。测试环境里主动暴露的问题越多,上线以后临时翻日志的次数就越少。 ## **常见问题** **Q:小项目需要一开始就上消息队列吗?** 不一定。任务少、允许整体重跑时,定时任务配合状态表已经够用。等到采集和处理速度明显不一致,或者失败任务需要独立重试,再引入消息队列。 **Q:告警阈值没有历史数据怎么定?** 先设置相对宽松的静态阈值,运行一到两周收集基线。等数据量和波动范围稳定后,再逐步换成按时段或任务类型区分的动态阈值。 **Q:怎样区分采集失败和数据源没有更新?** 同时看请求成功率、响应体大小、字段完整率和新增数据量。技术指标正常而新增量下降,更可能是数据源本身变化;多项技术指标一起异常,则优先检查采集链路。 **Q:代理接入层应该重点监控什么?** 不要只统计IP数量,重点看有效请求成功率、响应时间、连续失败次数和节点切换情况。如果准备接入代理商,建议直接用现有脚本测试,不要为了测试单独设计一套过于简单的请求。

优秀的个人博客,低调大师

Apex英雄目标检测数据集 深度学习框架YOLO如何训练APEX数据集

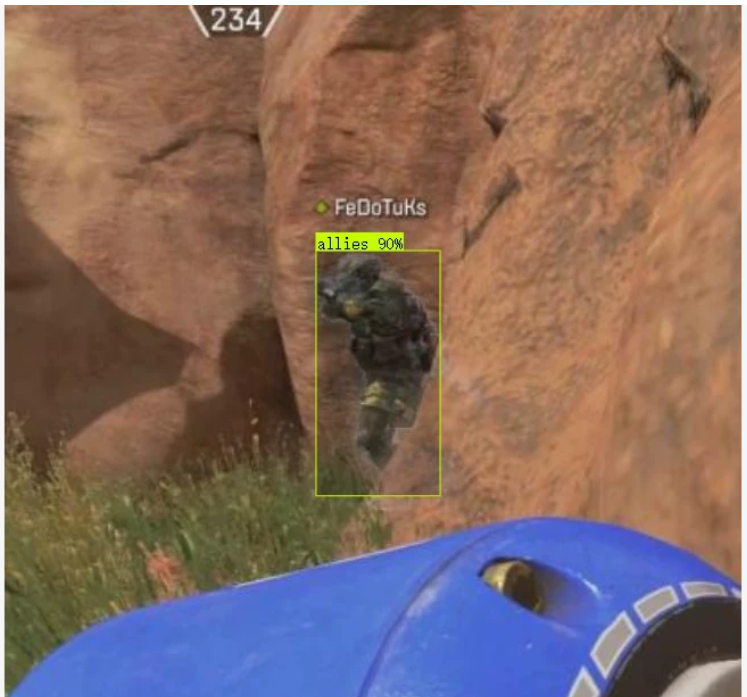
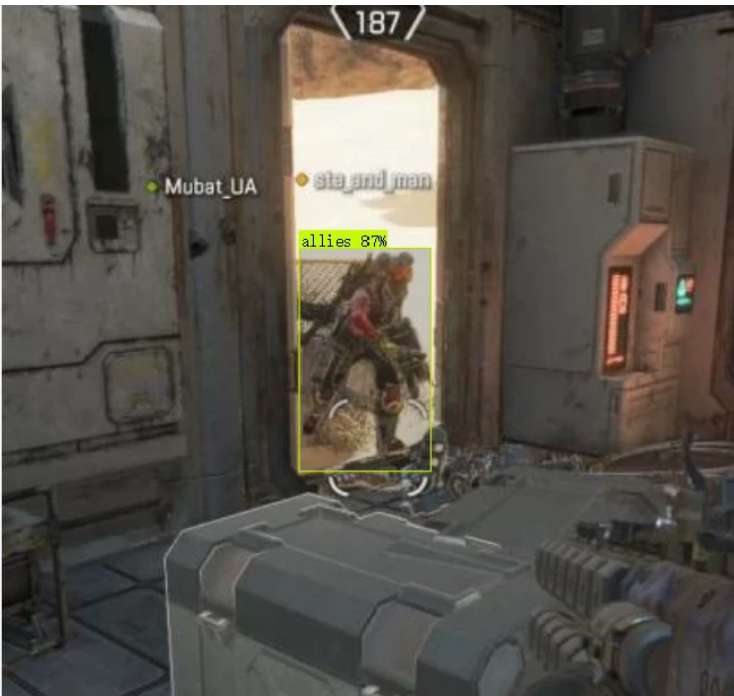
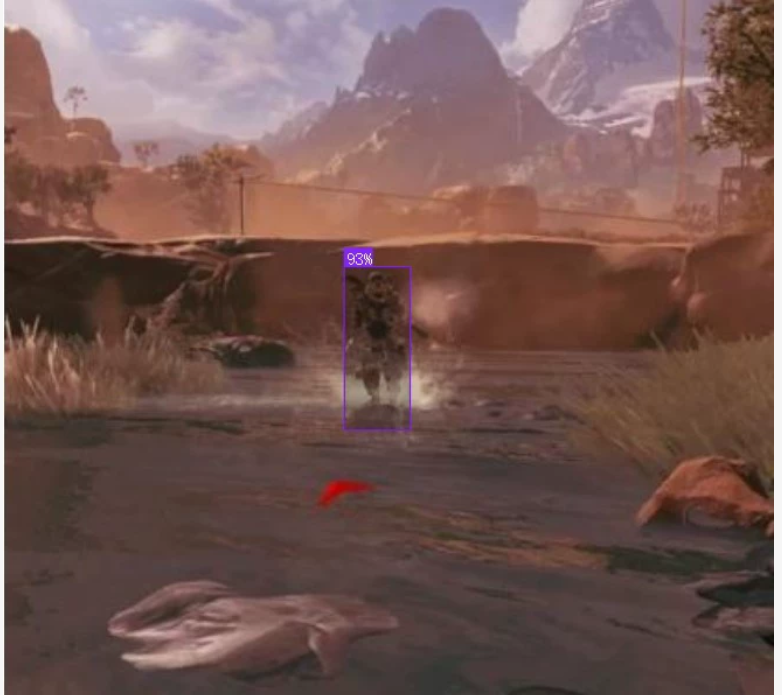
Apex检测数据集 ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-12490569/24ae6cc72ab6ed989cda3273b0aeb810.png) ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-12490569/6c757e86f1901b636ec2af8fde687405.png) 数据集详情 - 检测类别: allies enemy tag ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-12490569/18b6304f2376de08bff71a886fb18658.png) - 图片总量:7247张 - 训练集:5139张 - 验证集:1425张 - 测试集:683张![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-12490569/0a43f96d6f8eb8924927291cf4065393.png) - 标注状态:全部已标注,即拿即用![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-12490569/4329947a76bb76e38f5d74cd83c94aa9.png) - 数据格式:支持YOLO格式及其他格式( # Apex英雄目标检测数据集 ## 一、数据集信息表 | 项目 | 详细说明 | | ---- | ---- | | 数据集名称 | Apex英雄目标检测数据集 | | 图片总数量 | 7247 张 | | 数据集划分 | 训练集:5139 张验证集:1425 张测试集:683 张 | | 检测类别(共3类) | 0: allies(友方)1: enemy(敌方)2: tag(标记目标) | | 标注状态 | 全量完成标注,开箱即用 | | 数据格式 | 标准YOLO格式,同时兼容多种主流标注格式,可按需转换 | | 适用场景 | YOLO系列目标检测训练、游戏视觉识别、游戏AI开发、算法实训、计算机视觉毕业设计 | ## 二、核心标签 #Apex数据集 #Apex英雄 #目标检测 #YOLO数据集 #游戏视觉 #AI训练数据集 ## 三、数据集目录结构 ``` apex_dataset/ ├── images/ │ ├── train/ │ ├── val/ │ └── test/ ├── labels/ │ ├── train/ │ ├── val/ │ └── test/ └── apex.yaml ``` ## 四、数据集配置文件 apex.yaml ```yaml path: ./apex_dataset train: images/train val: images/val test: images/test nc: 3 names: 0: allies 1: enemy 2: tag ``` ## 五、环境依赖 ```bash pip install ultralytics torch opencv-python ``` ## 六、模型训练代码 train_apex.py ```python from ultralytics import YOLO def main(): # 加载YOLO预训练权重,兼容YOLOv8、YOLOv11 model = YOLO("yolov8s.pt") # 启动训练 train_res = model.train( data="./apex_dataset/apex.yaml", epochs=100, imgsz=640, batch=16, device=0, # 无GPU改为 device="cpu" workers=4, patience=15, project="runs/train", name="apex_detect", exist_ok=True, pretrained=True ) print("训练完成,权重存放路径:runs/train/apex_detect/weights") # 测试集评估 metrics = model.val(data="./apex_dataset/apex.yaml", split="test") print(f"mAP@50: {metrics.box.map50:.4f}") if __name__ == "__main__": main() ``` ## 七、推理测试代码 predict_apex.py ```python from ultralytics import YOLO import cv2 # 加载训练好的最优模型 model = YOLO("runs/train/apex_detect/weights/best.pt") if __name__ == "__main__": img_path = "test.jpg" # 执行检测并保存结果 results = model.predict(source=img_path, conf=0.25, iou=0.45, save=True) # 可视化画面 show_img = results[0].plot() cv2.imshow("Apex Detection", show_img) cv2.waitKey(0) cv2.destroyAllWindows() ```
资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册
修改密码
忘记密码