首页 文章 精选 留言 我的

精选列表

搜索[AI数据库],共10000篇文章
优秀的个人博客,低调大师

带你读AI论文丨针对文字识别的多模态半监督方法

摘要:本文提出了一种针对文字识别的多模态半监督方法,具体来说,作者首先使用teacher-student网络进行半监督学习,然后在视觉、语义以及视觉和语义的融合特征上,都进行了一致性约束。 本文分享自华为云社区《一种针对文字识别的多模态半监督方法》,作者: Hint 。 摘要 直到最近,公开的真实场景文本图像的数量仍然不足以训练场景文本识别器。因此,当前大多数的训练方法都依赖于合成数据并以全监督的方式运行。然而,最近公开的真实场景文本图像的数量显着增加,包括大量未标记的数据。利用这些资源需要半监督方法;然而,这些方法不能直接适配文字识别这类视觉语言的多模态结构。因此,本文提出了半监督多模态文本识别器(SemiMTR),它在训练阶段中,利用每个模态的未标记数据。此外,本文的方法并不需要额外的训练阶段,保持了当前的三阶段多模态训练策略。 首先,在视觉模型方面,本文提出了一个将自监督预训练和强监督训练结合的单阶段训练模型。然后,语言模型是在一个大型文本语料库上进行自监督预训练。得到两个模态的预训练模型之后,对文字识别进行半监督训练。本文采用的是teacher-student的结构,具体来说,对一张文本图像分别进行弱数据扩增和强数据扩增,然后对两个网络不同模态的输出进行一致性约束。大量实验证实本文的方法优于当前的训练方案,并在多个场景文本识别基准上取得了最先进的结果。 方法 1. 识别模型框架: 首先,本文的文字识别框架采用的是ABINet。大致流程如下:首先,视觉模型首先提取图像的特征序列并将其解码成字符序列;接着,将字符序列输入给语言模型,得到文本的语义特征;最后,使用一个融合模块,将视觉和语义特征进行融合,得到最终的识别结果。为了进一步提高识别性能,可以采用迭代的方式,多次对识别结果进行微调。 2. 视觉模型预训练 本文将自监督预训练与强监督预训练融合到了一个统一的框架下。自监督预训练采用的是基于对比学习的方法,在自监督的同时,也会对这些数据进行有标注的强监督预训练。 3. 基于一致性约束的半监督训练 首先,本文采用的是一个常见的teacher-student网络,进行半监督训练。具体来说,将前面得到的预训练模型作为teacher和student网络的初始化模型,然后对同一张输入图像进行弱数据扩增和强数据扩增,并分别输入到teacher和student网络中;将teacher网络的预测结果作为伪标签对student的输出进行监督。区别于一般的半监督学习,本文的方法对识别模型的各个模态都进行不同程度的一致性约束,比如视觉模型,语言模型和融合模型的输出。 实验 可以看到,本文的结果在多个数据集上取得了一致性的提升。 可以看到,在视觉预训练阶段,统一自监督预训练和强监督预训练比分阶段的训练效果要好。 可以看到,使用交叉熵loss作为一致性约束loss效果最好。 由于本文采用的识别模型,具有视觉、语言和融合的模态,所以在进行一致性约束的时候,teacher网络和student网络可以采用不同的特征分别进行对齐。从上表可以看到,当teacher和student网络中的vision,language和fusion模块分别进行对齐的时候,效果最好。 论文链接:[2205.03873] Multimodal Semi-Supervised Learning for Text Recognition (arxiv.org) 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

“千言”开源数据集项目全面升级:数据驱动AI技术进步

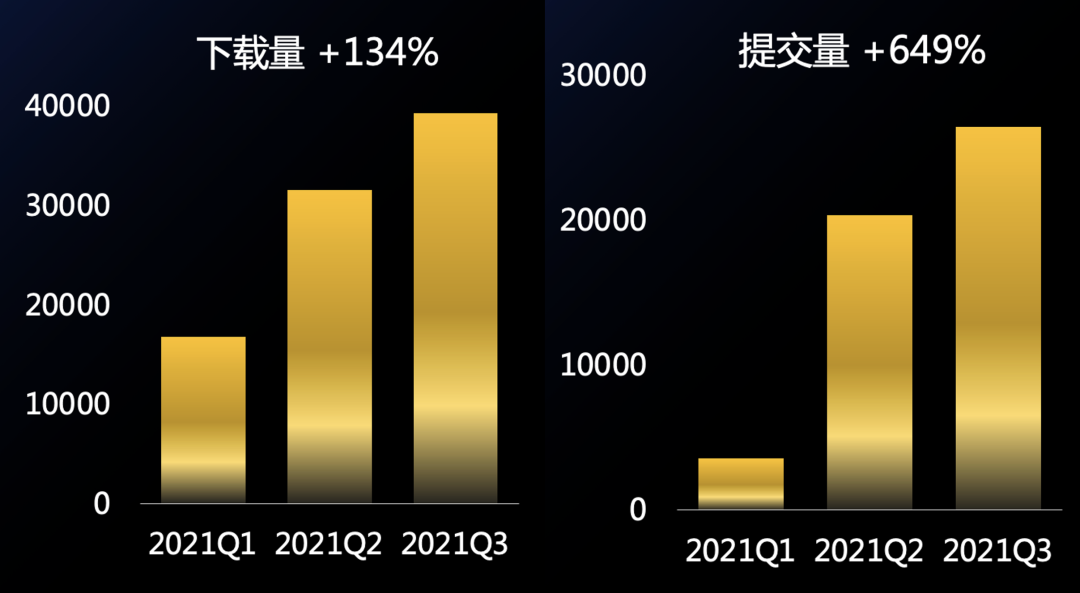
“千言”是由百度联合中国计算机学会、中国中文信息学会共同发起的面向自然语言处理的开源数据集项目,旨在推动中文信息处理技术的进步。近日,在2021年12月12日的WAVE SUMMIT+2021深度学习开发者峰会上,清华大学长聘副教授黄民烈作了题为“千言:数据驱动技术进步”的演讲,回顾了千言过去一年中取得的进展和广泛影响力,并发布了千言的全新升级,重点聚焦大模型时代的机遇和挑战。此外,还推出了“百+”计划,邀请更多的专家学者共同建设千言,构建世界范围内的中文NLP影响力。 中文开源数据集项目 “千言”获得广泛关注和使用 “千言”开源数据集项目自2020年8月发布以来,已经有来自清华、哈工大、中科院、美团、OPPO等14家单位的数据集作者加入共同建设,目前已经覆盖了10多个自然语言处理的任务,包含了开放域对话、机器阅读理解、机器同传、文本生成、情感分析等任务。“千言”为研究者提供了一站式的数据集浏览、整理、下载以及评测体验,受到了越来越多研究者的关注和使用,数据集下载量增长134%,相关任务的提交次数增长649%,增长非常显著。 此外,千言还推动了多项自然语言处理的评测,截至目前总共支持了20多项技术评测,包含了语言与智能技术竞赛(LIC 2021)、CCF BDCI多技能对话评测、NLGIW 2021面向事实一致性的生成评测、CCF BDCI问题匹配鲁棒性评测、NAACL 2021机器同传评测等。其中,参与评测的人员有57%来自高校和科研院所,21%来自企业,在学术界和工业界都产生了很大的影响力。开源数据集和技术评测的联动,很好的推动了相关任务的技术研究和应用发展。 “千言”升级:聚焦通用、可信、跨模态等大模型时代的机遇和技术挑战 推动人工智能技术进步的三大驱动力是算法、算力和数据。其中,数据作为最重要的基础,其数量和质量直接决定了算法能够达到的上限水平。人工智能的历史上,优秀的数据集极大地推动了领域技术的发展和行业的进步。近两三年,随着大模型技术的出现和发展,基于大模型的自然语言处理技术也取得了长足的进步。在取得进步的同时,大模型也带来了新的技术挑战和新的技术机遇,包括了通用、可信、跨模态等。“千言”的升级也重点聚焦在了这三个方面。 第一,通用。通用指模型需要具有全面的、处理多个子任务的能力,同时需要在跨领域数据上具有较好的泛化能力。“千言”推出了多技能对话任务和多形态信息抽取任务来促进模型通用性的提升。在多技能对话任务中,期望模型能够同时处理多种对话子任务,包括知识对话、闲聊对话、推荐对话、画像对话等;在多形态信息抽取任务上,期望模型能够同时处理句子级关系抽取、句子级事件抽取和以及篇章级事件抽取等任务。 第二,可信。可信是指模型在应用中需要有足够的鲁棒性、较高的可解释性以及结果的一致性。其中,为了促进提升模型的鲁棒性,“千言”发布了问题匹配鲁棒性数据集DuQM、阅读理解鲁棒性数据集DuReaderchecklist。为了提升模型的可解释性,“千言”发布了情感分析可解释数据集 DuTrust。在事实一致性方面,“千言”则推出三个生成任务来综合进行评测,分别包括了文案生成数据集AdvertiseGen、摘要生成数据集LCSTS、问题生成数据集DuReaderQG。 第三,跨模态。跨模态是指随着内容承载形式的多元化,模型需要具有多模态融合(语言、图像、语音、视频等)的内容理解等能力。为此,“千言”推出了机器同传数据集BSTC以及跨模态情感分析数据集DuVideoSenti来促进跨模态领域的发展。机器同传主要关注语言和语音跨模态的交互,而跨模态情感分析主要关注语言和视频跨模态的交互。 经过了一年的发展,千言所覆盖的任务和数据集数量显著增加,从最开始的7个任务,发展到最新的12个任务,对应的数据集数量,也从最开始的22个数据集,增加到了现在36个数据集。 千言“百+”计划:共同构建世界范围内中文NLP的影响力 为了更好地帮助数据集作者提升数据集影响力和推进相关技术发展,千言项目正式推出了“百+计划”,覆盖了“百+数据集作者”和“百+技术专家”。作为“百+数据集作者”,会被邀请进入千言学术委员会。千言会帮助数据集作者发布评测,并提供飞桨开源基线、评测平台和GPU算力的支持,提升数据集的影响力,推动技术的发展。“百+技术专家”则是针对优秀开发者和学生的认证,技术专家可以得到大量分享和交流技术方案的机会,并会受邀参与官方活动。 中文是千年华夏文明传承的载体,是中华民族的骄傲和根基。在当下的人工智能时代,“千言”数据开源项目也希望与学术界、产业界携手,共同推动中文信息处理技术的进步,理解语言、拥有智能,改变世界,将华夏文明的宝藏学习并传承下去。 点击进入获得更多技术信息~~

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册