首页 文章 精选 留言 我的

精选列表

搜索[智能体平台],共10000篇文章
优秀的个人博客,低调大师

《中国人工智能学会通讯》——3.6 跨网络链接预测的研究

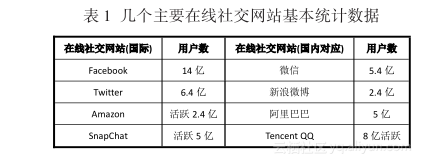
3.6 跨网络链接预测的研究 在线社交网络已取得飞速发展,众多网站,如Facebook(脸书)、Twitter 以及国内的新浪微博、人人网、腾讯网等迅速崛起。其中,Facebook 的用户数已经达到14亿,成为世界人口最多的“国家”,这些用户每月花在 Facebook 上的时间超过 6.4 亿分钟;Twitter 用户数也达到 6.4 亿。微信和微博是国内在线社交网络的两个代表,用户数也分别达到5.4 亿和 2.4 亿;阿里巴巴在双 11 节创下 24 小时912 亿元的成交额(见表 1)。 表 1 几个主要在线社交网站基本统计数据所有这些数据显示,在线社交网络已经成为网络信息空间和人类物理世界连接不可或缺的桥梁。在线社交网络发展的另一特点是百花齐放,这里1列出了近 400 个比较活跃的社交系统,用户分布在不同社交网络中,同时为了满足不同需求在不同社交网络中分别注册不同账号。一个初步统计表明,用户平均加入的社交网络数量是 8。针对美国用户的统计分析2表明,近 2/3 的美国成人使用如Facebook、Twitter、MySpace 或者 LinkedIn 等社交网络来和朋友、家人以及商业伙伴保持联络。从研究的角度,这一方面为研究提供了海量数据;另一方面由于用户数据分布异构在不同的社交网络,这也为研究带来很多新的挑战。其中一个技术挑战是,我们能设计一个方法将不同社交网络自动链接起来吗?该问题即跨网络链接集成(预测) [1] 。 跨网络链接预测事实上带来很多针对传统研究问题的思考。例如信息抽取,这是 Web 挖掘、自然语言处理、模式识别等多个领域的一个核心问题。传统的研究思路一般是首先找到目标页面,然后从其中抽取相关信息,如图 1(a) 所示,如果需要抽取Jeannette Wing 博士的个人信息,可以首先找到她的个人主页,然后从其中抽取职位、联系信息、教育经历等信息。然而在线社交网络的快速发展带来三个改变,第一个改变是这些语义信息更加异构且分布在不同数据源;第二个改变是信息更加结构化,很多信息在某些数据源可能是无结构,但在另一些数据源却已经是结构化的数据;第三个改变则是不同数据源数据的时效性不同。从跨网络链接预测的角度来看,获取信息的主要办法不再是单纯的抽取,而更重要的是如何自动链接不同数据源,并从其中识别哪些语义数据是有效的。例如 Talent 系统通过整合散落在多个网络的用户信息,为雇主提供了更全面的用户画像[2] 。图 1(b) 从网络的角度给出异构网络链接的示例,这表明在跨网络链接预测中,不仅需要考虑数据本身,还需要考虑网络拓扑结构,以及多个网络之间的一致性问题。 跨网络链接和传统单网络中的链接预测不同,链接预测是社交关系挖掘研究领域的一个重要研究课题,多年来受到多个领域的广泛关注。但目前大部分链接预测的研究对象是单一网络,主要预测和推荐单个网络中未知的链接,研究新链接的形成机理,讨论链接预测的方法、模型和应用。以手机通讯网络为例,在单个通讯网络内部可以预测用户和用户之间通信链接的建立;而跨网络链接预测,则可以通过某运营商内部用户的通信关系和部分与其他运营商用户的通信关系,成功地预测其竞争对手80% 以上的用户通信关系[3] 。通过主题模型,实现专利与产品的匹配,以及中英文 Wiki 页面匹配。对比传统方法,两个应用中分别可以提高 19.8% 及7.1% 的实体匹配准确率[4] 。 本文将从问题描述、主要方法和未来展望几个方面简要介绍跨网络链接预测问题的研究。

优秀的个人博客,低调大师

《中国人工智能学会通讯》——11.14 三维人脸识别算法

11.14 三维人脸识别算法 三维人脸识别由于其类内差距大而类间差距小,且易受表情变化等非刚性形变影响等特点,一直是一个富有挑战的模式识别问题[5] 。此外,三维人脸识别还易受头发遮挡,以及数据缺失等因素的影响。通过分析发现,虽然表情变化会改变人脸的三维形状,但人脸的局部形状信息依然能保持较好的稳定性。因此,采用局部特征匹配的方式可以有效地降低表情变化对人脸识别带来的负面影响。基于此,本文提出了一种基于 RoPS 局部特征的三维人脸识别算法[9] 。该算法首先采用鼻尖检测获得人脸点云;接着对三维人脸进行平滑补洞等预处理;进而在人脸上检测一系列具有较强类属关联性的关键点 ( 如图 10所示 ),这些关键点在不同个体人脸上的分布存在较大差异,但在同一个个体不同表情人脸上的分布较为相似。在此基础上,通过局部特征匹配与点云配准实现对三维人脸的融合识别 ( 如图 11 所示 )。在 FRGC v2 标准数据集上的测试结果 ( 见表 1)表明,本文算法获得了非常高的识别率和对表情变化的稳健性。该算法的贡献在于两方面,一方面,采用局部特征有效降低了表情变化对人脸识别的不利影响;另一方面,综合利用人脸局部和全局信息,采用特征匹配和点云配准实现融合识别,进一步提高了识别算法的精度。

优秀的个人博客,低调大师

《中国人工智能学会通讯》——4.39 什么是深度强化学习?

4.39 什么是深度强化学习? 现在街头巷尾都在谈论的机器学习,其实是一个非常宽泛的概念,而其中最酷的分支要算是深度学 习(Deeplearning) 和 强 化 学 习(Reinforcementlearning)了。谷歌的 DeepMind 就是将深度学习和强化学习这两者的精髓合二为一,提出了深度强化学习。在 2014 年的时候,这个团队就在《Nature》杂志上发表了题为《Human-level control through deepreinforcement learning》的论文,让业界对此充满了期待。 深度学习起源于 2006 年,这要感谢机器学习领域的泰斗 Geoffrey Hinton 先生,是他在《Science》上的一篇著名论文开启了深度学习的浪潮。Geoffrey Hinton先生是个非常勤奋的学者,老人家腰椎不是太好,写个代码都得站着,而且还无法坐飞机,正所谓,伟大的人总要有伟大的付出,在此,向他致敬! 深度学习是一种机器学习中建模数据的隐含分布的多层表达的算法。换句话来说,深度学习算法自动提取分类中所需要的低层次或者高层次特征,因此深度学习能够更好的表示数据的特征;同时由于模型的层次、参数很多,容量也足够,因此深度学习模型有能力表示大规模数据。所以对于图像、语音这种特征不明显的棘手问题,反而能够借助深度学习在大规模训练数据上取得更好的效果。而且由于深度学习将特征和分类器结合到一个框架中,用数据去学习特征,在使用中减少了手工提取特征的巨大工作量,因此不仅仅效果可以更好,而且应用起来也非常方便。因此深度学习在图像识别和语音识别方面获得了巨大的进步。 强化学习,其实,就是一个连续决策的过程,其特点是不给任何数据做标注,仅仅提供一个回报函数,这个回报函数决定当前状态得到什么样的结果(比如“好”还是“坏”),从数学本质上来看,还是一个马尔科夫决策过程。强化学习最终目的是让决策过程中整体的回报函数期望最优。 通过所谓的类似于人脑网状结构的神经网络,深度学习是可以解决很多很实际的问题。例如谷歌的图像搜索、Facebook 的人脸识别、Skype 的实时翻译,以及 Twitter 的色情语言识别。强化学习则将深度学习又往前推进了一步,一旦你建立起了一个玩游戏的深度学习网络,你可以通过强化学习,让它和自己进行比赛,自我进化。

优秀的个人博客,低调大师

《中国人工智能学会通讯》——11.53 合成人脸画像质量评价

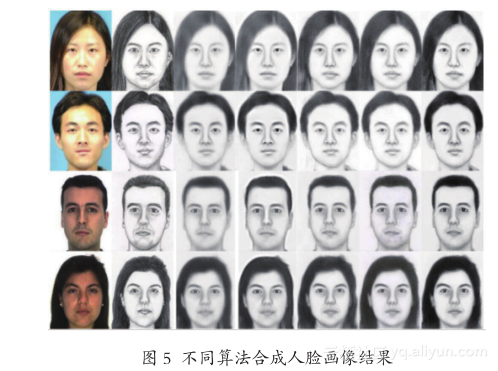
11.53 合成人脸画像质量评价 下面对以上三章中提到的基于稀疏近邻选择方法(SFS, Sparse Feature Selection)、基于人脸幻 象 思 想 的 合 成 方 法(SFS-SVR, Sparse FeatureSelection & Support Vector Regression) 和 基 于 直推式学习的方法(TFSS, Transductive Face SketchSynthesis)三种算法,以及基于位置的人脸画像合成方法 (PFSS, Position based Face Sketch Synthesis)[15]和基于马尔科夫权重场的方法 (MWF, MarkovWeight Field) [7] 进行质量评价。用这五种算法在CUHK 学生画像数据库[6]和 AR 画像数据库[16]上进行合成实验,每种算法生成 223 张画像(CUHK学生数据库 100 张,AR 数据库 123 张),算法部分合成结果示于图 5 中。图中,第一列为数据库中照片;第二列为画家手绘真实画像;第三列至最后一列分别为 SFS 方法、SFS-SVR 方法、PFSS 方法、MWF 方法及 TFSS 方法。这里采用的主观评价算法是两两成对比较。由于进行评价的目的是评价合成算法合成的效果,因而进行成对比较时,只需要比较对应于数据库中同一人的 5 种算法生成的画像的质量,即成对比较的内容是“相同”的(这里的内容相同指他们都属于同一个人的合成画像)。评价合成画像质量时,一般从两个方面来评价。① 合成的画像跟输入照片像不像;② 合成的画像纹理好不好。后台打分的规则是:画像 A 比画像 B 质量高,则 A 画像得 2 分,反之 B 得 2 分。如果无法判定(即不确定两者质量孰好孰坏)则两者均得 1 分。故每幅画像最高得分为 8 分(与其余四种算法合成的对应身份的画像质量相比,均判断为更好),最低得分为 0 分(其余四种算法合成的对应身份的画像质量与之相比均判断为更好)。实验中共邀请 16 位测评者进行测评,这些测评者来自各行各业,有工程师、学生、工人和老师等。 图 6 示出了主观质量评价的一种统计展示,其中,横轴为评价分数取值范围为 0~8 分;纵轴为百分比,表示某个合成算法合成的画像质量评价分数,大于横轴对应的分数的画像占该算法合成画像总数(本数据库中为 223)的百分比。该百分比越大,说明对应算法取得大于某分数的合成画像数量越多。从图中可以看出,TFSS 方法取得效果最佳。从图 6 中可以看出,基于直推式学习的合成方法 TFSS 总体评价值最高,基于马尔科夫权重场的合成方法 MWF 与基于位置的合成方法 PFSS 在大于 3 分小于 6 分的区间内领先于 SFS 和 SFS-SVR。但在小于 3 分的区间内,SFS-SVR 领先于除 TFSS之外的所有方法。由于模糊的原因,SFS 方法在五个合成算法中合成效果最差。这里需要注意的是由于主观评价做的是成对比较,比较的是算法,故这里 SFS 合成效果差只是相对于其他四种算法,并不是绝对的。SFS-SVR 方法大于所有的合成图像都大于 1 分,大于 2 分的占 99.5% ,说明仅有一张图像小于 2 分,且该图像得分大于 1 分。所有方法最终得到的平均质量评价分数没有等于 8 分(本系统中质量评价值最高位 8 分)的,说明没有一张合成画像是所有测评者认为其质量均优于其他四种算法合成效果的。 此外,我们还进行了基于上面五种算法合成的画像的人脸识别实验。由于本文的重点是异质人脸图像合成,人脸识别是提出的合成算法的下游应用之一,因此这里不再深究具体的人脸识别算法,而采用最常用的 3 个人脸识别算法,即 Eigenface[17] 、Fisherface [18]和 NLDA (Null-space LinearDiscriminant Analyisis) [19] 。XM2VTS 数据库[20]中的 195 对画像和照片作为训练人脸识别算法的数据集。表 1 给出了基于 5 种方法合成的人脸画像的最高识别率 , 以及对应的特征维数 ( 括号中的数字 )。从表 1 中可以看出,SFS 方法和 SFS-SVR 合成方法在使用 Fisherface 和 NLDA 识别方法时,能够在特征维数很低的情况下取得最高的准确率,维数越低,运算量越低,实时性越高。Fisherface 和 NLDA方法是监督学习方法,而 Eigenface 是无监督方法,故 Fisherface 和 NLDA 的人脸识别准确率明显高于Eigenface 方法。结合前面图 6 中给出的主观质量评价结果可以看出,并不是主观评价质量越高的图像越适合计算机进行人脸识别。人们评价图像时会被细节信息吸引,而这些细节信息有时并不一定适合于计算机进行识别,对于计算机而言,这些细节信息可能是“噪声”。现有的识别方法更多的是基于统计的一些信息来进行识别,而不是细节的一些信息,故而在主观评价质量值最低的两个方法 (SFS 和SFS-SVR) 反而能取得最高的人来识别准确率。

优秀的个人博客,低调大师

《中国人工智能学会通讯》——6.7 实体链接任务及系统

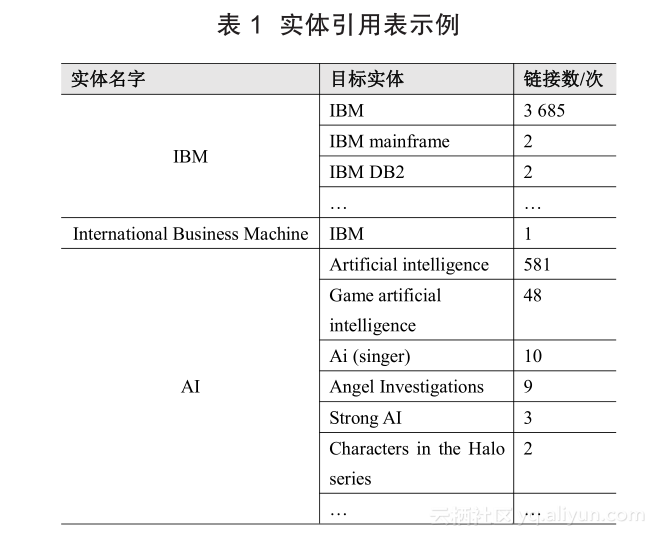
6.7 实体链接任务及系统 给定一段文本(如“在旧金山的发布会上,苹果为开发者推出新编程语言 Swift”),一个实体链接系统需要通过如下多个子任务来实现实体消歧 [4] 。 1 . 识别文档中的实体提及 (mention)。这里的提及指的是我们想要链接的对象,如上面例子文本中的提及 {“旧金山”,“苹果”,“Swift”}。 2 . 针对每一个提及,识别该提及在知识图谱中可能指向的候选目标实体。例如,上述文本中的提及“苹果”可能指向的目标实体包括 { 苹果 ( 水果 ),苹果公司,苹果 ( 电影 ),苹果 ( 银行 ), …}。 3 . 基于提及的上下文等信息对目标实体进行排序。例如,系统需要根据“苹果”的上下文词语{发布会,编程语言,开发者,…}识别出该段文本中“苹果”指的是苹果公司,而不是苹果 ( 水果 ) 或者苹果 ( 电影 )。 4 . 空提及检测与聚类。人类知识具有海量规模,同时随时间快速更新,因此知识图谱不可能覆盖所有的真实世界实体。在这种情况下,需要识别出知识库尚未包含其目标实体的提及,并将这些提及按其指向的真实世界实体进行聚类。例如,由于现有知识库没有包含上文中提及“Swift”指向的目标实体 Swift(编程语言),实体链接系统需要将“Swift”的目标实体设置为空实体 NIL,表示该提及在知识库中没有链接对象。 针对上述子任务,近年来的相关研究、技术和资源介绍如下。 提及识别。提及识别的目标是识别文本中需要链接的提及。目前提及识别主要采用两种技术,一是使用通用命名实体识别技术(例如 StanfordNER * 工具)来识别文本中的人名、地名和机构名,并将这些实体名作为待链接的对象;二是使用词典匹配技术,首先构建实体名字的列表,并在文本中匹配这些实体名字的出现来识别待链接提及。上述两项技术各有优缺点。命名实体识别技术保证了识别出的提及是完整的实体名,但是通常只能覆盖有限的实体类别,无法识别用户可能感兴趣的其他实体类别(如电影名、音乐名、书名等)。词典匹配技术能够覆盖大部分待链接的实体类别,但是其性能依赖于特定资源(也就是实体名字列表)的质量;同时由于有些类别的实体名包含了很多常用词(例如,在维基百科中 IS、A 等都是实体名字),上述词典匹配方法会引入大量的噪音;最后,基于词典的匹配没有考虑提及在句子中的语法约束,无法保证匹配的提及符合语法边界。 为解决上述问题,目前实体链接系统通常采用混合策略来完成提及识别:首先使用命名实体识别方法和词典匹配方法识别所有可能的提及候选;然后过滤掉统计意义上非显著的或不符合语法边界的提及候选。 候选目标实体识别。候选目标实体识别的目标是找到每一个提及可能指向的所有目标实体集合,例如找到提及“苹果”可能指向的目标实体集合 { 苹果 ( 水果 ),苹果公司,苹果 ( 电影 ),苹果( 银行 ),…}。目前,实体链接系统主要通过查阅实体引用表(Reference Table)来完成上述任务。表 1 中展示了一个引用表的示例,表中记录了每个实体名可能指向的目标实体(如 AI 的目标实体包括 Artificial Intelligence、歌手 Ai 等)及一些相关的统计数据(例如 AI 在维基百科中被链接到实体Artificial Intelligence 的次数)。 给定实体引用表,实体链接系统可以通过查阅实体名来找到其候选目标实体。显而易见,实体引用表的质量极大影响了实体链接系统的性能。目前,大部分的实体引用表通过挖掘维基百科锚文本(Wikipedia Anchor Text)的方式来构建[5] 。同时,为了进一步保证候选目标实体的覆盖度,名字扩展技术(如缩写名的扩展)[6]和错误拼写校正技术(如基于机器翻译的错误拼写校正)也被广泛使用。 实体排歧。实体排歧是实体链接的核心,也是实体链接的难点所在。给定一段文本、该段文本中的待链接提及集合及目标知识库,实体排歧的目标是确定每一个提及所指向的目标实体。下面展示了一个实体排歧任务的例子。 实体排歧的关键在于挖掘可用于识别提及目标实体的证据信息,将这些证据表示为供计算机处理的形式,并构建高性能的算法来综合不同证据进行链接决策。在当前研究中,实体排歧使用的主要证据信息可归纳为如下几类。 实体知名度。实体知名度指一个实体被人们了解的程度。通常情况下一个高知名度的实体更可能被一篇文章提到。例如,一篇新闻中提到“苹果”时,通常指的是水果苹果或者苹果公司,而不是电影苹果或者苹果银行,因为前两者在普通人中的知名度更高。一个实体 e 的知名度通常表示为该实体出现的先验概率 P(e)。 名字常用性。名字常用性指的是一个名字被用作特定实体名字的概率。例如虽然 IBM、Big Blue和 International Business Machine 都是 IBM 公司的名字,但是人们通常更倾向于使用名字 IBM,而只在特定情况下使用后面两个名字。名字常用性通常被表示为一个实体 e 使用一个名字 s 的条件概率P(s|e)。 上下文词语分布。上下文词语分布建模了特定实体周围词出现的规律性。图 2 展示了苹果公司和苹果银行的上下文词分布,可以看出上下文词分布为特定实体的出现提供了显著证据:苹果公司周围主要出现的词是 { 乔布斯,iPhone,公司,Mac,…},苹果银行周围主要出现的词是 { 银行,存款,纽约,…},两者之间具有明显差异。 实体之间的关联度。一篇文章中出现的实体并非毫无关系,而是通常具有一定程度的语义关联。因此,一个提及的目标实体应当与文章中其他提及的目标实体之间存在语义关联。例如,出现了实体“乔布斯”和“提姆库克”的文章中往往更有可能出现苹果公司;而出现了范冰冰的文章中则更有可能出现电影苹果。 文章主题。实体的出现往往与文章主题密切相关,因此文章的主题会为实体的出现提供重要证据。例如,在通用新闻中水果苹果的出现概率最高;在IT 新闻中苹果公司的出现概率会高于水果苹果;在娱乐新闻中则出现电影苹果的概率会高于水果苹果和苹果公司。 基于上述实体排歧证据,实体排歧算法的主要工作是如何综合多个证据为每个(提及,候选实体)对进行打分。然后对每个提及 m,选择具有最高打分的(m,候选实体)的候选实体作为m的目标实体。目前,实体排歧算法可以分为两类,分别是局部推理算法和全局推理算法。 ● 局部推理算法。局部推理算法认为提及之间相互独立,因此不考虑提及之间的相互关系,而只针对每个提及进行单独推断。例如,局部推理算法将例子 1 中三个提及 {m 1 = 旧金山 , m 2 = 苹果 ,m 3 = Swift} 的排歧看成三个相互独立的任务。目前,局部推理算法可以分为基于分类的算法[5-7]和基于生成模型的算法[8] 。基于分类的算法将每一个(提及,候选实体)表示为一个特征向量;然后通过分类器来综合所有特征信息,并使用分类器的打分来判断(提及,候选实体)是否是一个正确的链接决策。与基于分类的方法不同,基于生成模型的算法通过建模文档或实体提及的生成过程,并基于该生成过程计算特定上下文 c 中提及 m 指向实体 e 的后验概率 P(e|c,m) 来进行实体链接决策。 ● 全局推理算法。与局部推理算法不同,全局推理算法不仅仅考虑提及和其候选目标实体之间的打分,也考虑不同实体排歧决策之间存在的依赖关系(例如,同一篇文章中提及的目标实体必须语义相关)。目前,全局推理算法通常可以分为基于特定全局目标函数优化的方法[9] 、基于图的协同推理算法[10]和基于 Topic Model 的算法[11-12] 。 空实体检测与聚类。空实体检测与聚类仍然是实体链接的一个难点问题,同时也极大地影响实体链接系统性能。如在 KBP 2009 的实体链接数据集中,67.5%提及的目标实体在知识库中没有覆盖。目前大部分实体链接系统采用两种方法解决空实体检测问题,一是构建一个专门的空实体检测分类器;二是在知识库中加入一个伪实体 NIL,并通过对比(提及,NIL)的打分和提及与其他目标实体之间的打分检测该提及是否需要链接到 NIL 实体。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册