首页 文章 精选 留言 我的

精选列表

搜索[动态代码分析],共10000篇文章
优秀的个人博客,低调大师

java B2B2C电子商务平台分析之十四-----注册中心 Consul

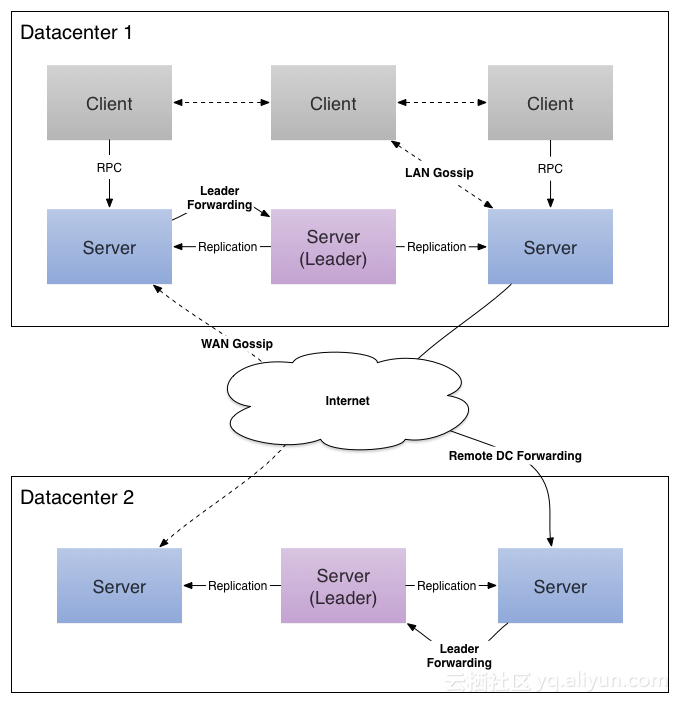
Consul 介绍Consul 是 HashiCorp 公司推出的开源工具,用于实现分布式系统的服务发现与配置。与其它分布式服务注册与发现的方案,Consul 的方案更“一站式”,内置了服务注册与发现框 架、分布一致性协议实现、健康检查、Key/Value 存储、多数据中心方案,不再需要依赖其它工具(比如 ZooKeeper 等)。使用起来也较 为简单。Consul 使用 Go 语言编写,因此具有天然可移植性(支持Linux、windows和Mac OS X);安装包仅包含一个可执行文件,方便部署,与 Docker 等轻量级容器可无缝配合。愿意了解源码的朋友直接求求交流分享技术:二一四七七七五六三三 Consul 的优势: 使用 Raft 算法来保证一致性, 比复杂的 Paxos 算法更直接. 相比较而言, zookeeper 采用的是 Paxos, 而 etcd 使用的则是 Raft。支持多数据中心,内外网的服务采用不同的端口进行监听。 多数据中心集群可以避免单数据中心的单点故障,而其部署则需要考虑网络延迟, 分片等情况等。 zookeeper 和 etcd 均不提供多数据中心功能的支持。支持健康检查。 etcd 不提供此功能。支持 http 和 dns 协议接口。 zookeeper 的集成较为复杂, etcd 只支持 http 协议。官方提供 web 管理界面, etcd 无此功能。综合比较, Consul 作为服务注册和配置管理的新星, 比较值得关注和研究。特性: 服务发现健康检查Key/Value 存储多数据中心Consul 角色 client: 客户端, 无状态, 将 HTTP 和 DNS 接口请求转发给局域网内的服务端集群。server: 服务端, 保存配置信息, 高可用集群, 在局域网内与本地客户端通讯, 通过广域网与其它数据中心通讯。 每个数据中心的 server 数量推荐为 3 个或是 5 个。Consul 客户端、服务端还支持夸中心的使用,更加提高了它的高可用性。 Consul 工作原理: 1、当 Producer 启动的时候,会向 Consul 发送一个 post 请求,告诉 Consul 自己的 IP 和 Port2、Consul 接收到 Producer 的注册后,每隔10s(默认)会向 Producer 发送一个健康检查的请求,检验Producer是否健康3、当 Consumer 发送 GET 方式请求 /api/address 到 Producer 时,会先从 Consul 中拿到一个存储服务 IP 和 Port 的临时表,从表中拿到 Producer 的 IP 和 Port 后再发送 GET 方式请求 /api/address4、该临时表每隔10s会更新,只包含有通过了健康检查的 ProducerSpring Cloud Consul 项目是针对 Consul 的服务治理实现。Consul 是一个分布式高可用的系统,它包含多个组件,但是作为一个整体,在微服务架构中为我们的基础设施提供服务发现和服务配置的工具。 技术架构图如下: 资料和源码来源

优秀的个人博客,低调大师

[雪峰磁针石博客]数据分析工具pandas快速入门教程5-处理缺失数据

第5章 缺失数据 介绍 很少没有任何缺失值的数据集。 有许多缺失数据的表示。 在数据库中是NULL值,一些编程语言使用NA。缺失值可以是空字符串:''或者甚至是数值88或99等。Pandas显示缺失值为NaN。 本章将涵盖: 什么是缺失值 如何创建缺失值 如何重新编码并使用缺失值进行计算 什么是缺失值 可以从numpy中获得NaN值,在Python中看到缺失值使用几种方式显示:NaN,NAN或nan,他们都是相等的。 NaN不等于0或空字符串''。 In [1]: from numpy import NaN, NAN, nan In [2]: print(NaN == True, NaN == False, NaN == 0, NaN == '', sep='|') False|False|False|False In [3]: print(NaN == NaN, NaN == nan, NaN == NAN, nan == NAN, sep='|') False|False|False|False In [4]: import pandas as pd In [5]: print(pd.isnull(NaN), pd.isnull(nan), pd.isnull(NAN), sep='|') True|True|True In [6]: print(pd.notnull(NaN), pd.notnull(99), pd.notnull("https://china-testing.github.io"), sep='|') False|True|True 缺失值的来源 来自加载数据或数据处理 加载数据 当我们加载数据时,pandas会自动找到该缺少数据的单元格,并填充NaN值。在read_csv函数中,参数na_values, keep_default_na, na_filter用于处理缺失值。比如:na_values=[99]。na_filter设置为False,在读大文件时会提升性能。 5-1.py import pandas as pd visited_file = 'data/survey_visited.csv' print(pd.read_csv(visited_file)) print(pd.read_csv(visited_file, keep_default_na=False)) print(pd.read_csv(visited_file, na_values=[''], keep_default_na=False)) 执行结果 $ python3 5-1.py ident site dated 0 619 DR-1 1927-02-08 1 622 DR-1 1927-02-10 2 734 DR-3 1939-01-07 3 735 DR-3 1930-01-12 4 751 DR-3 1930-02-26 5 752 DR-3 NaN 6 837 MSK-4 1932-01-14 7 844 DR-1 1932-03-22 ident site dated 0 619 DR-1 1927-02-08 1 622 DR-1 1927-02-10 2 734 DR-3 1939-01-07 3 735 DR-3 1930-01-12 4 751 DR-3 1930-02-26 5 752 DR-3 6 837 MSK-4 1932-01-14 7 844 DR-1 1932-03-22 ident site dated 0 619 DR-1 1927-02-08 1 622 DR-1 1927-02-10 2 734 DR-3 1939-01-07 3 735 DR-3 1930-01-12 4 751 DR-3 1930-02-26 5 752 DR-3 NaN 6 837 MSK-4 1932-01-14 7 844 DR-1 1932-03-22 合并数据 import pandas as pd visited = pd.read_csv('data/survey_visited.csv') survey = pd.read_csv('data/survey_survey.csv') print(visited) print(survey) vs = visited.merge(survey, left_on='ident', right_on='taken') print(vs) 执行结果 $ python3 5-2.py ident site dated 0 619 DR-1 1927-02-08 1 622 DR-1 1927-02-10 2 734 DR-3 1939-01-07 3 735 DR-3 1930-01-12 4 751 DR-3 1930-02-26 5 752 DR-3 NaN 6 837 MSK-4 1932-01-14 7 844 DR-1 1932-03-22 taken person quant reading 0 619 dyer rad 9.82 1 619 dyer sal 0.13 2 622 dyer rad 7.80 3 622 dyer sal 0.09 4 734 pb rad 8.41 5 734 lake sal 0.05 6 734 pb temp -21.50 7 735 pb rad 7.22 8 735 NaN sal 0.06 9 735 NaN temp -26.00 10 751 pb rad 4.35 11 751 pb temp -18.50 12 751 lake sal 0.10 13 752 lake rad 2.19 14 752 lake sal 0.09 15 752 lake temp -16.00 16 752 roe sal 41.60 17 837 lake rad 1.46 18 837 lake sal 0.21 19 837 roe sal 22.50 20 844 roe rad 11.25 ident site dated taken person quant reading 0 619 DR-1 1927-02-08 619 dyer rad 9.82 1 619 DR-1 1927-02-08 619 dyer sal 0.13 2 622 DR-1 1927-02-10 622 dyer rad 7.80 3 622 DR-1 1927-02-10 622 dyer sal 0.09 4 734 DR-3 1939-01-07 734 pb rad 8.41 5 734 DR-3 1939-01-07 734 lake sal 0.05 6 734 DR-3 1939-01-07 734 pb temp -21.50 7 735 DR-3 1930-01-12 735 pb rad 7.22 8 735 DR-3 1930-01-12 735 NaN sal 0.06 9 735 DR-3 1930-01-12 735 NaN temp -26.00 10 751 DR-3 1930-02-26 751 pb rad 4.35 11 751 DR-3 1930-02-26 751 pb temp -18.50 12 751 DR-3 1930-02-26 751 lake sal 0.10 13 752 DR-3 NaN 752 lake rad 2.19 14 752 DR-3 NaN 752 lake sal 0.09 15 752 DR-3 NaN 752 lake temp -16.00 16 752 DR-3 NaN 752 roe sal 41.60 17 837 MSK-4 1932-01-14 837 lake rad 1.46 18 837 MSK-4 1932-01-14 837 lake sal 0.21 19 837 MSK-4 1932-01-14 837 roe sal 22.50 20 844 DR-1 1932-03-22 844 roe rad 11.25 用户输入 import pandas as pd from numpy import NaN, NAN, nan num_legs = pd.Series({'goat': 4, 'amoeba': nan}) print(num_legs) scientists = pd.DataFrame({'Name': ['Rosaline Franklin', 'William Gosset'], 'Occupation': ['Chemist', 'Statistician'], 'Born': ['1920-07-25', '1876-06-13'], 'Died': ['1958-04-16', '1937-10-16'], 'missing': [NaN, nan]}) print(scientists) scientists['missing'] = nan print(scientists) 执行结果 $ python3 5-3.py amoeba NaN goat 4.0 dtype: float64 Born Died Name Occupation missing 0 1920-07-25 1958-04-16 Rosaline Franklin Chemist NaN 1 1876-06-13 1937-10-16 William Gosset Statistician NaN Born Died Name Occupation missing 0 1920-07-25 1958-04-16 Rosaline Franklin Chemist NaN 1 1876-06-13 1937-10-16 William Gosset Statistician NaN 重新索引 5-4.py import pandas as pd from numpy import NaN, NAN, nan gapminder = pd.read_csv('data/gapminder.tsv', sep='\t') life_exp = gapminder.groupby(['year'])['lifeExp'].mean() print(life_exp) print(life_exp.reindex(range(2000, 2010))) 执行结果 year 1952 49.057620 1957 51.507401 1962 53.609249 1967 55.678290 1972 57.647386 1977 59.570157 1982 61.533197 1987 63.212613 1992 64.160338 1997 65.014676 2002 65.694923 2007 67.007423 Name: lifeExp, dtype: float64 year 2000 NaN 2001 NaN 2002 65.694923 2003 NaN 2004 NaN 2005 NaN 2006 NaN 2007 67.007423 2008 NaN 2009 NaN Name: lifeExp, dtype: float64 处理缺失数据 统计缺失数据 5-5.py import pandas as pd from numpy import NaN, NAN, nan import numpy as np ebola = pd.read_csv('data/country_timeseries.csv') print(ebola.head()) print(ebola.count()) num_rows = ebola.shape[0] print("num_rows") print(num_rows) num_missing = num_rows - ebola.count() print("num_missing:") print(num_missing) print(np.count_nonzero(ebola.isnull())) print(np.count_nonzero(ebola['Cases_Guinea'].isnull())) print(ebola.Cases_Guinea.value_counts(dropna=False).head()) 执行结果 Date Day Cases_Guinea Cases_Liberia Cases_SierraLeone \ 0 1/5/2015 289 2776.0 NaN 10030.0 1 1/4/2015 288 2775.0 NaN 9780.0 2 1/3/2015 287 2769.0 8166.0 9722.0 3 1/2/2015 286 NaN 8157.0 NaN 4 12/31/2014 284 2730.0 8115.0 9633.0 Cases_Nigeria Cases_Senegal Cases_UnitedStates Cases_Spain Cases_Mali \ 0 NaN NaN NaN NaN NaN 1 NaN NaN NaN NaN NaN 2 NaN NaN NaN NaN NaN 3 NaN NaN NaN NaN NaN 4 NaN NaN NaN NaN NaN Deaths_Guinea Deaths_Liberia Deaths_SierraLeone Deaths_Nigeria \ 0 1786.0 NaN 2977.0 NaN 1 1781.0 NaN 2943.0 NaN 2 1767.0 3496.0 2915.0 NaN 3 NaN 3496.0 NaN NaN 4 1739.0 3471.0 2827.0 NaN Deaths_Senegal Deaths_UnitedStates Deaths_Spain Deaths_Mali 0 NaN NaN NaN NaN 1 NaN NaN NaN NaN 2 NaN NaN NaN NaN 3 NaN NaN NaN NaN 4 NaN NaN NaN NaN Date 122 Day 122 Cases_Guinea 93 Cases_Liberia 83 Cases_SierraLeone 87 Cases_Nigeria 38 Cases_Senegal 25 Cases_UnitedStates 18 Cases_Spain 16 Cases_Mali 12 Deaths_Guinea 92 Deaths_Liberia 81 Deaths_SierraLeone 87 Deaths_Nigeria 38 Deaths_Senegal 22 Deaths_UnitedStates 18 Deaths_Spain 16 Deaths_Mali 12 dtype: int64 num_rows 122 num_missing: Date 0 Day 0 Cases_Guinea 29 Cases_Liberia 39 Cases_SierraLeone 35 Cases_Nigeria 84 Cases_Senegal 97 Cases_UnitedStates 104 Cases_Spain 106 Cases_Mali 110 Deaths_Guinea 30 Deaths_Liberia 41 Deaths_SierraLeone 35 Deaths_Nigeria 84 Deaths_Senegal 100 Deaths_UnitedStates 104 Deaths_Spain 106 Deaths_Mali 110 dtype: int64 1214 29 NaN 29 86.0 3 495.0 2 112.0 2 390.0 2 Name: Cases_Guinea, dtype: int64 处理缺失数据 5-6.py import pandas as pd from numpy import NaN, NAN, nan import numpy as np ebola = pd.read_csv('data/country_timeseries.csv') print(ebola.iloc[0:10, 0:5]) print(ebola.fillna(0).iloc[0:10, 0:5]) # 前向填充 print(ebola.fillna(method='ffill').iloc[0:10, 0:5]) # 后向填充 print(ebola.fillna(method='bfill').iloc[0:10, 0:5]) print(ebola.interpolate().iloc[0:10, 0:5]) print(ebola.shape) ebola_dropna = ebola.dropna() print(ebola_dropna.shape) print(ebola_dropna) ebola['Cases_multiple'] = ebola['Cases_Guinea'] + ebola['Cases_Liberia'] + \ ebola['Cases_SierraLeone'] ebola_subset = ebola.loc[:, ['Cases_Guinea', 'Cases_Liberia', 'Cases_SierraLeone', 'Cases_multiple']] print(ebola_subset.head(n=10)) print(ebola.Cases_Guinea.sum(skipna = True)) print(ebola.Cases_Guinea.sum(skipna = False)) 执行结果 Date Day Cases_Guinea Cases_Liberia Cases_SierraLeone 0 1/5/2015 289 2776.0 NaN 10030.0 1 1/4/2015 288 2775.0 NaN 9780.0 2 1/3/2015 287 2769.0 8166.0 9722.0 3 1/2/2015 286 NaN 8157.0 NaN 4 12/31/2014 284 2730.0 8115.0 9633.0 5 12/28/2014 281 2706.0 8018.0 9446.0 6 12/27/2014 280 2695.0 NaN 9409.0 7 12/24/2014 277 2630.0 7977.0 9203.0 8 12/21/2014 273 2597.0 NaN 9004.0 9 12/20/2014 272 2571.0 7862.0 8939.0 Date Day Cases_Guinea Cases_Liberia Cases_SierraLeone 0 1/5/2015 289 2776.0 0.0 10030.0 1 1/4/2015 288 2775.0 0.0 9780.0 2 1/3/2015 287 2769.0 8166.0 9722.0 3 1/2/2015 286 0.0 8157.0 0.0 4 12/31/2014 284 2730.0 8115.0 9633.0 5 12/28/2014 281 2706.0 8018.0 9446.0 6 12/27/2014 280 2695.0 0.0 9409.0 7 12/24/2014 277 2630.0 7977.0 9203.0 8 12/21/2014 273 2597.0 0.0 9004.0 9 12/20/2014 272 2571.0 7862.0 8939.0 Date Day Cases_Guinea Cases_Liberia Cases_SierraLeone 0 1/5/2015 289 2776.0 NaN 10030.0 1 1/4/2015 288 2775.0 NaN 9780.0 2 1/3/2015 287 2769.0 8166.0 9722.0 3 1/2/2015 286 2769.0 8157.0 9722.0 4 12/31/2014 284 2730.0 8115.0 9633.0 5 12/28/2014 281 2706.0 8018.0 9446.0 6 12/27/2014 280 2695.0 8018.0 9409.0 7 12/24/2014 277 2630.0 7977.0 9203.0 8 12/21/2014 273 2597.0 7977.0 9004.0 9 12/20/2014 272 2571.0 7862.0 8939.0 Date Day Cases_Guinea Cases_Liberia Cases_SierraLeone 0 1/5/2015 289 2776.0 8166.0 10030.0 1 1/4/2015 288 2775.0 8166.0 9780.0 2 1/3/2015 287 2769.0 8166.0 9722.0 3 1/2/2015 286 2730.0 8157.0 9633.0 4 12/31/2014 284 2730.0 8115.0 9633.0 5 12/28/2014 281 2706.0 8018.0 9446.0 6 12/27/2014 280 2695.0 7977.0 9409.0 7 12/24/2014 277 2630.0 7977.0 9203.0 8 12/21/2014 273 2597.0 7862.0 9004.0 9 12/20/2014 272 2571.0 7862.0 8939.0 Date Day Cases_Guinea Cases_Liberia Cases_SierraLeone 0 1/5/2015 289 2776.0 NaN 10030.0 1 1/4/2015 288 2775.0 NaN 9780.0 2 1/3/2015 287 2769.0 8166.0 9722.0 3 1/2/2015 286 2749.5 8157.0 9677.5 4 12/31/2014 284 2730.0 8115.0 9633.0 5 12/28/2014 281 2706.0 8018.0 9446.0 6 12/27/2014 280 2695.0 7997.5 9409.0 7 12/24/2014 277 2630.0 7977.0 9203.0 8 12/21/2014 273 2597.0 7919.5 9004.0 9 12/20/2014 272 2571.0 7862.0 8939.0 (122, 18) (1, 18) Date Day Cases_Guinea Cases_Liberia Cases_SierraLeone \ 19 11/18/2014 241 2047.0 7082.0 6190.0 Cases_Nigeria Cases_Senegal Cases_UnitedStates Cases_Spain Cases_Mali \ 19 20.0 1.0 4.0 1.0 6.0 Deaths_Guinea Deaths_Liberia Deaths_SierraLeone Deaths_Nigeria \ 19 1214.0 2963.0 1267.0 8.0 Deaths_Senegal Deaths_UnitedStates Deaths_Spain Deaths_Mali 19 0.0 1.0 0.0 6.0 Cases_Guinea Cases_Liberia Cases_SierraLeone Cases_multiple 0 2776.0 NaN 10030.0 NaN 1 2775.0 NaN 9780.0 NaN 2 2769.0 8166.0 9722.0 20657.0 3 NaN 8157.0 NaN NaN 4 2730.0 8115.0 9633.0 20478.0 5 2706.0 8018.0 9446.0 20170.0 6 2695.0 NaN 9409.0 NaN 7 2630.0 7977.0 9203.0 19810.0 8 2597.0 NaN 9004.0 NaN 9 2571.0 7862.0 8939.0 19372.0 84729.0 nan 参考资料 技术支持qq群144081101 591302926 567351477 钉钉免费群21745728 本文最新版本地址 本文涉及的python测试开发库 谢谢点赞! 本文相关海量书籍下载 源码下载 本文英文版书籍下载

优秀的个人博客,低调大师

耗尽了CPU、RAM和磁盘I/O资源分析

知识预览 1.系统负载 2.使用top命令解决负载问题 2.1了解top命令的输出 2.2 解决高用户时间的问题 2.3解决内存不足的问题 2.4 解决高I/O等待时间问题 2.3问题发生后的高负载处理 3.1配置sysstat 3.2查看CPU统计信息 3.3查看RAM统计信息 3.4查看磁盘统计信息 3.5查看之前的统计信息 机器运行缓慢通常是由于消耗了太多系统特定的资源。系统的主要资源包括CPU、RAM、磁盘I/O以及网络。过度使用这些资源的任何一种都会让系统陷入困境。不过,如果能登录到系统之中,可以借助大量工具确定问题的起因。 回到顶部 1.系统负载 解决引起系统运行缓慢的问题时,平均系统负载可能是最先用到的基本度量标准。 最常用的命令是uptime: load average 后面的3个数字2.03、30.17 和 15.09分别代表了1分钟、5分钟和15分钟内机器的平均负载。一个系统的平均负载等于处于运行或者不可打扰状态进程的平均数。 平均负载为1的单CPU系统意味着这个CPU处于恒定负载。如果单CPU系统的平均负载是4,那么这个系统处于它可承受负载能力的4倍,所以3/4的进程都在等待资源。负载状态为1的单CPU系统与负载状态为4的四CPU系统使用资源的量一样。 这个例子中,5分钟内和15分钟内的平均负载都很低,但是1分钟内的平均负载却很高,所以知道负载的飙升相对而言发生在最近。通常我们会连续运行多次uptime命令(或者使用top命令)来观察负载是持续上升还是正在下降。 什么是高平均负载: 这取决于产生高负载的原因。因为负载描述了正在使用资源的活动进程的平均数量,所以负载的飙升透露了很多信息。明确负载是CPU密集型(等待CPU资源的进程)、RAM密集型(尤其是,频繁使用的RAM被移入了交换区)还是I/O密集型(争夺磁盘或网络I/O资源的进程)非常重要。 通常CPU密集型的系统会比I/O密集型的系统响应度更高。我见过数以白计CPU密集型的系统,仍然可以在这些系统上运行故障排除工具而且具有良好的响应时间。I/O负载相对较低的I/O密集型系统,只是登录系统就需要花费一段时间,因为它们的磁盘I/O完全饱和了。用尽RAM资源的系统通常与I/O密集型的系统表现相同,因为一旦系统开始使用磁盘上的交换存储,它就会消耗磁盘资源,导致进程逐渐变慢直至停止。 回到顶部 2.使用top命令解决负载问题 当需要解决高负载问题的时候,第一个想到的工具是top命令。你能看到系统的实时信息,包括系统启动了多久、负载平均值、系统中总共有多少进程在运行、总共有多少内存、使用了多少内存、还剩多少内存,最后还包含系统的进程列表以及它们占用的资源数量。top命令默认排序方式是按照进程的CPU使用情况从上到下排序,可以一眼就看到那些进程正在消耗CPU资源。 终止进程: top命令输出的第一列是PID,想要终止某个进程,只需按下K键,然后输入想要终止的PID,最后系统提示该进程将会终止与signal 15时,按下Enter键即可。 完整输出: 默认情况top命令是在非交互模式下,如果想看到top命令的完整输出,或将信息重定向到文件中,-b选项可以开启批处理模式,-n选项可以控制在退出top命令之前,刷新信息多少次。 查看完整的输出,仅需运行一次top命令: 1 top -b -n 1 将信息存储到名为top_output文件中: 1 top -b -n 1 > top_output 如果想看top命令的输出,同时将该输出写入文件,那么可以使用tee工具: 1 top -b -n 1 | tee top_output 回到顶部 2.1了解top命令的输出 top命令输出的第一行与之前见到的uptime命令输出一致。 top命令提供了额外的度量标准。例如,Cpu(s)这一行提供了当前CPU运行情况的信息。 缩写代表的意义: us:用户CPU时间 运行非优雅的用户进程所占CPU时间的百分比(优雅,英文“nicing”,是指一个进程允许你根据其他进程更改优先级)。 sy:系统CPU时间 运行内核和内核进程所占CPU时间的百分比。 ni:优雅CPU时间 如果更改过一些进程的优先级,这个指标能够告诉你它们所占CPU时间的百分比。 id:CPU空闲时间 这是你希望具备很高数值的度量指标中的一个。它代表了CPU的空闲时间比。如果系统运行缓慢,但是这个指标特别高,那么你就可以确定问题的原因不是高CPU负载。 wa:I/O等待 这个数字代表了CPU时间用在等待执行I/O操作所占的百分比。当你解决运行缓慢的系统问题的时候,这是一个非常有价值的度量指标,如果这个数值很低,那么就能轻松排除磁盘或者网络I/O的问题。 hi:硬件中断 CPU用于处理硬件中断所占时间的百分比。 si:软件中断 CPU用于处理软件中断所占时间的百分比。 st:流逝的时间 如果你正在运行虚拟机,这个度量指标会告诉你虚拟机中执行的其他任务所占CPU时间的百分比。 从以上例子中,可以看出系统有超过50%的空闲时间,这与机器具备4个CPU、系统负载为1.70的指标项匹配。当处理一个运行缓慢的系统的时候,首先要观察的度量指标之一就是I/O等待时间,它可以用来排除磁盘I/O的问题,如果I/O等待时间很低,那么可以看看CPU空闲时间百分比;如果I/O等待时间很高,那么下一步就是确定是什么因素导致I/O等待时间所占的比重这么高。如果I/O等待和CPU空闲时间百分比都很低,那么狠可能会看到一个非常高的用户时间百分比,所以必须确定是什么原因导致了这么高的用户时间百分比。如果I/O等待时间所占百分比很低,而空闲时间百分比很高,就知道系统运行缓慢不是CPU资源的原因,而应该从别的地方找原因。这可能意味着应该查看网络问题或web服务器的问题,或查看MySQL查询缓慢的问题等。 回到顶部 2.2 解决高用户时间的问题 解决故障的过程中一个常见而又相对简单的问题是,由用户CPU时间百分比高引起的高负载问题。如果发现用户时间百分比高但I/O等待时间百分比却很低,很显然你需要确定系统中哪一个进程占用了大量的CPU资源。默认情况,top会按照各个进程CPU使用率由高到低排序。 这个例子中,mysqld进程消耗了53%的CPU时间,nagios2db_status进程消耗了12%的CPU时间。这个数字代表的是锁占单个CPU的百分比,如果拥有一台具备4个CPU的机器,可能会看到多个进程都消耗了99%的CPU时间。 通常情况下很容易确定,top命令输出中前一两个进程都是非常高的CPU百分比,而其余进程所占CPU百分比相对很低,此时解决方法就是终止大量使用CPU资源的进程(按K键,然后输入对应进程的PID)。 在多进程的情况下,如果让系统做了太多事。比如,在Web服务器中可能有大量Apache进程,还有cron中运行的部分日志解析脚本。这些进程会消耗差不多等量的CPU资源。这种问题的解决方案从长期来看相当复杂。以Web服务器为例,你的确需要运行全部Apache进程,同时你可能还需要日志解析工具。在短期内,你可以终止(或推迟)一些进程直到负载降低,但从长期来看,你可能需要考虑增加系统资源或将这些功能分拆到多台服务器上。 回到顶部 2.3解决内存不足的问题 top输出中以下两行提供了非常有价值的RAM使用情况的信息。在处理特定的系统问题之前,排除内存问题非常重要。 第1行告诉我们有多少物理内存可用、占用了多少内存、空闲内存以及缓存了多少内存。第2行为我们提供了相似的信息,交换存储以及Linux文件缓存使用了多少RAM。需要注意得是系统仅显示26768KB空闲内存。 想找出进程到底使用了多少RAM,必须刨除RAM中的文件缓存。在已用的997408KB的RAM中,有286040KB的RAM被文件缓存占用,所以说实际上仅使用了711368KB的RAM。在这个例子中,系统仍然有大量可用的内存资源,几乎没有使用任何交换存储。即便看到使用了一些交换存储,这也不足以作为问题的征兆。如果一个进程转为空闲状态,Linux通常会将它占用的RAM释放,供其他进程使用。辨别是否耗尽了RAM的一个好方法是查看文件缓存。如果实际用的内存减去文件缓存的值很大,同时交换存储的值也很高,很可能的确有内存问题。 如果发现了内存问题,下一步就是确定哪些进程消耗了RAM。top默认按照CPU的使用率排序,所以你需要将其改为按照RAM使用率来排序,保持top的打开状态,然后按下M键。这就会让所有进程按照RAM的使用率排序。 注意%MEM这一列,会看到前几个进程占用了大量RAM。如果找到大量使用RAM的进程,可以终止它们,或者根据程序,通过专门的故障排除方法来寻找是什么原因导致这些进程占用了大量RAM。 注意: 实际上top命令的输出可以根据任何列排序。想要更改top输出的排序方式,按F键进入选择排序列的界面。在按下对应特定列的按键之后(比如,K对应CPU列),再按Enter键就能回到top的输出界面。 Linux内核也有一个内存耗尽(OOM)终结者,如果低内存导致系统运行危险,它就会介入。当系统内存快要耗尽的时候,OOM终结者就会开始终结进程。有些情况下,终止的可能是占用大量RAM的进程,但它并不能保证不会终止未占用大量RAM的进程。有的时候它也会终止像sshd这样的程序或者其他进程,而不是真正的罪魁祸首。很多时候,OOM终止了一些进程之后,系统就会变得不大稳定,所以你不得不重启机器以确保所有的系统进程都在正常运行。如果OOM终结者介入了,在/var/log/syslog中你会看到如下行: 回到顶部 2.4 解决高I/O等待时间问题 当看到I/O等待时间所占CPU时间的比重很高的时候,首先检查机器是否正大量使用交换空间。因为磁盘操作的速度远远低于RAM,所以当系统内存耗尽,开始使用交换空间的时候,系统的性能会受到严重影响。任何想要访问硬盘的操作都要完成与硬盘的I/O交换。所以,故障排除的第一步是看内存是否耗尽,如果是,先解决这个问题。如果还有大量可用的RAM,你需要明确哪个进程占用了大部分I/O操作。 有的时候很难弄明白到底是哪个进程占用了大量I/O资源,但是如果系统中存在多个分区,可以缩小范围,找到哪个分区正在执行大量I/O操作。想要做到这一点,需要使用iostat程序,基于Red Hat和基于Debian的系统的sysstat包中都提供了这个程序。如果机器没安装,可以通过包管理工具来安装。 首先看到的是与top命令相似的CPU信息,下面紧跟着系统上所有硬盘设备以及分区的I/O状态信息。各列代表的意义: tps 这个值列出了设备每秒的传输量。“传输”(Transfer)是向设备发送I/O请求的另一种表达方式。 Blk_read/s 表示每秒从设备读取的数据量。 Blk_wrtn/s 表示每秒从设备写入的数据量。 Blk_read 这一列表示从设备读取的数据总量。 Blk_wrtn 这一列表示写入设备的数据总量。 当系统处于高I/O负载状态的时候,首先就是观察每个分区,看看哪个分区的I/O负载最高。比如,有一台数据库服务器,数据库本身存储在/dev/sda3分区。如果看到大量的I/O操作来自这里,这就是一个很高的线索:数据库很可能占用了大量I/O资源。 弄明白这一点后,下一步就是确定I/O操作大部分来自读取还是写入。假设怀疑备份工作导致了I/O操作的增长。因为备份工作的操作主要集中于从文件系统中读取文件,然后通过网络传输到备用服务器,如果大量的I/O操作都来自于写入而不是读取操作,那么大概就可以排除这个问题。 注意: 你可能需要运行iostat命令多次,以此得到系统当前的精确I/O状况。如果在命令行指定一个数字参数,iostat就会持续运行并根据指定的秒数刷新输出信息。比如说,如果你想要每2秒看到一次iostat的输出,就可以输入iostat 2。如果你有任何NFS共享,iostat另一个非常有用的参数是-n,当你指定了-n参数,iostat就会给出所有NFS共享的I/O统计信息。 除了iostat,还有一个很简单的工具,它是top和iostat程序的混合体,能够显示系统中所有运行进程并将进程根据I/O统计信息排序。在默认情况下没有安装这个程序,可以再iotop包中找到它。 在这个例子中,会看到rsync进程执行了大量I/O读取操作。 回到顶部 2.3问题发生后的高负载处理 问题发生后的排查原因,只需要稍微多做一点工作,就能在服务器上安装相应的工具,记录全天的性能数据。 sysstat包中iostat工具能来解决高I/O的问题,sysstat也包含一些能报告CPU和RAM使用情况的工具。虽然可以使用top命令达到这个目的,但是sysstat更加强大,它能够用一种简单的机制来记录系统的统计信息,如CPU负载、RAM以及I/O状态。借助这些统计信息,当有人抱怨昨天中午系统很慢时,就可以查看日志,看看是什么原因引起的这个问题。 注意: 现在可以很方便得通过zabbix监控做到。 回到顶部 3.1配置sysstat 在基于Red Hat的系统上,需要修改/etc/sysconfig/sysstat文件,更改HISTORY选项,让它可以记录7天以上的统计信息。统计信息可以每10分钟抓取一次并记录每日总结。默认是记录28天。 一旦启用了sysstat,它就会每10分钟收集一次系统状态并将它存储到/var/log/sysstat或/var/log/sa文件中。除此之外,每天晚上再午夜之前,它还会分割统计文件。这些操作都是由/etc/cron.d/sysstat脚本执行的,所以如果想要更改sysstat收集信息的频率,可以修改这个脚本文件。 回到顶部 3.2查看CPU统计信息 sysstat统计信息的时候,它将这些信息存储在以sa开头、以本月当前日期结尾的文件名的文件中(如sa03)。这就意味着你可以查看从当前日期起,一个月以内的统计数据。使用sar工具可以查看这些统计信息。默认情况下sar会输出当天的CPU统计信息: 从输出可以发现,CPU很多统计信息和top命令的输出相同,在最后一行,sar还为每个值提供了平均值。 回到顶部 3.3查看RAM统计信息 sysstat计划任务不仅可以收集CPU负载信息,还能收集很多别的信息。使用-r选项就可以收集RAM的统计信息: 在这里可以看到使用了多少内存,空闲多少内存,同时还能查看交换空间的信息以及文件缓存的信息,这些信息与用top或free命令输出的信息类似。与之不同的是,你可以及时查看之前的信息。 回到顶部 3.4查看磁盘统计信息 磁盘统计信息,使用-b选项能给出一些列磁盘I/O的基本信息。 从这里可以看到每秒总共输出的数据量(tps),它由总共读取的数据量和写入的数据量(分别是rtps和wtps)相加获得。bread/s列并非用来衡量块I/O,而是告诉你平均每秒读取的数据量。bwrtn/s能告诉你平均每秒写入的数据量。 ar程序可以传入很多参数,输出特定的数据集,如果想看到所有数据。使用-A选项可以做到这点。它会显示包括负载平均值、CPU负载、RAM、磁盘I/O、网络I/O和其他一些有趣值在内的统计信息。通过阅读sar的用户手册(输入man sar)可以了解到想要看特定的统计信息应该传入什么标志位。 3.5查看之前的统计信息 有时需要查看一天中部分时间段内的信息。想要获得指定时间范围内的信息,可以使用-s和-e参数分别指定你感兴趣的开始时间和结束时间。例如,想查8:00pm—8:30pm这个时间段内的CPU数据,需要输入: 如果想要获取非当天的数据,使用-f选项,后面输入存储在/var/log/sysstat或/var/log/sa文件夹内统计信息文件的完整路径。例如,想要获取本月第6天的统计信息,输入: 1 sar -f / var /log/sysstat/sa06 也可以混合使用任意其他sar选项,从而获得特定类型的统计信息。

优秀的个人博客,低调大师

大数据日志分析产品——SaaS Cloud, e.g. Papertrail, Loggly, Sumo Logic;Open Source...

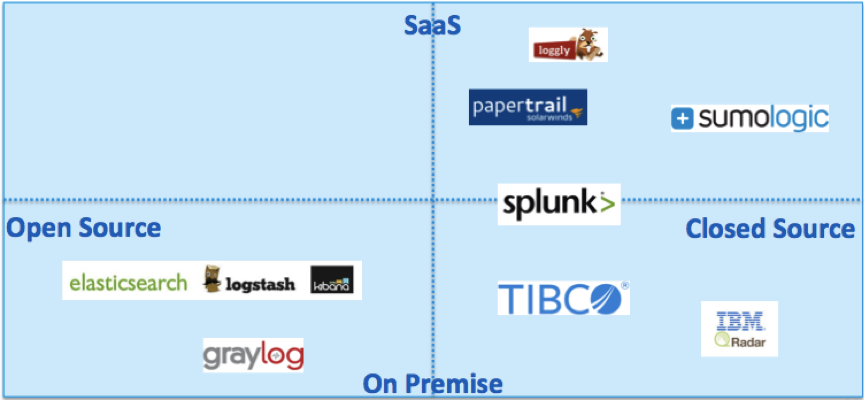
Learn how you canmaximize big data in the cloudwith Apache Hadoop. Download this eBook now. Brought to you in partnership withHortonworks. In February 2016, I presented a brand new talk at OOP in Munich: “Comparison of Frameworks and Tools for Big Data Log Analytics and IT Operations Analytics”. The focus of the talk is to discuss different open source frameworks, SaaS cloud offerings and enterprise products for analyzing big masses of distributed log events. This topic is getting much more traction these days with the emerging architecture concept ofMicroservices. Key Take-Aways Log Analytics enables IT Operations Analytics for Machine Data Correlation of Events is the Key for Added Business Value Log Management is complementary to other Big Data Components Log Management with Papertrail, ELK Stack, TIBCO LogLogic, Splunk, etc. Log Management has been a mature concept for many years; used for troubleshooting, root cause analysis, and solving security issues of devices such as web servers, firewalls, routers, databases, etc. In the meantime, it is also used for analyzing applications and distributed deployments using SOA or Microservices architectures. The slide deck compares different solutions for log management: SaaS Cloud, e.g.Papertrail,Loggly,Sumo Logic Open Source Frameworks, e.g.ELK stack (Logstash, Elasticsearch, Kibana),Graylog Enterprise Products, e.g.TIBCO LogLogic,IBM QRadar,Splunk IT Operations Analytics (ITOA) with TIBCO Unity IT Operations Analytics is a new, very young market growing strongly (100% year-by-year, according to Gartner). In contrary to Log Management, it does not just focus on analyzing historical data, but also enables to make complex correlations of distributed data to allow predictive analytics in (near) real time.TIBCO Unityis a product heading into this direction. You can integrate log data, but also real time events (e.g. via TIBCO Hawk) to enable monitoring, analysis and complex correlation of distributed Microserices. What about Apache Hadoop versus Log Management and ITOA? Why not use just Apache Hadoop? You can also store and analyze all data on its cluster! Why not just use Log Collectors (such as Apache Flume) and send data directly to Hadoop without Log Analytics “in the middle”? Here are some reasons… Log Management and ITOA tools. Are an integrated solution for data analysis (tooling, consulting, support). Are built exactly for these use cases. Involve data indexing, data processing (querying) and data visualization by means of dashboards and other tools out-of-the-box. Offer easy-of-use tooling and allow fast time-to-market / low TCO. The following graphic shows the different concepts and when they are usually used: Having said that, a better Hadoop integration is possible! It might make sense to leverage both together: the great tooling for Log Management, plus the Hadoop storage with very high scalability for really BIG data. For example, TIBCO Unity uses Apache Kafka under the hood to support processing and scaling millions of messages. Thus, integration with Hadoop storage might be possible in a future release… Slides Finally, here is my slide deck: xxx 转自:https://dzone.com/articles/frameworks-and-products-big-data-log-analytics-log 本文转自张昺华-sky博客园博客,原文链接:http://www.cnblogs.com/bonelee/p/6418854.html ,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册