首页 文章 精选 留言 我的

精选列表

搜索[智能平台],共10000篇文章
优秀的个人博客,低调大师

苹果iPhone X 发布,第一部人工智能意义上的手机

号称是科技界春晚的苹果发布会如期而至,此次共发布了3款iPhone手机,命名也与之前曝光的信息相符,分别为iPhone X、iPhone 8和iPhone 8 Plus。 其中iPhone X作为苹果十周年的创新性产品出现。不可否认的是,iPhone X发布之前的爆料信息都非常准确,像传闻的全面屏、取消Home键、3D面部识别扫描也都在昨晚被一一证实。 尽管没有特别让人意外的惊喜,iPhone X 的全面OLED屏、面部识别Face ID技术仍是整个发布会的亮点。苹果iPhone X 可以说是追赶当下AI潮流的一款产品。 取代Touch ID的Face ID 根据苹果发布会上介绍,苹果的面部识别技术(以下简称: Face ID)有9大特征。 人脸验证 原深感镜头 注册简单 专门的神经网络 安全自然 用户隐私 注意力感知 自适应性 和Apple Pay以及其

优秀的个人博客,低调大师

《中国人工智能学会通讯》——11.76 基于深度学习的特征表示模型

11.76 基于深度学习的特征表示模型 随着数据规模不断增大,深度学习在大数据分析中扮演着越来越重要的角色。图 5 显示了数据规模与性能之间的关系,传统学习算法在数据规模达到一定时性能几乎不再增加,而深度学习算法的性能会随着数据规模增加而增加。通过深度学习进行特征表示学习已经成为了机器学习和数据挖掘社区的一个快速突起的方法,并已经在许多领域获得成功,如计算机视觉、语音识别和自然语言处理等。蒙特利尔大学 Bengio 教授在文献 [8] 中综述了这方面的最新进展。许多深度神经网络模型,如自编码器和受限玻尔兹曼机,均采用无监督学习的模式。举例来说,一个自编码器通过数据自身重构的方式来学习优化网络参数。另一方面,深度神经网络也可以采用监督学习模式,如纽约大学 LeCun 教授提出的卷积神经网络[10] 。然而,在 2006 年之前大多数监督学习模式的深度网络均不是很成功。事实证明,多层神经网络的预测能力往往比浅层学习模型(如 SVM)更差。2006 年,多伦多大学 Hinton 教授革命性地提出了深度置信网络(Deep Belief Network,DBN),一种非监督式的逐层贪心训练算法,为有效训练深度神经网络带来了希望。之后,多种深度神经网络被提出,如堆栈式降噪自编码器(StackedDenoising Autoencoders,SDAE) [11] 。这些深度学习模型往往采用无监督学习模型,已经被证明可以有效学习高层次表征。机器学习,尤其是分类和回归问题的主要目标是估计条件分布 P(Y|X)。所有基于无监督学习的预训练方法都基于一个假设:输入数据的边缘分布 P(X) 包含了关于条件分布P(Y|X) 的重要信息[12] 。当存在大量标记数据时,有监督学习方法往往非常有效。当只有少量标记数据而无标记数据可以轻易获取时,结合已有标记数据和大量无标记数据将能增加对边缘分布 P(X) 估计的准确性。图 6 给出了一个线性特征空间的实例(图中,(a) 无监督学习——仅使用无标记数据;(b)监督学习——仅使用标记数据;(c) 半监督学习——同时使用标记数据和无标记数据。圆圈表示无标记数据;三角、方块、五角星表示不同的标记数据),其中潜在表征可以仅通过无标记数据或标记数据学习得到,也可以同时从两者学习得到。不难发现,无监督学习方式可以更好地刻画数据分布;监督学习可以很好地进行分类,但是不能确保与本质的数据分布一致;半监督学习方式可以同时利用标记数据和无标记数据进行协同训练,有利于产生好的表征。经典的自编码器及其变种往往采用无监督学习方式,为使其同样可以使用标记数据,受到一些基于弱监督学习或半监督学习的自编码器算法[13-15]的启发,我们提出了一种新的学习模型,命名为SUGAR(Supervision-Guided AutoencodeR) [16] 。 图 7给出了相应网络结构图,主要包括以下三个部分。 ● 主网络 (Main Network):用于重构输入,即无监督的自编码器; ● 辅助网络 (Auxiliary Network):基于对象间相似性,用于正则化学习到的网络,即有监督学习; ● 桥 (Bridge): 用于连接主网络和辅助网络,目的是增强两个网络之间参数的相关性。具体地,主网络使用无标记数据,可以采用正则自编码器(或降噪自编码器[11] );辅助网络使用标记数据(如成对标记),可以采用监督式学习方式(如哈希学习[17] );桥连接上面两部分,迫使它们的参数逼近。 基于 SUGAR 模型,我们给出了深度学习模型DeepSUGAR,如图 8 所示。DeepSUGAR 采用堆栈方式,将多个SUGAR堆起来形成一个深度学习模型,主要分为预训练和微调两个阶段。DeepSUGAR 的每一层是 SUGAR 模型,由主网络(实线框)、辅助网络(虚线框)和桥三个组件构成。f、h 表示编码函数,g 为解码函数,C 为区分函数。预训练后,所有虚线部分(包括 g 和 h)将被丢弃,整个系统通过编码函数 f 采用前馈传递方式产生紧致表征。我们在 8 个基准数据集上验证了模型的有效性。

优秀的个人博客,低调大师

《中国人工智能学会通讯》——7.15 篇章语义分析 :让机器读懂文章

7.15 篇章语义分析 :让机器读懂文章 自然语言处理的研究从词汇、词典的研究起步,近年来一直把句子作为核心的研究对象,对篇章的语义分析多是语言学家从理论上进行探索,计算机科学家对篇章范围语义现象的关注有限。但是,很多语义问题必须在篇章层面上才能够得到根本性的解决,比如“共指消解”、“语义关系识别”和“事件融合与关系识别”等。同时,这些篇章级语义问题的解决对于词汇级和句子级的分析同样具有反哺性的指导意义。近年来,中文词汇、句子级自然语言处理技术的发展,特别是词义消歧、句法分析和语义角色标注等研究工作的进展,为篇章语义分析的研究创造了技术条件。同时,搜索引擎等重大互联网应用也向篇章语义分析提出了应用上的强烈需求。如果能够建立一套既具有理论深度,又具有现实可行性的篇章语义分析的理论和方法体系,对于自然语言处理学术和应用的发展无疑都将具有重要意义。本文概述了目前主流的篇章语义分析方法,并简要介绍了其应用前景。

优秀的个人博客,低调大师

《中国人工智能学会通讯》——2.28 端到端神经机器翻译

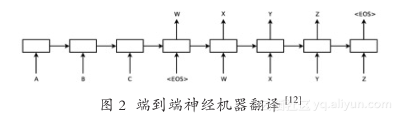
2.28 端到端神经机器翻译 端 到 端 神 经 机 器 翻 译(End-to-End NeuralMachine Translation)是从 2013 年兴起的一种全新机器翻译方法,其基本思想是使用神经网络直接将源语言文本映射成目标语言文本。与统计机器翻译不同,不再有人工设计的词语对齐、短语切分、句法树等隐结构(latent structure),不再需要人工设计特征,端到端神经机器翻译仅使用一个非线性的神经网络便能直接实现自然语言文本的转换。 英 国 牛 津 大 学 的 Nal Kalchbrenner 和 PhilBlunsom 于 2013 年首先提出了端到端神经机器翻译[10] 。他们为机器翻译提出一个“编码 - 解码”的新框架:给定一个源语言句子,首先使用一个编码器将其映射为一个连续、稠密的向量,然后再使用一个解码器将该向量转化为一个目标语言句子。Kalchbrenner 和 Blunsom 在论文中所使用的编码器是卷积神经网络(Convolutional NeuralNetwork),解码器是递归神经网络(RecurrentNeural Network)。使用递归神经网络具有能够捕获全部历史信息和处理变长字符串的优点。这是一个非常大胆的新架构,用非线性模型取代统计机器翻译的线性模型;用单个复杂的神经网络取代隐结构流水线;用连接编码器和解码器的向量来描述语义等价性;用递归神经网络捕获无限长的历史信息。然而,端到端神经机器翻译最初并没有获得理想的翻译性能,一个重要原因是训练递归神经网络时面临着“梯度消失”和“梯度爆炸”问题。因此,虽然递归神经网络理论上能捕获无限长的历史信息,但实际上难以真正处理长距离的依赖关系。 为此,美国 Google 公司的 Ilya Sutskever 等人 于 2014 年 将 长 短 期 记 忆(Long Short-TermMemory) [11] 引入端到端神经机器翻译[12] 。长短期记忆通过采用设置门开关(gate)的方法解决了训练递归神经网络时的“梯度消失”和“梯度爆炸”问题,能够较好地捕获长距离依赖。图 2 给出了Sutskever 等人提出的架构。与 Kalchbrenner 和Blunsom 的工作不同,无论是编码器还是解码器,Sutskever 等人都采用了递归神经网络。给定一个源语言句子“A B C”,该模型在尾部增加了一个表示句子结束的符号“〈EOS〉”。当编码器为整个句子生成向量表示后,解码器便开始生成目标语言句子,整个解码过程直到生成“〈EOS〉”时结束。需要注意的是,当生成目标语言词“X”时,解码器不但考虑整个源语言句子的信息,还考虑已经生成的部分译文(即“W”)。由于引入了长短期记忆,端到端神经机器翻译的性能获得了大幅度提升,取得了与传统统计机器翻译相当甚至更好的准确率。然而,这种新的框架仍面临一个重要的挑战,即不管是较长的源语言句子,还是较短的源语言句子,编码器都需将其映射成一个维度固定的向量,这对实现准确的编码提出了极大的挑战。 针对编码器生成定长向量的问题,YoshuaBengio 研究组提出了基于注意力(attention)的端到端神经网络翻译[13] 。所谓注意力,是指当解码器在生成单个目标语言词时,仅有小部分的源语言词是相关的,绝大多数源语言词都是无关的。例如,在图 2 中,当生成目标语言词“money”时,实际上只有“钱”是与之密切相关的,其余的源语言词都不相关。因此,Bengio 研究组主张为每个目标语言词动态生成源语言端的上下文向量,而不是采用表示整个源语言句子的定长向量。为此,他们提出了一套基于内容(content-based)的注意力计算方法。实验表明,注意力的引入能够更好地处理长距离依赖,显著提升端到端神经机器翻译的性能[14] 。 虽然端到端神经机器翻译近年来获得了迅速的发展,但仍存在许多重要问题有待解决。 ● 可解释性差:传统的统计机器翻译在设计模型时,往往会依据语言学理论设计隐结构和特征。端到端神经网络翻译重在设计神经网络架构。但是由于神经网络内部全部是向量,从语言学的角度来看可解释性很差,如何根据语言学知识设计新架构成为挑战,系统调试也困难重重。 ● 训练复杂度高:端到端神经机器翻译的训练复杂度与传统统计机器翻译相比具有数量级上的提升,必须使用较大规模的 GPU 集群才能获得较理想的实验周期。因此,计算资源成为开展端到端神经机器翻译研究的最大门槛。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册