首页 文章 精选 留言 我的

精选列表

搜索[分代式],共10000篇文章
优秀的个人博客,低调大师

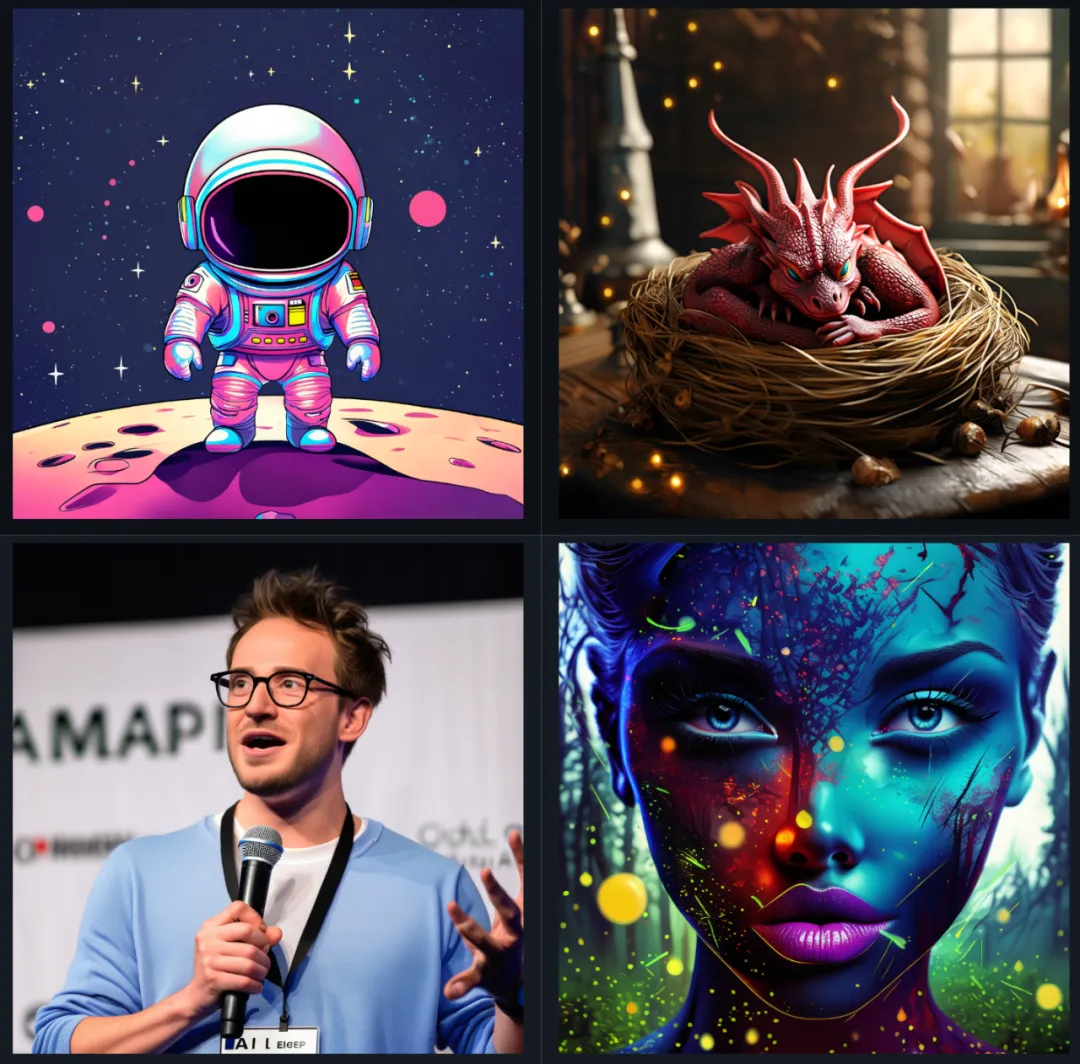
新一代开源 AI 图像生成/编辑模型 FLUX.2 发布

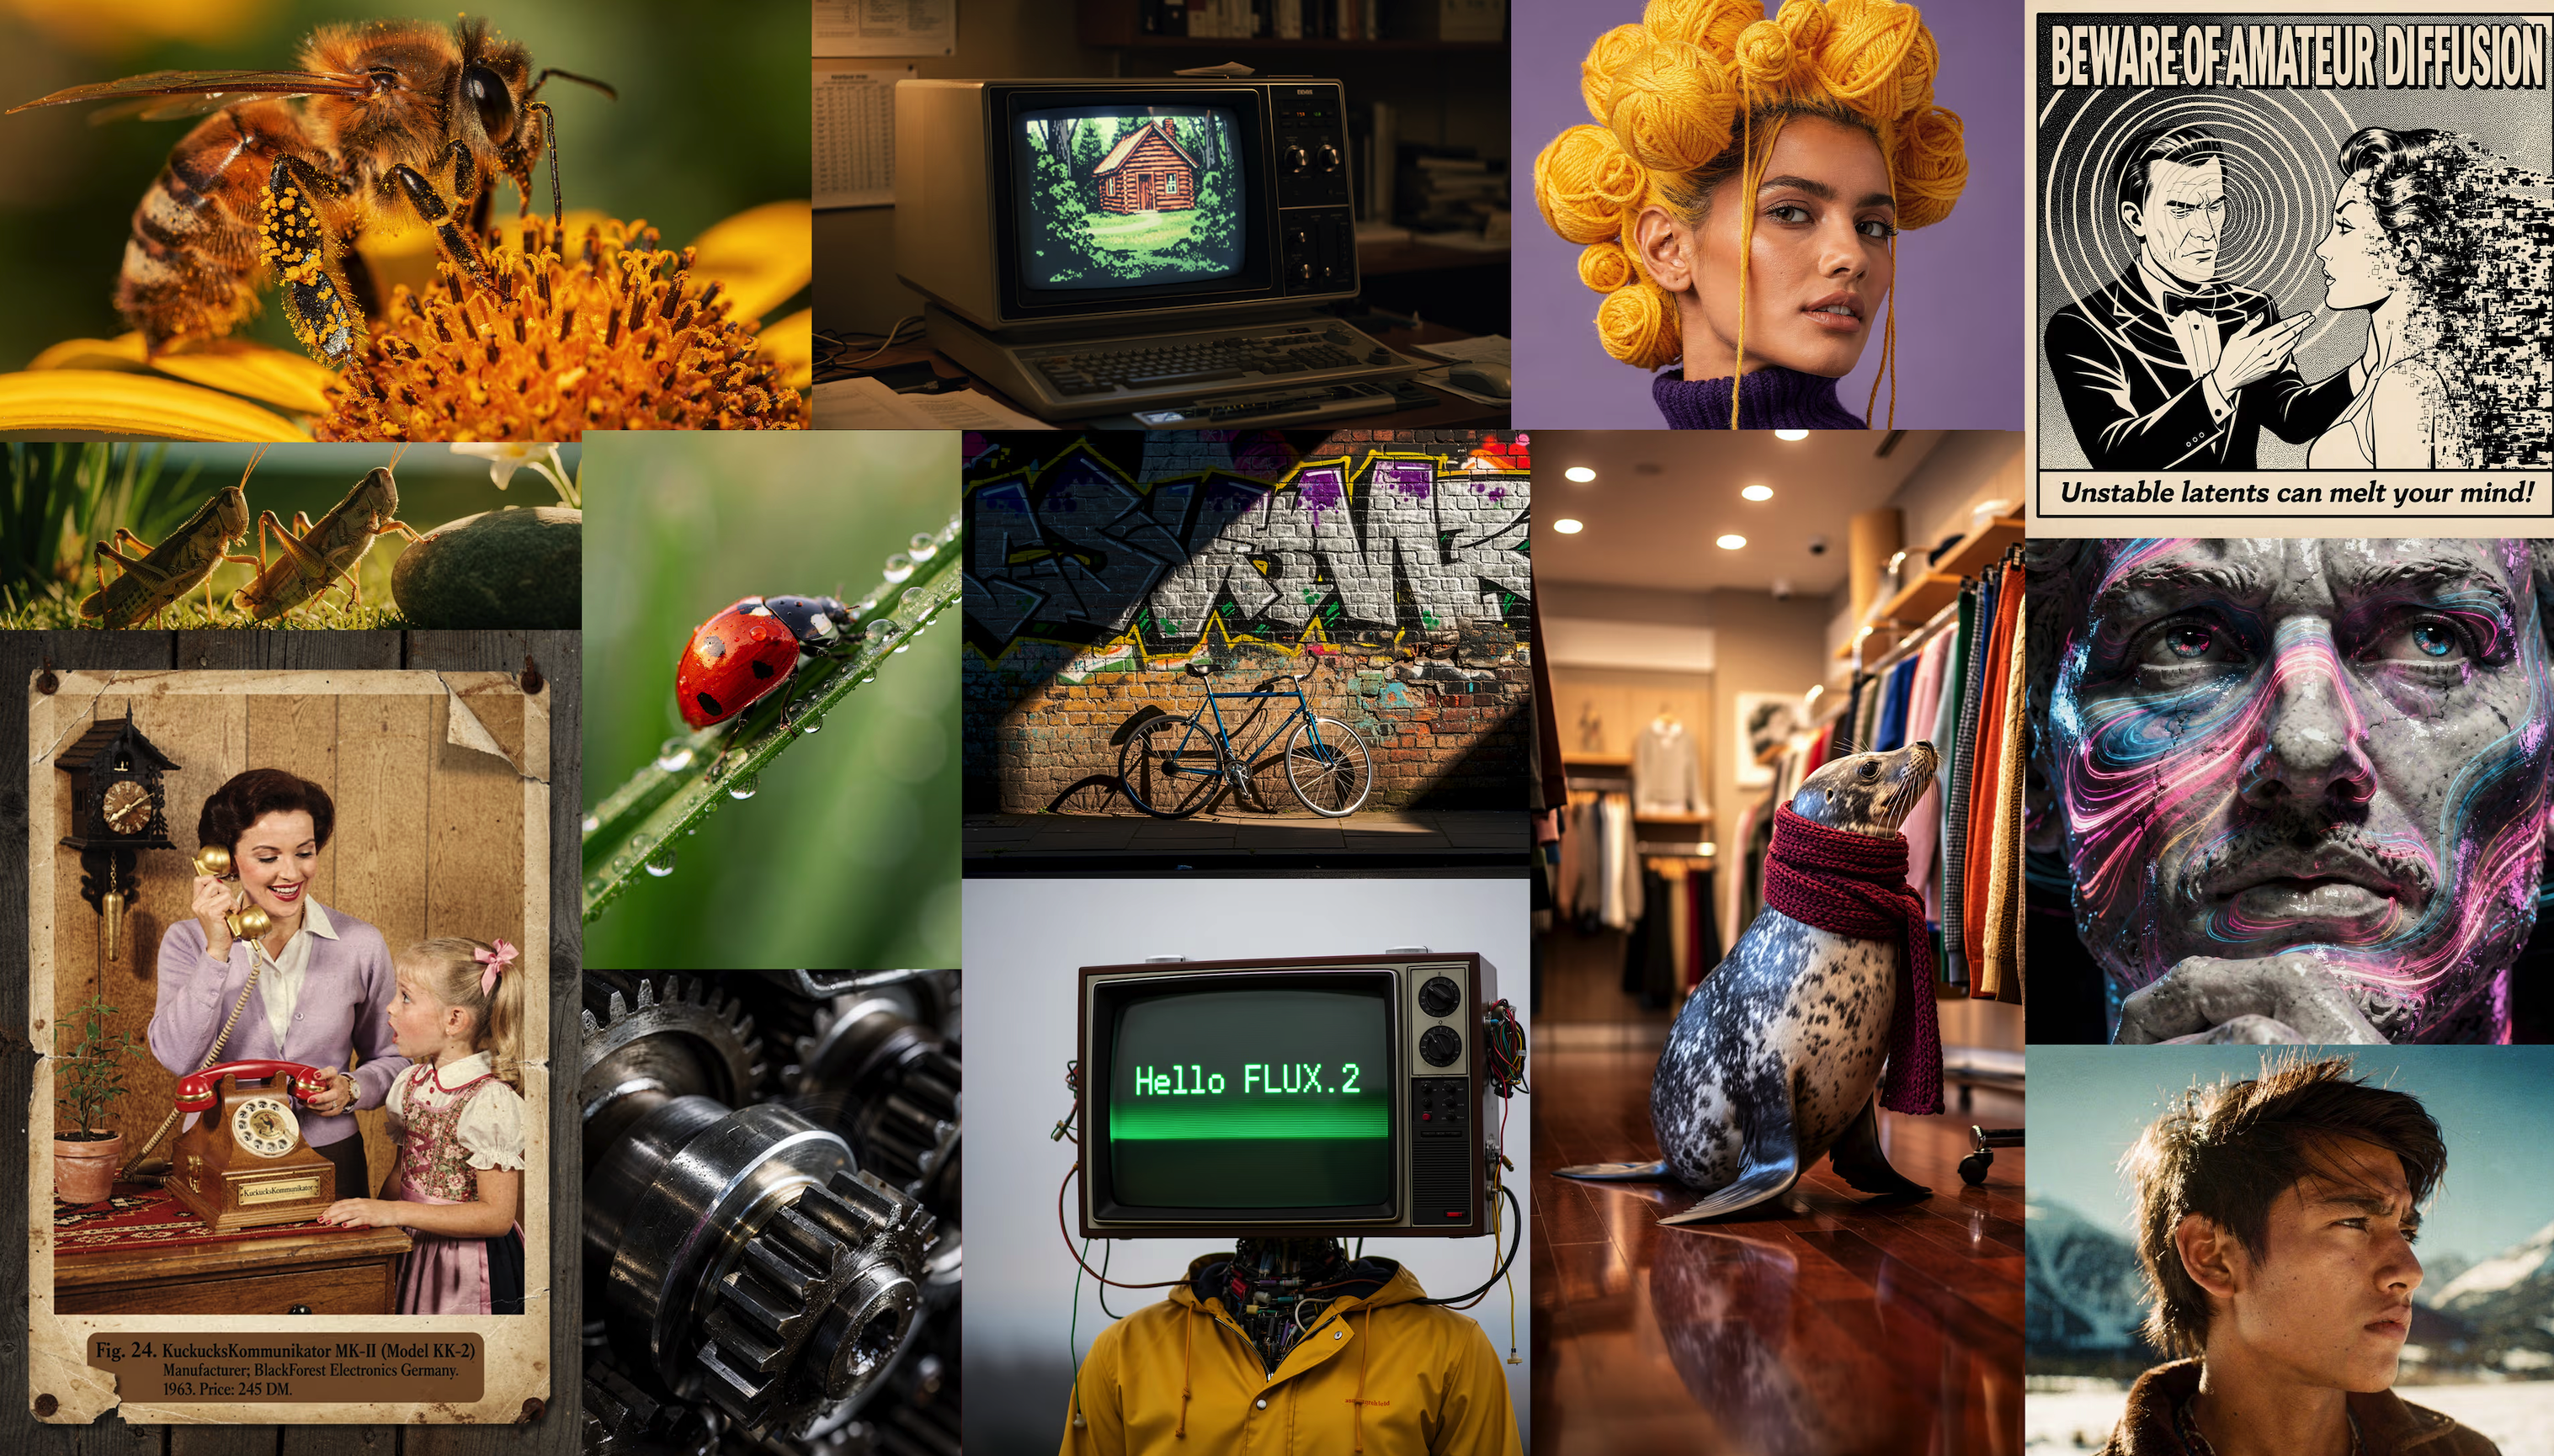
近日,德国 AI 公司 Black Forest Labs(BFL)正式发布 “FLUX.2”——他们迄今为止最强大的文本-图像生成/编辑模型,目标不仅是“炫技展示”,而是真正服务于专业创作与产业级视觉工作流。 据介绍,FLUX.2支持多参考图生成(最多10张),提升角色、风格一致性;优化光照、纹理细节,适用于产品摄影、UI设计等场景。此外新增结构化JSON提示词控制,支持十六进制颜色代码精准配色,强化复杂排版、多语言(含中文)文本渲染能力。 FLUX.2版本划分: FLUX.2 [pro]:闭源商用版本,图像质量对标顶级闭源模型,生成速度更快、成本更低。 FLUX.2 [flex]:允许调整步数、引导规模等参数,平衡质量与速度,擅长文本与细节渲染。 FLUX.2 [dev]:32B参数开源版本(需授权商用),集成文生图、多图编辑功能,支持本地部署(需RTX 4090及以上显卡),Hugging Face已开源权重。 FLUX.2 [klein](待发布):Apache 2.0协议的开源轻量版,通过蒸馏保留核心能力。 FLUX.2 亮点如下: 专业级画质 + 高分辨率:FLUX.2 支持生成和编辑高达 4 百万像素(4 MP)图像,画面细节、材质、光照、空间感都接近摄影级真实感。 多图参考 (Multi-reference) + 风格/角色/产品一致性:用户可以输入多张参考图像(最多 6–10 张),FLUX.2 能保持风格、角色、产品外观的一致性,这对广告图、系列海报、产品展示等应用尤为关键。 优异的文本与排版渲染能力:相比此前很多生成模型容易“字母混乱”或“假文本”,FLUX.2 能生成清晰、可读的文字,适合海报、UI mock-up、信息图 (infographics)、跨语言内容等场景。 物理世界感 + 语义理解 + 布局/构图控制:模型对于光照、阴影、反射、透视、材质表现有更好的理解,也能按照结构化提示 (structured prompts) 生成复杂构图 —— 几乎可以 “把脑中的设计图变成照片”。 开放-核心 (open-core) 策略 + 多种版本选择:FLUX.2 提供从开源/开权重 (open-weight) 的 “Dev” 版本,到针对商业用户优化的 “Pro”/“Flex” 版本。对于研究者、设计师、创意团队、公司都具有灵活选择空间。 实测显示,与Google Nano Banana Pro相比,FLUX.2在CCD相机风格还原、结构化场景生成上表现更优,但世界知识理解(如动漫角色)仍存在差距。开源版本FLUX.2 [dev]生成单图成本约0.03美元,在多图编辑任务中优于同类开源模型。 FLUX.2开源地址:https://github.com/black-forest-labs/flux2
优秀的个人博客,低调大师

智谱开源新一代文生图模型 CogView3-Plus

智谱宣布开源文生图模型 CogView3 及 CogView3-Plus-3B。CogView3 以及 CogView3-Plus 模型均使用 Apache 2.0 协议,目前该系列模型的能力已上线「智谱清言」(chatglm.cn)。 CogView3-Plus-3B 的效果: CogView3 是一个基于级联扩散的 text2img 模型,包含三个阶段: 第一阶段:利用标准扩散过程生成 512x512 低分辨率的图像。 第二阶段:利用中继扩散过程,执行 2 倍的超分辨率生成,从 512x512 输入生成 1024x1024 的图像。 第三阶段:将生成结果再次基于中继扩散迭代,生成 2048×2048 高分辨率的图像。 公告称,在实际效果上,CogView3 在人工评估中比目前最先进的开源文本到图像扩散模型 SDXL 高出 77.0%,同时只需要 SDXL 大约 1/10 的推理时间。 CogView-3-Plus 在 CogView3(ECCV'24) 的基础上引入了最新的 DiT 框架,以实现整体性能的进一步提升。其采用了 Zero-SNR 扩散噪声调度,并引入了文本-图像联合注意力机制。与常用的 MMDiT 结构相比,它在保持模型基本能力的同时,有效降低了训练和推理成本。CogView-3Plus 使用潜在维度为 16 的 VAE。 借由混合分辨率训练,CogView-3Plus 模型支持 512 ~ 2048 像素区间内分辨率的灵活生成。从效果上看,CogView3-plus 有着和最领先的 text2img 模型持平的水平。

优秀的个人博客,低调大师

为什么 mybatis-mp 是最新一代最强 ORM 框架?

我想不出为什么不用mybatis-mp的理由!唯一的理由:太强了! https://gitee.com/mybatis-mp 与众不同之外的 10 大亮 1:mybatis-mp-亮点一:可自定义动态默认值2:mybatis-mp-亮点二:支持不同数据库 ID 自增配置3:mybatis-mp-亮点三:逻辑删除,可自动填充删除时间4:mybatis-mp-亮点四:可自定义 sql(sql 模板)5:mybatis-mp-亮点五:mapWithKey(把查询转成一个map)6:mybatis-mp-亮点六:部分字段新增和修改7:mybatis-mp-亮点七:枚举的良好支持8:mybatis-mp-亮点八:mybatis-xmlreturnType的ORM映射9:mybatis-mp-亮点九:优雅的XML 和@Select 查询自动分页10:mybatis-mp-亮点十:支持多层嵌套 VO,自动映射以及自动 select所需列 mybatis-mp 包含丰富的 api: 1:基于注解,映射数据库; 2:支持多表 join 和返回; 3:api 采用 lambda 和 stream 流式设计; 4:select 自动化以及结果 1 对 1,1 对多,超级方便快捷; 5:内置分页以及超强的 sql 优化功能; 6:稳定且性能极优; 7:轻量级封装 mybatis,几乎没有侵入; 8:api 丰富,支持数据库函数、多表、乐观锁、多租户、逻辑删除、默认值(可动态值) 等众多功能; 9:零学习成本,和写 sql 一样方便。 10:支持复杂的返回关系映射:例如一对一 ,一对多,多对多; 11:支持自定义 sql 模板,再也不用担心框架支持不足; 12:内置代码生成器,通过配置,可定制自身规范; 13:全新的框架,全新的设计理念,新的就是好!

优秀的个人博客,低调大师

新一代“垫图”神器,IP-Adapter的完整应用解读

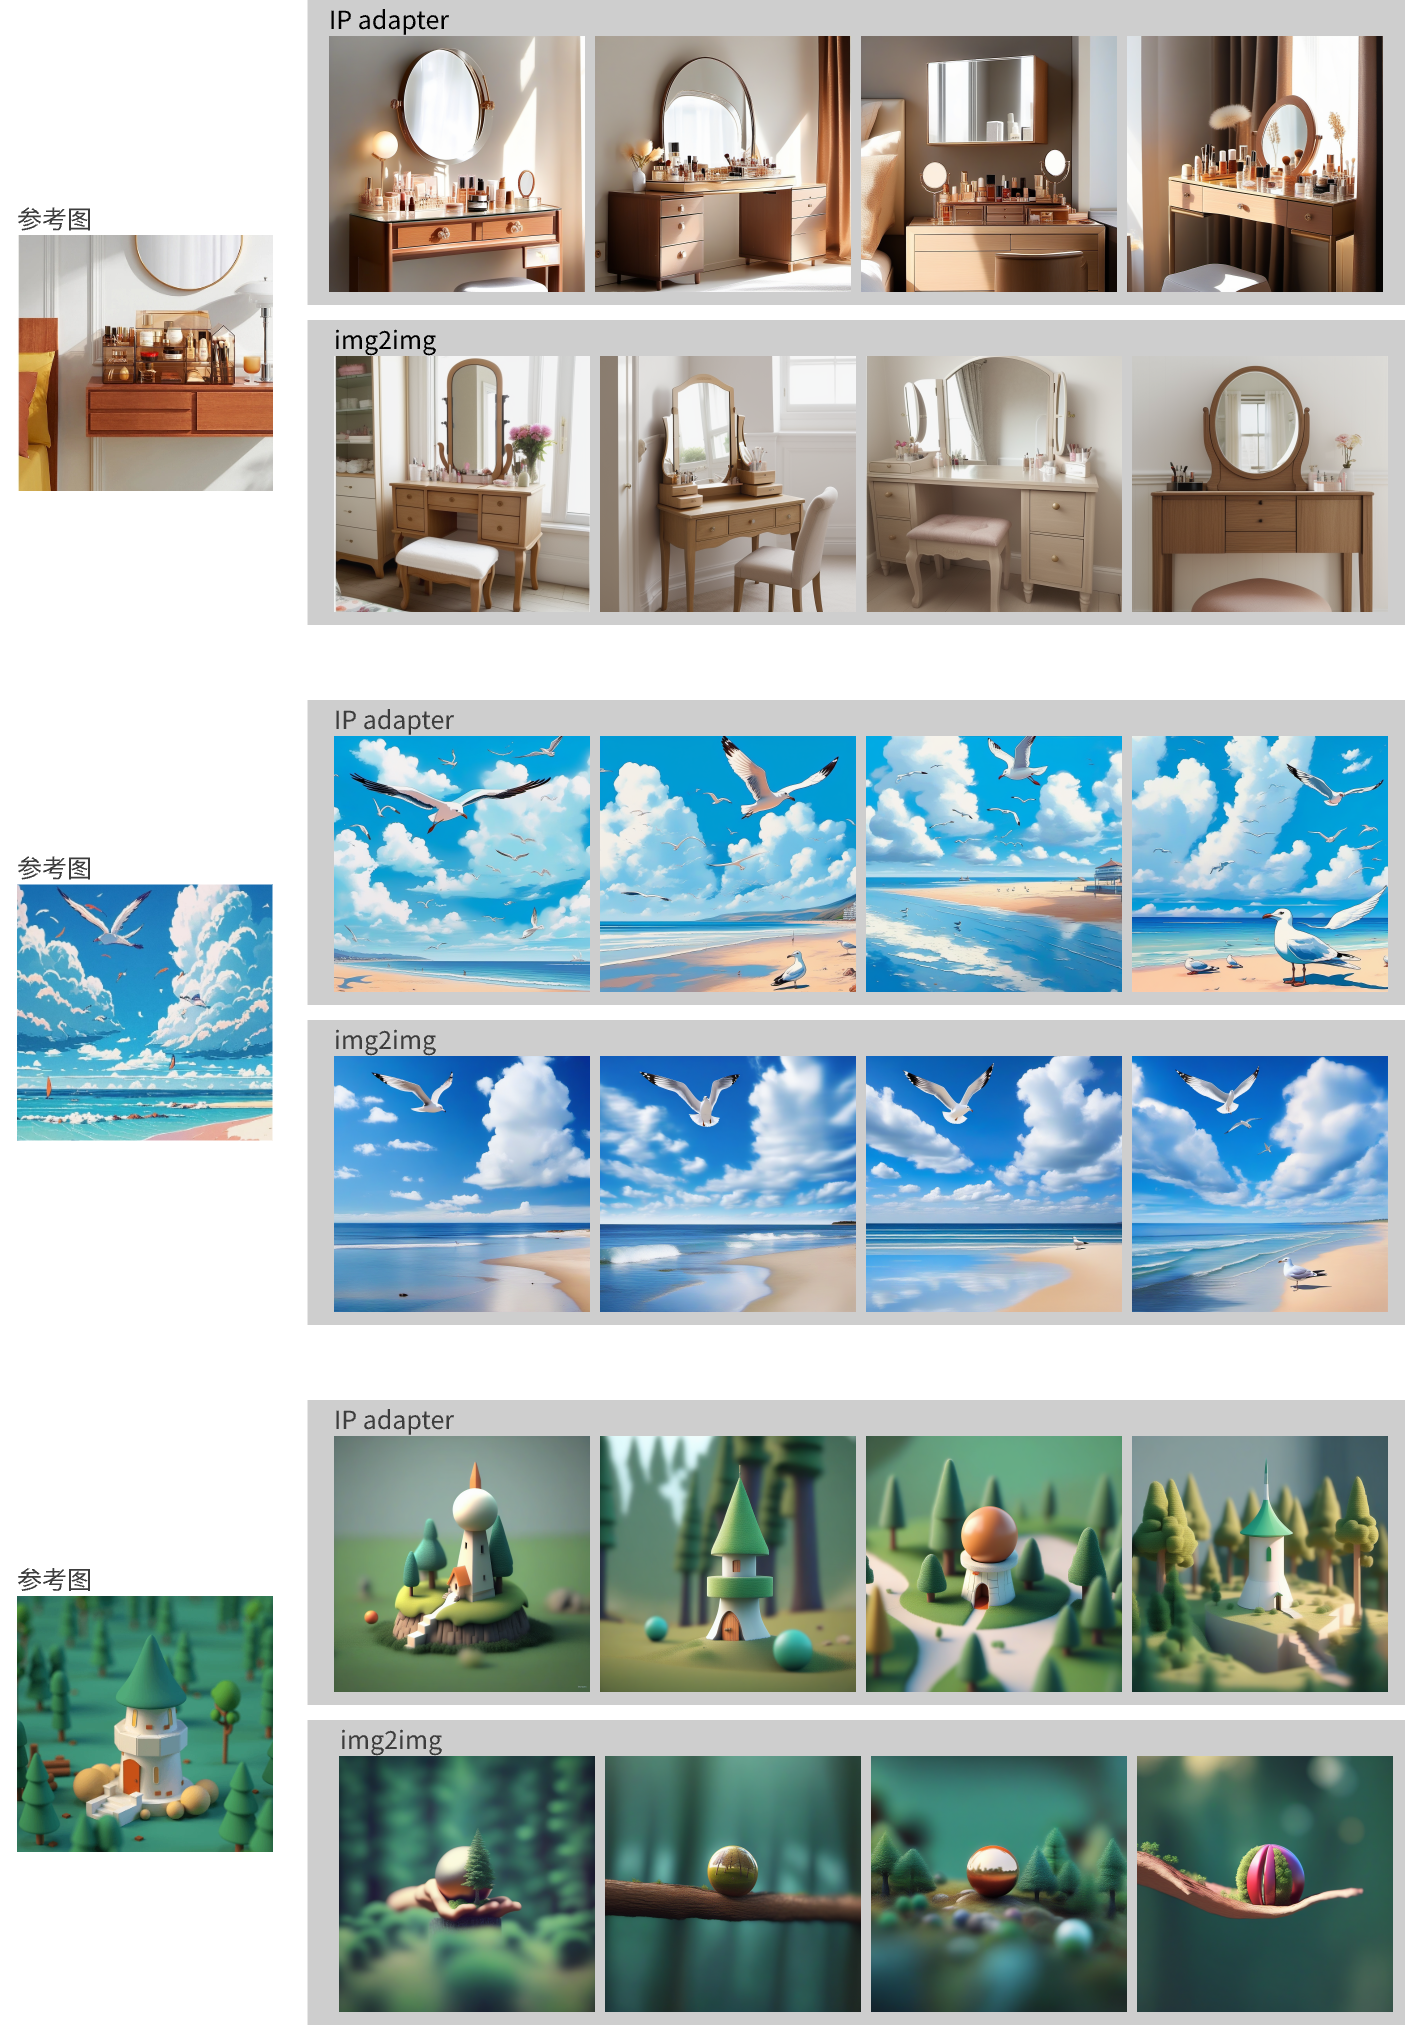
导读 不用训练lora,一张图就能实现风格迁移,还支持多图多特征提取,同时强大的拓展能力还可接入动态prompt矩阵、controlnet等等,这就是IP-Adapter,一种全新的“垫图”方式,让你的AIGC之旅更加高效轻松。  都是“垫图”,谁能还原你心中的图 “垫图”这个概念大家肯定都不陌生,此前当无法准确用prompt描述心中那副图时,最简单的办法就是找一张近似的,然后img2img流程启动,一切搞定。 可img2img简单的同时,也有它绕不过去的局限性,比如对prompt的还原度不足、生成画面多样性弱,特别是当需要加入controlnet来进行多层控制时,参考图、模型、controlnet的搭配就需要精心挑选,不然出图效果常常让人当场裂开…  但现在,我们有了新的“垫图”神器——IP-Adapter,在解读它之前,先来直观的感受一下它的效果。   效果可以说相当炸,那IP-Adapter就是终极答案了么?它的泛化性如何?兼容性是否足够?对prompt支持怎么样?当真的要接入现实工作中它还有什么拓展的能力呢?让我们一一来看。 IP-Adapter的核心优势,只画你关心的事 IP-Adapter和img2img虽然在操作上都是“垫图”,但它们的底层实现可以说是毫无关系。 用个不严谨但好理解的例子,“IP-Adapter”和“img2img”就是两位画师,现在给出prompt要求它俩画一个男人,在不提供参考图的情况下,它们大概都会画成图1的模样,但是当我们加上参考图2的时候,两者的区别就显现了。  img2img相当于直接盖在参考图上开始临摹,虽然知道要画个男人,但会在老虎的基础上去修改,始终会很别扭,中间不免出现老虎和男人混淆的情况,画出一些强行混合不知所谓的图来。因为在这个流程中,参考图更为重要,一切是在它基础上画出来的,结果也更倾向于参考图。  IP-Adapter则不是临摹,而是真正的自己去画,它始终记得prompt知道自己要画个男人,中间更像请来了徐悲鸿这样的艺术大师,将怎么把老虎和人的特点融为一体,讲解得偏僻入里,所以过程中一直在给“男人”加上“老虎”的元素,比如金黄的瞳仁、王字型的抬头纹、虎纹的须发等等。此时,prompt更为重要,因为这才是它的始终目标。  当然这些都是在一定的参数范围内,超过了阈值,那必然是要走极端的,照着参考图去copy了。但即便这样也可以看到img2img只是1:1的复制,而IP-Adapter有更多prompt的影子。  把简单的“垫图”,拓展得大有前途 在理解IP-Adapter的逻辑之后,会发现它带来的改变可不只是“垫图”,这里先展示一下它在我们工作中的实例,然后再和大家一步步的去拆解它。   以上这些效果实现很简单,只需要添加两层controlnet,一层用来提供IP-Adapter,一层利用canny用来对需要添加的商品进行绘制、固化即可。  如果只是在webui中应用,那到这里其实已经ok了。但这次我们要更进一步,利用新工具,去实现更有创造力的能力。 以下重点想分享的更多是工程搭建的能力和效果(具体的方法,我们会放到以后详细的讲解): ① 一张图就是一个lora,大大降低了训练的成本 ② 多参考图接入,提供更丰富的生成结果 ③ 利用对prompt的强注意力,提供prompt matrix丰富结果 ④ 基于comfyui的工作流部署,实现多步骤自动化生成  以往要想实现一个具体的设计风格,需要针对性的训练lora,背后涉及训练素材的搜集、打标、模型训练、效果检验等多个环节,通常要花一两天,并且结果还存在很强的不确定性。 但现在,通过IP-Adapter这一个步骤,在几分钟内就直观的看到结果,大大节省了时间,敏捷程度简直天壤之别。    当我们拥有这些特征,几乎就得到一个“即时lora”,而需要付出的成本只是去找几张符合预期的参考图。  同时IP-Adapter还能一次读取多张参考图,让生成的结果拥有更丰富的多样性和随机性,这是在img2img流程中无法实现的,也是两者之间区别最大的地方。     此刻,让我们把思路再打开一些,因为IP-Adapter对prompt的强注意力,prompt中的信息能更直观的反应在结果中。于是我们可以在继承img风格的同时,通过替换prompt里面的关键词,指向不同的结果,形成prompt的组合矩阵,更进一步的拓展生成结果的多样性。   更进一步,再加入不同的controlnet和批量素材读取,来实现对生成结果的可控引导,以及利用批量读取能力,来提供更加丰富的模板。一套”0成本即时lora + controlnet可控生成 + prompt matrix多样生成“的自动化流程就搭建完成了。 这个流程我们已经用在项目中,至于效果,大家的反馈概括为一句话就是——一键三连。   下面这张图就是上述流程部署在实际工作中的样子,载体是comfyui,它和webui都是基于stable diffusion能力,但和webui的网页化界面不同,它将SD的能力分解成不同的节点,通过节点关联搭建来实现各种功能。所以更加开放、自由、多源,并且可以实现流程的自动化,极大的提升了实际应用中的效率,下一期我们会专门针对它来进行解读。    到这里,关于IP-Adapter背后的原理和应用就整理完了,它有非常多的优点,但也非常需要结合实际的场景来应用,还是那个观念,没有最好的方法,只有适合的方法。 希望大家用的开心,有什么想法建议,十万吨的欢迎,我们下期再见。  这里是枯燥的分割线  有点无聊,但也很有得聊 看过它的表现的效果之后,再从底层原理看看IP-Adapter到底有什么特别。 我们知道stable diffustion是扩散模型,它的核心作用机制就是对噪音的处理,prompt可以看做是我们的目标,通过不断的去噪过程,向着目标越来越靠近,最终生成出预期的图片。   IP-Adapter则是将图片单独提出作为一种提示特征,相比以往那种只是单纯的把图像特征和文本特征抽取后拼接在一起的方法,IP-Adapter通过带有解耦交叉注意力的适配模块,将文本特征的Cross-Attention 和图像特征的Cross-Attention区分开来,在Unet的模块中新增了一路Cross-Attention模块,用于引入图像特征。 相当于将原本SD中img和prompt拼合成一个向量的做法分开来, img和prompt都会单独的组成向量, 然后交给unet层, 这样img中的特征就可以更好的被保留下来,从而实现对图像特征更显性的继承和保留。 本质上IP-Adapter就是txt2img的流程,流程中prompt还是最关键的,只是中间利用IP-Adapter强化了参考图的提示作用。   作为对比,img2img是直接将参考图传入unet,去替换了原始的随机噪音,这样所有的生成结果都是建立在它的基础上,于是有了前面人和老虎混杂的现象就比较好理解了。   最后的最后,我们通过伪码看一下它俩的底层区别 结构上: img2img使用unet架构,包括一个编码器(下采样)和一个解码器(上采样) IP-Adapter包括一个图像编码器和包含解耦交叉注意力机制的适配器 # img2img class UNet(nn.Module): # ... (U-Net architecture code) # IP-Adapter class IPAdapter(nn.Module): def __init__(self, image_encoder, text_to_image_model): # ... (initialization code)  流程上: img2img通过编码/解码器,需要通过一系列上采样、下采样 IP-Adapter通过图像编码器,文本提示和图像特征通过适配模块与预训练的文本到图像模型进行交互 # img2img encoded = unet_encoder(img2img_input) decoded = unet_decoder(encoded) # IP-Adapter image_features = image_encoder(ip_adapter_input[1]) adapted_features = adapter_module(ip_adapter_input[0], image_features)  输出上: img2img是输出一个转换后的图像 IP-Adapter是根据文本和图像提示生成的图片 # img2img output_image = img2img_model(img2img_input) # IP-Adapter generated_image = ip_adapter_model(ip_adapter_input)  以上,真的结束了。see you soon   作者:京东零售 何云深 来源:京东云开发者社区 转载请注明来源

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册