首页 文章 精选 留言 我的

精选列表

搜索[云安全中心],共10000篇文章
优秀的个人博客,低调大师

百度云平台使用说明

当我们登陆之后,百度提供了在server上面的工作文件夹,而且是以/user/username方式命名,其username就是我们注冊的用户名,在百度网盘能够与HDFS分布式文件系统交互,相同在WEBserver上也能够与HDFS分布式系统交互,其方法是:在web shell 界面输入upload能够将用户文件上传到WEBserver上面用户相应的工作文件夹以下,然后我们能够使用hadoop fs -put test ./ 将WEBserver上的文件上传到HDFS分布式系统上,在WEBserver上面能够使用ls直接查看当前文件夹以下文件,能够使用hadoop fs -ls ./查看HDFS分布式系统上文件夹以下的文件。 主办方提供三种数据: 1.关键词数据集(文件为:hdfs://share/data/compad/keyword_class.txt) 2.关键词辅助信息数据集(文件为:hdfs://share/data/compad/keyword_titles.txt) 3.关键词与广告主关联关系数据集(文件为:hdfs://share/data/compad/keyword_users.txt) 使用例如以下命令将hdfs分布式系统上的文件下载到WEBserver: hadoop fs -get /share/data/compad/keyword_class.txt ./keyword_class.txt hadoop fs -get /share/data/compad/keyword_titles.txt ./keyword_titles.txt hadoop fs -get /share/data/compad/keyword_users.txt ./keyword_users.txt 下载之后其存放路径是: 当我想使用download命令将文件下载到本地时候。会提示文件超过大小,百度提供的文件大小权限是10M。超过10M文件无法下载。 相同我们还能够使用 hadoop fs -cp /share/data/compad/keyword_users.txt ./keyword_users.txt 将文件复制到HDFS分布式系统上面我们自己的用户文件夹下 如:我拷贝过之后,使用命令查看, hadoop fs -ls ./其所在路径是: 注意:两种方式拷贝的文件的目的路径是不同的。 Hadoop 运行jar文件命令:hadoop jar xxx.jar mainclass args hadoop jar ./My.jar My.jar 应该存在你的JobClient的个人文件夹下(/home/shijiebei2009/My.jar), 而不是你的hdfs个人文件夹下。 假设我运行位于HDFS分布式系统上的jar文件,那么会出现permission denied错误提示。 我们能够实现百度网盘与HDFS分布式文件系统进行交互。 从百度网盘到HDFS的文件传输 pan –put ./tupian.png ./test/tupian.png 从HDFS到百度网盘的文件传输 pan –get ./test/tupian.png./test/tupian.png 在用户的server上工作文件夹下存在一个文件index.html,用户输入hadoop fs –put index.html ./001,则会拷贝用户server上工作文件夹下的index.html。保存在用户在HDFS的工作文件夹下的001子文件夹中。 Question: 在从HDFS上向网盘转移文件时候,使用例如以下命令 pan -get /share/data/compad/keyword_class.txt ./keyword_class.txt 会出现 hdfs file not exist! 使用命令: pan -get /share/data/compad/keyword_titles.txt ./keyword_titles.txt 会出现: com.baidu.pcs.exception.PcsHttpException: org.apache.http.HttpException: IOException java.net.SocketException: Connection reset 当我在使用命令从网盘向HDFS上载文件时候,提示上载成功 可是在文件夹以下并不能找到我上载的文件 pan -get /user/shijiebei2009/keyword_class.txt ./keyword_class.txt pan -get /user/shijiebei2009/keyword_users.txt ./keyword_users.txt 这两条命令均能够成功将文件下载到百度网盘,可是例如以下命令下载还有一个文件时候 会提示文件过大,不能下载。 在使用例如以下程序訪问keyword_titles.txt时候,出现的错误提示 import java.io.BufferedReader; import java.io.File; import java.io.FileNotFoundException; import java.io.FileReader; import java.io.IOException; import java.util.ArrayList; public class hi { public static void main(String[] args) { ArrayList<String> keywordclass=new ArrayList<String>(); ArrayList<String> keywordtitles=new ArrayList<String>(); ArrayList<String> keywordusers=new ArrayList<String>(); keywordtitles = GetData("keyword_titles.txt"); // keywordclass = GetData("keyword_class.txt"); // keywordusers = GetData("keyword_users.txt"); // System.out.println(keywordclass.size()+" "+keywordtitles.size()+" "+keywordusers.size()); // System.out.println(keywordclass.size()); System.out.println(keywordtitles.size()); } public static ArrayList<String> GetData(String filename) { String dir=System.getProperty("user.dir")+"/"+filename; ArrayList<String> datalist=new ArrayList<String>(); File file=new File(dir); String line; try { BufferedReader reader=new BufferedReader( new FileReader(file)); while((line=reader.readLine())!=null) datalist.add(line); } catch (Exception e) { // TODO Auto-generated catch block e.printStackTrace(); } System.out.println(dir); return datalist; } } 当我想知道keyword_class.txt文件的大小的时候。程序结果例如以下: 程序输出的数据是行数 当我想知道keyword_users.txt文件的大小的时候,程序结果例如以下: 经过试验,假设我将程序中的dir改成例如以下形式 dir = “hdfs://share/data/compad/keyword_class.txt”; 即我要訪问HDFS分布式系统上的文件是訪问不了的,程序给出提演示样例如以下: 本文转自mfrbuaa博客园博客,原文链接:http://www.cnblogs.com/mfrbuaa/p/5274628.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

使用docker构建云服务器项目

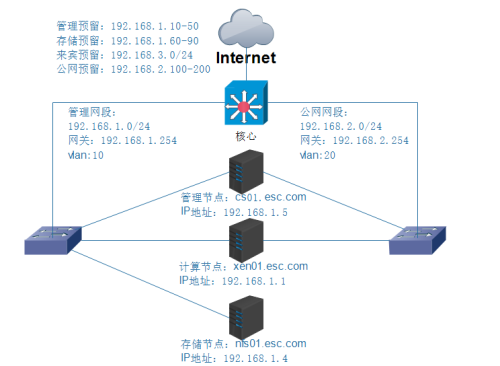
1.在CentOS7上安装 在线安装命令: yum –y install docker 启动 systemctl startdocker 导入镜像: docker load <centos7_tomcat7.tar 说明:<后面的centos7_tomcat7.tar要写centos7_tomcat7.tar所在的路径。 查看本地镜像库 docker images 2.创建br0网桥 说明:创建br0网桥目的是为docker容器设置固定IP。 执行命令: ip addr add192.168.152.193/24 dev br0; ip addr del192.168.152.193/24 dev eno16777736; brctl addif br0eno16777736; ip route add defaultvia 192.168.152.2 dev br0 说明:192.168.152.193/24为网卡eno16777736的IP地址,192.168.152.2为网关,根据自己机器的实际情况替换即可。 下载pipework脚本 下载地址https://github.com/jpetazzo/pipework,放到/usr/local/bin/目录下即可。 3.搭建Glusterfs分布式文件系统 说明:为docker容器提供硬盘挂载功能。 环境:S1、S2为服务器,C1为客户端(这里是Docker服务器)。S1(192.168.152.200)、S2(192.168.152.201)、C1(192.168.152.193) 3.1.服务端安装配置 安装epel-release yum -y installepel-release 在S1上下载repo: wget –P /etc/yum.repos.dhttp:// http://download.gluster.org/pub/gluster/glusterfs/LATEST/EPEL.repo/glusterfs-epel.repo yum命令在线安装 yum -y installglusterfs-server 编辑防火墙开启端口 vi /etc/sysconfig/iptables 添加内容: -A INPUT -p tcp -m state --state NEW -m tcp --dport 24007 -j ACCEPT -A INPUT -p tcp -m state --state NEW -m tcp --dport 49155 -j ACCEPT 保存并退出 启动服务: systemctl startglusterd S2服务器重复1至4步骤 在S1上绑定S2服务器: gluster peer probe 192.168.152.201 创建一个复制卷,保存2份数据,每台服务器保存一份: gluster volume create gfs 192.168.152.200:/gfs 192.168.152.201:/gfs 启动卷: gluster volumestart gfs 3.2.客户端安装配置 在C1安装 yum –y installglusterfs-client 创建要使用的文件目录 mkdir /gfs 挂载服务端卷到客户端 mount –tglusterfs 192.168.152.200:/gfs /gfs 4.运行RentServer项目 运行RentServer项目即可完成创建服务器,发布项目功能。 本文转自 yntmdr 51CTO博客,原文链接:http://blog.51cto.com/yntmdr/1713045,如需转载请自行联系原作者

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册