首页 文章 精选 留言 我的

精选列表

搜索[AIPC技术],共10000篇文章
优秀的个人博客,低调大师

面试系列五 之 项目涉及技术Spark

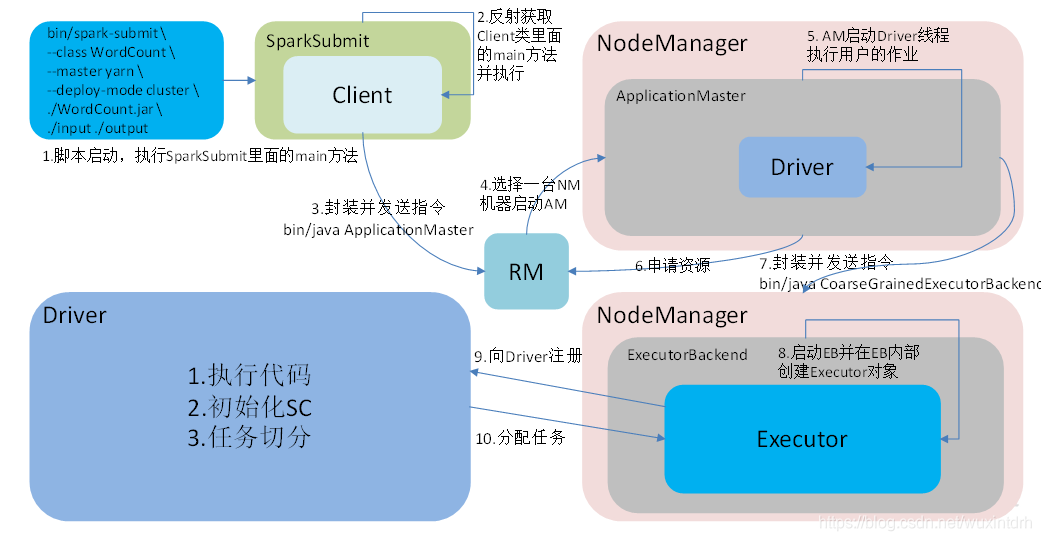
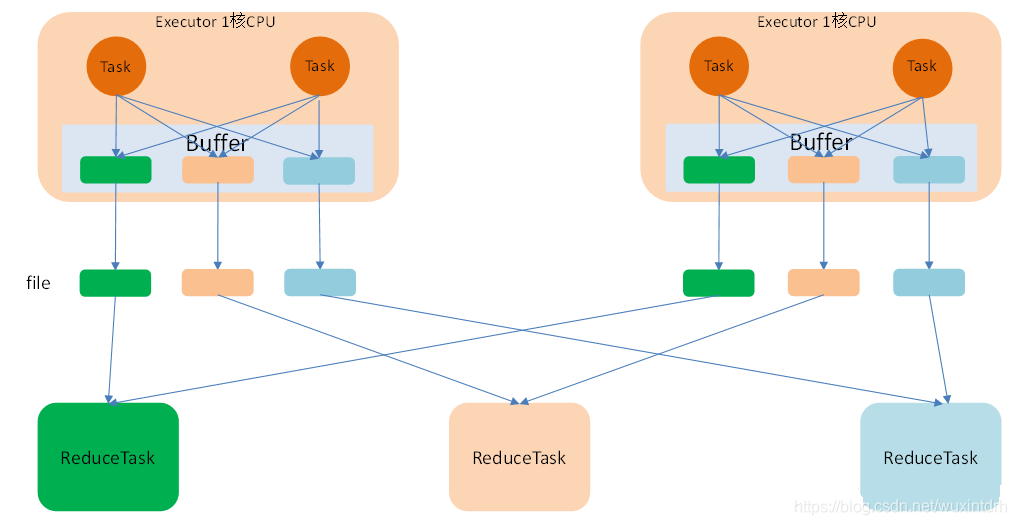
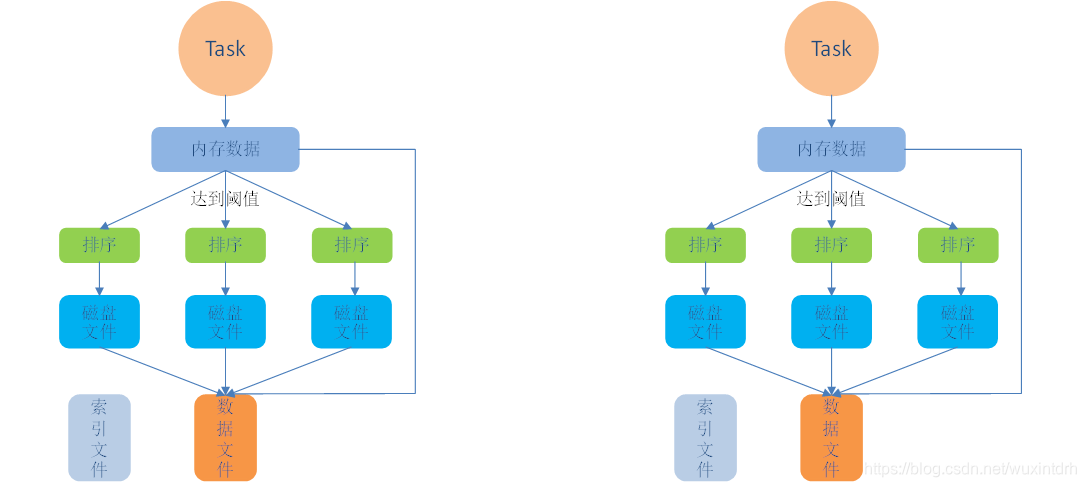
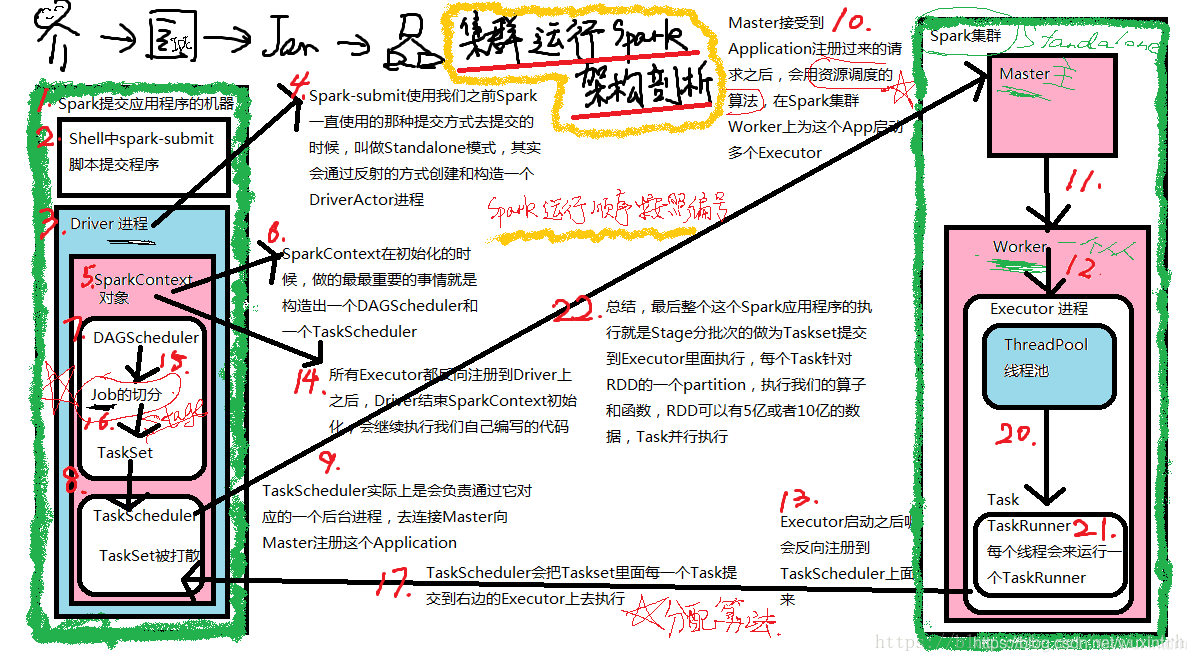
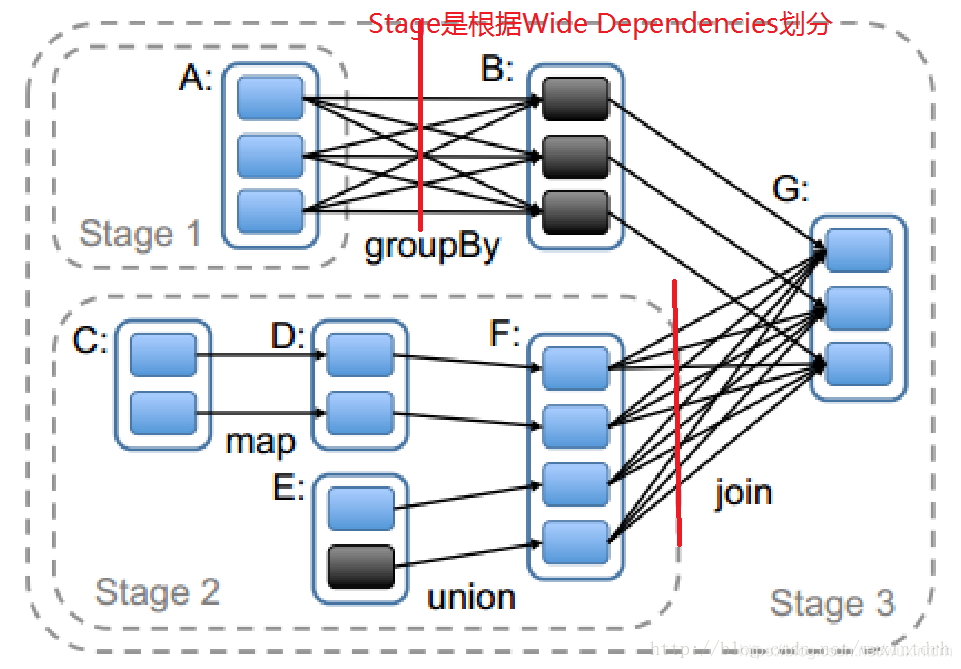
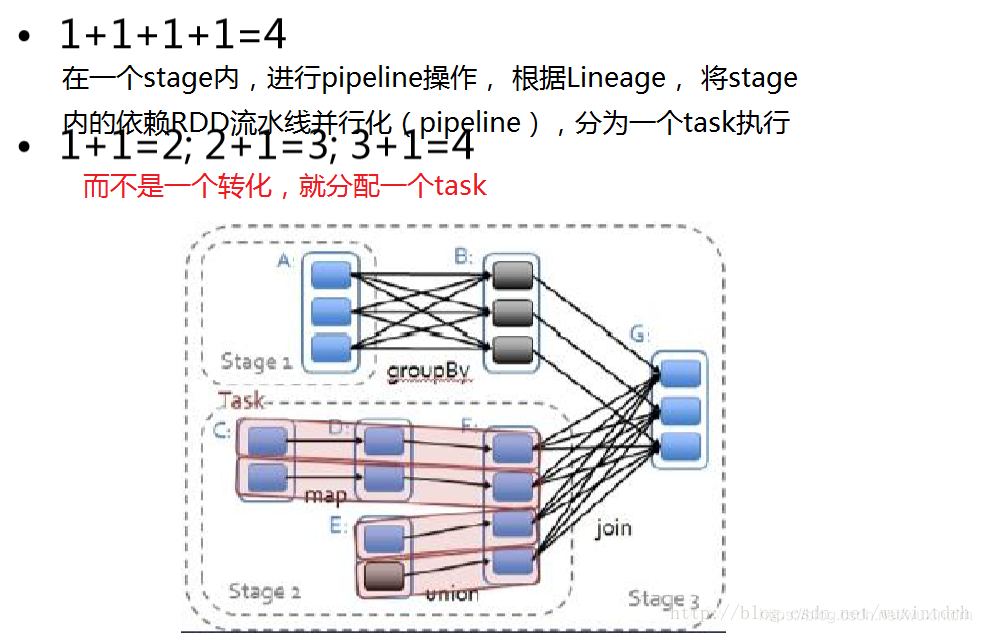
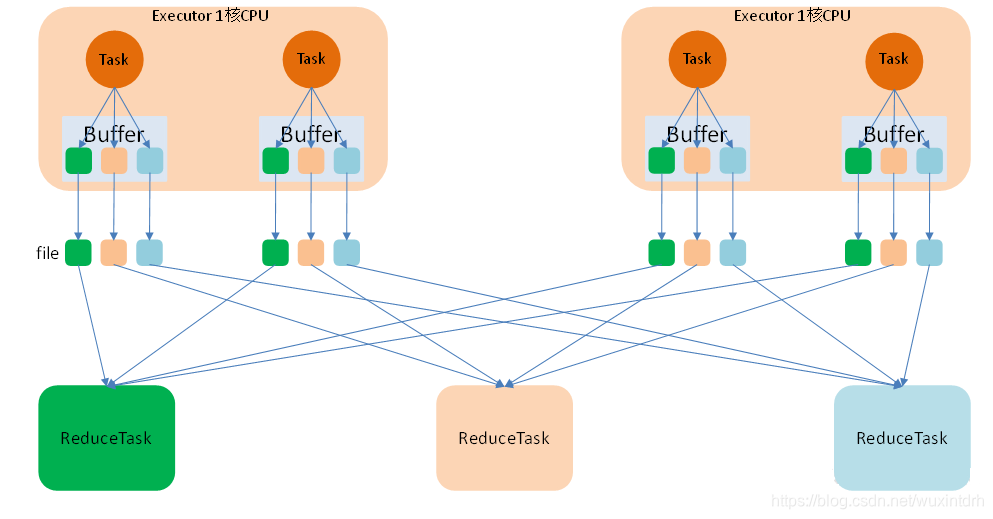
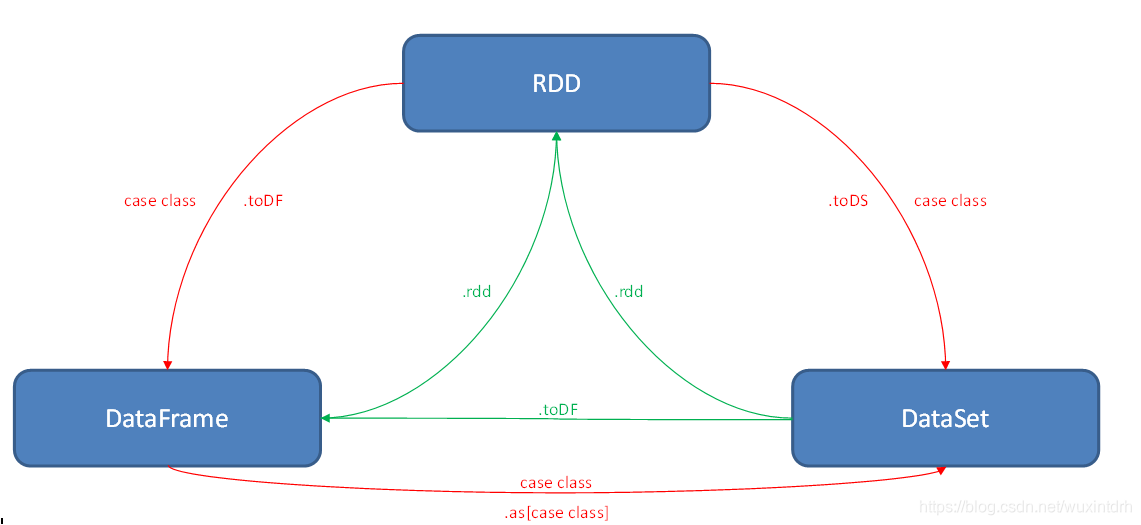
# 一、Spark ### 1.1 Spark有几种部署方式?请分别简要论述 - 1)Local:运行在一台机器上,通常是练手或者测试环境。 - 2)Standalone:构建一个基于Mster+Slaves的资源调度集群,Spark任务提交给Master运行。是Spark自身的一个调度系统。 - 3)Yarn: Spark客户端直接连接Yarn,不需要额外构建Spark集群。有yarn-client和yarn-cluster两种模式,主要区别在于:Driver程序的运行节点。 - 4)Mesos:国内大环境比较少用。 ### 1.2 Spark任务使用什么进行提交,javaEE界面还是脚本 Shell 脚本。 ### 1.3 Spark提交作业参数(重点) 1)在提交任务时的几个重要参数 - executor-cores —— 每个executor使用的内核数,默认为1,官方建议2-5个,我们企业是4个 - num-executors —— 启动executors的数量,默认为2 - executor-memory —— executor内存大小,默认1G - driver-cores —— driver使用内核数,默认为1 - driver-memory —— driver内存大小,默认512M 2)边给一个提交任务的样式 ```shell spark-submit \ --master local\[5\] \ --driver-cores 2 \ --driver-memory 8g \ --executor-cores 4 \ --num-executors 10 \ --executor-memory 8g \ --class PackageName.ClassName XXXX.jar \ --name "Spark Job Name" \ InputPath \ OutputPath ``` ### 1.4 简述Spark的架构与作业提交流程(画图讲解,注明各个部分的作用)(重点) 参考: https://blog.csdn.net/wuxintdrh/article/details/70956686 #### 1.4.1、standlone ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210620220315942.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) #### 1.4.2、yarn-cluster ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210620220419919.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ### 1.5 如何理解Spark中的血统概念(RDD)(笔试重点) 参考:https://blog.csdn.net/wuxintdrh/article/details/70840323 `RDD`在`Lineage`依赖方面分为两种`Narrow Dependencies`与`Wide Dependencies`用来解决数据容错时的高效性以及划分任务时候起到重要作用。 ### 1.6 简述Spark的宽窄依赖,以及Spark如何划分stage,每个stage又根据什么决定task个数? (笔试重点) Stage:根据RDD之间的依赖关系的不同将Job划分成不同的Stage,遇到一个宽依赖则划分一个Stage。 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210620220618234.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) Task:Stage是一个TaskSet,将Stage根据分区数划分成一个个的Task。 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210620220643695.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ### 1.7 请列举Spark的transformation算子(不少于8个),并简述功能(重点) **参考: https://blog.csdn.net/wuxintdrh/article/details/80815731** 1)map(func):返回一个新的RDD,该RDD由每一个输入元素经过func函数转换后组成. 2)mapPartitions(func):类似于map,但独立地在RDD的每一个分片上运行,因此在类型为T的RD上运行时,func的函数类型必须是Iterator\[T\] => Iterator\[U\]。假设有N个元素,有M个分区,那么map的函数的将被调用N次,而mapPartitions被调用M次,一个函数一次处理所有分区。 3)reduceByKey(func,\[numTask\]):在一个(K,V)的RDD上调用,返回一个(K,V)的RDD,使用定的reduce函数,将相同key的值聚合到一起,reduce任务的个数可以通过第二个可选的参数来设置。 4)aggregateByKey (zeroValue:U,\[partitioner: Partitioner\]) (seqOp: (U, V) => U,combOp: (U, U) => U: 在kv对的RDD中,,按key将value进行分组合并,合并时,将每个value和初始值作为seq函数的参数,进行计算,返回的结果作为一个新的kv对,然后再将结果按照key进行合并,最后将每个分组的value传递给combine函数进行计算(先将前两个value进行计算,将返回结果和下一个value传给combine函数,以此类推),将key与计算结果作为一个新的kv对输出。 5)combineByKey(createCombiner: V=>C, mergeValue: (C, V) =>C, mergeCombiners: (C, C) =>C): 对相同K,把V合并成一个集合。 1.createCombiner: combineByKey() 会遍历分区中的所有元素,因此每个元素的键要么还没有遇到过,要么就和之前的某个元素的键相同。如果这是一个新的元素,combineByKey()会使用一个叫作createCombiner()的函数来创建那个键对应的累加器的初始值 2.mergeValue: 如果这是一个在处理当前分区之前已经遇到的键,它会使用mergeValue()方法将该键的累加器对应的当前值与这个新的值进行合并 3.mergeCombiners: 由于每个分区都是独立处理的, 因此对于同一个键可以有多个累加器。如果有两个或者更多的分区都有对应同一个键的累加器, 就需要使用用户提供的 mergeCombiners() 方法将各个分区的结果进行合并。 … 根据自身情况选择比较熟悉的算子加以介绍。 ### 1.8 请列举Spark的action算子(不少于6个),并简述功能(重点) **参考: https://blog.csdn.net/wuxintdrh/article/details/80815731** 1)reduce: 2)collect: 3)first: 4)take: 5)aggregate: 6)countByKey: 7)foreach: 8)saveAsTextFile: ### 1.9 请列举会引起Shuffle过程的Spark算子,并简述功能。 reduceBykey: groupByKey: … ByKey: ### 1.10 简述Spark的两种核心Shuffle(HashShuffle与SortShuffle)的工作流程(包括未优化的HashShuffle、优化的HashShuffle、普通的SortShuffle与bypass的SortShuffle)(重点) 未经优化的HashShuffle: ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210620221116623.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) 优化后的Shuffle: ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210620221221471.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) 普通的SortShuffle: ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210620221316761.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) 当 `shuffle read task` 的 数 量 小 于 等 于 `spark.shuffle.sort`。 `bypassMergeThreshold` 参数的值时(默认为 200),就会**启用 bypass 机制**。 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210620221412460.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70#pic_center) ### 1.11 Spark常用算子reduceByKey与groupByKey的区别,哪一种更具优势?(重点) reduceByKey:按照key进行聚合,**在shuffle之前有combine(预聚合)操作**,返回结果是RDD\[k,v\]。 groupByKey:按照key进行分组,直接进行shuffle。 开发指导:reduceByKey比groupByKey,建议使用。但是需要注意是否会影响业务逻辑。 ### 1.12 Repartition和Coalesce关系与区别 1)关系: 两者都是用来改变RDD的partition数量的,repartition底层调用的就是coalesce方法:`coalesce(numPartitions, shuffle = true)` 2)区别: **repartition一定会发生shuffle,coalesce根据传入的参数来判断是否发生shuffle** 一般情况下 - 增大rdd的partition数量使用repartition - 减少partition数量时使用coalesce ### 1.13 分别简述Spark中的缓存机制(cache和persist)与checkpoint机制,并指出两者的区别与联系 都是做RDD持久化的 `cache`:内存,不会截断血缘关系,使用计算过程中的数据缓存。 `checkpoint`:磁盘,**截断血缘关系**,在ck之前必须没有任何任务提交才会生效,ck过程会额外提交一次任务。 ### 1.14 简述Spark中共享变量(广播变量和累加器)的基本原理与用途。(重点) **累加器(accumulator)**是Spark中提供的一种分布式的变量机制,其原理类似于mapreduce,即分布式的改变,然后聚合这些改变。累加器的一个常见用途是在调试时对作业执行过程中的事件进行计数。而广播变量用来高效分发较大的对象。 共享变量出现的原因: 通常在向 Spark 传递函数时,比如使用 map() 函数或者用 filter() 传条件时,可以使用驱动器程序中定义的变量,但是集群中运行的每个任务都会得到这些变量的一份新的副本,更新这些副本的值也不会影响驱动器中的对应变量。 Spark的两个共享变量,累加器与广播变量,分别为结果聚合与广播这两种常见的通信模式突破了这一限制。 ### 1.15 当Spark涉及到数据库的操作时,如何减少Spark运行中的数据库连接数? 使用foreachPartition代替foreach,在foreachPartition内获取数据库的连接。 ### 1.16 简述SparkSQL中RDD、DataFrame、DataSet三者的区别与联系? (笔试重点) **1)RDD** 优点: - 编译时类型安全 - 编译时就能检查出类型错误 - 面向对象的编程风格 - 直接通过类名点的方式来操作数据 缺点: - 序列化和反序列化的性能开销 - 无论是集群间的通信, 还是IO操作都需要对对象的结构和数据进行序列化和反序列化。 - GC的性能开销,频繁的创建和销毁对象, 势必会增加GC **2)DataFrame** DataFrame引入了`schema`和`off-heap` schema : RDD每一行的数据, 结构都是一样的,这个结构就存储在schema中。 Spark通过schema就能够读懂数据, 因此在通信和IO时就只需要序列化和反序列化数据, 而结构的部分就可以省略了。 **3)DataSet** DataSet结合了RDD和DataFrame的优点,并带来的一个新的概念`Encoder`。 当序列化数据时,Encoder产生字节码与off-heap进行交互,能够达到按需访问数据的效果,而不用反序列化整个对象。Spark还没有提供自定义Encoder的API,但是未来会加入。 **三者之间的转换:** ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210620222320481.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ### 1.17 SparkSQL中join操作与left join操作的区别? join和sql中的inner join操作很相似,返回结果是前面一个集合和后面一个集合中匹配成功的,过滤掉关联不上的。 leftJoin类似于SQL中的左外关联left outer join,返回结果以第一个RDD为主,关联不上的记录为空。 部分场景下可以使用left semi join替代left join: 因为 left semi join 是 in(keySet) 的关系,**遇到右表重复记录,左表会跳过****,****性能更高**,而 left join 则会一直遍历。**但是left semi join 中最后 select 的结果中只许出现左表中的列名**,因为右表只有 join key 参与关联计算了 ### 1.18 请手写出wordcount的Spark代码实现(Scala)(手写代码重点) ```scala val conf: SparkConf = new SparkConf().setMaster("local\[*\]").setAppName("WordCount") val sc = new SparkContext(conf) sc.textFile("/input") .flatMap(_.split(" ")) .map((_,1)) .reduceByKey(_+_) .saveAsTextFile("/output") sc.stop() ``` ### 1.19、 如何使用[Spark实现topN](https://blog.csdn.net/wuxintdrh/article/details/72810306)的获取(描述思路或使用伪代码)(重点) 方法1: - (1)按照key对数据进行聚合(groupByKey) - (2)将value转换为数组,利用scala的sortBy或者sortWith进行排序(mapValues)数据量太大,会OOM。 方法2: - (1)取出所有的key - (2)对key进行迭代,每次取出一个key利用spark的排序算子进行排序 方法3: - (1)自定义分区器,按照key进行分区,使不同的key进到不同的分区 - (2)对每个分区运用spark的排序算子进行排序 ### 1.20 京东:调优之前与调优之后性能的详细对比(例如调整map个数,map个数之前多少、之后多少,有什么提升) 这里举个例子。比如我们有几百个文件,会有几百个map出现,读取之后进行join操作,会非常的慢。这个时候我们可以进行coalesce操作,比如240个map,我们合成60个map,也就是窄依赖。这样再shuffle,过程产生的文件数会大大减少。提高join的时间性能。 # 二、SparkStreaming 参考: https://chbxw.blog.csdn.net/article/details/80809898 ### 2.1、 SparkStreaming有哪几种方式消费Kafka中的数据,它们之间的区别是什么? **1、基于Receiver的方式** 这种方式使用Receiver来获取数据。Receiver是使用Kafka的高层次Consumer API来实现的。receiver从Kafka中获取的数据都是存储在Spark Executor的内存中的(如果突然数据暴增,大量batch堆积,很容易出现内存溢出的问题),然后Spark Streaming启动的job会去处理那些数据。 然而,在默认的配置下,这种方式可能会因为底层的失败而丢失数据。如果要启用高可靠机制,让数据零丢失,就必须启用Spark Streaming的预写日志机制(Write Ahead Log,WAL)。该机制会同步地将接收到的Kafka数据写入分布式文件系统(比如HDFS)上的预写日志中。所以,即使底层节点出现了失败,也可以使用预写日志中的数据进行恢复。 **2、基于Direct的方式** 这种新的不基于Receiver的直接方式,是在Spark 1.3中引入的,从而能够确保更加健壮的机制。替代掉使用Receiver来接收数据后,这种方式会周期性地查询Kafka,来获得每个topic+partition的最新的offset,从而定义每个batch的offset的范围。当处理数据的job启动时,就会使用Kafka的简单consumer api来获取Kafka指定offset范围的数据。 **优点如下**: **简化并行读取**:如果要读取多个partition,不需要创建多个输入DStream然后对它们进行union操作。Spark会创建跟Kafka partition一样多的RDD partition,并且会并行从Kafka中读取数据。所以在Kafka partition和RDD partition之间,有一个一对一的映射关系。 **高性能**:如果要保证零数据丢失,在基于receiver的方式中,需要开启WAL机制。这种方式其实效率低下,因为数据实际上被复制了两份,Kafka自己本身就有高可靠的机制,会对数据复制一份,而这里又会复制一份到WAL中。而基于direct的方式,不依赖Receiver,不需要开启WAL机制,只要Kafka中作了数据的复制,那么就可以通过Kafka的副本进行恢复。 **一次且仅一次的事务机制**。 **3、对比:** 基于receiver的方式,是使用Kafka的高阶API来在ZooKeeper中保存消费过的offset的。这是消费Kafka数据的传统方式。这种方式配合着WAL机制可以保证数据零丢失的高可靠性,但是却无法保证数据被处理一次且仅一次,可能会处理两次。因为Spark和ZooKeeper之间可能是不同步的。 基于direct的方式,使用kafka的简单api,Spark Streaming自己就负责追踪消费的offset,并保存在checkpoint中。Spark自己一定是同步的,因此可以保证数据是消费一次且仅消费一次。 **在实际生产环境中大都用Direct方式** ### 2.2 简述SparkStreaming窗口函数的原理(重点) 窗口函数就是在原来定义的SparkStreaming计算批次大小的基础上再次进行封装,每次计算多个批次的数据,同时还需要传递一个滑动步长的参数,用来设置当次计算任务完成之后下一次从什么地方开始计算。 图中time1就是SparkStreaming计算批次大小,虚线框以及实线大框就是窗口的大小,必须为批次的整数倍。虚线框到大实线框的距离(相隔多少批次),就是滑动步长。 # 三、SparkSQL # 关注我的公众号【宝哥大数据】,更多干货 ![在这里插入图片描述](https://img-blog.csdnimg.cn/2021062022354047.png)
优秀的个人博客,低调大师

【技术原理】网络IO模型分析介绍(下)

每日努力 请一定要有自信。你就是一道风景,没必要在别人风景里面仰视。 网络IO模型的分类 BIO 伪异步 NIO AIO BIO BIO是一个典型的网络编程模型,是通常我们实现一个服务端程序的过程。 步骤如下 主线程accept请求阻塞 请求到达,创建新的线程来处理这个套接字,完成对客户端的响应。 主线程继续accept下一个请求 这种模型有一个很大的问题是:当客户端连接增多时,服务端创建的线程也会暴涨,系统性能会急剧下降。 伪异步(线程池模式的BIO) 在BIO模型的基础上,类似于tomcat的bio connector,采用的是线程池来避免对于每一个客户端都创建一个线程:把请求抛到线程池中异步等待处理。 NIO(非阻塞机制) NIO API主要是三个部分:缓冲区(Buffers)、通道(Channels)和 Selector。 NIO基于事件驱动思想来实现的,它采用Reactor模式实现,主要用来解决BIO模型中一个服务端无法同时并发处理大量客户端连接的问题。 NIO基于Selector(事件循环器)进行轮训,当socket有数据可读、可写、连接完成、新的TCP请求接入事件时,操作系统内核会触发(通过JNI回调给Java线程栈中的方法栈帧),Selector返回准备就绪的SelectionKey集合,通过SelectableChannel进行读写操作。(通过SelectionKey作为事件的标志字段) 由于JDK的Selector底层基于epoll实现,理论可以同时处理操作系统最大文件句柄个数的连接。 SelectableChannel 的读写操作都是=非阻塞的,当由于数据没有就绪导致读半包时(数据准备阶段),立即返回,不会同步阻塞等待数据就绪,当TCP缓冲区数据就绪之后,会触发Selector的读事件,驱动下一次读操作。 因此,一个Reactor线程就可以同时处理N个客户端的连接,使得Java服务器的并发读写能力得到极大的提升。 JDK1.4开始引入了NIO类库,这里的NIO指的是Non-block IO,主要是使用Selector多路复用器来实现。Selector在Linux等主流操作系统上是通过epoll实现的。 NIO的实现流程,类似于select: 创建ServerSocketChannel监听客户端连接并绑定监听端口,设置为非阻塞模式。 创建Reactor线程,创建多路复用器(Selector)并启动线程。 将ServerSocketChannel注册到Reactor线程的Selector上。监听accept事件。 Selector在线程run方法中无线循环轮询准备就绪的Key。 Selector监听到新的客户端接入,处理新的请求,完成tcp三次握手,建立物理连接。 将新的客户端连接注册到Selector上,监听读操作。读取客户端发送的网络消息。 客户端发送的数据就绪则读取客户端请求,进行处理。 AIO JDK1.7引入NIO2.0,提供了异步文件通道和异步套接字通道的实现。其底层在windows上是通过IOCP,在Linux上是通过epoll来实现的 LinuxAsynchronousChannelProvider.java, UnixAsynchronousServerSocketChannelImpl.java 创建AsynchronousServerSocketChannel,绑定监听端口 调用AsynchronousServerSocketChannel的accept方法,传入自己实现的CompletionHandler。包括上一步,都是非阻塞的 连接传入,回调CompletionHandler的completed方法,在里面,调用AsynchronousSocketChannel的read方法,传入负责处理数据的CompletionHandler。 数据就绪,触发负责处理数据的CompletionHandler的completed方法。继续做下一步处理即可。写入操作类似,也需要传入CompletionHandler。 同步和异步 这两个概念与消息的通知机制 (synchronous communication/ asynchronous communication)有关。 同步 一个任务的完成需要依赖另外一个任务时,只有等待被依赖的任务完成后,依赖的任务才能算完成,这是一种可靠的任务序列。要么都成功,要么都失败,两个任务的状态可以保持一致。 在发出一个调用时,在没有得到结果之前,该调用就不返回。但是一旦调用返回,就得到返回值了。换句话说,就是由调用者主动等待这个调用的结果。 对于同步型的调用,应用层需要自己去向系统内核问询,如果数据还未读取完毕,那此时读取文件的任务还未完成。 应用层根据其阻塞和非阻塞的划分,或挂起或去做其他事情(所以同步和异步并不决定其等待数据返回时的状态); 如果数据已经读取完毕,那此时系统内核将数据返回给应用层,应用层即可以用取得的数据做其他相关的事情。 异步 不需要等到被依赖的任务完成,只是通知被依赖的任务要完成什么工作,依赖的任务也立即执行,只要自己完成了整个任务就算完成了。至于被依赖的任务最终是否真正完成,依赖它的任务无法确定,所以它是不可靠的任务序列。 调用在发出之后,这个调用就直接返回了,所以没有返回结果。 换句话说,当一个异步过程调用发出后,调用者不会立刻得到结果。 而是在调用发出后,被调用者通过状态、通知来通知调用者,或通过回调函数处理这个调用。 而对于异步型的调用,应用层无需主动向系统内核问询,在系统内核读取完文件数据之后,会主动通知应用层数据已经读取完毕,此时应用层即可以接收系统内核返回过来的数据,再做其他事情。也就是说,是否是同步还是异步,关注的是任务完成时消息通知的方式。由调用方盲目主动问询的方式是同步调用,由被调用方主动通知调用方任务已完成的方式是异步调用。 消息的三种通知机制:状态、通知和回调。 前者低效,后两者高效、类似。 阻塞与非阻塞 这两个概念与程序(线程)等待消息通知(无所谓同步或者异步)时的状态有关。 阻塞调用 调用结果返回之前,当前线程会被挂起,一直处于等待消息通知,不能够执行其他业务。函数只有在得到结果之后才会返回。 非阻塞调用 指在不能立刻得到结果之前,该函数不会阻塞当前线程,而会立刻返回去完成其他任务。 总结来说,是否是阻塞还是非阻塞,关注的是接口调用(发出请求)后等待数据返回时的状态。被挂起无法执行其他操作的则是阻塞型的,可以被立即「抽离」去完成其他「任务」的则是非阻塞型的。 阻塞和同步的讨论 有人也许会把阻塞调用和同步调用等同起来,实际上它们是不同的。 对于同步调用来说,很多时候当前线程可能还是激活的,只是从逻辑上当前函数没有返回而已,此时,这个线程可能也会处理其他的消息。还有一点,在这里先扩展下: 如果这个线程在等待当前函数返回时,仍在执行其他消息处理,那这种情况就叫做同步非阻塞; 如果这个线程在等待当前函数返回时,没有执行其他消息处理,而是处于挂起等待状态,那这种情况就叫做同步阻塞; 所以同步的实现方式会有两种:同步阻塞、同步非阻塞;同理,异步也会有两种实现:异步阻塞、异步非阻塞; 对于阻塞调用来说,则当前线程就会被挂起等待当前函数返回; 虽然表面上看非阻塞的方式可以明显的提高CPU的利用率,但是也带了另外一种后果就是系统的线程切换增加。增加的CPU执行时间能不能补偿系统的切换成本需要好好评估。 同步异步/阻塞非阻塞 在说明synchronous IO和asynchronous IO的区别之前,需要先给出两者的定义。Stevens给出的定义(其实是POSIX的定义)是这样子的: A synchronous I/O operation causes the requesting process to be blocked until that I/O operation completes; An asynchronous I/O operation does not cause the requesting process to be blocked; 两者的区别就在于synchronous IO做”IO operation”的时候会将process阻塞。按照这个定义,之前所述的blocking IO,non-blocking IO,IO multiplexing都属于synchronous IO。 有人可能会说,non-blocking IO并没有被block啊。这里有个非常“狡猾”的地方,定义中所指的”IO operation”是指真实的IO操作,就是例子中的recvfrom这个system call。 non-blocking IO在执行recvfrom这个system call的时候,如果kernel的数据没有准备好,这时候不会block进程。 但是,当kernel中数据准备好的时候,recvfrom会将数据从kernel拷贝到用户内存中,这个时候进程是被block了,在这段时间内,进程是被block的。 而asynchronous IO则不一样,当进程发起IO 操作之后,就直接返回再也不理睬了,直到kernel发送一个信号,告诉进程说IO完成。在这整个过程中,进程完全没有被block。 同步异步/阻塞非阻塞 "同步异步"和"阻塞非阻塞"是两个不同范围的概念。 synchronous / asynchronous is to describe the relation between two modules. blocking / non-blocking is to describe the situation of one module. An example: "I": a "bookstore" : b a asks b: do you have a book named "c++ primer"? blocking: before b answers a, a keeps waiting there for the answer. Now a (one module) is blocking. a and b are two threads or two processes or one thread or one process? we DON'T know. non-blocking: before b answers a, a just leaves there and every two minutes, a comes here for looking for the answer. Here a (one module) is non-blocking. a and b are two threads or two processes or one process? we DON'T know. BUT we are sure that a and b couldn't be one thread. synchronous: before b answers a, a keeps waiting there for the answer. It means that a can't continue until b finishes its job. Now we say: a and b (two modules) is synchronous. a and b are two threads or two processes or one thread or one process? we DON'T know. asynchronous: before b answers a, a leaves there and a can do other jobs. When b gets the answer, b will call a: hey! I have it! Then a will come to b to get the book when a is free. Now we say: a and b (two modules) is asynchronous. a and b are two threads or two processes or one process? we DON'T know. BUT we are sure that a and b couldn't be one thread. 同步异步/阻塞非阻塞 同步和异步是一个非常广的概念,它们的重点在于多个任务和事件发生时,一个事件的发生或执行是否会导致整个流程的暂时等待。 阻塞和非阻塞的区别关键在于当发出请求一个操作时,如果条件不满足,是会一直等待还是返回一个标志信息。 在讨论IO(硬盘、网络、外设)时,一个完整的IO读请求操作包括两个阶段: 1)查看数据是否就绪; 2)进行数据拷贝(内核将数据拷贝到用户线程) 阻塞(blocking IO)和非阻塞(non-blocking IO)的区别就在于第一个阶段,如果数据没有就绪,在查看数据是否就绪的过程中是一直等待,还是直接返回一个标志信息。 在《Unix网络编程》一书中对同步IO和异步IO的定义是这样的: 事实上,同步IO和异步IO模型是针对用户线程和内核的交互来说的: 同步IO:当用户发出IO请求操作之后,如果数据没有就绪,需要通过用户线程或者内核不断地去轮询数据是否就绪,当数据就绪时,再将数据从内核拷贝到用户线程; 异步IO:只有IO请求操作的发出是由用户线程来进行的,IO操作的两个阶段都是由内核自动完成,然后发送通知告知用户线程IO操作已经完成。也就是说在异步IO中,不会对用户线程产生任何阻塞。 这是同步IO和异步IO关键区别所在,同步IO和异步IO的关键区别反映在数据拷贝阶段是由用户线程完成还是内核完成。 所以说<u>异步IO必须要有操作系统的底层支持</u>。 注意同步IO和异步IO与阻塞IO和非阻塞IO是不同的两组概念。 阻塞IO和非阻塞IO是反映在当用户请求IO操作时,如果数据没有就绪,是用户线程一直等待数据就绪,还是会收到一个标志信息这一点上面的。也就是说,阻塞IO和非阻塞IO是反映在IO操作的第一个阶段,在查看数据是否就绪时是如何处理的。 同步/异步与阻塞/非阻塞 同步阻塞:效率是最低的。 异步阻塞:异步操作是可以被阻塞住的,只不过它不是在处理消息时阻塞,而是在等待消息通知时被阻塞。 同步非阻塞:实际上是效率低下的,这个程序需要在两种不同的行为之间来回的切换,效率可想而知是低下的。 异步非阻塞:效率更高。 用户空间与内核空间 现在操作系统都是采用虚拟存储器,对32位操作系统而言,它的寻址空间(虚拟存储空间)为4G(2的32次方)。 操作系统的核心是内核,独立于普通的应用程序,可以访问受保护的内存空间,也有访问底层硬件设备的所有权限。 为了保证用户进程不能直接操作内核(kernel),保证内核的安全,操作系统将虚拟空间划分为两部分,一部分为内核空间,一部分为用户空间。 针对linux操作系统而言,将最高的1G字节(从虚拟地址0xC0000000到0xFFFFFFFF),供内核使用,称为内核空间,而将较低的3G字节(从虚拟地址0x00000000到0xBFFFFFFF),供各个进程使用,称为用户空间。 进程切换 为了控制进程的执行,内核必须有能力挂起正在CPU上运行的进程,并恢复以前挂起的某个进程的执行。这种行为被称为进程切换/任务切换/上下文切换。因此可以说,任何进程都是在操作系统内核的支持下运行的,是与内核紧密相关的。 从一个进程的运行转到另一个进程上运行,这个过程中经过下面这些变化: 保存处理机上下文,包括程序计数器和其他寄存器。 更新PCB信息。 把进程的PCB移入相应的队列,如就绪、在某事件阻塞等队列。 选择另一个进程执行,并更新其PCB。 更新内存管理的数据结构。 恢复处理机上下文。 进程的阻塞 正在执行的进程,由于期待的某些事件未发生,如请求系统资源失败、等待某种操作的完成、新数据尚未到达或无新工作做等,则由系统自动执行阻塞原语(Block),使自己由运行状态变为阻塞状态。可见,进程的阻塞是进程自身的一种主动行为,也因此只有处于运行态的进程(获得CPU),才可能将其转为阻塞状态。当进程进入阻塞状态,是不占用CPU资源的。 文件描述符fd 文件描述符(File descriptor)是计算机科学中的一个术语,是一个用于表述指向文件的引用的抽象化概念。 文件描述符在形式上是一个非负整数。实际上,它是一个索引值,指向内核为每一个进程所维护的该进程打开文件的记录表。当程序打开一个现有文件或者创建一个新文件时,内核向进程返回一个文件描述符。在程序设计中,一些涉及底层的程序编写往往会围绕着文件描述符展开。但是文件描述符这一概念往往只适用于UNIX、Linux这样的操作系统。 缓存 IO 缓存 IO 又被称作标准 IO,大多数文件系统的默认 IO 操作都是缓存 IO。在 Linux 的缓存 IO 机制中,操作系统会将IO的数据缓存在文件系统的页缓存( page cache )中,也就是说,数据会先被拷贝到操作系统内核的缓冲区中,然后才会从操作系统内核的缓冲区拷贝到应用程序的地址空间。 缓存 IO 的缺点 数据在传输过程中需要在应用程序地址空间和内核进行多次数据拷贝操作,这些数据拷贝操作所带来的CPU 以及内存开销是非常大的。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册