阿里重磅发布 Qwen3-Embedding 和 Qwen3-Reranker 两个知识库领域的新模型系列
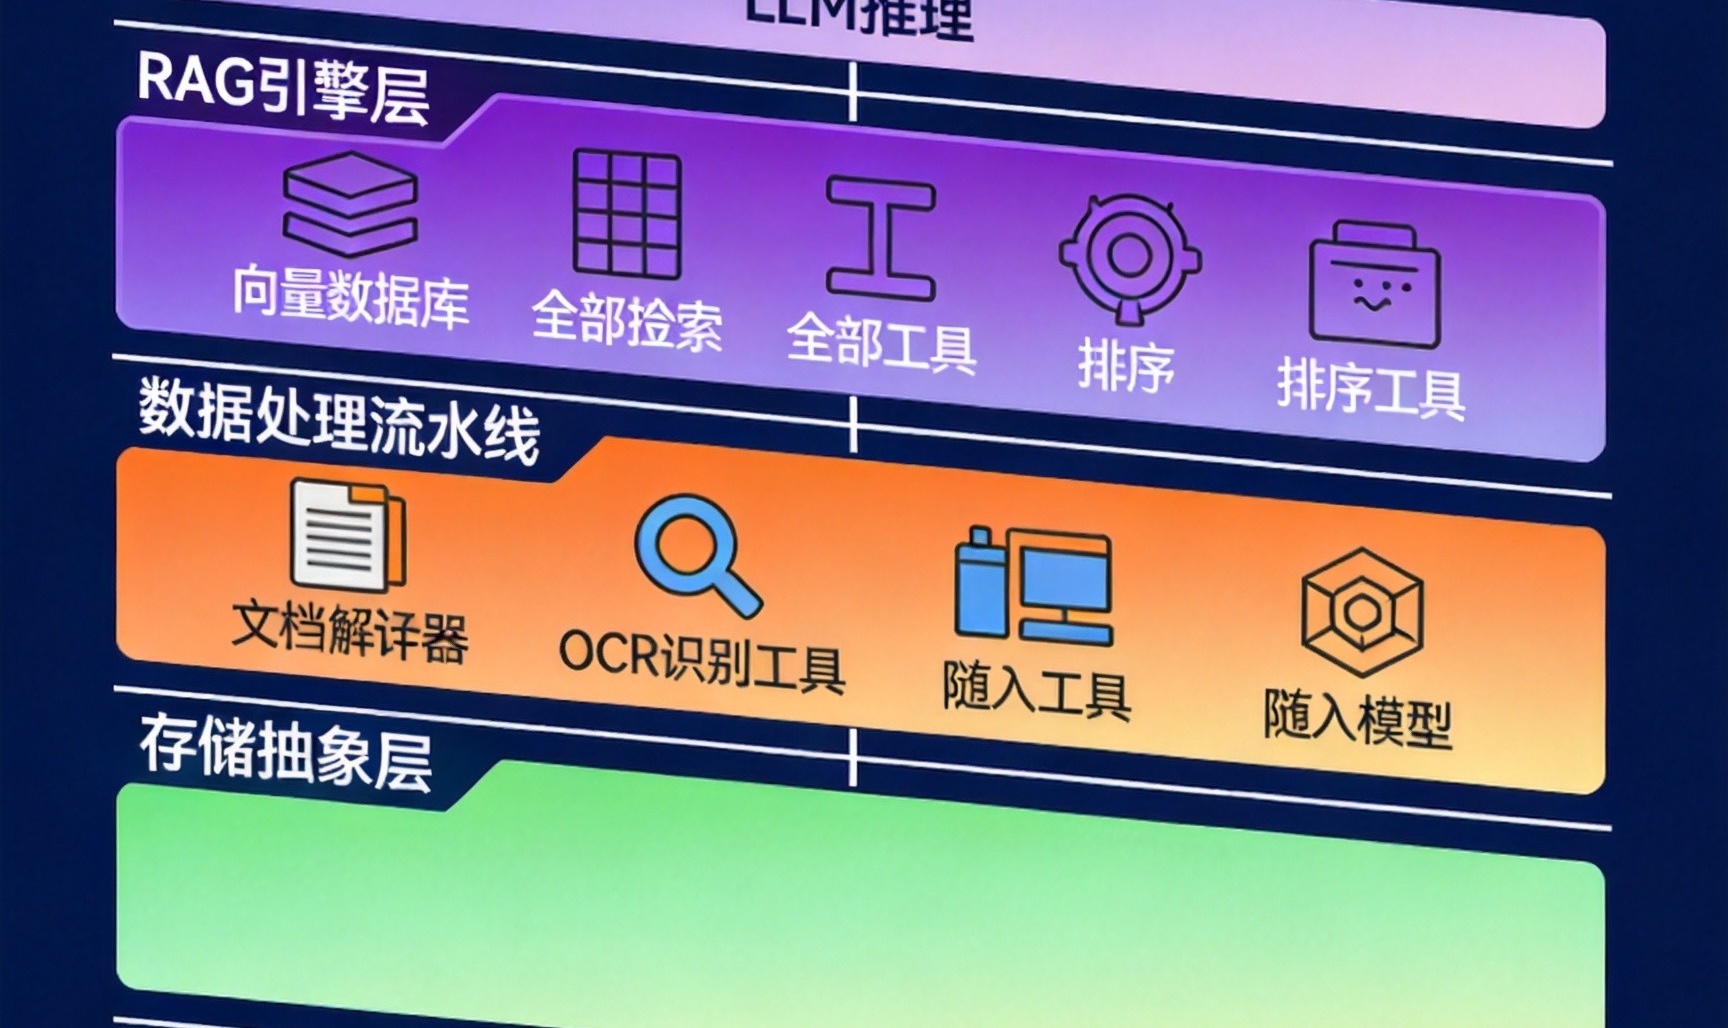
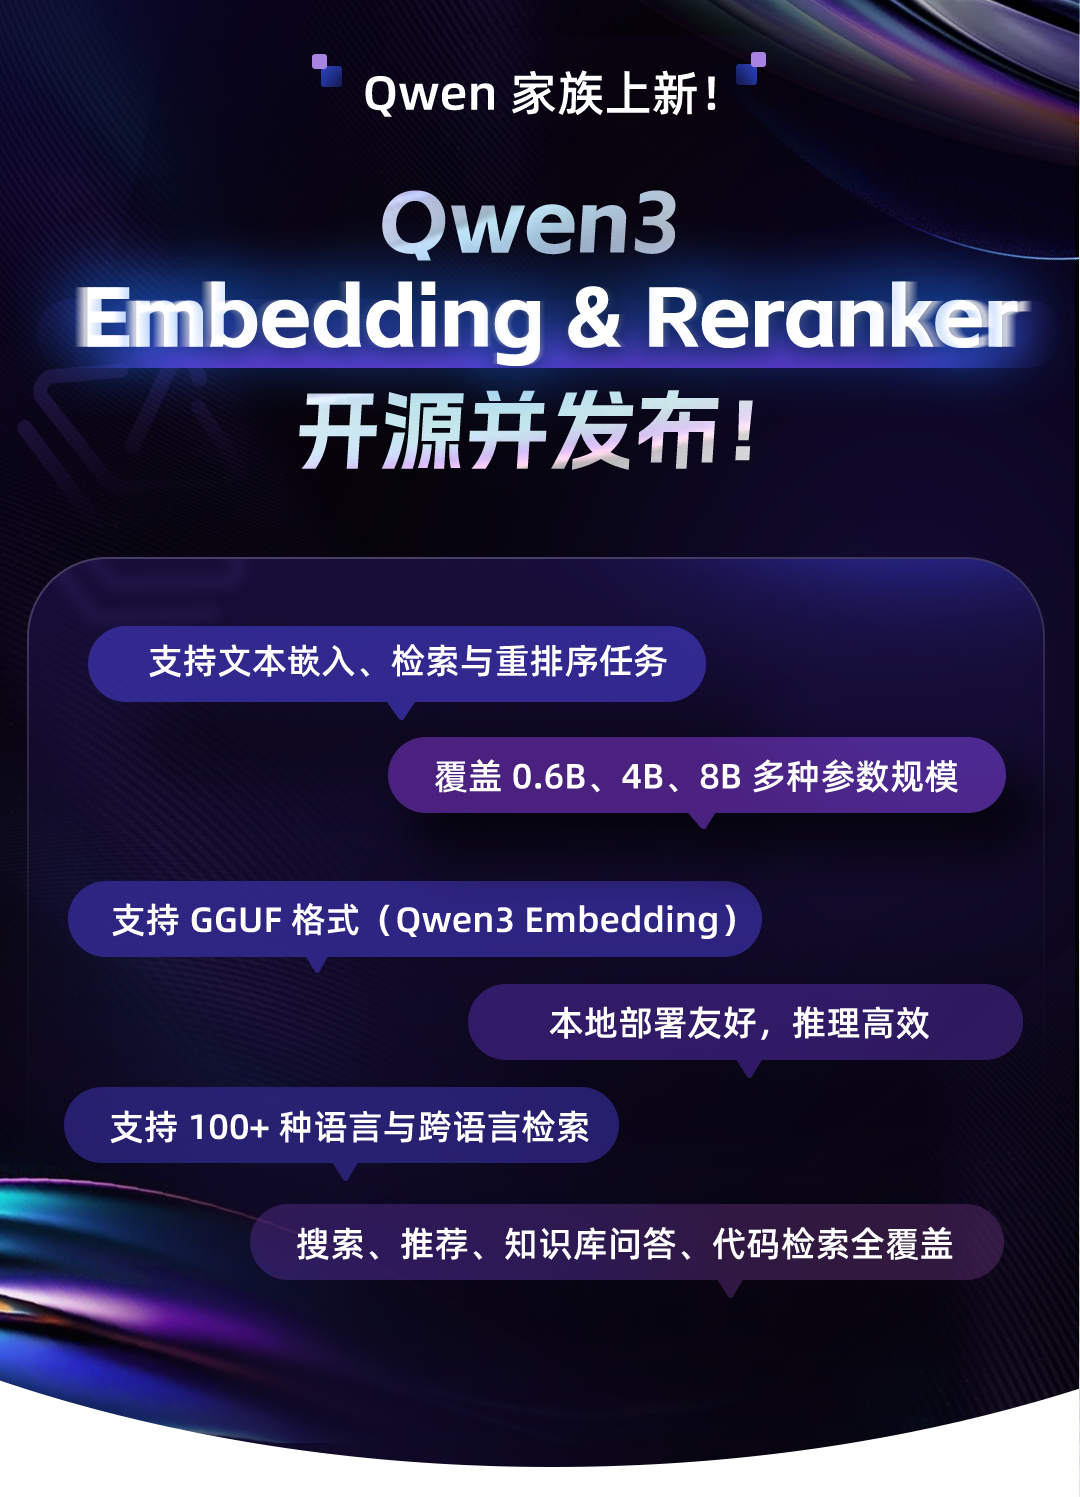
Qwen3 Embedding 是基于 Qwen3 基础模型训练的文本嵌入模型系列,能够将离散的、高维的符号(如文字、图片、声音等)转化为低维、连续的数字向量(Vector)的转化技术。通过捕捉不同数据点在嵌入空间中的距离远近,它能挖掘出它们之间隐藏的语义关系。 这样,模型就可以在不真正“理解”语言的前提下,通过数学运算模拟出对语言的理解能力 —— 让模型“算得更少,懂得更多”。 📌 举个例子 假设我们有三句话: “苹果手机真好用” “我有一部 iPhone” “今天天气不错” Qwen3 Embedding 会将这些句子转化为数字向量。其中,“苹果手机真好用”和“我有一部 iPhone”在语义上很接近,所以它们的向量也十分相似;而“今天天气不错”和它们表达的内容差别较大,因此在向量空间中距离更远。 通过这种方式,AI 就能自动判断内容的相关性,为搜索、推荐、聚类等任务提供有力支持。 如果说 Qwen3 Embedding 是“初筛”,那 Qwen3 Reranker 就是“精排” —— 它是专门用于提升搜索和推荐系统相关性排序能力的模型。 它的任务是判断两个文本之间的相关性有多高。比如在搜索引擎中,用户输入一个查询词后,系统会先通过 Embedding 模型快速选出一批可能相关的文档,但这些结果的质量参差不齐。这时,Qwen3 Reranker 会对他们进行精细化打分和排序,把最相关的结果排到前面。 📌 举个例子 当你搜索:什么是量子计算? 系统先用 Embedding 模型从大量文档中找出几篇可能相关的文章,比如: 《量子计算的基本原理》 《计算机发展简史》 《量子力学入门知识》 这三篇文章都包含关键词,但从内容来看,第 2 篇明显和“量子计算”关系较远。 Qwen3 Reranker 会为每篇文章打分: 第 1 篇:0.95(非常相关) 第 3 篇:0.80(有一定关联) 第 2 篇:0.30(不太相关) 最终,系统根据这个得分重新排序,优先展示最相关的内容。 卓越的泛化性: Qwen3-Embedding 系列在多个下游任务评估中达到行业领先水平。其中,8B 参数规模的 Embedding 模型在 MTEB 多语言 Leaderboard 榜单中位列第一(截至2025年6月6日,得分70.58),性能超越众多商业API服务。此外,该系列的排序模型在各类文本检索场景中表现出色,显著提升了搜索结果的相关性。 灵活的模型架构: Qwen3-Embedding 系列提供从 0.6B 到 8B 参数规模的3种模型配置,以满足不同场景下的性能与效率需求。开发者可以灵活组合表征与排序模块,实现功能扩展。 此外,模型支持以下定制化特性: 1) 表征维度自定义:允许用户根据实际需求调整表征维度,有效降低应用成本; 2) 指令适配优化:支持用户自定义指令模板,以提升特定任务、语言或场景下的性能表现。 全面的多语言支持: Qwen3-Embedding 系列支持超过 100 种语言,涵盖主流自然语言及多种编程语言。该系列模型具备强大的多语言、跨语言及代码检索能力,能够有效应对多语言场景下的数据处理需求。 Qwen3 Embedding 基于 Qwen3 强大的语言理解能力构建,采用了双编码器结构,分别处理查询与文档内容,从而提取出高质量的语义向量。这种结构使得模型在进行大规模文本匹配任务时具有更高的效率和更强的泛化能力。 在 Embedding 模型的训练过程中,我们采用三阶段训练架构:第一阶段通过超大规模弱监督数据进行对比学习预训练;第二阶段基于高质量标注数据进行监督训练;最终通过模型融合策略融合多个候选模型,以提升整体性能。这种分阶段训练机制有效平衡了模型的泛化能力与任务适配性。 在 Reranker 模型的训练中,基于实验验证结果,我们直接采用高质量标注数据进行监督训练,以提升训练效率。特别需要说明的是,在 Embedding 模型的第一阶段弱监督训练中,我们构建了多任务适配的 Prompt 体系,利用 Qwen3 基础模型的文本生成能力,我们针对不同任务类型和语言特性,动态生成了一系列弱监督文本对,突破了传统方法依赖社区论坛或开源数据筛选获取弱监督文本对的局限性,实现了大规模弱监督数据的高效生成。 在使用 Qwen3 Embedding-8B 之前,请确保你的 Transformers 库版本 ≥4.51.0 ,否则可能会遇到以下错误: KeyError: 'qwen3' 正确调用方式如下: # Requires transformers>=4.51.0 import torch import torch.nn.functional as F from torch import Tensor from modelscope import AutoTokenizer, AutoModel def last_token_pool(last_hidden_states: Tensor, attention_mask: Tensor) -> Tensor: left_padding = (attention_mask[:, -1].sum() == attention_mask.shape[0]) if left_padding: return last_hidden_states[:, -1] else: sequence_lengths = attention_mask.sum(dim=1) - 1 batch_size = last_hidden_states.shape[0] return last_hidden_states[torch.arange(batch_size, device=last_hidden_states.device), sequence_lengths] def get_detailed_instruct(task_description: str, query: str) -> str: return f'Instruct: {task_description}\nQuery:{query}' def tokenize(tokenizer, input_texts, eod_id, max_length): batch_dict = tokenizer(input_texts, padding=False, truncation=True, max_length=max_length-2) for seq, att in zip(batch_dict["input_ids"], batch_dict["attention_mask"]): seq.append(eod_id) att.append(1) batch_dict = tokenizer.pad(batch_dict, padding=True, return_tensors="pt") return batch_dict # Each query must come with a one-sentence instruction that describes the task task = 'Given a web search query, retrieve relevant passages that answer the query' queries = [ get_detailed_instruct(task, 'What is the capital of China?'), get_detailed_instruct(task, 'Explain gravity') ] # No need to add instruction for retrieval documents documents = [ "The capital of China is Beijing.", "Gravity is a force that attracts two bodies towards each other. It gives weight to physical objects and is responsible for the movement of planets around the sun." ] input_texts = queries + documents tokenizer = AutoTokenizer.from_pretrained('Qwen/Qwen3-Embedding-8B', padding_side='left') model = AutoModel.from_pretrained('Qwen/Qwen3-Embedding-8B') # We recommend enabling flash_attention_2 for better acceleration and memory saving. # model = AutoModel.from_pretrained('Qwen/Qwen3-Embedding-8B', attn_implementation="flash_attention_2", torch_dtype=torch.float16).cuda() eod_id = tokenizer.convert_tokens_to_ids("<|endoftext|>") max_length = 8192 # Tokenize the input texts batch_dict = tokenize(tokenizer, input_texts, eod_id, max_length) batch_dict.to(model.device) outputs = model(**batch_dict) embeddings = last_token_pool(outputs.last_hidden_state, batch_dict['attention_mask']) # normalize embeddings embeddings = F.normalize(embeddings, p=2, dim=1) scores = (embeddings[:2] @ embeddings[2:].T) print(scores.tolist()) 通过这种“初筛 + 精排”的组合,Qwen3 Embedding 与 Qwen3 Reranker 构建了一套完整的语义检索流程,显著提升了搜索、推荐等系统的准确性。 你也可以通过 ModelScope、Hugging Face、GitHub 快速体验,还可以通过阿里云百炼平台(https://www.aliyun.com/product/bailian)提供的最新的文本向量模型服务进行体验和使用。 快速体验 Qwen3-Embedding ➡️ Hugging Face https://huggingface.co/collections/Qwen/qwen3-embedding-6841b2055b99c44d9a4c371f ➡️ ModelScope https://modelscope.cn/collections/Qwen3-Embedding-3edc3762d50f48 ➡️ GitHub https://github.com/QwenLM/Qwen3-Embedding ➡️ Ollama https://ollama.com/dengcao/Qwen3-Embedding-0.6B https://ollama.com/dengcao/Qwen3-Embedding-4B https://ollama.com/dengcao/Qwen3-Embedding-8B Qwen3-Reranker ➡️ Hugging Face https://huggingface.co/collections/Qwen/qwen3-reranker-6841b22d0192d7ade9cdefea ➡️ ModelScope https://modelscope.cn/collections/Qwen3-Reranker-6316e71b146c4f ➡️ Ollama https://ollama.com/dengcao/Qwen3-Reranker-0.6B https://ollama.com/dengcao/Qwen3-Reranker-4B https://ollama.com/dengcao/Qwen3-Reranker-8B Ollama部署Qwen3-Embedding和Qwen3-Reranker的方法: 第一步,安装Ollama。打开官网下载:https://ollama.com/download 可以选择Download for Windows来下载。然后双击OllamaSetup.exe按提示安装完成。 第二步,打开Windows PowerShell,或者CMD命令。 如下载Qwen3-Embedding-0.6B,可以输入Ollama命令: ollama run dengcao/Qwen3-Embedding-0.6B:F16 如下载Qwen3-Reranker-0.6B,可以输入Ollama命令: ollama run dengcao/Qwen3-Reranker-0.6B:F16 接下来等待下载完成即可。 下面列出Qwen3-Embedding和Qwen3-Reranker各个版本的Ollama安装命令。 Qwen3-Embedding-0.6B系列: ollama run dengcao/Qwen3-Embedding-0.6B:Q8_0 ollama run dengcao/Qwen3-Embedding-0.6B:F16 Qwen3-Embedding-4B系列: ollama run dengcao/Qwen3-Embedding-4B:Q4_K_M ollama run dengcao/Qwen3-Embedding-4B:Q5_K_M ollama run dengcao/Qwen3-Embedding-4B:Q8_0 Qwen3-Embedding-8B系列: ollama run dengcao/Qwen3-Embedding-8B:Q4_K_M ollama run dengcao/Qwen3-Embedding-8B:Q5_K_M ollama run dengcao/Qwen3-Embedding-8B:Q8_0 Qwen3-Reranker-0.6B系列: ollama run dengcao/Qwen3-Reranker-0.6B:Q8_0 ollama run dengcao/Qwen3-Reranker-0.6B:F16 Qwen3-Reranker-4B系列: ollama run dengcao/Qwen3-Reranker-4B:Q4_K_M ollama run dengcao/Qwen3-Reranker-4B:Q5_K_M ollama run dengcao/Qwen3-Reranker-4B:Q8_0 Qwen3-Reranker-8B系列: ollama run dengcao/Qwen3-Reranker-8B:Q3_K_M ollama run dengcao/Qwen3-Reranker-8B:Q4_K_M ollama run dengcao/Qwen3-Reranker-8B:Q5_K_M ollama run dengcao/Qwen3-Reranker-8B:Q8_0 关于量化版本的说明: q8_0:与浮点数16几乎无法区分。资源使用率高,速度慢。不建议大多数用户使用。 q6_k:将Q8_K用于所有张量。 q5_k_m:将 Q6_K 用于一半的 attention.wv 和 feed_forward.w2 张量,否则Q5_K。 q5_0: 原始量化方法,5位。精度更高,资源使用率更高,推理速度更慢。 q4_k_m:将 Q6_K 用于一半的 attention.wv 和 feed_forward.w2 张量,否则Q4_K q4_0:原始量化方法,4 位。 q3_k_m:将 Q4_K 用于 attention.wv、attention.wo 和 feed_forward.w2 张量,否则Q3_K q2_k:将 Q4_K 用于 attention.vw 和 feed_forward.w2 张量,Q2_K用于其他张量。 根据经验,建议使用 Q5_K_M,因为它保留了模型的大部分性能。或者,如果要节省一些内存,可以使用 Q4_K_M。