首页 文章 精选 留言 我的

精选列表

搜索[智能体框架],共10000篇文章
优秀的个人博客,低调大师

业界 | 英伟达新利剑:发布RTX20系列新显卡,图灵框架铺垫

英伟达在2018科隆国际游戏展宣布,新款高端显卡GeForce RTX 2070,RTX 2080和RTX 2080 Ti正式问世。 这些RTX20系列显卡会接替英伟达目前的顶级GPU,包括GeForce GTX 1070,GTX 1080和GTX 1080 Ti。虽然英伟达通常会发布更强大的Ti版GPU,但这一次,它同时发布了RTX 2080和RTX 2080 Ti两款GPU。 点击观看宣传视频 当然,价格绝对不会便宜。英伟达CEO黄仁勋在演讲中也提到,这几款不同的显卡价格不同。黄仁勋说,RTX 2070的起售价为499美元,RTX 2080的起售价为699美元,RTX 2080 Ti的起售价为999美元。当被问到为何如此定价时,英伟达的一位代表说道,这些价格反映了第三方制造商的零售价。 英伟达还为这三款显卡提供了Founders Ed

优秀的个人博客,低调大师

python+pytest单元测试框架之在Jenkins上生成Allure测试报告

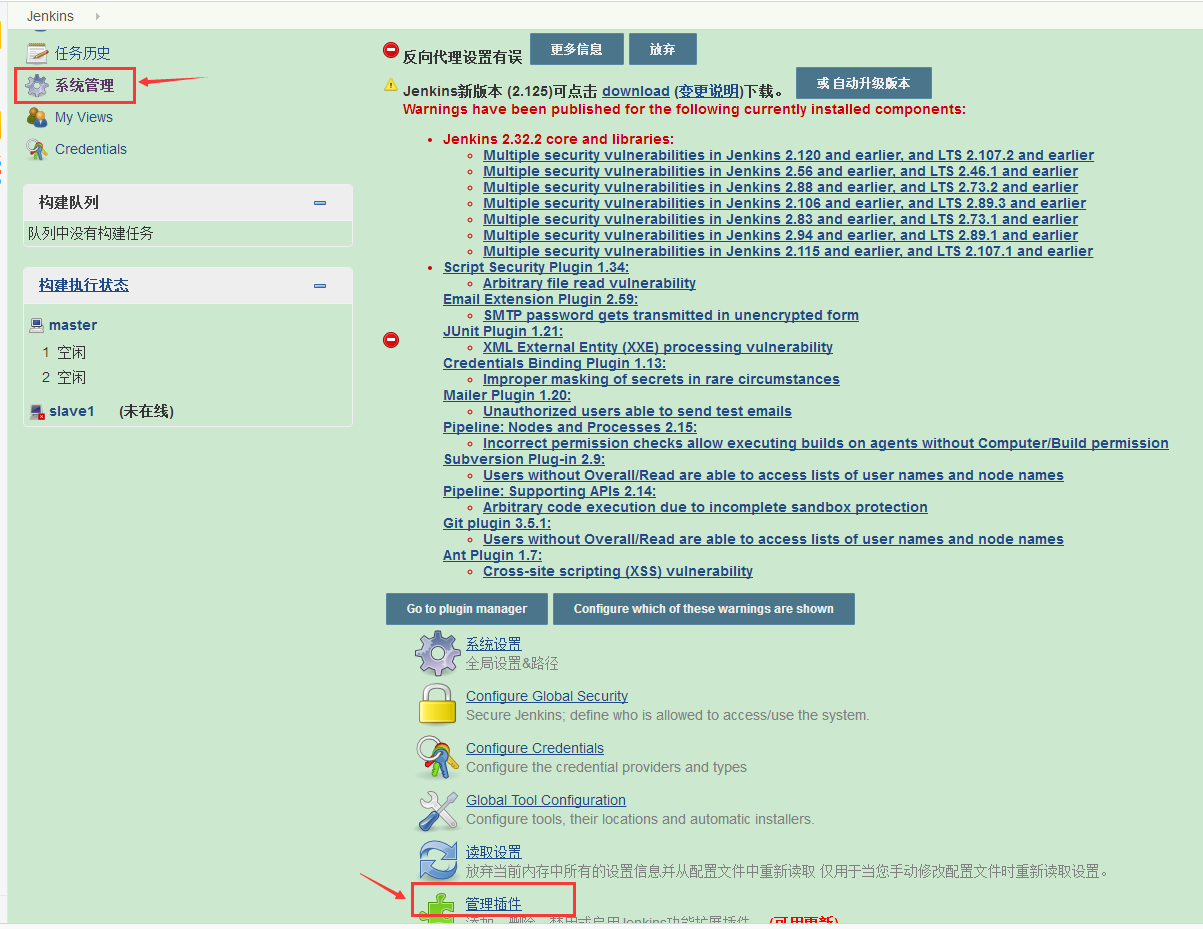
上篇我们通过Allure插件生成了测试report,并通过打开浏览器的方式查看图形化测试report,那要集成都Jenkins中去,并以邮件的方式发送测试report要怎么做呢?请看以下操作 一、搭建环境 1.jenkins环境搭建见《手把手教你搭建Jenkins+Jmeter+Ant自动化集成环境》中的Jenkins部分,这里不做介绍 二、在jenkins中配置插件 1.分别安装插件 Allure Jenkins Plugin 、HTML Publisher plugin a.在Jenkins的页面中点击“系统管理”->"管理插件",搜索“allure”,在搜索结果页,选择“Allure Jenkins Plugin”进行安装。安装完成之后重启一下Jenkins。 Jenkins界面 进入插件管理界面,选择“可选插件”->在右上角过滤编辑框中写入"Allure",按回车键,然后勾选Allure,点击直接安装 安装Allure插件 b.进入插件管理界面,选择“可选插件”->在右上角过滤编辑框中写入"HTML",按回车键,然后勾选HTML Publisher,点击直接安装 安装HTML Publisher 安装过程 安装完成 重启Jenkins 重启后可在“插件管理”界面查看到已安装成功的插件和插件版本 查看安装好的插件1 查看安装好的插件2 2.添加allure执行工具 下载allure压缩文件allure-commandline.zip,解压并添加allure路径至path环境变量 配置path 3.在Jenkins的主界面中找到并进入“(Global Tool Configuration)全局工具管理”页面 Global Tool Configuration管理界面 找到Allure Commandline安装 字样,点击新增Allure Commandline 安装Allure Commandline 点击后,在弹出下面的页面,输入Allure的命令别名和版本(这里我选择最新版本号)后,点击Apply 和Save 保存Allure配置 三、配置Job 1.在Jenkins主界面点击新建,进入如下界面,建立 jenkins 持续集成项目, 这里选择自由风格的项目,按照步骤执行操作后点击OK 输入项目名称 2.点击OK后进入Allure Report界面,如下图所示 进入项目配置界面 3.在Allure Report界面,分别配置“构建”和“构建后操作” a.配置构建步骤:进入Allure Report界面,找到“构建”下方的“增加构建步骤”,下来选择Excute Windows batch command 配置构建步 b.输入如下配置步骤指令: D: cd \work\pytest py.test -s -q --alluredir ${WORKSPACE}/report 配置指令 查看输出的log信息 原因:jenkins执行命令,会把命令生成一个批处理文件执行,而pytest命令对于批处理来说是外部命令,所以要加call表示调用。而jenkins执行windows命令,若退出代码不为0 ,则jenkins会将构建标记为失败,所以需要加上exit 0表示执行完成退出 解决方法:构建命令在py.test前面加上call,最后加上exit 0 重构指令 运行结果打印信息 c.在构建后操作下拉一栏选择“Allure Report”,进入“Allure Report”界面,写入保存报告的路径名称“report”,在“Properties”一栏分别写入Key和Value对应的变量值和存放测试用例文件的路径,如下图所示: 配置report路径 这里需要注意一点就是:执行指令生成测试报告的路径名称和保存测试报告的路径名称必须一致,不然会提示错误。如下图设置 设置测试报告名称 四、查看运行结果 在Jenkins界面点击“立即构建”,会在左下角出现进度条显示,当进度条显示完成后,刷新下当前界面,可以在页面右侧看到运行结果,点击界面的“Allure Report”字样,可查看该测试用例运行的详细情况 运行用例 运行结果1 运行结果2 运行结果3 运行结果4

优秀的个人博客,低调大师

探索分布式服务框架Dubbo9:Dubbo整体架构与实现原理

Dubbo剖析-整体架构分析 一、前言 工欲善其事,必先利其器,前面通过几篇文章简单的介绍了如何使用Dubbo搭建一个简单的分布式系统,在接下来的的一段时间就来研究Dubbo原理设计,本文作为原理设计的开篇先整体介绍下dubbo的架构。 二、整体架构 image.png dubbo官方的这个图很复杂,但是一开始没有必要深入细节,下面我们简单讲解主要模块。 其中Service 和 Config 层为 API,对应服务提供方来说是使用ServiceConfig来代表一个要发布的服务配置对象,对应服务消费方来说ReferenceConfig代表了一个要消费的服务的配置对象。可以直接初始化配置类,也可以通过 spring 解析配置生成配置类。 其它各层均为 SPI,SPI意味着下面各层都是组件化可以被替换的,这也是dubbo比较好的一点,主要功能组件都可以插件化替换。dubbo增强了JDK中的SPI功能,在dubbo中其它各层都是使用扩展点进行提供服务的,dubbo增强的SPI增加了对扩展点 IoC 和 AOP 的支持,一个扩展点可以直接 setter 注入其它扩展点;并且不会一次性实例化扩展点的所有实现类,这避免了有扩展实现初始化很耗时,但如果没用上也加载,会很浪费资源的情况,增强的SPI是在具体用某一个实现类时候才进行实例化。后续会具体讲解增强的SPI的实现原理。 proxy 服务代理层:扩展接口为 ProxyFactory,dubbo实现的SPI主要JavassistProxyFactory(默认使用)和JdkProxyFactory,用来对服务提供方和服务消费方的服务进行代理。 registry 注册中心层:封装服务地址的注册与发现,扩展接口为 Registry , RegistryService,Dubbo提供的扩展接口实现为ZookeeperRegistry,RedisRegistry,MulticastRegistry,DubboRegistry。 扩展接口RegistryFactory,dubbo提供的扩展接口实现DubboRegistryFactory,DubboRegistryFactory,RedisRegistryFactory,ZookeeperRegistryFactory。 cluster 路由层:封装多个提供者的路由及负载均衡,并桥接注册中心, 扩展接口为 Cluster , Directory , Router ,LoadBalance。 monitor 监控层:RPC 调用次数和调用时间监控,扩展接口为 MonitorFactory , Monitor , MonitorService。 protocol 远程调用层:封将 RPC 调用,扩展接口为 Protocol , Invoker , Exporter。 exchange 信息交换层:封装请求响应模式,同步转异步,扩展接口为 Exchanger , ExchangeChannel ,ExchangeClient , ExchangeServer transport 网络传输层:抽象 mina 和 netty 为统一接口扩展接口为 Channel , Transporter , Client , Server , Codec serialize 数据序列化层:可复用的一些工具,扩展接口为 Serialization , ObjectInput , ObjectOutput , ThreadPool 关于dubbo扩展点一个简单的例子: 以扩展 Dubbo 的协议为例,在协议的实现 jar 包内放置文本文件: METAINF/dubbo/com.alibaba.dubbo.rpc.Protocol ,内容为: myprotocol=com.alibaba.user.MyProtocol MyProtocol内容如下: package com.alibaba.user; import com.alibaba.dubbo.rpc.Protocol; public class MyProtocol implemenets Protocol { // ... } 配置模块中的配置 Dubbo 配置模块中,扩展点均有对应配置属性或标签,通过配置指定使用哪个扩展 实现。比如: <dubbo:protocol name="myprotocol" /> 三、远程调用细节 3.1 服务提供者暴露一个服务的详细过程 image.png 首先 ServiceConfig 类拿到对外提供服务的实际类 ref(如:UserServiceImpl),然后通过 ProxyFactory 类的 getInvoker 方法使用 ref 生成一个 AbstractProxyInvoker 实例,到这一步就完成具体服务到 Invoker 的转化。 接下来就是 Invoker 转换到 Exporter 的过程。Dubbo 处理服务暴露的关键就在 Invoker 转换到 Exporter 的过程,上图中的红色部分。 Dubbo 协议的 Invoker 转为 Exporter 发生在 DubboProtocol 类的 export 方法,它主要是打开创建一个Netty Server 侦听服务,并接收客户端发来的各种请求,通讯细节由 Dubbo 自己实现,然后注册服务到服务注册中心。 3.2 服务消费者消费一个服务的详细过程 image.png 首先 ReferenceConfig 类的 init 方法调用 Protocol 的 refer 方法生 成 Invoker 实例(如上图中的红色部分),这是服务消费的关键。接下来把 Invoker 转换为客户端需要的接口(如:UserServiceBo)。 dubbo协议的invoker转换为客户端需要的接口是发生在DubboProtocol的refer方法,他主要是创建一个netty client 链接服务提供者,通讯细节由 Dubbo 自己实现。 四、总结 本文简单的介绍了dubbo整体架构,后续具体介绍,dubbo增强的spi的实现,服务提供方如何发布服务,比如何时如何创建netty Server来监听服务消费者的链接,何时如何注册服务到服务治理中心;dubbo的filter链如何构建;服务消费方如何消费服务,何时创建netty client…. 微信公众号【Java技术江湖】一位阿里 Java 工程师的技术小站。(关注公众号后回复”Java“即可领取 Java基础、进阶、项目和架构师等免费学习资料,更有数据库、分布式、微服务等热门技术学习视频,内容丰富,兼顾原理和实践,另外也将赠送作者原创的Java学习指南、Java程序员面试指南等干货资源) ​

优秀的个人博客,低调大师

10小时大数据入门实战(五)-分布式计算框架MapReduce

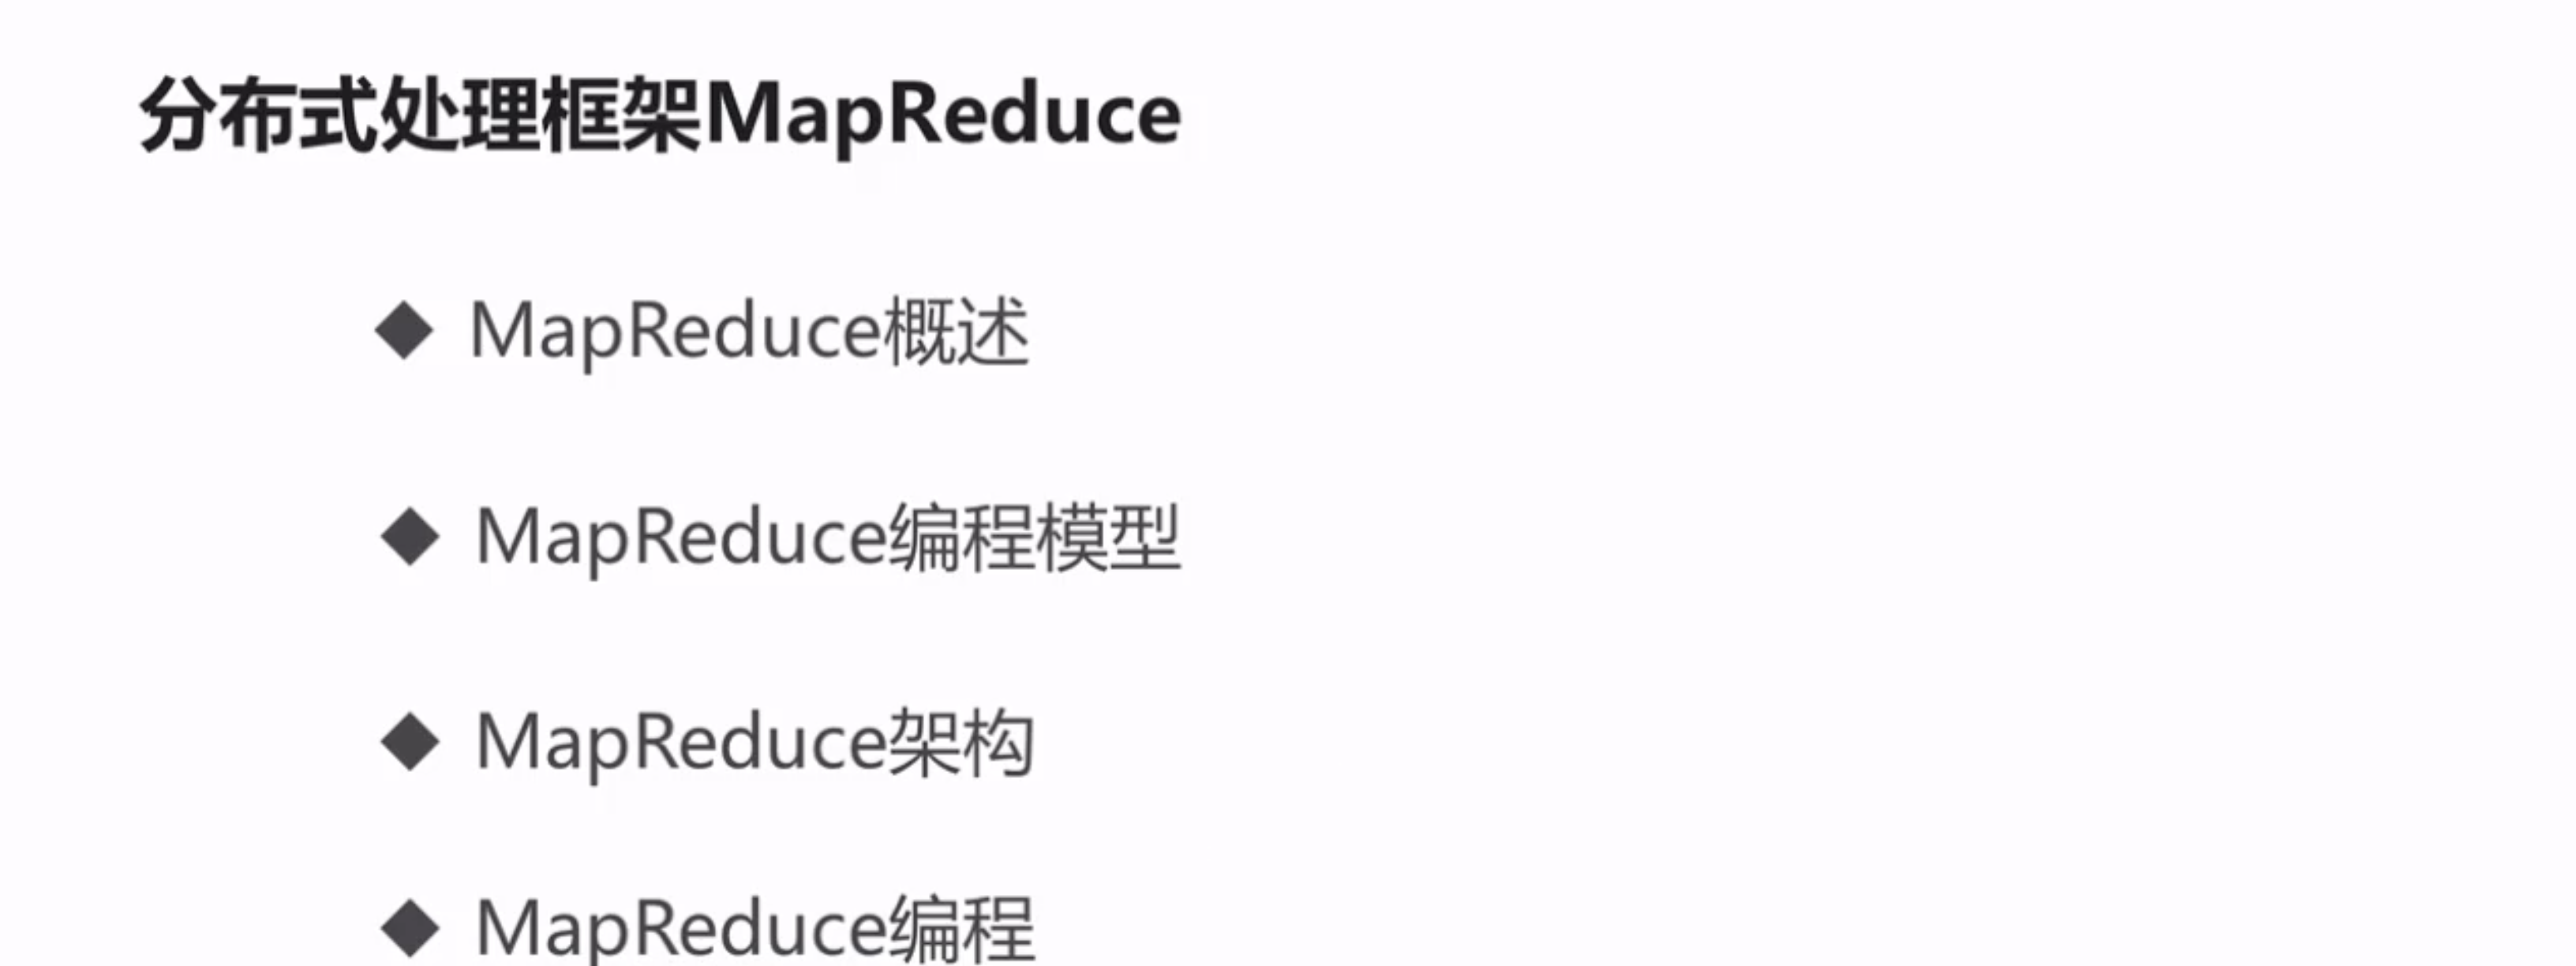
目录 1 MapReduce概述 2 MapReduce编程模型之通过wordcount词频统计分析案例入门 MapReduce执行流程 InputFormat OutputFormat OutputFormt接口决定了在哪里以及怎样持久化作业结果。Hadoop为不同类型的格式提供了一系列的类和接口,实现自定义操作只要继承其中的某个类或接口即可。你可能已经熟悉了默认的OutputFormat,也就是TextOutputFormat,它是一种以行分隔,包含制表符界定的键值对的文本文件格式。尽管如此,对多数类型的数据而言,如再常见不过的数字,文本序列化会浪费一些空间,由此带来的结果是运行时间更长且资源消耗更多。为了避免文本文件的弊端,Hadoop提供了SequenceFileOutputformat,它将对象表示成二进制形式而不再是文本文件,并将结果进行压缩。 3 MapReduce核心概念 3.1 Split 3.2 InputFormat 4 MapReduce 1.x 架构 5 MapReduce 2.x 架构 6 Java 实现 wordCount clean package 上传到Hadoop服务器 全路径没有问题 7 重构 8 Combiner编程 9 Partitoner 10 JobHistoryServer

优秀的个人博客,低调大师

3个netty5的例子,java开源框架简单介绍netty的用法

这是一个netty快速入门的例子,也是我的学习笔记,比较简单,翻译于官方的文档整理后把所有代码注释放在每一行代码中间,简单明了地介绍一些基础的用法。 首页这是基于netty5的例子,如果需要使用请依赖netty5的包。maven引用方式 1 <dependency> 2 <groupId>io.netty</groupId> 3 <artifactId>netty-all</artifactId> 4 <version>5.0.0.Alpha2</version> 5 </dependency> 0.Netty Server packagecom.tjbsl.netty.demo0.server; importcom.tjbsl.netty.demo3.time.TimeServerHandler; importio.netty.bootstrap.ServerBootstrap; importio.netty.channel.ChannelFuture; importio.netty.channel.ChannelInitializer; importio.netty.channel.ChannelOption; importio.netty.channel.EventLoopGroup; importio.netty.channel.nio.NioEventLoopGroup; importio.netty.channel.socket.SocketChannel; importio.netty.channel.socket.nio.NioServerSocketChannel; /** *处理数据 */ publicclassNettyServer{ privateintport; publicNettyServer(intport){ this.port=port; } publicvoidrun()throwsException{ /*** *NioEventLoopGroup是用来处理I/O操作的多线程事件循环器, *Netty提供了许多不同的EventLoopGroup的实现用来处理不同传输协议。 *在这个例子中我们实现了一个服务端的应用, *因此会有2个NioEventLoopGroup会被使用。 *第一个经常被叫做‘boss’,用来接收进来的连接。 *第二个经常被叫做‘worker’,用来处理已经被接收的连接, *一旦‘boss’接收到连接,就会把连接信息注册到‘worker’上。 *如何知道多少个线程已经被使用,如何映射到已经创建的Channels上都需要依赖于EventLoopGroup的实现, *并且可以通过构造函数来配置他们的关系。 */ EventLoopGroupbossGroup=newNioEventLoopGroup(); EventLoopGroupworkerGroup=newNioEventLoopGroup(); System.out.println("准备运行端口:"+port); try{ /** *ServerBootstrap是一个启动NIO服务的辅助启动类 *你可以在这个服务中直接使用Channel */ ServerBootstrapb=newServerBootstrap(); /** *这一步是必须的,如果没有设置group将会报java.lang.IllegalStateException:groupnotset异常 */ b=b.group(bossGroup,workerGroup); /*** *ServerSocketChannel以NIO的selector为基础进行实现的,用来接收新的连接 *这里告诉Channel如何获取新的连接. */ b=b.channel(NioServerSocketChannel.class); /*** *这里的事件处理类经常会被用来处理一个最近的已经接收的Channel。 *ChannelInitializer是一个特殊的处理类, *他的目的是帮助使用者配置一个新的Channel。 *也许你想通过增加一些处理类比如NettyServerHandler来配置一个新的Channel *或者其对应的ChannelPipeline来实现你的网络程序。 *当你的程序变的复杂时,可能你会增加更多的处理类到pipline上, *然后提取这些匿名类到最顶层的类上。 */ b=b.childHandler(newChannelInitializer<SocketChannel>(){//(4) @Override publicvoidinitChannel(SocketChannelch)throwsException{ //ch.pipeline().addLast(newDiscardServerHandler());//demo1.discard //ch.pipeline().addLast(newResponseServerHandler());//demo2.echo ch.pipeline().addLast(newTimeServerHandler());//demo3.time } }); /*** *你可以设置这里指定的通道实现的配置参数。 *我们正在写一个TCP/IP的服务端, *因此我们被允许设置socket的参数选项比如tcpNoDelay和keepAlive。 *请参考ChannelOption和详细的ChannelConfig实现的接口文档以此可以对ChannelOptions的有一个大概的认识。 */ b=b.option(ChannelOption.SO_BACKLOG,128); /*** *option()是提供给NioServerSocketChannel用来接收进来的连接。 *childOption()是提供给由父管道ServerChannel接收到的连接, *在这个例子中也是NioServerSocketChannel。 */ b=b.childOption(ChannelOption.SO_KEEPALIVE,true); /*** *绑定端口并启动去接收进来的连接 */ ChannelFuturef=b.bind(port).sync(); /** *这里会一直等待,直到socket被关闭 */ f.channel().closeFuture().sync(); }finally{ /*** *优雅关闭 */ workerGroup.shutdownGracefully(); bossGroup.shutdownGracefully(); } } publicstaticvoidmain(String[]args)throwsException{ intport; if(args.length>0){ port=Integer.parseInt(args[0]); }else{ port=8000; } newNettyServer(port).run(); //通过cmd窗口的telnet127.0.0.18000运行 } } 1.DISCARD服务(丢弃服务,指的是会忽略所有接收的数据的一种协议) packagecom.tjbsl.netty.demo1.discard; importio.netty.buffer.ByteBuf; importio.netty.channel.ChannelHandlerAdapter; importio.netty.channel.ChannelHandlerContext; importio.netty.util.CharsetUtil; importio.netty.util.ReferenceCountUtil; /** *服务端处理通道.这里只是打印一下请求的内容,并不对请求进行任何的响应 *DiscardServerHandler继承自ChannelHandlerAdapter, *这个类实现了ChannelHandler接口, *ChannelHandler提供了许多事件处理的接口方法, *然后你可以覆盖这些方法。 *现在仅仅只需要继承ChannelHandlerAdapter类而不是你自己去实现接口方法。 * */ publicclassDiscardServerHandlerextendsChannelHandlerAdapter{ /*** *这里我们覆盖了chanelRead()事件处理方法。 *每当从客户端收到新的数据时, *这个方法会在收到消息时被调用, *这个例子中,收到的消息的类型是ByteBuf *@paramctx通道处理的上下文信息 *@parammsg接收的消息 */ @Override publicvoidchannelRead(ChannelHandlerContextctx,Objectmsg){ try{ ByteBufin=(ByteBuf)msg; /*while(in.isReadable()){ System.out.print((char)in.readByte()); System.out.flush(); }*/ //这一句和上面注释的的效果都是打印输入的字符 System.out.println(in.toString(CharsetUtil.US_ASCII)); }finally{ /** *ByteBuf是一个引用计数对象,这个对象必须显示地调用release()方法来释放。 *请记住处理器的职责是释放所有传递到处理器的引用计数对象。 */ ReferenceCountUtil.release(msg); } } /*** *这个方法会在发生异常时触发 *@paramctx *@paramcause */ @Override publicvoidexceptionCaught(ChannelHandlerContextctx,Throwablecause){ /*** *发生异常后,关闭连接 */ cause.printStackTrace(); ctx.close(); } } 以上是一个丢弃服务的处理方式,你可以运行后通过telnet来发送消息,来查看是否正常运行,注意console里会打印你的输入内容。 2.ECHO服务(响应式协议) 到目前为止,我们虽然接收到了数据,但没有做任何的响应。然而一个服务端通常会对一个请求作出响应。让我们学习怎样在ECHO协议的实现下编写一个响应消息给客户端,这个协议针对任何接收的数据都会返回一个响应。 和discard server唯一不同的是把在此之前我们实现的channelRead()方法,返回所有的数据替代打印接收数据到控制台上的逻辑。 说明NettyServer 还是用上面已经提供的类,只是把这段里的注销部分修改成如下。 packagecom.tjbsl.netty.demo2.echo; importio.netty.buffer.ByteBuf; importio.netty.channel.ChannelHandlerAdapter; importio.netty.channel.ChannelHandlerContext; importio.netty.util.CharsetUtil; /** *服务端处理通道. *ResponseServerHandler继承自ChannelHandlerAdapter, *这个类实现了ChannelHandler接口, *ChannelHandler提供了许多事件处理的接口方法, *然后你可以覆盖这些方法。 *现在仅仅只需要继承ChannelHandlerAdapter类而不是你自己去实现接口方法。 *用来对请求响应 */ publicclassResponseServerHandlerextendsChannelHandlerAdapter{ /** *这里我们覆盖了chanelRead()事件处理方法。 *每当从客户端收到新的数据时, *这个方法会在收到消息时被调用, *ChannelHandlerContext对象提供了许多操作, *使你能够触发各种各样的I/O事件和操作。 *这里我们调用了write(Object)方法来逐字地把接受到的消息写入 *@paramctx通道处理的上下文信息 *@parammsg接收的消息 */ @Override publicvoidchannelRead(ChannelHandlerContextctx,Objectmsg){ ByteBufin=(ByteBuf)msg; System.out.println(in.toString(CharsetUtil.UTF_8)); ctx.write(msg); //cxt.writeAndFlush(msg) //请注意,这里我并不需要显式的释放,因为在进入的时候netty已经自动释放 //ReferenceCountUtil.release(msg); } /** *ctx.write(Object)方法不会使消息写入到通道上, *他被缓冲在了内部,你需要调用ctx.flush()方法来把缓冲区中数据强行输出。 *或者你可以在channelRead方法中用更简洁的cxt.writeAndFlush(msg)以达到同样的目的 *@paramctx *@throwsException */ @Override publicvoidchannelReadComplete(ChannelHandlerContextctx)throwsException{ ctx.flush(); } /** *这个方法会在发生异常时触发 * *@paramctx *@paramcause */ @Override publicvoidexceptionCaught(ChannelHandlerContextctx,Throwablecause){ /*** *发生异常后,关闭连接 */ cause.printStackTrace(); ctx.close(); } } 同样以上运行后,可以通过telnet发送数据,console里会打印出你发送的数据,同时你的命令行界面里应该也会接收到相同的数据。 3.TIME服务(时间协议的服务) 在这个部分被实现的协议是TIME协议。和之前的例子不同的是在不接受任何请求时他会发送一个含32位的整数的消息,并且一旦消息发送就会立即关闭连接。在这个例子中,你会学习到如何构建和发送一个消息,然后在完成时主动关闭连接。 因为我们将会忽略任何接收到的数据,而只是在连接被创建发送一个消息,所以这次我们不能使用channelRead()方法了,代替他的是,我们需要覆盖channelActive()方法,下面的就是实现的内容: 说明NettyServer 还是用上面已经提供的类,只是把这段里的注销部分修改成如下。 1 //ch.pipeline().addLast(newDiscardServerHandler()); 2 //ch.pipeline().addLast(newResponseServerHandler()); 3 ch.pipeline().addLast(newTimeServerHandler()); TimeServerHandler类的如下: packagecom.tjbsl.netty.demo3.time; importio.netty.buffer.ByteBuf; importio.netty.channel.ChannelFuture; importio.netty.channel.ChannelFutureListener; importio.netty.channel.ChannelHandlerAdapter; importio.netty.channel.ChannelHandlerContext; importio.netty.util.CharsetUtil; importjava.util.Scanner; publicclassTimeServerHandlerextendsChannelHandlerAdapter{ /** *channelActive()方法将会在连接被建立并且准备进行通信时被调用。 *因此让我们在这个方法里完成一个代表当前时间的32位整数消息的构建工作。 * *@paramctx */ @Override publicvoidchannelActive(finalChannelHandlerContextctx){ /*Scannercin=newScanner(System.in); System.out.println("请输入发送信息:"); Stringname=cin.nextLine();*/ Stringname="HelloWorld!"; /** *为了发送一个新的消息,我们需要分配一个包含这个消息的新的缓冲。 *因为我们需要写入一个32位的整数,因此我们需要一个至少有4个字节的ByteBuf。 *通过ChannelHandlerContext.alloc()得到一个当前的ByteBufAllocator, *然后分配一个新的缓冲。 */ finalByteBuftime=ctx.alloc().buffer(4); time.writeBytes(name.getBytes()); /*** *和往常一样我们需要编写一个构建好的消息 *。但是等一等,flip在哪?难道我们使用NIO发送消息时不是调用java.nio.ByteBuffer.flip()吗? *ByteBuf之所以没有这个方法因为有两个指针, *一个对应读操作一个对应写操作。 *当你向ByteBuf里写入数据的时候写指针的索引就会增加, *同时读指针的索引没有变化。 *读指针索引和写指针索引分别代表了消息的开始和结束。 *比较起来,NIO缓冲并没有提供一种简洁的方式来计算出消息内容的开始和结尾, *除非你调用flip方法。 *当你忘记调用flip方法而引起没有数据或者错误数据被发送时, *你会陷入困境。这样的一个错误不会发生在Netty上, *因为我们对于不同的操作类型有不同的指针。 *你会发现这样的使用方法会让你过程变得更加的容易, *因为你已经习惯一种没有使用flip的方式。 *另外一个点需要注意的是ChannelHandlerContext.write()(和writeAndFlush())方法会返回一个ChannelFuture对象, *一个ChannelFuture代表了一个还没有发生的I/O操作。 *这意味着任何一个请求操作都不会马上被执行, *因为在Netty里所有的操作都是异步的。 *因此你需要在write()方法返回的ChannelFuture完成后调用close()方法, *然后当他的写操作已经完成他会通知他的监听者。 */ finalChannelFuturef=ctx.writeAndFlush(time);//(3) /** *当一个写请求已经完成是如何通知到我们? *这个只需要简单地在返回的ChannelFuture上增加一个ChannelFutureListener。 *这里我们构建了一个匿名的ChannelFutureListener类用来在操作完成时关闭Channel。 */ f.addListener(newChannelFutureListener(){ @Override publicvoidoperationComplete(ChannelFuturefuture){ assertf==future; /*** *请注意,close()方法也可能不会立马关闭,他也会返回一个ChannelFuture。 */ ctx.close(); } }); } //接收结果 @Override publicvoidchannelRead(ChannelHandlerContextctx,Objectmsg) throwsException{ ByteBufbuf=(ByteBuf)msg; System.out.println("client:"+buf.toString(CharsetUtil.UTF_8)); } @Override publicvoidexceptionCaught(ChannelHandlerContextctx,Throwablecause){ cause.printStackTrace(); ctx.close(); } } 4.Time客户端 不像DISCARD和ECHO的服务端,对于TIME协议我们需要一个客户端因为人们不能把一个32位的二进制数据翻译成一个日期或者日历。在这一部分,我们将会讨论如何确保服务端是正常工作的,并且学习怎样用Netty编写一个客户端。 在Netty中,编写服务端和客户端最大的并且唯一不同的使用了不同的BootStrap和Channel的实现。 packagecom.tjbsl.netty.demo3.time.client; importio.netty.bootstrap.Bootstrap; importio.netty.channel.ChannelFuture; importio.netty.channel.ChannelInitializer; importio.netty.channel.ChannelOption; importio.netty.channel.EventLoopGroup; importio.netty.channel.nio.NioEventLoopGroup; importio.netty.channel.socket.SocketChannel; importio.netty.channel.socket.nio.NioSocketChannel; publicclassTimeClient{ publicstaticvoidmain(String[]args)throwsException{ Stringhost="127.0.0.1"; intport=8000; EventLoopGroupworkerGroup=newNioEventLoopGroup(); try{ /** *如果你只指定了一个EventLoopGroup, *那他就会即作为一个‘boss’线程, *也会作为一个‘workder’线程, *尽管客户端不需要使用到‘boss’线程。 */ Bootstrapb=newBootstrap();//(1) b.group(workerGroup);//(2) /** *代替NioServerSocketChannel的是NioSocketChannel,这个类在客户端channel被创建时使用 */ b.channel(NioSocketChannel.class);//(3) /** *不像在使用ServerBootstrap时需要用childOption()方法, *因为客户端的SocketChannel没有父channel的概念。 */ b.option(ChannelOption.SO_KEEPALIVE,true);//(4) b.handler(newChannelInitializer<SocketChannel>(){ @Override publicvoidinitChannel(SocketChannelch)throwsException{ ch.pipeline().addLast(newTimeClientHandler()); } }); //用connect()方法代替了bind()方法 ChannelFuturef=b.connect(host,port).sync(); //等到运行结束,关闭 f.channel().closeFuture().sync(); }finally{ workerGroup.shutdownGracefully(); } } }

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册