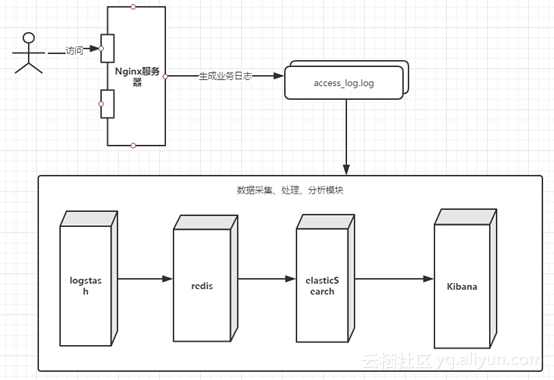
ELK日志分析系统的搭建
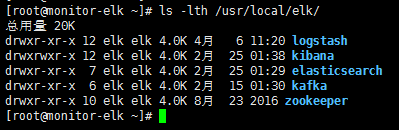
一、环境准备 1.安装java环境: yuminstalljava-1.8.0-openjdk*-y 2.添加elk执行用户: groupadd-g77elk useradd-u77-gelk-d/home/elk-s/bin/bashelk 3.在/etc/security/limits.conf追加以下内容: elksoftmemlockunlimited elkhardmemlockunlimited *softnofile65536 *hardnofile131072 4.执行生效 sysctl-p 5.配置主机名 hostnamectlset-hostnamemonitor-elk echo"10.135.3.135monitor-elk">>/etc/hosts 二、服务部署 1.服务端: 1)下载ELK相关的源码包: wget"https://artifacts.elastic.co/downloads/elasticsearch/elasticsearch-5.2.2.tar.gz" wget"https://artifacts.elastic.co/downloads/logstash/logstash-5.2.2.tar.gz" wget"https://artifacts.elastic.co/downloads/kibana/kibana-5.2.2-linux-x86_64.tar.gz" wget"http://mirror.bit.edu.cn/apache/kafka/0.10.2.0/kafka_2.12-0.10.2.0.tgz" wget"http://mirror.bit.edu.cn/apache/zookeeper/zookeeper-3.4.9/zookeeper-3.4.9.tar.gz" 2)创建elk目录,并将以上源码包解压至该目录: mkdir/usr/local/elk mkdir-p/data/elasticsearch/ chown-Relk.elk/data/elasticsearch/ mkdir-p/data/{kafka,zookeeper} mvlogstash-5.2.2logstash&&mvkibana-5.2.2-linux-x86_64kibana&&mvelasticsearch-5.2.2elasticsearch&&mvfilebeat-5.2.2-linux-x86_64filebeat&&mvkafka_2.12-0.10.2.0kafka&&mvzookeeper-3.4.9zookeeper chown-Relk.elk/usr/local/elk/ 程序目录列表如下: 3)修改以下程序的相应配置文件 ①kibana: [root@monitor-elk~]#cat/usr/local/elk/kibana/config/kibana.yml|grep-v"^#\|^$" server.host:"localhost" elasticsearch.url:"http://localhost:9200" elasticsearch.requestTimeout:30000 logging.dest:/data/elk/logs/kibana.log [root@monitor-elk~]# ②elasticsearch: [root@monitor-elk~]#cat/usr/local/elk/elasticsearch/config/elasticsearch.yml|grep-v"^#\|^$" node.name:node01 path.data:/data/elasticsearch/data path.logs:/data/elk/logs/elasticsearch bootstrap.memory_lock:true network.host:127.0.0.1 http.port:9200 [root@monitor-elk~]#/usr/local/elk/elasticsearch/config/jvm.options #修改以下参数 -Xms1g -Xmx1g ③logstash: [root@monitor-elk~]#cat/usr/local/elk/logstash/config/logs.yml input{ #使用kafka的数据作为日志数据源 kafka { bootstrap_servers=>["127.0.0.1:9092"] topics=>"beats" codec=>json } } filter{ #过滤数据,如果日志数据里面包含有该IP地址,将会被丢弃 if[message]=~"123.151.4.10"{ drop{} } #转码,转成正常的url编码,如中文 #urldecode{ #all_fields=>true #} #nginxaccess #通过type来判断传入的日志类型 if[type]=="hongbao-nginx-access"or[type]=="pano-nginx-access"or[type]=="logstash-nginx-access"{ grok{ #指定自定义的grok表达式路径 patterns_dir=>"./patterns" #指定自定义的正则表达式名称解析日志内容,拆分成各个字段 match=>{"message"=>"%{NGINXACCESS}"} #解析完毕后,移除默认的message字段 remove_field=>["message"] } #使用geoip库解析IP地址 geoip{ #指定解析后的字段作为数据源 source=>"clientip" fields=>["country_name","ip","region_name"] } date{ #匹配日志内容里面的时间,如05/Jun/2017:03:54:01+0800 match=>["timestamp","dd/MMM/yyyy:HH:mm:ssZ"] #将匹配到的时间赋值给@timestamp字段 target=>"@timestamp" remove_field=>["timestamp"] } } #tomcataccess if[type]=="hongbao-tomcat-access"or[type]=="ljq-tomcat-access"{ grok{ patterns_dir=>"./patterns" match=>{"message"=>"%{TOMCATACCESS}"} remove_field=>["message"] } geoip{ source=>"clientip" fields=>["country_name","ip","region_name"] } date{ match=>["timestamp","dd/MMM/yyyy:HH:mm:ssZ"] target=>"@timestamp" remove_field=>["timestamp"] } } #tomcatcatalina if[type]=="hongbao-tomcat-catalina"{ grok{ match=>{ "message"=>"^(?<log_time>\d{4}-\d{2}-\d{2}\d{2}:\d{2}:\d{2},\d{3})(?<level>\w*)(?<log_data>.+)" } remove_field=>["message"] } date{ match=>["log_time","yyyy-MM-ddHH:mm:ss,SSS"] target=>"@timestamp" remove_field=>["log_time"] } } } output{ #将解析失败的记录写入到指定的文件中 if"_grokparsefailure"in[tags]{ file{ path=>"/data/elk/logs/grokparsefailure-%{[type]}-%{+YYYY.MM}.log" } } #nginxaccess #根据type日志类型分别输出到elasticsearch不同的索引 if[type]=="hongbao-nginx-access"{ #将处理后的结果输出到elasticsearch elasticsearch{ hosts=>["127.0.0.1:9200"] #指定输出到当天的索引 index=>"hongbao-nginx-access-%{+YYYY.MM.dd}" } } if[type]=="pano-nginx-access"{ elasticsearch{ hosts=>["127.0.0.1:9200"] index=>"pano-nginx-access-%{+YYYY.MM.dd}" } } if[type]=="logstash-nginx-access"{ elasticsearch{ hosts=>["127.0.0.1:9200"] index=>"logstash-nginx-access-%{+YYYY.MM.dd}" } } #tomcataccess if[type]=="hongbao-tomcat-access"{ elasticsearch{ hosts=>["127.0.0.1:9200"] index=>"hongbao-tomcat-access-%{+YYYY.MM.dd}" } } if[type]=="ljq-tomcat-access"{ elasticsearch{ hosts=>["127.0.0.1:9200"] index=>"ljq-tomcat-access-%{+YYYY.MM.dd}" } } #tomcatcatalina if[type]=="hongbao-tomcat-catalina"{ elasticsearch{ hosts=>["127.0.0.1:9200"] index=>"hongbao-tomcat-catalina-%{+YYYY.MM.dd}" } } } [root@monitor-elk~]# 配置正则表达式 [root@monitor-elk~]#cp/usr/local/elk/logstash/vendor/bundle/jruby/1.9/gems/logstash-patterns-core-4.0.2/patterns/grok-patterns/usr/local/elk/logstash/config/patterns [root@monitor-elk~]#tail-5/usr/local/elk/logstash/config/patterns #Nginx NGINXACCESS%{COMBINEDAPACHELOG}%{QS:x_forwarded_for} #Tomcat TOMCATACCESS%{COMMONAPACHELOG} [root@monitor-elk~]#chownelk.elk/usr/local/elk/logstash/config/patterns 4)配置zookeeper: cp/usr/local/elk/zookeeper/conf/zoo_sample.cfg/usr/local/elk/zookeeper/conf/zoo.cfg 修改配置文件中的数据存储路径 vim/usr/local/elk/zookeeper/conf/zoo.cfg dataDir=/data/zookeeper 备份并修改脚本/usr/local/elk/zookeeper/bin/zkEnv.sh 修改以下变量的参数 ZOO_LOG_DIR="/data/zookeeper-logs" ZOO_LOG4J_PROP="INFO,ROLLINGFILE" 备份并修改日志配置/usr/local/elk/zookeeper/conf/log4j.properties 修改以下变量的参数 zookeeper.root.logger=INFO,ROLLINGFILE log4j.appender.ROLLINGFILE=org.apache.log4j.DailyRollingFileAppender#每天轮转日志 启动zookeeper: /usr/local/elk/zookeeper/bin/zkServer.shstart 5)配置kafka: 修改配置文件/usr/local/elk/kafka/config/server.properties的以下参数 log.dirs=/data/kafka zookeeper.connect=localhost:2181 备份并修改脚本/usr/local/elk/kafka/bin/kafka-run-class.sh 在“base_dir=$(dirname$0)/..”的下一行追加LOG_DIR变量,并指定日志输出路径 LOG_DIR=/data/kafka-logs 创建日志存储目录: mkdir-p/data/kafka-logs mkdir-p/data/elk/logs chown-Relk.elk/data/elk/logs 启动kafka: nohup/usr/local/elk/kafka/bin/kafka-server-start.sh/usr/local/elk/kafka/config/server.properties&>>/data/elk/logs/kafka.log& 需要注意的是主机名一定要有配置在/etc/hosts文件中,否则kafka会无法启动 [root@monitor-elk~]#cat/etc/hosts 127.0.0.1localhostlocalhost.localdomain ::1localhostlocalhost.localdomainlocalhost6localhost6.localdomain6 10.135.3.135monitor-elk 6)配置supervisor ①安装supervisor: yuminstallsupervisor-y 设置服务开机自启动(server程序也会一起启动): systemctlenablesupervisord.service ②修改配置 a.创建日志存储路径: mkdir-p/data/supervisor chown-Relk.elk/data/supervisor/ b.修改主配置文件/etc/supervisord.conf logfile=/data/supervisor/supervisord.log c.创建elk程序对应的supervisor配置文件,并添加以下配置内容: [root@monitor-elk~]#cat/etc/supervisord.d/elk.ini [program:elasticsearch] directory=/usr/local/elk/elasticsearch command=su-c"/usr/local/elk/elasticsearch/bin/elasticsearch"elk autostart=true startsecs=5 autorestart=true startretries=3 priority=10 [program:logstash] directory=/usr/local/elk/logstash command=/usr/local/elk/logstash/bin/logstash-f/usr/local/elk/logstash/config/logs.yml user=elk autostart=true startsecs=5 autorestart=true startretries=3 redirect_stderr=true stdout_logfile=/data/elk/logs/logstash.log stdout_logfile_maxbytes=1024MB stdout_logfile_backups=10 priority=11 [program:kibana] directory=/usr/local/elk/kibana command=/usr/local/elk/kibana/bin/kibana user=elk autostart=true startsecs=5 autorestart=true startretries=3 priority=12 [root@monitor-elk~]# ③启动supervisor: systemctlstartsupervisord 查看程序进程和日志: psaux|grep-vgrep|grep"elasticsearch\|logstash\|kibana" tip: 重启配置的单个程序,如: supervisorctlrestartlogstash 重启配置的所有程序: supervisorctlrestartall 重载配置(只重启配置变动的对应程序,其他配置未变动的程序不重启): supervisorctlupdate 7)配置nginx ①安装nginx yuminstallnginx-y ②配置nginx代理: [root@monitor-elk~]#cat/etc/nginx/conf.d/kibana.conf upstreamkibana{ server127.0.0.1:5601max_fails=3fail_timeout=30s; } server{ listen8080; server_namelocalhost; location/{ proxy_passhttp://kibana/; indexindex.htmlindex.htm; #auth auth_basic"kibanaPrivate"; auth_basic_user_file/etc/nginx/.htpasswd; } } [root@monitor-elk~]#greplisten/etc/nginx/nginx.conf listen8000default_server; listen[::]:8000default_server; [root@monitor-elk~]# ③创建nginx认证: [root@monitor-elk~]#yuminstallhttpd-y [root@monitor-elk~]#htpasswd-cm/etc/nginx/.htpasswdelk Newpassword: Re-typenewpassword: Addingpasswordforuserelk [root@monitor-elk~]#systemctlstartnginx [root@monitor-elk~]#systemctlenablenginx 8)配置ik中文分词: ①安装maven: wget"http://mirror.bit.edu.cn/apache/maven/maven-3/3.3.9/binaries/apache-maven-3.3.9-bin.tar.gz" tar-zxfapache-maven-3.3.9-bin.tar.gz mvapache-maven-3.3.9/usr/local/maven echo"exportMAVEN_HOME=/usr/local/maven">>/etc/bashrc echo"exportPATH=$PATH:$MAVEN_HOME/bin">>/etc/bashrc ./etc/bashrc ②编译安装ik(注意下载对应版本): wget"https://github.com/medcl/elasticsearch-analysis-ik/archive/v5.2.2.zip" unzipv5.2.2.zip cdelasticsearch-analysis-ik-5.2.2/ mvnpackage mkdir/usr/local/elk/elasticsearch/plugins/ik cptarget/releases/elasticsearch-analysis-ik-5.2.2.zip/usr/local/elk/elasticsearch/plugins/ik/ cd/usr/local/elk/elasticsearch/plugins/ik/ unzipelasticsearch-analysis-ik-5.2.2.zip rm-felasticsearch-analysis-ik-5.2.2.zip chown-Relk.elk../ik supervisorctlrestartelasticsearch ③创建索引模板: 要使用ik分词,需要在创建指定的索引前(不管是通过命令手动还是logstash配置来创建)先创建索引模板,否则使用默认的模板即可: cd/usr/local/elk/logstash 创建并编辑文件logstash.json,添加以下内容: { "order":1, "template":"tomcatcat-*", "settings":{ "index":{ "refresh_interval":"5s" } }, "mappings":{ "_default_":{ "dynamic_templates":[ { "string_fields":{ "mapping":{ "norms":false, "type":"text", "analyzer":"ik_max_word", "search_analyzer":"ik_max_word" }, "match_mapping_type":"text", "match":"*" } } ], "_all":{ "norms":false, "enabled":true }, "properties":{ "@timestamp":{ "include_in_all":false, "type":"date" }, "log_data":{ "include_in_all":true, "type":"text", "analyzer":"ik_max_word", "search_analyzer":"ik_max_word", "boost":8 }, "@version":{ "include_in_all":false, "type":"keyword" } } } }, "aliases":{} }' 添加完毕后,执行curl命令创建索引模板 curl-XPUT'http://localhost:9200/_template/tomcatcat'-d@logstash.json 执行成功后会返回结果{"acknowledged":true} ④热更新配置: 有些词语ik无法识别分词,如公司名称、服务名称之类 curl-XGET'http://localhost:9200/_analyze?pretty&analyzer=ik_smart'-d' 腾讯云' 这时需要自己自定义词库,ik支持分词热更新的方式(不需要重启elasticsearch),每分钟自动检测一次 在nginx根路径下创建一个utf8格式的文本文件ik.txt,将自己需要分词的词语写入ik.txt,一行一词: 然后修改/usr/local/elk/elasticsearch/plugins/ik/config/IKAnalyzer.cfg.xml <!--用户可以在这里配置远程扩展字典--> <entrykey="remote_ext_dict">http://127.0.0.1:8000/ik.txt</entry> 配置完毕重启elasticsearch,再次获取分词结果: 2.客户端: 1)下载filebeat: wget"https://artifacts.elastic.co/downloads/beats/filebeat/filebeat-5.2.2-linux-x86_64.tar.gz" 解压filebeat-5.2.2-linux-x86_64.tar.gz至/usr/local/elk/目录,并重命名为filebeat mkdir/usr/local/elk/ mkdir-p/data/elk/logs/ echo"10.135.3.135elk">>/etc/hosts 2)配置filebeat: [root@test2filebeat]#catlogs.yml filebeat.prospectors: - #指定需要监控的日志文件路径,可以使用*匹配 paths: -/data/nginx/log/*_access.log #指定文件的输入类型为log(默认) input_type:log #设定日志类型 document_type:pano-nginx-access #从文件的末尾开始监控文件新增的内容,并按行依次发送 tail_files:true #将日志内容输出到kafka output.kafka: hosts:["10.135.3.135:9092"] topic:beats compression:Snappy [root@test2filebeat]# [root@test3filebeat]#catlogs.yml filebeat.prospectors: - paths: -/usr/local/tomcat/logs/*access_log.*.txt input_type:log document_type:hongbao-tomcat-access tail_files:true - paths: -/usr/local/tomcat/logs/catalina.out input_type:log document_type:hongbao-tomcat-catalina #多行匹配模式,后接正则表达式,这里表示匹配时间,如2017-06-0510:00:00,713 multiline.pattern:'^\d{4}-\d{2}-\d{2}\d{2}:\d{2}:\d{2},\d{3}' #将未匹配到的行合并到上一行,如java的错误日志 multiline.negate:true #将未匹配到的行添加到上一行的末尾 multiline.match:after tail_files:true output.kafka: hosts:["10.135.3.135:9092"] topic:beats compression:Snappy [root@test3filebeat]# 3)启动filebeat nohup/usr/local/elk/filebeat/filebeat-e-c/usr/local/elk/filebeat/logs.yml-d"publish"&>>/data/elk/logs/filebeat.log& 三、kibanaweb端配置 1.浏览器访问kibana地址,并输入前面nginx设置的账号密码: http://10.135.3.135:8080 在访问Kibana时,默认情况下将加载Discover(发现)页面,并选择默认的索引模式(logstash-*)。timefilter(时间过滤器)默认设置为last15minutes(最近15分钟),搜索查询默认设置为match-all(*)。 服务器资源状态页: http://10.135.3.135:8080/status 2.建立索引模式 注意,索引模式的名称要和logstash的output生成的索引(也就是说必须存在于Elasticsearch中,而且必须包含有数据)进行匹配,如logstash-*可与logstash-20170330匹配,还可以匹配多个索引(所有以logstash-开头的索引)。 *匹配索引名称中的零个或多个字符 3.索引建立完毕后,点击Discover中的索引模式,即可看到Elasticsearch的日志数据 4.创建可视化图表 绘制可视化图表,将拆分出来的nginx或tomcat访问日志中的字段response状态码进行聚合显示,以图表的形式直观显示各状态码(如200、400等)的统计情况 1)点击 Visualize 中 Vertical Bar Charts(垂直条形图) 2)选择其中一个索引模式,如 pano-* 3)通过字段 response.keyword 指定terms(词条)聚合,按从大到小的顺序来显示前五列状态码的总数数据,然后点击 Apply changes 图标生效。 图表中,X轴显示的是状态码,Y轴显示的是对应的状态码总数。 4)最后点击右上角的 Save 保存,同时输入一个可视化的名称。 5.创建仪表盘 可以将相同业务或类型的可视化对象,集中显示在同一个仪表盘中。 1)点击 add 添加可视化对象到仪表盘, 2)点击创建好的可视化对象,将会排列在在仪表盘的窗口中。对其可视化对象的窗口大小进行合适的调整。 3)添加和调整完毕后,点击右上角的 Save 保存,同时输入一个仪表盘的名称。 4)显示的结果 四、服务监控脚本 1.服务端 1)kafka [root@monitor-elk~]#cat/usr/local/scripts/monitor_kafka.sh #!/bin/bash # ############################################# #author:Ellen #describes:Checkkafkaprogram #version:v1.0 #updated:20170407 ############################################# # #Configurationinformation program_dir=/usr/local/elk/kafka logfile=/usr/local/scripts/log/monitor_kafka.log #Checkexecuteduser if[`whoami`!="root"];then echo"Pleaseuserootrunscript!!!" exit1 fi #Checkkafkaprogram num=`psaux|grep-w$program_dir|grep-vw"grep\|vim\|vi\|mv\|scp\|cat\|dd\|tail\|head\|script\|ls\|echo\|sys_log\|logger\|tar\|rsync\|ssh"|wc-l` if[${num}-eq0];then echo"[`date+'%F%T'`][CRITICAL]Kafkaprogramdostnotstart!!!"|tee-a$logfile #Sendalarminformation #cagent_tools是腾讯云服务器自带的报警插件,该插件可发送短信或邮箱告警,如不需要可注释 /usr/bin/cagent_toolsalarm"Kafkaprogramdostnotstart!!!" echo"[`date+'%F%T'`][INFO]Beginstartkafkaprogram..."|tee-a$logfile nohup/usr/local/elk/kafka/bin/kafka-server-start.sh/usr/local/elk/kafka/config/server.properties&>>/data/elk/logs/kafka.log& if[$?-eq0];then echo"[`date+'%F%T'`][INFO]Kafkaprogramstartsuccessful."|tee-a$logfile /usr/bin/cagent_toolsalarm"Kafkaprogramstartsuccessful" exit0 else echo"[`date+'%F%T'`][CRITICAL]Kafkaprogramstartfailed!!!"|tee-a$logfile /usr/bin/cagent_toolsalarm"Kafkaprogramstartfailed!!!Pleasehandleit!!!" exit6 fi else echo"[`date+'%F%T'`][INFO]Kafkaprogramisrunning..."|tee-a$logfile exit0 fi [root@monitor-elk~]# 2)zookeeper [root@monitor-elk~]#cat/usr/local/scripts/monitor_zookeeper.sh #!/bin/bash # ############################################# #author:Ellen #describes:Checkzookeeperprogram #version:v1.0 #updated:20170407 ############################################# # #Configurationinformation program_dir=/usr/local/elk/zookeeper logfile=/usr/local/scripts/log/monitor_zookeeper.log #Checkexecuteduser if[`whoami`!="root"];then echo"Pleaseuserootrunscript!!!" exit1 fi #Checkzookeeperprogram num=`psaux|grep-w$program_dir|grep-vw"grep\|vim\|vi\|mv\|scp\|cat\|dd\|tail\|head\|ls\|echo\|sys_log\|tar\|rsync\|ssh"|wc-l` if[${num}-eq0];then echo"[`date+'%F%T'`][CRITICAL]Zookeeperprogramdostnotstart!!!"|tee-a$logfile #Sendalarminformation /usr/bin/cagent_toolsalarm"Zookeeperprogramdostnotstart!!!" echo"[`date+'%F%T'`][INFO]Beginstartzookeeperprogram..."|tee-a$logfile /usr/local/elk/zookeeper/bin/zkServer.shstart if[$?-eq0];then echo"[`date+'%F%T'`][INFO]Zookeeperprogramstartsuccessful."|tee-a$logfile /usr/bin/cagent_toolsalarm"Zookeeperprogramstartsuccessful" exit0 else echo"[`date+'%F%T'`][CRITICAL]Zookeeperprogramstartfailed!!!"|tee-a$logfile /usr/bin/cagent_toolsalarm"Zookeeperprogramstartfailed!!!Pleasehandleit!!!" exit6 fi else echo"[`date+'%F%T'`][INFO]Zookeeperprogramisrunning..."|tee-a$logfile exit0 fi [root@monitor-elk~]# 3)添加crontab定时任务 0-59/5****/usr/local/scripts/monitor_kafka.sh&>/dev/null 0-59/5****/usr/local/scripts/monitor_zookeeper.sh&>/dev/null 2.客户端: [root@test2~]#cat/usr/local/scripts/monitor_filebeat.sh #!/bin/bash # ############################################# #author:Ellen #describes:Checkfilebeatprogram #version:v1.0 #updated:20170407 ############################################# # #Configurationinformation program_dir=/usr/local/elk/filebeat logfile=/usr/local/scripts/log/monitor_filebeat.log #Checkexecuteduser if[`whoami`!="root"];then echo"Pleaseuserootrunscript!!!" exit1 fi #Checkfilebeatprogram num=`psaux|grep-w$program_dir|grep-vw"grep\|vim\|vi\|mv\|cp\|scp\|cat\|dd\|tail\|head\|script\|ls\|echo\|sys_log\|logger\|tar\|rsync\|ssh"|wc-l` if[${num}-eq0];then echo"[`date+'%F%T'`][CRITICAL]Filebeatprogramdostnotstart!!!"|tee-a$logfile #Sendalarminformation /usr/bin/cagent_toolsalarm"Filebeatprogramdostnotstart!!!" echo"[`date+'%F%T'`][INFO]Beginstartfilebeatprogram..."|tee-a$logfile nohup/usr/local/elk/filebeat/filebeat-e-c/usr/local/elk/filebeat/logs.yml-d"publish"&>>/data/elk/logs/filebeat.log& if[$?-eq0];then echo"[`date+'%F%T'`][INFO]Filebeatprogramstartsuccessful."|tee-a$logfile /usr/bin/cagent_toolsalarm"Filebeatprogramstartsuccessful" exit0 else echo"[`date+'%F%T'`][CRITICAL]Filebeatprogramstartfailed!!!"|tee-a$logfile /usr/bin/cagent_toolsalarm"Filebeatprogramstartfailed!!!Pleasehandleit!!!" exit6 fi else echo"[`date+'%F%T'`][INFO]Filebeatprogramisrunning..."|tee-a$logfile exit0 fi [root@test2~]# 3)添加crontab定时任务 0-59/5****/usr/local/scripts/monitor_filebeat.sh&>/dev/null 五、注意事项 1.数据流向 -------------------------------------------------------------------------------------------------- log_files->filebeat->kafka->logstash->elasticsearch->kibana -------------------------------------------------------------------------------------------------- 2.每天定时清理elasticsearch索引,只保留30天内的索引 1)编写脚本 [root@monitor-elk~]#cat/usr/local/scripts/del_index.sh #!/bin/bash # ############################################# #author:Ellen #describes:Deleteelasticsearchhistoryindex. #version:v1.0 #updated:20170407 ############################################# # #Configurationinformation logfile=/usr/local/scripts/log/del_index.log tmpfile=/tmp/index.txt host=localhost port=9200 deldate=`date-d'-30days'+'%Y.%m.%d'` #Checkexecuteduser if[`whoami`!="root"];then echo"Pleaseuserootrunscript!!!" exit1 fi #Deleteelasticsearchindex curl-s"$host:$port/_cat/indices?v"|grep-vhealth|awk{'print$3'}|grep"$deldate">$tmpfile if[!-s$tmpfile];then echo"[`date+'%F%T'`][WARNING]$tmpfileisaemptyfile."|tee-a$logfile exit1 fi foriin`cat/tmp/index.txt` do curl-XDELETEhttp://$host:$port/$i if[$?-eq0];then echo"[`date+'%F%T'`][INFO]Elasticsearchindex$ideletesuccessful."|tee-a$logfile else echo"[`date+'%F%T'`][CRITICAL]Elasticsearchindex$ideletefailed!!!"|tee-a$logfile /usr/bin/cagent_toolsalarm"Elasticsearchindex$ideletefailed!!!" exit6 fi done [root@monitor-elk~]# 2)添加crontab定时任务 0002***/usr/local/scripts/del_index.sh&>/dev/null 3.按业务进行建立索引 如hongbao、pano等 4.nginx和tomcat等访问日志使用默认格式 六、相关命令参考 1.列出所有索引 curl-s'http://localhost:9200/_cat/indices?v' 2.列出节点列表 curl'localhost:9200/_cat/nodes?v' 3.查询集群健康信息 curl'localhost:9200/_cat/health?v' 4.查看指定的索引数据(默认返回十条结果) curl-XGET'http://localhost:9200/logstash-nginx-access-2017.05.20/_search?pretty' 5.删除指定的索引 curl-XDELETE http://localhost:9200/logstash-nginx-access-2017.05.20 6.查询模板 curl-s'http://localhost:9200/_template'