首页 文章 精选 留言 我的

精选列表

搜索[基础软件],共10000篇文章
优秀的个人博客,低调大师

mica v2.0.0 强化基础工具集

mica(云母) mica 云母,寓意为云服务的核心,增强 Spring cloud 功能,使得 Spring cloud 服务开发更加方便快捷。 mica 2.x核心依赖 mica 基于 java 8,没有历史包袱,支持传统 Servlet 和 Reactive(webflux)。采用 mica-auto 自动生成 spring.factories 和 spring-devtools.properties 配置,仅依赖 Spring boot、Spring cloud 全家桶,无第三方依赖。市面上鲜有的微服务核心组件。 依赖 版本 Spring Boot 2.2.x 关于此版本 此次版本相比 mica 1.x 少了一些模块,主要原因如下: mica-launcher、 mica-boot-testmica 2.x中采用新方式给精简掉了。 部分模块本次版本暂不开源,后续会逐步开放。 部分模块开发层度比较低,转到内部继续研发。 其他模块付费提供,付费版很多模块都已经打通。 知识付费,让你我走的更远!!! mica 2.x 现有模块示意图: 注意:左边开锁状态的模块,后续都会开放。 更新说明 ✨mica-http 支持指定协议 protocols。 ⚡mica-http 扩展 HttpRequest proxy 方法,方便使用。 ✨mica-http 拆出 mica-spider 爬虫工具,精简依赖。 ✨mica-spider 增强 CssQueryMethodInterceptor。 ⚡mica-captcha 验证码抽象,支持数学计算型验证码。 ✨mica-captcha 验证码缓存接口,完善验证码生成说明。 ✨mica-swagger 升级 swagger 到 knife4j。 ✨mica-redis 限流算法改为同 Spring cloud gateway,减少内存占用。 ✨mica-jobs 添加 xxl-job starter。 ✨mica-core 生成 mica 版本信息到 Mica 类中。 ✨mica-core 添加 compiler 工具类。 ✨mica-core 添加用于计数的 CountMap。 ✨mica-core 添加 Once 对象。 ✨mica-core 中的 jackson 包移动到 mica-boot,并做调整用于支持 mica-api-encrypt 组件。 ✨mica-core 简化 aes 工具类代码。 ⚡mica-core 优化 DateUtil。 ⚡mica-core 优化 RuntimeUtil。 ✨mica-core 拆解完善 HexUtil。 ✨mica-core 添加 DesUtil。 ✨mica-core 添加 RsaUtil。 ✨mica-core 优化 ResourceUtil 工具类。 ✨mica-core 微调 Bean copy。 ✨mica-core function 添加序列化。 ✨mica-core MD5 不再依赖 Spring DigestUtils。 ✨mica-core 优化 file 工具对文件名处理。 ⚡add .gitattributes。 ⚡ @configuration 替换为 @configuration(proxyBeanMethods = false)。 ⬆️升级 okhttp 到 3.14.8。 ⬆️升级 jsoup 到 1.13.1。 ⬆️升级 mica-auto 到 1.2.2。 ⬆️升级 spring boot 到 2.2.6,不再支持,spring boot 2.2.x 以下版本。 ⬆️升级 spring cloud 到 Hoxton.SR4。 文档 mica 源码 Github:https://github.com/lets-mica mica 源码 Gitee(码云):https://gitee.com/596392912/mica 文档地址(官网):https://www.dreamlu.net/mica2x/index.html 文档地址(语雀-可关注订阅):https://www.yuque.com/dreamlu 示例项目:https://github.com/lets-mica/mica-example 欢迎关注我们的公众号:JAVA架构日记,精彩内容每日推送。

优秀的个人博客,低调大师

JetLinks 物联网基础平台 1.0 RELEASE 发布

更新时间: 2020-04-01 主要优化: 重构elasticsearch-component模块. 优化elasticsearch索引管理,支持自定义策略,如按月对索引分表. 增加GeoType类型支持,为未来的Gis支持作准备. 增加网关设备功能.见:通过网关设备接入多个下挂设备 增加属性变更Dashboard接口,可同时订阅一个设备对所有属性变更事件. 优化设备协议,增加调试功能. 增加脚本支持(PRO). 增加设备功能调用,可在界面发起功能调用指令. 增加设备标签功能,可自定义设备标签,可通过标签查询设备: where("id$dev-tag","location:重庆市"); //查询标签key为location,value为重庆市的设备. 优化消息网关中的设备消息topic,详见:从消息网关中订阅设备消息 DeviceMessage增加头:Headers.keepOnline,用于在TCP短连接的场景保持设备一直在线,仅通过keepalive超时判断离线. 消息网关增加集群支持,在任意一个服务节点都可订阅设备消息.(PRO) 增加UDP设备网关,可通过UDP接入设备了(PRO). 增加CoAP设备网关,可通过CoAP接入设备了(PRO). 设备会话支持手动指定心跳超时时间以及获取客户端地址信息. 优化批量upsert,提升批量导入性能. 性能优化,详见压力测试. 一系列UI优化. 主要BUG修复: 修复使用save保存的数据中有字段使用默认值时,更新数据会导致字段被更新为默认值的问题. 修复选择网络协议时出现重复选项. 修复设备属性和事件历史记录部分类型无法展示问题. 修复无法将excel大文件导入设备实例的的问题. 修复在某些情况下redis超时后的NPE错误. 修复无法导出设备问题. 修复当设备数量较多时同步设备状态可能导致崩溃的问题.

优秀的个人博客,低调大师

Java基础知识的27个点

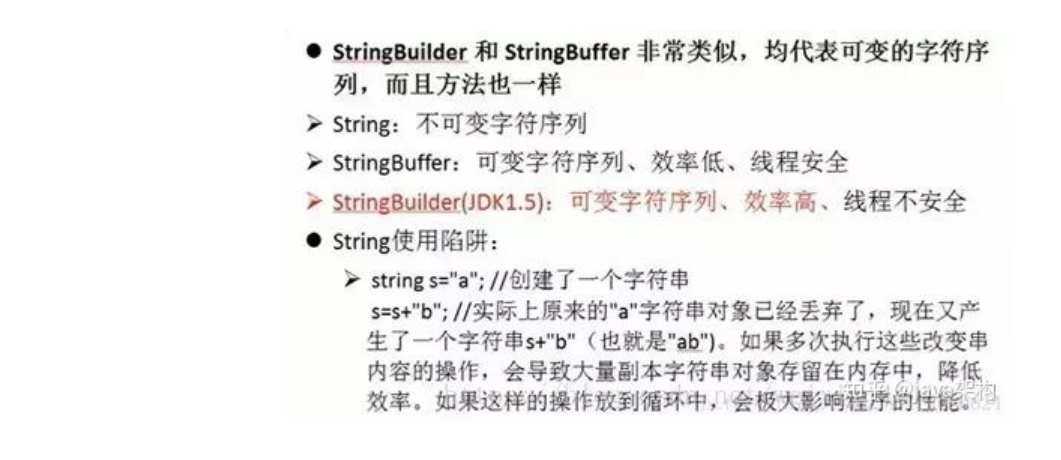
云栖号:https://yqh.aliyun.com第一手的上云资讯,不同行业精选的上云企业案例库,基于众多成功案例萃取而成的最佳实践,助力您上云决策! 1、JAVA中的几种基本数据类型是什么,各自占用多少字节。 2、String类能被继承吗,为什么 不能。在Java中,只要是被定义为final的类,也可以说是被final修饰的类,就是不能被继承的。 3、String,Stringbuffer,StringBuilder的区别。 4、ArrayList和LinkedList有什么区别。 简单的区别: 1.ArrayList是实现了基于动态数组的数据结构,LinkedList基于链表的数据结构。 (LinkedList是双向链表,有next也有previous) 2.对于随机访问get和set,ArrayList觉得优于LinkedList,因为LinkedList要移动指针。 3.对于新增和删除操作add和remove,LinedList比较占优势,因为ArrayList要移动数据。 深度的区别: 1.对ArrayList和LinkedList而言,在列表末尾增加一个元素所花的开销都是固定的。对ArrayList而言,主要是在内部数组中增加一项,指向所添加的元素,偶尔可能会导致对数组重新进行分配;而对LinkedList而言,这个开销是统一的,分配一个内部Entry对象。 2.在ArrayList的中间插入或删除一个元素意味着这个列表中剩余的元素都会被移动;而在LinkedList的中间插入或删除一个元素的开销是固定的。 3.LinkedList不支持高效的随机元素访问。 4.ArrayList的空间浪费主要体现在在list列表的结尾预留一定的容量空间,而LinkedList的空间花费则体现在它的每一个元素都需要消耗相当的空间 5、讲讲类的实例化顺序。 问题:比如父类静态数据,构造函数,字段,子类静态数据,构造函数,字 段,当new的时候,他们的执行顺序。 答案: 类加载器实例化时进行的操作步骤(加载–>连接->初始化)。 父类静态变量、 父类静态代码块、 子类静态变量、 子类静态代码块、 父类非静态变量(父类实例成员变量)、 父类构造函数、 子类非静态变量(子类实例成员变量)、 子类构造函数。 6、用过哪些Map类,都有什么区别。 问题:比如HashMap是线程安全的吗,并发下使用的Map是什么,他们 内部原理分别是什么,比如存储方式,hashcode,扩容,默认容量等。 答案: 不安全,并发下使用ConcurrentHashMap。 7、JAVA8的ConcurrentHashMap为什么放弃了分段锁? 原因:通过 JDK 的源码和官方文档看来, 他们认为的弃用分段锁的原因由以下几点: 1、加入多个分段锁浪费内存空间。 2、生产环境中, map 在放入时竞争同一个锁的概率非常小,分段锁反而会造成更新等操作的长时间等待。 3、为了提高 GC 的效率 既然弃用了分段锁, 那么一定由新的线程安全方案, 我们来看看源码是怎么解决线程安全的呢?CAS 首先通过 hash 找到对应链表过后, 查看是否是第一个object, 如果是, 直接用cas原则插入,无需加锁,然后如果不是链表第一个object, 则直接用链表第一个object加锁,这里加的锁是synchronized,虽然效率不如 ReentrantLock, 但节约了空间,这里会一直用第一个object为锁, 直到重新计算map大小, 比如扩容或者操作了第一个object为止。 8、ConcurrentHashMap(JDK1.8)为什么要使用synchronized而不是如ReentranLock这样的可重入锁? 可以从下面几个方面讲述: 锁的粒度 首先锁的粒度并没有变粗,甚至变得更细了。每当扩容一次,ConcurrentHashMap的并发度就扩大一倍。 Hash冲突 JDK1.7中,ConcurrentHashMap从过二次hash的方式(Segment -> HashEntry)能够快速的找到查找的元素。在1.8中通过链表加红黑树的形式弥补了put、get时的性能差距。 扩容 JDK1.8中,在ConcurrentHashmap进行扩容时,其他线程可以通过检测数组中的节点决定是否对这条链表(红黑树)进行扩容,减小了扩容的粒度,提高了扩容的效率。 为什么是synchronized,而不是可重入锁 减少内存开销 假设使用可重入锁来获得同步支持,那么每个节点都需要通过继承AQS来获得同步支持。但并不是每个节点都需要获得同步支持的,只有链表的头节点(红黑树的根节点)需要同步,这无疑带来了巨大内存浪费。获得JVM的支持 可重入锁毕竟是API这个级别的,后续的性能优化空间很小。 synchronized则是JVM直接支持的,JVM能够在运行时作出相应的优化措施:锁粗化、锁消除、锁自旋等等。这就使得synchronized能够随着JDK版本的升级而不改动代码的前提下获得性能上的提升。9、有没有有顺序的Map实现类,如果有,他们是怎么保证有序的。 Hashmap和Hashtable 都不是有序的。 TreeMap和LinkedHashmap都是有序的。(TreeMap默认是key升序,LinkedHashmap默认是数据插入顺序) TreeMap是基于比较器Comparator来实现有序的。 LinkedHashmap是基于链表来实现数据插入有序的。 10、抽象类和接口的区别,类可以继承多个类么,接口可以继承多个接口么,类可以实现多个接口 么。 区别: 1、抽象类和接口都不能直接实例化,如果要实例化,抽象类变量必须指向实现所有抽象方法的子类对象,接口变量必须指向实现所有接口方法的类对象。 2、抽象类要被子类继承,接口要被类实现。 3、接口只能做方法申明,抽象类中可以做方法申明,也可以做方法实现 4、接口里定义的变量只能是公共的静态的常量,抽象类中的变量是普通变量。 5、抽象类里的抽象方法必须全部被子类所实现,如果子类不能全部实现父类抽象方法,那么该子类只能是抽象类。同样,一个实现接口的时候,如不能全部实现接口方法,那么该类也只能为抽象类。 6、抽象方法只能申明,不能实现。abstract void abc();不能写成abstract void abc(){}。 7、抽象类里可以没有抽象方法 8、如果一个类里有抽象方法,那么这个类只能是抽象类 9、抽象方法要被实现,所以不能是静态的,也不能是私有的。 10、接口可继承接口,并可多继承接口,但类只能单根继承。 类不能继承多个类 接口可以继承多个接口 类可以实现多个接口 11、继承和聚合的区别在哪。 继承 指的是一个类继承另外的一个类的功能,并可以增加它自己的新功能的能力,继承是类与类或者接口与接口之间最常见的关系;在Java中此类关系通过关键字extends明确标识。 聚合 聚合体现的是整体与部分、拥有的关系,此时整体与部分之间是可分离的,他们可以具有各自的生命周期;比如计算机与CPU、公司与员工的关系等; 12、IO模型有哪些,讲讲你理解的nio ,他和bio,aio的区别是啥,谈谈reactor模型。 各IO的区别: reactor是什么? 事件驱动可以处理一个或多个输入源通过Service Handle同步的将输入事件采用多路复用分发给相应的Request Handler(一个或多个)处理 13、反射的原理,反射创建类实例的三种方式是什么。 //创建Class对象的方式一:(对象.getClass()),获取类中的字节码文件 Class class1 = p1.getClass(); //创建Class对象的方式二:(类.class:需要输入一个明确的类,任意一个类型都有一个静态的class属性) Class class3 = Person.class; //创建Class对象的方式三:(forName():传入时只需要以字符串的方式传入即可) //通过Class类的一个forName(String className)静态方法返回一个Class对象,className必须是全路径名称; //Class.forName()有异常:ClassNotFoundException Class class4 = Class.forName("cn.xbmchina.Person"); 14、反射中,Class.forName和ClassLoader区别 。 Class.forName(className)方法,内部实际调用的方法是 Class.forName(className,true,classloader); 第2个boolean参数表示类是否需要初始化, Class.forName(className)默认是需要初始化。 一旦初始化,就会触发目标对象的 static块代码执行,static参数也也会被再次初始化。 ClassLoader.loadClass(className)方法,内部实际调用的方法是 ClassLoader.loadClass(className,false); 第2个 boolean参数,表示目标对象是否进行链接,false表示不进行链接,由上面介绍可以, 不进行链接意味着不进行包括初始化等一些列步骤,那么静态块和静态对象就不会得到执行 15、描述动态代理的几种实现方式,分别说出相应的优缺点。 原理区别: java动态代理是利用反射机制生成一个实现代理接口的匿名类,在调用具体方法前调用InvokeHandler来处理。 而cglib动态代理是利用asm开源包,对代理对象类的class文件加载进来,通过修改其字节码生成子类来处理。 1、如果目标对象实现了接口,默认情况下会采用JDK的动态代理实现AOP 2、如果目标对象实现了接口,可以强制使用CGLIB实现AOP 3、如果目标对象没有实现了接口,必须采用CGLIB库,spring会自动在JDK动态代理和CGLIB之间转换 如何强制使用CGLIB实现AOP? (1)添加CGLIB库,SPRING_HOME/cglib/*.jar (2)在spring配置文件中加入 JDK动态代理和CGLIB字节码生成的区别? (1)JDK动态代理只能对实现了接口的类生成代理,而不能针对类 (2)CGLIB是针对类实现代理,主要是对指定的类生成一个子类,覆盖其中的方法 因为是继承,所以该类或方法最好不要声明成final 16、final的用途。 1、被final修饰的类不可以被继承 2、被final修饰的方法不可以被重写 3、被final修饰的变量不可以被改变(切记不可变的是变量的引用而非引用指向对象的内容。) 4、被final修饰的方法,JVM会尝试为之寻求内联,这对于提升Java的效率是非常重要的。因此,假如能确定方法不会被继承,那么尽量将方法定义为final的,具体参见运行期优化技术的方法内联部分 5、被final修饰的常量,在编译阶段会存入调用类的常量池中,具体参见类加载机制最后部分和Java内存区域 17、写出三种单例模式实现 。 1 饿汉式 public class EagerSingleton {static { System.out.println("EagerSingleton 被加载");} //私有化构造方法,限制直接构造,只能调用 getInstance() 方法获取单例对象private EagerSingleton(){} private static final EagerSingleton eagerSingleton=new EagerSingleton(); // 私有化静态 final成员,类加载直接生成单例对象,比较占用内存 public static EagerSingleton getInstance(){ //提供对外的公共api获取单例对象 return eagerSingleton;} } 总结:饿汉式单例的特点:饿汉式在类创建的同时就实例化一个静态对象出来,不管之后会不会使用这个单例,都会占据一定的内存,但是相应的,在第一次调用时速度也会更快,因为其资源已经初始化完成。 2 懒汉式 public class LazySingleton {static { System.out.println("LazySingleton 被加载");}private LazySingleton(){} //私有化构造方法,限制直接构造,只能调用 getInstance() 方法获取单例对象private static LazySingleton lazySingleton=null;//静态域初始化为null,为的是需要时再创建,避免像饿汉式那样占用内存public static LazySingleton getInstance(){//提供对外的公共api获取单例对象 if(lazySingleton==null){ synchronized (LazySingleton.class){ //在getInstance中做了两次null检查,确保了只有第一次调用单例的时候才会做同步,这样也是线程安全的,同时避免了每次都同步的性能损耗 if(lazySingleton==null){ lazySingleton = new LazySingleton(); } } } return lazySingleton; }} 总结:有同步锁的性能消耗 3 静态内部类实现 public class IoDHSingleton {static {System.out.println("IoDHSingleton 被加载");}private IoDHSingleton(){} //私有化构造方法,限制直接构造,只能调用 getInstance() 方法获取单例对象public static IoDHSingleton getInstance(){//提供对外的公共api获取单例对象//当getInstance方法第一次被调用的时候,它第一次读取HolderClass.ioDHSingleton,内部类HolderClass类得到初始化;//而这个类在装载并被初始化的时候,会初始化它的静态域,从而创ioDHSingleton 的实例,由于是静态的域,因此只会在虚拟机装载类的时候初始化一次,并由虚拟机来保证它的线程安全性。 return HolderClass.ioDHSingleton; } private static class HolderClass{ static { System.out.println("HolderClass 被加载"); } private static IoDHSingleton ioDHSingleton = new IoDHSingleton(); } // 防止反序列化获取多个对象的漏洞 private Object readResolve() throws ObjectStreamException { return HolderClass.ioDHSingleton; } }这个模式的优势在于,getInstance方法并没有被同步,并且只是执行一个域的访问,因此延迟初始化并没有增加任何访问成本。 考虑反射: 由于在调用 SingletonHolder.instance 的时候,才会对单例进行初始化,而且通过反射,是不能从外部类获取内部类的属性的。 所以这种形式,很好的避免了反射入侵。 考虑多线程: 由于静态内部类的特性,只有在其被第一次引用的时候才会被加载,所以可以保证其线程安全性。 总结: 优势:兼顾了懒汉模式的内存优化(使用时才初始化)以及饿汉模式的安全性(不会被反射入侵)。 劣势:需要两个类去做到这一点,虽然不会创建静态内部类的对象,但是其 Class 对象还是会被创建,而且是属于永久带的对象。 18、如何在父类中为子类自动完成所有的hashcode和equals实现?这么做有何优劣。 19、请结合OO设计理念,谈谈访问修饰符public、private、protected、default在应用设计中的作用。 访问修饰符,主要标示修饰块的作用域,方便隔离防护。 public: Java语言中访问限制最宽的修饰符,一般称之为“公共的”。被其修饰的类、属性以及方法不仅可以跨类访问,而且允许跨包(package)访问。 private: Java语言中对访问权限限制的最窄的修饰符,一般称之为“私有的”。被其修饰的类、属性以及方法只能被该类的对象访问,其子类不能访问,更不能允许跨包访问。 protect: 介于public 和 private 之间的一种访问修饰符,一般称之为“保护形”。被其修饰的类、属性以及方法只能被类本身的方法及子类访问,即使子类在不同的包中也可以访问。 default:即不加任何访问修饰符,通常称为“默认访问模式“。该模式下,只允许在同一个包中进行访问。 20、深拷贝和浅拷贝区别。 浅拷贝(Shallow Copy): ①对于数据类型是基本数据类型的成员变量,浅拷贝会直接进行值传递,也就是将该属性值复制一份给新的对象。因为是两份不同的数据,所以对其中一个对象的该成员变量值进行修改,不会影响另一个对象拷贝得到的数据。 ②对于数据类型是引用数据类型的成员变量,比如说成员变量是某个数组、某个类的对象等,那么浅拷贝会进行引用传递,也就是只是将该成员变量的引用值(内存地址)复制一份给新的对象。因为实际上两个对象的该成员变量都指向同一个实例。在这种情况下,在一个对象中修改该成员变量会影响到另一个对象的该成员变量值。 深拷贝: 首先介绍对象图的概念。设想一下,一个类有一个对象,其成员变量中又有一个对象,该对象指向另一个对象,另一个对象又指向另一个对象,直到一个确定的实例。这就形成了对象图。那么,对于深拷贝来说,不仅要复制对象的所有基本数据类型的成员变量值,还要为所有引用数据类型的成员变量申请存储空间,并复制每个引用数据类型成员变量所引用的对象,直到该对象可达的所有对象。也就是说,对象进行深拷贝要对整个对象图进行拷贝! 简单地说,深拷贝对引用数据类型的成员变量的对象图中所有的对象都开辟了内存空间;而浅拷贝只是传递地址指向,新的对象并没有对引用数据类型创建内存空间。 21、数组和链表数据结构描述,各自的时间复杂度。 数组和链表的区别: 1、从逻辑结构角度来看: 数组必须事先定义固定的长度(元素个数),不能适应数据动态地增减的情况。当数据增加时,可能超出原先定义的元素个数;当数据减少时,造成内存浪费。 链表动态地进行存储分配,可以适应数据动态地增减的情况,且可以方便地插入、删除数据项。(数组中插入、删除数据项时,需要移动其它数据项) 2、数组元素在栈区,链表元素在堆区; 3、从内存存储角度来看: (静态)数组从栈中分配空间, 对于程序员方便快速,但自由度小。 链表从堆中分配空间, 自由度大但申请管理比较麻烦。 数组利用下标定位,时间复杂度为O(1),链表定位元素时间复杂度O(n); 数组插入或删除元素的时间复杂度O(n),链表的时间复杂度O(1)。 22、error和exception的区别,CheckedException,RuntimeException的区别。 23、在自己的代码中,如果创建一个java.lang.String类,这个类是否可以被类加载器加载?为什么。 加载过程中会先检查类是否被已加载,检查顺序是自底向上,从Custom ClassLoader到BootStrap ClassLoader逐层检查,只要某个classloader已加载就视为已加载此类,保证此类只所有ClassLoader加载一次。而加载的顺序是自顶向下,也就是说当发现这个类没有的时候会先去让自己的父类去加载,父类没有再让儿子去加载,那么在这个例子中我们自己写的String应该是被Bootstrap ClassLoader加载了,所以App ClassLoader就不会再去加载我们写的String类了,导致我们写的String类是没有被加载的。 24、说一说你对java.lang.Object对象中hashCode和equals方法的理解。在什么场景下需要重新实现这两个方法。 对于equals()与hashcode(),比较通用的规则: ①两个obj,如果equals()相等,hashCode()一定相等 ②两个obj,如果hashCode()相等,equals()不一定相等 25、在jdk1.5中,引入了泛型,泛型的存在是用来解决什么问题。 面向对象的转型只会发生在具有继承关系的父子类中(接口也是继承的一种) 向上转型:其核心目的在于参数的统一上,根本不需要强制类型转换。 向下转型:是为了操作子类定义的特殊功能,需要强制类型转换,可是现在存在的问题是:向下转型其实是一种非常不安全的操作,以为编译的时候,程序不会报错,而在运行的时候会报错,这就是传说中的—迷之报错。 不过呢,在JDK1.5之后,新增加了泛型的技术,这就将上述向下转型的问题消灭在了萌芽之中。 泛型的核心意义在于:类在进行定义的时候可以使用一个标记,此标记就表示类中属性或者方法以及参数的类型,标记在使用的时候,才会去动态的设置类型。 26、Java中的HashSet内部是如何工作的。 HashSet 的内部采用 HashMap来实现。由于 Map 需要 key 和 value,所以HashSet中所有 key 的都有一个默认 value。类似于 HashMap,HashSet 不允许重复的 key,只允许有一个null key,意思就是 HashSet 中只允许存储一个 null 对象。 27、什么是序列化,怎么序列化,为什么序列化,反序列化会遇到什么问题,如何解决。 什么是序列化? 序列化:把对象转换为字节序列的过程称为对象的序列化。 反序列化:把字节序列恢复为对象的过程称为对象的反序列化 什么情况下需要序列化? 当你想把的内存中的对象状态保存到一个文件中或者数据库中时候; 当你想用套接字在网络上传送对象的时候; 当你想通过RMI传输对象的时候; 如何实现序列化? 实现Serializable接口即可 注意事项: transient 修饰的属性,是不会被序列化的 静态static的属性,他不序列化。 实现这个Serializable 接口的时候,一定要给这个 serialVersionUID 赋值 关于 serialVersionUID 的描述: 序列化运行时使用一个称为 serialVersionUID 的版本号与每个可序列化类相关联,该序列号在反序列化过程中用于验证序列化对象的发送者和接收者是否为该对象加载了与序列化兼容的类。如果接收者加载的该对象的类的 serialVersionUID 与对应的发送者的类的版本号不同,则反序列化将会导致 InvalidClassException。可序列化类可以通过声明名为 “serialVersionUID” 的字段(该字段必须是静态 (static)、最终 (final) 的 long 型字段)显式声明其自己的 serialVersionUID 云栖号:https://yqh.aliyun.com第一手的上云资讯,不同行业精选的上云企业案例库,基于众多成功案例萃取而成的最佳实践,助力您上云决策! 原文发布时间:2020-01-19本文作者:长安街本文来自阿里云云栖号合作伙伴“oschina”,了解相关信息可以关注“oschina”

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册