智能仓储 WMS 前端系统 | 语音拣货辅助界面:Web Speech API 集成
# 引言 拣货员的手上总有东西。扫码枪、PDA、纸单,或者一整箱待复核的货。在这种场景下,"解放双手"不是体验加分项,而是效率前提——一边抱箱子一边腾出手点屏幕,是拣货作业里最真实的摩擦。 语音交互的门槛比想象中低:浏览器原生就带 SpeechRecognition 与 speechSynthesis,不需要模型、不需要联网鉴权、不需要装插件。但它的坑也极深——只在 Chrome/Edge 上可用、HTTP 下直接静默失败、单页只能有一个活跃识别器、噪声环境下错误率会塌方。本文落地一套能进生产环境的语音拣货界面:命令式而非听写式的识别设计、有限状态机驱动对话流程、声纹可视化反馈、离线降级与权限兜底。 --- # 一、API 选型:听写与命令式,是两回事 Web Speech API 有两个完全独立的接口,很多人混着用就踩坑: - **SpeechRecognition(识别)**:把语音转文字。这是输入通道,是我们要用的。 - **SpeechSynthesis(合成)**:把文字转语音。这是输出通道,用来做语音播报。 拣货场景用的是**命令式识别**,不是听写。识别目标是一个**有限命令集**("确认""跳过""下一单""数量 12"),而不是自由文本。这个区别决定了后面所有设计。 ```javascript // src/voice/capability.js export function getSpeech() { const SR = window.SpeechRecognition || window.webkitSpeechRecognition; return { supported: !!SR, synthesis: 'speechSynthesis' in window, // 关键:requiresSecureContext。http:// 页面上 API 存在但启动即报错 secureContext: window.isSecureContext, userAgent: navigator.userAgent, lang: navigator.language || 'zh-CN', }; } export function createRecognizer({ lang = 'zh-CN', onResult, onError } = {}) { const SR = window.SpeechRecognition || window.webkitSpeechRecognition; if (!SR) { onError?.({ code: 'unsupported' }); return null; } const rec = new SR(); rec.lang = lang; rec.continuous = false; // 命令式:一次说一句,说完就停 rec.interimResults = true; // 开启临时结果,做实时反馈 rec.maxAlternatives = 3; // 取前 3 个候选,提高容错 let finalTranscript = ''; rec.onresult = (e) => { let interim = ''; for (let i = e.resultIndex; i onError?.({ code: e.error, message: errorMessages[e.error] || e.error }); rec.onend = () => { /* 由状态机决定是否重启 */ }; return { start: () => { try { rec.start(); } catch (err) { onError?.({ code: 'start-failed', err }); } }, stop: () => rec.stop(), abort: () => rec.abort(), }; } ``` 逐段解读: - `webkitSpeechRecognition` 是必须写的前缀。标准属性 `SpeechRecognition` 在 Safari 上不存在,不写兜底就是整段失效。 - `isSecureContext` 是硬性门槛。HTTP 页面上 `SR` 构造函数虽然存在,调用 `start()` 会抛 `NotAllowedError`。生产环境必须从网关层强制 HTTPS,不能等到联调才发现。 - `continuous: false` 是命令式识别的关键。设为 `true` 会持续监听,容易把拣货员和同事的对话都收进去,误触发率直线上升,也更耗电。 - `maxAlternatives: 3` 配合 `matchCommand` 遍历候选。ASR 的第一个候选未必最匹配命令集——它选的是"语言上最可能",而不是"命令集里最像"。遍历三个候选能显著降低误拒。 - `onresult` 里区分 `isFinal` 与临时结果。临时结果用来做实时回显(让用户看到"我在听"),最终结果才触发命令。混在一起会导致一个"确认"被触发三四次。 - `start()` 的 try/catch 不是多余。`rec.start()` 在识别器已经在运行时调用会抛 `InvalidStateError`,状态机并发调用时必然踩到。 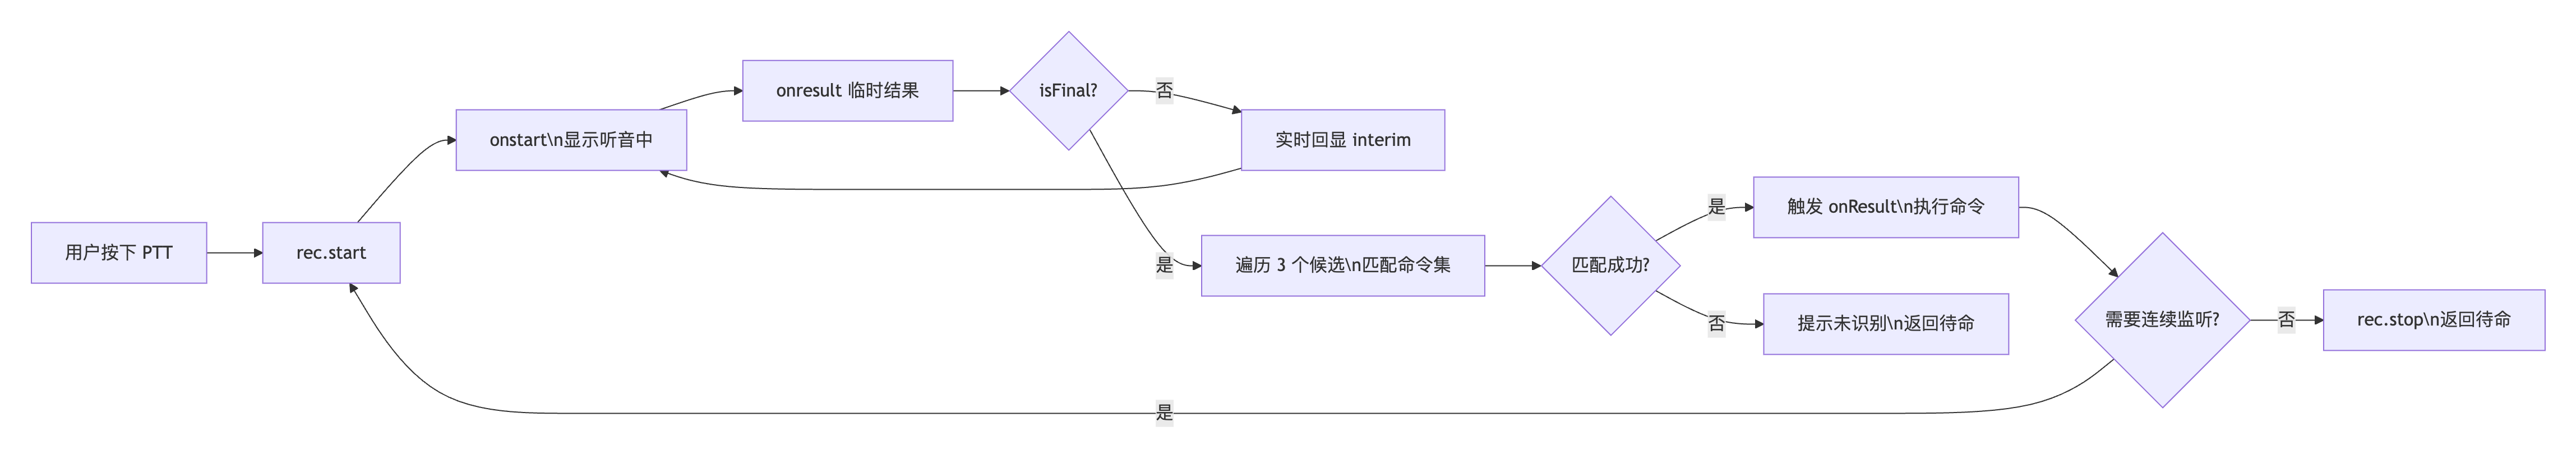 --- # 二、命令匹配:用有限状态机,不用 if-else 瀑布 "确认""下一单"这种静态命令用正则就够。真正复杂的是带参数的命令——"数量 12""拣货位 A03",以及多轮确认——"要跳过吗?""是的"。它们必须放进状态机。 ```javascript // src/voice/commands.js import { createMachine } from 'xstate'; // 纯 JS 版状态机,不依赖 TS const COMMAND_PATTERNS = { confirm: [/^确认$/, /^好的$/, /^对$/, /^是$/], cancel: [/^(取消|算了|不要)$/], skip: [/^(跳过|下一个|跳过这个)$/], nextOrder: [/^(下一单|下一张单|继续)$/], repeat: [/^(再说一遍|重复|没听清)$/], qty: [/数量\s*(\d+)/, /^(\d+)\s*(个|件|箱)?$/], // "数量12" 或 "12件" locate: [/^(找一下|定位|在哪)\s*([A-Za-z0-9\-]+)/], // "找一下 A03-02" }; export function matchCommand(result, altIndex = 0) { const text = (result[altIndex]?.transcript || '').trim(); for (const [name, patterns] of Object.entries(COMMAND_PATTERNS)) { for (const re of patterns) { const m = text.match(re); if (m) { const cmd = { name, raw: text, confidence: result[altIndex].confidence }; if (m[1] !== undefined) cmd.arg = m[1]; if (m[2] !== undefined) cmd.arg2 = m[2]; return cmd; } } } return null; } // 拣货流程状态机:待命 → 听音 → 待确认 → 执行 export const pickingMachine = createMachine({ id: 'pickingVoice', initial: 'idle', states: { idle: { on: { PTT_DOWN: 'listening' }, }, listening: { on: { RECOGNIZED: [ { target: 'awaitingConfirm', cond: 'needsConfirm', actions: 'cacheCommand' }, { target: 'executing', actions: 'execute' }, ], NO_MATCH: 'idle', ERROR: 'idle', }, }, awaitingConfirm: { on: { PTT_DOWN: 'listening', // 再次按下重新听 RECOGNIZED: [ { target: 'executing', cond: 'isAffirmative', actions: 'execute' }, { target: 'idle', cond: 'isNegative' }, ], }, }, executing: { on: { DONE: 'idle' }, }, }, }); ``` 逐段解读: - **正则按业务优先级排列**。先匹配"确认""取消"这类动作词,再匹配"数量 12"这类带参命令。顺序错了,"12 件"可能被某个贪婪正则提前吞掉。 - `m[1]`、`m[2]` 的捕获组设计让 `arg` 承载数量、`arg2` 承载单位。这是中文命令解析最实用的技巧,不需要 NLP 模型。 - `confidence` 是 ASR 给的置信度,0~1。可以设置阈值(如 { if (!stream) return; const ctx = new AudioContext(); const source = ctx.createMediaStreamSource(stream); const analyser = ctx.createAnalyser(); analyser.fftSize = 64; // 32 个频点,够做声波动画 analyser.smoothingTimeConstant = 0.8; // 平滑,避免跳变 source.connect(analyser); const data = new Uint8Array(analyser.frequencyBinCount); function tick() { analyser.getByteFrequencyData(data); setBars(new Uint8Array(data)); // 频谱柱状图 let sum = 0; for (let i = 0; i { cancelAnimationFrame(raf.current); source.disconnect(); ctx.close(); }; }, [stream]); return { volume, bars }; } export function AudioMeter({ volume }) { // 音量越大图标越红、越大;静音时灰显,提示"没收音" const scale = 1 + volume * 0.6; return ( 0.6 ? '#ef4444' : volume > 0.1 ? '#3b82f6' : '#cbd5e1', }} aria-label={volume > 0.05 ? '正在收音' : '未检测到声音'} > 🎙 ); } ``` 逐段解读: - `AudioContext` 只能在用户手势后创建或恢复,否则浏览器会 suspend 它。这是浏览器自动播放策略的延伸。必须让首次启动走按钮点击。 - `fftSize = 64` 给出 32 个频点,对动画足够。取更大值只是浪费计算。频谱动画比单一音量圆点包含更多信息,用户能看出"有没有声音进来"。 - `smoothingTimeConstant = 0.8` 做帧间平滑。不设的话声波会高频抖动,看起来像噪声而非反馈。 - `volume` 驱动三个视觉状态:红(声音过大,可能爆音或距离过近)、蓝(正常收音)、灰(没声音)。**灰色状态极其重要**——仓库噪声大,如果系统没收音,用户必须立刻知道,而不是对着屏幕说三遍。 - 清理函数 `ctx.close()` 不可省。AudioContext 是重资源,组件卸载不释放会持续占用电量。  --- # 四、语音播报:提示音 + 内容,合成要排队 `SpeechSynthesis` 本身不难,难的是**别把用户的耳朵吵炸**。 ```javascript // src/voice/tts.js let queue = []; let speaking = false; export function speak(text, { priority = 'normal', voice = null } = {}) { return new Promise((resolve) => { const u = new SpeechSynthesisUtterance(text); u.lang = 'zh-CN'; u.rate = 1.15; // 拣货提示要快,1.15 是现场可读的较快值 u.pitch = 1.0; u.volume = 0.9; if (voice) u.voice = voice; u.onend = () => { speaking = false; resolve(); drain(); }; u.onerror = () => { speaking = false; resolve(); drain(); }; if (priority === 'urgent') queue.unshift(u); // 紧急提示插队 else queue.push(u); drain(); }); } function drain() { if (speaking || queue.length === 0) return; speaking = true; speechSynthesis.speak(queue.shift()); } // 关键:iOS 上队列会被 GC 清空,需要"喂狗" setInterval(() => { if (speechSynthesis.speaking || speechSynthesis.pending) { speechSynthesis.resume(); } }, 5000); export function cancelSpeech() { queue = []; speechSynthesis.cancel(); } ``` 逐段解读: - **必须自己排队**。同时调用两次 `speechSynthesis.speak`,行为因浏览器而异——Chrome 会串行,Safari 会丢第一条。统一队列是唯一可靠做法。 - `rate = 1.15` 是经过现场验证的取值。拣货提示是短句、重复度高,正常语速会拖慢作业。太快则听不清数字,1.15 是平衡值。长句(如异常说明)应单独用 1.0。 - **iOS 的队列丢失 Bug** 是必须知道的坑:iOS Safari 在合成进行中会 GC 掉待播队列。每 5 秒 `resume()` 一次是目前已知的有效规避手段,虽然丑但有效。 - `priority: 'urgent'` 的插队机制服务于安全。通道堵塞、路径需重新规划这类提示必须打断当前播报,而不是排在"下一拣货位是 A03"后面。 - `cancelSpeech` 用于用户主动停止。语音交互里"随时能打断"和"能开始"同等重要。 --- # 五、UI 组件:一句话、一个波形、一个按钮 语音界面要极简。拣货员不看界面,界面只是在出错时给信息。 ```javascript // src/voice/VoicePicking.jsx import React, { useState } from 'react'; import { createRecognizer, matchCommand } from './commands'; export function VoicePicking({ currentTask, onCommand }) { const [state, setState] = useState('idle'); // idle | listening | processing | error const [heard, setHeard] = useState(''); const [errMsg, setErrMsg] = useState(''); const rec = React.useMemo(() => createRecognizer({ onResult: (cmd) => { setHeard(cmd.raw); onCommand(cmd); setState('idle'); }, onError: (e) => { setErrMsg(e.message); setState('error'); }, }), []); function handleDown() { setHeard(''); setErrMsg(''); rec?.start(); setState('listening'); speak('请说指令', { priority: 'urgent' }); } function handleUp() { rec?.stop(); } return ( {currentTask?.sku} 目标数量 {currentTask?.qty} {state === 'listening' ? '正在听…' : '按住说话'} {heard && 听到:「{heard}」} {errMsg && {errMsg}} ); } ``` - **PTT(Push-To-Talk)是必选项**。始终监听的语音交互在仓库里不可用——环境噪声、同事对话、叉车声都会被收进去。按下才听、松手就停,既省电又准确。 - `aria-live="polite"` 让读屏用户能感知识别结果,而 `aria-pressed` 表达按钮的按下状态。这两个属性能让语音界面本身保持可访问。 - 同时绑定 `onMouseDown/Up` 与 `onTouchStart/End`。只绑鼠标事件在触屏 PDA 上会有 300ms 延迟和触摸行为冲突。 - 出错时给出可读的中文提示(`errorMessages` 映射),而不是把 `not-allowed` 这种内部错误码甩给用户。  --- # 六、降级与权限:不能用的 API 要有退路 语音 API 的可用性严重依赖环境和浏览器。降级策略必须在架构层面设计,而不是报错后补丁。 ```javascript // src/voice/degrade.js export function pickVoiceStrategy(cap) { if (!cap.secureContext) { return { mode: 'disabled', reason: '页面需 HTTPS,语音服务不可用', fallback: 'manual' }; } if (!cap.supported) { return { mode: 'stt-fallback', reason: '当前浏览器不支持语音识别', fallback: 'keyboard' }; } if (!cap.synthesis) { return { mode: 'recognition-only', fallback: 'visual-toast' }; } return { mode: 'full', fallback: 'keyboard' }; } export async function requestMicrophone() { try { const stream = await navigator.mediaDevices.getUserMedia({ audio: true, video: false }); return { stream, granted: true }; } catch (e) { return { granted: false, reason: e.name === 'NotAllowedError' ? '麦克风权限被拒绝,请在设置中开启' : e.name === 'NotFoundError' ? '未检测到麦克风设备' : '无法访问麦克风', }; } } ``` - **HTTPS 是硬门槛**,必须在网关层强制,前端只能提示,无法绕过。 - **浏览器覆盖**是现实约束:SpeechRecognition 仅在 Chrome 与 Edge 上可用,Safari/Firefox 没有实现。所以 `fallback: 'keyboard'` 不是备胎,而是相当比例用户的**主路径**。 - 权限被拒绝时的提示必须**告诉用户在哪改**。"麦克风权限被拒绝"这句话没有行动指引,等于没提示。 - 音频轨道在用户拒绝后不再请求。反复弹权限框会让用户直接永久拒绝,反而彻底关闭这条通道。 |场景|策略|用户体验| | --- | --- | --- | |HTTPS + Chrome/Edge|完整语音识别 + 合成|主流程| |HTTPS + 其他浏览器|识别不可用,合成可能可用|保留语音播报,输入走键盘/扫码| |HTTP 页面|完全禁用|明确提示需 HTTPS| |麦克风被拒|语音通道关闭|提供设置入口,其余走手动| |识别连续失败 3 次|自动切键盘输入|不跟环境较劲| --- # 七、噪声与准确率:命令集设计本身就是优化 代码解决不了仓库噪声,但**命令集设计可以大幅降低噪声的影响**。 - **静态命令集 > 自由文本**。识别器在命令集上不需要理解语义,只需匹配固定模式,准确率远高于听写。这是语音拣货能用的根本原因。 - **避免同音字冲突**。命令词要选发音差异大的:"确认/取消/跳过"比"好的/可以/行"区分度高得多。设计命令集时应做过发音相似度筛查。 - **数字要说完整**。"数量 12"比"一二"可靠。涉及 SKU 编码、库位码这类字母数字混合内容,**语音识别准确率会显著下降**,这类场景应强制扫码,不要指望 ASR。 - **短句优先**。单次 utterance 控制在 4 字以内,过长的指令在噪声下几乎必然断裂。 - **PTT 降低信噪比**。按下才采集,等于把环境噪声挡在识别窗口外。这是最有效也最便宜的"降噪算法"。 --- # 结语 本文交付了一套能在真实仓库使用的语音拣货辅助前端。五条核心结论: **第一,命令式识别才是正解。** SpeechRecognition 配 `maxAlternatives: 3` 遍历候选、`continuous: false` 一次一句,识别目标限定为有限命令集,准确率与稳定性远高于听写模式。 **第二,有限状态机是语音交互的骨架。** 它区分了"需要确认"与"直接执行",让破坏性操作(跳过、取消)必须经过二次确认,同时把识别器的并发调用约束在合法状态内。 **第三,反馈不是装饰而是功能。** AudioContext 频谱驱动的波形与音量色态,让用户实时知道系统是否收音;`aria-live` 让识别结果对读屏可用。听不见反馈的语音界面等于不可用。 **第四,语音合成要自己排队。**`SpeechSynthesis` 没有可靠队列,必须包一层;iOS 的队列 GC 问题需要 `resume()` 喂狗;紧急提示要能插队。 **第五,降级决定可用性。** HTTPS 是硬门槛、浏览器覆盖不均、麦克风权限可能被拒——三条主路径之外必须存在键盘/扫码兜底,且命令集设计本身要规避同音冲突与编码识别的天然弱点。