首页 文章 精选 留言 我的

精选列表

搜索[全栈管理],共10000篇文章
优秀的个人博客,低调大师

超全机器学习资料合集!(附下载)

最近在群里发现一些小伙伴在寻找资料的时候总是无处可找,网上出现很多收集免费资料再去打包收钱的人,我看不惯这样的人,所以把自己收集的文件分享给大家。 百度云经常抽风,如果大家遇到了失效的链接,请在评论区给我评论,我会很快的更新。 1:数据挖掘:概念与技术(中文第三版)链接: https://pan.baidu.com/s/1skTjb69 密码: 6ixx 2:矩阵分析.美国 Roger.A.Horn.链接: https://pan.baidu.com/s/1boVDyAN 密码: p85p 3:统计学习方法 李航链接: https://pan.baidu.com/s/1o85OO22 密码: v3ri 4:概率论与数理统计 - 陈希孺.pdf链接: https://pan.baidu.com/s/1o7RTgXc 密码: 7r63 5:模式

优秀的个人博客,低调大师

历代GPU架构全解析

原文链接 http://www.pcpop.com/doc/0/521/521833.shtml 泡泡网 显卡 频道4月30日 NVIDIA 与 ATI ( AMD )的GPU之战,远比 Intel 和AMD的 CPU 之战有意思,毕竟双方的实力差距并没有那么悬殊,经常斗得是难解难分。N/A的连年征战给我们带来无与伦比游戏画面和优秀产品的同时,也为喜欢IT技术的朋友带来了许多乐趣和谈资,只有深爱硬件技术的朋友才能有所体会。 掐指一算,从GPU诞生至今双方都已推出了十代产品,每一代产品之间的对决都令无数玩家心动不已,而其中最精彩的战役往往在微软DirectX API版本更新时出现。虽说胜败乃兵家常事,但NVIDIA和ATI每一代产品谁更强大似乎有某种规律可循,而且与DirectX有着某种微妙的关系。 相信很多人都有这种感觉,似乎谁与微软走的更近,谁能最先支持新版DirectX API,谁就能占据更多的优势。但也有例外,比如DX8.1对于Radeon 8500的帮助有限,DX10.1也没有给HD3000带来好运。其实这些只是表象,如果我们能够透过现象看其本质的话,就会发现DirectX与GPU 的架构是有直接关系的,而GPU架构的优劣直接了决定一代产品的成败。 所以,今天我们就抛开GPU的晶体管数、管线/流处理器规模、工艺、频率、功能等等技术参数不谈,我们将关注的焦点集中在GPU体系架构方面。看看每逢DirectX版本有重大更新时,NVIDIA与ATI是如何博弈的,克敌制胜的关键到底是什么? DirectX 7.0特性:硬件T&L 在DirectX 5.0以前,这个被微软整合在Windows操作系统内部的图形API并没有现在这么风光,当时的显卡和游戏都以支持OpenGL和Glide(3DFX的专用API)为荣,DirectX在持续不断的改进与发展,但始终都没能超越对手,一方面基于DOS系统的Windows还不够强大,另一方面微软的影响力还没到左右游戏开发商和芯片厂商的地步。 直到Windows 95发布之后,全新的图形界面让整个业界都兴奋不已,90%的占有率直接带动了整个行业的需求,也迫使全球软硬件厂商都不得不向其靠拢。此时整合 Win95整合的DirectX 6.0也有了足够的实力与OpenGL/Glide分庭抗力,在技术特性不输与人的情况下,DirectX的影响力与日剧增。 ●DirectX 7.0确定权威:核心技术T&L DirectX 7.0是一次革命性的改进,其最大的特色就是支持Transform & Lighting(T&L,坐标转换和光源)。 3D游戏中的任何一个物体都有一个坐标,当此物体运动时,它的坐标发生变化,这指的就是坐标转换;3D游戏中除了场景+物体还需要灯光,没有灯光就没有3D物体的表现,无论是实时3D游戏还是3D影像渲染,加上灯光的3D渲染是最消耗资源的。 基于T&L技术的演示Demo 在T&L问世之前,位置转换和灯光都需要CPU来 计算,CPU速度越快,游戏表现越流畅。使用了T&L功能后,这两种效果的计算用显卡核心来计算,这样就可以把CPU从繁忙的劳动中解脱出来,让 CPU做他该作的事情,比如逻辑运算、数据计算等等。换句话说,DX7显卡用T&L渲染游戏时,即使没有高速的CPU,同样能能流畅的跑3D游 戏。 DirectX 7.0架构:首颗GPU GeForce 256 首颗GPU诞生:GeForce 256(NV10) T&L优秀的特性成为当时业界关注的焦点,那么首款支持DX7与T&L的显卡自然备受期待,NVIDIA的GeForce 256就是这样一款划时代的产品,为了突出它先进的技术特性,NVIDIA将GeForce 256的显示核心称为GPU(Graphic Processing Unit,图形处理器)。 GeForce 256所采用的核心技术除了硬件T&L之外,还有立方环境材质贴图、顶点混合、纹理压缩和凹凸映射贴图、双重纹理四像素、256位渲染引擎等诸多先进技术。在性能大幅提升的同时,3D游戏的画面得到了质的提升。 此后发布的GeForce 2 GTS就是GeForce 256的提速版本,架构、规格和技术没有多少改变。因此可以说GeForce 256就已经确立了当今GPU的整体架构雏形,我们可以看到它拥有专门的坐标转换与光源引擎,还有装配引擎、渲染管线、后期处理模块等等,这些功能单元基 本都被沿用至今。 两强争霸局面形成:Radeon 256 在DX7大势所趋的局面下,ATI也发布了首款DX7显卡,其命名都与NVIDIA惊人的一致——Radeon 256,由此掀开了NVIDIA与ATI、GeForce与Radeon争霸的局面。 Radeon 256独特的单管线3纹理架构 Radeon 256同样支持硬件T&L、环境贴图和凹凸贴图,还支持Hyper及和DOT3压缩技术,Radeon 256只有两条渲染管线,但每条管线拥有多达3个纹理单元,而GeForce 256每条管线只有1一个纹理单元,GeForce 2 GTS才改进为2个。但遗憾的是Radeon 256的第3个贴图单元直到它退市的时候也没有任何程序能够支持它,同时令人诟病的驱动也令用户大为恼火。 Radeon 256及其衍生的Radeon VE/LE/SE等都是优秀的产品,技术与架构不输给GeForce系列,功能甚至还更丰富,但糟糕的软硬件支持度导致它无法同GeForce相抗衡,口碑和市场都不如人意。 小结:DX7架构平分秋色,硬件规格决定性能 GeForce 256与Radeon 256的基本架构是相同的,不同的是管线设计,GeForce 256拥有更多4条管线,但纹理单元也只有4个;Radeon 256虽然只有2条管线,但每管线拥有3个纹理单元,而且工作频率很高,因此在理论性能上占优势。 在当时来说,游戏大量使用了各种纹理贴图,因此对纹理单元提出了很高的要求,所以NVIDIA在GeForce 2 GTS当中改进为单管线双纹理。NVIDIA管线:纹理=1:2、ATI管线:纹理=1:3的架构都维持了很多年,直到DX9时代才有了较大的变化。 DirectX 8.0特性:像素和顶点管线 ●DirectX 8.0:引入像素和顶点两大渲染管线 面向图形计算,让GPU逐渐找到了自己的方向,那就是给予用户更真更快地视觉体验,但是GPU架构也遇到一些问题亟待解决。首要问题就是,要实现更加复杂 多变的图形效果,不能仅仅依赖三角形生成和固定光影转换,虽然当时游戏画面的提高基本上都是通过大量的多边形、更复杂的贴图来实现的。 但后期的发展中,顶点和像素运算的需求量猛增。每个顶点都包含许多信息,比顶点上的纹理信息,散光和映射光源下表现的颜色,所以在生成多边形的时候带上这些附加运算,就可以带来更多的效果,但这也更加考验顶点和像素计算能力。 2001年微软发布了DirectX 8.0,一场新的显卡革命开始,它首次引入了ShaderModel的概念,ShaderModel就相当于是GPU的图形渲染指令集。其中像素渲染引擎 (Pixel Shader)与顶点渲染引擎(VertexShader)都是ShaderModel 1.0的一部分,此后每逢DirectX有重大版本更新时,ShaderModel也会相应的升级版本,技术特性都会大大增强。 与DX7引入硬件T&L仅仅实现的固定光影转换相比,VS和PS单元的灵活性更大,它使GPU真正成为了可编程的处理器,时至今日DX11时代 ShaderModel都在不停地更新,以便渲染出更逼真更完美的画面。这意味着程序员可通过它们实现3D场景构建的难度大大降低,但在当时来说可编程性 还是很弱,GPU的这一特性还是太超前了。 DX8动态光影效果展示:变色龙和不同角度的人脸 DirectX 8.0当中的Pixel Shader和Vertex Shader的引入,使得GPU在硬件逻辑上真正支持像素和顶点的可编程,反映在特效上就是动态光影效果,当时波光粼粼的水面都是第一次展现在玩家面前。 但是DX8的普及之路并不顺畅,主要是因为当时的DX8显卡都定位太高,NVIDIA和ATI双方都没有推出过低端DX8显卡,热卖的产品都是DX7,直到DX9诞生之后,双方才把昔日高端的DX8显卡当作低端产品处理。 DirectX 8.0架构:N/A争霸开始 首款DX8显卡:GeForce 3 Ti 在DX8之前,无论NVIDIA还是ATI,都在强调显卡前端及后端输出。而Shader理念提出之后,双方逐渐将竞争重点放在了显卡的渲染核心部分—— 像素渲染管线和顶点渲染管线,无论是GeForce 3 Ti还是Radeon 8500都内置的规格和频率更强的PS和VS单元。当然也对显卡的后端ROP(光栅化引擎,负责完成像素的输出)也做了相应的改进,各种各样的多重采样 AA模式和材质过滤技术逐步得以实现。 上图就是GeForce 3的核心架构图,可以看出,由于DX8渲染模式的改变,GeForce 3相对于DX7的GeForce 2/256有了天翻地覆的变化,一半以上的模块需要重新设计(绿色部分)。 GeForce 3的顶点管线设计 硬件规格方面,GeForce 3依然只有4条渲染管线,每条管线内置2个纹理单元,这与上代的GeForce 2没有区别。但是GeForce 3的核心晶体管数竟然是GeForce 2的两倍以上,额外的晶体管大都用在了顶点管线部分,虽然它只有一个顶点着色单元。这个顶点着色单元其实就是一个4D SIMD(单指令多数据流)处理器,可以计算最多16项数据的顶点,这在当时来说运算能力已经非常富裕了。 不过,主流的游戏还是基于DX7开发,因此GeForce 3的VS单元很多时候都派不上用场,由此导致GeForce 3在DX7游戏当中领先GeForce 2 Ti的优势并不大,毕竟它们的像素渲染管线和纹理单元数目是相同的,频率也没有提升太多。 ATI直上DX8.1:Radeon 8500 DX8方面ATI再次落后于NVIDIA,但后发制人也有好处,ATI直接采用了微软更新的DX8.1 API,因此在硬件特性方面要更胜一筹。不过DX8.1的改进极为有限,只是改进了大纹理水波纹的效能,未能得到整个业界的重视。 Radeon 8500与DX7版的Radeon系列相比,架构上也产生了翻天覆地的变化,除了加入顶点引擎外,更多尚处于实验性的技术都被置于其中,而且2D输出部分的功能更为丰富,可以说在技术和功能方面完全超越了GeForce 3 Ti。 规格方面,Radeon 8500拥有4条像素渲染管线,这与GeForce 3是相同的,但是8500拥有2个顶点着色单元,而GeForce 3只有1个,这就使得8500的理论性能更占优势。纹理单元方面ATI放弃了管线:纹理=1:3的设计,采用了与NVIDIA相同的1:2设计,因为第3 个纹理单元在多数游戏中都毫无用处,这样双方的纹理单元数量也完全相同。 小结:DX8架构ATI更出色,NV性能更强 整体来看双方都是重新设计的优秀架构,考虑到众多的特色功能和技术,Radeon 8500的确要优于GeForce 3 Ti。这是在3DFX灭亡之后,第一次有一家公司对NVIDIA造成如此大的压力,所以NVIDIA发布了更高频率的GeForce 3 Ti 500才勉强夺回性能之王的宝座。当然NVIDIA成熟稳定的驱动和长期积累的用户口碑以帮助GeForce 3 Ti力压Radeon 8500系列。 后期NVIDIA推出更多管线的GeForce 4 Ti自然拥有更强的DX8性能,但考虑到ATI方面没有与之相对应的产品,就不做对比了,因为ATI已经直接进入了DX9时代。 DirectX 9.0特性:高精度渲染 ●DirectX 9.0:高精度渲染时代来临 2002年底,微软发布DirectX 9.0,如果从技术规格上看,DX9似乎没有DX7和DX8那种让人眼前一亮的革命性技术,它只是将ShaderModel版本从1.0升级到2.0而 已。其实不然,此次ShaderModel指令集的改进让图形渲染画质提高到了新的水平。 首先,PixelShader 2.0具备完全可编程架构,能对纹理效果即时演算、动态纹理贴图,还不占用显存,理论上对材质贴图的分辨率的精度提高无限多;另外PS1.4只能支持28 个硬件指令,同时操作6个材质,而PS2.0却可以支持160个硬件指令,同时操作16个材质数量,新的高精度浮点数据规格可以使用多重纹理贴图,可操作 的指令数可以任意长,电影级别的显示效果轻而易举的实现。 3DMark03中的最后一个场景就是DX9渲染,让人眼前一亮 其次,VertexShader 2.0通过增加顶点指令的灵活性,显著的提高了老版本的顶点性能,新的控制指令,可以用通用的程序代替以前专用的单独着色程序,效率提高许多倍;增加循环 操作指令,减少工作时间,提高处理效率;扩展着色指令个数,从128个提升到256个。 Radeon 9700所提供的HDR Demo 另外,增加对浮点数据的处理功能,以前只能对整数进行处理,这样提高渲染精度,使最终处理的色彩格式达到电影级别。突破了以前限制PC图形图象质量在数学上的精度障碍,它的每条渲染流水线都升级为128位浮点颜色,让游戏程序设计师们更容易更轻松的创造出更漂亮的效果,让程序员编程更容易。 DirectX 9.0架构:"真DX9"大获全胜 首款DX9显卡——Radeon 9700 当NVIDIA沉浸于GeForce 4 Ti大获全胜的DX8时代时,ATI在DX9标准正式确立之前就提前发布了Radeon 9700显卡,打得NVIDIA措手不及。这款产品来得如此突然,以至于ATI发布之时甚至没有提供相关技术PPT/PDF。 由于DX9相比DX8并没有改变3D渲染流程,仅仅是强化了ShaderModel指令集,因此R300的架构相比R200改进并不大,主要的变化是规模 的扩充与外围控制模块的加强。比如:首次使用256bit显存控制器、类似CPU的FCBGA封装、更先进的纹理压缩技术以及后期处理单元。 R300的顶点和像素着色单元结构 当然,R300的Shader单元经过了重新设计,定址、色彩和纹理单元都支持浮点运算精度,这是它能够完美运行DX9程序的关键。R300核心拥有8条 像素渲染管线及4个顶点着色单元,每条像素管线中只有1个纹理单元。至此ATI的像素与纹理的比例从1:3到1:2再到1:1,在DX9C时代将会进一步 拉大至3:1,也就是风靡一时的3:1架构,当然这是后话了。 NVIDIA遭遇滑铁卢——GeForce FX5800 NV30核心采用了业界最先进的0.13微米工艺制造,并使用了最高频率的GDDR2显存,而且发布时间较晚,理应占尽优势才对。但是这一次NVIDIA没能跟上微软的步伐,不仅在时间上晚于ATI,而且在DX9技术方面也未能超越。NV30的架构存在较大的缺陷,NVIDIA艰难的完成了从DX8到DX9的过渡,但结果很不理想。 从宏观上说,NV30的整体架构更像是一个DX7(固定功能TRUE T&L单元)、DX8(FX12combiner整数处理单元)、DX9(浮点像素单元)的混合体。而在DX9的应用中,不能出现非浮点精度的运 算,所以前两者是不起作用的,造成了NV30晶体管资源的浪费,同时也影响了性能。 NV30的PiexlShader单元没有Co-issue(标量指令+矢量指令并行处理)能力,而在DX9中,单周期3D+1D是最常见指令处理方式, 即在很多情况下RGB+A是需要非绑定执行的,这时候NV30就无法并行执行,指令吞吐量大大降低。其次,NV30没有miniALU单元,也限制了 NV30的浮点运算能力(在NV35中DX8整数单元被替换为miniALU)。 另外,NV30在寄存器设计(数量及调用方式)、指令存储方式(读写至显存)等方面也有缺陷。NV30的寄存器数量较少,不能满足实际程序的需要。而且, 用微软的HLSL语言所编写的pixel shader2.0代码可以说NV30的“天敌”,这些shader代码会使用大量的临时寄存器,并且将材质指令打包成块,但是NV30所采用的显存是 DDR-SDRAM,不具备块操作能力。同时,NV30材质数据的读取效率低下,导致核心的Cache命中率有所下降,对显存带宽的消耗进一步加大。 由于NV30是VILW(超长指令,可同时包含标量和SIMD指令)设计类型的处理器,对显卡驱动的Shader编译器效率有较高的要求。排列顺序恰当的 shader代码可以大幅度提升核心的处理能力。在早期的一些游戏中,这种优化还是起到了一定的作用。但对于后期Shader运算任务更为繁重的游戏则效 果不大。 最终,虽然NV30与上代的NV25相比架构变化很大,但性能方面全面落后与对手的R300。不过NV30的架构还是有一定的前瞻性,ATI的R600在Shader设计方面与NV30有很多相似之处。 小结:非“真DX9架构”导致NV30失败 现在再来看看,相信没人会认为DX9的改进有限了。正是由于NVIDIA没能适应DX9所带来ShaderModel指令的诸多改进,采用DX8+DX9 混合式的架构,才导致NV30存在很大缺陷,在运行DX9游戏时效率很低。另外冒险采用先进工艺、不成熟的GDDR2显存、128bit位宽这些都极大的 限制了NV30的性能,即便在DX8游戏中都无法胜过R300。 而ATI则占据天时地利人和等一切优势,完全按照DX9标准而设计,甚至在DX9标准确立之前就早早的发布了DX9显卡,这不免让人感觉ATI和微软之间存在微妙的关系,“阴”了NVIDIA一把。 DirectX 9.0c特性:震古烁今的HDR 这是DirectX历史上唯一一次半代更新就引起渲染大波的版本,DirectX 9.0c,大名鼎鼎的HDR技术诞生。 ●DirectX 9.0c:无与伦比的光影渲染 DX9也是一次革命性的改进,但由于没有代表性的关键技术,以至于被广大用户所忽视,其实ShaderModel从1.0升级到2.0给图像渲染品质带来 了巨大的提升。DX9的第三个版本DX9C则更进一步,将ShaderModel从2.0升级至3.0,这一次又能带来什么呢? ShaderModel 3.0除了继续扩展指令长度之外,还提升了指令执行能力,它开始支持动态分支操作,像素程序开始支持分支操作(包括循环、if/else等),支持函数调 用。因此DX9C和SM3.0标准的推出,可以说是DirectX发展历程中的重要转折点。 SM3.0除了取消指令数限制和加入位移贴图等新特性之外,更多的特性都是在解决游戏的执行效率和品质上下功夫,SM3.0诞生之后,人们对待游戏的态度也开始从过去单纯地追求速度,转变到游戏画质和运行速度两者兼顾。因此SM3.0对游戏产业的影响可谓深远。 以上诸多改进相信很多人都不关心也不想知道,绝大多数人记住的只有一个,那就是只有DX9C显卡才支持HDR技术,因为HDR所带来华丽的光影效果给所有人都留下了深刻的印象,那种从暗淡无光到流光溢彩的美好回忆,可以说是前无古人后无来者的! HDR的全称是High Dynamic Range,即高动态范围,是一种色彩存储方式,在游戏用于存储渲染和光照数据。HDR渲染可以用4句话来概括:1.亮的地方很亮;2.暗的地方很 暗;3.亮暗部的细节非常非常明显;4.所有光照为实时计算生成,可模拟人眼视网膜动态改变明暗细节。 HDR(高动态范围)渲染 在DX9C之前,HDR已经得到了广泛应用,一般有FP16 HDR(半精度浮点型)和INT32 HDR(整数型),但效果都不如人意,FP16的动态范围不够大,而IN32的效率很低,因此这些HDR格式并未带来震撼效果。而FP32 HDR(32bit浮点格式)的诞生则大大拓展了明暗度扩展空间,使得游戏的光影效果有了质的提升,当年的《细胞分裂》、《FarCry》、 《3DMark06》等一系列游戏开启HDR后的画面让人惊讶不已! DirectX 9.0c架构:6800领衔1900收官 首款DX9C显卡——GeForce 6800 在经历了GeForce FX系列惨痛的失败后,NVIDIA痛定思痛,要挽回在高端产品上的失利局面,仅靠架构已完全定型的NV3x系列作一定程度的增补显然是很难实现的。 NVIDIA将更大的希望押宝在了新一代产品之上,它吸取了上一代产品的教训,重新设计的架构和完整支持DX9C标准,让这款显卡以全新的形象展现在用户 面前。甚至有分析家评论GeForce 6800和GeForce FX简直不是一家公司设计的产品,其架构变化之大可见一斑! NV3X最大的弊端就是像素渲染单元效能低下,而NV40最强大之处就在像素单元架构部分。NV40拥有多达16条像素渲染管线暂且不谈,其每一个PSU 的结构都值得探讨,NVIDIA将其称为Superscalar(超标量)的设计。普通的像素渲染管线只提供一组着色器单元,每个周期最多只能执行四组运 算,而NV40的超标量架构则内含第二组着色器单元,让每个周期的运算量增加一倍。 NV40的像素渲染管线结构 正因为如此,对手ATI的X800系列虽然在硬件规格上与NV40完全相同,但在DX9b游戏中的性能差距依然不小,这就是超标量架构的优势。当然固步自封的ATI在X800时代依然仅支持DX9b,无法开启HDR,丧失了很多卖点,让用户大失所望。 6800的成功让NVIDIA风光无限,整个GeForce 6家族在各个价位都力压对手的X800家族,而且完美的架构使得NVIDIA可以轻易的扩充规模,发布了拥有多达24条像素渲染管线的第二代DX9C显卡 ——GeForce 7800系列(其架构基本没变,只做了些许优化,这里就不多做介绍了)。 支持HDR+AA的DX9C显卡——X1800/X1900 X800的对手是6800系列,但它既没有性能优势,也不支持DX9C/HDR,这使得ATI经历了9700/9800系列短暂的辉煌之后再次陷入被动局 面。于是,ATI开始研发下一代GPU,改良架构,准备重夺王位。但事与愿违,R520核心的X1800XT虽然使用了全新的架构,完美支持DX9C,但 依然没能击败已经发布半年之久的7800GTX,因为X1800XT依然只有16条像素渲染管线,而7800GTX拥有多达24条,差距如此之大,根本无 法用新架构的效率及高频率来弥补。 R520与R580的架构几乎完全相同,不同的只有像素单元数量 当时谁都没有料到ATI还预留了一手,原来R520这种架构的实力远不止16条像素渲染管线这么简单,ATI完全颠覆了传统“管线”的概念,R580核心 紧随其后,将像素渲染单元提升只48个之多,整整是R520的3倍!而顶点渲染单元和纹理单元以及GPU其它所有模块都没有做任何改动。 从R520到R580的这种改变当时令所有人都很费解,因为包括G70和R420在内的以往所有GPU都是管线式架构,就是像素渲染单元内部包含了纹理单 元,一般像素和纹理的比例是1:2或者1:1。而R520首次将像素单元和纹理单元拆分开来,成为独立的设计,所有的像素单元都可以互相共享所有纹理单元 资源,R520的像素和纹理比例依然是1:1,而R580的比例则瞬间提升至3:1,相信资历较老的玩家一定记得ATI当年大肆鼓吹“三比一架构”。 这样设计是因为ATI发现了游戏的发展趋势,像素渲染的比重越来越高,而纹理贴图的增长比较缓慢,相信大家还记得当年ATI的DX7显卡,其一条管线中包 括了3个纹理单元,以前是1:3后来是1:2接着变成1:1,现在被ATI一举提升至3:1。虽然当时很多人都不好理解,但从现在的发展来看,像素与纹理 的比例越拉越大,DX10时代大概是3:1,DX11时代则变成了5:1甚至更高! 除了具有前瞻性的3:1架构外,X1000架构还有另一大绝招就是HDR+AA技术。大家知道6800系列连续两年都是市面上唯一的DX9C显卡,当时所 有的DX9C游戏都是基于NVIDIA的架构而开发,当使用N卡开启HDR特效时(准确的说是FP32格式),会占据原本属于MSAA的缓冲区,导致 HDR和AA无法共存。HDR是DX9C的代表技术,能大大提升画面效果,而AA消除锯齿也能大幅改善画质,这两项关键特效无法同时开启让玩家们很郁闷。 ATI的DX9C产品比NV晚了一代,ATI意识到了DX9C的这一缺陷之后,在其架构设计之初就考虑到了HDR和AA共存的问题,因此特别设计了专用的 缓冲区,可以通过游戏或者驱动重新指定MSAA的缓存位置,从而同时开启HDR+AA。遗憾的是修改游戏或驱动兼容性并不好,支持的游戏也不多,虽然这确 实是一个很大的卖点,ATI锐意进取的精神也值得尊重,但最终效果还是不如人意。 另外,X1000也改进了像素着色单元的内部结构,每个像素单元都拥有两个算术逻辑单元和一个分支执行单元,其中ALU1只能执行加法(ADD)计 算,ALU2能执行包括加法、乘法(MUL)、乘加(MADD)各类运算,两个ALU最高可以执行两条指令(3D+1D)。为了控制如此庞大的像素单 元,ATI还针对SM3.0的特性改进了动态流控制功能,大大改进了SIMD架构的动态分支性能,让像素着色效能得到提升。 功夫不负有心人,全新架构并且拥有多达48像素单元的X1900XTX,性能比X1800XT获得了大幅提升,完胜对手的7900GTX,而且越新的游戏 优势越明显。强大的X1900XTX迫使NVIDIA推出双G71核心的7950GX2来对抗,虽然7950GX2单卡超越了X1950XTX,但双卡的 话则因效率问题依然是A卡占优。 小结:DX9C时代双方架构各有所长 DX9C是一代经典API,至今依然有很多游戏无视DX10/DX11,坚守DX9C平台,以至于HDR+AA的问题被遗留至今依然没能得到完美解决。NV40是因为发布较早没能解决这一难题,G70则是扩充像素和顶点的产物,也没能解决。 ATI在X800时代未能抢得先机,因此在X1000架构当中花了很多心思,争取做最完美的DX9C显卡,他们确实做到了这一点,无论架构和性能都有优势。但由于晶体管规模太大,功耗表现不如人意,因此在市场方面X1000与GF7相比并无优势。 DirectX 10特性:统一渲染和几何着色 以往的DirectX游戏无论多么优秀,始终都会有OpenGL引擎和游戏站出来发起挑战,而且其画面还相当不错。但DX9C之后,就只有ID Software还在负隅顽抗了,到了DX10时代,再也没有任何一款OpenGL能与DX游戏相抗衡,微软终于一统江湖! ●DirectX 10.0:统一渲染架构和几何着色 DX10又是一次大革命,除了将ShaderModel从3.0升级至4.0版本外,还有两项非常重要技术: 第一:引入统一渲染架构,从此不再区分像素与顶点着色单元,而是由流处理器单元按照负载动态的执行包括像素和顶点在内的各种着色指令: DX11引入统一渲染架构,不同的着色单元不会再出现空闲浪费资源的情况 第二,引入全新的几何着色单元,它第一次允许由GPU来动态的生成和销毁几何图元数据,使GPU可以在不用CPU干涉的条件下进行反复运算,许多以前无法实时使用的算法现在都可以在GPU中使用了。 此外,DX10还引入了两种新的HDR格式,避免了HDR和AA不兼容的情况出现,并提升了HDR效率;DX10还大大改进了纹理贴图的精度和效率;其它大大小小的改进有数十项之多,这里就不多做介绍了。 统一渲染架构的引入要求NVIDIA和ATI双方必须放弃以往的模式,重新设计全新的GPU架构,G80和R600之争拉开了帷幕…… DirectX 10架构:G80和R600斗了4年 首款DX10显卡——GeForce 8800 无论从哪个方面来看,GeForce 8800与DX9时代的Radeon 9700都非常相似,微软的新一代API尚未正式发布,而新显卡居然开卖了大半年,虽然没有新游戏的支持,但在老游戏下的性能依然非常完美。因此每一代成 功的显卡最关键的还不是API,还是核心架构。DX10是API的又一次革命,而G80则是GPU架构的一次伟大革命: 如果说R580像素与纹理3:1的比例让人很费解的话,那么G80的流处理器设计则让用户们一头雾水:从G71的24条像素管线一下变成了128个流处理器,哪来的这么多? 传统的GPU Shader架构 传统的Shader不管是像素还是顶点,其实都是SIMD(单指令多数据流)结构,就是个4D矢量处理器,可以一次性的改变像素的RGBA数据或者顶点的 XYZW数据。而G80的流处理器则是1D标量处理器,它一次只能计算像素和顶点4个数据中的1个,如此说来效率岂不是很低? 当然不是,因为随着游戏的发展,GPU所要处理的指令已经不是4D这种常规数据流了,进入DX10时代后Z缓冲区(1D)或纹理存取(2D)等非4D指令 所占比重越来越多,此时传统的Shader单元在执行此类指令时的效率会降至1/2甚至1/4,即便有Co-issue技术的支持效率改进也十分有限。 G80的SP 而G80 1D标量流处理器执行各种类型指令时的效率都能达到100%,这也就是NVIDIA对于GPU架构大换血的主要目的。G80的这种架构被称为MIMD(多 指令多数据流),其特色就是执行效率非常高,但也不是没有缺点,理论运算能力偏低、晶体管消耗较大,当然由于对手产品实力不行,这些缺点在很长一段时间内 都没有被发现。 而且NVIDIA的1D标量流处理器还可以异步工作在超高频率之下,一般是GPU核心频率的两倍,由此大幅提升了渲染能力。这一技术ATI至今都未能实现。 ATI的DX10图形架构——R600 与革命性的G80架构不同,R600身上有很多传统GPU的影子,其Stream Processing Units很像上代的Shader Units,它依然是传统的SIMD架构。 R600拥有4个SIMD阵列,每个SIMD阵列包括了16个Stream Processing Units,这样总共就是64个,但不能简单地认为它拥有64个流处理器,因为R600的每个Units内部包含了5个ALU: 我们来仔细看看R600的流处理器架构:Branch Execution Unit(分歧执行单元)就是指令发射和控制器,它获得指令包后将会安排至它管辖下5个ALU,进行流控制和条件运算。General Purpose Registers(通用寄存器)存储输入数据、临时数值和输出数据,并不存放指令。 由于内部的5个1D ALU共享同一个指令发射端口,因此宏观上R600应该算是SIMD(单指令多数据流)的5D矢量架构。但是R600内部的这5个ALU与传统GPU的 ALU有所不同,它们是各自独立能够处理任意组合的1D/2D/3D/4D/5D指令,完美支持Co-issue(矢量指令和标量指令并行执行),因此微 观上可以将其称为5D Superscalar超标量架构。 通过上图就可以清楚的看到,单指令多数据流的超标量架构可以执行任意组合形式的混合指令,在一个Stream Processing Units内部的5个ALU可以在单时钟周期内进行5次MAD(Multiply-Add,乘加)运算,其中比较“胖”的ALU除了MAD之外还能执行一 些函数(SIN、COS、LOG、EXP等)运算,在特殊条件下提高运算效率! 现在我们就知道R600确实拥有64x5=320个流处理器。R600的流处理器之所以能比G80多好几倍就是得益于SIMD架构,可以用较少的晶体管堆 积出庞大规模的流处理器。但是在指令执行效率方面,SIMD架构非常依赖于将离散指令重新打包组合的算法和效率,正所谓有得必有失。 总结:DX10架构G80笑到了最后 通过前面的分析我们可以初步得出这样的结论:G80的MIMD标量架构需要占用额外的晶体管数,在流处理器数量和理论运算能力方面比较吃亏,但却能保证超 高的执行效率;而R600的SIMD超标量架构可以用较少的晶体管数获得很多的流处理器数量和理论运算能力,但执行效率方面却不如人意。 G80的架构显然要比R600改进更为彻底,所以打从一开始G80/G92就遥遥领先与R600/RV670,其后续产品GT200一如既往的保持领先优势,但幅度没有G80那么大了,因为R600的架构的特性就是通过数量弥补效率的不足。 DirectX 11特性:曲面细分最关键 ●DirectX 11注重效率:关键特性曲面细分 DX9C和DX10听起来非常完美,但也有明显的缺点,就是系统资源开销很大,运算效率比较低,所以DX11的重点就落在了改进渲染效能方面。DX11除 了将ShaderModel从4.0升级至5.0外,还有两项最重要的改进就是Tessellation和DirectCompute,其中 DirectCompute的指令集主要来源于ShaderModel 5.0。 当然还有多线程渲染、增强的纹理压缩格式等其它若干改进,在我们之前的HD5800和GTX480评测中已经做过详细介绍了,因此就不再赘叙。 Tessellation被译为镶嵌,就是一种能让GPU在模型内部自动插入新的顶点,从而让几何图形变得无比复杂细腻的技术,它可以在很少的性能损失下 换取明显的画质提升。DX11游戏在画面上的改进主要来自于曲面细分技术,而且曲面细分还能带来很多意想不到的特效! 为了配合Tessellation技术,微软还专门设计了两种全新的Shader着色器,Hull和Domain,以便更精确的控制镶嵌位置,并置换位移贴图。这就与DX9/DX10时代的Tessellation有着本质区别,无法照抄照搬。 DirectCompute则是微软的GPU计算API,可以让GPU处理一些非图形类指令,获得远超CPU的性能。不过目前DirectCompute主要还是用在图形渲染后处理器方面,可以产生非常逼真的景深、透明效果。 DirectX 11架构:沿用DX10架构行吗? 首款DX11显卡——HD5800 在经历了DX10时代R600的失利之后,ATI对于微软新一代API十分重视,第一时间对于DX10.1提供了支持,可惜DX10.1相对于DX10改 进有限,并不像DX9C那样带来震撼的HDR技术,因此未能得到足够的重视。但ATI积极向上的精神让它在DX11时代抢得先机。 但令人奇怪的是,ATI并没有因为DX11而改变架构,而是几乎原封未动的照搬了上代RV770核心,除了显存位宽维持256bit不变之 外,Cypress的其它所有规格都正好是RV770的两倍,而且在流处理器部分可以看作是双核心的设计,几乎就是并排放置了两颗RV770核心。 在流处理器部分,RV870相对于RV770改进有限,只是加入了DX11新增的位操作类指令,并优化了Sum of Absolute Differences(SAD,误差绝对值求和)算法。基本上,除了新增DX11支持和扩充规模外,Cypress与RV770在架构方面没有本质区 别。 HD5000系列的主要优势就是功耗控制比较出色,另外功能方面Eyefinity多屏显示以及次世代音频源码输出都很有特色,架构方面确实没有多少亮点。 完全针对DX11而设计的显卡——GTX480 HD5800这一领先,又是半年,这次NVIDIA的阵脚并没有像NV30那样被打乱,而是按部就班的按照既定的设计目标推出全新架构的一代产品,而不是 像ATI那样在上代产品基础上改改就发布新品,因为DX11是全新的API,必须为DX11新的特性做相应的优化,才能获得最出色的DX11效能。 GF100核心是既G80和R600之后,近4年来GPU架构改进最大的一次,主要体现在以下四个方面: 1. GPU核心处理部分被划分为4个区块(GPC),每个区块内部囊括了所有主要的图形处理单元。它代表了顶点、几何、光栅、纹理以及像素处理资源的均衡集 合。除了ROP功能以外,GPC可以被看作是一个自给自足的GPU,所以说GF100就是一颗四核心的GPU。 2. 每个GPC都拥有一个独立的Raster Engine(光栅化引擎),负责边缘设置、光栅器消隐以及Z轴压缩功能。可大幅提升GPU在高分辨率下的性能。 3. 每组SM都拥有一个独立的PolyMorph Engine(多形体引擎),负责GPU的几何图形转换以及Tessellation曲面细分功能,彻底消除GPU的几何性能不足的瓶颈,从而大幅提升DX11性能。 4. GPU的一二级缓存都经过了重新设计,架构上更类似于Intel的多核CPU,改进流处理器和纹理单元的性能,进一步提升MIMD架构的效能。 和上代的GT200相比,GF100的所有模块几乎都经过了重新的设计,就连CUDA核心(流处理器)内部的ALU运算单元都针对新的浮点运算格式以及函 数做了改进与优化,而不仅仅是兼容SM5.0指令集而已。相反ATI的Cypress核心与上代的RV770相比几乎所有模块都未做任何改进。 经过我们此前的评测来看,GTX480/470在DX10游戏中领先HD5870/5850的幅度并不大,20-30%左右的优势都在意料之中。但在 DX11游戏和应用中性能优势十分显著,尤其是Tessellation性能遥遥领先于HD5870甚至双核心的HD5970。DX11特效使用的越 多,GTX480/470的优势就越明显。问题显然出在GPU架构方面,GF100是一颗完全针对DX11设计的、采用的全新架构的GPU,而 Cypress核心只不过是上代DX10架构外加SM5.0指令集而已,只能说支持DX11但具体的效能不容乐观。 小结:DX10架构无法满足DX11的需要 通过以上分析可以看出,由于HD5800的架构与HD4800完全相同,只是流处理器规模翻倍而已,因此它确实拥有出色的DX10/10.1性能,但 DX11的性能却很一般。因为DX11是一款全新的API,并不是针对DX10的小修小补,很多特性不是兼容SM5.0指令集就能做得到的。 ATI虽然通过抢先发布DX11显卡赚得了满堂彩,但却没能经得住时间的考验,未能重现DX9时代R300的辉煌。因为时代变了,当年的R300是全新的 架构,完美支持DX9,而NV30架构存在很多缺陷。而现在正好相反,Cypress完全是新瓶装旧酒,而GF100则是真正的DX11架构,这在所有 DX11测试中都得到了证实。 回顾历史:DX重大版本升级GPU必改架构 ●回顾GPU和DirectX发展史,有规律可循 回顾DirectX的发展史,就会发现虽然微软一直在左右着两大显示巨头的发展,但这只是外因而不是内因,真正决定胜败的关键还是在GPU体系架构方面,这才是双方设计实力的体现。 纵观NVIDIA和ATI近几年的交锋:DX7 NV占优,DX8前期ATI占优后期NV反超,DX9 ATI优势明显,DX9C前期NV大获全胜后期被反超,DX10 NV一路遥遥领先,DX11 ATI抢得先机但又被NV反超——似乎毫无规律可循,实则不然,且听笔者慢慢道来: DirectX重大版本更新,GPU必采用全新架构 从DX7、DX8、DX9、DX9C、DX10,每逢DirectX有重大版本更新时(主要是ShaderModel指令集),GPU架构都会做大幅度的 调整,甚至是抛弃老架构重新设计一套新的架构,NVIDIA和ATI双方无一例外!而且新的架构总是能够取得胜利,因为全新的架构完全针对新的API设 计,能够彻底发挥出新技术和特性的优势,确保发挥出预期的效果。 比如DX7 DX8时代,双方都是全新的架构,产品的性能其实相差不多,DX8的Radeon 8500甚至超越了GeForce 3,GeForce 4的优势是建立在ATI已经放弃DX8提前进入DX9时代的基础上;DX9时代全新架构的R300大获全胜,NV30的混合架构效率极差一败涂 地;DX9C时代NV40重返王座,其后续产品G70/G71因为没有更换架构,在ATI全新的R580面前失去了以往的辉煌;DX10时代G80 /G92革命性的架构一路遥遥领先,R600的架构脱胎于R580,表现不甚理想,曾一度遭到怀疑,但随着800SP RV770诞生后,其出色的表现证明了ATI当初的设计思路其实并没有错,但始终没有得到翻身的机会。 NVIDIA要让GT200添加DX11支持是很容易的,但并没有这么做 DirectX半代更新,GPU不会更改架构 而DirectX的半代更新,比如DX7.1、DX8.1、DX9.0b、DX10.1这些版本(DX9C不算,因为其ShaderModel从2.0升 至3.0),双方都不会更改GPU架构,只是在上代产品基础上小修小补,通过扩充指令集的方式兼容新API即可。尤其是DX10.1这个版本,由于改进太 少,双方竟然将G80/R600这一套架构用了5年之久,这在GPU发展史上是极为罕见的! 当然如果DirectX版本停滞不前的话,GPU架构更不会更换,比如DX9C时代的GF6和GF7,DX10时代的GF8/GF9/GT200和RV670/RV770。 展望未来:GF100才是真正的DX11架构 唯一的例外——首款DX11显卡HD5000 以上结论看起来很有意思,但是唯独DX11是个例外:ATI对RV770(还是R600架构)没有做任何更改就制造出了DX11显卡,这样的做法确实让人感到意外,但也不难理解,ATI信奉“先行者胜”的理念,认为只要抢先发布DX11显卡就能取得成功。 但在NVIDIA发布GF100之后,HD5000低下的DX11性能让人非常失望,HD5000的确是优秀的DX10/10.1显卡,但他不能算是一款合格的DX11显卡,最终HD5000也难逃宿命,胜利属于全新架构的NVIDIA GF100。 HD5000只是过渡产品,ATI真DX11显卡尚未露面 或许我们现在下结论还为时过早,但ATI的做法已经证明了DX11确实需要一套全新的GPU架构,HD5000只不过是临时性架构,ATI下一代的 DX11核心“南方群岛”和“北方群岛”都在紧锣密鼓的开发当中,据称“北方群岛”将会是一套彻底改头换面的架构,而“南方群岛”将采用混合式的架构,仅 在外围模块使用新的技术,内核部分依然保持不变。 想要在DX11性能方面取得突破,就必须将现有的架构推倒重新来过,NV30的混合型架构一败涂地就是很好的例子。HD5000确实拥有不俗的DX10性 能,但现在越来越多的用户需要真正的DX11显卡,因为DX11是大势所趋,其普及速度之快超越了以往任何一代API。 目光放长远一点,真DX11架构的显卡更值得期待 目前来看,真正为DX11设计的GPU只有GF100这一颗,GTX480/470定位较高难入平常百姓家。不过其后续产品也非常值得期待,我们知道 GF100强悍的动力源自于内部的光栅化引擎和多形体引擎,即便将GF100的规格削减为1/2甚至1/4,它依然拥有不俗的几何性能和 Tessellation性能,而且功耗将会控制的更好,非常值得中端主流用户期待。■ 本文转自zdd博客园博客,原文链接:http://www.cnblogs.com/graphics/archive/2012/07/19/2599180.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android Design Support Library全解:Part 2 Snackbar

Android Design Support Library系列第2弹: Snackbar “Providing lightweight, quick feedback about an operation is a perfect opportunity to use a snackbar.” image.png SnackBar是Design Support Library中很实用的控件,它可以在屏幕的底部展示快速消息,功能类似于Toast,但更加灵活和强大: SnackBar会在交互或者超时之后自动消失; SnackBar可以包含一个Action动作,来触发事件; SnackBar所展示的信息是UI的界面的一部分,它将出现于所有页面元素的之下,而Toast的是覆盖UI界面; 统一时间内,只会显示一条SnackBar。 因为SnackBar和Toast的功能相近,所以SnackBar继承了很多Toast的属性和方法,比如标识显示时间长短的LENGTH_LONG and LENGTH_SHORT。 使用方法 SnackBar的使用方法大致如下: Snackbar.make(view, message, duration) .setAction(action message, click listener) .show(); 其中: make() – 创建SnackBar来显示信息; setAction() – 设置Action事件; show() – 显示SnackBar; 需要说明的参数: make方法的第一个参数view,代表着SnackBar所要依附的父视图(parent view); make方法的最后一个参数duration,代表着SnackBar出现的时间,超过该时间之后便会消失。 下面我们看一个实例: Snackbar.make(rootlayout, "Hello SnackBar!", Snackbar.LENGTH_SHORT) .setAction("Undo", new View.OnClickListener() { @Override public void onClick(View v) { // 点击事件 } }) .show(); 其中,rootlayout为上一节中,包含FAB的framelayout,点击悬浮按钮就会弹出Snackbar。 Snackbar-framelayout 虽然Snackbar出现了,但是和我们预期的还是有差距,我们希望Snarkbar出现在最下方时,FAB等控件可以随之上移,比如下面的效果: Snackbar-with-CoordinatorLayout 这就需要配合CoordinatorLayout 控件来使用,我们会在后续的篇章里介绍。 自定义Snackbar样式 虽然可以通过setActionTextColor方法来设置Action字体样式,但是在实际的使用中,往往需要让Snackbar显示出不同的样式(字体和颜色)来体现出不同的意义。 如何为Snackbar添加背景颜色 你可以通过getView() 方法获取Snackbar所在的View,然后就可以在对它采用任意的背景颜色:snackbar.getView().setBackgroundColor(colorId); 下面是ColoredSnackbar类,它利用装饰器模式封装了一些方法,可以根据用户指定的类型显示不同背景颜色。 //彩色 public class ColoredSnackbar { //红色 private static final int red = 0xfff44336; //绿色 private static final int green = 0xff4caf50; //蓝色 private static final int blue = 0xff2195f3; //橙色 private static final int orange = 0xffffc107; //获得当前SnackBar所在的View private static View getSnackBarLayout(Snackbar snackbar) { if (snackbar != null) { return snackbar.getView(); } return null; } //装饰器 private static Snackbar colorSnackBar(Snackbar snackbar, int colorId) { View snackBarView = getSnackBarLayout(snackbar); if (snackBarView != null) { snackBarView.setBackgroundColor(colorId); } return snackbar; } //使用蓝色表示一般信息 public static Snackbar info(Snackbar snackbar) { return colorSnackBar(snackbar, blue); } //使用橙色表示提醒信息 public static Snackbar warning(Snackbar snackbar) { return colorSnackBar(snackbar, orange); } //使用红色表示警告信息 public static Snackbar alert(Snackbar snackbar) { return colorSnackBar(snackbar, red); } //使用绿色表示确认信息 public static Snackbar confirm(Snackbar snackbar) { return colorSnackBar(snackbar, green); } } 其使用方式很简单,先构建正常的SnackBar,然后调用ColoredSnackBar进行装饰: Snackbar snackbar = Snackbar.make(getView(), R.string.hello_snackbar, Snackbar.LENGTH_SHORT); ColoredSnackBar.alert(snackbar).show(); 效果如下: ColoredSnackBar 更多关于Design Support Library中控件的讲解将会在持续更新,欢迎关注。

优秀的个人博客,低调大师

首尔2017年公共区域全覆盖免费WiFi

韩国首都首尔市政府近日透露,到2017年,全市所有的公共区域都将提供免费的WiFi服务。这也是首尔市进一步增强其数字平台的举措之一。 首尔市政府表示,免费WiFi服务还将覆盖地铁和公交车,并表示,将同韩国中央政府一道确保所提供的网络质量。 首尔市市长朴元淳(Park Won-soon)表示,市政府将在未来5年内投资4605亿韩元(约合24.87亿元人民币)用于促进数字经济领域增长。 按照《首尔数字总规划2020》,首尔还将扩大物联网的应用。首尔计划建立一个综合停车系统,让车主可以利用智能手机检查车辆停放的位置。到2020年,将覆盖550个公共和私人停车位。 朴元淳表示:“到2020年,首尔市约有50%的公共数字事业会由民间部门主导,涉及企划、实行、运营到评价的全过程。我们将努力解决各种问题,在2020年将首尔打造成世界领先的数字首都。” 根据规划,首尔将借助数字手段,加强与市民的沟通,同时加强监管。到2020年,该市将开发扶持30个智能产业相关企业发展。首尔还会建设综合生活福利信息系统,对市民提供更智能的数字化服务。而在2016年,首尔上岩将构建云计算中心,到2020年,首尔市数据中心可实现100%云计算。 本文转自d1net(转载)

优秀的个人博客,低调大师

【干货】全自主研发Docker容器调度引擎——Newbon

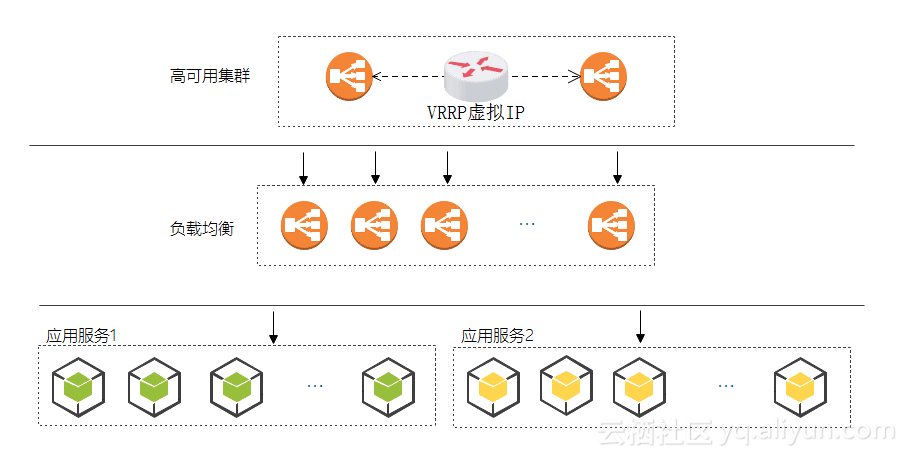
背景: 大家所熟知的Docker容器调度引擎包括,K8S, Swarm, Mesos和Rancher,这些调度引擎都是开源的国外引擎,各有各的特点。在同客户和圈内人士沟通中,很多人直言国内容器创业公司大多只是将各种开源组件集成在一起,同质化严重,没有核心竞争力。作为国内第一批的容器创业公司——Ghostcloud精灵云,深知国内需要在容器的诸多领域拥有真正完全可控,同时具有核心竞争力的产品。因此,容器云平台最核心的调度引擎迫切需要一个完全可控,自主的产品,在这种背景下Newbon应运而生。Newbon取自“牛犇”的谐音,意在构建一个稳定的,牢固的容器调度引擎。接下来就简单介绍一下Newbon的实现细节,并通过一系列视频进行功能展示。 组成: Newbon包含几个核心部分: l Api-Server : 为UI和第三方集成提供调用接口。 l Scheduler : 负责解释定义,收集数据和执行调度。 l DNS/ETCD : 负责服务注册,服务发现,订阅和容器主机访问。 l Executer :负责执行Server端下发命令。 l Monitor : 负责监控主机和容器的各种状态。 l Heapster : 负责健康检查。 l Calico+ : 经过二次开发的基于Calico的网络插件。 l Nginx : 七层负载均衡器。 l HAProxy : 四层/七层负载均衡器。 l Keepalive : 高可用组件。 典型逻辑结构: 下面是典型的逻辑结构图: 最上层是高可用集群,中间接负载均衡器,底层接多个应用服务,从这幅图就能看出,Newbon从设计之初就支持高可用,负载均衡和弹性伸缩,以及多服务挂载。 接下来我们重点介绍下Newbon中负责解释定义,收集数据和执行调度的核心组件Scheduler。 Scheduler功能包括: l 解释服务定义 l 选择合适的节点创建容器 l 监控节点和容器运行状态 l 服务注册和注销 l 自动扩容和缩容 l 灰度升级(Rolling Upgrade) 解释服务定义: 结合解释服务定义,下面是一个服务示例: 应用支持的扩展配置: 健康检查配置支持(TCP): 健康检查配置支持(Http): 服务配置: 调度配置: 高可用集群: 服务发现,服务注册和注销: 在容器调度引擎中,这三个过程可以说是最核心的地方。Newbon借鉴了多个调度引擎的优点,使用了ETCD和DNS并结合控制服务器来实现以下功能: · 创建服务后自动创建DNS记录用于访问相关容器: § A记录,通过域名访问单个容器和一组容器。 § SRV记录,记录容器提供的服务协议、端口、优先级和提供服务的IP列表。 · 容器状态健康后注册SRV信息: · 当容器停止或处于不健康状态时,会注销DNS A记录和SRV信息。 下面就是一个DNS纪录示例: 自动扩容和缩容: 这一部分主要通过以下方式实现: Agent monitor 模块实时监测容器cpu和内存使用情况: 定义性能指标阈值和容器运行上限和下限。 扩容: 当容器平均性能指标超过阈值一段时间(1分钟)后启动自动扩容,创建更多容器以达到 阀值要求的90%。 当没有主机资源运行新容器时,自动申请新主机(限公有云环境)。 缩容: 当一段时间(3分钟)负载持续低于阈值80%启动缩容。 优先删除新创建容器和主机,以释放资源和降低运营成本。 下面是一个扩容的示意图: 功能展示: 接下来我们将通过视频的方式给大家展示Newbon所支持的一系列功能,本期重点展示Newbon的自动扩展功能: https://v.qq.com/x/page/i03670gm0fh.html Q&A: Q: 既然已经有K8S, Swarm, Mesos, Rancher等调度引擎,为什么精灵云还要自主研发调度引擎Newbon呢? A: 调度引擎是容器云平台最核心的部分,开源固然可以快速上手,快速搭建系统,但是任何一个开源系统实际是由一个或多个公司主导的,因此在使用中经常会受制于国外。开源系统由于需求和贡献者多,因此会导致系统异常庞大,企业往往只需要使用20%功能,但是却要去维护80%的其他系统。因此,精灵云从一开始就选择自主研发调度框架,做到完全自主可控,为企业级用户提供更好的服务。 Q: Newbon 跟其他容器调度相比有何优势? A: Newbon吸取各调度引擎的长处,可以说是目前国内定制能力最强,支持功能丰富的调度框架,包括在网络、应用迁移、应用快照、模板、负载均衡、弹性伸缩、高可用、CI/CD集成、灰度发布和回滚、镜像集成、日志监控等方面都有着非常大的优势。 Q: Newbon稳定吗?有多少用户在使用? A: Newbon虽然是最近才对外公布,但实际是精灵云核心研发团队多年的积累。团队在内核和分布式领域有丰富的经验,主要来自于Veritas, EMC,微软和IBM,平均拥有10年以上分布式系统研发经验,曾负责华为存储软件的OEM工作。Veritas可以说是分布式领域的兵工厂,它的Veritas Cluster Server是最早的分布式中间件,K8S容器负责人Dawn Chen也曾就职于Veritas。因此,Newbon是集众家之所长,并且在精灵云的公有云上得到了充分的验证,支撑数万用户和数十万的容器调度。Newbon从EcOS 2.0开始内置,目前已经在多家中大型企业得到运用。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册