首页 文章 精选 留言 我的

精选列表

搜索[AI创作],共10000篇文章
优秀的个人博客,低调大师

端侧大模型部署踩坑实录:Qwen + OpenVINO 在 AI PC 上跑通本地推理

## 一、为什么要费劲把模型搬到本地 半年前我开始琢磨一件事:手上的推理需求里,有相当一部分根本不需要联网。合同条款比对、内部纪要整理、批量日志初筛——这些活儿有两个共同点:**素材敏感**,且**重复率高**。 放在云端 API 上跑,三个问题绕不过去: **一是数据边界。** 内部文档一旦送出去,回不回来、留多久、被谁看过,就不是我能控制的了。合规上过不去。 **二是离线场景。** 出差路上、工地现场、内网隔离环境,网络时有时无,云 API 直接失效。 **三是成本曲线。** 高频、结构化的短请求,单次单价再低,乘以量之后也不好受。对我这种每天要跑几百次小任务的人来说,账算得过来才怪。 于是我决定试端侧。硬件条件不算顶配——一台带 Intel Core Ultra 的笔记本,32GB 内存,有 NPU。目标很朴素:**能在本地跑一个 7B 级别的中文模型,回答质量够用,交互不卡。** 前后折腾了两周,踩的坑比想象中多。下面按实际过程写,包括那些官方文档里没明说、但一定会撞上的地方。 --- ## 二、我为什么选 Qwen + OpenVINO 这条链路? 选型上有两条路:一是 llama.cpp 系的 GGUF,二是 Intel 的 OpenVINO 栈。我最终走了后者,理由有三个: **第一,能吃满硬件。** OpenVINO 对 Intel CPU / 核显 / NPU 的支持是原生的,能按设备调度。llama.cpp 在纯 CPU 上表现很好,但我这台机器的 NPU 就浪费了。 **第二,模型导出有官方路径。** HuggingFace 的 `optimum-intel` 提供了官方 CLI 工具,一行命令把 Hub 上的模型转成 OpenVINO IR 格式并顺带量化,不需要自己写转换脚本。对我这种不想深挖编译细节的人,这点很关键。 **第三,模型选 Qwen2.5-Instruct 系列。** 中文理解在线,尺寸档位齐全(1.5B / 3B / 7B 都有),而且是 OpenVINO 官方维护的预转换模型清单里的常客——意味着我可以直接用别人压好的 INT4 版本,跳过本地转换。 链路是这样的: ``` HuggingFace Hub(Qwen2.5-Instruct) │ optimum-cli export openvino ▼ OpenVINO IR(.xml + .bin,INT4 压缩权重) │ openvino_genai.LLMPipeline ▼ CPU / GPU / NPU 上的本地推理 ``` --- ## 三、关键步骤:五步跑通 ### 3.1 环境准备(版本要钉死) 端侧部署最忌讳版本漂移,我这套是能跑通的组合: ``` python -m venv ov-env source ov-env/bin/activate # Windows 用 ov-env\Scripts\activate # 官方推荐配套版本(见参考资料 [1]) pip install --upgrade optimum-intel openvino openvino-genai openvino-tokenizers nncf ``` > 📌 我踩的第一个坑就在这`:optimum-inte`l 2.0 起移除了 INC 和 IPEX 后端,ONNX 依赖也一并去掉,OpenVINO 和 NNCF 改成默认安装。如果你照着一年前的教程去装` optimum[openvino`] 这种老式 extras,会装出一堆冗余包,甚至版本冲突卡在编译环节**。新教程只认一条命令**。 ### 3.2 导出并量化模型 不想自己转的话,HuggingFace 上有官方压好的 INT4 版本(如 `OpenVINO/Qwen2.5-1.5B-Instruct-int4-ov`)可直接下载。想自己控参数,就用 CLI: ``` # 一行完成「导出 OpenVINO IR + INT4 权重量化」 optimum-cli export openvino \ --model Qwen/Qwen2.5-7B-Instruct \ --weight-format int4 \ --group-size 128 \ --ratio 1.0 \ ov_qwen2.5_7b_int4/ ``` 三个参数的含义值得说清楚,这是最容易调错的地方: |参数|作用|我的取值理由| | --- | --- | --- | |--weight-format|权重量化精度|int4 体积最小,7B 模型压到约 4GB 量级;精度敏感就退 int8| |--group-size|量化分组粒度|128 是官方建议用于较小模型(约 ≤4B–5B)的常用值,在体积/精度/速度间较均衡;更大模型通常 channel-wise 量化表现更好| |--ratio|int4 与 int8 权重的比例|1.0 表示全部权重以 int4 表示;掉精度明显时降到 0.6~0.8,即约 60% 权重用 int4、40% 留 int8| ### 3.3 推理代码(官方 API,二十行以内) ``` import openvino_genai as ov_genai model_path = "ov_qwen2.5_7b_int4/" pipe = ov_genai.LLMPipeline(model_path, "CPU") # 换 "GPU" / "NPU" 即可切换设备 # 多轮对话用 ChatHistory,它会自动套用模型的 chat template chat = ov_genai.ChatHistory([{"role": "system", "content": "你是一个严谨的中文助理。"}]) chat.append({"role": "user", "content": "把下面这段会议纪要压缩成三条待办。"}) cfg = ov_genai.GenerationConfig() cfg.max_new_tokens = 256 cfg.do_sample = False # 关掉采样,同样的输入结果稳定,便于对比 print(pipe.generate(chat, generation_config=cfg)) ``` ### 3.4 选设备:不是越强越好 `LLMPipeline` 第二个参数就是设备名,切换成本几乎为零。但要清楚三者的脾气: - **CPU**:最稳,兼容性最好,7B INT4 在移动端芯片上能跑但首 token 会等一会儿。 - **GPU(核显/独显)**:交互体验最好,流式输出顺畅。 - **NPU**:省电、常驻场景合适,但**限制最多**(详见第四节踩坑 1)。 ### 3.5 用官方工具测数据,别靠感觉 OpenVINO 自带 `benchmark_app`,测延迟和吞吐不用自己写循环: ``` pip install openvino-dev benchmark_app -m ov_qwen2.5_7b_int4/openvino_model.xml -d CPU -api async -t 30 ``` 把 `-d` 换成 `GPU`、`NPU` 再跑一遍,同一模型在三类设备上的差异一目了然。我强烈建议先跑基准再定设备,能省掉大量"感觉慢"的猜测。 --- 实施效果:我的实测环境与数据 实测环境:Windows 11 / Intel Core Ultra(含 NPU)/ 32GB LPDDR5 / OpenVINO 2026.4 + openvino-genai 2026.4 测试方法:benchmark_app 固定 30 秒异步推理 + 同一组中文 prompt 人工体感评分 直觉感受:7B INT4 压完之后,做摘要、改写、结构化提取这类任务基本不掉链子;但涉及多步推理、长链逻辑的活儿,能明显感到比 FP16 版本"钝"一些。INT4 是拿精度换体积和速度的交易,不是免费午餐。 ## 四、经验总结 **1:NPU 对量化格式很挑,不是所有 INT4 都能上。**这是我最没想到的一条。NPU 插件对量化格式有硬性偏好——FP16-NF4 精度的 NPU 支持是随新一代 Core Ultra 200V(Series 2)引入的,面向 8B 以内的模型;而**较早一代 Core Ultra 只支持对称量化的 channel-wise 或 group-wise INT4-FP16,NF4 不被支持**(见参考资料 [5])。结果就是:同一份 INT4 模型在 CPU 上跑得好好的,丢给 NPU 直接加载失败。**先查目标硬件的量化兼容矩阵,再定压缩方案**,顺序反了就是白干。 **2:NPU 的上下文是有天花板的。**NPU 插件对长上下文有明确限制(官方 2026.4 版本说明里提到 NPU 插件已支持到 8K tokens 量级)。我一开始拿一份两万字的合同去试,直接报错。后来改成**先切分、再做多轮小结**的路子才跑通。**端侧不等于能塞任意长文本**,这一点和云端 API 的体验差别很大。 **3:`group_size` 调小不一定是好事。**我一度以为 group_size 越小越精细、精度越高。实测下来,调小确实提升了量化精度,但**模型文件变大、推理也变慢**。128 这个量级对较小模型(约 ≤4B–5B)是甜点,更大模型通常 channel-wise 量化表现更好;除非精度实在不够,否则没必要一味往下压。 **4:设备名一改,首次加载会重新编译。**OpenVINO 会按设备做图编译并缓存。我第一次从 CPU 切到 GPU,等了很久以为卡死了,其实是在编译。**如果换了设备或改了模型,首次启动慢是正常的**,别急着 Ctrl+C 反复重试。 **坑 5:动态形状带来的性能抖动容易被误判。**提示词长度变化会导致部分算子重编译,表现为"有时候很快、有时候很慢"。我一开始以为是散热降频,其实是形状问题。**测性能要用固定长度的输入做对比**,否则数据没有可比性。 **坑 6:省下的不只是钱,还有等待和顾虑。**这条是正向收益。原来等云端返回、担心内容出域的隐性成本,换到本地之后基本消失了。**但如果你的请求量本来就低、且对数据不敏感,硬上端侧并不划算**——维护环境、调参、追版本,都是真金白银的时间。 ## 五、疑问解答 **Q1:这套方案需要独立显卡吗?**不需要。纯 CPU 可以跑,只是速度差一截;有 Intel 核显或独显体验更好;NPU 适合常驻省电场景,但要先确认量化格式兼容。 **Q2:7B 和 1.5B 怎么选?**看任务复杂度。纯做分类、抽取、短摘要,1.5B 够用而且响应快;要做归纳、改写、跨段落推理,7B 是底线。**我的建议是先拿 1.5B 把链路跑通,再按质量短板往上换。** **Q3:和直接用云端 API 比,到底哪个划算?**没有普适答案,取决于三个变量:请求量、数据敏感度、有没有离线需求。量小且不敏感的,云端省事;量大、敏感、要离线的,端侧才是解法。**建议先做两周的请求日志统计,用真实频次算账,再决定。** **Q4:模型更新了怎么办?**重新导出一次即可,流程完全一样,只是把 `--model` 换成新版本号。建议把导出命令写成脚本存进仓库,别靠记忆。 ## 参考资料 1. Optimum-Intel v2.2.0 & OpenVINO GenAI 2026.4.0 发布说明 — HuggingFace 官方博客,2026-09-18 1. Optimum Intel 2.0:OpenVINO-First 工具链 — HuggingFace 官方博客 1. `optimum-cli export openvino` 官方用法与量化参数说明 — HuggingFace 模型卡(`OpenVINO/Qwen2.5-Coder-3B-Instruct-int4-ov`) 1. OpenVINO GenAI `LLMPipeline` 推理示例 — HuggingFace 模型卡与 openvino-genai 官方文档 1. Intel Distribution of OpenVINO Toolkit 版本说明(NPU 量化精度兼容性、上下文长度限制)— Intel 开发者官网

优秀的个人博客,低调大师

AI 预测可视化平台 | 从前端到模型反馈闭环:标注数据回传后端设计

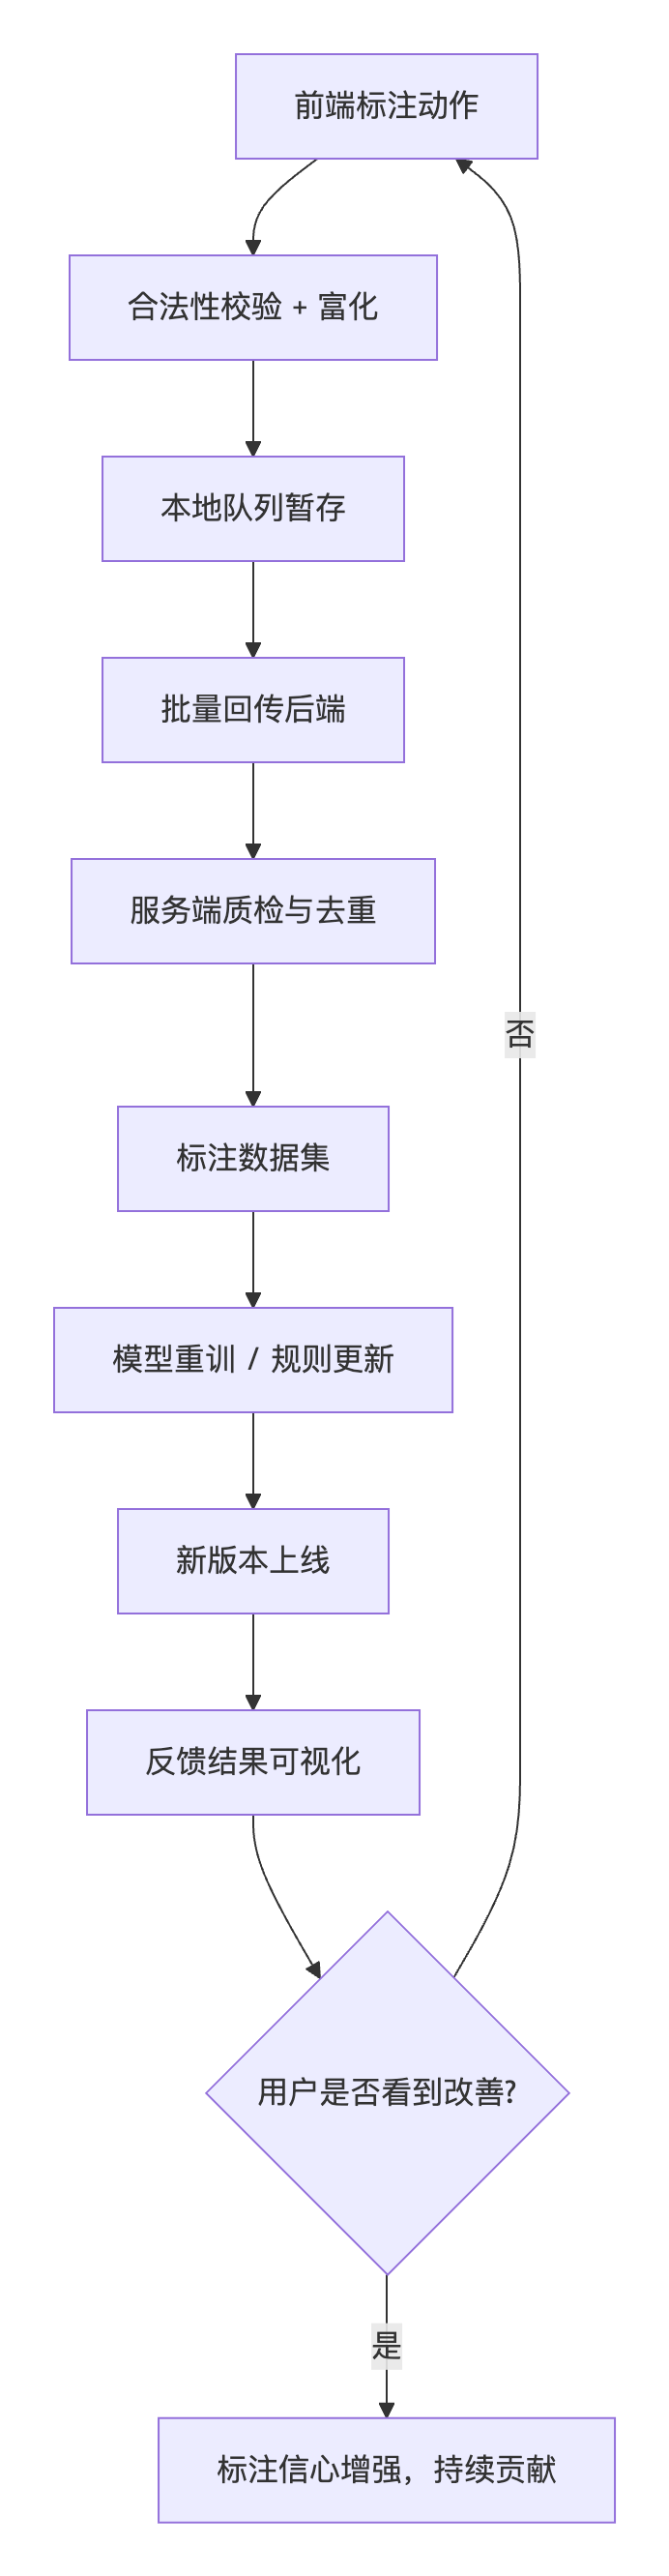
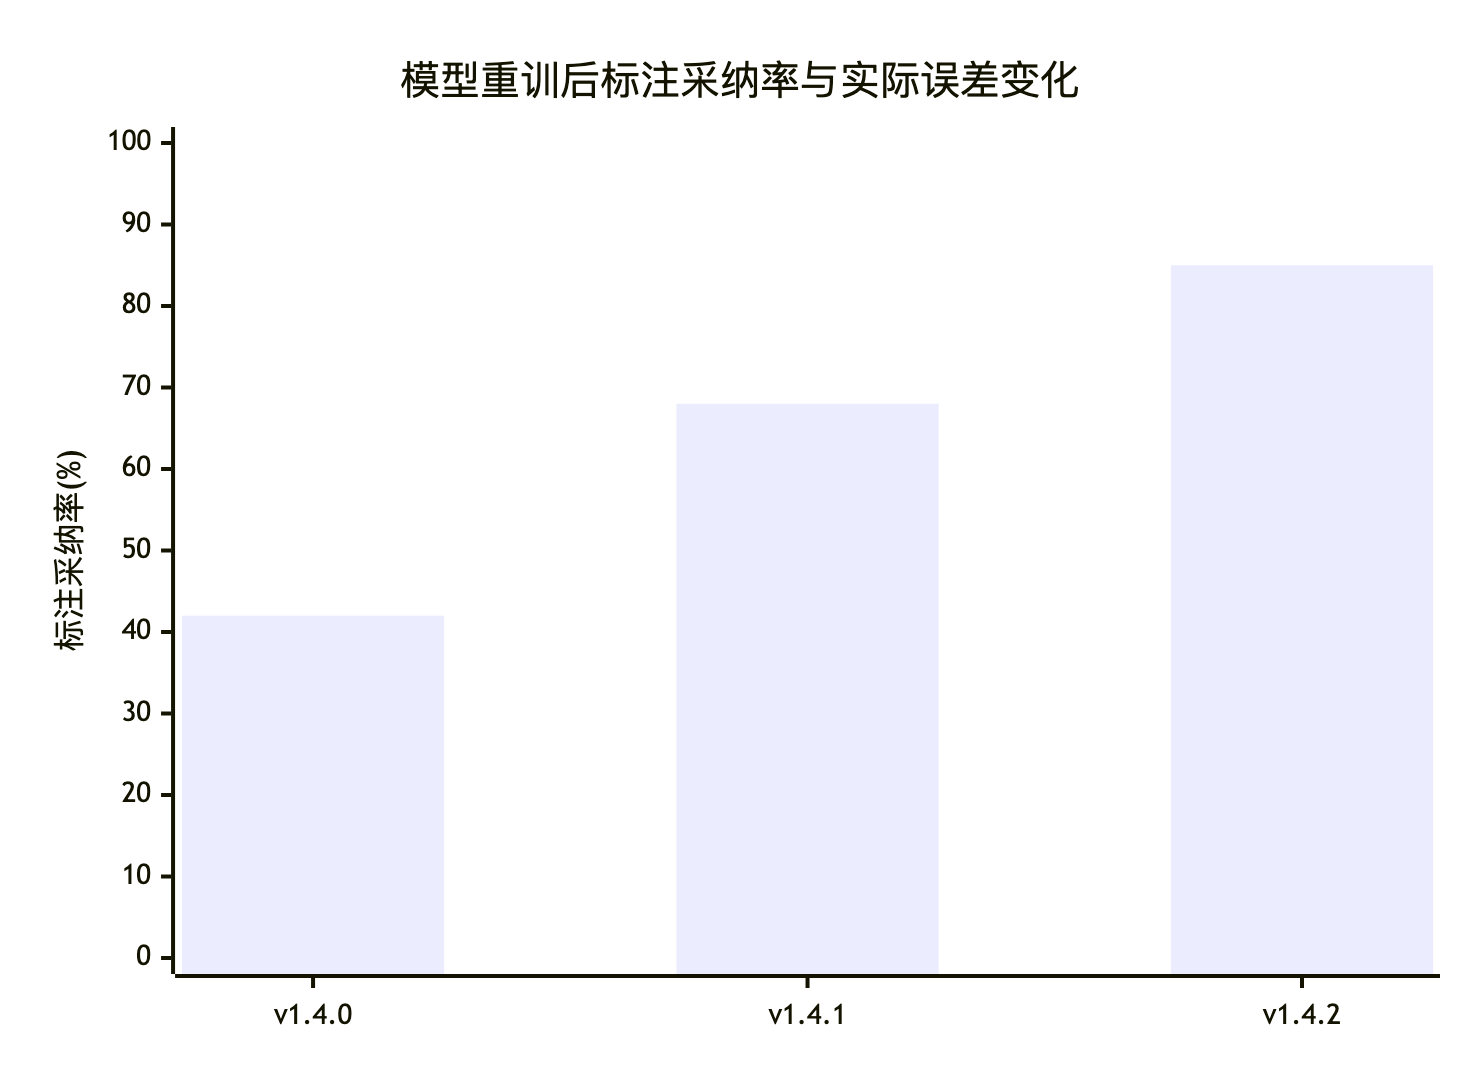
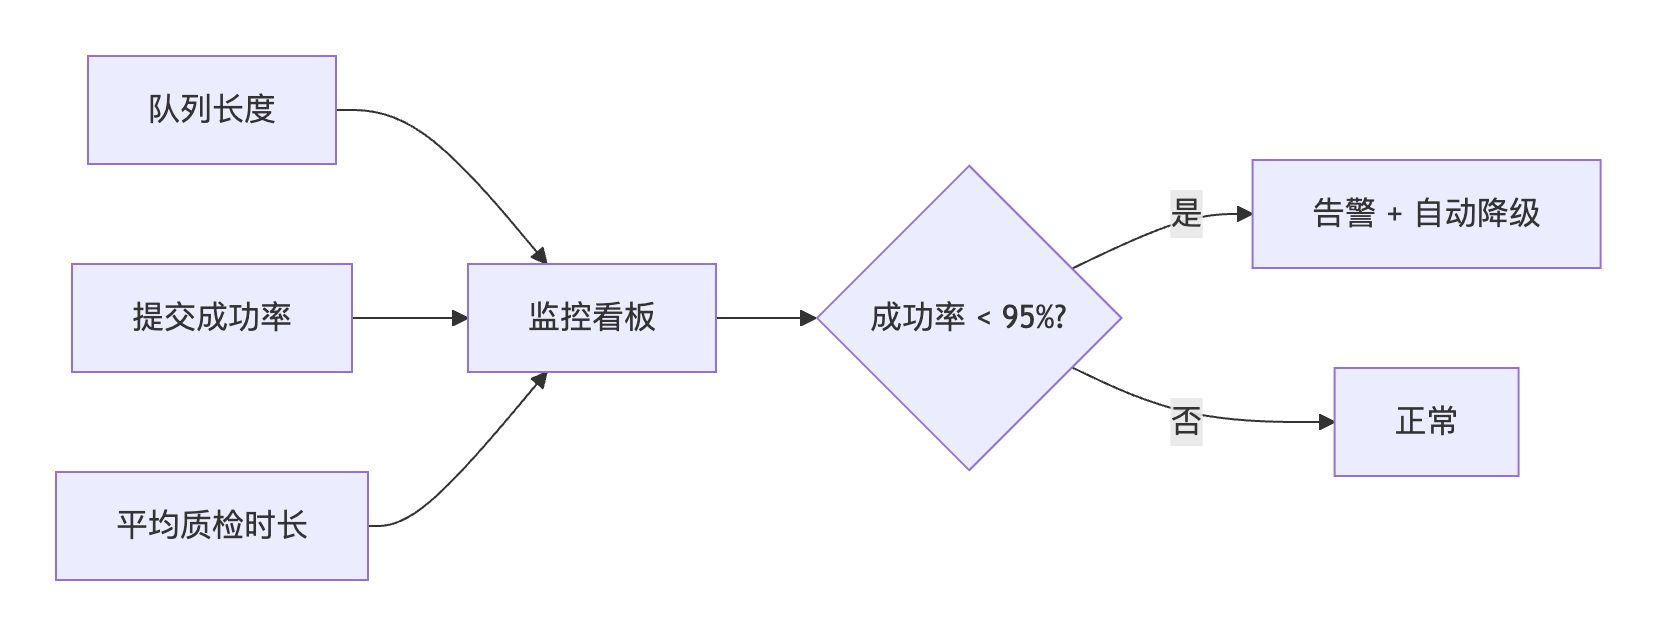
# 引言 我们建立了异常标记、偏差归因、SHAP 解释、场景模拟、报告批注——所有这些交互都产生了一类被传统 BI 完全浪费掉的数据:**人在这个界面上做了什么判断**。计划员确认了一个异常、驳回了一个误报、在图上批注"双十一实际超预期",这些动作本身就是高质量的训练样本。 模型反馈闭环要做的,就是把散落的标注收拢成一条**可信、可追溯、可直接进训练集**的数据管道。前端在这个闭环里的职责不是"把数据发出去"这么简单,而是**保证标注的合法性、减少回传量、处理离线场景、并把模型改进后的结果重新呈现给用户**。本文将拆解数据模型、状态机、批量提交、幂等与重试、前后端契约、冲突处理,以及闭环的最终验证机制。 --- # 一、先厘清:反馈闭环到底闭环在哪 很多团队理解的"反馈"只是把标注存进数据库,然后就没了。这不是闭环,这是垃圾场。 ![](https://developer.qcloudimg.com/http-save/audit-10133498/e223820bc7c9b527888db422c05d1d03.png) **解析**:真正的闭环有七个环节,且**必须回到用户眼前**。用户提交了标注却看不到任何变化,第二次就不会再提交——**闭环的最后一环是"让用户看见模型因为他而变好了"**,这是标注系统可持续运转的唯一动力。 --- # 二、数据模型:标注不是一条备注,是一条样本 标注要能进训练集,就必须携带足够的上下文。缺了任何一个字段,这条数据就只能是审计日志,成不了样本。 ```javascript { "feedbackId": "fb_88201", "sku": "SKU-1002331", "targetDate": "2026-11-11", "modelVersion": "prophet-v1.4.2", "modelOutput": { "yhat": 1370, "yhatLower": 1180, "yhatUpper": 1470, "actual": 1520 }, "label": { "verdict": "confirmed", "rootCause": "promo_underestimated", "severity": 3, "comment": "渠道促销未纳入特征,实际超预期", "tags": ["promotion", "holiday"] }, "context": { "price": 89, "promoIntensity": 0.9, "inventory": 3200, "isHoliday": true }, "author": "u_1024", "role": "demand_planner", "createdAt": "2026-09-25T10:31:00+08:00", "status": "submitted", "quality": { "hasActual": true, "contextComplete": true, "authorReliable": true } } ``` **解析**:`modelOutput` 把提交时刻的模型输出冻结下来——**这是关键,因为模型会重训,当时的预测值会变**。`context` 把当时的特征快照一起存下,让这条数据可以直接作为监督样本。`quality` 三个布尔值是质检的自动判定,决定它能否进入训练集。`author` 和 `role` 记录来源,后续可做标注者可靠性加权。 `rootCause` 必须取自受控枚举,不能让用户自由输入: ```javascript const ROOT_CAUSES = { promo_underestimated: '促销强度低估', price_effect_missed: '价格效应未捕捉', holiday_shift: '节假日效应偏移', supply_shortage: '供应不足导致销量被压低', data_quality: '源数据质量问题', model_baseline_drift: '基线漂移', known_event: '已知事件,非模型问题', } export function validateLabel(label) { const errors = [] if (!ROOT_CAUSES[label.rootCause]) { errors.push('根因必须从标准分类中选择') } if (!label.comment?.trim()) { errors.push('说明不能为空,需描述判断依据') } if (label.severity 3) { errors.push('严重度取值必须为 1~3') } return errors } ``` **解析**:枚举化的根因是训练数据可用性的前提。**自由文本进不了结构化训练集,只能靠 NLP 清洗,成本极高且噪声大**。说明必填则保证每条标注都有判断依据,可供复核。这套校验要在**前端提交前和后端入库前各跑一遍**,双保险。 --- # 三、状态机:一条标注的完整生命周期 标注不是提交即完成,它要经过质检、采纳、训练多个状态。状态机必须显式建模。 ![](https://developer.qcloudimg.com/http-save/audit-10133498/e9d1c1d42aecd835e019d25551a414ae.png) **解析**:`drafting` 和 `pending` 的区别在于是否进入发送队列。`failed` 不丢数据,而是留在本地队列等待重试。`rejected`** 必须可退回修改**,否则标注者遇到一次拒绝就不再提交。`training` 状态就是"已闭环"的标志,前端据此给用户正向反馈。 ```javascript const TRANSITIONS = { drafting: ['pending'], pending: ['submitted', 'failed'], failed: ['pending'], submitted: ['validating'], validating:['accepted', 'rejected'], rejected: ['drafting'], accepted: ['training', 'archived'], training: ['*'], // 终态 archived: ['*'], } export function canTransition(from, to) { const allowed = TRANSITIONS[from] || [] return allowed.includes(to) || allowed.includes('*') } ``` **解析**:`TRANSITIONS` 表驱动所有状态变更,**禁止任何代码绕过这张表直接改状态**。终态 `training` 和 `archived` 用 `'*'` 表示不再允许变更,是防止重复训练的锁。 --- # 四、本地队列:离线也要能标注 供应链场景里,计划员常在仓库、门店等弱网环境工作。标注动作必须能离线发生。 ```javascript const QUEUE_KEY = 'feedback-queue' class FeedbackQueue { constructor() { this.items = this._load() } _load() { try { return JSON.parse(localStorage.getItem(QUEUE_KEY) || '[]') } catch { return [] } } _persist() { localStorage.setItem(QUEUE_KEY, JSON.stringify(this.items)) } enqueue(item) { const normalized = { ...item, feedbackId: item.feedbackId || `fb_${Date.now()}_${Math.random().toString(36).slice(2, 8)}`, status: 'pending', attempts: 0, createdAt: new Date().toISOString(), } this.items.push(normalized) this._persist() return normalized } async flush(sender) { const pending = this.items.filter(i => i.status === 'pending') for (const item of pending) { try { item.attempts += 1 await sender(item) item.status = 'submitted' } catch (err) { item.status = item.attempts >= 5 ? 'failed' : 'pending' item.lastError = err.message if (item.status === 'failed') break // 停止重试,等待人工或下次重连 } } this._persist() return this.items.filter(i => i.status === 'submitted').length } } ``` **解析**:队列持久化到 localStorage,**刷新和断网都不丢**。`feedbackId` 在客户端生成并用时间戳+随机串,保证离线时也能唯一标识。`attempts` 计数配合最多 5 次重试,**连续失败就停止而非无限重试耗尽电池和网络**。每轮 flush 后统一持久化,保证任意时刻中断都可恢复。 --- # 五、批量提交与幂等 逐条发请求会让 50 条标注产生 50 次 HTTP 往返。批量提交 + 幂等键是这里的标配。 ![](https://developer.qcloudimg.com/http-save/audit-10133498/491c7c3523a5879774a2bfba61d0f420.png) **解析**:批量提交一次往返处理多条,是弱网环境的必需品。幂等键让重复提交安全——网络超时后前端无法判断服务端是否收到,只能重试,此时幂等保证不会插入重复数据。 ```javascript export async function sendBatch(items, { signal, maxBatch = 50 } = {}) { const results = [] for (let i = 0; i c.feedbackId))) const res = await fetch('/api/feedback/batch', { method: 'POST', headers: { 'Content-Type': 'application/json', 'Idempotency-Key': `batch-${key}`, }, body: JSON.stringify({ items: chunk }), signal, }) if (res.status === 409) { // 幂等命中:视为成功,无需重复插入 results.push(...chunk.map(c => ({ feedbackId: c.feedbackId, status: 'submitted' }))) continue } const json = await res.json() results.push(...json.results) } return results } ``` **解析**:`maxBatch` 控制单批大小,**避免一次 POST 体积过大触发网关限制**。`Idempotency-Key` 用批次内所有 feedbackId 的哈希生成,保证"同一批内容"必然命中同一键。**409 不算错误而是幂等命中**,这条判断不能漏。 --- # 六、前后端契约:富化与质检的分工 前端不该算质检结论,后端也不该重新推断用户已经确认的信息。分工要明确。 ![](https://developer.qcloudimg.com/http-save/audit-10133498/e1b43ba398bc643cbab558c41250810a.png) **解析**:前端负责"保证数据完整",后端负责"保证数据可信"。**上下文特征必须在前端随提交一起抓取**,因为模型重训后原始特征可能已不可得。`quality` 里的 `authorReliable` 由后端根据历史标注与复核结果动态计算,前端不碰。 ```javascript // 前端提交前的富化:补齐模型快照与上下文 export function enrichFeedback(draft, { series, modelVersion, context }) { const point = series.find(d => d.ds === draft.targetDate) return { feedbackId: draft.feedbackId, sku: draft.sku, targetDate: draft.targetDate, modelVersion, modelOutput: { yhat: point?.yhat, yhatLower: point?.yhatLower, yhatUpper: point?.yhatUpper, actual: point?.actual ?? null, }, label: { verdict: draft.verdict, rootCause: draft.rootCause, severity: draft.severity, comment: draft.comment.trim(), tags: draft.tags || [], }, context, author: draft.author, role: draft.role, } } ``` **解析**:`actual` 可能为 null(预测期),用 `?? null` 显式表达"暂无实际值",而不是省略字段——**省略会让后端无法区分"未采集"和"零值"**。`context` 由调用方注入,保证提交时刻的特征是最新的。 --- # 七、冲突与复核:标注之间也会打架 同一天可能被两人标注为不同根因,也可能与模型结论冲突。这些不是要消除,而是要记录下来供仲裁。 ![](https://developer.qcloudimg.com/http-save/audit-10133498/57b2951200b92bf857b8e7d6c7b97d0b.png) **解析**:分歧不是噪声。**两个人给出不同根因,说明分类体系有歧义或特征确实有复合原因**,这比一致标注更有信息量,应保留并触发复核。 ```javascript export function detectConflicts(feedbacks) { const groups = new Map() feedbacks.forEach(f => { const k = `${f.sku}:${f.targetDate}` if (!groups.has(k)) groups.set(k, []) groups.get(k).push(f) }) const conflicts = [] for (const [k, items] of groups) { const causes = new Set(items.map(i => i.label.rootCause)) if (causes.size > 1) { conflicts.push({ key: k, items, reason: 'root_cause_diverged' }) } } return conflicts } ``` **解析**:按 SKU+日期分组,`Set` 的 size 大于 1 即存在分歧。**分歧记录本身要入库并关联原始标注**,供仲裁时查看各方理由。前端在列表页用醒目标记提示"该点存在分歧,待复核"。 --- # 八、闭环验证:让用户看见改善 这是全篇最容易被漏掉、却最决定标注系统生死的一环。 ![](https://developer.qcloudimg.com/http-save/audit-10133498/2d24cb6a34bd8adcbd392291a172548c.png) **解析**:曲线持续上升,是"你的标注在起作用"的最直接证明。**这条曲线必须出现在前端首页**,而不是藏在后台报表里。没有它,标注系统撑不过三个月。 ```javascript export function FeedbackImpact({ stats }) { const items = stats.versions.map(v => ({ version: v.version, adoption: v.acceptedFeedback / v.totalFeedback * 100, wmape: v.wmape, })) return ( 你的标注带来的变化 {items.map(it => ( {it.version} 采纳 {it.adoption.toFixed(0)}% ))} 累计 {stats.totalContributed} 条标注中,{stats.totalAccepted} 条已进入训练集, 相关 SKU 平均 WMAPE 改善 {(stats.wmapeDelta * 100).toFixed(1)} 个百分点 ) } ``` **解析**:**"你的标注带来的变化"是这句话的精准表述**,不是"系统贡献"。末尾的量化结论把个人动作与业务结果直接挂钩,是最强的行为激励。百分比条用绿色,强化正向反馈。 --- # 九、可观测性与合规 反馈管道一旦失效,模型迭代就会静默停滞。必须有端到端的可观测性。 ![](https://developer.qcloudimg.com/http-save/audit-10133498/9b9218b82149ecdfe9b31c49d7e0b39f.png) **解析**:队列长度反映离线积压,提交成功率反映管道健康,质检时长反映后端处理能力。**三个指标任一异常都该告警**,因为标注丢失是不可逆的(用户不会记得自己标过什么)。 ```javascript export function telemetry(queue) { const pending = queue.items.filter(i => i.status === 'pending').length const failed = queue.items.filter(i => i.status === 'failed').length const total = queue.items.length // 上报到监控(如 Sentry / 自建埋点) report('feedback_queue', { total, pending, failed, oldestPending: queue.items.find(i => i.status === 'pending')?.createdAt, }) if (failed > 10) { notify('标注回传多次失败,已暂停重试,请检查网络') } } ``` **解析**:`oldestPending` 暴露积压时长,比单纯计数更有告警价值。**失败超过阈值就停止重试并提示用户**,避免无意义的网络消耗。 合规上,标注数据含业务判断,需明确权属与留存: ```javascript export function applyRetention(feedbacks, policy) { const cutoff = new Date() cutoff.setMonth(cutoff.getMonth() - policy.months) return feedbacks.filter(f => { const created = new Date(f.createdAt) if (created < cutoff && f.status === 'archived') return false return true }) } ``` **解析**:只有已归档且超期的记录才清理,accepted/training 状态的数据即便超期也保留——**训练数据一旦删除,模型就失去可复现性**。留存期限从策略读取,便于按合规要求调整。 --- # 结语 反馈闭环是预测平台从"给人看的仪表盘"进化为"能自我改进的智能系统"的分界点。本文给出了一条完整链路:**先把标注建模成带模型快照与特征上下文的结构化样本,再用显式状态机管理从草稿到训练的全生命周期,用本地队列保证弱网不丢数据,用批量提交与幂等键保证高效且安全的回传,用冲突检测保留分歧信号,最后把"采纳率提升、误差改善"直接呈现给标注者,让闭环真正闭环。** 阅读本文的收获: - **标注必须冻结当时的模型输出与特征上下文,否则重训后失去训练价值;** - **状态机要显式建模且用表驱动,禁止绕行;** - **离线场景必须用持久化队列与有限重试,失败超阈值即停止而非耗尽资源;** - **分歧不是噪声而是分类体系待改进的信号,应保留并触发复核;** - **闭环的最后一环是让用户看见自己的贡献带来的改善,这是标注系统能否持续运转的唯一动力。**
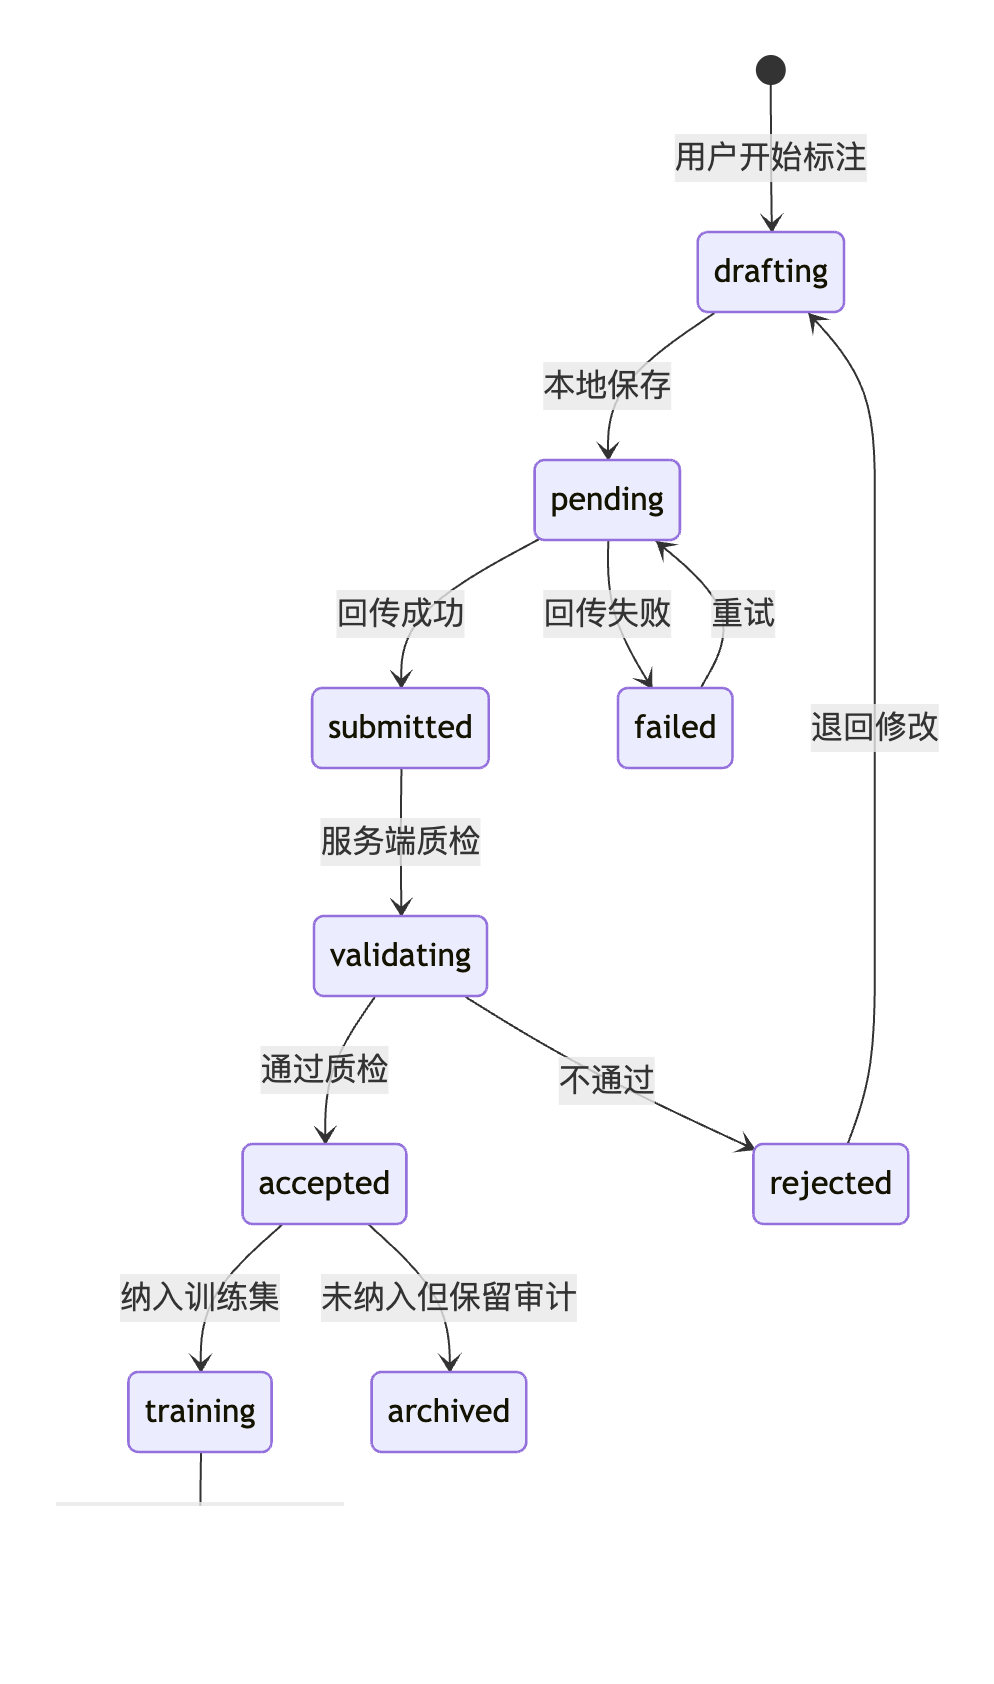
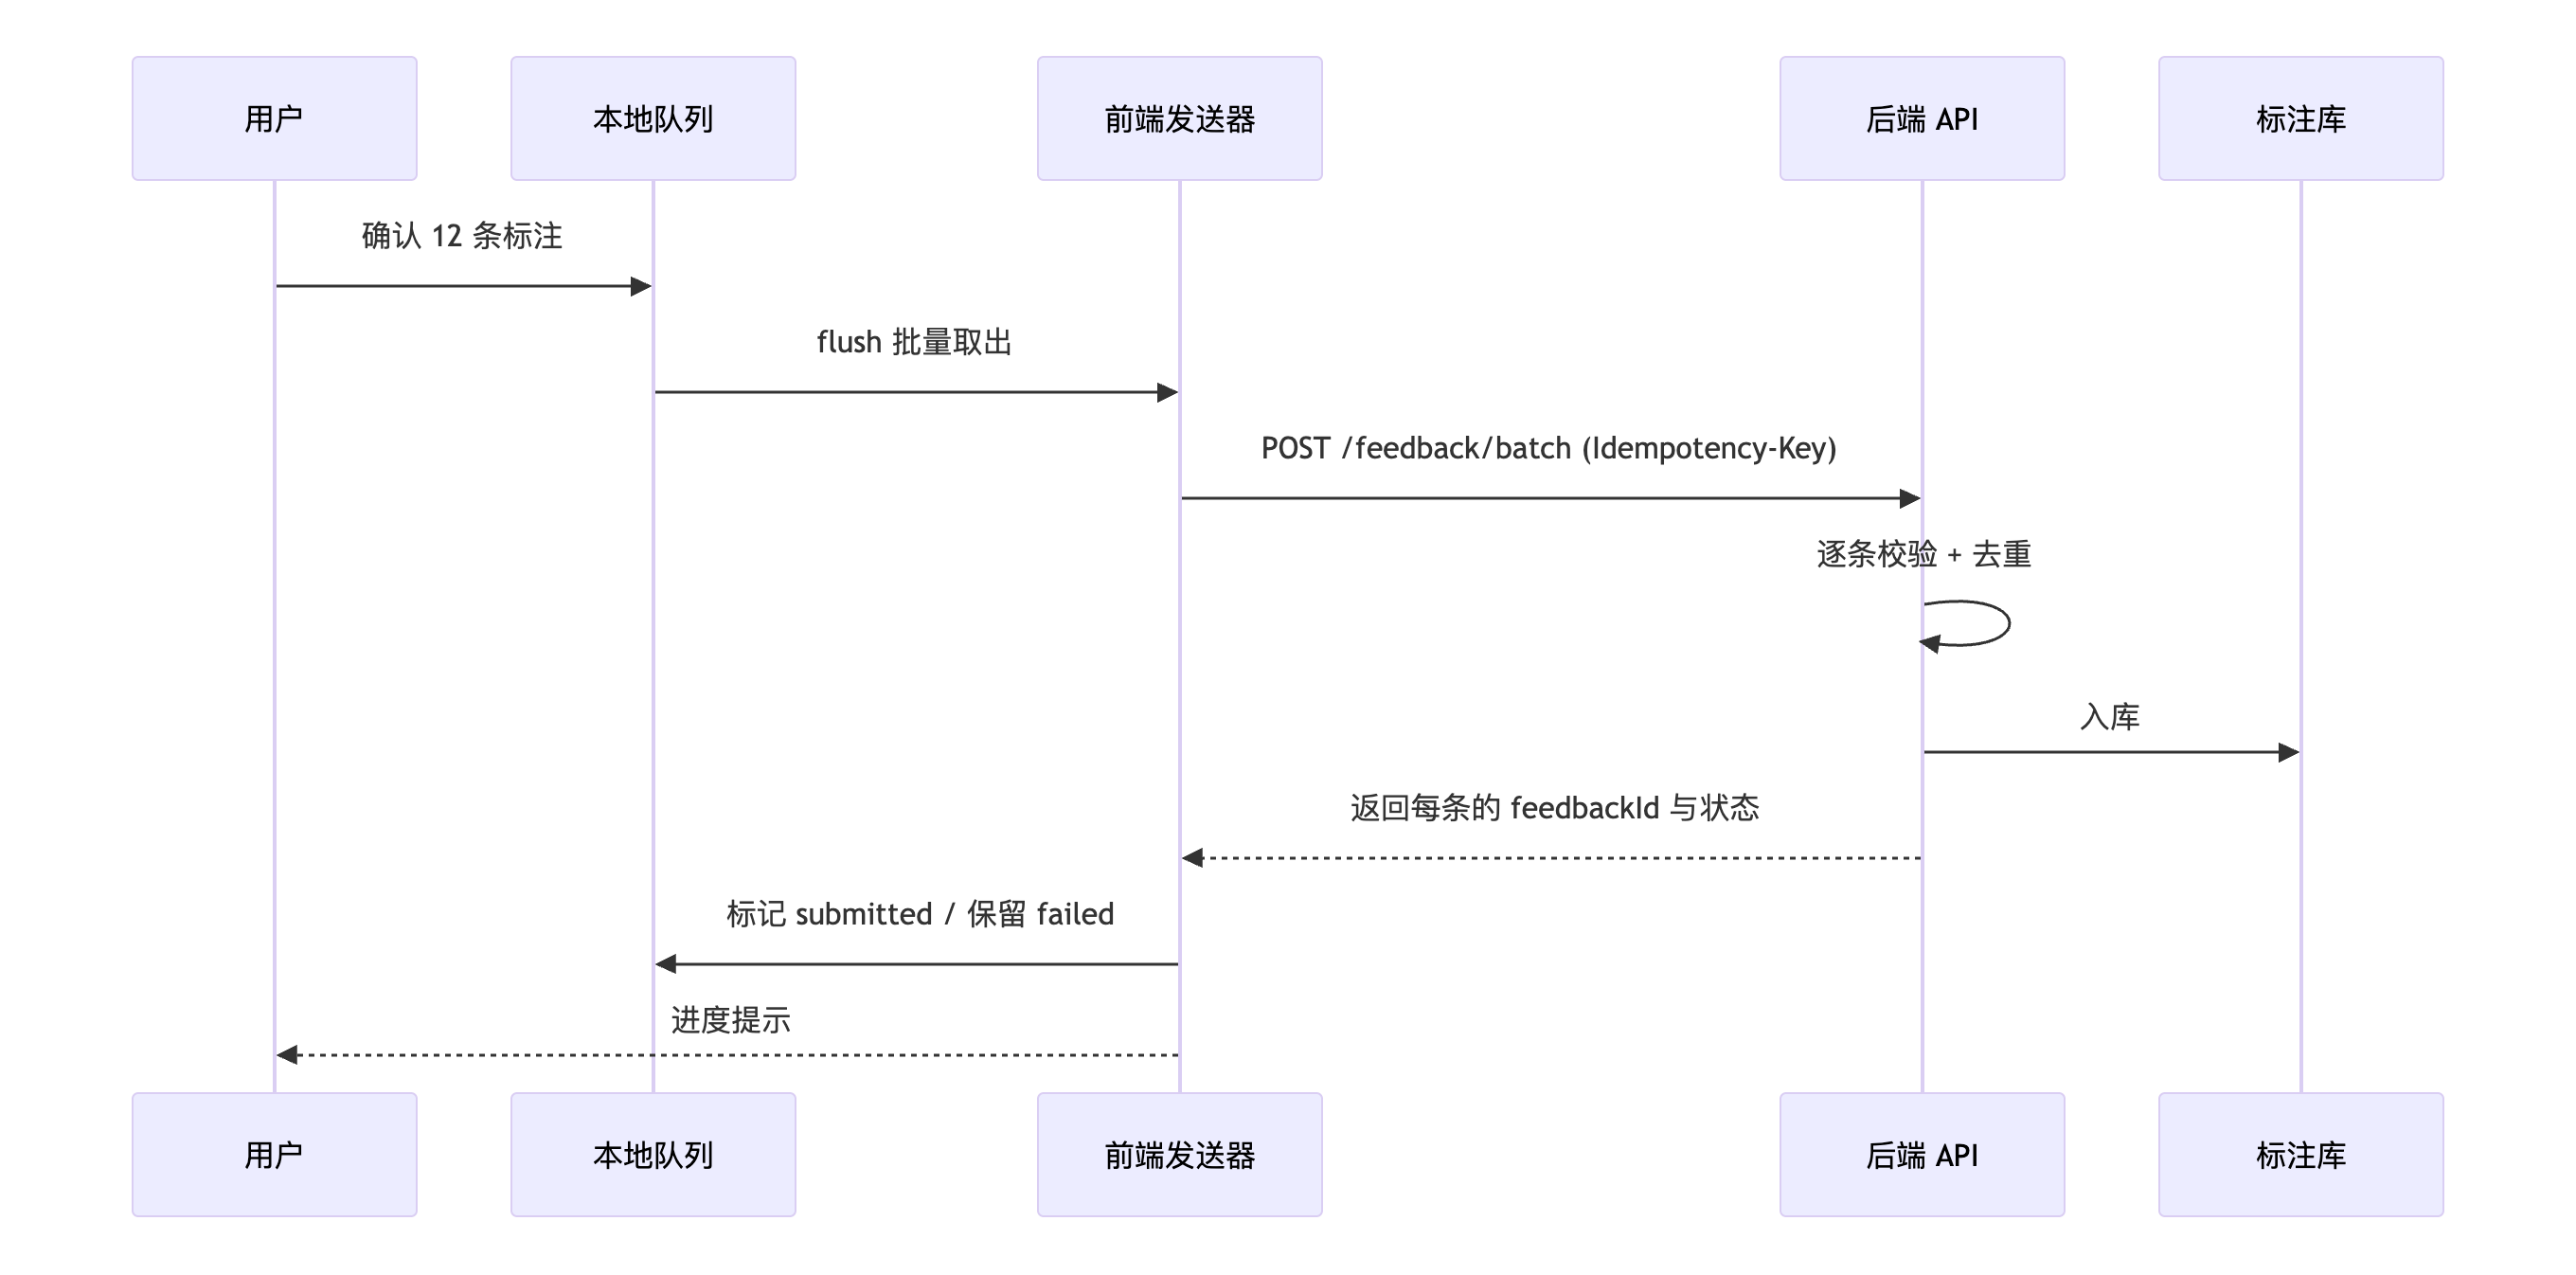
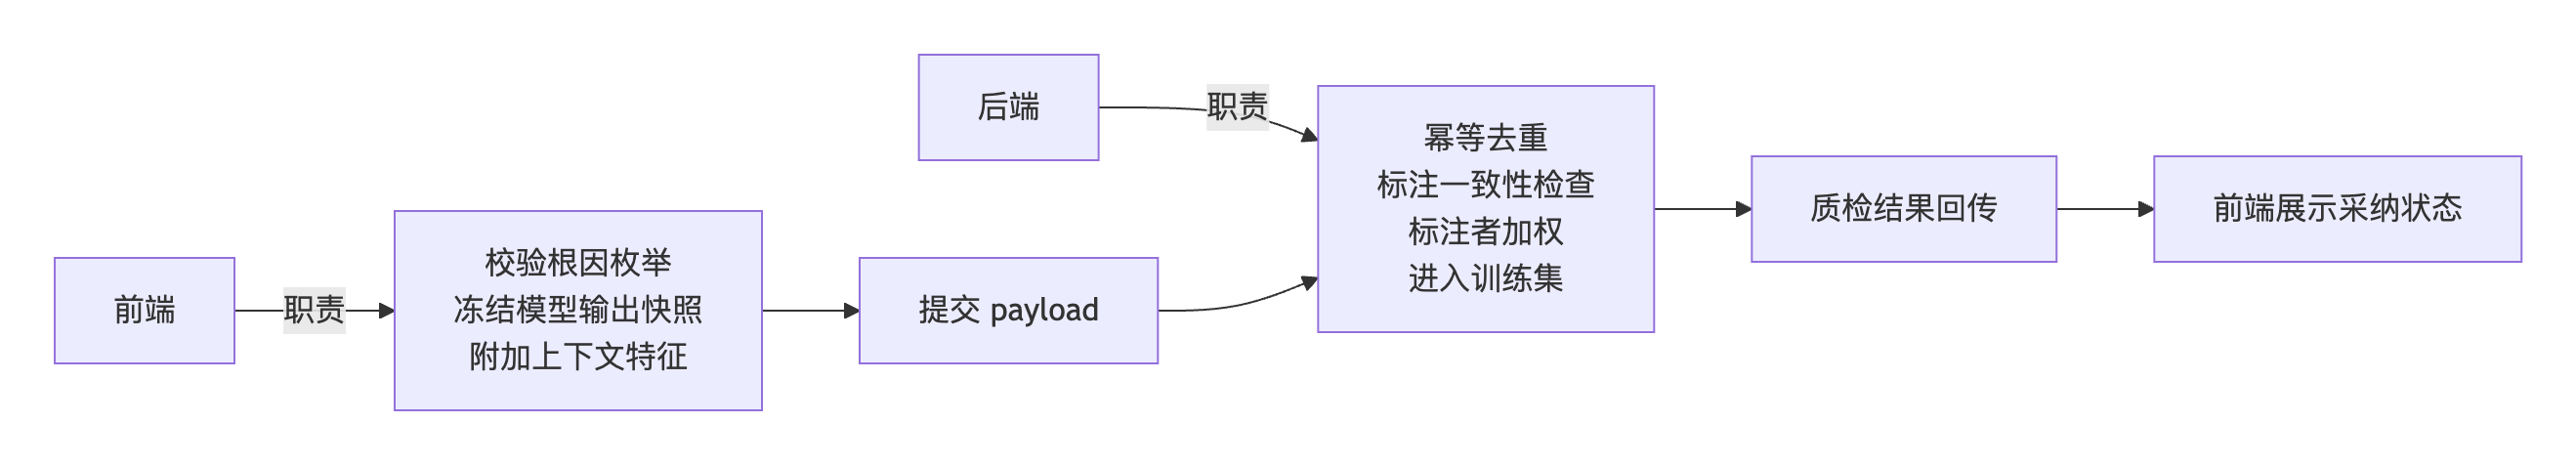
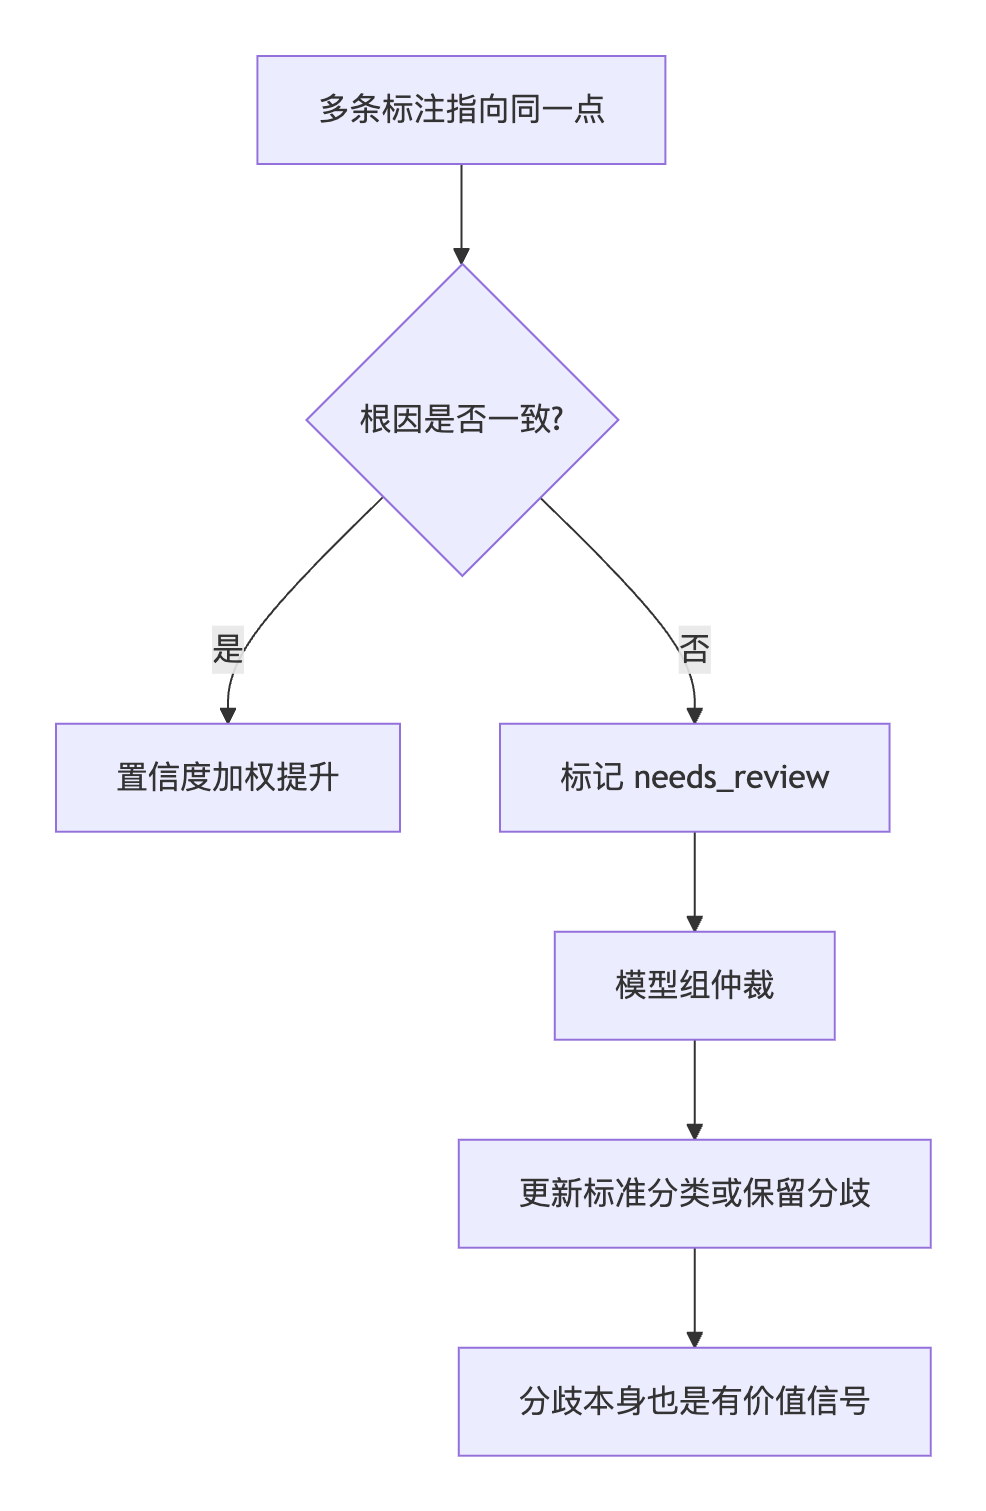

优秀的个人博客,低调大师

AI 预测可视化平台 | 预测准确率追踪:WMAPE/MAPE 实时计算与展示

# 引言 一个日常的问题:**准确率今天是多少?** 模型上线不是终点,数据漂移、促销突袭、供应链扰动都在让预测悄悄变坏。如果准确率只在一周一次的复盘会上出现,等发现时损失已经发生了。 准确率追踪要做三件事:**算对、算快、算得让人看得懂**。WMAPE 和 MAPE 口径不同、适用场景不同,前端的职责是让两者实时可得、口径可见、趋势可查、告警可触达。本文将拆解指标公式与陷阱、流式计算实现、趋势可视化、口径切换与分层下钻,以及性能边界。 --- # 一、先厘清:WMAPE 与 MAPE 不是一回事 这是整个模块的地基。两个指标看着只差一个 W,实际含义、行为和对零销量的处理完全不同。 ![](https://developer.qcloudimg.com/http-save/audit-10133498/bcf2468ff0403e41d6fcb34ce116fceb.png) **解析**:**MAPE 是逐点相对误差的平均,WMAPE 是总量误差相对总量**。当某天实际销量为 0 而预测为 5 时,MAPE 该项趋于无穷,整条指标直接失效;WMAPE 的分母是所有实际值之和,天然规避零除。**零销量普遍存在的品类(长尾 SKU)只能用 WMAPE**,用 MAPE 等于自欺欺人。 |维度|MAPE|WMAPE| | --- | --- | --- | |分母|各点实际值|全期实际值之和| |零销量处理|失效|正常| |极端值敏感度|高|低| |适合场景|单 SKU、销量平稳|汇总、多 SKU 加权| |直观性|高(即百分比)|中(需解释)| 数据契约建议把两者都下发,并附上口径说明和样本量: ```javascript { "sku": "SKU-1002331", "range": { "from": "2026-06-01", "to": "2026-09-25" }, "metrics": { "wmape": 0.118, "mape": 0.142, "mapeValidCount": 82, "mapeTotalCount": 90, "mapeExcluded": 8, "coverage": 0.91, "sampleDays": 90 }, "history": [ { "ds": "2026-06-01", "wmape": 0.134, "mape": 0.161, "volume": 1280 }, { "ds": "2026-09-25", "wmape": 0.118, "mape": 0.142, "volume": 1520 } ] } ``` **解析**:`mapeExcluded` 是零销量排除件数,**必须展示**。否则计划员看到 MAPE 0.142 会以为是全量口径,实际它只算了 82 天——两个数字不可比。`coverage` 是区间覆盖率,与 WMAPE 并称"准确度的两条腿":WMAPE 讲中心趋势、coverage 讲不确定性。`history` 提供趋势数据,驱动下文的折线图。 --- # 二、计算实现:增量聚合与流式更新 准确率指标看似简单,但**一旦要做"任意时间窗下的实时值",就必须支持增量计算**,否则每拖动一次滑块就全量重算,万级数据直接卡死。 ```javascript import { sum } from 'd3-array' // 单次全量计算:适用于首屏与小规模序列 export function computeAccuracy(series) { const valid = series.filter(d => d.actual != null) const n = valid.length if (!n) return { wmape: null, mape: null, mapeValidCount: 0, mapeExcluded: 0 } let absErrSum = 0 let actualSum = 0 let absRelErrSum = 0 let mapeValidCount = 0 let mapeExcluded = 0 for (const d of valid) { const absErr = Math.abs(d.actual - d.yhat) absErrSum += absErr actualSum += d.actual if (d.actual === 0) { mapeExcluded += 1 // 零销量不纳入 MAPE,避免除零 } else { absRelErrSum += absErr / Math.abs(d.actual) mapeValidCount += 1 } } return { wmape: actualSum > 0 ? absErrSum / actualSum : null, mape: mapeValidCount > 0 ? absRelErrSum / mapeValidCount : null, mapeValidCount, mapeExcluded, sampleDays: n, } } ``` **解析**:一次遍历同时算完两个指标,是 O(n) 的最优写法。**零销量在循环内分支计数而不参与累加**,既规避除零,又保证 `mapeValidCount` 是真实分母。返回 null 而非 0 很重要——null 表示"无法计算",0 会被误解为"完美预测"。 ```javascript // 增量聚合器:时间窗滑动时只更新差值部分 export class AccuracyAggregator { constructor(series) { this.series = series this.prefix = new Map() // 前缀和,下标 i 处存 [absErrSum, actualSum, relSum, relCount, zeroCount] this._buildPrefix() } _buildPrefix() { let a = 0, s = 0, r = 0, rc = 0, z = 0 this.series.forEach((d, i) => { if (d.actual != null) { a += Math.abs(d.actual - d.yhat) s += d.actual if (d.actual === 0) z += 1 else { r += Math.abs(d.actual - d.yhat) / Math.abs(d.actual); rc += 1 } } this.prefix.set(i, [a, s, r, rc, z]) }) } // 区间 [l, r] 的准确率,O(1) 查询 query(l, r) { const at = i => this.prefix.get(i) || [0, 0, 0, 0, 0] const [a1, s1, rel1, rc1, z1] = at(r) const [a0, s0, rel0, rc0, z0] = l > 0 ? at(l - 1) : [0, 0, 0, 0, 0] const absErr = a1 - a0 const actual = s1 - s0 const relSum = rel1 - rel0 const rc = rc1 - rc0 const zc = z1 - z0 return { wmape: actual > 0 ? absErr / actual : null, mape: rc > 0 ? relSum / rc : null, mapeValidCount: rc, mapeExcluded: zc, sampleDays: r - l + 1, } } } ``` **解析**:前缀和把区间查询从 O(n) 降到 O(1),是滑动时间窗能 60fps 响应的关键。`query` 用区间右端点减左端点前一位置,是前缀和的标准用法。**构建阶段一次 O(n),之后任意窗都 O(1)**,代价是 O(n) 内存——90 天窗口完全无感,全量历史可改用分段前缀和压缩。 --- # 三、趋势可视化:口径切换与基带图 准确率指标必须配趋势,单点数字没有意义。但切换 WMAPE/MAPE 时,量级和含义都变,视图必须同步重绘而非复用刻度。 ![](https://developer.qcloudimg.com/http-save/audit-10133498/29f5b82cd0da9d1edc869a8c89232b15.png) **解析**:WMAPE 稳定且永不为零,适合用**基带图(带目标区间的水平带状图)**,一眼看出"在不在目标内";MAPE 波动大、有剔除,适合折线图并配文字说明。**两种口径用两种视觉编码,不能共用一套刻度配置**,否则刻度失真会让趋势被误读。 ```javascript import { scaleLinear } from 'd3' const TARGET = { wmape: 0.15, mape: 0.18 } const WARN = { wmape: 0.22, mape: 0.28 } export function AccuracyTrend({ history, metric }) { const data = history.map(d => ({ ds: d.ds, v: d[metric] })) const last = data[data.length - 1]?.v const target = TARGET[metric] const warn = WARN[metric] return ( {(last * 100).toFixed(1)}% {metric === 'wmape' ? 'WMAPE(加权平均)' : 'MAPE(含零销量剔除)'} {/* 目标带:绿色安全区 */} {/* 告警带:橙色风险区 */} {/* 危险区 */} ) } ``` **解析**:三段色带把"好/中/差"直接画进坐标系,**不需要用户读数字就能判断状态**。数字负责精确、色带负责直觉,两者互补。切换 `metric` 时 `target/warn` 从配置表读取,保证口径与阈值同步,不会出现"WMAPE 用 MAPE 阈值"的低级错误。 ![](https://developer.qcloudimg.com/http-save/audit-10133498/5f1eb9940b335452767ca091549e88c0.png) **解析**:图中曲线在 W4 突破目标线,这就是趋势图的核心价值——**单点 18% 看不出问题,连续上升的趋势才是告警信号**。告警应该针对"连续 N 期恶化"而非单点超阈,否则噪声会触发大量误报。 --- # 四、告警规则:何时该通知人 告警是准确率追踪唯一会"打扰人"的环节,规则必须克制且可配置。 ![](https://developer.qcloudimg.com/http-save/audit-10133498/9d3bd41611e112e6d676f62eda1614c3.png) **解析**:三态状态机比单阈值更可靠。**连续 3 期恶化才进 watching,避免单点抖动触发;突破告警线才真正打扰人**。恢复必须由人或新的达标数据确认,避免"刚好卡回线下"被误判为已修复。 ```javascript export function evaluateAlert(history, metric, rules) { const series = history.map(d => d[metric]).filter(v => v != null) const last = series.slice(-rules.window) // 默认最近 3 期 const prev = series.slice(-rules.window - 1, -1) const worsening = last.length >= 2 && last.every((v, i) => i === 0 || v >= last[i - 1]) const breached = last[last.length - 1] > rules.threshold return { level: breached ? 'alert' : worsening ? 'watch' : 'healthy', last: last[last.length - 1], delta: last[last.length - 1] - prev[prev.length - 1], message: breached ? `${metric.toUpperCase()} 已突破阈值 ${(rules.threshold * 100).toFixed(0)}%` : worsening ? `连续 ${last.length} 期恶化,需关注` : '指标处于目标带内', } } ``` **解析**:`worsening` 用 `every` 检查单调递增,**只要出现一期回落就不算连续恶化**,避免误报。`delta` 给出恶化速度,比绝对值更能说明问题(从 15% 涨到 18% 比从 20% 涨到 21% 严重得多)。三态 `level` 直接映射通知策略。 --- # 五、分层下钻:问题到底出在哪个层级 准确率是一个汇总数,但问题永远藏在某一层。没有下钻,指标只是个数字看板。 ![](https://developer.qcloudimg.com/http-save/audit-10133498/1561b380924fe7acd8aaa405dff297e6.png) **解析**:下钻是"从指标到动作"的最短路径。**仓库和品类用于定位范围,SKU 排序用于定位个案**——两者互补。下方统一汇入模型组的排查流程,保证告警不会烂在通知里。 ```javascript export function DrillDownTable({ groups, onSelect }) { const rows = groups .map(g => ({ ...g, delta: g.wmape - g.baselineWmape })) .sort((a, b) => b.delta - a.delta) return ( 维度样本量 WMAPE 较基线 {rows.map(r => ( onSelect(r)}> {r.key} {r.sampleDays} 天 {(r.wmape * 100).toFixed(1)}% 0 ? 'text-rose-600' : 'text-emerald-600'}`}> {r.delta > 0 ? '+' : ''}{(r.delta * 100).toFixed(1)}pp ))} ) } ``` **解析**:按 `delta` 降序保证"最差的最靠前",这与用户意图一致。`pp`(百分点)而不是 `%` 是口径严谨——**WMAPE 从 12% 到 15% 是涨了 3 个百分点,不是涨了 3%**(实际是涨了 25%)。这一处细节是准确率模块专业度的分水岭。 --- # 六、口径切换组件与性能边界 口径切换看似是下拉框,实际要处理单位、阈值、说明文案三套配置的联动: ```javascript export function MetricSwitcher({ metric, onChange, excluded }) { return ( {['wmape', 'mape'].map(m => ( onChange(m)} className={`px-3 py-1 rounded ${metric === m ? 'bg-indigo-600 text-white' : 'text-gray-600'}`}> {m.toUpperCase()} ))} {metric === 'mape' && excluded > 0 && ( 已剔除 {excluded} 天零销量数据 )} ) } ``` **解析**:切换按钮用受控组件,`excluded` 提示只在 MAPE 下显示,且带琥珀色警示——**提示不抢注意力,但存在感足够**。这是"口径可见"原则的具体落地。 性能上要守住两条线: |场景|策略| | --- | --- | |单 SKU 全量|前缀和一次构建,区间 O(1)| |多 SKU 汇总|服务端预聚合,下发汇总值| |实时数据流|Web Worker 增量更新| ![](https://developer.qcloudimg.com/http-save/audit-10133498/37fe6dfd5666a1cffc97b12c04e00134.png) **解析**:百万点单次全量要 700ms,会卡住主线程。**实时数据流必须走 Worker 做增量更新**,前端只消费聚合结果。日常交互场景下,前缀和方案把区间查询压到常数级,滑动时间窗毫无压力。 --- # 结语 准确率追踪不是把 WMAPE 画成一个数字,而是构建一个**算得对、算得快、看得懂、叫得醒**的监控体系。本文给出了一条完整链路:**分清 WMAPE 与 MAPE 的口径差异和零销量处理,是可信度的前提;前缀和把区间查询降到 O(1),让时间窗滑动实时可得;目标带与告警规则把数字翻译成状态,且只对连续恶化与越界真正打扰人;分层下钻把汇总指标落实到仓库、品类与具体 SKU。** 阅读本文收获: - **WMAPE 用总量做分母、可安全处理零销量,MAPE 必须显式剔除并披露件数,两者不可混用;** - **指标变化要报百分点(pp)而非百分比,这是口径严谨的分水岭;** - **告警要针对连续恶化趋势而非单点超阈,否则噪声会淹没真实问题;** - **区间查询必须用前缀和做 O(1) 聚合,全量历史则走服务端预聚合。**

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册