首页 文章 精选 留言 我的

精选列表

搜索[AIPC技术],共10000篇文章
优秀的个人博客,低调大师

一份研发图纸的外流路径复盘:终端防泄密技术该在哪几个环节设卡

假设我们现在拿到一份泄密事件的调查报告:某工程师离职前一周,把伺服驱动的核心 PCB 设计图通过个人网盘发了出去。复盘他当时的操作路径,大致是五步——本地打开文件、另存到桌面、拖进浏览器上传窗口、点击发送、清空浏览器记录。整个过程不到三分钟,事后在公司的现有系统里几乎找不到任何痕迹。

优秀的个人博客,低调大师

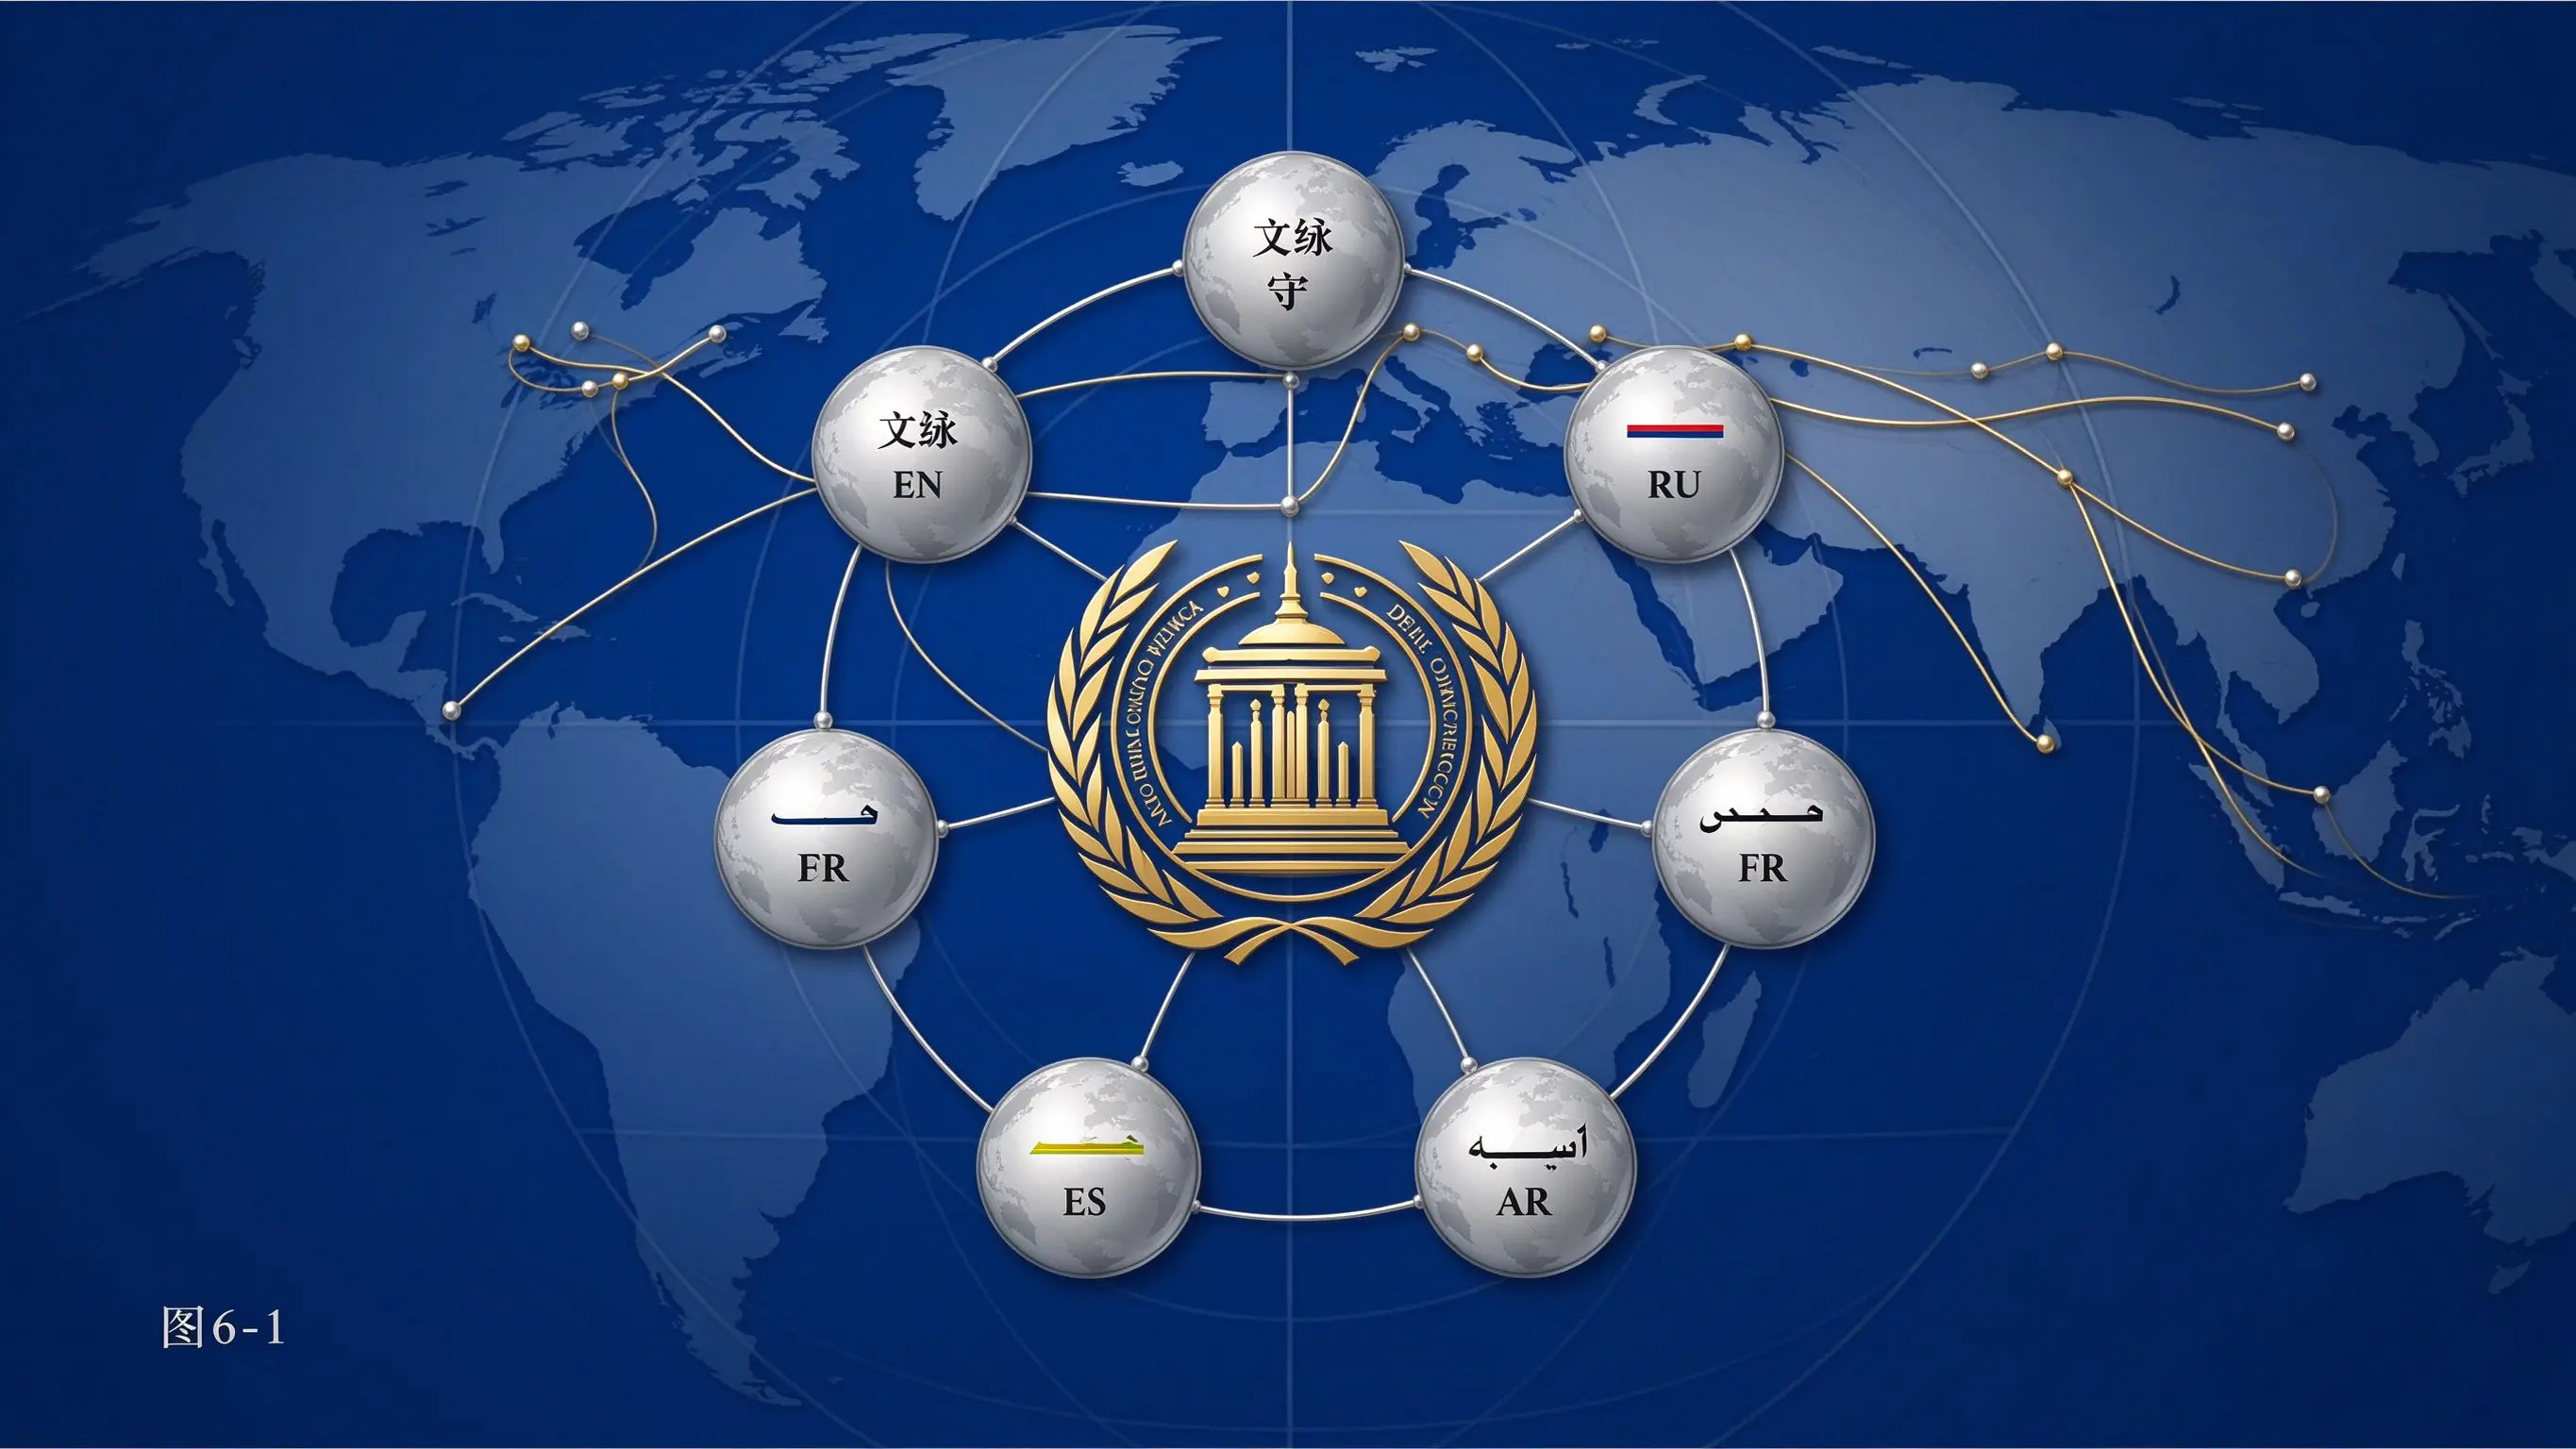
技术第6篇,多语言智能生态架构实战:55873 七国语言原生保真 + 可控智能翻译体系

做多语言 AI 平台的朋友,是不是也遇到过这些问题? 翻译篡改原文怎么办?小语种安全审核怎么做?数据出境合规怎么解决?语音自动转写的隐私风险怎么控制? 今天给大家拆解 55873 生态系统「多语言智能生态」的完整架构 —— 从原文保真、前端 UI 多语言切换、聊天智能翻译、语音隐私保护、多语言安全适配到文脉守护七语文化传播,一套可落地的多语言可信 AI 架构。 关键词:多语言 原文保真 智能翻译 Qwen3Guard Falcon-H1 Arabic 语音隐私 数据出境合规 一、为什么需要原文保真? 核心原则:永远保留用户原始输入文本,不自动篡改原始内容。 用户输入的原文是原始证据,无论是否开启翻译,存入系统的原始文本保持不变。翻译译文仅为阅读辅助,不会覆盖、替换原文。 设计依据: 用户原文是存证正本的语言基础。所有永久存证数据 100% 保留用户原生语言 译文不进入永久存证库,不写入数据库,仅前端临时渲染 阿拉伯语由第 7 套私有化专项模型 Falcon-H1 Arabic 增强 二、前端 UI 多语言体系 平台界面 7 国语言包全部放置前端。语言切换仅修改前端页面文字,不会向后端提交额外请求,不改动后端存储数据。 七国语言清单: 语言 代码 语言包位置 切换方式 中文 ZH 前端 纯前端切换 英语 EN 前端 纯前端切换 俄语 RU 前端 纯前端切换 德语 DE 前端 纯前端切换 法语 FR 前端 纯前端切换 西班牙语 ES 前端 纯前端切换 阿拉伯语 AR 前端 纯前端切换 优势: 响应速度快,不因切换 UI 语言带来数据泄露风险 原始业务数据完全不受界面语言影响 与 18 个一级界面的配置化挂载兼容 三、聊天智能翻译机制 3.1 翻译开关由用户自主控制 支持自动翻译或手动点击翻译 默认不自动翻译,用户主动开启后才调用翻译模型 3.2 译文仅前端临时渲染 译文只在前端临时渲染展示 译文不写入数据库,不参与永久存证 原始消息原文完整保留,保证证据真实性 3.3 翻译模型调用策略 场景 调用模型 说明 默认翻译 Qwen-MT(私有化) 本地部署,数据不出集群 阿拉伯语翻译 Falcon-H1 Arabic + Qwen-MT 专项增强 复杂小语种兜底 DeepL API 仅本地失败时调用,需脱敏,默认不启用 合规边界:调用 DeepL 意味着用户原文离开私有集群。仅在用户主动开启翻译且本地 Qwen-MT 失败时调用;调用前对个人信息、敏感标识做临时脱敏;默认不启用,需符合数据出境合规要求。 四、语音机制:隐私优先 平台不会自动对语音消息做转写、自动翻译。只有用户手动点击转写按钮,才调用 Qwen3-ASR 生成文本。 设计原则: 语音不自动转写、不自动翻译 用户手动点击才触发 Qwen3-ASR 转写出来的文本跟随聊天消息,执行 72 小时临时存储策略,到期自动清除 与数据安全体系完全对齐 五、多语言安全适配 Qwen3Guard 安全护栏原生支持 119 种语言及方言,覆盖 55873 七国语言体系。 5.1 公开安全基准 语言 Qwen3Guard-8B 对比模型 说明 英语提示分类 90.0 Avg F1 — SOTA 中文提示分类 85.1 Avg F1 PolyGuard-Qwen-7B: 68.4 +16.7 多语言 Avg 84.0 strict F1 — 119 种语言覆盖 阿拉伯语 SalamahBench 90.8% 准确率 Llama Guard 4: 83.3% +7.5% 阿拉伯语 AraSafe 88.7% 准确率 Aya Expanse 32B: 91.0% 无显著差异 5.2 安全策略编排层适配 多语言请求同样经过 L1/L2/L3 分级检测 低风险只读请求(如浏览多语言内容)走 L1,不调用 AI 模型 阿拉伯语高风险写操作走 L3,由 Qwen3Guard-8B + Falcon-H1 Arabic 双重保障 Arabizi(阿拉伯语罗马化书写)场景纳入专项测试集 六、行业痛点与解决方案 6.1 八大行业痛点 痛点 具体表现 机器翻译篡改原文 普通平台自动翻译并覆盖原文,导致存证语言非原生 小语种安全审核缺失 低资源语言的安全拒绝率显著低于高资源语言 阿拉伯语生成质量差 多数平台仅依赖通用基座模型,阿拉伯语被 "平均化" 翻译数据出境合规风险 调用 DeepL 等外部 API 意味着用户原文离开私有集群 UI 语言切换污染数据 部分平台语言切换会向后端提交请求 语音自动转写隐私风险 部分平台自动转写、自动翻译语音消息 文化语境失真 通用翻译模型缺乏文化语境优化 存证语言不统一 若存证正本使用翻译后语言,原始母语证据链断裂 6.2 55873 的解决方案 行业痛点 55873 解决方案 机器翻译篡改原文 原文绝对保真,译文仅前端临时展示,不写入数据库 小语种安全审核缺失 Qwen3Guard 支持 119 种语言及方言,L1/L2/L3 分级检测 阿拉伯语被平均化 Falcon-H1 Arabic 专项模型,OALL 排名第一 翻译数据出境合规风险 默认 Qwen-MT 本地翻译;DeepL 仅兜底,需脱敏 UI 语言切换污染数据 前端语言包纯前端切换,不请求后端 语音自动转写隐私风险 用户手动点击才触发 Qwen3-ASR,72 小时清理 文化语境失真 文化语境优化 + 七语实时互译 + 原文保真 存证语言不统一 存证正本 100% 保留用户原生语言 七、量化价值 维度 量化指标 来源 多语言安全覆盖 119 种语言及方言 Qwen3Guard Technical Report 英语提示分类 90.0 Avg F1 Qwen3Guard 公开基准 中文提示分类 85.1 Avg F1 Qwen3Guard 公开基准 阿拉伯语 SalamahBench 90.8% 准确率 SalamahBench Falcon-H1 Arabic 3B OALL 61.87% Open Arabic LLM Leaderboard Falcon-H1 Arabic 7B OALL 71.47% Open Arabic LLM Leaderboard Falcon-H1 Arabic 34B OALL 75.36% Open Arabic LLM Leaderboard 八、落地实践:文脉守护的七语文化传播 文脉守护板块是多语言生态的典型落地场景。 8.1 七语实时互译 文脉守护已支持中文、英语、俄语、德语、法语、西班牙语、阿拉伯语七种语言的实时互译。 传播场景 七语支持 说明 非遗技艺展示 七语互译 1,200+ 非遗项目 上古玉器讲解 七语互译 近 5 万件馆藏 古籍文献检索 七语互译 1,870 万 + 份档案 文明谱系研究 七语互译 238 个文明体系 学术交流 七语互译 跨文化无障碍传播 8.2 阿拉伯语专项增强 Falcon-H1 Arabic 专项模型在文脉守护场景中承担阿拉伯语生成增强与翻译增强。 模型规模 OALL 平均分 超越对象 3B 61.87% 超越 Microsoft Phi-4 Mini 等 4B 竞品 10 个百分点 7B 71.47% 超越 Qatar Fanar-1-9B、Saudi HUMAIN ALLaM 7B 34B 75.36% 超越中国 Qwen2.5 72B、Meta Llama-3.3 70B 九、总结 55873 多语言智能生态解决的不是 "翻译好不好用" 的问题,而是多语言场景下证据可信、安全可控、隐私合规、文化不失真的系统性问题。 通过六项机制,为全球用户、监管方、学术机构与文明保护组织提供一套可验证、可审计、可复制的多语言可信 AI 架构: 原文保真:译文仅前端临时展示,不写入数据库 七语覆盖:7 国语言原生保真 阿拉伯语专项:Falcon-H1 Arabic 增强 数据不出境:默认本地翻译,DeepL 仅兜底 语音手动:用户手动触发才调用 Qwen3-ASR 存证语言原生:存证正本 100% 保留用户原生语言 55873 多语言生态坚持原文保真,界面语言前端化,翻译仅做前端辅助展示,语音转写由用户手动触发。七国语言全覆盖,阿拉伯语由 Falcon-H1 Arabic 专项模型增强。兼顾国际化交流需求,同时守住原始数据、证据的真实性与用户隐私安全。 话题标签:多语言 原文保真 智能翻译 Qwen3Guard Falcon-H1 Arabic 语音隐私 数据出境合规 55873生态系统

优秀的个人博客,低调大师

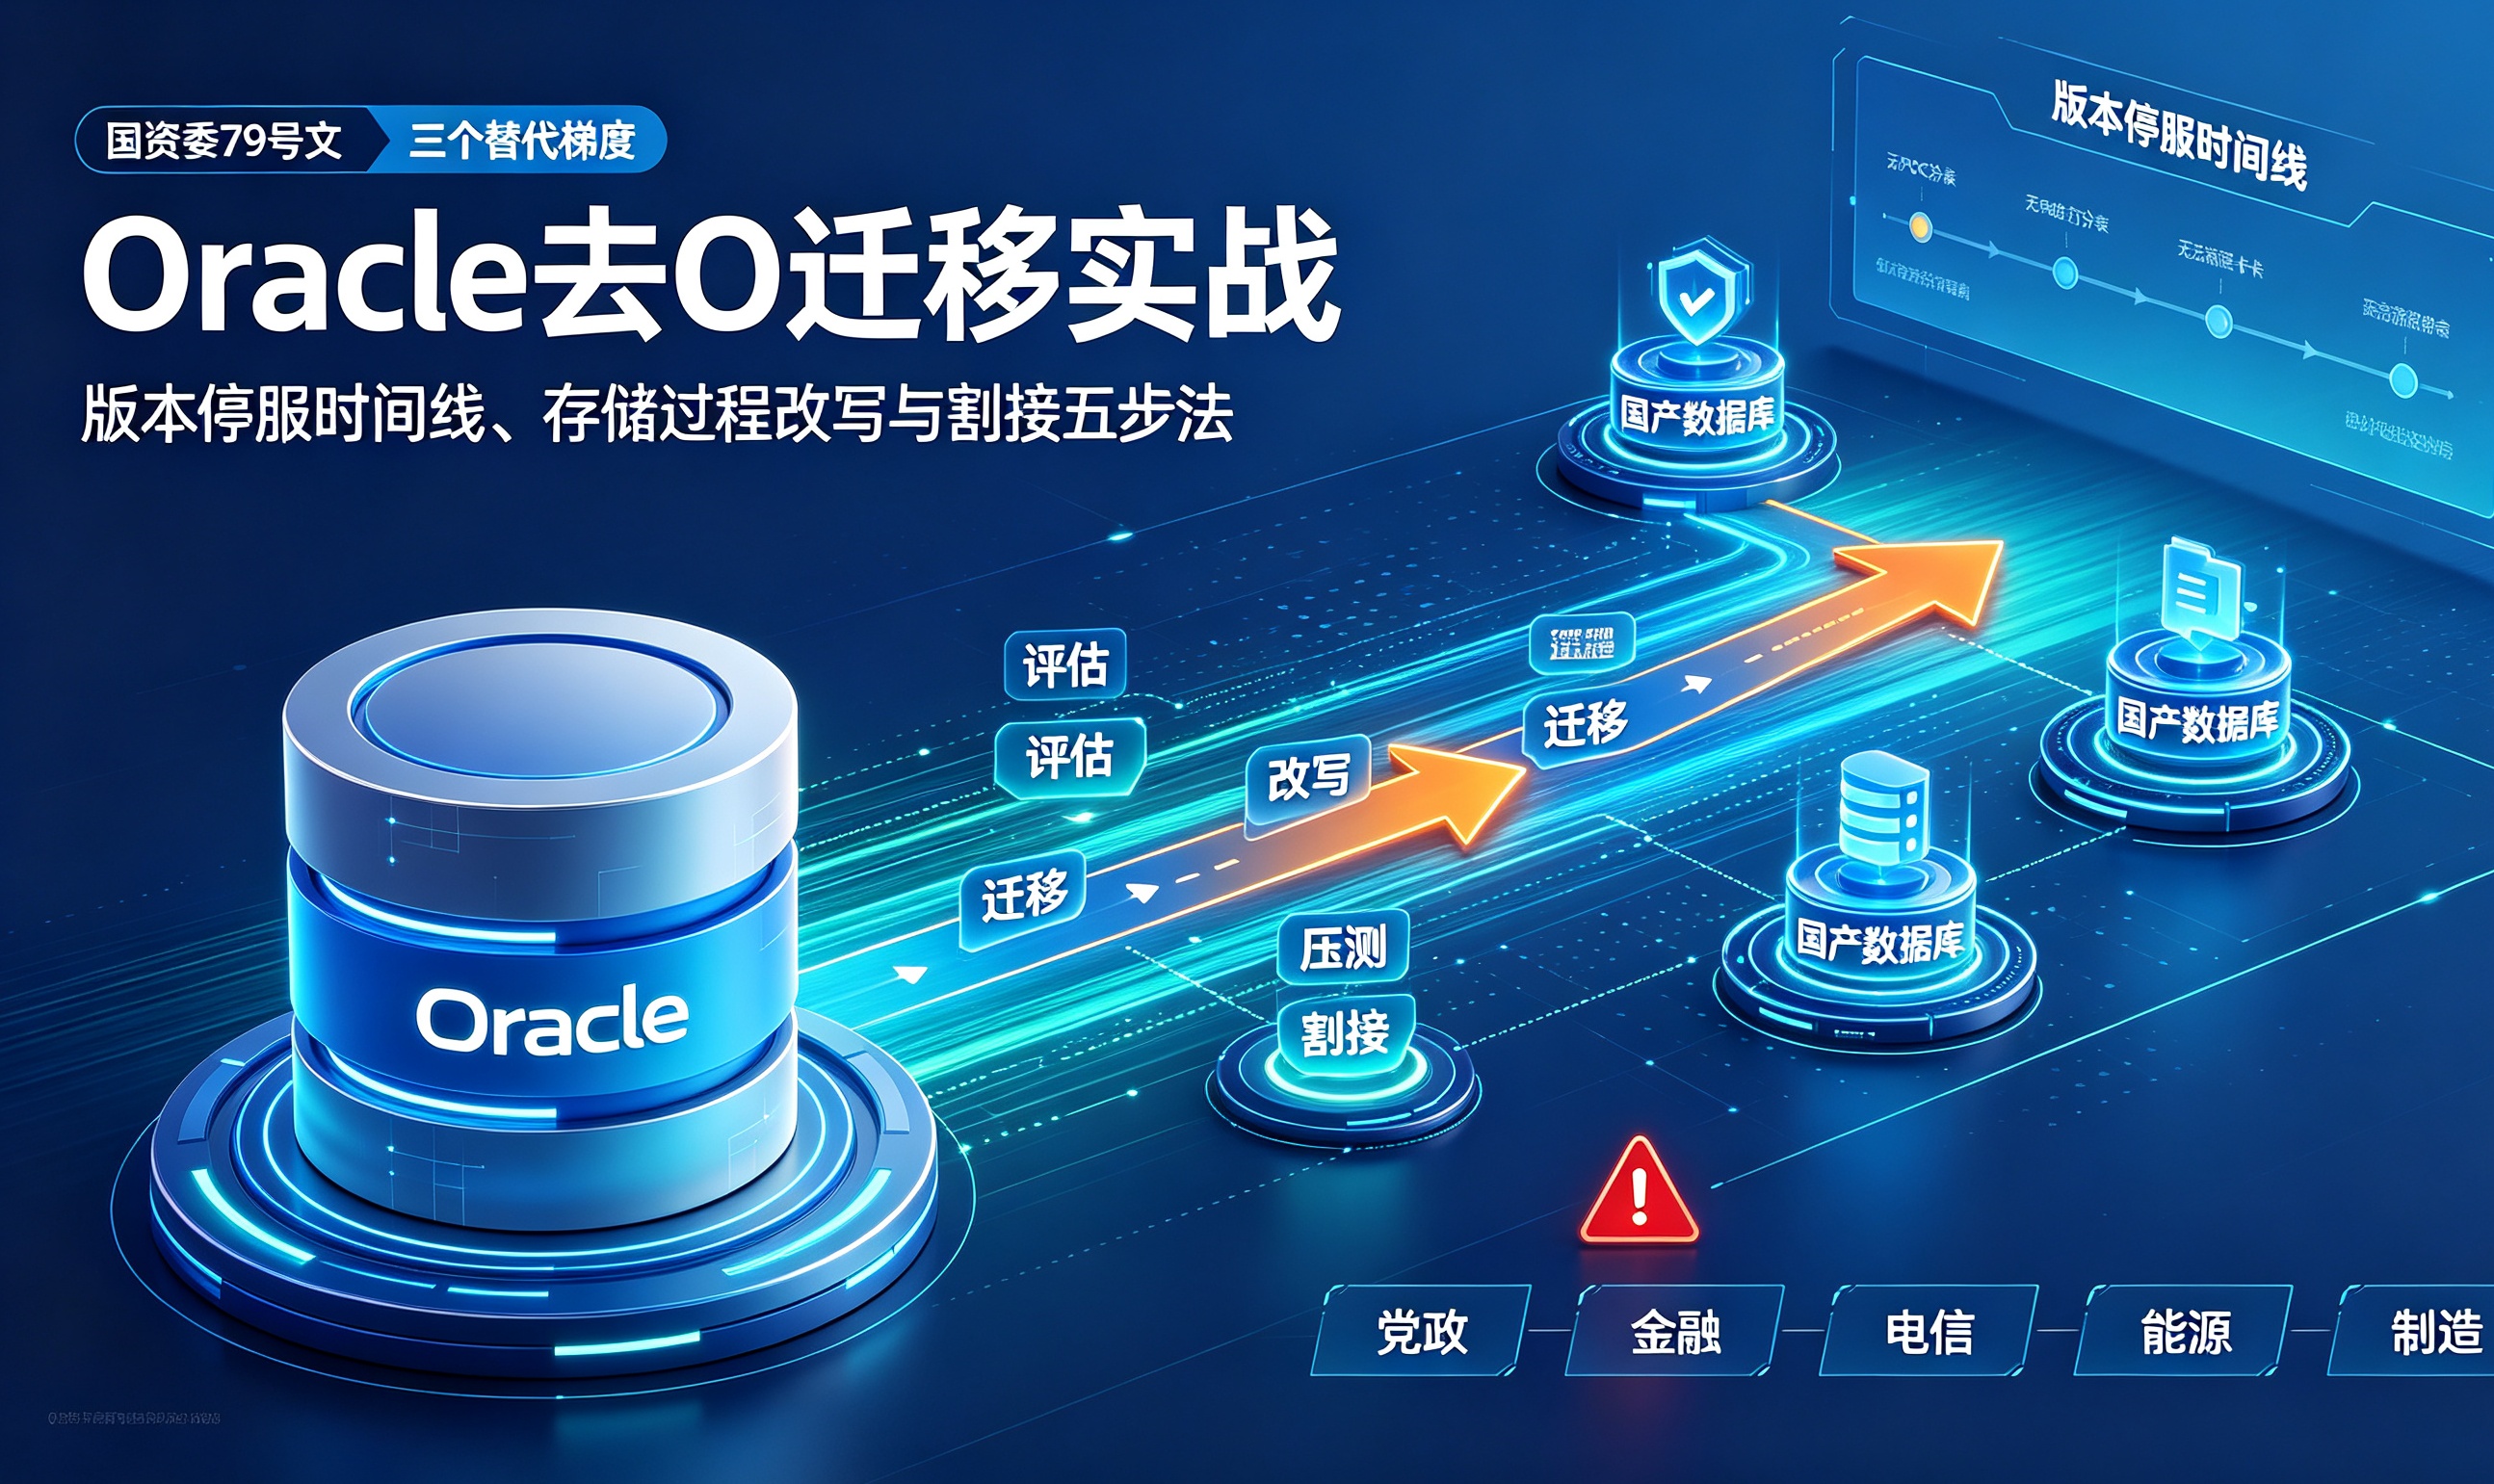
Oracle核心系统替换的三道技术关卡:RAC架构、跑批窗口与行为一致性

上个月团队接了个去O的活,让我先盘家底。系统清单拉出来,二十多个库,一大半还跑在Oracle 11g和12c上。这两个版本早就停服了,没补丁,出了问题没法兜底。报告交上去那天,领导问了一句:这些库2027前都得换完,排期怎么给?说实话,我给不出来。不是不知道工作量,是不知道同行走到哪了。快的是不是已经切完核心了,慢的还在外围打转?自己算快还是算慢,心里真没数。

优秀的个人博客,低调大师

大模型对齐核心技术拆解:详解RLHF强化学习、PPO优化、DPO偏好对齐的差异与实践22.3

在日常使用大模型的过程中,很多人都会遇到一类典型问题:模型本身储备的知识足够全面,但输出的回答往往生硬冗长、重点模糊,甚至频繁出现内容幻觉、答非所问等问题,无法贴合人类的对话逻辑与使用习惯。这类问题并非源于预训练阶段的知识训练不足,核心原因是模型未完成人类偏好对齐优化。

优秀的个人博客,低调大师

基于计算机视觉与边缘云协同架构的零售门店自动化巡检技术实现机理

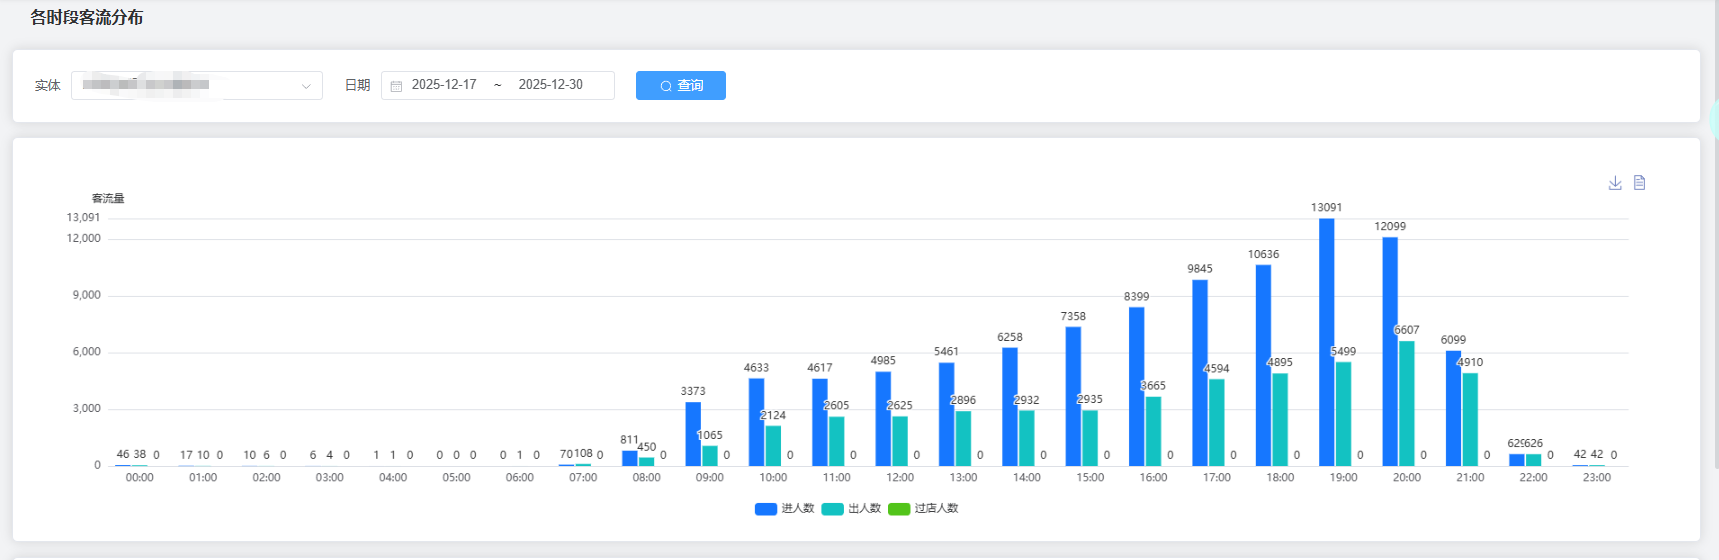
视频流经帧采样与畸变校正预处理后,通过多目标跟踪算法实现行人目标的连续轨迹关联,结合跨帧表观特征匹配完成人次去重计数,通过虚拟计数线与空间区域的双重判定逻辑区分过店客流与进店客流。人群属性识别基于细粒度人脸属性分类网络,在人脸关键点对齐的基础上输出性别、年龄段等属性的概率分布,实现客群结构的量化统计。行人轨迹经单应性矩阵映射至门店二维平面坐标系后,通过时空密度插值算法生成客流热力图,结合密度聚类方法识别高停留区域与冷区,为动线规划与人员配置提供空间量化依据。

优秀的个人博客,低调大师

2026 DTCC 中国数据库技术大会:腾讯云数据库诊断 Agent 工程实践与自研底座 Engram

腾讯云在2026 DTCC大会分享了数据库诊断Agent工程实践与自研底座Engram。针对弱模型适配与高噪声输入挑战,通过六条优化主线(数据源上下文、SKILL组织、SUBAGENT编排、多模并行、EVALS等)及Engram的Graph DSL声明式编排,实现端到端时延降至分钟级、Token消耗从百万级降至十万级、舒适区工单闭环率从30%提升至70%,系统性提升了诊断效率与可控性。

优秀的个人博客,低调大师

掌握RAG、Agent、函数调用、MCP、A2A全核心技术,AI应用架构设计能力完全解析21.1

相信大家应该也有一样的感觉,早期接触AI,会把大模型应用开发等同于简单的模型接口调用。调用API、输入提示词、获取输出,看似简单高效,但真正落地到企业生产场景就会漏洞百出。回答幻觉严重、无法获取实时数据、不能自主完成复杂任务、工具调用混乱、多智能体协作失效、上下文溢出、安全风险极高,这些都是纯模型调用开发的致命短板。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。


用户登录
用户注册