AI Infra 系列 · 第六章 GPU 性能工程(四):并行策略
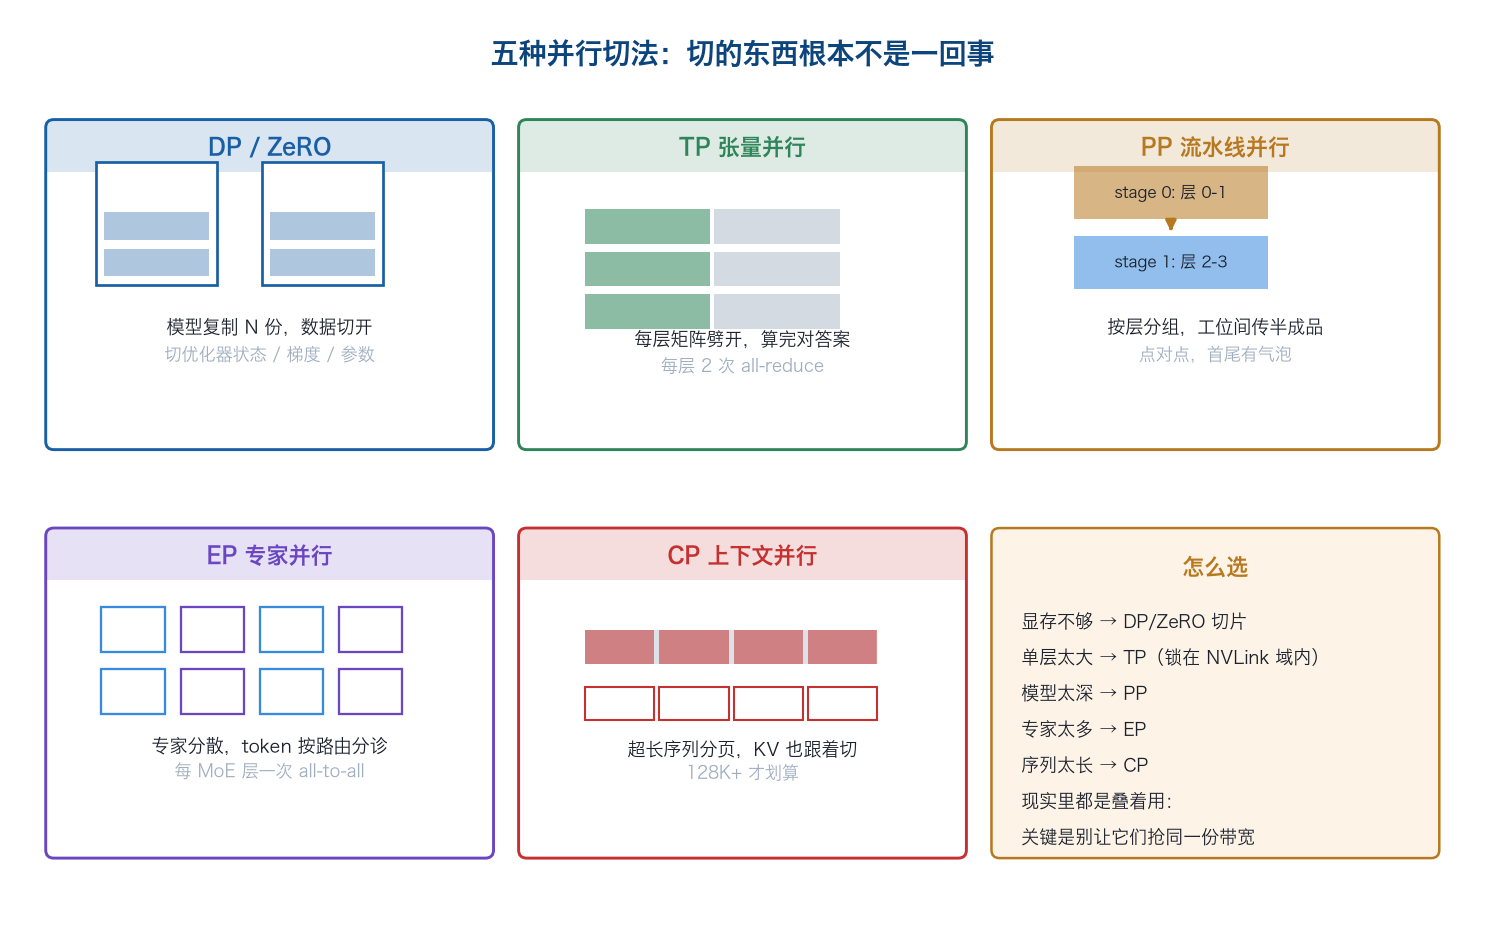 ## 一、先算一笔账:你的模型到底要多少显存 聊并行之前得先知道敌人是谁。训练时一个参数要占多少字节?混合精度 + AdamW 的标准配置下: - **FP32 主权重**:4 字节(bf16 只是计算用,主权重得留高精度) - **Adam 一阶动量 m**:4 字节 - **Adam 二阶动量 v**:4 字节 - **BF16 副本**:2 字节(实际参与计算的那份) - **梯度**:2 字节(bf16) 加起来 **16 字节/参数**。后面每笔账都从这个数往下拆,我自己算显存的时候也一直拿它打底。 下面这段脚本不用 GPU,纯算数,复制就能跑: ```python # mem_ledger.py —— 训练显存账本,纯 CPU 可跑 BYTES_PER_PARAM = 16 # 混合精度 + AdamW:4(master) + 4(m) + 4(v) + 2(bf16) + 2(grad) def gib(n): return n / 1024**3 def ledger(params_b: float, world: int, gpus_per_node: int = 8): """params_b: 模型参数量(十亿); world: 总卡数""" P = params_b * 1e9 rows = [ ("DDP(每卡完整副本)", P * 16), # 什么都不切 ("ZeRO-1(切优化器状态)", P * (12 / world + 4)), # 12 字节那部分切了 ("ZeRO-2(再切梯度)", P * (14 / world + 2)), # 梯度也切 ("ZeRO-3 / FSDP 全分片", P * (16 / world)), # 连参数一起切 ] print(f"\n模型 {params_b}B · {world} 卡({world//gpus_per_node} 节点 × {gpus_per_node} 卡)") print(f"{'策略':14}") print("-" * 44) for name, mem in rows: flag = " ← 装不下(> 80 GiB)" if gib(mem) > 80 else "" print(f"{name:10.1f} GiB{flag}") ledger(7, 8) # 7B 模型,单机 8 卡 ledger(70, 64) # 70B 模型,8 节点 ledger(671, 2048) # DeepSeek-V3 量级 ``` 我这边跑出来的结果(改参数看自己的): ``` 模型 7B · 8 卡(1 节点 × 8 卡) 策略 每卡模型状态 ---------------------------------------- DDP(每卡完整副本) 104.3 GiB ← 装不下(> 80 GiB) ZeRO-1(切优化器状态) 35.9 GiB ZeRO-2(再切梯度) 24.4 GiB ZeRO-3 / FSDP 全分片 13.0 GiB 模型 70B · 64 卡(8 节点 × 8 卡) DDP(每卡完整副本) 1043.1 GiB ← 装不下(> 80 GiB) ZeRO-1(切优化器状态) 273.0 GiB ← 装不下(> 80 GiB) ZeRO-2(再切梯度) 144.6 GiB ← 装不下(> 80 GiB) ZeRO-3 / FSDP 全分片 16.3 GiB 模型 671B · 2048 卡(256 节点 × 8 卡) DDP(每卡完整副本) 9998.7 GiB ← 装不下(> 80 GiB) ZeRO-1(切优化器状态) 2503.3 GiB ← 装不下(> 80 GiB) ZeRO-2(再切梯度) 1254.1 GiB ← 装不下(> 80 GiB) ZeRO-3 / FSDP 全分片 4.9 GiB ``` 这张表最值得看的不是 DDP 爆了,而是 **ZeRO-1 和 ZeRO-2 从 70B 开始也全爆了**。原因藏在那两个公式里:`12/world + 4` 和 `14/world + 2`——**参数本身那 2 字节和梯度那 2 字节,ZeRO-1/2 是不切的**,每卡都得留一份完整副本。模型越大,这份副本越要命。671B 光 bf16 参数就 1342 GiB,切一万张卡的优化器状态也救不回来。 所以结论是:**ZeRO-1/2 省的是优化器状态,不是参数。** 参数得靠 TP、PP、EP 去切。而能单独搞定 671B 的 ZeRO-3,代价是通信量涨到约 DDP 的 1.5 倍(来源:微软 ZeRO 论文与 DeepSpeed 文档给出的定性结论,倍数随模型结构浮动)。显存和通信,暂时还只能二选一。 顺带说一句,这个账本没算激活值。实际上激活往往比模型状态还能吃——batch 一大、序列一长,激活能轻松翻倍。所以你还得开梯度检查点(第二章讲过)或者把 batch 拆成 micro-batch。 ## 二、五种切法,切的东西根本不是一回事 很多人把"并行"当成一个词用,其实五种切法切的是五个完全不同的维度。 | 切法 | 切什么 | 大白话 | 通信类型 | 适合解决 | | ------------- | ------------------------- | ----------------------------------- | --------------------------- | ----------- | | **DP / ZeRO** | 数据切开,模型复制或分片 | 同一本书每人保管几页,用到时找同伴复印,复印的流量就是代价 | all-reduce / reduce-scatter | 显存不够、要提吞吐 | | **TP** | 每层内部的矩阵切开 | 几个人合算一道大题,每算完一步得对答案 | all-reduce(每层 2 次) | 单层太大、要降延迟 | | **PP** | 按层切开,0-19 层给 A,20-39 层给 B | 工厂流水线,工位之间传半成品 | 点对点(stage 之间) | 模型太深、装不下 | | **EP** | MoE 的专家分散到不同卡 | 专家门诊:dispatch 是挂号分诊,combine 是取回检查报告 | all-to-all(每 MoE 层) | 专家太多、参数量爆炸 | | **CP** | 序列维度切开 | 超长文章分页给多人读 | all-gather / ring attention | 128K+ 超长上下文 | **TP 是最"娇气"的那个。** 它每层要做两次 all-reduce(attention 的输出投影一次、MLP 的下投影一次),频率高到离谱,所以必须跑在高带宽互连上。NVIDIA 的建议很直接:TP 组待在单个 NVLink 域内,别跨节点(来源:NVIDIA Megatron-LM 与 TensorRT-LLM 文档)。跨节点跑 TP,IB 的延迟会让每一层的对答案时间都变长,加速比直接塌掉。 ```python # 最小 TP 示意:列切 + 行切,两卡各算一半 # 运行环境:至少 2 张 GPU + nccl,torchrun --nproc_per_node=2 tp_min.py import os, torch, torch.distributed as dist import torch.nn as nn dist.init_process_group("nccl") rank = int(os.environ["LOCAL_RANK"]); torch.cuda.set_device(rank) W = 4096 class ColumnParallel(nn.Module): # 列切:A 切成 [A1, A2],各自算完拼回来 def __init__(self): super().__init__() self.w = nn.Parameter(torch.randn(W, W // 2, device="cuda") * 0.02) def forward(self, x): return x @ self.w # 本地算一半,输出 [b, s, W/2] class RowParallel(nn.Module): # 行切:A 切成 [A1; A2],各算部分和再相加 def __init__(self): super().__init__() self.w = nn.Parameter(torch.randn(W // 2, W, device="cuda") * 0.02) def forward(self, x): y = x @ self.w # [b, s, W] dist.all_reduce(y) # ← 这一行就是 TP 的通信成本 return y x = torch.randn(2, 512, W, device="cuda") out = RowParallel()(ColumnParallel()(x)) print(f"rank{rank} out={out.shape} sum={out.sum().item():.3f}") ``` 真实框架里这两步之间还有 all-reduce 与计算的切分重叠(Megatron 的 `sequence_parallel` 就是干这个的),但骨架就是上面这样:**每一层的矩阵乘法被劈成两半,算完必须凑齐**。 **PP 的问题是气泡。** 流水线首尾必然有空档:开头后面的工位在等前面的产出,结尾前面的工位闲着。这个空档占总时间的比例,是可以算出来的——第四节给脚本。 **EP 的问题是分诊本身。** MoE 每个 token 只去 top-k 个专家,token 得先被送到专家所在的卡上(dispatch),算完再送回来(combine),这就是 all-to-all。DeepSeek-V3 的技术报告里给了一个让人清醒的数字:跨节点专家并行带来的**计算:通信比大约是 1:1**(来源:DeepSeek-V3 Technical Report, arXiv:2412.19437)。也就是说,通信时间跟计算时间一样长——不把它藏起来,一半的算力就白烧了。 ## 三、通信量账本:三种切法的流量差多少 同样是"切模型",三种切法的通信量完全不在一个量级。这段脚本算出来给你看: ```python # comm_ledger.py —— 每个 transformer 层的通信字节数,纯算术 def per_layer_comm(b, s, h, top_k, world_tp=1, bpe=2): act = b * s * h * bpe # 一层激活的字节数(bf16) # TP:每层 2 次 all-reduce,ring all-reduce 实际流量 2(N-1)/N × 张量大小 tp = 2 * act * (2 * (world_tp - 1) / world_tp) if world_tp > 1 else 0.0 # EP:dispatch 发过去 + combine 收回来,每个 token 走 top_k 个专家 ep = 2 * (b * s * top_k * h * bpe) # PP:只在 stage 边界传一次激活 pp = act return tp, ep, pp for name, (b, s, h, k, tp_w) in { "7B 小 batch": (8, 2048, 4096, 2, 8), "70B 中 batch": (16, 4096, 8192, 2, 8), "671B MoE": (32, 4096, 7168, 8, 1), # tp_w=1 表示不用 TP }.items(): t, e, p = per_layer_comm(b, s, h, k, tp_w) print(f"{name:8.1f} MB EP={e/1e6:>9.1f} MB PP={p/1e6:>8.1f} MB") ``` 我这边跑出来(每层,bf16): ``` 7B 小 batch TP= 469.8 MB EP= 536.9 MB PP= 134.2 MB 70B 中 batch TP= 3758.1 MB EP= 4295.0 MB PP= 1073.7 MB 671B MoE TP= 0.0 MB EP= 30064.8 MB PP= 1879.0 MB ``` 三个观察: **TP 和 EP 的量级差不多,但性质完全不同。** TP 是每层两次小批量 all-reduce,频率高、单次量小,靠 NVLink 的低延迟扛得住;EP 是每 MoE 层一次大批量 all-to-all,单次量大,且**流量跟 top_k 成正比**——671B 那行 top_k=8,EP 流量直接干到 30 GB/层,是 PP 的 16 倍。 **PP 是最省的**,因为它只在 stage 边界传一次激活,没有"每层都要对账"的开销。代价是气泡(下一节)。 **最后一行 TP=0 不是脚本偷懒**——DeepSeek 真的没用张量并行。为什么?看下去。 顺带一个推论:小模型(比如 7B 量级)单卡就装得下,上 EP 纯属给自己找通信开销——EP 是专家多了才需要的东西,别看到 DeepSeek 用就跟着上。 ## 四、PP 的气泡能算,DualPipe 省在哪 流水线气泡占比是可以手算的。DeepSeek-V3 论文 Table 2 直接给了三种调度方式的气泡公式(来源:arXiv:2412.19437 表 2): | 方法 | 气泡时间 | 参数显存 | 激活显存 | | -------- | -------------------- | ------ | ---- | | 1F1B | `(PP-1)(F+B)` | 1× | PP | | ZB1P | `(PP-1)(F+B-2W)` | 1× | PP | | DualPipe | `(PP/2-1)(F&B+B-3W)` | **2×** | PP+1 | F 是前向 chunk 时间,B 是反向 chunk 时间,W 是"为权重算反向"的时间,F\&B 是一对前向/反向 chunk 重叠后的时间。论文还注明 DualPipe 的峰值激活显存只比 1F1B 多 1/PP,随规模增大几乎可忽略(来源:arXiv:2412.19437 Table 2)。 ```python # bubble.py —— 流水线气泡占比,参数按你的实测改 def bubble_ratio(pp, m, F=1.0, B=2.0, W=0.5, FandB=2.0): """pp: 流水线阶段数; m: micro-batch 数量""" ideal = m * (F + B) # 无气泡时的总时间 f1b = (pp - 1) * (F + B) zb1p = (pp - 1) * (F + B - 2 * W) dual = (pp / 2 - 1) * (FandB + B - 3 * W) return {k: b / (ideal + b) for k, b in {"1F1B": f1b, "ZB1P": zb1p, "DualPipe": dual}.items()} print(f"{'PP':>4}{'micro-batch':>13}{'1F1B':>10}{'ZB1P':>10}{'DualPipe':>10}") for pp, m in [(8, 16), (8, 64), (16, 64), (16, 256)]: r = bubble_ratio(pp, m) print(f"{pp:>4}{m:>13}{r['1F1B']:>9.1%}{r['ZB1P']:>10.1%}{r['DualPipe']:>10.1%}") ``` 一组示意参数下的结果(F=1, B=2, W=0.5, F\&B=2.0,换成你的实测值): ``` PP micro-batch 1F1B ZB1P DualPipe 8 16 30.4% 22.6% 13.5% 8 64 9.9% 6.8% 3.8% 16 64 19.0% 13.5% 8.4% 16 256 5.5% 3.8% 2.2% ``` 三个规律跑完就明白了:**micro-batch 越多,气泡占比越低**(分母变大);**PP 越深,气泡越狠**(这是 1F1B 的软肋);**DualPipe 把 PP 的影响几乎砍半**——公式里是 `PP/2 - 1` 而不是 `PP - 1`。 代价是参数显存翻倍(表格里那个 2×)。DeepSeek 的说法是:反正 EP 规模大,参数本来就是分散的,多一份副本影响不大(来源:同上)。 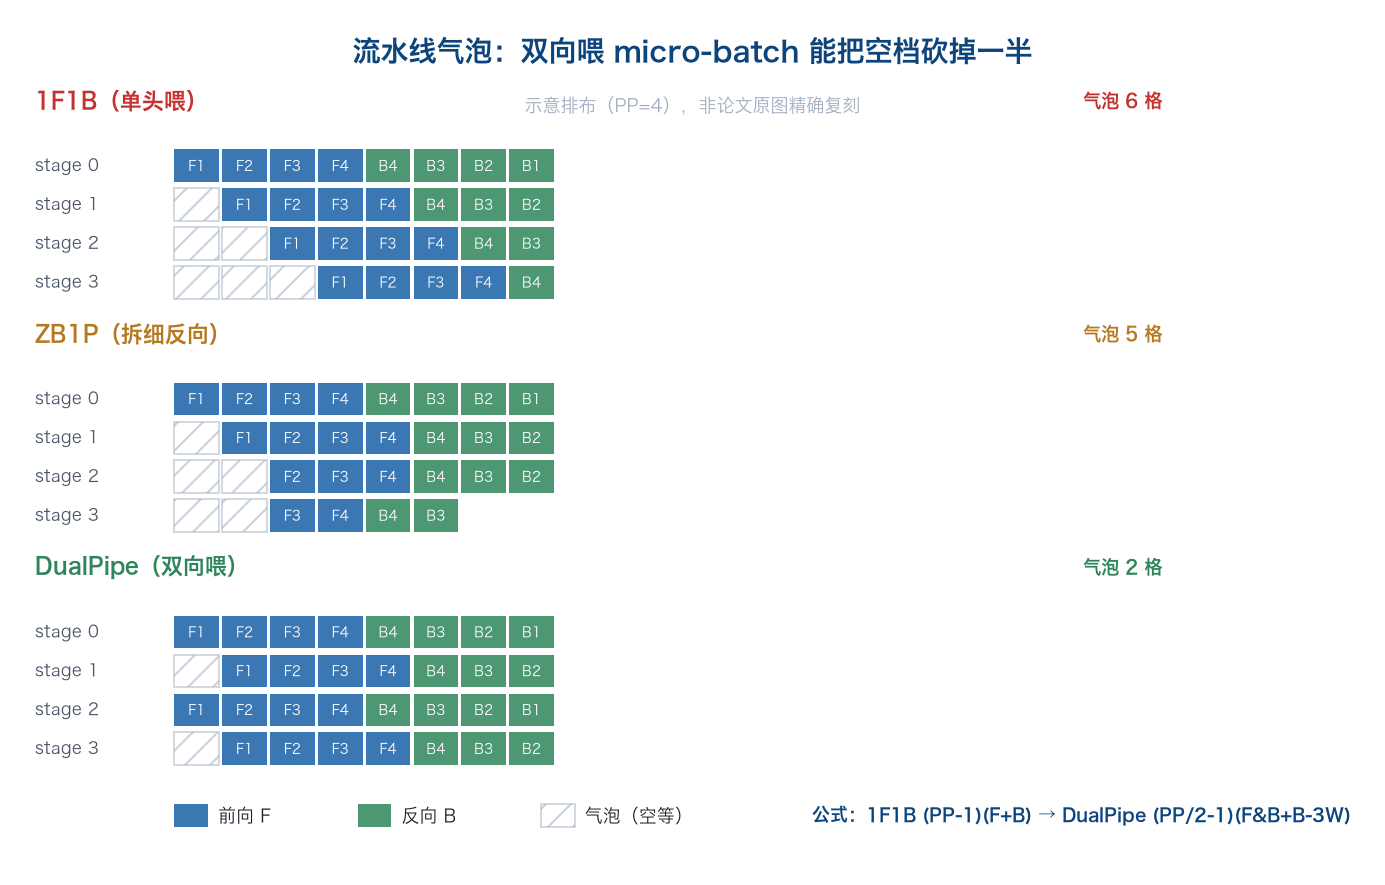 DualPipe 的思路说穿了不复杂:**从两端同时喂 micro-batch**。传统 1F1B 只从一头喂,warmup 阶段全是前向、cooldown 阶段全是反向,这两段没有前向能和反向配对,通信就没法藏。双向喂之后,稳态阶段里前向和反向天然成对,all-to-all 通信可以全程躲在计算的影子里。 它还有个配套狠活:跨节点 all-to-all 通信只用 **20 个 SM** 就把 IB 和 NVLink 带宽打满了。做法是 warp specialization——20 个 SM 分成 10 个通道,IB 发送、IB→NVLink 转发、NVLink 接收各由不同 warp 负责,比例按实际负载动态调(来源:同上,3.2.2 节)。H800 一共 132 个 SM,划 20 个出来做通信,剩下的全留给计算。 ## 五、DeepSeek-V3 的取舍:为什么 TP 和 ZeRO-2/3 都被放弃了 V3 的训练配置是 **PP=16、EP=64(跨 8 个节点)、ZeRO-1 数据并行**,2048 张 H800(来源:arXiv:2412.19437)。这个组合里有两个"反常识"的缺席: **为什么不用 TP?** 因为 TP 的 all-reduce 频率太高(每层两次),而且它要的是超高带宽。DeepSeek 的集群是"节点内 NVLink 快、跨节点 IB 慢"的典型结构(论文里给的是 NVLink 160 GB/s,IB 50 GB/s,差 3.2 倍)。在这种结构上,**稀缺的 IB 带宽必须留给 EP 的 all-to-all**——那是刚需。把宝贵的跨节点带宽分给 TP,EP 就得饿着。 不用 TP 的前提是内存得省得下来。他们做了几件事:RMSNorm 和 MLA 上投影在反向时重算不缓存、embedding 和输出头放在同一个 PP rank 上物理共享(这两招在报告 3.2.3 节)、Adam 的 m/v 用 BF16 存而主权重和梯度留 FP32(3.3.3 节)(来源:arXiv:2412.19437)。省出来的空间刚好够不用 TP。 **为什么不用 ZeRO-2/3?** 同样的道理——ZeRO-2/3 会跟 EP 抢 IB 带宽。ZeRO-1 只切优化器状态,梯度通信的量和 DDP 一样(第一节算过的),省了显存但不额外增加跨节点流量。这是带宽受限集群上的最优解。 > 这点我觉得是整篇报告里最值得学的一课:**并行策略不是挑"最强的那个",是挑"不跟别人抢资源的那个"。** 你在论文里看到的每一个"故意不用 X",背后都是一笔资源冲突账。 还有一个数字很能说明硬件约束:他们限制**每个 token 最多 dispatch 到 4 个节点**。因为 NVLink 比 IB 快 3.2 倍,先走 IB 到目标节点的同号卡,再走 NVLink 转发到具体专家,这样平均每个节点能选 3.2 个专家而不额外增加 NVLink 开销——虽然实际只选 8 个路由专家,理论上最多能扩到 13 个(4 节点 × 3.2)而通信成本不变(来源:同上)。 ## 六、DualPipe 也有罩不住的地方:V4 的 Waved-EP ### 双向喂的罩门 DualPipe 有个前提经常被忽略:**它靠前向和反向配对来藏通信**。这在预训练的大 batch 场景没问题,但到 RL rollout 和推理就露馅了——**推理没有反向,拿什么配对?** 而且就算有反向,DualPipe 的稳态长度取决于 micro-batch 数量 M。RL 和小 batch 场景下 M 很小,warmup 和 cooldown 占比就高,躲在稳态里的通信遮掩效果大打折扣。 ### V4 的解法:把专家切波 V4 的方案(社区习惯叫 Waved-EP,技术报告原文的表述是细粒度 EP + 波次调度,融合内核开源为 MegaMoE)不再依赖 PP 调度,直接在 MoE 层内部解决。把专家切成若干个"波"(wave),一个波里的专家通信一完成,计算立刻开始,不等其他专家。稳态下三件事同时发生:当前波在计算、下一波的 token 在传输、已完成专家的结果在回传(来源:DeepSeek-V4 技术报告,2026-04;相关解读见 jianyuh.github.io 与阿里云开发者社区)。 实测加速比:通用推理场景对比强基线 **1.5-1.73 倍**,RL rollout 等延迟敏感场景 **1.96 倍**(来源:同上,属特定配置下的论文实测值)。  更值得琢磨的是他们顺手给出的一条硬件判据——**通信能不能被计算完全盖住,本质由 C/B(峰值算力 ÷ 互联带宽)决定,而不是靠堆带宽**: ```python # wave_ratio.py —— 你的硬件能不能把 EP 通信完全藏住?纯算术 def need_cb(d): """d: 专家中间层维度; h: 隐藏维度(下面推导里会被约掉) SwiGLU 一个 token-expert pair: gate/up/down 三次投影 = 6*h*d FLOPs 通信: dispatch(FP8, h bytes) + combine(BF16, 2h bytes) = 3h bytes 能完全重叠的条件: C/B 6} FLOPs/Byte " f"→ 每 1 GB/s 互联带宽可隐藏 {n/1000:.1f} TFLOP/s 算力") # 反过来:拿你的硬件实际比值去比 def check(peak_tflops, bw_gbs, mfu, need): actual = peak_tflops * mfu * 1000 / bw_gbs # 换算成 FLOPs/Byte print(f"MFU {mfu:.0%} 时 C/B = {actual:>7.0f} → " f"{'可完全重叠' if actual <= need else '通信藏不住,会成为瓶颈'}") # H100 峰值 BF16 约 989 TFLOPS,DeepSeek-V3 集群跨节点 IB 约 50 GB/s for mfu in [1.0, 0.4, 0.3]: check(989, 50, mfu, need_cb(3072)) ``` 我这边跑出来的: ``` V4-Pro (d=3072) 需 C/B ≤ 6144 FLOPs/Byte → 每 1 GB/s 互联带宽可隐藏 6.1 TFLOP/s 算力 d=2048 需 C/B ≤ 4096 FLOPs/Byte → 每 1 GB/s 互联带宽可隐藏 4.1 TFLOP/s 算力 经典 7B FFN 需 C/B ≤ 22016 FLOPs/Byte → 每 1 GB/s 互联带宽可隐藏 22.0 TFLOP/s 算力 MFU 100% 时 C/B = 19780 → 通信藏不住,会成为瓶颈 MFU 40% 时 C/B = 7912 → 通信藏不住,会成为瓶颈 MFU 30% 时 C/B = 5934 → 可完全重叠 ``` 论文的结论就是第一行:**1 GB/s 的互联带宽足以隐藏 6.1 TFLOP/s 的计算**,所以硬件厂商该瞄准这个平衡点,而不是无脑堆带宽(来源:DeepSeek-V4 技术报告)。 后三行是我自己加的推演,比论文结论更有意思:H100 配 50 GB/s 的 IB,**就算 MFU 只有 40%,通信依然藏不住**;要到 MFU 30% 才刚好压线。反过来说,如果你把 MFU 优化得很好(这是好事),通信反而更容易暴露——这也解释了为什么 DeepSeek 要在通信重叠上做到那种程度。 这组数字我用的是 H100 的标称峰值和 V3 论文里的 IB 带宽,你的卡型和网络不一样,换成自己的规格再跑一遍才有意义。 ## 七、2026 年怎么选:FSDP2、DeepSpeed、Megatron 工具层面,2026 年的格局是这样的: **FSDP2 已是 PyTorch 官方推荐的新代码路径。** API 从包装类改成函数式 `fully_shard`,直接作用在每个 transformer block 上,模块树和参数名保持不变(来源:PyTorch 官方文档与 FSDP1→FSDP2 迁移指南)。多个 2026 年的实践资料都提到 FSDP1 已进入弃用/维护流程,只是不同资料给出的具体版本号略有出入——方向是一致的:**新项目用 `fully_shard`**。 ```python # fsdp2_min.py —— 最小 FSDP2 骨架(torchrun --nproc_per_node=8 fsdp2_min.py) # 注意:MyTransformer 和 batch 是占位,换成你自己的模型和 DataLoader 就能跑 import os, torch, torch.distributed as dist from torch.distributed.device_mesh import init_device_mesh from torch.distributed.fsdp import fully_shard, MixedPrecisionPolicy dist.init_process_group("nccl") local_rank = int(os.environ["LOCAL_RANK"]); torch.cuda.set_device(local_rank) # 1-D mesh = 全分片(ZeRO-3);2-D mesh = 混合分片(节点内切、节点间复制) mesh = init_device_mesh("cuda", (dist.get_world_size(),)) mp = MixedPrecisionPolicy(param_dtype=torch.bfloat16, reduce_dtype=torch.float32) model = MyTransformer().cuda() # ← 换成你的模型 for blk in model.blocks: # 逐 block 切,最后切 root fully_shard(blk, mesh=mesh, mp_policy=mp) fully_shard(model, mesh=mesh, mp_policy=mp) opt = torch.optim.AdamW(model.parameters(), lr=3e-4) GRAD_ACCUM = 2 for step in range(100): opt.zero_grad(set_to_none=True) for micro in range(GRAD_ACCUM): last = micro == GRAD_ACCUM - 1 model.set_requires_gradient_sync(last) # 非最后一步跳过梯度同步 loss = model(batch[micro]) # ← batch 换成你的数据 (loss / GRAD_ACCUM).backward() torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0) # DTensor 原生支持 opt.step() dist.destroy_process_group() ``` PyTorch 官方 TorchTitan 论文给过一组对照数据(arXiv:2410.06511,Llama-7B / 8×H100):同配置下 FSDP2 显存比 FSDP1 约降 7%、吞吐基本持平(约 1.5%);配合 torch.compile 与 float8 训练在 Hopper 上最高可到 50% 吞吐提升(属论文在特定配置下的实测值,请以自己负载为准)。 **DeepSpeed 还剩三张牌**:ZeRO-Infinity 的 NVMe offload(单台 8 卡机器训百亿模型的"穷人方案")、Ulysses 序列并行(超长上下文场景比 Ring Attention 通信量低)、成熟的 MoE 专家并行实现。如果你的场景是"一台机器 + 一个死活塞不下的模型",还得是它。 **Megatron-LM 仍是超大规模预训练的首选**,尤其 TP+PP+EP 的组合能力和 NVIDIA 硬件的深度适配。代价是上手成本高、跟 HuggingFace 生态的桥接要额外折腾。 我的排序习惯是这么定的: | 场景 | 我的第一选择 | 理由 | | ----------------- | ---------------------------------------- | ------------------ | | 8B-70B 单机微调 | FSDP2 全分片 + bf16 + 梯度检查点 + torch.compile | PyTorch 原生,无额外依赖 | | 70B-405B 跨 2-4 节点 | FSDP2 混合分片(节点内切、节点间复制) | 节点间只走梯度,省 IB | | LoRA / QLoRA | FSDP2 | 部分参数冻结处理比 FSDP1 干净 | | 单机塞不下的超大模型 | DeepSpeed ZeRO-Infinity | NVMe offload 路径最成熟 | | 千卡以上预训练 | Megatron-LM(或自研) | 多维并行组合能力最强 | | MoE 训练 | EP + 通信重叠(DeepEP / MegaMoE 一类) | all-to-all 是生死线 | ## 八、上手前先问自己四个问题 配置并行之前,我一般会先把这四个问题过一遍,答案决定策略: 1. **模型状态要多少显存?** 跑第一节脚本,看 DDP 能不能装下。装得下的话,切片带来的通信是纯亏,我的经验是能用复制就先不切片。 2. **激活值要多少?** batch 和序列长度翻一倍,激活也跟着翻。我一般先开梯度检查点,加卡放最后——卡一多通信量跟着涨,反而可能更慢。 3. **单机 NVLink 域有多大?** 8 卡还是 72 卡(NVL72)?TP 组必须待在 NVLink 域内,超了就得换策略。 4. **跨节点带宽多少?** 50 GB/s 的 IB 还是 800 GB/s 的 XDR?这决定了 EP 的 all-to-all 能不能藏住——用第六节的脚本算。 诊断通信有没有藏住,看时间线最直接: ```bash # 抓一段 trace,重点看 all-to-all 是不是有独立的时间段 torchrun --nproc_per_node=8 train.py \ --profiler # 或用 torch.profiler.profile(activities=[ProfilerActivity.CUDA]) # 从 trace 里数通信算子占比(Perfetto 打开后执行 SQL) # SELECT name, SUM(dur)/1e6 AS ms FROM slice # WHERE name LIKE '%all_to_all%' OR name LIKE '%allreduce%' # GROUP BY name ORDER BY ms DESC ``` 我看 trace 只认一件事:**all-to-all 是单独占了一段,还是被计算盖住了**。单独占一段的那几毫秒,就是纯烧掉的钱。