首页 文章 精选 留言 我的

精选列表

搜索[记忆机制],共10000篇文章
优秀的个人博客,低调大师

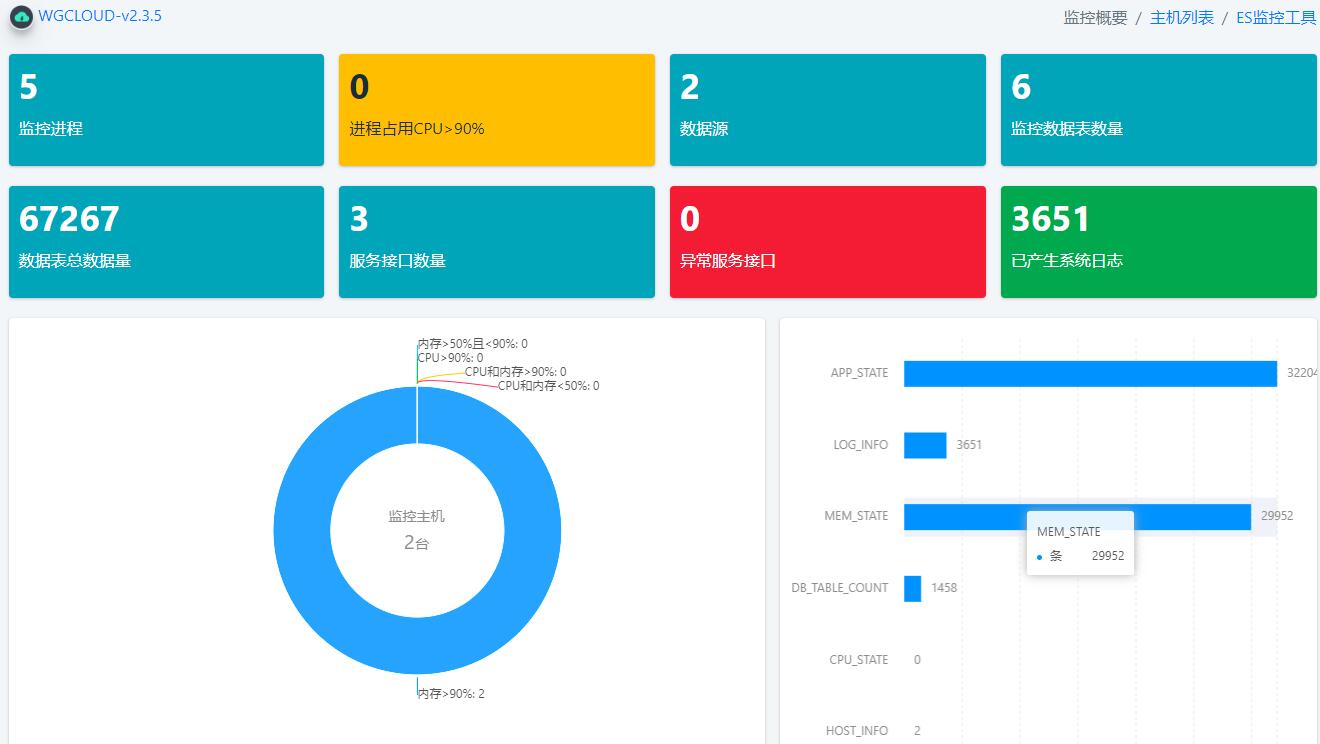
WGCLOUD 监控系统,升级数据扫描机制,提升性能

WGCLOUD基于java语言开发,是微服务架构构建监控系统,支持高并发高性能高可用,核心模块包括:服务器集群监控,ES集群状态监控,CPU监控,内存监控,数据监控(mysql,postgresql,oracle,sqlserver,db2),服务心跳检测,应用进程管理,磁盘IO监控,系统负载监控,监控告警信息推送。 此次更新,新增数据监控间隔时间配置,服务接口监控间隔时间配置,使之更快更灵活。根据个人需求酌情修改扫描时间,时间间隔越短,监控更实时,但是server压力相应会加大,根据服务器配置观察调整。 base: #登陆账号admin的密码 admindPwd: 111111 #通信token,agent端和此保持一致 wgToken: wgcloud #是否开启公众看板,yes开启,no关闭,公众看板页面无需登陆 dashView: yes #数据表监控间隔,单位毫秒,默认60分钟 dbTableTimes: 3600000 #服务接口监控间隔,单位毫秒,默认10分钟 heathTimes: 600000

优秀的个人博客,低调大师

疫情下个人数据安全和工作机制的思考

2019年12月武汉爆发了“新冠”病毒引发的疫情,病毒引起发烧、咳嗽等症状,具备“人传人”可能且暂无特效药,有人因此丢掉生命。正逢中国春节的到来,2020年武汉春运终有500万人离开,“人传人”从而引发疫情蔓延。1月25日中央成立应对疫情工作领导小组,全国各地疫情防控全面展开,我们都坚信在党中央的领导下防疫战役终能取得胜利。 有史以来人员出入最少,社区管理最严的春节与“新冠”疫情同时到来了。大家都能感觉到社区联防工作的效果非常好,各单位的工作协同前所未有的高效,这是必须点赞的,也为祖国上下同心和强大的执行力感到自豪。 我算专业做安全工作的,应该属于最早防控疫情的一拨人。整个春节就没闲着,各种工作和要求都要落实,事关国家安全责无旁贷,防控疫情更是应尽义务。工作了30多天,支持5类以上单位的联控工作配合。正是因为全国各条战线防控人员都在努力,所以全面联控得到了好的成效,疫情新增减少和治愈患者增多。 2月13日中央政治局常委会强调,实事求是做好疫情防控工作。十六字要求中“科学防治、精准施策”是重要内容;不能一关了之、一停了之;基于此和30多天工作情况提两点思考供大家在后续工作中参考。 一是,疫情中的个人数据安全问题。 防疫过程中,相关单位需要大数据来辅助疫情防控工作,不仅在疫情数据、病毒数据分析上有直接作用,还能发现故意隐瞒和可能扩散病毒的人员,所以第一时间掌握大 数据至关重要。疫情数据和病毒数据基本应用在专业机构,分析工作涉及的信息化系统和人员也相对独立或安全级别较高,扩散的可能性较小,做好关机基础设施保护就能有效防护。但还有一部分机关单位、社区防疫工作人员在个人数据采集、使用和传递中缺少必要的保护意识和工作流程,大量 抽调的防控人员接触和使用个人数据更缺少数据安全作业规则。那么涉及全国防疫联控工作中收集使用到 的(姓名、小区、单位、电话、车牌、家庭成员、***号等)众多个人数据, 在疫情中、后期会流失到哪里,会造成什么影响,这点目前还是未知,但未知不代表没有,只是说无法预测影响有多重、有多大。 人民日报公众号2月18日在“武汉病毒研究所陈全姣实名举报所长?发文真相让人不寒而栗”一文中提到,近些年境外反华势力通过非法盗用公民个人信息的黑色产业链,已经从中获取了大量国内公民的个人信息。反华势力非法得到我国公民个人信息还能做什么不言而喻。 公安部历年净网行动有着一个不变的内容就是继续依法严厉打击侵犯公民个人信息。近日公安部网安局也发出战“疫”期间保护公民个人信息要做到6条的要求,尤其对相关单位、物业公司使用个人数据提出警示。 采集个人信息应遵循目的限定原则,合理确定个人信息采集范围,避免采集与疫情防控无关的个人信息; 使用个人信息应严格限定使用范围,为疫情排查收集的个人信息,不用于其他用途; 对信息系统采集的个人信息,应采取访问控制、加密存储和审计等必要措施,确保采集的个人信息,特别是个人敏感信息不被泄露、篡改、损坏; 以纸质填表方式登记个人信息的,应严格管理纸质材料,妥善保管、使用、销毁; 在发生或可能发生个人信息泄露、损失、丢失的情况下,应立即采取补救措施,按照规定及时告知用户并向有关主管部门报告; 不通过信息网络或者其他途径发布个人信息,但经过匿名处理,无法识别被顶个人且不能复原的除外。 那么在疫情防控期间,谁来对个人用户数据的安全负责。这里为大家提供几个参考,或许能说明一些责任和要求。2月4日中央网络安全和信息化委员会办公室发布了“关于做好个人信息保护利用大数据支撑联防联控工作的通知”。这里解读4条: 除国务院卫健部门依法授权部门外,其他机构和个人不得以疫情为由收集个人用户信息(法律要求除外); 收集使用个人信息必需采用最小化原则,一般不得特定区域所有人; 防疫用个人信息不得用作其他用途,因联防工作需脱敏使用; 收集个人信息的机构和个人承担被收集信息的安全责任。最后一条,任何组织和个人发现违法收集、使用个人信息的行为可以向网信、公安部门举报。相关部门可依法打击。 另在下面的法律条文中也能让大家对个人数据安全的法律要求有所了解,有兴趣的可以自行查阅原文。 《中华人民共和国民法总则》 第一百一十一条 自然人的个人信息受法律保护。任何组织和个人需要获取他人个人信息的,应当依法取得并确保信息安全,不得非法收集、使用、加工、传输他人个人信息,不得非法买卖、提供或者公开他人个人信息。 《中华人民共和国刑法》 第二百五十三条之一【侵犯公民个人信息罪】违反国家有关规定,向他人出售或者提供公民个人信息,情节严重的,处三年以下有期徒刑或者拘役,并处或者单处罚金;情节特别严重的,处三年以上七年以下有期徒刑,并处罚金。 《中华人民共和国网络安全法》 第四十一条至第四十五条也对个人信息的收集、使用明确了法律要求和相关权利义务。 那么如何规避和减少这样问题,这应该是第二个思考。总书记说“两难问题多从群众角度想,要把人民的利益放在第一位”。 二是,政治过硬、服务人民、训练有素、底线思维的必备问题 现阶段个别工作能用一个“急”解千愁,一个“紧急”能防万一,而且理由充分,所以可以放低下限、打破原则、再权衡利弊。我们相信如果遇到战争人民军队不会这样,他们一直准备着,时刻保卫祖国;发生火灾消防员不会这样,他们训练有素,有条不紊面对灾难;疫情爆发在武汉的医务人员不会这样,他们政治过硬心系患者,专业技能扎实有效。既然这么紧急的事情发生都能应对,什么情况下需要用“紧急”为理由打破原则。 2014年我国全面推进依法治国,就是要依法执政,依法工作。那么在防疫期间有些单位采用行政手段使用个人数据,对使用个人数据的最小化和必要性原则以及个人知情权;个人数据传递过程中必要的加密或脱敏保护;使用后的个人数据如何删除或存储;适合的法律法规不甚了解或者简单扩大和推导法律解释,这可以说明在需要的情况下,个别人和单位对依法合规还没有充分认知和履行。 上海交大数据法律研究中心执行主任何渊发文说“面对来势汹汹的新型冠状病毒,我们必须把握好政府信息公开及数据开放的法律边界及“颗粒度”,即不得突破“三安全一稳定(国家安全、公共安全、经济安全及社会稳定)”及“二秘密一隐私(国家秘密、商业秘密及个人隐私)”等底线思维”。 其实,各单位都有情况突发的应急预案,预案应该涵盖的不仅有组织机构还应该要求专业事专业人做,不仅有工作流程还应该明确适用法律法规,不仅有责任分工还应该有标准和原则。越是关键时期工作人员政治必须更过硬,为人们服务意识必须更强化、底线思维必须更加坚守,专业人员作用必须充分发挥。这样才能更好的落实总书记说的“两难问题多从群众角度想,要把人民的利益放在第一位”,这样应该可以兼顾和有效防范更多问题的发生。 当然,出现问题不会是一个角度能分析全面,也不是一个措施能解决所有。那么每一次都有改进和完善就会越来越重要,只要坚持下来,相信全面推进依法治国也会更快。

优秀的个人博客,低调大师

图解kubernetes容器探活机制核心实现状态管理

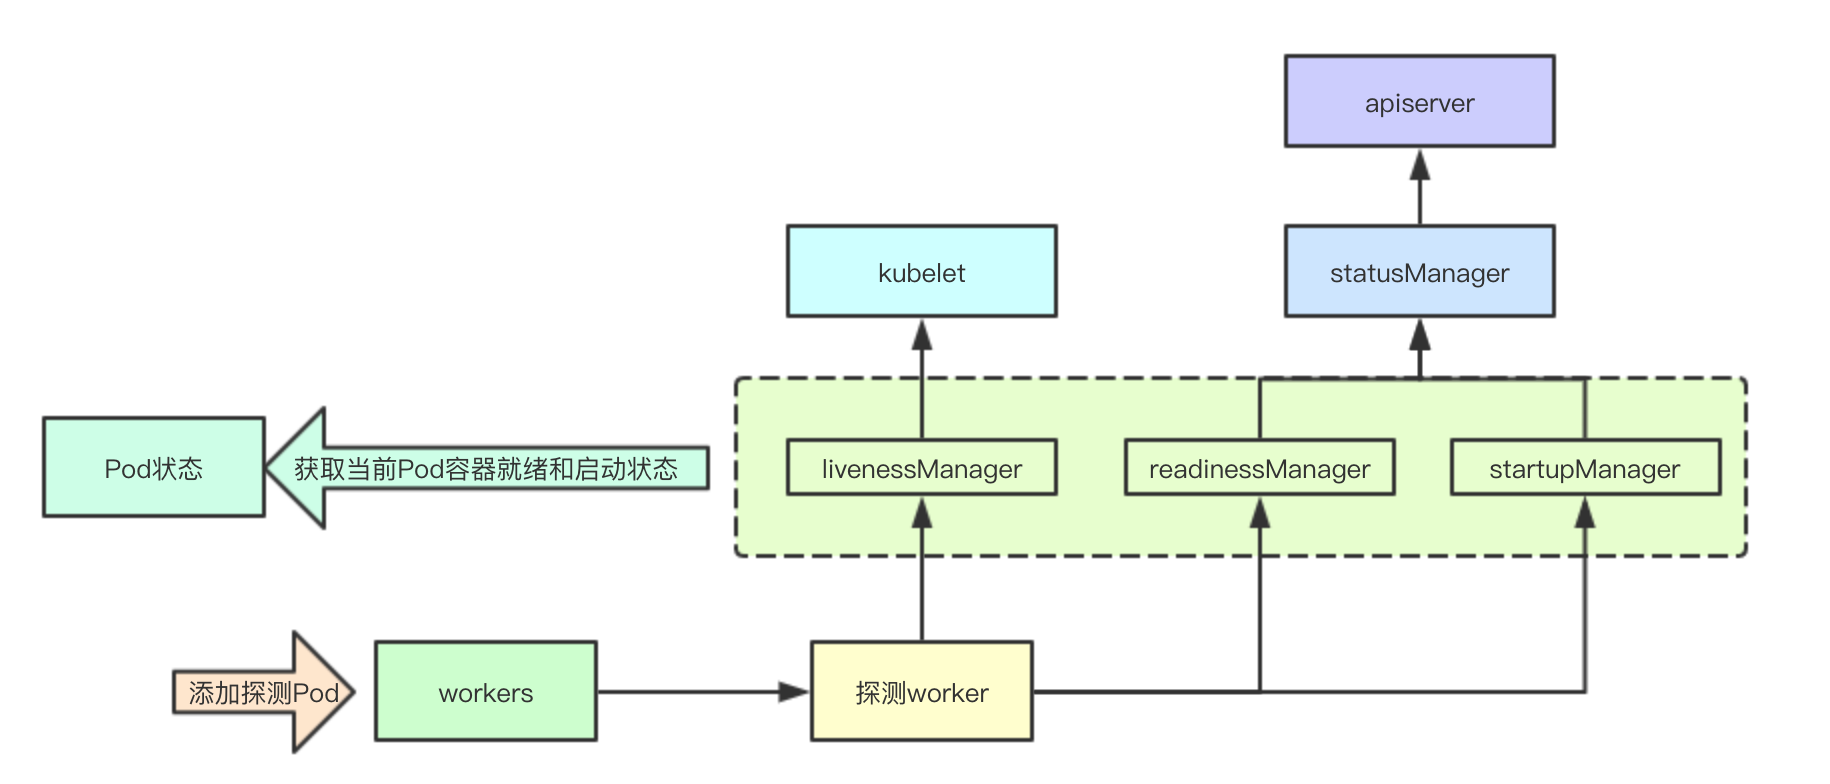
k8s为实现容器探活worker的管理构建了一个Manager组件,该组件负责底层探活worker的管理,并且缓存当前的容器的状态,并对外同步容器的当前状态,今天我们就来分析下其部分核心组件 1. 核心原理实现 Manager缓存的状态主要是会被kubelet、状态组件消费,并且在Pod同步状态的时候,会通过当前Manager里面的探测状态来更新Pod的容器的就绪与启动状态的更新,让我们一起看看Manager自身的一些关键实现吧 2. 探活结果管理 即prober/results/results_manager组件,其主要作用是:存储探测结果和通知探测结果 2.1 核心数据结构 cache负责容器的探测结果的保存,updates则负责对外更新状态的订阅,其通过新的结果和cache中的状态进行对比,从而决定是否对外通知 // Manager implementation. type manager struct { // 保护cache sync.RWMutex // 容器ID->探测结果 cache map[kubecontainer.ContainerID]Result // 更新管道 updates chan Update } 2.2 更新缓存通知事件 更新缓存的时候回通过对比前后状态来进行是否发布变更事件,从而通知到外部订阅容器变更的kubelet核心流程 func (m *manager) Set(id kubecontainer.ContainerID, result Result, pod *v1.Pod) { // 修改内部状态 if m.setInternal(id, result) { // 同步更新事件 m.updates <- Update{id, result, pod.UID} } } 内部状态修改与判断是否进行同步实现 // 如果之前的缓存不存在,或者前后状态不一致则会返回true触发更新 func (m *manager) setInternal(id kubecontainer.ContainerID, result Result) bool { m.Lock() defer m.Unlock() prev, exists := m.cache[id] if !exists || prev != result { m.cache[id] = result return true } return false } 2.3 对外更新管道 func (m *manager) Updates() <-chan Update { return m.updates } 3.探测管理器 探测管理器是指的prober/prober)manager的Manager组件,其负责当前kubelet上面探活组件的管理,并且进行探测状态结果的缓存与同步,并且内部还通过statusManager来进行apiserver状态的同步 3.1 容器探测Key 每个探测Key包含要探测的目标信息:pod的ID、容器名、探测类型 type probeKey struct { podUID types.UID containerName string probeType probeType } 3.2 核心数据结构 statusManager组件在后续章节里面会进行详细分析,说下livenessManager该组件即探活的结果,所以当一个容器探测失败,则会由kubelet本地先进行处理,而readlinessManager和startupManager则需要通过statusManager同步给apiserver进行同步 type manager struct { //探测Key与worker映射 workers map[probeKey]*worker // 读写锁 workerLock sync.RWMutex //statusManager缓存为探测提供pod IP和容器id。 statusManager status.Manager // 存储readiness探测结果 readinessManager results.Manager // 存储liveness探测结果 livenessManager results.Manager // 存储startup探测结果 startupManager results.Manager // 执行探测操作 prober *prober } 3.3 同步startup探测结果 func (m *manager) updateStartup() { // 从管道获取数据进行同步 update := <-m.startupManager.Updates() started := update.Result == results.Success m.statusManager.SetContainerStartup(update.PodUID, update.ContainerID, started) } 3.4 同步readiness探测结果 func (m *manager) updateReadiness() { update := <-m.readinessManager.Updates() ready := update.Result == results.Success m.statusManager.SetContainerReadiness(update.PodUID, update.ContainerID, ready) } 3.5 启动同步探测结果后台任务 func (m *manager) Start() { // Start syncing readiness. go wait.Forever(m.updateReadiness, 0) // Start syncing startup. go wait.Forever(m.updateStartup, 0) } 3.6 添加Pod探测 添加 Pod的时候会遍历Pod的所有容器,并根据探测类型来进行对应探测worker的构建 func (m *manager) AddPod(pod *v1.Pod) { m.workerLock.Lock() defer m.workerLock.Unlock() key := probeKey{podUID: pod.UID} for _, c := range pod.Spec.Containers { key.containerName = c.Name // 针对startupProbe的探测任务的构建 if c.StartupProbe != nil && utilfeature.DefaultFeatureGate.Enabled(features.StartupProbe) { key.probeType = startup if _, ok := m.workers[key]; ok { klog.Errorf("Startup probe already exists! %v - %v", format.Pod(pod), c.Name) return } // 构建新的worker w := newWorker(m, startup, pod, c) m.workers[key] = w go w.run() } // 针对ReadinessProbe的探测任务的构建 if c.ReadinessProbe != nil { key.probeType = readiness if _, ok := m.workers[key]; ok { klog.Errorf("Readiness probe already exists! %v - %v", format.Pod(pod), c.Name) return } w := newWorker(m, readiness, pod, c) m.workers[key] = w go w.run() } // 针对LivenessProbe的探测任务的构建 if c.LivenessProbe != nil { key.probeType = liveness if _, ok := m.workers[key]; ok { klog.Errorf("Liveness probe already exists! %v - %v", format.Pod(pod), c.Name) return } w := newWorker(m, liveness, pod, c) m.workers[key] = w go w.run() } } } 3.7 更新Pod状态 更新Pod状态主要是根据当前Manager里面缓存的之前的状态信息来更新Pod里面对应容器的状态,这些状态是Pod里面容器最新的探测状态,获取这些状态则是检测当前的容器是否已经就绪和启动,为后续更新流程做基础数据 3.7.1 容器状态更新 for i, c := range podStatus.ContainerStatuses { var ready bool // 检测容器状态 if c.State.Running == nil { ready = false } else if result, ok := m.readinessManager.Get(kubecontainer.ParseContainerID(c.ContainerID)); ok { // 检测readinessMnager里面的状态,如果是成功则就是已经就绪 ready = result == results.Success } else { // 检查是否有尚未运行的探测器。只要存在则认为就绪 _, exists := m.getWorker(podUID, c.Name, readiness) ready = !exists } podStatus.ContainerStatuses[i].Ready = ready var started bool if c.State.Running == nil { started = false } else if !utilfeature.DefaultFeatureGate.Enabled(features.StartupProbe) { // 容器正在运行,如果StartupProbe功能被禁用,则假定它已启动 started = true } else if result, ok := m.startupManager.Get(kubecontainer.ParseContainerID(c.ContainerID)); ok { // 如果startupManager里面的状态是成功的则认为是已经启动的 started = result == results.Success } else { // 检查是否有尚未运行的探测器。 _, exists := m.getWorker(podUID, c.Name, startup) started = !exists } podStatus.ContainerStatuses[i].Started = &started } 3.7.2 初始化容器状态更新 针对初始化容器主要容器已经终止并且退出的状态码为0,则认为初始化容器已经就绪 for i, c := range podStatus.InitContainerStatuses { var ready bool if c.State.Terminated != nil && c.State.Terminated.ExitCode == 0 { // 容器状态 ready = true } podStatus.InitContainerStatuses[i].Ready = ready } 3.8 存活状态通知 存活状态通知主要是在kubelet的核心流程循环中进行的,如果检测到容器的状态失败,会立刻进行对应pod的容器状态的同步,从而决定下一步的操作是做什么 case update := <-kl.livenessManager.Updates(): // 如果探测状态失败 if update.Result == proberesults.Failure { // 省略代码 handler.HandlePodSyncs([]*v1.Pod{pod}) } 探活整体的设计大概就是这样,接下来会分期其statusManager组件,即将将探测的状态与apiserver的同步的实现, k8s源码阅读电子书地址: https://www.yuque.com/baxiaoshi/tyado3 > 微信号:baxiaoshi2020 > 关注公告号阅读更多源码分析文章 > 更多文章关注 www.sreguide.com > 本文由博客一文多发平台 OpenWrite 发布


优秀的个人博客,低调大师

Java垃圾回收机制与典型的垃圾回收算法

说到垃圾回收(Garbage Collection,GC),很多人就会自然而然地把它和Java联系起来。在Java中,程序员不需要去关心内存动态分配和垃圾回收的问题,这一切都交给了JVM来处理。顾名思义,垃圾回收就是释放垃圾占用的空间,那么在Java中,什么样的对象会被认定为“垃圾”?那么当一些对象被确定为垃圾之后,采用什么样的策略来进行回收(释放空间)?在目前的商业虚拟机中,有哪些典型的垃圾收集器?下面我们就来逐一探讨这些问题。以下是本文的目录大纲: 一.如何确定某个对象是“垃圾”? 二.典型的垃圾收集算法 三.典型的垃圾收集器 如果有不正之处,希望谅解和批评指正,不胜感激。 请尊重作者劳动成果,转载请标明原文链接: http://www.cnblogs.com/dolphin0520/p/3783345.html 一.如何确定某个对象是“垃圾”? 在这一小节我们先了解一个最基本的问题:如果确定某个对象是“垃圾”?既然垃圾收集器的任务是回收垃圾对象所占的空间供新的对象使用,那么垃圾收集器如何确定某个对象是“垃圾”?—即通过什么方法判断一个对象可以被回收了。 在java中是通过引用来和对象进行关联的,也就是说如果要操作对象,必须通过引用来进行。那么很显然一个简单的办法就是通过引用计数来判断一个对象是否可以被回收。不失一般性,如果一个对象没有任何引用与之关联,则说明该对象基本不太可能在其他地方被使用到,那么这个对象就成为可被回收的对象了。这种方式成为引用计数法。 这种方式的特点是实现简单,而且效率较高,但是它无法解决循环引用的问题,因此在Java中并没有采用这种方式(Python采用的是引用计数法)。看下面这段代码: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 public class Main { public static void main(String[] args) { MyObject object1 = new MyObject(); MyObject object2 = new MyObject(); object1.object = object2; object2.object = object1; object1 = null ; object2 = null ; } } class MyObject{ public Object object = null ; } 最后面两句将object1和object2赋值为null,也就是说object1和object2指向的对象已经不可能再被访问,但是由于它们互相引用对方,导致它们的引用计数都不为0,那么垃圾收集器就永远不会回收它们。 为了解决这个问题,在Java中采取了 可达性分析法。该方法的基本思想是通过一系列的“GC Roots”对象作为起点进行搜索,如果在“GC Roots”和一个对象之间没有可达路径,则称该对象是不可达的,不过要注意的是被判定为不可达的对象不一定就会成为可回收对象。被判定为不可达的对象要成为可回收对象必须至少经历两次标记过程,如果在这两次标记过程中仍然没有逃脱成为可回收对象的可能性,则基本上就真的成为可回收对象了。 至于可达性分析法具体是如何操作的我暂时也没有看得很明白,如果有哪位朋友比较清楚的话请不吝指教。 下面来看个例子: 1 2 3 4 5 6 7 Object aobj = new Object ( ) ; Object bobj = new Object ( ) ; Object cobj = new Object ( ) ; aobj = bobj; aobj = cobj; cobj = null ; aobj = null ; 第几行有可能会使得某个对象成为可回收对象?第7行的代码会导致有对象会成为可回收对象。至于为什么留给读者自己思考。 再看一个例子: 1 2 3 String str = new String( "hello" ); SoftReference<String> sr = new SoftReference<String>( new String( "java" )); WeakReference<String> wr = new WeakReference<String>( new String( "world" )); 这三句哪句会使得String对象成为可回收对象?第2句和第3句,第2句在内存不足的情况下会将String对象判定为可回收对象,第3句无论什么情况下String对象都会被判定为可回收对象。 最后总结一下平常遇到的比较常见的将对象判定为可回收对象的情况: 1)显示地将某个引用赋值为null或者将已经指向某个对象的引用指向新的对象,比如下面的代码: 1 2 3 4 5 Object obj = new Object(); obj = null ; Object obj1 = new Object(); Object obj2 = new Object(); obj1 = obj2; 2)局部引用所指向的对象,比如下面这段代码: 1 2 3 4 5 6 7 8 void fun() { ..... for ( int i= 0 ;i< 10 ;i++) { Object obj = new Object(); System.out.println(obj.getClass()); } } 循环每执行完一次,生成的Object对象都会成为可回收的对象。 3)只有弱引用与其关联的对象,比如: 1 WeakReference<String> wr = new WeakReference<String>( new String( "world" )); 二.典型的垃圾收集算法 在确定了哪些垃圾可以被回收后,垃圾收集器要做的事情就是开始进行垃圾回收,但是这里面涉及到一个问题是:如何高效地进行垃圾回收。由于Java虚拟机规范并没有对如何实现垃圾收集器做出明确的规定,因此各个厂商的虚拟机可以采用不同的方式来实现垃圾收集器,所以在此只讨论几种常见的垃圾收集算法的核心思想。 1.Mark-Sweep(标记-清除)算法 这是最基础的垃圾回收算法,之所以说它是最基础的是因为它最容易实现,思想也是最简单的。标记-清除算法分为两个阶段:标记阶段和清除阶段。标记阶段的任务是标记出所有需要被回收的对象,清除阶段就是回收被标记的对象所占用的空间。具体过程如下图所示: 从图中可以很容易看出标记-清除算法实现起来比较容易,但是有一个比较严重的问题就是容易产生内存碎片,碎片太多可能会导致后续过程中需要为大对象分配空间时无法找到足够的空间而提前触发新的一次垃圾收集动作。 2.Copying(复制)算法 为了解决Mark-Sweep算法的缺陷,Copying算法就被提了出来。它将可用内存按容量划分为大小相等的两块,每次只使用其中的一块。当这一块的内存用完了,就将还存活着的对象复制到另外一块上面,然后再把已使用的内存空间一次清理掉,这样一来就不容易出现内存碎片的问题。具体过程如下图所示: 这种算法虽然实现简单,运行高效且不容易产生内存碎片,但是却对内存空间的使用做出了高昂的代价,因为能够使用的内存缩减到原来的一半。 很显然,Copying算法的效率跟存活对象的数目多少有很大的关系,如果存活对象很多,那么Copying算法的效率将会大大降低。 3.Mark-Compact(标记-整理)算法 为了解决Copying算法的缺陷,充分利用内存空间,提出了Mark-Compact算法。该算法标记阶段和Mark-Sweep一样,但是在完成标记之后,它不是直接清理可回收对象,而是将存活对象都向一端移动,然后清理掉端边界以外的内存。具体过程如下图所示: 4.Generational Collection(分代收集)算法 分代收集算法是目前大部分JVM的垃圾收集器采用的算法。它的核心思想是根据对象存活的生命周期将内存划分为若干个不同的区域。一般情况下将堆区划分为老年代(Tenured Generation)和新生代(Young Generation),老年代的特点是每次垃圾收集时只有少量对象需要被回收,而新生代的特点是每次垃圾回收时都有大量的对象需要被回收,那么就可以根据不同代的特点采取最适合的收集算法。 目前大部分垃圾收集器对于新生代都采取Copying算法,因为新生代中每次垃圾回收都要回收大部分对象,也就是说需要复制的操作次数较少,但是实际中并不是按照1:1的比例来划分新生代的空间的,一般来说是将新生代划分为一块较大的Eden空间和两块较小的Survivor空间,每次使用Eden空间和其中的一块Survivor空间,当进行回收时,将Eden和Survivor中还存活的对象复制到另一块Survivor空间中,然后清理掉Eden和刚才使用过的Survivor空间。 而由于老年代的特点是每次回收都只回收少量对象,一般使用的是Mark-Compact算法。 注意,在堆区之外还有一个代就是永久代(Permanet Generation),它用来存储class类、常量、方法描述等。对永久代的回收主要回收两部分内容:废弃常量和无用的类。 三.典型的垃圾收集器 垃圾收集算法是 内存回收的理论基础,而垃圾收集器就是内存回收的具体实现。下面介绍一下HotSpot(JDK 7)虚拟机提供的几种垃圾收集器,用户可以根据自己的需求组合出各个年代使用的收集器。 1.Serial/Serial Old Serial/Serial Old收集器是最基本最古老的收集器,它是一个单线程收集器,并且在它进行垃圾收集时,必须暂停所有用户线程。Serial收集器是针对新生代的收集器,采用的是Copying算法,Serial Old收集器是针对老年代的收集器,采用的是Mark-Compact算法。它的优点是实现简单高效,但是缺点是会给用户带来停顿。 2.ParNew ParNew收集器是Serial收集器的多线程版本,使用多个线程进行垃圾收集。 3.Parallel Scavenge Parallel Scavenge收集器是一个新生代的多线程收集器(并行收集器),它在回收期间不需要暂停其他用户线程,其采用的是Copying算法,该收集器与前两个收集器有所不同,它主要是为了达到一个可控的吞吐量。 4.Parallel Old Parallel Old是Parallel Scavenge收集器的老年代版本(并行收集器),使用多线程和Mark-Compact算法。 5.CMS CMS(Current Mark Sweep)收集器是一种以获取最短回收停顿时间为目标的收集器,它是一种并发收集器,采用的是Mark-Sweep算法。 6.G1 G1收集器是当今收集器技术发展最前沿的成果,它是一款面向服务端应用的收集器,它能充分利用多CPU、多核环境。因此它是一款并行与并发收集器,并且它能建立可预测的停顿时间模型。 下面补充一下关于内存分配方面的东西: 对象的内存分配,往大方向上讲就是在堆上分配,对象主要分配在新生代的Eden Space和From Space,少数情况下会直接分配在老年代。如果新生代的Eden Space和From Space的空间不足,则会发起一次GC,如果进行了GC之后,Eden Space和From Space能够容纳该对象就放在Eden Space和From Space。在GC的过程中,会将Eden Space和From Space中的存活对象移动到To Space,然后将Eden Space和From Space进行清理。如果在清理的过程中,To Space无法足够来存储某个对象,就会将该对象移动到老年代中。在进行了GC之后,使用的便是Eden space和To Space了,下次GC时会将存活对象复制到From Space,如此反复循环。当对象在Survivor区躲过一次GC的话,其对象年龄便会加1,默认情况下,如果对象年龄达到15岁,就会移动到老年代中。 一般来说,大对象会被直接分配到老年代,所谓的大对象是指需要大量连续存储空间的对象,最常见的一种大对象就是大数组,比如: byte[] data = new byte[4*1024*1024] 这种一般会直接在老年代分配存储空间。 当然分配的规则并不是百分之百固定的,这要取决于当前使用的是哪种垃圾收集器组合和JVM的相关参数。 参考资料: 《深入理解Java虚拟机》 作者: 海子 出处: http://www.cnblogs.com/dolphin0520/ 本博客中未标明转载的文章归作者 海子和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文连接,否则保留追究法律责任的权利。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册