首页 文章 精选 留言 我的

精选列表

搜索[笔记工具],共10000篇文章
优秀的个人博客,低调大师

【swift学习笔记】四.swift使用Alamofire和swiftyJson

Alamofire是AFNetworking的swift版本,功能灰常强大。 github:https://github.com/Alamofire/Alamofire SwiftyJSON是操作json的非常棒的开源库 github:https://github.com/SwiftyJSON/SwiftyJSON 接下来我做一个简单的入门小例子, 我使用cocoaPods来管理依赖,需要在Podfile里添加我们需要的两个库 source 'https://github.com/CocoaPods/Specs.git' platform :ios, '9.0' use_frameworks! target 'AlamofireDemo' do pod 'Alamofire', '~> 3.4' pod 'SwiftyJSON', :git => 'https://github.com/SwiftyJSON/SwiftyJSON.git' end 在terminal里运行 cocoapods会为我们自动生成需要导入的第三方库的信息。 关闭工程打开cocoaPods为我们生成的工程文件,编辑通过后就能导入这两个库了 import Alamofire import SwiftyJSON 因为我们要访问网络,需要在info.plist里开放权限,加入下面的代码 <key>NSAppTransportSecurity</key> <dict> <key>NSAllowsArbitraryLoads</key> <true/> </dict> 接下来就可以用它Alamofire请求网络使用swiftyJson解析Json let currRequest = Alamofire.request(.POST, "http://www.yourweb.com", parameters: ["para1":"aaa", "para2":[0,1,2,3], "para3":NSNull()], encoding: .JSON, headers: ["Content-Type":"application/json"]) currRequest.responseJSON{(responseJson) -> Void in print(responseJson.response?.statusCode) print(responseJson.request) print(responseJson.response) print(responseJson.data) print(responseJson.result) switch responseJson.result { case .Success(let value): print("Value:\(value)") print("------") let swiftyJsonVar = JSON(value) print(swiftyJsonVar) case .Failure(let error): print(error) } } 好了这个简单的例子就写完了,还有一个更方便的方法就是用下边这个库,他是集成了上边说的两个库,有时间你可以玩一下 https://github.com/SwiftyJSON/Alamofire-SwiftyJSON 本文转自lpxxn博客园博客,原文链接:http://www.cnblogs.com/li-peng/p/5558551.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

MongoDB学习笔记(四)--索引 && 性能优化

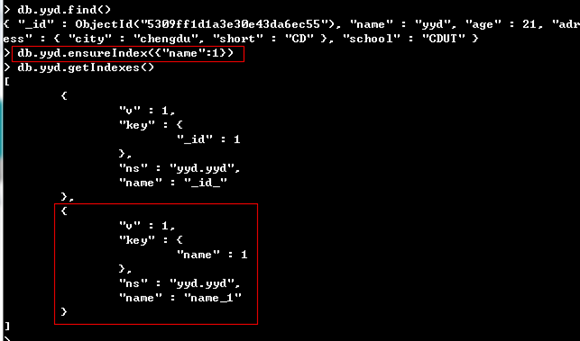
索引 基础索引 用到ensureIndex方法建立索引,1为升序,-1为降序。 MongoDB数据库在创建集合的时候,默认会为_id创建索引。 注:当系统已有大量数据时,创建索引就是一个非常耗时的工作,只需要指定backgroud:true即可。 db.yyd.ensureIndex({"name":1},{"backgroud:true"}) 文档索引 注:下面的查询将不会用到索引,因为查询的顺序与索引建立的顺序不一样。 db.yyd.find({"address":{"short":"CD","city":"chengdu"}}) 组合索引 此时,无论city和short的顺序是前是后,都会用到索引。 删除索引 为了后面方便查看,先把刚才建立的索引删除掉。 唯一索引 这里的唯一索引就像非NoSQL数据库里面的主键一样。如果集合中有重复的值,系统会报错。 强制使用索引 先向里面插入数据,使name和age为索引,当查询的时候用explain()方法来查看查询所用到的索引indexBounds参数。由上图看出,没用到索引。 现在通过hint命令强制使用索引。 索引名称 索引的名称是默认取好了的,一般是“索引_1”这样的,当然也可以自己设置索引的名字。 db.yyd.ensureIndex({"name":1},{"name":"index_name"}) 优化器profiler profiler相当于MySQL中的慢查询日志,但是比慢查询日志更详细。 使用profiler优化器就必须先开启它,在mongoDB中有两种方法控制profiler的开关和级别。 方法一: 在启动服务的时候加上 –profiler 参数,通过这个参数来设置profiler的级别。 方法二: db.setProfilingLevel(level,slowms) 在客户端调用setProfilingLevel()方法。 level为级别,0代表不开启,1代表记录慢命令(默认100ms),3代表记录所有命令。 slowms代表慢命令执行的时间,超过这个时间将写入日志中。 查询profiler日志 db.system.profile.find() show profile 性能优化 创建索引 限定返回结果数 只查询使用到的字段,而不查询所以字段 采用capped集合 采用Server Side Code Execution hint 采用profiling mongosniff底层监控 mongosniff --source NET lo mongostat查看运行中的实例统计信息 mongostat db.serverStatus查看实例运行状态 >db.serverStatus() db.stats查看数据库状态 >db.stats() 本文转自我爱物联网博客园博客,原文链接:http://www.cnblogs.com/yydcdut/p/3563704.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

mapreduce的shuffle机制(来自学习笔记)

3. MAPREDUCE原理篇(2) 3.1 mapreduce的shuffle机制 3.1.1 概述: v mapreduce中,map阶段处理的数据如何传递给reduce阶段,是mapreduce框架中最关键的一个流程,这个流程就叫shuffle; vshuffle: 洗牌、发牌——(核心机制:数据分区,排序,缓存) v具体来说:就是将maptask输出的处理结果数据,分发给reducetask,并在分发的过程中,对数据按key进行了分区和排序; 3.1.2 主要流程: Shuffle缓存流程: shuffle是MR处理流程中的一个过程,它的每一个处理步骤是分散在各个map task和reduce task节点上完成的,整体来看,分为3个操作: 1、分区partition 2、Sort根据key排序 3、Combiner进行局部value的合并 3.1.3 详细流程 1、maptask收集我们的map()方法输出的kv对,放到内存缓冲区中 2、从内存缓冲区不断溢出本地磁盘文件,可能会溢出多个文件 3、多个溢出文件会被合并成大的溢出文件 4、在溢出过程中,及合并的过程中,都要调用partitoner进行分组和针对key进行排序 5、reducetask根据自己的分区号,去各个maptask机器上取相应的结果分区数据 6、reducetask会取到同一个分区的来自不同maptask的结果文件,reducetask会将这些文件再进行合并(归并排序) 7、合并成大文件后,shuffle的过程也就结束了,后面进入reducetask的逻辑运算过程(从文件中取出一个一个的键值对group,调用用户自定义的reduce()方法) Shuffle中的缓冲区大小会影响到mapreduce程序的执行效率,原则上说,缓冲区越大,磁盘io的次数越少,执行速度就越快 缓冲区的大小可以通过参数调整, 参数:io.sort.mb 默认100M 3.1.4 详细流程示意图

优秀的个人博客,低调大师

OpenCV学习笔记(七)—— OpenCV for Android实时图像处理

在上篇中我们已经实现了相机打开和实时图像信息的获取,那么接下来我们可以尝试在获取的图像信息进行一些处理,然后实时显示出来,在这里我们要完成的的几种处理: 灰化、Canny边缘检测、Hist直方图计算、Sobel边缘检测、SEPIA(色调变换)、ZOOM放大镜、PIXELIZE像素化 一、修改布局界面: 由于这里我们需要切换不同的图像处理模式,所以这里我们需要在界面上放置一个按钮,我们可以放置很多个按钮,每个按钮对应一种处理模式,但是这里我们也可以只放置一个按钮,每次点击按钮就切换一次,循环切换模式: activity_main.xml文件: [java] view plain copy print ? <FrameLayout xmlns:android="http://schemas.android.com/apk/res/android" xmlns:tools="http://schemas.android.com/tools" xmlns:opencv="http://schemas.android.com/apk/res-auto" android:layout_width="match_parent" android:layout_height="match_parent"> <org.opencv.android.JavaCameraView android:layout_width="fill_parent" android:layout_height="fill_parent" android:id="@+id/camera_view" opencv:show_fps="true" opencv:camera_id="any"/> <RelativeLayout android:layout_width="fill_parent" android:layout_height="fill_parent" android:gravity="bottom|center_horizontal"> <Button android:id="@+id/deal_btn" android:layout_width="100dp" android:layout_height="40dp" android:layout_marginBottom="20dp" android:text="处理"/> </RelativeLayout> </FrameLayout> 查看预览图: 二、获取按钮组件并监听按钮点击: 1.声明一个Button对象用于绑定上面的按钮组件和一个状态标志位用于存储当前状态: [java] view plain copy print ? //按钮组件 privateButtonmButton; //当前处理状态 privatestaticintCur_State=0; 2.在OnCreate中绑定按钮和按钮点击监听: [java] view plain copy print ? mButton=(Button)findViewById(R.id.deal_btn); mButton.setOnClickListener(newOnClickListener(){ @Override publicvoidonClick(Viewv){ if(Cur_State<8){ //切换状态 Cur_State++; }else{ //恢复初始状态 Cur_State=0; } } }); 这里的状态标志位Cur_State与图像处理的每个类型对应,0对应默认状态,也就是显示原图,1-7分别对应: 灰化、Canny边缘检测、Hist直方图计算、Sobel边缘检测、SEPIA(色调变换)、ZOOM放大镜、PIXELIZE像素化 三、图像信息获取保存、处理和显示: 1.在OpenCV中一般都是使用Mat类型来存储图像等矩阵信息,所以我们可以声明一个Mat对象用来作为实时帧图像的缓存对象: [java] view plain copy print ? //缓存相机每帧输入的数据 privateMatmRgba; 2.对象实例化以及基本属性的设置,包括:长度、宽度和图像类型标志: [java] view plain copy print ? publicvoidonCameraViewStarted(intwidth,intheight){ //TODOAuto-generatedmethodstub mRgba=newMat(height,width,CvType.CV_8UC4); } 3.对象赋值,这里只对原图和灰化两种情况进行了处理,其他的处理后续再添加: [java] view plain copy print ? /** *图像处理都写在此处 */ @Override publicMatonCameraFrame(CvCameraViewFrameinputFrame){ switch(Cur_State){ case1: //灰化处理 Imgproc.cvtColor(inputFrame.gray(),mRgba,Imgproc.COLOR_GRAY2RGBA,4); break; default: //显示原图 mRgba=inputFrame.rgba(); break; } //返回处理后的结果数据 returnmRgba; } 4.由于用对象存储图像数据的话,数据会保存到内存中,所以结束的时候需要进行数据释放,不然可能导致崩溃: [java] view plain copy print ? @Override publicvoidonCameraViewStopped(){ //TODOAuto-generatedmethodstub mRgba.release(); } 5.运行查看效果: 正常模式: 灰化图: 四、其他处理及结果: 在以上的例子中我们已经完成了预览图的灰化处理,那么接下来我们把其他处理都添加到代码中,查看效果。由于在2.x版本中使用到的部分方法已经发生了变化,如:在OpenCV 3.1.0中org.opencv.core.Core类中的方法line和rectangle都已失效,可以用org.opencv.imgproc.Imgproc中的line和rectangle来代替: 1.MainActivity.Java源码: [java] view plain copy print ? packagecom.linsh.opencv_test; importjava.util.Arrays; importorg.opencv.android.BaseLoaderCallback; importorg.opencv.android.CameraBridgeViewBase; importorg.opencv.android.OpenCVLoader; importorg.opencv.android.CameraBridgeViewBase.CvCameraViewFrame; importorg.opencv.android.CameraBridgeViewBase.CvCameraViewListener2; importorg.opencv.android.LoaderCallbackInterface; importorg.opencv.core.Core; importorg.opencv.core.CvType; importorg.opencv.core.Mat; importorg.opencv.core.MatOfFloat; importorg.opencv.core.MatOfInt; importorg.opencv.core.Point; importorg.opencv.core.Scalar; importorg.opencv.core.Size; importorg.opencv.imgproc.Imgproc; importandroid.R.string; importandroid.app.Activity; importandroid.os.Bundle; importandroid.util.Log; importandroid.widget.Button; importandroid.view.View; importandroid.view.View.OnClickListener; publicclassMainActivityextendsActivityimplementsCvCameraViewListener2{ privateStringTAG="OpenCV_Test"; //OpenCV的相机接口 privateCameraBridgeViewBasemCVCamera; //缓存相机每帧输入的数据 privateMatmRgba,mTmp; //按钮组件 privateButtonmButton; //当前处理状态 privatestaticintCur_State=0; privateSizemSize0; privateMatmIntermediateMat; privateMatOfIntmChannels[]; privateMatOfIntmHistSize; privateintmHistSizeNum=25; privateMatmMat0; privatefloat[]mBuff; privateMatOfFloatmRanges; privatePointmP1; privatePointmP2; privateScalarmColorsRGB[]; privateScalarmColorsHue[]; privateScalarmWhilte; privateMatmSepiaKernel; /** *通过OpenCV管理Android服务,异步初始化OpenCV */ BaseLoaderCallbackmLoaderCallback=newBaseLoaderCallback(this){ @Override publicvoidonManagerConnected(intstatus){ switch(status){ caseLoaderCallbackInterface.SUCCESS: Log.i(TAG,"OpenCVloadedsuccessfully"); mCVCamera.enableView(); break; default: break; } } }; @Override protectedvoidonCreate(BundlesavedInstanceState){ super.onCreate(savedInstanceState); setContentView(R.layout.activity_main); mCVCamera=(CameraBridgeViewBase)findViewById(R.id.camera_view); mCVCamera.setCvCameraViewListener(this); mButton=(Button)findViewById(R.id.deal_btn); mButton.setOnClickListener(newOnClickListener(){ @Override publicvoidonClick(Viewv){ if(Cur_State<8){ //切换状态 Cur_State++; }else{ //恢复初始状态 Cur_State=0; } } }); } @Override publicvoidonResume(){ super.onResume(); if(!OpenCVLoader.initDebug()){ Log.d(TAG,"OpenCVlibrarynotfound!"); }else{ Log.d(TAG,"OpenCVlibraryfoundinsidepackage.Usingit!"); mLoaderCallback.onManagerConnected(LoaderCallbackInterface.SUCCESS); } }; @Override publicvoidonDestroy(){ if(mCVCamera!=null){ mCVCamera.disableView(); } }; @Override publicvoidonCameraViewStarted(intwidth,intheight){ //TODOAuto-generatedmethodstub mRgba=newMat(height,width,CvType.CV_8UC4); mTmp=newMat(height,width,CvType.CV_8UC4); mIntermediateMat=newMat(); mSize0=newSize(); mChannels=newMatOfInt[]{newMatOfInt(0),newMatOfInt(1),newMatOfInt(2)}; mBuff=newfloat[mHistSizeNum]; mHistSize=newMatOfInt(mHistSizeNum); mRanges=newMatOfFloat(0f,256f); mMat0=newMat(); mColorsRGB=newScalar[]{newScalar(200,0,0,255),newScalar(0,200,0,255),newScalar(0,0,200,255)}; mColorsHue=newScalar[]{ newScalar(255,0,0,255),newScalar(255,60,0,255),newScalar(255,120,0,255),newScalar(255,180,0,255),newScalar(255,240,0,255), newScalar(215,213,0,255),newScalar(150,255,0,255),newScalar(85,255,0,255),newScalar(20,255,0,255),newScalar(0,255,30,255), newScalar(0,255,85,255),newScalar(0,255,150,255),newScalar(0,255,215,255),newScalar(0,234,255,255),newScalar(0,170,255,255), newScalar(0,120,255,255),newScalar(0,60,255,255),newScalar(0,0,255,255),newScalar(64,0,255,255),newScalar(120,0,255,255), newScalar(180,0,255,255),newScalar(255,0,255,255),newScalar(255,0,215,255),newScalar(255,0,85,255),newScalar(255,0,0,255) }; mWhilte=Scalar.all(255); mP1=newPoint(); mP2=newPoint(); //Fillsepiakernel mSepiaKernel=newMat(4,4,CvType.CV_32F); mSepiaKernel.put(0,0,/*R*/0.189f,0.769f,0.393f,0f); mSepiaKernel.put(1,0,/*G*/0.168f,0.686f,0.349f,0f); mSepiaKernel.put(2,0,/*B*/0.131f,0.534f,0.272f,0f); mSepiaKernel.put(3,0,/*A*/0.000f,0.000f,0.000f,1f); } @Override publicvoidonCameraViewStopped(){ //TODOAuto-generatedmethodstub mRgba.release(); mTmp.release(); } /** *图像处理都写在此处 */ @Override publicMatonCameraFrame(CvCameraViewFrameinputFrame){ mRgba=inputFrame.rgba(); SizesizeRgba=mRgba.size(); introws=(int)sizeRgba.height; intcols=(int)sizeRgba.width; MatrgbaInnerWindow; intleft=cols/8; inttop=rows/8; intwidth=cols*3/4; intheight=rows*3/4; switch(Cur_State){ case1: //灰化处理 Imgproc.cvtColor(inputFrame.gray(),mRgba,Imgproc.COLOR_GRAY2RGBA,4); break; case2: //Canny边缘检测 mRgba=inputFrame.rgba(); Imgproc.Canny(inputFrame.gray(),mTmp,80,100); Imgproc.cvtColor(mTmp,mRgba,Imgproc.COLOR_GRAY2RGBA,4); break; case3: //Hist直方图计算 Mathist=newMat(); intthikness=(int)(sizeRgba.width/(mHistSizeNum+10)/5); if(thikness>5)thikness=5; intoffset=(int)((sizeRgba.width-(5*mHistSizeNum+4*10)*thikness)/2); //RGB for(intc=0;c<3;c++){ Imgproc.calcHist(Arrays.asList(mRgba),mChannels[c],mMat0,hist,mHistSize,mRanges); Core.normalize(hist,hist,sizeRgba.height/2,0,Core.NORM_INF); hist.get(0,0,mBuff); for(inth=0;h<mHistSizeNum;h++){ mP1.x=mP2.x=offset+(c*(mHistSizeNum+10)+h)*thikness; mP1.y=sizeRgba.height-1; mP2.y=mP1.y-2-(int)mBuff[h]; Imgproc.line(mRgba,mP1,mP2,mColorsRGB[c],thikness); } } //ValueandHue Imgproc.cvtColor(mRgba,mTmp,Imgproc.COLOR_RGB2HSV_FULL); //Value Imgproc.calcHist(Arrays.asList(mTmp),mChannels[2],mMat0,hist,mHistSize,mRanges); Core.normalize(hist,hist,sizeRgba.height/2,0,Core.NORM_INF); hist.get(0,0,mBuff); for(inth=0;h<mHistSizeNum;h++){ mP1.x=mP2.x=offset+(3*(mHistSizeNum+10)+h)*thikness; mP1.y=sizeRgba.height-1; mP2.y=mP1.y-2-(int)mBuff[h]; Imgproc.line(mRgba,mP1,mP2,mWhilte,thikness); } break; case4: //Sobel边缘检测 Matgray=inputFrame.gray(); MatgrayInnerWindow=gray.submat(top,top+height,left,left+width); rgbaInnerWindow=mRgba.submat(top,top+height,left,left+width); Imgproc.Sobel(grayInnerWindow,mIntermediateMat,CvType.CV_8U,1,1); Core.convertScaleAbs(mIntermediateMat,mIntermediateMat,10,0); Imgproc.cvtColor(mIntermediateMat,rgbaInnerWindow,Imgproc.COLOR_GRAY2BGRA,4); grayInnerWindow.release(); rgbaInnerWindow.release(); break; case5: //SEPIA(色调变换) rgbaInnerWindow=mRgba.submat(top,top+height,left,left+width); Core.transform(rgbaInnerWindow,rgbaInnerWindow,mSepiaKernel); rgbaInnerWindow.release(); break; case6: //ZOOM放大镜 MatzoomCorner=mRgba.submat(0,rows/2-rows/10,0,cols/2-cols/10); MatmZoomWindow=mRgba.submat(rows/2-9*rows/100,rows/2+9*rows/100,cols/2-9*cols/100,cols/2+9*cols/100); Imgproc.resize(mZoomWindow,zoomCorner,zoomCorner.size()); Sizewsize=mZoomWindow.size(); Imgproc.rectangle(mZoomWindow,newPoint(1,1),newPoint(wsize.width-2,wsize.height-2),newScalar(255,0,0,255),2); zoomCorner.release(); mZoomWindow.release(); break; case7: //PIXELIZE像素化 rgbaInnerWindow=mRgba.submat(top,top+height,left,left+width); Imgproc.resize(rgbaInnerWindow,mIntermediateMat,mSize0,0.1,0.1,Imgproc.INTER_NEAREST); Imgproc.resize(mIntermediateMat,rgbaInnerWindow,rgbaInnerWindow.size(),0.,0.,Imgproc.INTER_NEAREST); rgbaInnerWindow.release(); break; default: //显示原图 mRgba=inputFrame.rgba(); break; } //返回处理后的结果数据 returnmRgba; } } 2.效果图: Canny边缘检测: Hist直方图计算: Sobel边缘检测: SEPIA(色调变换): ZOOM放大镜: PIXELIZE像素化:

优秀的个人博客,低调大师

HBase核心功能模块--读书笔记

客户端Client 客户端 Client 是整个 HBase 系统的入口。使用者直接通过客户端操作 HBase。客户端 使用 HBase 的 RPC 机制与 HMaster 和 RegionServer进行通信。对于管理类操作Client 与 HMaster 进行 RPC 通信对于数据读写类操作Client 与RegionServer 进行 RPC 交互。这里 客户端可以是多个并不限定是原生 Java 接口还有 Thrift、Avro、Rest等客户端模式甚 至 MapReduce 也可以算作一种客户端。 协调服务组件Zookeeper ZooKeeper Quorum队列负责管理 HBase 中多 HMaster 的选举、服务器之间状态同 步等。再具体一些就是HBase 中 ZooKeeper 实例负责的协调工作有存储 HBase 元数据信 息、实时监控 RegionServer、存储所有 Region 的寻址入口当然还有最常见的功能就是保证 HBase 集群中只有一个HMaster 节点 主节点Hmaster HMaster 没有单点问题在HBase 中可以启动多个 HMaster通过ZooKeeper 的 Master 选举机制保证总有一个 Master 正常运行并提供服务其他 HMaster 作为备选时刻准备当目 前 HMaster 出现问题时提供服务。HMaster 主要负责Table 和 Region 的管理工作 管理用户对 Table 的增、删、改、查操作。 管理 RegionServer 的负载均衡调整 Region 分布。 在 Region 分裂后负责新 Region 的分配。 在 RegionServer 死机后负责失效 RegionServer 上的 Region 迁移。 Region 节点 HRegionServer HRegionServer 主要负责响应用户 I/O 请求向 HDFS 文件系统中读写数据是 HBase 中最核心的模块。HRegionServer 内部管理了一系列 HRegion对象每个 HRegion 对应了 Table 中的一个Region。HRegion 由多个HStore 组成每个 HStore 对应了Table 中的一个 Column Family 的存储。可以看出每个 Column Family 其实就是一个集中的存储单元因 此最好将具备共同 I/O 特性的列放在一个 Column Family 中这样能保证读写的高效性。 HStore 存 储 是 HBase 存 储 的 核 心 由 两 部 分 组 成MemStore 和 StoreFile。MemStore是 Sorted Memory Buffer用户写入的数据首先会放入 MemStore 中当 MemStore 满了以后会缓冲flush成一个 StoreFile底层实现是 HFile 当 StoreFile 文件数 量增长到一定阈值会触发 Compact 操作将多个StoreFiles 合并成一个 StoreFile在合并 过程中会进行版本合并和数据删除因此可以看出 HBase 其实只有增加数据所有的更新和 删除操作都是在后续的 Compact 过程中进行的这使得用户的写操作只要进入内存中就可以 立即返回保证了 HBase I/O 的高性能。 StoreFiles 在触发 Compact 操作后会逐步形成越来越大的 StoreFile当单个StoreFile 大小超过一定阈值后会触发 Split 操作同时把当前Region 分裂成 2 个 Region父 Region 会下线新分裂的 2 个子 Region 会被HMaster 分配到相应的 HRegionServer 上使得原先 1 个 Region 的压力得以分流到 2 个 Region 上。 每个 HRegionServer 中都有一个 HLog 对象HLog 是一个实现 Write Ahead Log 的类 在每次用户操作写入 MemStore 的同时也会写一份数据到HLog 文件中HLog 文件定期 会滚动出新并删除旧的文件已持久化到 StoreFile 中的数据 。在 HRegionServer 意外终 止后HMaster 会通过 ZooKeeper 感知到首先处理遗留的 HLog 文件将其中不同 Region 的 Log 数据进行拆分分别放到相应 Region 的目录下然后再将失效的 Region 重新分配 领取到这些 Region 的 HRegionServer 在加载 Region 的过程中会发现有历史 HLog 需要处 理因此会将 HLog 中的数据回放到 MemStore 中然后缓冲flush到 StoreFiles完成数 据恢复。

优秀的个人博客,低调大师

解决configure: error: Popt libraries is required简单报错笔记!

问题: 编译keepalived时报 configure: error: Popt libraries is required 问题原因: 这个错误是因为没有安装popt的开发包导致的 解决方式: 只要yum install popt-devel, 就可以安装好popt的开发包了。 重新./configure 总结:一般编译报错是缺少依赖包或者找不到一些东西,安装指定包或者做相应软链接即可! 注意事项:yum安装比较简单,但是卸载时候要注意依赖环境。编译安装比较灵活,但是麻烦。具体需求个人而定。

优秀的个人博客,低调大师

论文笔记之:Playing Atari with Deep Reinforcement Learning

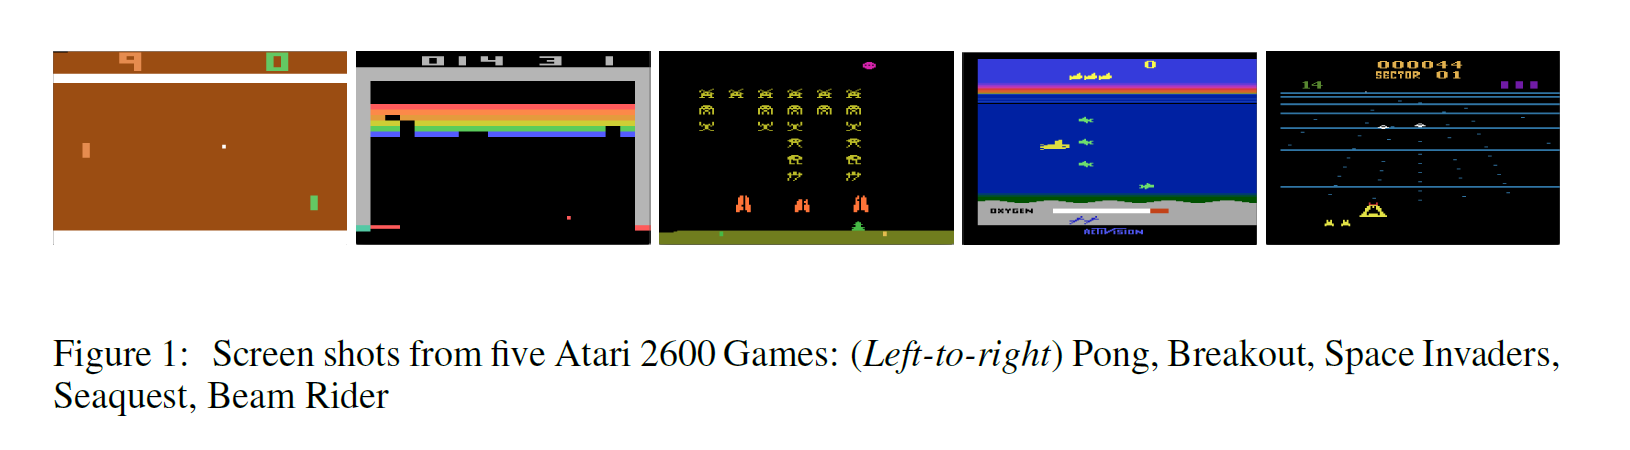
Playing Atari with Deep Reinforcement Learning 《Computer Science》,2013 Abstract: 本文提出了一种深度学习方法,利用强化学习的方法,直接从高维的感知输入中学习控制策略。模型是一个卷积神经网络,利用 Q-learning的一个变种来进行训练,输入是原始像素,输出是预测将来的奖励的 value function。将此方法应用到 Atari 2600 games 上来,进行测试,发现在所有游戏中都比之前的方法有效,甚至在其中3个游戏中超过了一个人类玩家的水平。 Introduction: 从高维感知输入中学习控制agents,像视觉或者speech 是强化学习中一个长期的挑战。大部分成功的涉及到这几个领域的RL 应用都依赖于手工设计的feature 和 线性策略函数或者策略表示的组合。明显,这种系统的性能严重的依赖于特征表示的质量。 最近深度学习的发展,对于从原始感知数据中提取高层feature 称为可能,并且在计算机视觉和语音识别上面取得了很大的进展。这些方法利用神经网络结构,包括 神经网络,多层感知机,RBM 和 RNN,已经涉及到监督学习和非监督学习领域。大家很自然的就会问,是否可以利用相似的技术来解决 RL 中感知数据的问题。 然而, RL 从深度学习的角度,体现了几个挑战: 首先,大部分成功的 深度学习算法都依赖于海量标注的数据, RL 算法,从另一个角度,必须从一个变换的奖励信号中进行学习,而且这种信号还经常是稀疏的,有噪声的,且是延迟的。动作 和 导致的奖励 之间的延迟,可能有几千步那么长,看起来在监督学习中,当直接将输入和目标联系起来非常吓人。 另一个问题是,大部分深度学习算法都假设 data samples 是相互独立的,然而, RL 经常遇到 高度相关的状态。 此外,在 RL 中数据分布随着算法学习到新的行为而改变,这对于深度学习假设固定的潜在分布是有问题的。 这篇文章表明,一个 CNN 可以克服这些挑战,并且在复杂的 RL 环境下从原始视频数据中学习到控制策略。该网络是用变种的 Q-learning 算法训练的,利用 SGD 来更新权重。为了降低相关数据和非静态分布的问题,我们使用了一种 经验重播机制 (experience replay mechanism),该机制随机的采样之前的转换,所以就在许多过去的行为上平滑了训练分布。 Background: 我们考虑到 agent 和 环境交互,即:Atari emulator,是一个动作,观察 和 奖励的序列。在每一个时间步骤,agent 选择一个动作 $a_t$ 从合法的动作集合 $\mathcal{A} = {1, 2, ..., K}$. 该动作被传递到模拟器,然后修改其初始状态和游戏得分。总的来说 环境可能是随机的。模拟器的中间状态, agent 是无法看到的;但是 agent 可以观察到一张图像 xt,由原始像素值构成的表示当前屏幕的向量。此外,他也接收到表示游戏得分的奖励 rt。注意到,总的来说,游戏得分依赖于动作和观察的整个序列;关于一个动作的反馈可能得在几千次时间步骤上才能收到。 由于该 agent 仅仅观察到当前屏幕的图像,所以任务是部分观察到的,许多模拟器状态是感官上有锯齿的,即:仅仅从当前的屏幕,无法完全理解当前的情形。我们所以就考虑 动作和观察的序列, $s_t = x_1, a_1, x_2, ... , a_{t-1}$,然后依赖于这些序列去学习游戏策略。模拟器中的序列都认为会在有限的时间步骤内结束。这就是说在每一个序列,一个large 但是有限的 MDP 是一个清楚的状态。结果,我们采用标准的 RL 方法来处理 MDPs,利用完整的序列 $s_t$ 作为时刻 t 的状态表示。 agent的目标是和模拟器交互,然后选择动作,使得将来的奖励最大化。我们做出假设,即:将来的奖励每一个时间步骤都会打一个折扣 $\gamma$,定义将来的时刻 t 的折扣 return 为: 我们定义一个最优 动作-值函数 $Q^*(s, a)$ 作为采用任何策略后最大期望 return,在看了一些序列 s 然后采取了一些动作 a, $Q^*(s, a) = max_{\pi} E [R_t|s_t = s, a_t = a, \pi]$,其中,$\pi$ 是一个从序列到动作的映射。 最优的动作值函数 服从一个重要的等式,叫做:Bellman equation. 这个基于如下的观察:如果下一个时间步骤的序列 s'的 最优值 Q^*(s', a') 对于所有可能的动作 a' 都是已知的,然后最优策略就是选择动作 a' 使得期望值 $r + \gamma Q^*(s', a')$最大化: 许多强化学习算法背后基本的 idea 是预测 the action-value function,利用 Bellman equation 作为一次迭代更新, $Q_{i+1}(s, a) = E[ r + \gamma_{a'} Q_i(s, a) ]$. 如此 value iteration 算法收敛到一个最优的 动作值函数,$Q_i -> Q^*$。 实际上,这个基础的方法是完全不实用的,因为:动作值函数是对每一个序列分别预测的,而没有任何泛化。(the action-value function is estimated separately for each sequence, without any generalisation.) 相反,实用 function approximator 去预测 action-value function的值确实很常见的,即: $Q(s, a; \theta) = Q^*(s, a)$ 在强化学习领域,这通常是一个线性函数,但是有时候非线性函数估计也用,如:神经网络。我们将带有权重的神经网络函数记为:Q-network。一个Q-network 可以通过一个序列的损失函数 $L_i(\theta_i)$ 最小化来实现每一次迭代 i 的改变。 其中,是第i次迭代的目标,也就是当做 label 来用。当优化损失函数 $L_i(\theta_i)$,前一次迭代的参数固定。注意到,target 依赖于网络的权重,这是和监督学习当中的 target对比而来的,在学习开始之前是固定的。区分开损失函数与对应的权重,我们得到如下的梯度: 不是在上述梯度中,计算全部的期望,比较适合的方法是利用 SGD 的方法来优化损失函数。If the weights are updated after every time-step, and the expectations are replaced by single samples from the behaviour distribution and the emulator, respectively, then we arrive at the familiar Q-learning algorithm. 注意到,该算法是 "model-free"的,即:直接从模拟器中利用采样,解决了 RL 学习任务,而没有显示的构建 estimate。本算法也是“off-policy”的,即:学习贪婪策略 $a = max_a Q(s, a; \theta)$,服从一个行为分布,确保状态空间的足够探索。实际上,行为分布经常被贪婪策略选择,有 1-x 的概率进行探索,以 x 的概率随机选择一个动作。 Deep Reinforcement Learning 最近在计算机视觉和语音识别领域的突破,主要依赖于有效的深度学习在海量训练数据上的学习。最成功的方法是直接从原始输入上进行训练,基于 SGD 进行权重更新。通过喂养深度神经网络足够的数据,通常可以学习到比手工设计特征要好得多的特征表达(feature representation)。这些成功激发了我们在 RL 相关的工作。我们的目标是将 RL 算法和深度神经网络进行联系,也是直接处理 RGB 图像,并且利用 随机梯度更新来有效的处理训练数据。 和 TD-Gammon 以及类似的 online方法相对,我们利用一种称为 experience replay 的技术,我们将 agent 每一个时间步骤的经验存储起来,$e_t = (s_t, a_t, r_t, s_{t+1})$,将许多 episodes 存储进一个 replay memory。在算法内部循环中,我们采用 Q-learning 更新,或者 minibatch updates,来采样 experience,从存储的样本中随机的提取。在执行 experience replay之后,agent 根据贪婪算法,选择并且执行一个动作。由于采用任意长度的 histories 作为神经网络的输入是非常困难的,我们的 Q-function 作用在由函数作用之后,固定长度表示的 histories。算法的全称,我们称为 Deep Q-learning。 该算法与传统的 Q-learning 相比,有以下几个优势: 首先,experience 的每一个步骤都在权重更新上有潜在的应用,可以允许更好的数据效率。 第二,从连续的样本上直接进行学习是 inefficient的,由于样本之间较强的相关性;随机提取这些样本,就打算了他们之间的联系,所以减少了更新的方差。 第三,当学习 on-policy 的时候,当前参数决定了下一个数据样本( when learning on-policy the current parameters determine the next data sample that the parameters are trained on)。例如,如果最大值动作是向左移动,那么训练样本就主要由左侧的样本构成;如果最大化动作是向右移动,然后训练分布也随之改变。It is easy to see how unwanted feedback loops may arise and the parameters could get stuck in a poor local minimum, or even diverge catastrophically. 通过利用 experience replay,行为分布就在之前许多状态上取了平均,使得学习更加平滑,而不至于震荡或者不收敛的情况。 在我们的方法之中,我们的算法仅仅存储最近 N 个 experience tuples,当执行更新的时候,随机的从 D 上均匀的采样。 数据的预处理,就是对输入的图像进行降分辨率等相关处理,使得尽可能的减少计算量。 模型的结构主要是:2层卷积层,后面接2层全连接层,输出是 动作空间,即:所有的可能要采取的动作。 算法的流程如下图所示: 实验部分:

优秀的个人博客,低调大师

Hbase客户端API基础小结笔记(未完)

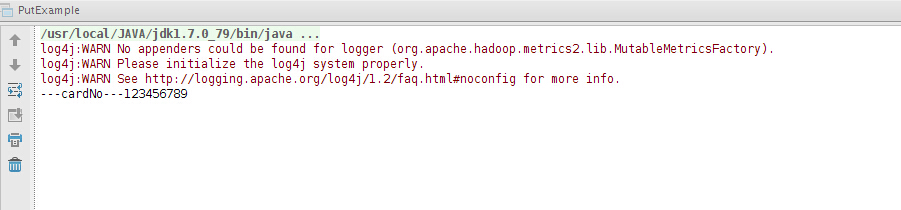
客户端API:基础 HBase的主要客户端接口是由org.apache.hadoop.hbase.client包中的HTable类提供的,通过这个类,用户可以完成向HBase存储和检索数据,以及删除无效数据之类的操作。 通常在正常负载下和常规操作下,客户端读操作不会受到其他修改数据的客户端影响,因为它们之间的冲突可以忽略不计。但是,当允许客户端需要同时修改同一行数据时就会产生问题。所以,用户应当尽量使用批量处理(batch)更新来减少单独操作同一行数据的次数。 (如果是实时系统,则需要加上synchronized关键字) 创建HTable实例是有代价的。每个实例都需要扫描.META表,以检查该表是否存在、是否可用,此外还要执行一些其他操作,这些检查和操作导致实例调用非常耗时,因此推荐用户只创建一次HTable实例(就好比在Hadoop的setup中创建一次实例,供后续mapreduce调用,最终在cleanup中close) 向HBase插入数据的example: package HBaseTest; import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.hbase.HBaseConfiguration; import org.apache.hadoop.hbase.client.Get; import org.apache.hadoop.hbase.client.HTable; import org.apache.hadoop.hbase.client.Put; import org.apache.hadoop.hbase.client.Result; import org.apache.hadoop.hbase.util.Bytes; import java.io.IOException; /** * Created by root on 5/27/16. */ public class PutExample { public static void main(String[] args){ //加载配置文件 Configuration conf = HBaseConfiguration.create(); HTable table = null; try { //创建HTable对象 table = new HTable(conf,"practice"); //设置rowkey Put put = new Put(Bytes.toBytes("rowKeyNum1")); //设置要写入的列族,列与value put.add(Bytes.toBytes("f1"),Bytes.toBytes("cardNo"),Bytes.toBytes("123456789")); table.put(put); //获取rowkey Get result = new Get("rowKeyNum1".getBytes()); //将获取到的值放入Hbase的Result中 Result rs = table.get(result); //获取指定列族的列的value String cardNo = Bytes.toString(rs.getValue("f1".getBytes(),"cardNo".getBytes())); System.out.println("---cardNo---" + cardNo); } catch (IOException e) { e.printStackTrace(); } } } 数据和坐标都是以Java的byte[]形式存储的,即以字节数组的形式存储的。使用这种底层存储类型的目的是 ,允许存储任意类型的数据,并且可以有效地只存储所需的字节,这保证了最少的内部数据结构开销。另一个原因是,每一个字节数组都有一个offerset参数和一个length参数,它们允许用户提交一个已存在的字节数组,并进行效率很高的字节级别的操作。 客户端的写缓冲区 每一个put操作实际上都是一个RPC操作,它将客户端数据传送到服务器然后返回。这只适合小数据量的操作,如果有个应用程序需要每秒存储上千行数据到HBase表中,这样的处理就不太合适了。(一般情况下,在LAN网络中大概要花1毫秒的时间,这意味着1秒钟的时间内只能完成1000次RPC往返响应。) HBase的API配备了一个客户端的写缓冲区(write buffer),缓冲区负责收集put操作,然后调用RPC操作一次性将put送往服务器。(默认情况下,客户端缓冲区是禁用的,可以通过将自动刷写autoflush设置为false来激活缓冲区) HTable table = new HTable(conf,"practice"); table.setAutoFlush(false); 客户端写缓冲区的大小默认是2MB,如果需要存储较大的数据,为了避免每次创建实例都要修改缓冲区大小,可以在hbase-site.xml配置文件中添加一个较大的预设值。 <property> <name>hbase.client.write.buffer</name> <value>20971520</value> </property> 这会将缓冲区大小增肌到20MB,大小可以根据数据量等参考设置。 强制刷写数据可以调用table.flushCommits();直接产生一个RPC请求。 注意: 客户端缓冲区是一个简单的保存在客户端进程内存中的列表,用户需要注意不能在运行时终止程序,如果发生这种情况,哪些尚未被刷写的数据就会丢失,服务器将无法收到数据,因此这些数据没有任何副本可以用来做数据恢复。 另外注意,一个更大的缓冲区需要客户端和服务器端消耗更多的内存,因此服务器端也需要先将数据写入到服务器端消耗更多的内存,因为服务器端也需要先将数据写入到服务器的写缓冲区中,然后再处理它,估算服务器端内存的占用可使用hbase.client.write.buffer 乘以 hbase.regionserver.handle.count 乘以region服务器的数量。 如果用户只存储大单元格,客户端缓冲区的作用就不大了,因为传输时间占用了大部分的请求时间。 参考:《HBase权威指南》

优秀的个人博客,低调大师

挑灯熬夜看《Build 2015 Keynote》图文笔记

又是一年微软Build大会时间,网络上流传各种微软新品发布的消息终于也要揭晓了,一直熬夜到凌晨3点,好久没有这么兴奋了。 微软给力的很嘛! Satya nadella开始讲解 首先回顾微软的传统和技术氛围,Paul Allen的一段BASIC代码揭示微软对技术的专注和热爱,以此来表明微软对Build大会的定义,接下来表明本次Build大会的主题——开发,平台和生态 正餐之前是小点,首先请上来一个德国小伙David William,StarffPad的联合创始人,现场演示他们的应用在Surface上使用触摸笔做谱并演奏,很酷的操作,很快的五线谱识别,中间一度被各种Twitter刷屏,各种High。 会议进程将从微软最赚钱的两个部分——Azure云和Office开始阐述,接着会介绍Window相关的更新。 首先端上菜是云,Scott Guthrie开始介绍Azure云相关的更新,一系列的数据展示,嗯,Azure已经比Amazon和Google强了。 Azure继续更新.NET开源,提升对Docker的支持,通过.NET CORE可以轻松部署应用到Linux Docker容器中 现场演示开发一个ASP.NET 5应用并部署到不同的Docker容器中,其中一个非常酷的功能是,VS开启了强大的Linux容器的调试功能,嗯,妈妈再也不担心我的代码了! Scott回来继续介绍云的提升,刚刚更名的Azure App Service中更新最多,增加了很多数据连接和工作流相关的应用,其中强调了一下混合应用部署的解决方案,使得更容易的连接到重要的已有数据应用中,比如实例中多次提到Saleforce。 漏出来一个Visual Studio Code,一个全平台支持的代码编辑器,关键也是免费的。 在演示Mac OS X版的时候,窗口从最小化缓慢展开,酷炫的缓慢动画,底下果断一片掌声,果然高级黑啊。 Sql Data Warehouse,有一个强大的数据集成中心,AWS不小心躺枪了,呵呵 接下来,转向Office 还是集成,然后看到了Office 2016,示例Excel集成SAP应用 还有Uber,直接在Outlook中 然后是Windows的消息,Satya Nadella小小的调侃了一下——我知道你们等很久了! 然后Terry Myerson登台介绍Window 10的近况,微软的计划和销售目标,重点在强调开发者生态。 重用web,开速开发universal apps .NET和Win32应用也可以放到Windows Store上了 内置支持Android子系统,支持重用Android代码和应用 支持在Windows上编译Objective-C,在Windows上运行 免费赠送HP Spectre 360 Joe介绍桌面Win10系统的最近更新,主要还是菜单 接下来是锁屏界面,随着时间变化会自动更新图片和变化 Cortona,在桌面执行各种应用 新浏览器,定妆名称Microsoft Edge 支持标准HTML+JS开发扩展 最后是Continuim功能,就是Windows Phone插上屏幕,作为桌面用 HoloGraph和HoloLens,很强大的虚拟增强,号称沉浸式与虚拟世界交互。 物联网(IoT)结合的例子 最后是一组妹子倾情演奏。 一看表,都凌晨3点多了,赶紧激动的睡,明天还得写ComponentOne的代码呢。

优秀的个人博客,低调大师

SSLClient 工具

import org.apache.http.conn.ClientConnectionManager; import org.apache.http.conn.scheme.Scheme; import org.apache.http.conn.scheme.SchemeRegistry; import org.apache.http.conn.ssl.SSLSocketFactory; import org.apache.http.impl.client.DefaultHttpClient; import javax.net.ssl.SSLContext; import javax.net.ssl.TrustManager; import javax.net.ssl.X509TrustManager; import java.security.cert.CertificateException; import java.security.cert.X509Certificate; /** * 〈一句话功能简述〉<br> * 〈避免需要证书用于进行Https请求的HttpClient 〉 * * @author zhoumoxuan * @create 9/14/18 * @since 1.0.0 */ public class SSLClient extends DefaultHttpClient { public SSLClient() throws Exception { super(); SSLContext ctx = SSLContext.getInstance("TLS"); X509TrustManager tm = new X509TrustManager() { @Override public void checkClientTrusted(X509Certificate[] chain, String authType) throws CertificateException { } @Override public void checkServerTrusted(X509Certificate[] chain, String authType) throws CertificateException { } @Override public X509Certificate[] getAcceptedIssuers() { return null; } }; ctx.init(null, new TrustManager[]{tm}, null); SSLSocketFactory ssf = new SSLSocketFactory(ctx, SSLSocketFactory.ALLOW_ALL_HOSTNAME_VERIFIER); ClientConnectionManager ccm = this.getConnectionManager(); SchemeRegistry sr = ccm.getSchemeRegistry(); sr.register(new Scheme("https", 443, ssf)); } }

优秀的个人博客,低调大师

Python工具

PyEnv python -V --> 显示版本 pyenv install --list --> 列出所有可以安装的包 pyenv versions --> 显示所有的版本 pyenv version --> 显示当前的版本 pyenv install versionId --> 安装 pyenv install versionId -v --> 采用缓存的方式安装 pyenv local 3.6.2 --> 在当期目录创建一个.python-version, 执行pyenv local 自动读取当前目录下的该文件修改PATH变量, 但是这种方式不是基于虚拟环境的, 没有实现隔离 pyenv virtualenv versionId envName --> 创建一个独立的虚拟环境(对PATH做了手脚, 还在工作目录~/.pyenv/versions/对应的versionId目录下创建了名为envName的目录, 虚拟环境独立提供了binary执行文件和site-packages目录) pyevn active envName --> 求换python版本(python的虚拟环境, 修理了PATH) pyenv deactive --> 退出当前虚拟化境 建议对于不同目的的project创建不同的python虚拟环境, 爬虫创建web(有flask等包), 数据分析创建datanalysis(有numpy等包) pyenv uninstall vir --> 删除虚拟化境 更改pip源 cd mkdir .pip cd .pip vim pip.conf [global] trusted-host = mirrors.aliyun.com index-url = http://mirrors.aliyun.com/pypi/simple pip freeze > /tmp/packages.list --> 导出所有已经安装的Python包 pip install -r /tmp/packages.list --> 安装所有在packages.list中的包 jupyter notebookp配置 jupyter notebook --generate-config jupyter notebook password jupyter notebook --ip 0.0.0.0 --no-browser

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册