首页 文章 精选 留言 我的

精选列表

搜索[WebGL崩溃],共6152篇文章
优秀的个人博客,低调大师

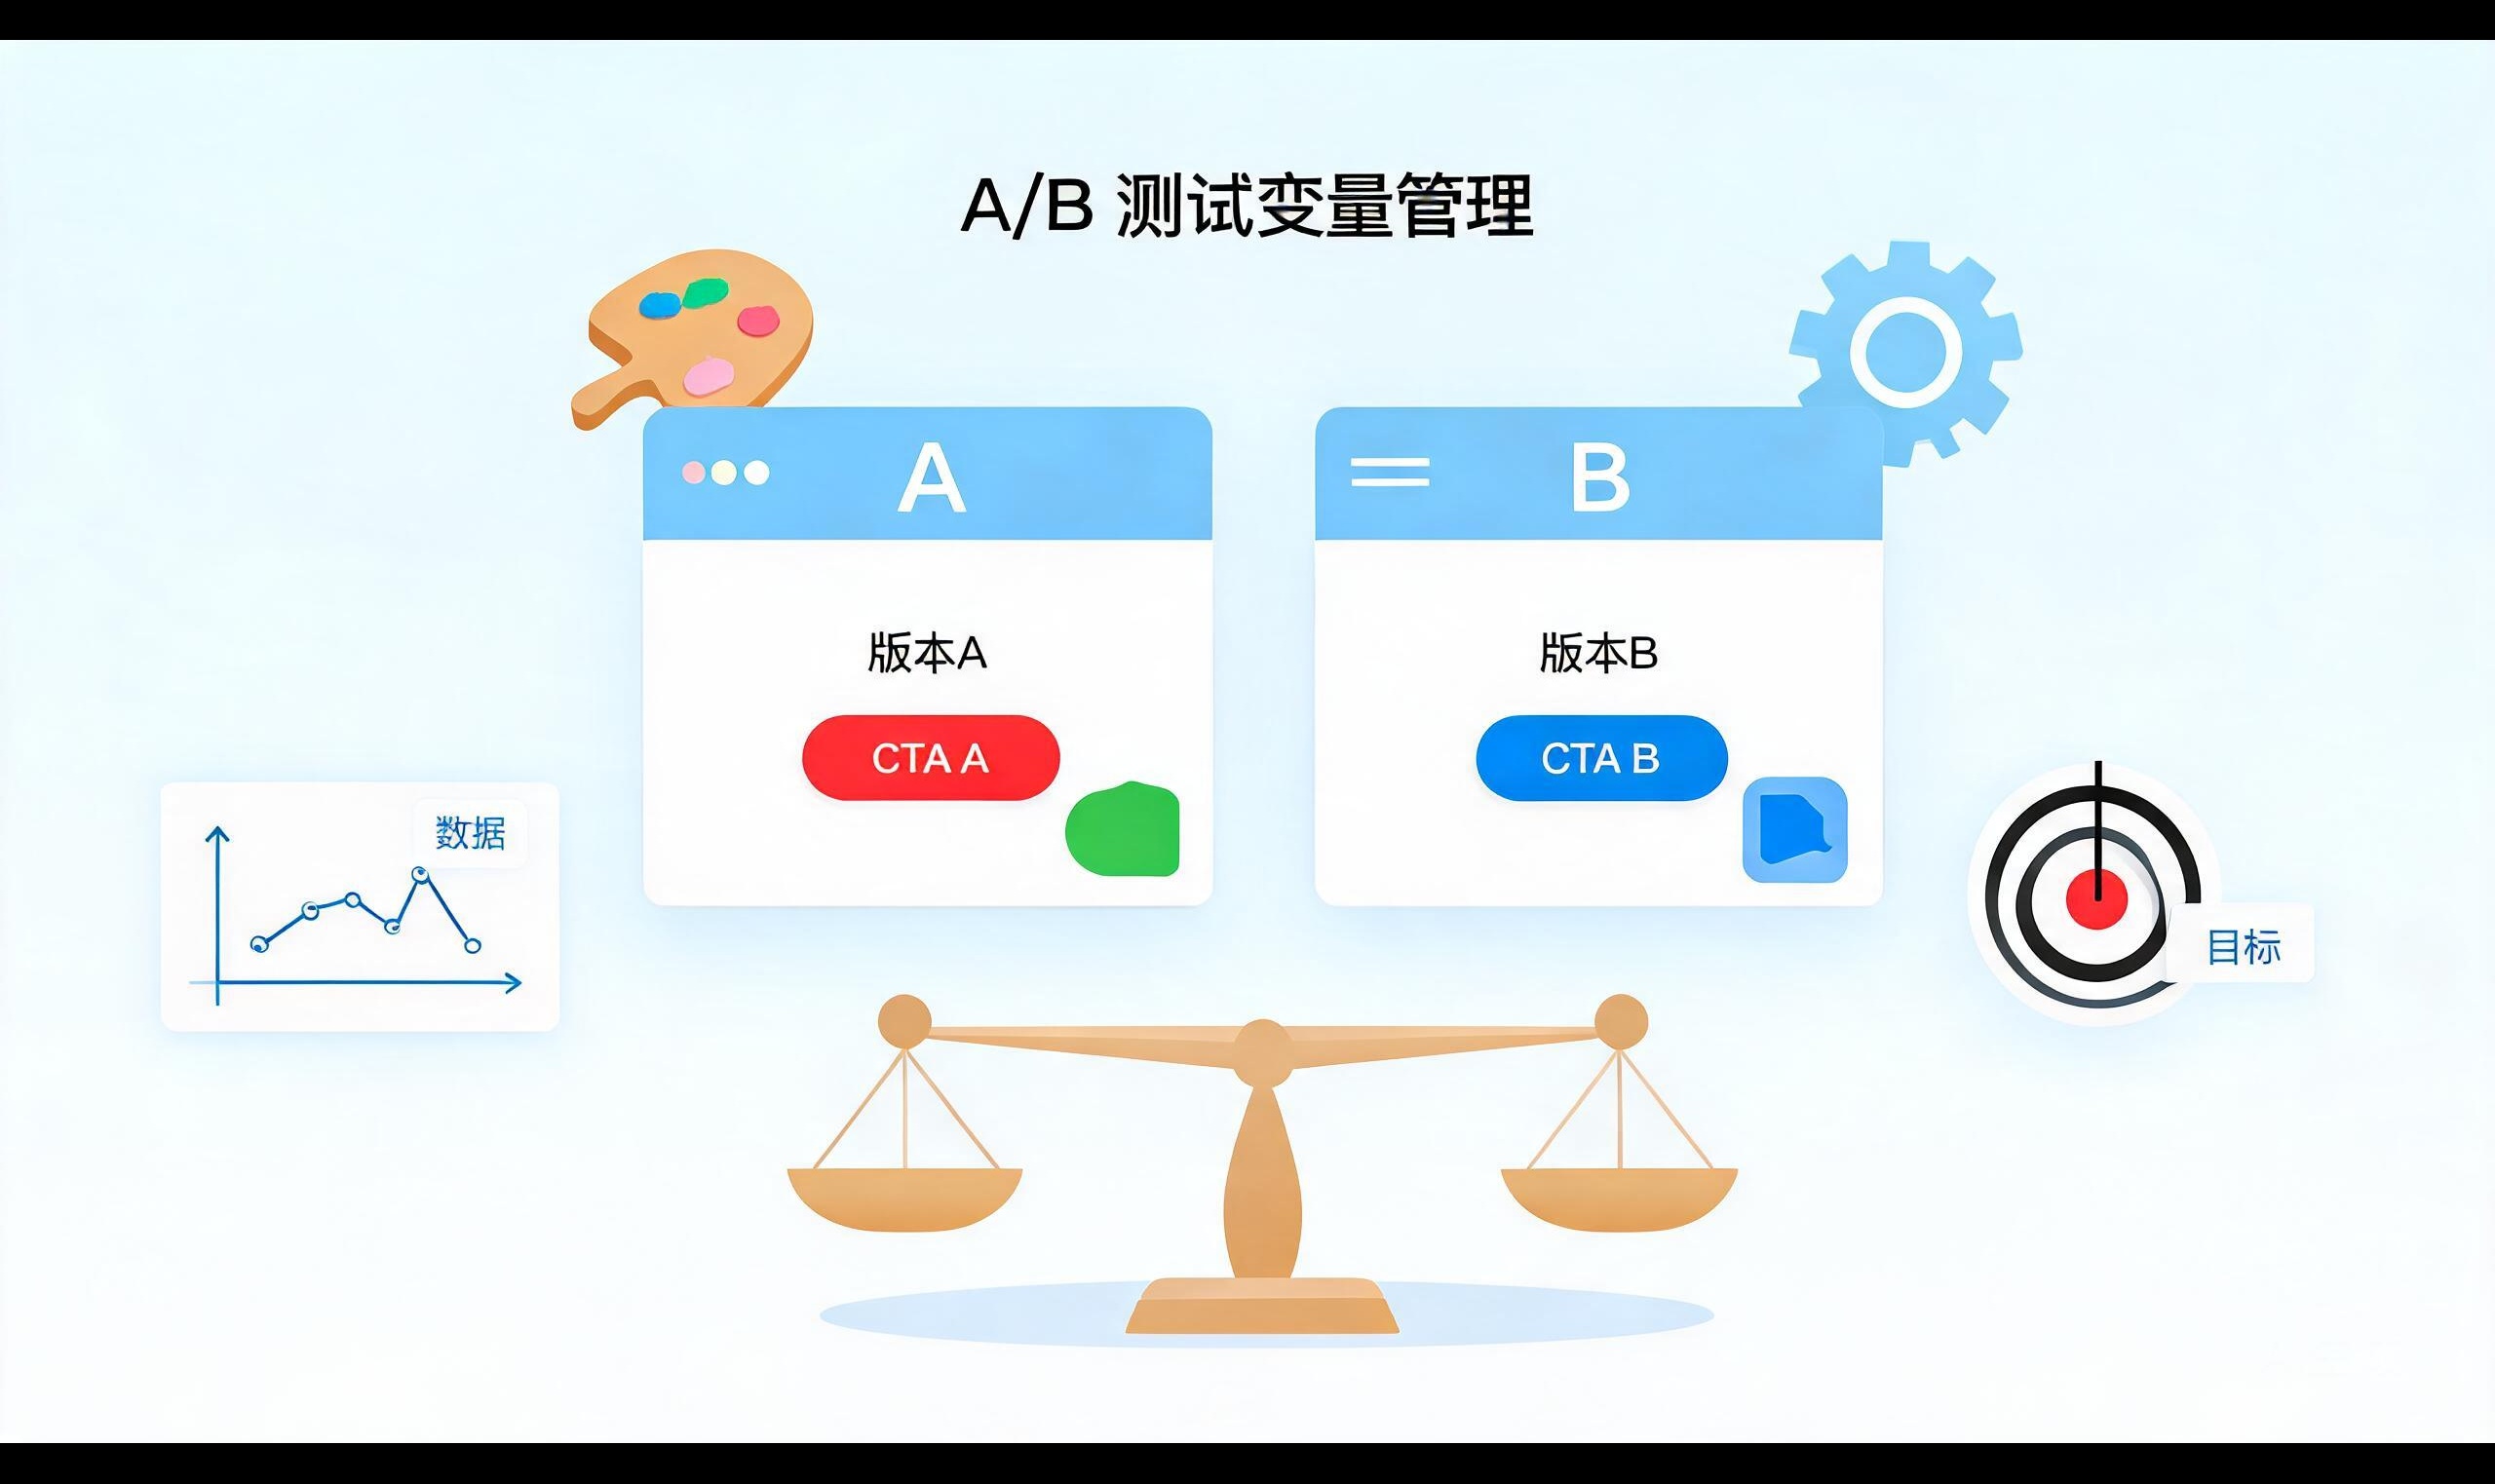
从Canvas到WebGL:指纹浏览器在A/B测试中的变量隔离原理

做过Facebook、Google广告投放的朋友大概率都遇到过这样的问题:你同时跑着十几组A/B测试,每组测试变量不同——有的测创意素材,有的测落地页版本,有的测受众定向。为了保证测试数据的纯净度,你需要每个测试账户都有独立的浏览器环境、独立的IP、甚至独立的设备指纹。可一旦测试数量上来了,光是管理这些环境就让人头大:指纹参数配置错一个、IP串了一条,整个测试的数据就废了。更麻烦的是,有些平台对多账户检测越来越严,稍有不慎几个测试号一起出问题,几天的测试预算全打了水漂。

优秀的个人博客,低调大师

爬虫老崩溃咋整 ?retrying模块了解一下!

retrying模块的学习 我们在写爬虫的过程中,经常遇到爬取失败的情况,这个时候我们一般会通过try块去进行重试,但是每次都写那么一堆try块,真的是太麻烦,所以今天就来说一个比较pythonic的模块,retrying. 安装 retring模块的安装很简单直接用匹配安装即可。 pipinstallretrying 使用 retring模块通过装饰器的形式来进行重试操作的,首先我们看一个简单的例子 fromretryingimportretry@retry(stop_max_attempt_number=5,wait_random_min=1000,wait_random_max=5000)defrun(): print("开始重试") raiseNameErrorif__name__=='__main__': run() 上面的代码干了哪些事呢,首先导入retring的retry模块 然后装饰一个run函数,然后调用run,函数内容很简单就是通过raise抛出一个异常,执行该代码我们发现。程序打印了五次开始重试,最后一次抛出异常,NameError。 到这里我们可以感受到重试了,就是这么简单的代码,就完成了五次重试,同时这五次重试的间隔时间也是不同的。 如果想尝试10次就把上面的stop_max_attempt_number=5,改成10即可,到这里就可以解释retry装饰器的参数了 stop_max_attempt_number:最大重试次数,超过这个次数会停止重试,并报异常。 wait_random_min:随机等待最小时间。 wait_random_max:随机等待最大时间。 好了retry的使用就是这么简单,在需要重试的函数上面加个装饰器就好了。 关键是装饰器里的参数的使用,下面列举了retrying的参数。 如果不写参数将会一直重试. stop_max_attempt_number:在停止之前尝试的最大次数,最后一次如果还是有异常则会抛出异常,停止运行,默认为5次 @retry(stop_max_attempt_number=5)defrun(): print("开始重试") raiseNameErrorif__name__=='__main__': run() 强调总次数。stop_max_delay:最大延迟时间,大概意思就是:如果调用的函数出现异常,那么就会重复调用这个函数,最大调用时间,默认为100毫秒 fromretryingimportretry@retry(stop_max_delay=5000)defrun(): print("开始重试") raiseNameErrorif__name__=='__main__': run() 会重试5秒钟,强调总时间。wait_fixed:两次调用方法期间停留时长, 如果出现异常则会一直重复调用,默认 1000毫秒 fromretryingimportretry@retry(wait_fixed=2000)defrun(): print("开始重试") raiseNameErrorif__name__=='__main__': run() 强调间隔时间。wait_random_min:在两次调用方法停留时长,停留最短时间,默认为0 wait_random_max:在两次调用方法停留时长,停留最长时间,默认为1000毫秒 wait_incrementing_increment:每调用一次则会增加的时长,默认 100毫秒 wait_exponential_multiplier和wait_exponential_max:以指数的形式产生两次retrying之间的停留时间,产生的值为2^previous_attempt_number * wait_exponential_multiplier,previous_attempt_number是前面已经retry的次数,如果产生的这个值超过了wait_exponential_max的大小,那么之后两个retrying之间的停留值都为wait_exponential_max retry_on_exception: 指定一个函数,如果此函数返回指定异常,则会重试,如果不是指定的异常则会退出 fromretryingimportretrydefrun2(exception): returnisinstance(exception,ZeroDivisionError)@retry(retry_on_exception=run2)defrun(): print("开始重试") a=1/0if__name__=='__main__': run() retry_on_result:指定一个函数,如果指定的函数返回True,则重试,否则抛出异常退出 fromretryingimportretrydefrun2(r): returnisinstance(r,int)@retry(retry_on_result=run2)defrun(): print("开始重试") a=1 returnaif__name__=='__main__': run() wrap_exception:参数设置为True/False,如果指定的异常类型,包裹在RetryError中,会看到RetryError和程序抛的Exception error stop_func: 每次抛出异常时都会执行的函数,如果和stop_max_delay、stop_max_attempt_number配合使用,则后两者会失效 指定的stop_func会有两个参数:attempts, delay wait_func:和stop_func用法差不多,不多描述 看不懂的小伙伴儿可以留言。

优秀的个人博客,低调大师

业务集群崩溃迷雾重重!麒麟软件 48 小时绝地破局

2026年某天深夜,某金融客户业务系统集群突发重大故障,部分业务中断。面对多层技术栈耦合、故障表象高度迷惑的复杂现场,麒麟软件凭借标准化排查方法论、全链路技术研判能力与7×24小时极速响应能力,48小时精准破局、稳控风险、恢复业务,成功帮客户规避重大业务风险。 一、高危故障突发!极端场景考验硬实力 凌晨0点27分,“麒心优服”值班人员接到紧急电话,某金融用户紧急求助:数十台服务器集群全部无响应、无法连通,相关业务全面停滞。 本次故障极具特殊性:无前置预警、无人工变更、无规律征兆,属于突发性集群级雪崩故障。运维团队第一时间开展重启、复位等常规应急操作,但故障反复复发,短暂恢复后即刻再次宕机,常规运维手段完全无法根治问题。 同时,全网海量报错日志批量刷屏,系统、应用、数据库多维度异常信息交织堆叠,故障线索繁杂混乱,极易造成排查误判。对于金融业务场景而言,容错空间几乎为零,一旦排查方向偏差,不仅无法止损,还会持续放大业务风险。 危急时刻,用户单位第一时间寻求原厂应急支持,麒麟软件依托成熟的保障体系,攻坚小组迅速赶赴现场。 二、拒绝经验主义!用专业方法论破除排查迷雾 故障爆发初期,现场各类异常表象交织,常规排查思路极易陷入误区:集群宕机指向系统内核问题、业务报错指向数据库故障、链路阻塞指向配置异常,多重猜测让排查工作陷入僵局。 一般情况下,常规排查方式会优先聚焦“表层故障现象”,采取试错式修复。而麒麟软件深耕政企金融核心场景多年,始终坚持“先定边界、再找根因、杜绝盲试”,以避免经验主义和主观预判误导。 抵达现场后,团队第一时间稳住现场秩序,叫停重装系统、重建集群等高风险无效操作,避免造成二次故障。同时快速建立多节点时间线对齐、全维度日志溯源、分层链路校验三大排查模型,从杂乱的故障信息中,剥离表象、锁定因果,为高效攻坚奠定基础。 三、全链路溯源!甄别故障层级、锁定核心根因 本次故障最大难点,在于所有异常都是连锁继发结果,无任何直观根因线索,系统、应用、数据库均呈现报错状态,极具迷惑性。 麒麟软件不局限于单一技术层排查,依托对服务器操作系统、软硬件协同、存储链路、业务架构的全栈技术积累,逐层穿透排查: 1、系统层排障 通过千万级系统日志逐行溯源、内核行为分析,精准验证银河麒麟高级服务器操作系统V10运行状态正常,所有系统异常均为底层链路阻塞后的被动继发问题,彻底排除系统本身故障,为客户规避大量无效排查成本。 2、业务层剥离表象 逐一校验数据库运行参数、连接链路、请求日志,确认数据库异常为业务阻塞后的连锁反应,并非故障源头。 3、跨层链路深度下钻 凭借丰富的复杂集群协同故障处置经验,团队捕捉到多节点共性核心线索:全集群机器统一出现持续性I/O读写等待。顺着链路层层溯源,最终精准定位底层Ceph分布式存储异常,引发集群级读写阻塞,进而拖垮整套交易集群。 这一结论解释了所有疑难现象,包括设备重启短暂恢复、反复宕机、集群集体失联等,彻底终结现场多方猜测,为后续精准修复提供100%实证支撑。 四、科学精准施治!兼顾业务连续性与数据安全性 金融业务系统故障修复,最怕“盲目操作、试错修复”,极易造成数据错乱、业务不可逆损伤。麒麟软件不仅快速找根因,更结合金融行业严苛的业务规范与数据安全要求,为用户制定精准方案、安全稳恢复。 1、界定故障边界 明确系统、应用、数据库的受影响范围,杜绝无效整改,大幅缩短故障处置周期; 2、聚焦核心症结 收敛排查重心至底层存储链路问题,协同推进存储侧状态核查与异常修复; 3、分层恢复业务 严控每一步操作风险,逐节点校验链路状态,优先恢复业务链路,全程保障金融数据零丢失、零错乱。 整套方案完全规避标准化机械处置的弊端,适配复杂金融集群的个性化场景需求,在极速止损和绝对安全之间实现精准平衡。历经48小时不间断攻坚,客户业务链路全面恢复,集群运行回归稳定,高危故障彻底解除。 五、专业铸就信赖!技术守住核心底线 对于用户而言,本次故障处置最核心的价值并非简单恢复业务,而是规避了方向误判导致的长时间停机,业务停摆风险。 用户技术负责人高度评价:“麒麟软件不仅帮我们快速恢复业务,更精准厘清了故障边界,帮我们少走了所有弯路。如果方向错了,损失无法估量。” 此次复盘也再次印证:复杂问题场景中,故障表象往往具有极强迷惑性,真正的专业服务,是穿透表象看本质、依托方法论定根因、基于经验稳风险。“麒心优服”团队不局限于单一产品运维,具备跨层级、全链路的故障研判与处置能力,可从容应对各类复杂集群级疑难故障。 从7×24小时极速应急响应,到标准化、体系化的故障排查方法论;从单一系统运维,到全栈链路、跨软硬件层级的综合攻坚,麒心优服的专业能力,藏在每一次深夜驰援、每一次精准破局、每一次风险兜底之中。 未来,麒麟软件将持续深耕金融、政务、能源等关键核心领域,以过硬的产品能力、成熟的实战体系、极致的服务水准,持续为客户核心业务稳定运行保驾护航,以专业实力筑牢国产化数字底座的安全稳定防线。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册