首页 文章 精选 留言 我的

精选列表

搜索[情绪分析],共4845篇文章
优秀的个人博客,低调大师

性能分析与架构建议

**MCms 本身可以支撑百万级 PV,但前提是必须开启全站静态化、接入 CDN、做 Redis 缓存与数据库优化,并采用多节点集群部署;如果直接用默认单体部署、未做静态化和缓存,很难稳定扛住百万 PV。 ### 先厘清“百万 PV”意味着多大压力 | 场景 | 估算 QPS | 说明 | | ------ |------ |------ | | 平均 QPS | 约 11.6 | 1,000,000 ÷ 86,400 秒 | | 峰值 QPS(3 倍) | 约 35 | 常见内容站早晚高峰 | | 峰值 QPS(5 倍) | 约 58 | 活动、热点内容场景 | | 峰值 QPS(10 倍) | 约 116 | 突发流量、推广投放 | 如果页面是动态查询数据库,116 QPS 并不低;但如果页面已经静态化、命中 CDN 或 Redis,应用层实际压力会大幅下降。 ### MCms 的性能基础 MCms 是开源 Java CMS,常见版本基于 **Spring / Spring MVC / MyBatis** 技术栈,支持 **HTML 静态化、模板标签建站、插件扩展、多终端适配**。 它的优势在于: - **Java 生态成熟**,便于接入 Redis、Nginx、消息队列等高性能组件; - **支持静态化**,对内容型站点非常关键; - **模块化设计**,便于二次开发和架构升级; - **开源可改造**,可以针对高并发场景做定制优化。 但 MCms 并不是“开箱即扛百万 PV”的产品。它的承载能力更多取决于部署架构和运维优化。 ### 百万 PV 推荐架构 #### 1. 全站静态化 + CDN 内容页、列表页、首页尽量生成静态 HTML,并通过 CDN 分发。这样大部分流量不会打到应用服务器。 对于 CMS 站点,这是提升性能收益最大的手段。 #### 2. 应用层集群 + 负载均衡 不要只部署单节点。建议使用: - Nginx / SLB 做负载均衡; - 至少 2~4 台应用节点; - 会话状态改为 Redis 或无状态设计; - 静态资源走 CDN 或 Nginx。 #### 3. 多级缓存 建议采用: - CDN 缓存静态页面; - Nginx 缓存热点资源; - Redis 缓存栏目、文章、配置、字典数据; - 应用本地缓存缓存低频变动数据。 这样可以明显降低数据库压力。 ### 不同部署方式的承载能力 | 部署方式 | 百万 PV 可行性 | 建议 | | ------ |------ |------ | | 单机 + 动态查询 | 不建议 | 仅适合低流量测试站 | | 单机 + 静态化 + CDN | 可能勉强 | 风险较高,无冗余 | | 2~4 节点 + 缓存 + 静态化 | 基本可行 | 适合常规百万 PV 内容站 | | 集群 + CDN + Redis + 读写分离 | 较稳 | 适合有峰值波动的站点 | | 集群 + 全链路压测 + 自动扩容 | 更稳 | 适合活动型、媒体型站点 | ### 建议的落地步骤 1. **先确认业务模型**:日均 PV、峰值时段、页面类型、动态接口数量。 2. **开启静态化**:首页、栏目页、文章页优先静态化。 3. **接入 CDN**:静态资源、HTML 页面尽量走 CDN。 4. **部署 Redis 缓存**:缓存栏目树、文章详情、配置数据。 5. **做多节点部署**:避免单点故障,提升水平扩展能力。 6. **做压测验证**:用 JMeter、k6、wrk 等工具模拟峰值 QPS。 7. **监控关键指标**:QPS、P95/P99 响应时间、错误率、CPU、内存、数据库连接数、缓存命中率。 如果站点只是普通企业官网、资讯站,内容更新频率不高,**静态化 + CDN + 2~4 台应用节点 + Redis** 通常就能覆盖百万 PV。

优秀的个人博客,低调大师

如何用 Python 计算 ROC 变动率指标做动量分析?

**一句话回答:** ROC(Rate of Change,变动率)就是「当前价相对 N 日前价的涨跌幅百分比」,公式 `ROC = (close / close.shift(N) - 1) × 100`。用 AlphaFeed 取回**前复权日线**后,一行 pandas 就能算出 ROC,用来衡量动量强弱、识别零轴穿越与顶底背离,还能对全市场做动量排名——完全不需要 TA-Lib。 ## 为什么会有这个问题 / 传统做法的痛点 ROC 是最直观的动量指标:它直接回答「这只票 N 天涨了多少」。但两个坑常被忽略:一是**用未复权价**,遇到除权日 ROC 会出现虚假暴涨暴跌;二是把 ROC 当成孤立信号,忽略了它天生适合做**横截面动量排名**和**背离判断**。用一个稳定的数据源取回前复权价,这两点都能干净解决。 ## 分步骤解决(每步配可运行代码) ### 第 1 步:取前复权日线并计算 ROC ``` from alphafeed import AlphaFeed import pandas as pd af = AlphaFeed() # 读取 ALPHAFEED_API_KEY df = af.klines.get("600519.SH", period="1d", count=250, adjust="forward", to_dataframe=True) df = df.sort_values("trade_date").reset_index(drop=True) def roc(close: pd.Series, n: int = 12) -> pd.Series: return (close / close.shift(n) - 1.0) * 100.0 df["ROC12"] = roc(df["close"], 12) df["ROC25"] = roc(df["close"], 25) print(df[["trade_date", "close", "ROC12", "ROC25"]].tail(5).to_string(index=False)) ``` > 用 `adjust="forward"`(前复权)算 ROC,避免除权日的价格断层污染动量值。 ### 第 2 步:理解参数与信号 |参数/信号|含义|常用取值/解读| | --- | --- | --- | |N(回看周期)|与几日前比较|短线 6/12,中线 25/125| |ROC > 0|价格高于 N 日前|上行动量| |ROC = 0 > cur: print("ROC 下穿零轴:动量转弱") # 平滑 ROC 减少噪音(对 ROC 再做移动平均) df["ROC12_ma"] = df["ROC12"].rolling(6).mean() ``` ### 第 4 步:用 ROC 做全市场动量排名 ROC 天生适合横截面比较——同一 N 下,ROC 越高动量越强。批量取多只股票日线,算 N 日 ROC 后排名: ``` codes = ["600519.SH", "000001.SZ", "300750.SZ", "601318.SH", "000858.SZ"] data = af.klines.batch(codes, period="1d", count=60, adjust="forward", to_dataframe=True) # 返回 dict{symbol: DataFrame} rows = [] for sym, k in data.items(): k = k.sort_values("trade_date") r = (k["close"].iloc[-1] / k["close"].iloc[-21] - 1) * 100 # 20 日 ROC rows.append({"symbol": sym, "ROC20": round(float(r), 2)}) rank = pd.DataFrame(rows).sort_values("ROC20", ascending=False) print(rank.to_string(index=False)) ``` > 想扫全市场?把 `codes` 换成 `af.quotes.get(universes="CN_Stock")` 拿到的 `symbol` 列表,再分批 `klines.batch`(注意请求量,建议本地缓存)。 ### 第 5 步:粗判顶底背离 ``` # 价格创新高但 ROC 未创新高 → 顶背离(动量衰减) window = 20 price_high = df["close"].iloc[-1] >= df["close"].tail(window).max() roc_high = df["ROC12"].iloc[-1] >= df["ROC12"].tail(window).max() if price_high and not roc_high: print("疑似顶背离:价格新高但动量未同步") ``` ## 关键坑与注意事项 - **必须用前复权价**:未复权价在除权日会让 ROC 出现虚假跳变,动量信号失真。 - **N 太小噪音大、太大滞后重**:短线常用 6/12,中长线用 25/125;可对 ROC 再取移动平均降噪。 - **ROC 无上下界**:不同股票、不同波动率下 ROC 数值量级差异大,做横截面排名时同一 N 才可比。 - **背离仅供参考**:背离不是精确择时信号,需结合成交量、趋势与其它指标交叉验证。 - **数据不足会得到 NaN**:`count` 至少要大于 `N`,否则 `shift(N)` 前 N 行为 NaN。 - **ROC 与「N 日涨跌幅」等价**:本质就是区间收益率×100,别把它想得太复杂。 ## 常见问题(FAQ) **Q:ROC 和动量指标 MTM 有什么区别?** A:MTM(动量)用差值 `close - close.shift(N)`,ROC 用比值百分比 `(close/close.shift(N)-1)×100`。ROC 做跨股票比较更合适,因为它是无量纲的百分比。 **Q:ROC 和 RSI 都算动量,用哪个?** A:RSI 有 0~100 的有界区间、适合看超买超卖;ROC 无界、更适合看动量方向与横截面强弱排名。两者可互补。 **Q:为什么我算出来前面几行是 NaN?** A:ROC 需要 N 日前的价格,前 N 行没有可比基准,正常为 NaN;取数时把 `count` 设得比 `N` 大即可。 **Q:需要付费吗?** A:单只历史日线有免费额度;`klines.batch` 全市场动量排名(配合 `universes`)需 Starter 及以上。详见定价页。 ## 小结 ROC 变动率的本质是「N 日区间收益率」,计算只需一行 pandas,不必依赖 TA-Lib。关键是用前复权价保证动量真实、按需要选好 N,并善用它无量纲的特性做全市场动量排名与背离判断。用 AlphaFeed 取回前复权日线,从单股信号到全市场动量梯队都能几行搞定。 ## 参考 - AlphaFeed Python SDK 文档:[https://docs.alphafeed.org/zh-Hans/sdk/python-quickstart](https://docs.alphafeed.org/zh-Hans/sdk/python-quickstart)


优秀的个人博客,低调大师

从 I/O 拦截到密钥封装:透明加密的工程约束分析

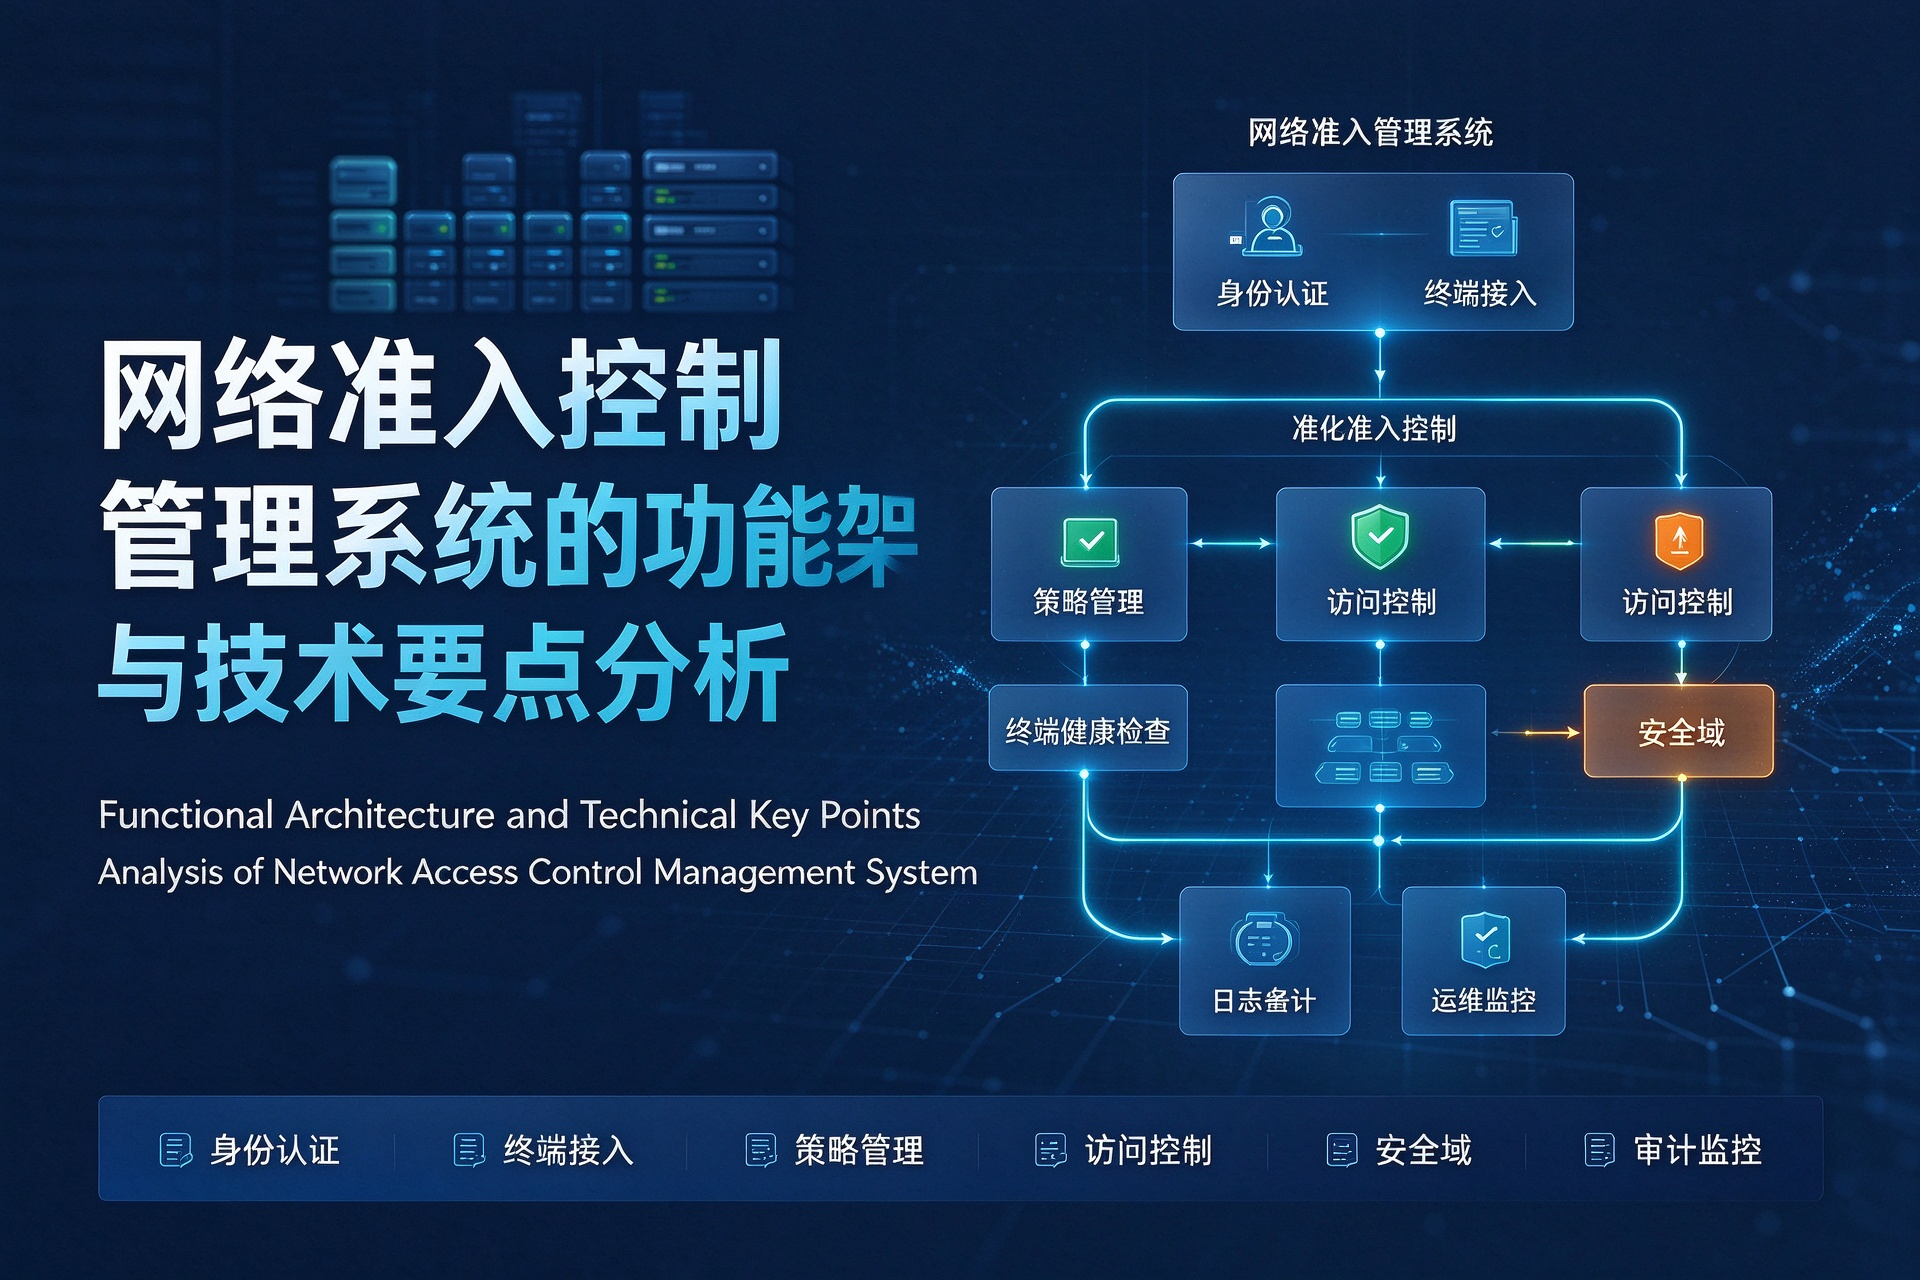
透明加密常被简化为“选算法、做驱动、加密文件”三步,但在终端文件安全场景中,真正决定系统能否稳定运行的,并不是密码原语本身。AES、SM4 等算法均为公开标准,工程差异更多来自三个位置:文件 I/O 在何处被截获、密钥以何种结构封装、策略判定如何与内核机制解耦。围绕这三个位置,可以更清楚地看到驱动层透明加密的技术逻辑及其限制。 ## 一、拦截点:微过滤驱动与 IRP 判定 应用层之所以“感觉不到加密”,是因为文件读写请求在到达磁盘之前或返回进程之前已被处理。Windows 平台通常借助文件系统微过滤驱动(Minifilter)挂接到过滤栈中,对发往卷设备的 I/O 请求包进行观察和干预。写请求进入驱动后,加密模块在数据落盘前完成变换;读请求从磁盘返回后,解密模块在数据交付调用进程前完成还原。由此形成的性质是:明文主要存在于内存路径中,磁盘上持久化的是密文形态。 但拦截并不等于“逢文件必加密”。驱动拿到 IRP 后,先要完成一次策略匹配:请求来自哪个进程、目标路径是否在受控范围、文件类型是否属于保护对象、当前终端用户是否具备相应身份。只有命中规则的写操作才进入加密分支;系统缓存、临时目录、特定工具链路径可以被排除,以降低误加密造成的系统异常。因此,透明加密的覆盖范围是策略配置的结果,而不是驱动安装后自动获得的全局属性。把“透明”理解为“应用无感”是准确的,把它理解为“全盘无差别加密”则不准确。 ## 二、密钥结构:文件级 DEK 与信封封装 拦截点解决“在哪里变换”,密钥结构解决“用哪把密钥变换、由谁授权还原”。较常见的做法是为每个受保护文件生成独立的数据加密密钥(DEK),用其对文件正文做对称加密;DEK 不直接长期保存,而是由上层密钥加密密钥(KEK)封装后写入文件头部的元数据区域,形成信封式结构。 文件级 DEK 的收益是故障隔离:某个 DEK 泄漏或需要更换,不会牵连其他文件。其代价集中在密钥轮换路径。若 KEK 到期或疑似暴露,合理操作不是重新加密全部正文,而是“重封装”:用旧 KEK 解出 DEK,再用新 KEK 封装写回,正文密文保持不变。该操作的计算量主要随受管文件数量增长,而非随文件体积增长;但在轮换窗口内,驱动需要同时具备新旧 KEK 的解封能力,并依靠文件头中的密钥版本字段选择正确分支。双版本共存期越长,灰度越平滑;越短,旧 KEK 暴露后的风险窗口越小。这是一个安全性与可用性之间的参数选择。 离线终端还会把密钥管理的时间维度暴露出来。设备离开内网后无法实时向策略服务器请求解密授权,较稳妥的方式不是把明文 DEK 长期缓存在客户端,而是缓存由服务器签发、带有效期的票据,票据中携带解封文件头所需的材料或派生条件。票据有效期直接决定设备丢失后的风险敞口,这已超出单纯的“文件加密”范畴,进入终端身份与密钥绑定的交叉地带。 ## 三、机制与策略分离:同一内核的不同行为 在拦截框架和密钥封装之上,系统通常还要支持多种行为模式:透明加密、智能加密、只解密不加密、只读加密、不加密等。从架构上看,这体现为机制与策略的分离:内核侧的拦截框架和加解密引擎保持稳定,差异由策略引擎对“写是否触发加密、读是否触发解密”的判定逻辑实现。 这种分离的工程价值在于,同一套驱动可按部门、岗位或进程下发不同配置,而不必为每种模式维护独立内核模块。例如研发终端可采用透明模式,使受控进程读写自动变换;经常接收外部资料的岗位可配置智能加密,让已加密文件保持密态、外来明文不强制转入加密流程;审阅场景可使用只解密不加密模式,允许读取密文但在修改后输出明文。策略能力越丰富,落地风险也越集中:配置项越多,误配置和豁免滥用越难排查。因此,工程成熟度不仅体现在加密引擎本身,也体现在灰度工具、豁免机制和回滚路径的精细程度上。迪康文件加密系统在这一层面的设计,可作为观察策略与机制分离的一个样本。 ## 四、能力边界:文件路径之外与性能兼容性 驱动层透明加密解决的问题有明确边界:文件作为字节流离开授权环境后不可读。文件头中的策略标识和密钥索引,使过滤驱动在脱离策略服务器或终端身份不匹配时不执行解密,文件呈现为不可读密文。但这条路径只覆盖“以文件形态离开”的场景。截屏、拍照、把内容复制到新建的未加密文件、通过剪贴板粘贴到非受控应用,这些通道不经过文件过滤驱动的 I/O 判定路径,加密机制不会介入。这也解释了为什么加密内核之外通常还需配套剪贴板管控、截屏防护、水印和审计等模块。 审计同样有专属性。一次“加密”发生在哪个进程、使用哪个 DEK、由哪条策略触发,“解密”是透明路径自动完成还是经过审批,这些事件在过滤驱动内部完成,应用层没有感知,通用终端审计无法直接覆盖,必须由加密内核产出带有业务语义的日志,并与通用审计在时间戳和文件标识上对齐。 性能与兼容性是另一组约束。明密文变换在内存中完成的设计,对常规 Office 文档读写可将磁盘 I/O 影响控制在较低量级;但在大文件连续读写时,过滤驱动介入和 DEK 查找可能引入可观测延迟。更隐蔽的问题在工具链:源代码加密后必须能被编译器、链接器和版本管理工具正确处理,驱动层方案需要妥善处理内存映射文件、临时文件和多进程句柄共享,否则会出现“文件能打开但编译报错”一类问题。因此这类方案上线通常需要灰度:先在小范围验证工具链兼容性,再逐步扩大覆盖。 总体而言,驱动层透明加密的工程取舍在于安全属性绑定位置:把加解密下沉到应用难以绕过的 I/O 路径,收益是密文随文件本体移动;代价是内核开发复杂性、兼容性负担,以及由拦截点位置决定的能力边界。判断一套方案是否适用,理解这条边界比记住它支持哪些算法更有意义。

优秀的个人博客,低调大师

|爱分析洞察

**Anthropic最该担心的竞争对手,不是OpenAI,而是Meta。** 这不是因为Meta研发出了Coding能力更强的模型,也不是因为Anthropic的模型不再领先,而是Meta可能押中了下一轮AGI竞争的关键方向:**Personal Agent。** 过去一年,Anthropic凭借Coding能力建立了自己的竞争优势。当越来越多的人相信AI写代码、做任务才能通往AGI时,Meta却选择了一条不同的路。 ![](https://developer.qcloudimg.com/http-save/yehe-10505706/2b0e4fa3a3205ec9df7ba40e7bb235f0.png) 去年夏天,扎克伯格重整AI团队后,在公开信中明确了Meta新的方向,个人超级智能(Personal Superintelligence),之后Meta研发Muse、收购Manus,都是这一战略的落地成果。 **战略方向不同,会导致对下一代模型应该具备什么能力的判断完全不同。**基于能力目标的设定,用什么标准评测模型、如何打磨模型、如何甄选训练数据,都将随之改变。 Meta首席AI官Alexandr Wang在接受David Senra访谈时,回顾了团队开发Muse Personal Agent的过程。他提到,团队从原型走向产品发布,经历了七个月的研发和打磨,并围绕100多项具体行为和能力建立评测体系,持续改进模型。这个过程不仅涉及基础模型的预训练,同时覆盖到后训练阶段,是全新的端到端训练重塑,从而让模型更好地服务于Personal Agent这一目标。 如果Meta赌对了,那么它挑战的将是Anthropic赖以建立领先优势的Coding技术路线。**当行业发现AGI下一轮的方向变了,领先者Anthropic无法及时转身,AGI的旗手位置将易位。** # **01 Anthropic All-in Coding,Meta不跟** 要理解Meta为什么能挑战Anthropic,得先弄清楚Anthropic是怎么赢的。 过去几年,AI行业一直在追求更强的模型能力。但模型刷榜取得更高的分数、输出更漂亮的答案,并不意味着它就能真正替人完成工作,Coding改变了这件事。 ![](https://developer.qcloudimg.com/http-save/yehe-10505706/f4a0edcb1f6c1f4222b0c83824589046.png) 随着Claude和Claude Code的发展,Anthropic不仅获得了开发者的认可,也逐渐把模型能力转化为商业增长。 这次技术路线下注非常成功,彻底改变了行业的竞争格局。**OpenAI让位,Anthropic接过了AGI旗手。** ![](https://developer.qcloudimg.com/http-save/yehe-10505706/1f0bf2e3dc1ddc62d2ea0c0956457187.png) 对于追赶者来说,要追上已经被验证的方向,目标明确、路径清晰,但所缺的唯有时间。可如果所有人都在追赶上一轮的领先者,下一轮竞争又会从哪里开始?Meta的答案是,重新定义下一轮的路线方向,放弃追赶Anthropic,找到另一个能够释放模型能力的方向。 在公开访谈中,Wang回顾了当时的行业判断,“2026年初,Anthropic和Claude在Coding领域已经建立了很强的优势,行业普遍把Coding Agent看作先进AI最重要的产品方向之一。Meta却认为,个人AI和消费级AI可能更适合自己。” **Anthropic希望AI能够承担越来越复杂的工作,Meta则希望AI能够更深入地服务于每一个人。**前者从工作能力切入,后者从个人需求切入。这背后,就是扎克伯格最近提出的新思考,“个人超级智能最大的贡献不是自动化,而是发明创造”。AI不是替代人类工作,而是与人共同创造新事物。 对于AI的三观差别,会决定当研发资源有限时,把什么能力放在优先位置。 # **02 一次成功的路线选择,为什么可能改变行业座次?** 大家所熟知的智谱故事即是案例。 2025年下半年,在行业普遍看衰智谱技术能力、非议智谱商业模式之时,唐老师力排众议,**重注Coding、舍弃2B交付。** 为此,智谱围绕Coding目标组织训练数据,设计评测体系,不断优化模型在编程、工具调用和复杂任务执行上的表现。随着GLM-5发布,智谱的模型能力得到市场迅速认可,产品获得用户,用户又带来新的使用反馈,进一步推动模型迭代。 仅仅半年时间,智谱从被诟病的二线模型厂商一跃成为头部。当这条路线被证明有效,厂商就会持续加大投入,逐渐形成优势。 同一时期,Meta的Llama与智谱处于同一困境,但是Meta的选择不是再造一个Coding Llama,**而是选择押注下一代AI技术路线,Personal Agent。**因此,Meta彻底放弃Llama,基于Personal Agent要求重新训练Muse模型。 ![](https://developer.qcloudimg.com/http-save/yehe-10505706/f93f3a50c435c71da52ec2eb827a35d9.png) 针对Personal Agent,Muse在训练时面对的任务更加开放。比如,用户说了一句模糊的需求,它需要理解背后的意图;一个任务尚未完成,用户又提出了新的要求,它需要协调优先级;要真正帮助用户解决问题,它还可能需要跨越不同应用、调用不同工具,并在行动过程中不断调整计划。 这些能力当然并非Coding Agent完全不具备,但如果厂商将Personal Agent作为优先目标,就会围绕这些问题设计更系统的训练和评测。 模型厂商不是先造出一个无所不能的模型,再决定把它用在哪里。**对未来技术路线的判断,决定了模型厂商训练什么模型、采用什么评测标准,以及把有限的研发资源投入哪里。**当模型研发走完从预训练到后训练的每一个环节,这种目标导向不同带来的差异不断累积,使得原本看起来能力相近的模型,在不同任务上拉开差距。 如果Personal Agent最终被证明是下一个技术路线方向,Meta就有机会在自己选择的方向上建立充分的时间优势,而不必先在Anthropic已经占优的赛道上完成追赶。 # **03 Meta的赌注,下一代模型长什么样** Wang在访谈中讲述的研发过程,有一个细节值得注意。 Meta并不是先有了一个Personal Agent产品,再要求模型团队把它做得更好。团队把Personal Agent作为模型研发的重要方向之一,列出了超过100项模型需要具备的具体行为和能力,为每一项建立评测,再通过一轮轮训练与检查,逐渐提高模型的表现。 ![](https://developer.qcloudimg.com/http-save/yehe-10505706/0afcc2f3532fe679f4426b96c79cafac.png) Wang描述的过程并不神秘,甚至有些笨功夫的感觉。模型在哪些事情上做得不好,就针对这些问题继续改进,哪些能力还达不到要求,就继续打磨。但这件事的意义在于,**Meta不只是选择了一个产品方向,而是开始围绕这个方向组织模型能力的改进。** Meta还有一个先天优势,它拥有庞大的消费级产品生态。Wang在访谈中提到,Meta的应用每天触达约35亿用户,对于Personal Agent来说,这意味着它有机会接触大量真实的个人需求,并将产品使用中的问题转化为下一轮改进的依据。 # **04 Anthropic,将面临当年OpenAI窘境?** 假设有一天,Anthropic也认为Personal Agent将成为下一轮竞争的关键方向,它能不能迅速追上Meta? **当然可以开始追赶,但会有时间差。** Meta团队从2026年初的原型走到同年9月的产品发布,经历了七个月的研发与打磨。产品原型可以在一两周内做出来,但要把一个时灵时不灵的演示,变成能够可靠服务普通用户的产品,需要大量持续的模型改进。 ![](https://developer.qcloudimg.com/http-save/yehe-10505706/46a517fb9095b44fa34c4f11c7f0b9df.png) 因此,**Anthropic近期发布的个人智能体产品Claude Duet,**注定是个半成品炮灰。毕竟其背后的模型并非根据主动服务而训练,产品体验自然拉胯。 而且,Anthropic面临的选择可能不只是要不要追赶,还需要决定,**应该在多大程度上调整已有的研发重点,以及如何在Coding等现有优势与Personal Agent等新方向之间分配资源。**届时,Anthropic将面临当年OpenAI的窘境。 由此延伸一下,假如这一次Meta赌对了,那么Anthropic掉队将是不可避免的。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册