首页 文章 精选 留言 我的

精选列表

搜索[渲染问题],共10000篇文章
优秀的个人博客,低调大师

巧用RoaringBitMap处理海量数据内存diff问题

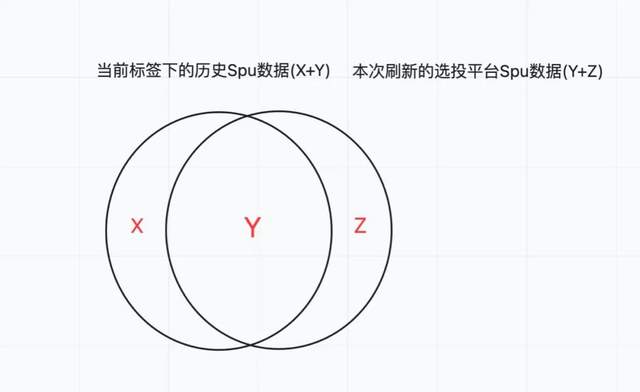
原创 Creed 得物技术 背景 目前,在商品圈选投场景,每个标签id都会根据规则/指标绑定一定数据量的商品集,在圈选规则条件变动或者定时任务触发时会进行商品集的刷新,新增符合规则的商品,删除不符合规则的商品。 但是由于商品集下的spu数量大部分都在数十万,多的能达到上百万,如果直接将刷新前后各十万甚至百万的spu全量放到内存中互相做diff,再对diff得到的差集做增删,当同一时间刷新的标签数量过多时,内存就很容易溢出,造成整个服务宕机。 同时目前底层存储商品集的数据库为Hbase,因此在标签侧对于商品集的刷新场景目前都是采取全增全删的策略,即把刷新后的商品集先全量保存一次(利用Hbase 保存的幂等性,同一个rowkey的数据重复保存会进行覆盖,而不用在保存前做额外的数据是否存在的判断),并更新数据的modity_time=now(),然后再从Hbase中分批scan遍历商品集,找到modity_time<now的再进行删除,以此完成一次标签的刷新任务。 往往一个商品集在刷新前后真正变化的spu量并不大,通过取数分析得知变化的不会超过商品集数量的10%。而我们目前采用的这种全增全删的策略,每次刷新后都会有大量已有数据的重复插入,不仅延长了刷新的速度,也增加底层储存的压力,同时由于选投平台里有标签的指标,标签的变动需要推送变化的spu给选投平台进行重新圈品,同时spu es 中也存有标签的数据用于后台展示,所以当前全增全删的策略,尤其是大量已有数据的重复插入,都会同步到选投平台和spu es侧,对他们造成大量的性能浪费和处理成本,改造迫在眉睫。 优化方案 前面提到,由于传统的java Set结构在数据量较大的情况,占用内存较多,导致无法将前后海量商品集的数据全部存到内存中去做运算。 那么有没有一个数据结构可以在存海量数据时还能保持较低的内存占用,支持去重,还支持交集,差集等各种运算呢? Bitmap完美满足要求。 Bitmap是通过bit数组来存储数据的数据结构,是一串连续的二进制数组(0和1),可以通过偏移量(offset)定位元素。Bitmap通过最小的单位bit来进行0|1的设置,表示某个元素的值或者状态,时间复杂度为O(1)。 同时由于采用了Bit为单位来存储数据,因此在存储空间方面,可以大大节省。例如储存500W数据仅需5000000/8/1024/1024=0.5M内存。 因此准备使用Bitmap结构来存储刷新前后的商品集,然后分别对新老Bitmap互相求差集得到,最终对差集进行add和delete操作即可。 方案可行性分析 以标签场景为例。 标签可以绑定选投平台,标签系统会把选投平台圈选的所有商品集都打上标,此刻标签下的商品集记为oldSset(X+Y)。 选投平台刷新后,会重新圈选出一批满足选投平台指标的商品集,此时选投平台下的商品集记为newSet(Y+Z) 。 此时标签系统需要给newSet(Y+Z)打标,同时从oldSet(X+Y)删除不在本次圈选范围内的商品(X)。 标签商品集底层储存是Hbase,对于已存在数据的插入,只要rowkey(标签id+spuId)不变, Hbase就会进行覆盖,保存最新时间戳的数据,可以理解为老Y已经被新Y覆盖(老Y数据=新Y数据,只是时间戳会不一样),所以老全增全删的方案, 删除量级是X,而不是X+Y。 如上图所示,每次刷新后,其实只需要对X进行删除和对Z进行新增。 相比于老全增全删逻辑,Bitmap diff新方案查询和删除量级不变,新增量级和对选投平台,spu es 的通知量级,都减少了Y。 同时由于Bitmap本身储存数据的方式,储存500W的spu数据集对内存的占用也才在0.5M,完成不用担心内存溢出风险。 因此采用Bitmap来储存刷新前后的全量商品数据,并在内存中做diff是一个理论可行的方案。 技术选型 既然我们选定了使用Bitmap作为新方案的储存,那么应该选取哪种Bitmap实现呢? 众所周知,Bitmap的实现有很多,例如java原生的BitSet,guava的EWAHCompressedBitmap,第三方的RoaingBitmap,redis Bitmap等等,由于redis的Bitmap主要做远程储存不适合当前内存diff场景,因此排除。 本次主要对比BitSet、EWAHCompressedBitmap、RoaingBitmap三种实现在各种数据稀疏度下的内存占用和cpu占用,以选出最满足当前场景的实现。 内存占用测试 通过往Bitmap中添加1、N+1、2N+1.....5000000数据,其中N为数据的步长(稀疏度) 来计算各个Bitmap在不同稀疏度下(N)的内存占用情况。 通过下图可以看出,除了在稀疏度为1时,EWAHCompressedBitmap内存占用最低以外,其余稀疏度下的内存占用:RoaingBitmap<EWAHCompressedBitmap<BitSet。 cpu耗时测试 往各个Bitmap中添加1、N+1、2N+1.....5000000数据,其中N为数据的步长(稀疏度),然后与有5000000满数据的Bitmap分别求2000次差集并取2000次中的最大耗时,得到在每个稀疏度下每种Bitmap的耗时情况。 通过下图可以看出,各个稀疏度下的cpu耗时:RoaingBitmap≈EWAHCompressedBitmap<BitSet. 选型最终结论 从内存占用,cpu耗时测试,实际场景下数据稀疏度综合考虑,RoaingBitmap效果最优,因此选用RoaingBitmap作为新方案的Bitmap实现。 RoaingBitmap介绍及原理 RoaingBitmap储存原理 RoaingBitmap会将32 bit unsigned int 类型数据 划分为 2^16 个大Container(即使用数据的前16位二进制作为Container的编号),每个大Container有一个小Container 来存放一个数值的低16位。 在存储和查询数值时,将数值 k 划分为高 16 位和低 16 位,取高 16 位值找到对应的Container,然后在将低 16 位值存放在相应的 Container 中。 这样说可能比较抽象不易理解,下面我通过一个例子来说明。 比如我们要将31这个数放进RoarigBitmap中,它的16进制为:0000 001F,前16位为0000,后16为001F。所以我们先需要根据前16位的值:0,找到它对应的的Container编号为0,然后根据后16位的值:31,确定这个值应该放到Container中的哪一个位置,如下图所示。 需要注意大Container里面的各个小Container是在需要的时候才会申请开辟的,并不是一开始就全部申请的,而且大Container中小Container都是按序号有序排列在大Container里面的。 四种container介绍 为了在各种场景和稀疏度下都始终保持有良好的内存占用和性能表现,RoaingBitmap 特意设计了4种小Container,分别为ArrayContainer(数组容器),BitmapContainer(位图容器),Runcontainer(行程步长容器),Sharedcontainer(共享容器),下面我会对每个ArrayContainer的使用场景和原理进行介绍。 Arraycontiner 在创建一个新container时,如果只插入一个元素,RBM(RoaingBitmap)默认会用ArrayContainer来存储。当ArrayContainer(其中每一个元素的类型为 short 占两个字节,且里面的元素都是按从小到大的顺序排列的)的容量超过4096(这里是指4096个short 即8k)后,会自动转成BitmapContainer(这个所占空间始终都是8k)存储。4096这个阈值很聪明,低于它时ArrayContainer比较省空间,高于它时BitmapContainer比较省空间。也就是说ArrayContainer存储稀疏数据,BitmapContainer存储稠密数据,可以最大限度地避免内存浪费,如下图所示。 BitmapContainer 这个容器其实就是我们所说的位图,只不过这里位图的位数为65536个,也就是2^16个bit,计算下来起所占内存就是8kb。然后每一位用0,1表示这个数不存在或者存在,如下图所示: Runcontainer 这是一种利用步长来压缩空间的方法 我们举个例子:比如连续的整数序列 11, 12, 13, 14, 15, 27, 28, 29 会被 压缩为两个二元组 11, 4, 27, 2 表示:11后面紧跟着4个连续递增的值,27后面跟着2个连续递增的值,那么原先16个字节的空间,现在只需要8个字节,是不是节省了很多空间呢。不过这种容器不常用,所以在使用的时候需要我们自行调用相关的转换函数来判断是不是需要将arraycontiner,或BitmapContainer转换为Runcontainer。 Sharedcontainer 这种容器它本身是不存储数据的,只是用它来指向ArrayContainer,BitmapContainer或Runcontainer,就好比指针的作用一样,这个指针可以被多个对象拥有,但是指针所指针的实质东西是被这多个对象所共享的。在我们进行RoaingBitmap之间的拷贝的时候,有时并不需要将一个container拷贝多份,那么我们就可以使用Sharedcontainer来指向实际的container,然后把Sharedcontainer赋给多个RoaingBitmap对象持有,这个RoaingBitmap对象就可以根据Sharedcontainer找到真正存储数据的container,这可以省去不必要的空间浪费。 这些container之间的关系可以用下面这幅图来表示: 其中的roaring_array是RoaingBitmap对象,而途中的Sharedcontainer则表示被多个roaring_array里面的小Container共享。 RoaingBitmap优势 内存 Bitmap比较适用于数据分布比较稠密的存储场景中,对于原始的Bitmap来说,若要存储一个uint32类型数据,这就需要2 ^ 32长度的bit数组,通过计算可以发现(2 ^ 32 / 8 bytes = 512MB),一个普通的Bitmap需要耗费512MB的存储空间。如果我们只存储几个数据的话依然需要占用512M的话,就有些浪费空间了,因此我们可以采用对位图进行压缩的RoaingBitmap,以此减少内存和提高效率。 性能 RoaingBitmap除了比Bitmap占用内存少之外,其并集和交集操作的速度也要比Bitmap的快。原因归结为以下几点: 计算上的优化 对于RoaingBitmap本质上是将大块的Bitmap分成各个小块,其中每个小块在需要存储数据的时候才会存在。所以当进行交集或并集运算的时候,RoaingBitmap只需要去计算存在的一些块而不需要像Bitmap那样对整个大的块进行计算。如果块内非常稀疏,那么只需要对这些小整数列表进行集合的 AND、OR 运算,这样的话计算量还能继续减轻。这里既不是用空间换时间,也没有用时间换空间,而是用逻辑的复杂度同时换取了空间和时间。 同时在RoaingBitmap中32位长的数据,被分割成高 16 位和低 16 位,高 16 位表示块偏移,低16位表示块内位置,单个块可以表达 64k 的位长,也就是 8K 字节。这样可以保证单个块都可以全部放入 L1 Cache,可以显著提升性能。 程序逻辑上的优化 RoaingBitmap维护了排好序的一级索引,以及有序的ArrayContainer当进行交集操作的时候,只需要根据一级索引中对应的值来获取需要合并的容器,而不需要合并的容器则不需要对其进行操作直接过滤掉。 当进行合并的ArrayContainer中数据个数相差过大的时候采用基于二分查找的方法对ArrayContainer求交集,避免不必要的线性合并花费的时间开销。 RoaingBitmap在做并集的时候同样根据一级索引只对相同的索引的容器进行合并操作,而索引不同的直接添加到新的RoaingBitmap上即可,不需要遍历容器。 RoaingBitmap在合并容器的时候会先预测结果,生成对应的容器,避免不必要的容器转换操作 show me the code 代码逻辑其实相对简单,主要是构建新老Bitmap,互相求差集后对本次新增的spu进行新增,对本次需要删除的spu进行删除操作。 优化效果 刷新速度 统计全量标签在新老逻辑下的耗时,发现提升比例大部分都集中在40%-60%区间,去掉最高及最低值 得出最终结论为平均提升比例在52.42% 写入量级以及对其他场景影响 统计全量标签在新老逻辑下的写量级,发现提升比例大部分都集中在85%-99%区间,去掉最高及最低值 得出最终结论为平均提升比例在86.98% 总结 由于java的Set结构在大数据量下的内存占用很高,因此在圈选商品集的刷新场景无法直接在内存中用set去全量储存刷新前后的商品集并做差集运算。 因此考虑到了使用Bitmap这样一种通过bit数组来存储数据的数据结构,它采用了Bit为单位来存储数据,因此在存储空间方面,可以大大节省。 对比了业界了各种Bitmap实现,结合当前场景,最终采用了RoaingBitmap来作为最终的实现。 RoaingBitmap属于是位图的一个进化,即压缩位图,不过在RoaingBitmap中不只包含Bitmap这一种数据结构,而是包涵了多种存储的方式(contianer),同时通过计算及逻辑上的优化,保证了在各个稀疏度下相比于传统的Bitmap都能保持较低的内存占用和对比速度。 最终上线后优化效果也是比较不错,刷新速度提升在52%左右,写入量级平均降低87%,有效的提升了刷新速度,以及对储存DB及其他场景域的压力。 同时本方案也适用其他类似的场景,比如选投平台侧的刷新,绑定选投平台的主题集下的商品刷新等。 参考文档: RoaingBitmap 官方github地址 使用Apache ECharts完成优化效果图绘制 *文/Creed 关注得物技术,每周一三五晚18:30更新技术干货 要是觉得文章对你有帮助的话,欢迎评论转发点赞~

优秀的个人博客,低调大师

20210602 TensorFlow 实现多点线性回归问题

0 导包 importwarnings warnings.filterwarnings("ignore") importnumpyasnp#numpy支持矩阵计算 importtensorflowastf importmatplotlib.pyplotasplt#matplotlib是Python的画图工具 1-1 构造数据 np.random.seed(999)#设定随机种子,用于控制随机过程 defpre(x): return2*x+3#这里w是2,b是3 #多点的线性回归,随机产生500个0-5的数据 x=5*np.random.random(500) y=[pre(i)foriinx] 1-1-2 画图 plt.plot(x,y,'salmon')#plt.plot画折线图;salmon指定颜色 plt.scatter(x,y)#scatter画点 plt.grid() plt.show() #线性回归的当前任务是,只给出点,让网络自动将w和b的值求出来 1-2-1 # 现在对 数据点 添加噪声;产生-0.5到0.5之间的随机数 -0.5+np.random.random(1) x=[i-0.5+np.random.random(1)[0]foriinx] y=[i-0.5+np.random.random(1)[0]foriiny] plt.scatter(x,y) plt.grid() plt.show() 1-3 数据处理1、x,y值放在一起2、数据集分为训练集和测试集# x:[x1,x2,x3,x4,x5......] y:[y1,y2,y3,y4,y5......]# [[x1,y1],[x2,y2],[x3,y3],[x4,y4].....] x=np.array(x) y=np.array(y) print(x[:10]) print(y[:10]) print(x.shape) # --> (500,)# 将 x 值和 y 值对应一起,有 2 种 做法1-3-1 # 做法1 升维操作 x=x.reshape(-1,1) y=y.reshape(-1,1) all_data=np.concatenate([x,y],axis=1) #拼接操作,将对应的x和y拼接一起 print(all_data[:10]) 1-3-2 # 做法2 x=x.reshape(-1,) y=y.reshape(-1,) all_data=np.array([x,y]) all_data=all_data.T#转至操作 print(all_data[:10]) train_data=all_data[:-64] test_data=all_data[-64:] # 将数据 分为 训练数据和测试数据;一般进行网络训练有三个数据集# 训练集,验证集和测试集,一般验证集可能是从训练集中分出来的# 训练完成后,使用测试集的数据验证查看 loss1-4 数据分块# 如果将数据一次性全部放到网络中,参数较多,运行速度较慢,或者内存直接溢出# 所以训练时,将数据切成一块块的,放入网络进行训练# 如何将数据分块呢?通过生成器实现# 生成器 defgen_batch(data): foriinrange(len(data)//64): cursor=64*i batch_data=data[cursor:cursor+64] x=batch_data[:,0]#取第一维度全要,第二维度中取第一个元素 y=batch_data[:,1]#取第一维度全要,第二维度中取第二个元素 yieldx,y #这里的生成器将data按大小分块,这里没有要余数 g_batch=gen_batch(train_data) print(g_batch) --><generator object gen_batch at 0x00000273D6BEAFC0>打印结果是一个生成器对象,那么生成器应该怎样用?1-4-1 forx_,y_ingen_batch(train_data): print(x_.shape) print(y_.shape) print('-------') # 一次完整的for循环可以将测试数据跑一遍,# 假设我们想论循100次我们的训练数据集,那应该是 importtensorflowastf foriinrange(100): forx_,y_ingen_batch(train_data): sess=tf.Session() sess.run() # 实际上,在TensorFlow中,也内置了一些生成器,可以直接调用参数实现# 不过,很多时候是自己写生成器,因为这样便于控制自己的业务数据 2 线性回归2-1 超参数 learing_rate=0.01#学习率 num_train_epochs=100#循环训练数据的次数 display_per_step=50#每隔50次,查看训练情况 # 超参数就是训练时需要用到的参数,把它们提取出来,易于修改 2-2 计算图 graph=tf.Graph() withgraph.as_default(): #x和y是真实值,是需要传入到网络里的 #所以需要定义2个placeholder,用这2个placeholder接收真实值 x=tf.placeholder(shape=[None,],dtype=tf.float32,name='x') y=tf.placeholder(shape=[None,],dtype=tf.float32,name='y') #w和b的初始值为0.5和0.2 w=tf.Variable(0.5,dtype=tf.float32) b=tf.Variable(0.2,dtype=tf.float32) #计算y_pred y_pred=w*x+b#正向过程,查看y预测值 #定义loss loss=tf.reduce_mean(tf.square(y_pred-y)) #定义优化器 optimizer=tf.train.GradientDescentOptimizer(learing_rate) train_step=optimizer.minimize(loss) 2-3 运行计算图 withtf.Session(graph=graph)assess: init=tf.global_variables_initializer() sess.run(init) step=0 forepochinrange(num_train_epochs): #注意x,y不要重名 forx_,y_ingen_batch(train_data): #x_y_代表从生成器中抓取出来的数据 step+=1 _,l=sess.run([train_step,loss],{x:x_,y:y_}) ifstep%display_per_step==0: w_value,b_value=sess.run([w,b]) print("w_valueis{:.4},b_valueis{:.4},lossis{:.4}".format(w_value,b_value,l)) print('trainingover') x_test,y_test=next(gen_batch(test_data)) #查看测试数据,用生成器的next方法查看 loss_test=sess.run(loss,{x:x_test,y:y_test}) print('testlossis{:.4}'.format(loss_test)) w_value,b_value=sess.run([w,b]) print(w_value,b_value) 部分代码解释:1. numpy中random;array;shape的使用 https://blog.51cto.com/u_15149862/28410032. numpy中reshape的使用;数组的拼接操作 https://blog.51cto.com/u_15149862/28410833. 1-4 中的生成器 https://blog.51cto.com/u_15149862/28444584. 2-2 中的 format 用法 https://blog.51cto.com/u_15149862/2847102 https://blog.51cto.com/u_15149862/2760852

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册