首页 文章 精选 留言 我的

精选列表

搜索[分库分表],共10000篇文章
优秀的个人博客,低调大师

CDN企业三分天下 共享模式独树一帜

日前,工信部下发第6批CDN牌照,截至目前获得CDN牌照的企业已达16家,分别是网宿科技、蓝汛通信、帝联科技、阿里云、腾讯云、同兴万点、福建光通互联、北京供销科技、上海云熵网络、金山云、高升控股、中联利信、知道创宇、网心科技、白山云、以及三快云(美团云)。 自此,形成了三大阵营对垒的局面逐步形成,其中,网宿、蓝汛、帝联是传统的专业型CDN服务商,在其领域占据举足轻重的地位;以阿里云、腾讯云、金山云为代表的互联网云厂商现在也是如日中天,发展迅速。而网心科技作为创新型企业的代表,获得工信部颁发的牌照,无疑代表着国家对创新型概念的认同和肯定。 另辟蹊径 打造共享经济CDN模式 众所周知,客户在选择CDN服务厂商时,出于稳定、可靠的考量,一般会选择3家以上的企业提供服务。这就造成CDN行业难以一家独大。因此,CDN企业只有坚持自己特色化的道路才能长久生存下去。 对此,网心科技另辟蹊径,打造共享经济模式的CDN服务理念。网心科技打造的星域CDN拥有300,000+节点数量,10T的带宽储备问题,在业内也是屈指可数。 牌照本身对星域CDN而言无疑是最有力的公信力背书,特别是对其所采用的共享经济云计算模式意义重大。这种模式因其创新性而曾一度被争议,现在它不但获得了市场和客户的检验,还获得了来自工信部的权威认可。 共享CDN模式也受到业内人士的高度好评,对此,小米科技创始人雷军表示“星域CDN把闲置的带宽资源、计算资源、存储资源全部连接在一起,然后提供给需要的人。这是一个颠覆性的东西,有点像CDN领域的Uber,会对整个行业有巨大的推动力。” “星域的诞生,既是基于迅雷过去十年的技术积累,同时这种基于无限个人节点布局的CDN,不仅将构筑重新定义CDN行业的技术能力,也将孕育具有巨大空间的商业模式。”迅雷董事长邹胜龙如是说。 四大创新技术 重新定义CDN 星域CDN首创“无限节点”技术,已拥有在全国布建百万量级服务节点的能力(包括400余个骨干节点+百万量级末梢节点),首次实现下沉至家庭内拉取内容数据,开辟了一条总量更庞大、分布更均匀,数据传输距离可近至1km的网络加速通道。 依托于迅雷热门资源实时统计系统的先天优势,结合业内独家的P2SP技术和领先的全网探测技术,星域CDN首创了“星域调度”技术。可实现百万量级节点全局调度,最优路径数据传输,速度更快,稳定性更佳。 星域CDN可支持HTTP DNS域名解析技术,同时拥有丰富的防盗链机制,帮助小米应用商店达到100%防劫持,响巢看看高清内容盗链数成功为0。同时,依托无限节点,星域CDN可轻松抵御高达300G的DDoS攻击,安全稳定有保障。 星域CDN领先的弱网加速技术,通过底层协议优化,有效对抗数据传输过程中各网络节点的波动,解决下载失败、下载错误、速度慢等常见问题,在下载速度低于50KB的弱网环境下,可将数据传输速度提升10倍。 获牌后,星域CDN将迎新一轮增长 获得牌照后,星域CDN的销售总经理曾卓表示,“星域CDN不出意外将迎来一波较高的增长,获得牌照无疑会大大提升我们的公信力。” 这种信任来自于CDN牌照的近乎苛刻的评定指标。由于日益提高的重要性,中国政府在“宽带中国”战略中明确将CDN作为网络基础设施重要组成部分。为此,工信部设立了严格设立的CDN牌照资质制度,以规范和提高CDN企业准入门槛。根据规定,想要获得牌照的CDN企业,需要经过三项严苛的重要评测。 并不是每一家CDN都有足够的技术水平通过这些测试,这也是为何目前市面上拥有牌照的CDN企业不足整体数量三成的原因之一。 在笔者看来,在大谈共享经济的今天,获得CDN牌照成为共享经济在技术领域的成功案例。万事开头难,在经历一番洗牌后,共享CDN模式也将大有作为。 作者:耿鹏飞 来源:51CTO

优秀的个人博客,低调大师

科普贴:一分钟读懂“云存储”

云存储时代来临过去十几年间,中国的经济、科技实力进步明显,众多科技热词都随着这股“洪流”奔涌出来,云存储就是其中之一。 对于非行业人士,听闻大数据、云存储这类字眼,便不由的打个“寒颤”,顿感虚无,但其实不然,云存储作为新时代的科技产品代表,其具有相当强的实用价值,它集成各种存储设备至一个平台,为人们服务;值得一提的是,它提供的还是多样化且定制化的服务,因此,客户选择它也不仅仅是存储需求的服务,更多的是其中以客户为中心的随时可变的多样化的数据服务。 云存储的发展轨迹 据度娘介绍,云存储是在云计算(cloud computing)概念上延伸和发展出来的一个新的概念,是一种新兴的网络存储技术,是指通过集群应用、网络技术或分布式文件系统等功能,将网络中大量各种不同类型的存储设备通过应用软件集合起来协同工作,共同对外提供数据存储和业务访问功能的一个系统。当云计算系统运算和处理的核心是大量数据的存储和管理时,云计算系统中就需要配置大量的存储设备,那么云计算系统就转变成为一个云存储系统,所以云存储是一个以数据存储和管理为核心的云计算系统。简单来说,云存储就是将储存资源放到云上供人存取的一种新兴方案。使用者可以在任何时间、任何地方,透过任何可连网的装置连接到云上方便地存取数据。 总的来说,云存储是一种服务,是一种以计算机科学为载体的新兴服务,它可以是一个设备、一个工具、一个网络接口等等,它的每个部分都可利用存储作为平台来进行其他的数据访问;另外,云存储还可看做是服务器与存储设备的叠加,云技术可以大大减少服务器数量、大幅度减少数据传输环节、降低系统建设成本,提高工作效率,保证系统的稳定运行。 云存储的结构模型 云存储的整体架构也与普通设备大不相同,其不仅仅是单个的硬件组成,而是存在多个系统分布。 一、 存储层 这是在云存储系统中最基础的部分,包含很多存储设备,利用互联网技术将这些不同的存储设备连接起来,构建成存储设备的管理系统;存储设备之上是一个统一存储设备管理系统,可以实现存储设备的逻辑虚拟化管理、多链路冗余管理,以及硬件设备的状态监控和故障维护。另外,该系统还可利用系统中的模块对设备进行监控和管理。 二、基础管理层 基础管理层是云存储最核心的部分,它在存储层之上,也是最复杂的部分,这个管理层利用集群分布的文件系统,实现存储设备之间的多重工作,使得存储设备可以提供新的服务,提高数据访问的可能性,保证数据的安全性;同时,通过各种技术和措施可以保证云存储中的数据不会丢失,保证云存储自身的安全和稳定。 三、应用接口层 应用接口层是云存储最灵活多变的部分。不同的不同的云存储运营单位可以根据实际业务类型,开发不同的应用服务接口,为用户提供不同的服务。 四、访问层 任何一个授权用户都可以通过标准的公用应用接口来登录云存储系统,享受云存储服务。云存储运营单位不同,云存储提供的访问类型和访问手段也不同。 云存储的优劣所在云存储是一种功能强大、灵活多变的网络系统,首先其支持多种设备同时为一个客户服务,任何被授权的用户都可利用一个简单的网址就可登陆其指定的系统,尽享云服务;其次云存储的容量不再受到单一限制而是根据客户的需求扩大其容量,在后台进行设备维修和升级时也不会影响到客户的存储内容;再者,使用云存储还可提高资源利用率,将数据集中起来,用户可以在任何地点,依靠单机或是移动设备随时访问数据,实现网内资源共享和协同工作,减少了传统的资源交换,提高资源的利用率;另外大大降低,有效减少移动存储设备的使用,降低了企业成本,最后也是最重要的一点是数据不会丢失。 但,需要注意的是,云存储的顺利推行目前也存在着很多问题和挑战,安全问题是目前最大的一个困扰,因为其接口的公用化导致授权用户都可以对其数据访问,这是其便利的一个因素但同时是其最致命的地方,如果是数据在传输的过程中被拦截的话,就会造成数据泄露,虽然目前很多云存储都采用了加密的手段,但因为增加了访问的关卡,无疑又造成了访问的繁琐性,访问的速度也是目前云服务无法突破的一个瓶颈,另外,数据的所有权也是云存储的一大问题。 用哲学的观点来看这个问题,问题和矛盾是永远存在的,技术的探索与使用虽然可能会发生各种各样的故障,但没有哪一项技术可以做到完美无瑕,我们必须接受这个事实,最好找出问题解决它。 云存储的交互应用 与存储联系最紧密的莫过于数据,我们无时无刻不在产生数据,而且这个量是非常巨大的,但我们鲜有人了解它,甚至知道它,这些数据产生出来需要我们去存储起来以便后期的挖掘与分析,而这,正好是这两者的交集所在。 有资料指出,现在创建的数字化信息量超过可用存储空间的35%,而且这一数字还在逐年上升,那么,今后该用什么“容器”去承载这些大的可怕的数据量呢?云存储将成主流。 每个技术的兴起总是由一个巨无霸企业牵头而且,这在众多科技热词身上都得以体现,当然,云存储也不例外,之前,两家IT巨头戴尔和惠普竞购3PAR直截了当的告诉人们,云存储是未来的发展趋势并将成为主流存储模型。 相关行业人士表示,与传统解决方案相比,云存储的成本和复杂性都降低了,并且能够更好的保护数据,即使办公室着火,异地备份的数据也会安然无忧,因此,这些优势让云存储很快就会受到众多企业的青睐,道理很简单,花了最少的钱得到最优的数据保障。 今后,云存储将会走向一个更加成熟的阶段,它所给予的服务将会更加全面和完善。除了数据圈,在每个领域都会有广泛的应用,虽然现在还面临很多问题,但在不久后,这块将是很多行业不可或缺的重要内容。 本文转自d1net(转载)

优秀的个人博客,低调大师

构建镜像 - 每天5分钟玩转容器技术(12)

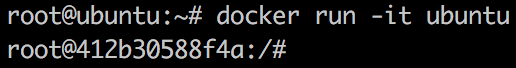
对于 Docker 用户来说,最好的情况是不需要自己创建镜像。几乎所有常用的数据库、中间件、应用软件等都有现成的 Docker 官方镜像或其他人和组织创建的镜像,我们只需要稍作配置就可以直接使用。 使用现成镜像的好处除了省去自己做镜像的工作量外,更重要的是可以利用前人的经验。特别是使用那些官方镜像,因为 Docker 的工程师知道如何更好的在容器中运行软件。 当然,某些情况下我们也不得不自己构建镜像,比如: 找不到现成的镜像,比如自己开发的应用程序。 需要在镜像中加入特定的功能,比如官方镜像几乎都不提供 ssh。 所以本节我们将介绍构建镜像的方法。同时分析构建的过程也能够加深我们对前面镜像分层结构的理解。 Docker 提供了两种构建镜像的方法: docker commit 命令 Dockerfile 构建文件 docker commit docker commit 命令是创建新镜像最直观的方法,其过程包含三个步骤: 运行容器 修改容器 将容器保存为新的镜像 举个例子:在 ubuntu base 镜像中安装 vi 并保存为新镜像。 第一步, 运行容器-it参数的作用是以交互模式进入容器,并打开终端。412b30588f4a是容器的内部 ID。 安装 vi确认 vi 没有安装。 安装 vi。 保存为新镜像在新窗口中查看当前运行的容器。silly_goldberg是 Docker 为我们的容器随机分配的名字。 执行 docker commit 命令将容器保存为镜像。新镜像命名为ubuntu-with-vi。 查看新镜像的属性。从 size 上看到镜像因为安装了软件而变大了。 从新镜像启动容器,验证 vi 已经可以使用。 以上演示了如何用 docker commit 创建新镜像。然而,Docker并不建议用户通过这种方式构建镜像。原因如下: 这是一种手工创建镜像的方式,容易出错,效率低且可重复性弱。比如要在 debian base 镜像中也加入 vi,还得重复前面的所有步骤。 更重要的:使用者并不知道镜像是如何创建出来的,里面是否有恶意程序。也就是说无法对镜像进行审计,存在安全隐患。 既然 docker commit 不是推荐的方法,我们干嘛还要花时间学习呢? 原因是:即便是用 Dockerfile(推荐方法)构建镜像,底层也 docker commit 一层一层构建新镜像的。学习 docker commit 能够帮助我们更加深入地理解构建过程和镜像的分层结构。 下一节我们学习如何通过 Dockerfile 构建镜像。

优秀的个人博客,低调大师

实践 config drive - 每天5分钟玩转 OpenStack(170)

如果 instance 无法通过 metadata service 获取 metadata(无 DHCP 或者 nova-api-metadata 服务),instance 还可以通过 config drive 获得 metadata。 config drive 是一个特殊的文件系统,OpenStack 会将 metadata 写到 config drive,并在 instance 启动时挂载给 instance。如过 instance 安装了 cloud-init,config drive 会被自动 mount 并从中读取 metadata,进而完成后续的初始化工作。 接下来我们将实践 config-drive。 配置 config drive 默认是 disable 的,所以首先得启用。有两种方法启用 config drive: 启动 instance 时指定--config-drive true。 在计算节点的 /etc/nova/nova.conf 中配置force_config_drive = true,这样部署到此计算节点的 instance 都会使用 config drive。我们实验中使用的就是这种方法。 config drive 支持两种格式,iso9660 和 vfat,默认是 iso9660,但这会导致 instance 无法在线迁移,必须设置成config_drive_format=vfat才能在线迁移,这一点需要注意。 配置完成后,重启 nova-compute 服务。 过程分析 部署一个新的 cirros instancec2,我们先到计算节点的 instances 目录下看看 c1 与 c2 的区别。 c2 的目录下会多一个disk.config文件,这就是 config drive。通过virsh edit可以看到 disk.config 已经挂载到 instance 上了。 打开 c2 的控制台,hostname 已经配置好,说明 metadata 拿到了。 为了确保 metadata 不是从 nova-api-metadata 获取,我已经提前关闭了 DHCP 服务,可以看到当前 c2 是没有 IP 的。 lsblk查看块设备,iso 设备sr0就是 config drive。 mount sr0,查看 config drive 的内容。 meta_data.json中存放了 ssh public key, hostname 等信息。 instance 可以通过 nova-api-metadata 或者 config drive 这两种途径拿到 metadata,如何使用这些 data 是 cloud-init 要完成的工作,下节我们将开始详细讨论 cloud-init。 ​

优秀的个人博客,低调大师

Troubleshooting OpenStack 瘫痪 - 每天5分钟玩转 OpenStack(160)

这是 OpenStack 实施经验分享系列的第 10 篇。是软件就会有 bug,OpenStack 也不例外,只要用它就一定会遇到故障。Troubleshooting(故障排除)是运维 OpenStack 等开源项目的重要技能,遇到问题后一定要借助社区的力量定位、搜索、分析并解决问题。下面 CloudMan 将分享一个真实的案例,还原当时Troubleshooting 的过程,希望能给大家一些启发。 问题描述 某天客户的 OpenStack 突然全线瘫痪:任何操作都无法正常完成,一直处于正在执行状态,界面上也不报错,就是无法完成操作。 问题分析 这是一个全局性的问题,首先查看 nova 日志,无报错,再看 MySQL 和 RabbitMQ 日志,在 RabbitMQ 中发现大量重复报错: 一直报 reply_529af7a7c3784c2d9dc5e72c603024a5 这个 exchange 找不到。 这些 reply_XXX 的都是 OpenStack 自己维护的,之前运行得好好的,为什么突然找不到,应该是发生了异常,跟配置没有关系,估计是 bug。先google 一下吧。搜索技术问题,google 是首选,翻不了墙就用 bing,度娘嘛还是让她专注中文吧 :-) 这里贴出 bing 的搜索结果: 看上去第二个比较靠谱,点进去发现跟我们的情况完全一样,而且还提到一个相关 bug。 浏览一下 bug 的内容,确实是我们遇到的问题,这是一个 oslo.messaging 的 bug,而且已经 fix 了。 因为客户 OpenStack 版本是 kilo, 所以点击 kilo 对应的 review 链接看看 fix 都修改了哪些地方。 一共改了两个文件,点开 amqpdriver.py 的链接,可以看到 diff。 对比客户系统 /usr/local/lib/python2.7/dist-packages/oslo_messaging/_drivers/amqpdriver.py 文件内容,确实是 fix 之前的版本。 问题确定了,解决办法也有了:更新 olso.messageing 包。 解决问题 OpenStack 的源代码是在 github 上维护的,每个模块有自己的 repository。 oslo.messageing 的项目主页是https://github.com/openstack/oslo.messaging 因为我们目前的版本是 kilo,所以要找 oslo.messaging 在 kilo 上的最新版本。 在Tags中,我们看到有 kilo-eol,eol 的意思是 “end of life”,是 kilo 的最终版本了。 可以再次确认,kilo-eol 确实包含了我们想要的 fix。后面的工作就很直接了: 下载 oslo.messaging 代码库。 安装 kilo-eol 版本。 重启相关 OpenStack 相关服务。 下节我们会详细讨论如何更新 OpenStack 组件。 由于 oslo.messaging 是基础组件,几乎所有服务都会用到,所以不得不更新每一个节点并重启 OpenStack。工作量虽然大些,但问题终于解决了。

优秀的个人博客,低调大师

启用 Open vSwitch - 每天5分钟玩转 OpenStack(127)

Linux Bridge 和 Open vSwitch 是目前 OpenStack 中使用最广泛的两种虚机交换机技术。 前面各章节我们已经学习了如何用 Linux Bridge 作为 ML2 mechanism driver 实现 Neutron 网络。今天开始我们将详细讨论如何用 Open vSwitch 实现 Neutron。 实验环境两节点的网卡分配方式与 Linux Bridge 一致,如下所示: 控制节点三个网卡(eth0, eth1, eth2),计算节点两网卡(eth0, eth1)。 合并 Management 和 API 网络,使用 eth0,IP 段为 192.168.104.0/24。 VM 网络使用 eht1。 控制节点的 eth2 与 External 网络连接,IP 段为 10.10.10.0/24。 网络拓扑 实验环境的网络拓扑如下图所示 这个图在 Linux Bridge 实现中也看到过,唯一的区别是: 对于节点中的 “Virtual Network Switch” 我们将用 Open vSwitch 替换掉 Linux Bridge。 配置 openvswitch mechanism driver 要将 Liunx Bridge 切换成 Open vSwitch,首先需要安装 Open vSwitch 的 agent。 修改 devstack 的 local.conf: 重新运行 ./stack,devstack 会自动下载并安装 Open vSwitch。 接下来就可以修改 ML2 的配置文件 /etc/neutron/plugins/ml2/ml2_conf.ini,设置使用 openvswitch mechanism driver。 控制节点和计算节点都需要按照上面的方法安装并配置 Open vSwitch。 Neutron 服务重启后,可以通过 neutron agent-list 命令查看到 neutron-openvswitch-agent 已经在两个节点上运行。 下一节查看当前网络的状态并介绍 Open vSwitch 涉及的各种网络设备。

优秀的个人博客,低调大师

LBaaS 实现机制 - 每天5分钟玩转 OpenStack(125)

上一节我们已经配置并测试 LBaaS,今天重点分析 Neutron 是如何用 Haproxy 来实现负责均衡的。 在控制节点上运行 ip netns,我们发现 Neutron 创建了新的 namespace qlbaas-xxx。 该 namespace 对应我们创建的 pool “web servers”。 其命名格式为 qlbaas-< pool ID>。 可以通过 ip a 查看其设置。 VIP 172.16.100.11 已经配置在 namespace interface 上。 在 subnet 的 Port 列表中也可以找到该 interface 的相应配置。 对于每一个 pool,Neutron 都会启动一个 haproxy 进程提供 load balancering 功能。 通过 ps 命令查找 haproxy 进程: haproxy 配置文件保存在 /opt/stack/data/neutron/lbaas/< pool ID>/conf 中。 查看 “web servers” 的配置内容: 可以看到: 1. frontend 使用的 HTTP 地址为 VIP:80 2. backend 使用的 HTTP 地址为 172.16.100.10:80 和 172.16.100.9:80 3. balance 方法为 roundrobin 这些内容与我们前面的配置一致。 以上就是 Neutron 实现 LBaaS 的理。下一节我们讨论如何通过 floating IP 访问 VIP。

优秀的个人博客,低调大师

添加 Pool Member - 每天5分钟玩转 OpenStack(123)

我们已经有了 Load Balance Pool “web servers”和 VIP,接下来需要往 Pool 里添加 member 并学习如何使用 cloud image。 先准备两个 instance: “Web1” 和 “Web2”。 使用 Ubuntu Cloud Image 由于 cirros 镜像不能运行 HTTP 服务,我们将使用 Ubuntu Cloud Image。下载地址为 http://uec-images.ubuntu.com/trusty/current/trusty-server-cloudimg-amd64-disk1.img 与以前的 instance 不同,Web1 和 Web2 使用了命名为“cloud”的 Key Pair。这是因为 Ubuntu Cloud Image 默认用户 “ubuntu” 的密码是随机生成的,通过 Key Pair 访问是一个比较方便的方法。 下面是 Key Pair 的配置方法: 通过 ssh-keygen 生成 Key Pair。其中 cloud.key.pub 是公钥,需要添加到 instance 的 ~/.ssh/authorized_keys 文件中。 cloud.key 是私钥,用于访问 instance。 将 Pair Key 导入 OpenStack 进入 Project -> Compute -> Access & Security 菜单,点击 Key Pairs 标签页的 “Import Key Pair” 按钮。复制 cloud.key.pub 的内容。粘贴到 Public Key 输入框中,给 Key Pair 命名为 “cloud”,并点击 “Import Key Pair”。Key Pair “cloud” 成功导入。 使用 Key Pair “cloud”。 launch instance 的时候,在 Access & Security 标签页中选择 Key Pair “cloud”。 OpenStack 会自动将公钥添加进 instance 的 ~/.ssh/authorized_keys 文件。 ssh instance。 用 -i cloud.key 指定私钥,并以 ubuntu 用户 ssh “Web1” 和 “Web2”。无需密码直接登录 instance。注:为了便于演示,这里我们是在 router 的 namespace 中执行 ssh,主要目的是网络可达。 “Web1” 和 “Web2” 准备就绪了,可以添加到 Pool 中了。 在 Project -> Network -> Load Balancers 的 Members 标签页中 点击 “Add Member” 按钮。 Pool 选择 “web servers”。 Member(s) 中多选 “Web1” 和 “Web2”。 Protocol Port 设置为 “80”。 点击 “Add”,member 添加成功。 Pool Member 有了,下一节我们将为 Pool 创建 Monitor,用于 Member 健康检查。

优秀的个人博客,低调大师

理解 Neutorn LBaaS - 每天5分钟玩转 OpenStack(120)

Load Balance as a Service(LBaaS)是 Neutron 提供的一项高级网络服务。LBaaS 允许租户在自己的网络中创建和管理 load balancer。 load balancer 可以说是分布式系统中比较基础的组件。 它接收前端发来的请求,然后将请求按照某种均衡策略转发给后端资源池中的某个处理单元,以完成处理。 load balancer 可以实现系统高可用和横向扩展。 LBaaS 有三个主要的概念: Pool Member,Pool 和 Virtual IP Pool MemberPool Member 是 layer 4 的实体,拥有 IP 地址并通过监听端口对外提供服务。 例如 Pool Member 可以是一个 web server,IP 为 172.16.100.9 并通过 80 端口提供 HTTP 服务。 PoolPool 由一组 Pool Member 组成。 这些 Pool Member 通常提供同一类服务。 例如一个 web server pool,包含: web1:172.16.100.9:80 web2:172.16.100.10:80 Virtual IPVirtual IP 也称作 VIP,是定义在 load balancer 上的 IP 地址。 每个 pool member 都有自己的 IP,但对外服务则是通过 VIP。 load balancer 负责监听外部的连接,并将连接分发到 pool member。 外部 client 只知道 VIP,不知道也不需要关心是否有 pool 或者有多少个 pool member。 OpenStack Neutron 目前默认通过 HAProxy 软件来实现 LBaaS。 HAProxy 是一个流行的开源 load balancer。 Neutron 也支持其他一些第三方 load balancer。 下图展示了 HAProxy 实现 load balancer 的方式。 左图是 client 发送请求到 web server 的数据流:1. Client 10.10.10.4 通过浏览器访问服务器的外网 IP 10.10.10.7。2. 请求首先到达路由器,将目的地址设置为服务器的内网 VIP 172.16.100.113. VIP 设置在 load balancer 上,load balancer 收到请求后选择 pool member WEB1,将数据包的目的 IP 设为 WEB1 的地址 172.16.100.9。 4. 在将数据包转发给 WEB1 之前,load balancer 将数据包的源 IP 修改为自己的 VIP 地址 172.16.100.11,其目的是保证 WEB1 能够将应答数据发送回 load balancer。 5. WEB1 收到请求数据包。 右图是 web server 应答的数据流: 1. WEB1 将数据包发送给 load balancer。 2. load balancer 收到 WEB1 发回的数据后,将目的 IP 修改为 Client 的地址 10.10.10.4。 同时也将数据包的源 IP 修改为 VIP 地址 172.16.100.11,保证 Client 能够将后续的数据发送给自己。 3. load balancer 将数据发送给路由器。4. 路由器将数据包的源地址恢复成服务器的外网 IP 10.10.10.7,然后发送给 Client。5. Client 收到应答数据。 以上就是 Load Balance as a Service 的工作原理。下节我们将开始实践 Neutron LBaaS。

优秀的个人博客,低调大师

理解 Neutron FWaaS - 每天5分钟玩转 OpenStack(117)

前面我们学习了安全组,今天学习另一个与安全相关的服务 -- FWaaS。理解概念 Firewall as a Service(FWaaS)是 Neutron 的一个高级服务。用户可以用它来创建和管理防火墙,在 subnet 的边界上对 layer 3 和 layer 4 的流量进行过滤。 传统网络中的防火墙一般放在网关上,用来控制子网之间的访问。 FWaaS 的原理也一样,是在 Neutron 虚拟 router 上应用防火墙规则,控制进出租户网络的数据。 FWaaS 有三个重要概念: Firewall、Policy 和 Rule。 Firewall租户能够创建和管理的逻辑防火墙资源。 Firewall 必须关联某个 Policy,因此必须先创建 Policy。 Firewall PolicyPolicy 是 Rule 的集合,Firewall 会按顺序应用 Policy 中的每一条 Rule。 Firewall RuleRule 是访问控制的规则,由源与目的子网 IP、源与目的端口、协议、allow 或 deny 动作组成。例如,我们可以创建一条 Rule,允许外部网络通过 ssh 访问租户网络中的 instance,端口为 22。 与 FWaaS 容易混淆的概念是安全组(Security Group)。 安全组的应用对象是虚拟网卡,由 L2 Agent 实现,比如 neutron_openvswitch_agent 和 neutron_linuxbridge_agent。安全组会在计算节点上通过 iptables 规则来控制进出 instance 虚拟网卡的流量。也就是说:安全组保护的是 instance。 FWaaS 的应用对象是 router,可以在安全组之前控制外部过来的流量,但是对于同一个 subnet 内的流量不作限制。也就是说:FWaaS 保护的是 subnet。 所以,可以同时部署 FWaaS 和安全组实现双重防护。 启用 FWaaS 因为 FWaaS 是在 router 中实现的,所以 FWaaS 没有单独的 agent。 已有的 L3 agent 负责提供所有 FWaaS 功能。 要启用 FWaaS,必须在 Neutron 的相关配置文件中做些设置。 配置 firewall driver Neutron 在 /etc/neutron/fwaas_driver.ini 文件中设置 FWaaS 使用的 driver。 如下图所示: 这里 driver 为 iptables。如果以后支持更多的 driver,可以在这里替换。 配置 Neutron 在 Neutron 配置文件 /etc/neutron/neutron.conf 中启用 FWaaS plugin。 配置完毕!下节我们开始创建 Firewall。

优秀的个人博客,低调大师

创建 floating IP - 每天5分钟玩转 OpenStack(106)

先复习一下前面我们讨论的知识。 当租户网络连接到 Neutron router,通常将 router 作为默认网关。当 router 接收到 instance 的数据包,并将其转发到外网时: 1. router 会修改包的源地址为自己的外网地址,这样确保数据包转发到外网,并能够从外网返回。 2. router 修改返回的数据包,并转发给真正的 instance。 这个行为被称作 Source NAT。 如果需要从外网直接访问 instance,则可以利用 floating IP。下面是关于 floating IP 必须知道的事实: 1. floating IP 提供静态 NAT 功能,建立外网 IP 与 instance 租户网络 IP 的一对一映射。 2. floating IP 是配置在 router 提供网关的外网 interface 上的,而非 instance 中。 3. router 会根据通信的方向修改数据包的源或者目的地址。 下面我们通过实验深入学习 floating IP。点击 Project -> Compute -> Access & Security 菜单,打开 Floating IPs 标签页。 点击 “Allocate IP To Project” 按钮。 floating IP Pool 为 ext_net,点击 “Allocate IP” 按钮。 从 Pool 中成功分配了一个 IP 10.10.10.3。 下面我们将它分配给 cirror-vm3,点击 “Associate” 按钮。 在下拉列表中选择 cirror-vm3,点击 “Associate” 按钮。 分配成功,floating IP 10.10.10.3 已经对应到 cirros-vm3 的租户 IP 172.16.101.3。 下一节我们将观察底层网络发生了怎样的变化,并分析 floating IP 是如何工作的。

优秀的个人博客,低调大师

Routing 功能概述 - 每天5分钟玩转 OpenStack(98)

路由服务(Routing)提供跨 subnet 互联互通功能。 例如前面我们搭建了实验环境: cirros-vm1 172.16.100.3 vlan100 cirros-vm3 172.16.101.3 vlan101 这两个 instance 要通信必须借助 router。 可以是物理 router 或者虚拟 router。 物理 router 使用物理 router,如下图所示: 接入的物理 router 有两个 interface ip: 172.16.100.1 对应 vlan100 的网关。 172.16.101.1 对应 vlan101 的网关。 当 cirros-vm1 要跟 cirros-vm3 通信时,数据包的流向是这样的: 1. 因为 cirros-vm1 的默认网关指向 172.16.100.1,cirros-vm1 发送到 cirros-vm3 的数据包首先通过 vlan100 的 interface 进入物理 router。 2. router 发现目的地址 172.16.101.3 与 172.16.101.1 为同一个 vlan,则从 vlan101 的 interface 发出。 3. 数据包经过 brq1d7040b8-01 最终到达 cirros-vm3。 虚拟 router 虚拟 router 的路由机制与物理 router 一样,只是由软件实现。 Neutron 两种方案都支持。如果要使用虚拟 router,需要启用 L3 agent。L3 agent 会在控制节点或者网络节点上运行虚拟 router,为 subnet 提供路由服务。 下节开始详细讨论 Neutron 的虚拟 router 实现。

优秀的个人博客,低调大师

配置 DHCP 服务 - 每天5分钟玩转 OpenStack(89)

前面章节我们看到 instance 在启动过程中能够从 Neutron 的 DHCP 服务获得 IP,本节将详细讨论其内部实现机制。 Neutron 提供 DHCP 服务的组件是 DHCP agent。 DHCP agent 在网络节点运行上,默认通过 dnsmasq 实现 DHCP 功能。 配置 DHCP agent DHCP agent 的配置文件位于 /etc/neutron/dhcp_agent.ini。 dhcp_driver使用 dnsmasq 实现 DHCP。 interface_driver使用 linux bridge 连接 DHCP namespace interface。 当创建 network 并在 subnet 上 enable DHCP 时,网络节点上的 DHCP agent 会启动一个 dnsmasq 进程为该 network 提供 DHCP 服务。 dnsmasq 是一个提供 DHCP 和 DNS 服务的开源软件。 dnsmasq 与 network 是一对一关系,一个 dnsmasq 进程可以为同一 netowrk 中所有 enable 了 DHCP 的 subnet 提供服务。 回到我们的实验环境,之前创建了 flat_net,并且在 subnet 上启用了 DHCP,执行 ps 查看 dnsmasq 进程,如下图所示: DHCP agent 会为每个 network 创建一个目录 /opt/stack/data/neutron/dhcp/,用于存放该 network 的 dnsmasq 配置文件。 下面讨论 dnsmasq 重要的启动参数: --dhcp-hostsfile存放 DHCP host 信息的文件,这里的 host 在我们这里实际上就是 instance。 dnsmasq 从该文件获取 host 的 IP 与 MAC 的对应关系。 每个 host 对应一个条目,信息来源于 Neutron 数据库。 对于 flat_net,hostsfile 是 /opt/stack/data/neutron/dhcp/f153b42f-c3a1-4b6c-8865-c09b5b2aa274/host,记录了 DHCP,cirros-vm1 和 cirros-vm2 的 interface 信息。 --interface指定提供 DHCP 服务的 interface。 dnsmasq 会在该 interface 上监听 instance 的 DHCP 请求。 对于 flat_net,interface 是 ns-19a0ed3d-fe。 或许大家还记得,之前我们看到的 DHCP interface 叫 tap19a0ed3d-fe(如下图所示),并非 ns-19a0ed3d-fe。 从名称上看,ns-19a0ed3d-fe 和 tap19a0ed3d-fe 应该存在某种联系,但那是什么呢? 要回答这个问题,需要先搞懂一个概念:Linux Network Namespace,我们下一节详细讨论。

优秀的个人博客,低调大师

创建 flat network - 每天5分钟玩转 OpenStack(87)

上一节我们讨论了 flat network 的原理,今天就来创建 "flat_net" 并分析底层网络的实现。 打开菜单 Admin -> Networks,点击 “Create Network” 按钮。 显示创建页面。 Provider Network Type 选择 “Flat”。 Physical Network 填写 “default”,与 ml2_conf.ini 中 flat_networks 参数保持一致。 点击 “Create Network”,flat_net 创建成功。 点击 flat_net 链接,进入 network 配置页面,目前还没有 subnet,点击 “Create Subnet” 按钮。 设置 IP 地址为 “172.16.1.0/24”。 点击 “Next”,设置 IP 地址范围为 172.16.1.101-172.16.1.200。 点击 “Create”,subnet 创建成功。 底层网络发生了什么变化 执行 brctl show,查看控制节点当前的网络结构。 Neutron 自动新建了 flat_net 对应的网桥 brqf153b42f-c3,以及 dhcp 的 tap 设备 tap19a0ed3d-fe。 另外,tap19a0ed3d-fe 和物理网卡 eth1 都已经连接到 bridge。 此时 flat_net 结构如图所示: flat_net准备就绪,下一节将部署 instance 到此 flat 网络。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册