首页 文章 精选 留言 我的

精选列表

搜索[安全机制],共10000篇文章
优秀的个人博客,低调大师

图解kubernetes容器探活机制核心实现状态管理

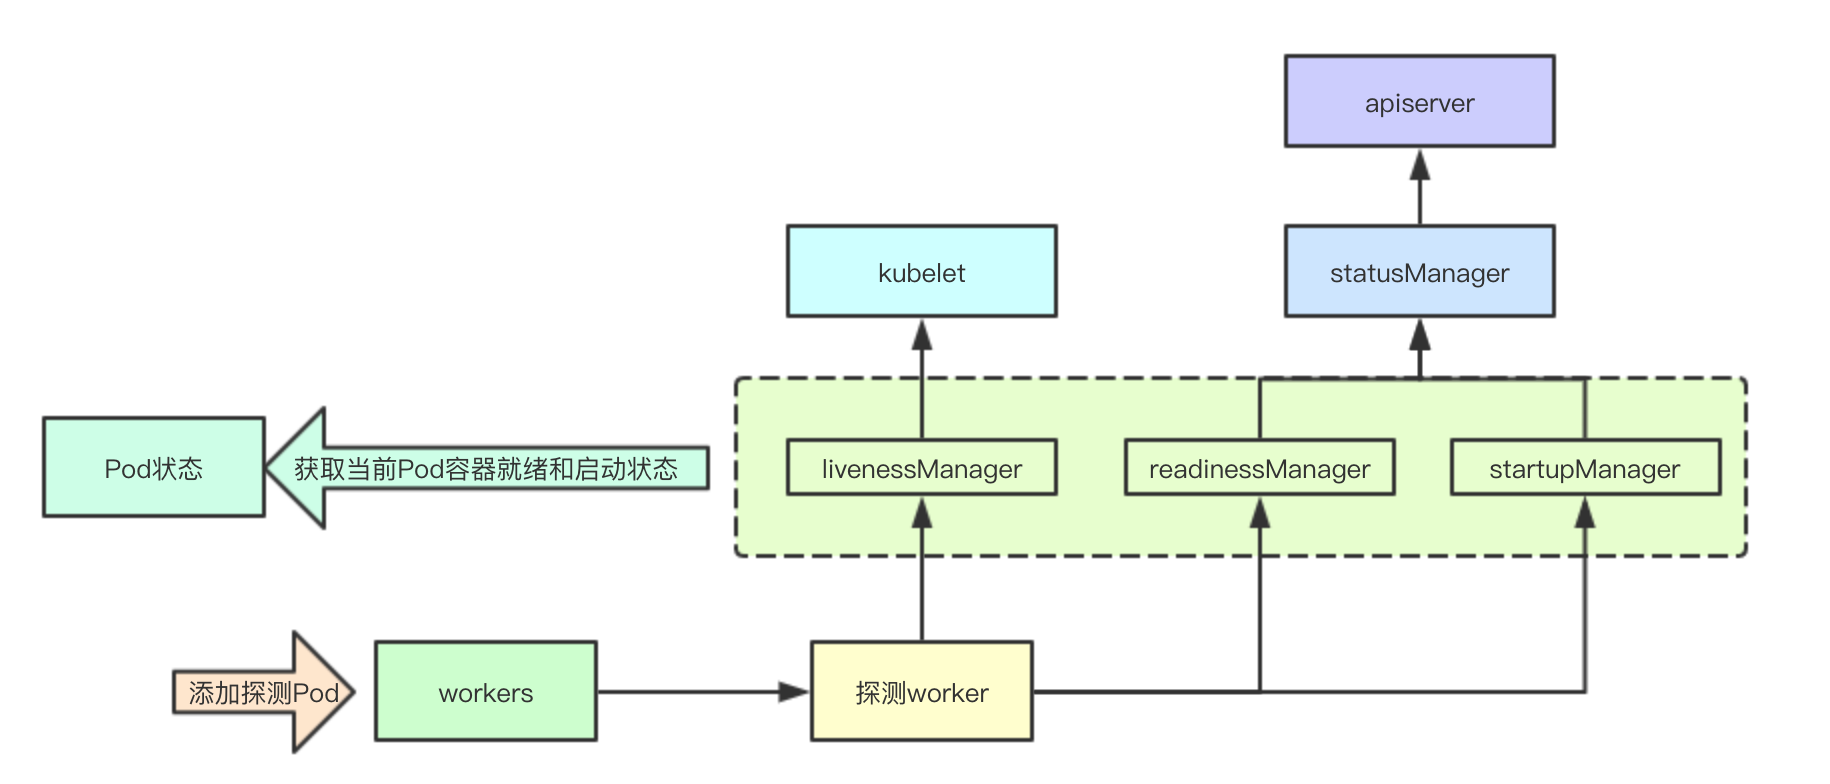
k8s为实现容器探活worker的管理构建了一个Manager组件,该组件负责底层探活worker的管理,并且缓存当前的容器的状态,并对外同步容器的当前状态,今天我们就来分析下其部分核心组件 1. 核心原理实现 Manager缓存的状态主要是会被kubelet、状态组件消费,并且在Pod同步状态的时候,会通过当前Manager里面的探测状态来更新Pod的容器的就绪与启动状态的更新,让我们一起看看Manager自身的一些关键实现吧 2. 探活结果管理 即prober/results/results_manager组件,其主要作用是:存储探测结果和通知探测结果 2.1 核心数据结构 cache负责容器的探测结果的保存,updates则负责对外更新状态的订阅,其通过新的结果和cache中的状态进行对比,从而决定是否对外通知 // Manager implementation. type manager struct { // 保护cache sync.RWMutex // 容器ID->探测结果 cache map[kubecontainer.ContainerID]Result // 更新管道 updates chan Update } 2.2 更新缓存通知事件 更新缓存的时候回通过对比前后状态来进行是否发布变更事件,从而通知到外部订阅容器变更的kubelet核心流程 func (m *manager) Set(id kubecontainer.ContainerID, result Result, pod *v1.Pod) { // 修改内部状态 if m.setInternal(id, result) { // 同步更新事件 m.updates <- Update{id, result, pod.UID} } } 内部状态修改与判断是否进行同步实现 // 如果之前的缓存不存在,或者前后状态不一致则会返回true触发更新 func (m *manager) setInternal(id kubecontainer.ContainerID, result Result) bool { m.Lock() defer m.Unlock() prev, exists := m.cache[id] if !exists || prev != result { m.cache[id] = result return true } return false } 2.3 对外更新管道 func (m *manager) Updates() <-chan Update { return m.updates } 3.探测管理器 探测管理器是指的prober/prober)manager的Manager组件,其负责当前kubelet上面探活组件的管理,并且进行探测状态结果的缓存与同步,并且内部还通过statusManager来进行apiserver状态的同步 3.1 容器探测Key 每个探测Key包含要探测的目标信息:pod的ID、容器名、探测类型 type probeKey struct { podUID types.UID containerName string probeType probeType } 3.2 核心数据结构 statusManager组件在后续章节里面会进行详细分析,说下livenessManager该组件即探活的结果,所以当一个容器探测失败,则会由kubelet本地先进行处理,而readlinessManager和startupManager则需要通过statusManager同步给apiserver进行同步 type manager struct { //探测Key与worker映射 workers map[probeKey]*worker // 读写锁 workerLock sync.RWMutex //statusManager缓存为探测提供pod IP和容器id。 statusManager status.Manager // 存储readiness探测结果 readinessManager results.Manager // 存储liveness探测结果 livenessManager results.Manager // 存储startup探测结果 startupManager results.Manager // 执行探测操作 prober *prober } 3.3 同步startup探测结果 func (m *manager) updateStartup() { // 从管道获取数据进行同步 update := <-m.startupManager.Updates() started := update.Result == results.Success m.statusManager.SetContainerStartup(update.PodUID, update.ContainerID, started) } 3.4 同步readiness探测结果 func (m *manager) updateReadiness() { update := <-m.readinessManager.Updates() ready := update.Result == results.Success m.statusManager.SetContainerReadiness(update.PodUID, update.ContainerID, ready) } 3.5 启动同步探测结果后台任务 func (m *manager) Start() { // Start syncing readiness. go wait.Forever(m.updateReadiness, 0) // Start syncing startup. go wait.Forever(m.updateStartup, 0) } 3.6 添加Pod探测 添加 Pod的时候会遍历Pod的所有容器,并根据探测类型来进行对应探测worker的构建 func (m *manager) AddPod(pod *v1.Pod) { m.workerLock.Lock() defer m.workerLock.Unlock() key := probeKey{podUID: pod.UID} for _, c := range pod.Spec.Containers { key.containerName = c.Name // 针对startupProbe的探测任务的构建 if c.StartupProbe != nil && utilfeature.DefaultFeatureGate.Enabled(features.StartupProbe) { key.probeType = startup if _, ok := m.workers[key]; ok { klog.Errorf("Startup probe already exists! %v - %v", format.Pod(pod), c.Name) return } // 构建新的worker w := newWorker(m, startup, pod, c) m.workers[key] = w go w.run() } // 针对ReadinessProbe的探测任务的构建 if c.ReadinessProbe != nil { key.probeType = readiness if _, ok := m.workers[key]; ok { klog.Errorf("Readiness probe already exists! %v - %v", format.Pod(pod), c.Name) return } w := newWorker(m, readiness, pod, c) m.workers[key] = w go w.run() } // 针对LivenessProbe的探测任务的构建 if c.LivenessProbe != nil { key.probeType = liveness if _, ok := m.workers[key]; ok { klog.Errorf("Liveness probe already exists! %v - %v", format.Pod(pod), c.Name) return } w := newWorker(m, liveness, pod, c) m.workers[key] = w go w.run() } } } 3.7 更新Pod状态 更新Pod状态主要是根据当前Manager里面缓存的之前的状态信息来更新Pod里面对应容器的状态,这些状态是Pod里面容器最新的探测状态,获取这些状态则是检测当前的容器是否已经就绪和启动,为后续更新流程做基础数据 3.7.1 容器状态更新 for i, c := range podStatus.ContainerStatuses { var ready bool // 检测容器状态 if c.State.Running == nil { ready = false } else if result, ok := m.readinessManager.Get(kubecontainer.ParseContainerID(c.ContainerID)); ok { // 检测readinessMnager里面的状态,如果是成功则就是已经就绪 ready = result == results.Success } else { // 检查是否有尚未运行的探测器。只要存在则认为就绪 _, exists := m.getWorker(podUID, c.Name, readiness) ready = !exists } podStatus.ContainerStatuses[i].Ready = ready var started bool if c.State.Running == nil { started = false } else if !utilfeature.DefaultFeatureGate.Enabled(features.StartupProbe) { // 容器正在运行,如果StartupProbe功能被禁用,则假定它已启动 started = true } else if result, ok := m.startupManager.Get(kubecontainer.ParseContainerID(c.ContainerID)); ok { // 如果startupManager里面的状态是成功的则认为是已经启动的 started = result == results.Success } else { // 检查是否有尚未运行的探测器。 _, exists := m.getWorker(podUID, c.Name, startup) started = !exists } podStatus.ContainerStatuses[i].Started = &started } 3.7.2 初始化容器状态更新 针对初始化容器主要容器已经终止并且退出的状态码为0,则认为初始化容器已经就绪 for i, c := range podStatus.InitContainerStatuses { var ready bool if c.State.Terminated != nil && c.State.Terminated.ExitCode == 0 { // 容器状态 ready = true } podStatus.InitContainerStatuses[i].Ready = ready } 3.8 存活状态通知 存活状态通知主要是在kubelet的核心流程循环中进行的,如果检测到容器的状态失败,会立刻进行对应pod的容器状态的同步,从而决定下一步的操作是做什么 case update := <-kl.livenessManager.Updates(): // 如果探测状态失败 if update.Result == proberesults.Failure { // 省略代码 handler.HandlePodSyncs([]*v1.Pod{pod}) } 探活整体的设计大概就是这样,接下来会分期其statusManager组件,即将将探测的状态与apiserver的同步的实现, k8s源码阅读电子书地址: https://www.yuque.com/baxiaoshi/tyado3 > 微信号:baxiaoshi2020 > 关注公告号阅读更多源码分析文章 > 更多文章关注 www.sreguide.com > 本文由博客一文多发平台 OpenWrite 发布
优秀的个人博客,低调大师

Java垃圾回收机制与典型的垃圾回收算法

说到垃圾回收(Garbage Collection,GC),很多人就会自然而然地把它和Java联系起来。在Java中,程序员不需要去关心内存动态分配和垃圾回收的问题,这一切都交给了JVM来处理。顾名思义,垃圾回收就是释放垃圾占用的空间,那么在Java中,什么样的对象会被认定为“垃圾”?那么当一些对象被确定为垃圾之后,采用什么样的策略来进行回收(释放空间)?在目前的商业虚拟机中,有哪些典型的垃圾收集器?下面我们就来逐一探讨这些问题。以下是本文的目录大纲: 一.如何确定某个对象是“垃圾”? 二.典型的垃圾收集算法 三.典型的垃圾收集器 如果有不正之处,希望谅解和批评指正,不胜感激。 请尊重作者劳动成果,转载请标明原文链接: http://www.cnblogs.com/dolphin0520/p/3783345.html 一.如何确定某个对象是“垃圾”? 在这一小节我们先了解一个最基本的问题:如果确定某个对象是“垃圾”?既然垃圾收集器的任务是回收垃圾对象所占的空间供新的对象使用,那么垃圾收集器如何确定某个对象是“垃圾”?—即通过什么方法判断一个对象可以被回收了。 在java中是通过引用来和对象进行关联的,也就是说如果要操作对象,必须通过引用来进行。那么很显然一个简单的办法就是通过引用计数来判断一个对象是否可以被回收。不失一般性,如果一个对象没有任何引用与之关联,则说明该对象基本不太可能在其他地方被使用到,那么这个对象就成为可被回收的对象了。这种方式成为引用计数法。 这种方式的特点是实现简单,而且效率较高,但是它无法解决循环引用的问题,因此在Java中并没有采用这种方式(Python采用的是引用计数法)。看下面这段代码: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 public class Main { public static void main(String[] args) { MyObject object1 = new MyObject(); MyObject object2 = new MyObject(); object1.object = object2; object2.object = object1; object1 = null ; object2 = null ; } } class MyObject{ public Object object = null ; } 最后面两句将object1和object2赋值为null,也就是说object1和object2指向的对象已经不可能再被访问,但是由于它们互相引用对方,导致它们的引用计数都不为0,那么垃圾收集器就永远不会回收它们。 为了解决这个问题,在Java中采取了 可达性分析法。该方法的基本思想是通过一系列的“GC Roots”对象作为起点进行搜索,如果在“GC Roots”和一个对象之间没有可达路径,则称该对象是不可达的,不过要注意的是被判定为不可达的对象不一定就会成为可回收对象。被判定为不可达的对象要成为可回收对象必须至少经历两次标记过程,如果在这两次标记过程中仍然没有逃脱成为可回收对象的可能性,则基本上就真的成为可回收对象了。 至于可达性分析法具体是如何操作的我暂时也没有看得很明白,如果有哪位朋友比较清楚的话请不吝指教。 下面来看个例子: 1 2 3 4 5 6 7 Object aobj = new Object ( ) ; Object bobj = new Object ( ) ; Object cobj = new Object ( ) ; aobj = bobj; aobj = cobj; cobj = null ; aobj = null ; 第几行有可能会使得某个对象成为可回收对象?第7行的代码会导致有对象会成为可回收对象。至于为什么留给读者自己思考。 再看一个例子: 1 2 3 String str = new String( "hello" ); SoftReference<String> sr = new SoftReference<String>( new String( "java" )); WeakReference<String> wr = new WeakReference<String>( new String( "world" )); 这三句哪句会使得String对象成为可回收对象?第2句和第3句,第2句在内存不足的情况下会将String对象判定为可回收对象,第3句无论什么情况下String对象都会被判定为可回收对象。 最后总结一下平常遇到的比较常见的将对象判定为可回收对象的情况: 1)显示地将某个引用赋值为null或者将已经指向某个对象的引用指向新的对象,比如下面的代码: 1 2 3 4 5 Object obj = new Object(); obj = null ; Object obj1 = new Object(); Object obj2 = new Object(); obj1 = obj2; 2)局部引用所指向的对象,比如下面这段代码: 1 2 3 4 5 6 7 8 void fun() { ..... for ( int i= 0 ;i< 10 ;i++) { Object obj = new Object(); System.out.println(obj.getClass()); } } 循环每执行完一次,生成的Object对象都会成为可回收的对象。 3)只有弱引用与其关联的对象,比如: 1 WeakReference<String> wr = new WeakReference<String>( new String( "world" )); 二.典型的垃圾收集算法 在确定了哪些垃圾可以被回收后,垃圾收集器要做的事情就是开始进行垃圾回收,但是这里面涉及到一个问题是:如何高效地进行垃圾回收。由于Java虚拟机规范并没有对如何实现垃圾收集器做出明确的规定,因此各个厂商的虚拟机可以采用不同的方式来实现垃圾收集器,所以在此只讨论几种常见的垃圾收集算法的核心思想。 1.Mark-Sweep(标记-清除)算法 这是最基础的垃圾回收算法,之所以说它是最基础的是因为它最容易实现,思想也是最简单的。标记-清除算法分为两个阶段:标记阶段和清除阶段。标记阶段的任务是标记出所有需要被回收的对象,清除阶段就是回收被标记的对象所占用的空间。具体过程如下图所示: 从图中可以很容易看出标记-清除算法实现起来比较容易,但是有一个比较严重的问题就是容易产生内存碎片,碎片太多可能会导致后续过程中需要为大对象分配空间时无法找到足够的空间而提前触发新的一次垃圾收集动作。 2.Copying(复制)算法 为了解决Mark-Sweep算法的缺陷,Copying算法就被提了出来。它将可用内存按容量划分为大小相等的两块,每次只使用其中的一块。当这一块的内存用完了,就将还存活着的对象复制到另外一块上面,然后再把已使用的内存空间一次清理掉,这样一来就不容易出现内存碎片的问题。具体过程如下图所示: 这种算法虽然实现简单,运行高效且不容易产生内存碎片,但是却对内存空间的使用做出了高昂的代价,因为能够使用的内存缩减到原来的一半。 很显然,Copying算法的效率跟存活对象的数目多少有很大的关系,如果存活对象很多,那么Copying算法的效率将会大大降低。 3.Mark-Compact(标记-整理)算法 为了解决Copying算法的缺陷,充分利用内存空间,提出了Mark-Compact算法。该算法标记阶段和Mark-Sweep一样,但是在完成标记之后,它不是直接清理可回收对象,而是将存活对象都向一端移动,然后清理掉端边界以外的内存。具体过程如下图所示: 4.Generational Collection(分代收集)算法 分代收集算法是目前大部分JVM的垃圾收集器采用的算法。它的核心思想是根据对象存活的生命周期将内存划分为若干个不同的区域。一般情况下将堆区划分为老年代(Tenured Generation)和新生代(Young Generation),老年代的特点是每次垃圾收集时只有少量对象需要被回收,而新生代的特点是每次垃圾回收时都有大量的对象需要被回收,那么就可以根据不同代的特点采取最适合的收集算法。 目前大部分垃圾收集器对于新生代都采取Copying算法,因为新生代中每次垃圾回收都要回收大部分对象,也就是说需要复制的操作次数较少,但是实际中并不是按照1:1的比例来划分新生代的空间的,一般来说是将新生代划分为一块较大的Eden空间和两块较小的Survivor空间,每次使用Eden空间和其中的一块Survivor空间,当进行回收时,将Eden和Survivor中还存活的对象复制到另一块Survivor空间中,然后清理掉Eden和刚才使用过的Survivor空间。 而由于老年代的特点是每次回收都只回收少量对象,一般使用的是Mark-Compact算法。 注意,在堆区之外还有一个代就是永久代(Permanet Generation),它用来存储class类、常量、方法描述等。对永久代的回收主要回收两部分内容:废弃常量和无用的类。 三.典型的垃圾收集器 垃圾收集算法是 内存回收的理论基础,而垃圾收集器就是内存回收的具体实现。下面介绍一下HotSpot(JDK 7)虚拟机提供的几种垃圾收集器,用户可以根据自己的需求组合出各个年代使用的收集器。 1.Serial/Serial Old Serial/Serial Old收集器是最基本最古老的收集器,它是一个单线程收集器,并且在它进行垃圾收集时,必须暂停所有用户线程。Serial收集器是针对新生代的收集器,采用的是Copying算法,Serial Old收集器是针对老年代的收集器,采用的是Mark-Compact算法。它的优点是实现简单高效,但是缺点是会给用户带来停顿。 2.ParNew ParNew收集器是Serial收集器的多线程版本,使用多个线程进行垃圾收集。 3.Parallel Scavenge Parallel Scavenge收集器是一个新生代的多线程收集器(并行收集器),它在回收期间不需要暂停其他用户线程,其采用的是Copying算法,该收集器与前两个收集器有所不同,它主要是为了达到一个可控的吞吐量。 4.Parallel Old Parallel Old是Parallel Scavenge收集器的老年代版本(并行收集器),使用多线程和Mark-Compact算法。 5.CMS CMS(Current Mark Sweep)收集器是一种以获取最短回收停顿时间为目标的收集器,它是一种并发收集器,采用的是Mark-Sweep算法。 6.G1 G1收集器是当今收集器技术发展最前沿的成果,它是一款面向服务端应用的收集器,它能充分利用多CPU、多核环境。因此它是一款并行与并发收集器,并且它能建立可预测的停顿时间模型。 下面补充一下关于内存分配方面的东西: 对象的内存分配,往大方向上讲就是在堆上分配,对象主要分配在新生代的Eden Space和From Space,少数情况下会直接分配在老年代。如果新生代的Eden Space和From Space的空间不足,则会发起一次GC,如果进行了GC之后,Eden Space和From Space能够容纳该对象就放在Eden Space和From Space。在GC的过程中,会将Eden Space和From Space中的存活对象移动到To Space,然后将Eden Space和From Space进行清理。如果在清理的过程中,To Space无法足够来存储某个对象,就会将该对象移动到老年代中。在进行了GC之后,使用的便是Eden space和To Space了,下次GC时会将存活对象复制到From Space,如此反复循环。当对象在Survivor区躲过一次GC的话,其对象年龄便会加1,默认情况下,如果对象年龄达到15岁,就会移动到老年代中。 一般来说,大对象会被直接分配到老年代,所谓的大对象是指需要大量连续存储空间的对象,最常见的一种大对象就是大数组,比如: byte[] data = new byte[4*1024*1024] 这种一般会直接在老年代分配存储空间。 当然分配的规则并不是百分之百固定的,这要取决于当前使用的是哪种垃圾收集器组合和JVM的相关参数。 参考资料: 《深入理解Java虚拟机》 作者: 海子 出处: http://www.cnblogs.com/dolphin0520/ 本博客中未标明转载的文章归作者 海子和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文连接,否则保留追究法律责任的权利。

优秀的个人博客,低调大师

一个Demo带你理解Android接口回调机制

前言 开发中,接口回调是我们经常用到的。 接口回调的意思即,注册之后并不立马执行,而在某个时机触发执行。 举个例子: A有一个问题不会,他去问B,B暂时解决不出来,B说,等我(B)解决了再告诉你(A)此时A可以继续先做别的事情。 那么就只有当B解决完问题后告诉A问题解决了,A才可以能解决这个问题。 代码中比如最常用的: 一个Activity中给按钮一个接口回调方法,只有用户点击了这个按钮,告诉按钮被点击了,才会执行按钮接口回调的方法 Button btn = new Button(this); btn.setOnClickListener(new View.OnClickListener() { @Override public void onClick(View view) { } }); 那么下面通过一个Demo理解接口回调: 主线程开启一个异步任务,当异步任务接收到数据,则把数据用TextView显示出来 1、首先 我们需要定义一个接口,定义一个方法,参数为一个字符串: package com.xqx.InterfaceDemo; public interface ChangeTitle { void onChangeTitle(String title); } 2、写一个异步任务,把接口作为构造方法参数,在doInBackground()方法中判断如果有数据,则接口回调 package com.xqx.InterfaceDemo; import android.content.Context; import android.os.AsyncTask; public class MyTask extends AsyncTask<String,Void,String>{ private ChangeTitle changeTitle; public MyTask(ChangeTitle changeTitle) { this.changeTitle = changeTitle; } @Override protected String doInBackground(String... strings) { if (strings[0]!=null){ changeTitle.onChangeTitle(strings[0]); } return null; } } 3、主Activity,给异步任务参数传this,即 接口回调方法在此类中执行,那么就需要实现ChangeTitle接口,重写接口中 onChangeTitle 方法 package com.xqx.InterfaceDemo; import android.app.Activity; import android.os.Bundle; import android.view.View; import android.widget.TextView; public class MainActivity extends Activity implements ChangeTitle { private TextView textView; @Override public void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.main); textView = (TextView) findViewById(R.id.textView); new MyTask(this).execute("我是标题"); } // 重写接口方法,执行相应操作 @Override public void onChangeTitle(String title) { textView.setText(title); } } 附录 Android高级技术大纲,以及系统进阶视频; Android高级技术大纲 Android进阶系统资料视频 获取方式; 加Android进阶群;701740775。即可前往免费领取。免费备注一下csdn

优秀的个人博客,低调大师

如何设计投放系统系列----灵活的字段映射补全机制

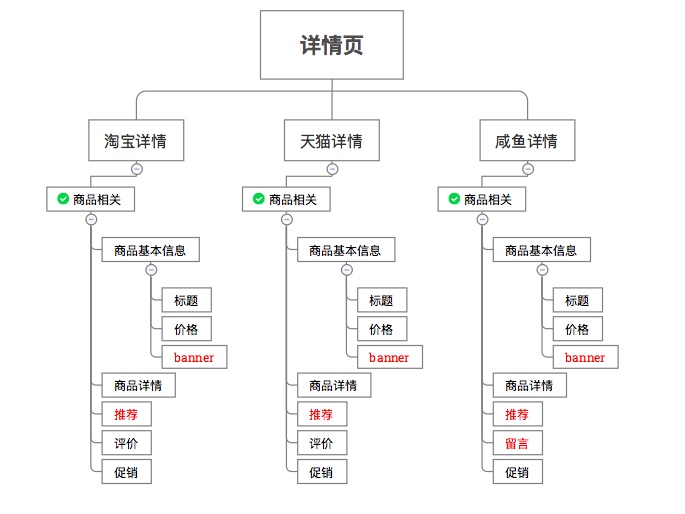
引言 我们知道搭建系统跟投放系统是两个紧密关联的系统,搭建产出的是页面的结构,投放产出的是页面的数据。搭建产出的页面包含各式各样的模块,这些模块包含的字段也没有太多规律可言,那么投放系统怎么为这些模块补全数据呢? 在回答这个问题之前,我们先尝试解决一些简单的业务 case。 几个案例 案例一 有一个商品模块,字段包括:商品的标题、商品图片、购买链接、商品价格、商品描述,想要投放某个选品集的商品,请问投放系统应该怎么设计以补全这些字段信息? 拿到这个需求,最直观的解决方案就是,直接去商品库取选品集对应的商品列表,把商品库里的字段塞到对应的模块字段上。 // 商品选品集 var goodSet = [1,2,3,4,5]; // 从商品库获取对应的商品实体信息 var entityMap = goodService.fetch(goodSet);

优秀的个人博客,低调大师

学习Java基础知识,打通面试关~十三锁机制

静态创建线程池 我们平常使用的大部分还是依靠java中自带的静态工厂产生的线程池。先了解下自带的线程池。 newFixedThreadPool(int numThreads) 该线程池会在初始化的指定线程数量。具有以下的特点1.在任何时刻都是最多有numThreads的线程数量活动。如果超过限制会在LinkedBlockingQueue中等待。 2.当达到核心线程数的时候,线程数不在继续增加。3.有工作线程退出,新的工作线程被创建来达到设置的线程数。 Executors.newFixedThreadPool(1); //源码实现 public static ExecutorService newFixedThreadPool(int nThreads) { return new ThreadPoolExecutor(nThreads, nThreads, 0L, TimeUnit.MILLISECONDS, new LinkedBlockingQueue<Runnable>()); } newCachedThreadPool 该线程池是一个可以用来缓存的线程池。1.尝试缓存使用过的线程。2.没有缓存的线程池时,就会使用工厂方法创建线程池,最大的容量理论上是Integer.MAX_VALUE。这个跟服务器的配置有关。所以如果过来大量的线程任务,那么该线程池会在瞬间创建多个线程来执行工作。3.时间上多余的线程超过60秒会被终止移除缓存中。4.内部使用的SynchronousQueue实现的队列,该队列在实现的时候没有容量。适合来做交换的工作。 Executors.newCachedThreadPool(); //源码实现 public static ExecutorService newCachedThreadPool() { return new ThreadPoolExecutor(0, Integer.MAX_VALUE, 60L, TimeUnit.SECONDS, new SynchronousQueue<Runnable>()); } newSingleThreadExecutor 该线程池是用来设置单个的线程池,使用的队列是无界队列。因为提交的任务只要一个是能活动的,剩下的是放到无界队列中。队列是先进先出的。那么执行顺序是有序的。 Executors.newSingleThreadExecutor(); //源码 public static ExecutorService newSingleThreadExecutor() { return new FinalizableDelegatedExecutorService (new ThreadPoolExecutor(1, 1, 0L, TimeUnit.MILLISECONDS, new LinkedBlockingQueue<Runnable>())); } newWorkStealingPool 工作线程,该线程是在jdk1.8以后新增加的.使用的是ForkJoinPool创建线程池。该任务执行没有顺序。需要考虑到硬件的cpu核心数。 Executors.newWorkStealingPool(); public static ExecutorService newWorkStealingPool() { return new ForkJoinPool (Runtime.getRuntime().availableProcessors(), //默认使用的是硬件的cpu数目 ForkJoinPool.defaultForkJoinWorkerThreadFactory, null, true); } Executors.newWorkStealingPool(10); public static ExecutorService newWorkStealingPool(int parallelism) { return new ForkJoinPool (parallelism, // 使用的是自定义的核心数 ForkJoinPool.defaultForkJoinWorkerThreadFactory, null, true); } newSingleThreadScheduledExecutor()与newScheduledThreadPool(int poolSize) 周期性的调度执行任务的线程池。 单个执行。 Executors.newSingleThreadScheduledExecutor(); public static ScheduledExecutorService newSingleThreadScheduledExecutor() { return new DelegatedScheduledExecutorService (new ScheduledThreadPoolExecutor(1)); } //核心周期执行的线程数 Executors.newScheduledThreadPool(10); public static ScheduledExecutorService newScheduledThreadPool(int corePoolSize) { return new ScheduledThreadPoolExecutor(corePoolSize); } 了解其java内部的静态线程池,并且在程序中使用其策略。当然在这种我们没有看到的是线程池的拒绝策略。无界队列和有界队列,核心数的与最大的核心数的设置,这些不同。那么我们的执行拒绝策略也是不同的。在接下里的文章我们会具体了解拒绝策略。 原文发布时间为:2018-07-09本文作者:mengrui本文来自云栖社区合作伙伴“LuckQI”,了解相关信息可以关注“LuckQI”。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册