首页 文章 精选 留言 我的

精选列表

搜索[webpack入门],共10000篇文章
优秀的个人博客,低调大师

设备树入门:简单介绍设备树

设备树在嵌入式 Linux 驱动开发里是一个绕不开的话题。很多人第一次打开 设备树的目录时,会被层层嵌套的 .dtsi 和 .dts 文件弄晕,而厂商已经做好了大量板级适配,我们只需要找到我们需要的设备树,然后编译。本文会把设备树的核心概念、迅为平台的典型文件结构、屏幕与 GPIO 的修改方法,以及编译验证的完整链路串起来,目标是让你看完就能在自己的迅为板子上动手改起来。 ## 一、设备树的文件 设备树源码有两种文本文件:.dts 和 .dtsi。.dtsi 通常是 SoC 厂商提供的**芯片级描述**,包含 CPU、中断控制器、片上外设控制器等公共信息;.dts 是**板级描述**,描述具体开发板上的外设、电源、引脚复用等差异内容。.dts 通过 #include 把 .dtsi 包含进来,编译时合并成完整的设备树。使用dtc工具编译后的二进制文件叫 .dtb。Bootloader启动时把 DTB 的地址传给内核,内核读取 DTB 中的 magic 字段确认合法性,再按结构块和字符串块的偏移量解析硬件描述。 在实际开发中,我们需要在板子中找到实际使用的设备树文件,需要在/boot文件夹中使用命令ll -al来查看设备树实际链接的文件。找到后在内核文件中找到这个设备树文件的.dts源码,通过修改源码然后编译,就可以增加相应的设备并获取相应设备的属性。 ## 二、设备树的语法 设备树由**节点**和**属性**两种基本元素构成。根节点 `/` 有且仅有一个,所有硬件信息都挂在根节点之下。在设备树开头可以include文件,include的文件的内容的根节点和这个文件的根节点是一样的。设备树开头需要有版本,一般是 /dts-v1/; 之后跟着根节点 /{ };根节点里面放入我们需要的内容。 节点的基本格式是 label: node-name@unit-address { ... }。label 是标签,方便在其他地方用 &label 引用;node-name 是节点名;unit-address 通常是寄存器基地址。一个 UART 节点可以写成: ``` uart1: serial@02020000 { compatible = "fsl,imx6ul-uart", "fsl,imx6q-uart"; reg = ; status = "okay"; }; ``` ![UART 节点代码](https://developer.qcloudimg.com/http-save/yehe-12795436/73879f0888af4bf4866c7e7e3198f82c.gif) 属性里最重要的几个: - **compatible**:驱动匹配的依据。格式推荐 "manufacturer,model",内核按顺序匹配,直到找到对应驱动。 - **reg** :寄存器地址空间,格式 ,具体解析方式由父节点的 #address-cells 和 #size-cells 决定。 - **status** :"okay" 表示启用,"disabled" 表示禁用。很多 SoC 外设在 .dtsi 里默认是 disabled,需要在板级 .dts 中改为 okay。 - **pinctrl-names 和 pinctrl-0** :引用引脚复用配置节点,是迅为平台上改 GPIO 时绕不开的一对属性。 - **phandle / 标签引用**:&gpio1 这种写法在编译时会被 dtc 自动决议为一个唯一的 32 位数字 ID。 子节点的 reg 属性格式不是固定的,它由**父节点**的 #address-cells 和 #size-cells 决定:前者规定 reg 中地址部分占几个 32 位 cell,后者规定长度部分占几个 cell。 在典型的 i.MX6ULL 设备树中: ``` / { #address-cells = ; #size-cells = ; cpus { #address-cells = ; #size-cells = ; cpu0: cpu@0 { reg = ; }; cpu1: cpu@1 { reg = ; }; }; soc { #address-cells = ; #size-cells = ; uart1: serial@02020000 { reg = ; }; }; }; ``` cpus 节点设 #size-cells = ,所以两个 CPU 子节点的 reg 只有地址、没有长度,分别是 和 。soc 节点设 #size-cells = ,uart1 的 reg 就变成 两个 cell。 根节点的子节点使用的是 CPU 视角的地址域,所以直接子节点不需要 ranges。但更深层的总线节点(比如 I2C 控制器、外部总线)有自己的地址域,这时就需要 ranges 把子地址映射到父地址。 ranges 的格式由父节点的 #address-cells、子节点的 #address-cells 和父节点的 #size-cells 共同决定,每一项是 。 ## 三、pinctrl子系统的使用方法 pinctrl 的设备树分为**消费者(客户端)** 和**生产者(服务端)** 两部分。消费者语法所有平台一致,生产者语法各芯片厂商不同。[-1](https://blog.csdn.net/beijingxunwei/article/details/135545864?ops_request_misc=elastic_search_misc&request_id=ffae3fa994a34124b3c305c0c0f282c6&biz_id=0&utm_medium=distribute.pc_search_result.none-task-blog-2~all~ElasticSearch~search_v2-8-135545864-null-null.nonecase&utm_term=rk3568%20pinctrl%E5%AD%90%E7%B3%BB%E7%BB%9F#1) ### 3.1 消费者:pinctrl-names 与 pinctrl-x 任何需要使用引脚的设备节点,通过两个属性声明需求: - **pinctrl-names** :字符串列表,给每个“状态”起名字。 - **pinctrl-0、pinctrl-1……**:每个状态对应的引脚配置 phandle 列表,pinctrl-0 对应 pinctrl-names 中的第一个名字,pinctrl-1 对应第二个,以此类推。 最常见的单状态写法: ``` &uart1 { pinctrl-names = "default"; pinctrl-0 = ; }; ``` 多状态用于运行中动态切换复用功能。例如一个引脚在“GPIO 模式”和“I2C 模式”之间切换: ``` my_device { pinctrl-names = "gpio_state", "i2c_state"; pinctrl-0 = ; pinctrl-1 = ; }; ``` 驱动在运行时调用 pinctrl_select_state() 传入 "i2c_state",pinctrl 子系统就会把 pinctrl-1 对应的配置写进硬件。一个 pinctrl-x 也可以包含多个 phandle,表示该状态同时配置多组引脚。 ### 3.2 生产者之一:Rockchip 平台(RK3568)的 rockchip,pins RK3568 的引脚配置节点放在 pinctrl 节点下(通常是 rk3568-pinctrl.dtsi),每个配置是一个子节点,核心属性是 **rockchip,pins**,每个引脚用四个 cell 描述: ``` ``` 第一个参数是 GPIO 组(bank),第二个是该组内的引脚编号,第三个是复用功能号,第四个是电气配置(上下拉、驱动强度等)的 phandle。 一个 UART 的配置示例: ``` &pinctrl { uart1 { uart1_xfer: uart1-xfer { rockchip,pins = , ; }; }; }; ``` RK_PB4、RK_PB5 是 Rockchip pinctrl 头文件里定义的宏,展开后就是 bank 内引脚号。第三个参数“复用功能号”是写 pinctrl 时最需要查手册的一个:同一个引脚在不同复用号下对应不同功能,比如复用号 1 可能是 PWM,2 可能是 UART。这个号必须查芯片数据手册或用户手册的引脚复用表才能确定,不能猜。第四个参数通常用 SoC dtsi 中预定义好的 pcfg_pull_up、pcfg_pull_none 等 phandle。 rockchip,pins 的父节点(如上面的 uart1 分组节点)只是组织用的容器,真正的 label 挂在包含 rockchip,pins 的那个子节点上(uart1_xfer),消费者的 pinctrl-0 引用的正是这个 label。 ## 四、验证语法是否写对的方法 改完设备树后,可以在 /proc/device-tree/查看自己的设备是否在里面,如果没有在里面,需要查看自己的设备树是否写错了。 如果节点存在但驱动 probe 时报告 pinctrl 相关错误,先用 dmesg | grep pinctrl 看内核日志。常见的错误是 pinctrl-0 引用的 label 在最终 DTS 中不存在,或者 rockchip,pins 的复用号与硬件不匹配。 如果还是看不出来,可以反编译最终 DTB: ``` dtc -I dtb -O dts -o /tmp/final.dts arch/arm/boot/dts/your_board.dtb ``` 在反编译输出中搜索你改的节点,看 reg、clocks、pinctrl-0 的最终 phandle 是否指向了预期的节点。设备树的 &label 在编译后全部变成数字 phandle,反编译能帮你确认这些数字到底指向谁。 ## 五、总结 设备树语法看起来零散,但拆开看只有两条主线:“地址怎么解释”和“资源怎么引用”。 节点关系决定地址格式**。** 子节点的 reg 长什么样,不由子节点自己决定,而由父节点的 #address-cells 和 #size-cells 决定。这两个属性只对直接子节点生效,不向下继承,所以每个需要描述地址的总线节点都要自己声明。跨地址域时用 ranges 做映射;板级 .dts 用 &label 重新打开节点追加或覆盖属性,最终生效的是最后一次赋值。 pinctrl 在设备树中采用“生产者声明配置、消费者声明需求”的结构。引脚复用和电气配置内容写在pinctrl 控制器节点下,并给配置节点打上 label;消费者节点只负责通过 pinctrl-x 引用这个 label。 reg、pinctrl-0、clocks 在编译后全部变成数字 phandle,用 dtc -I dtb -O dts 反编译看实际指向,比在多个源文件之间猜要可靠得多。节点存在但驱动不 probe,优先查 compatible 匹配、pinctrl label 是否存在、引脚是否被重复申请、clock 是否拿到。

优秀的个人博客,低调大师

LangSmith 入门:可观测性先于优化

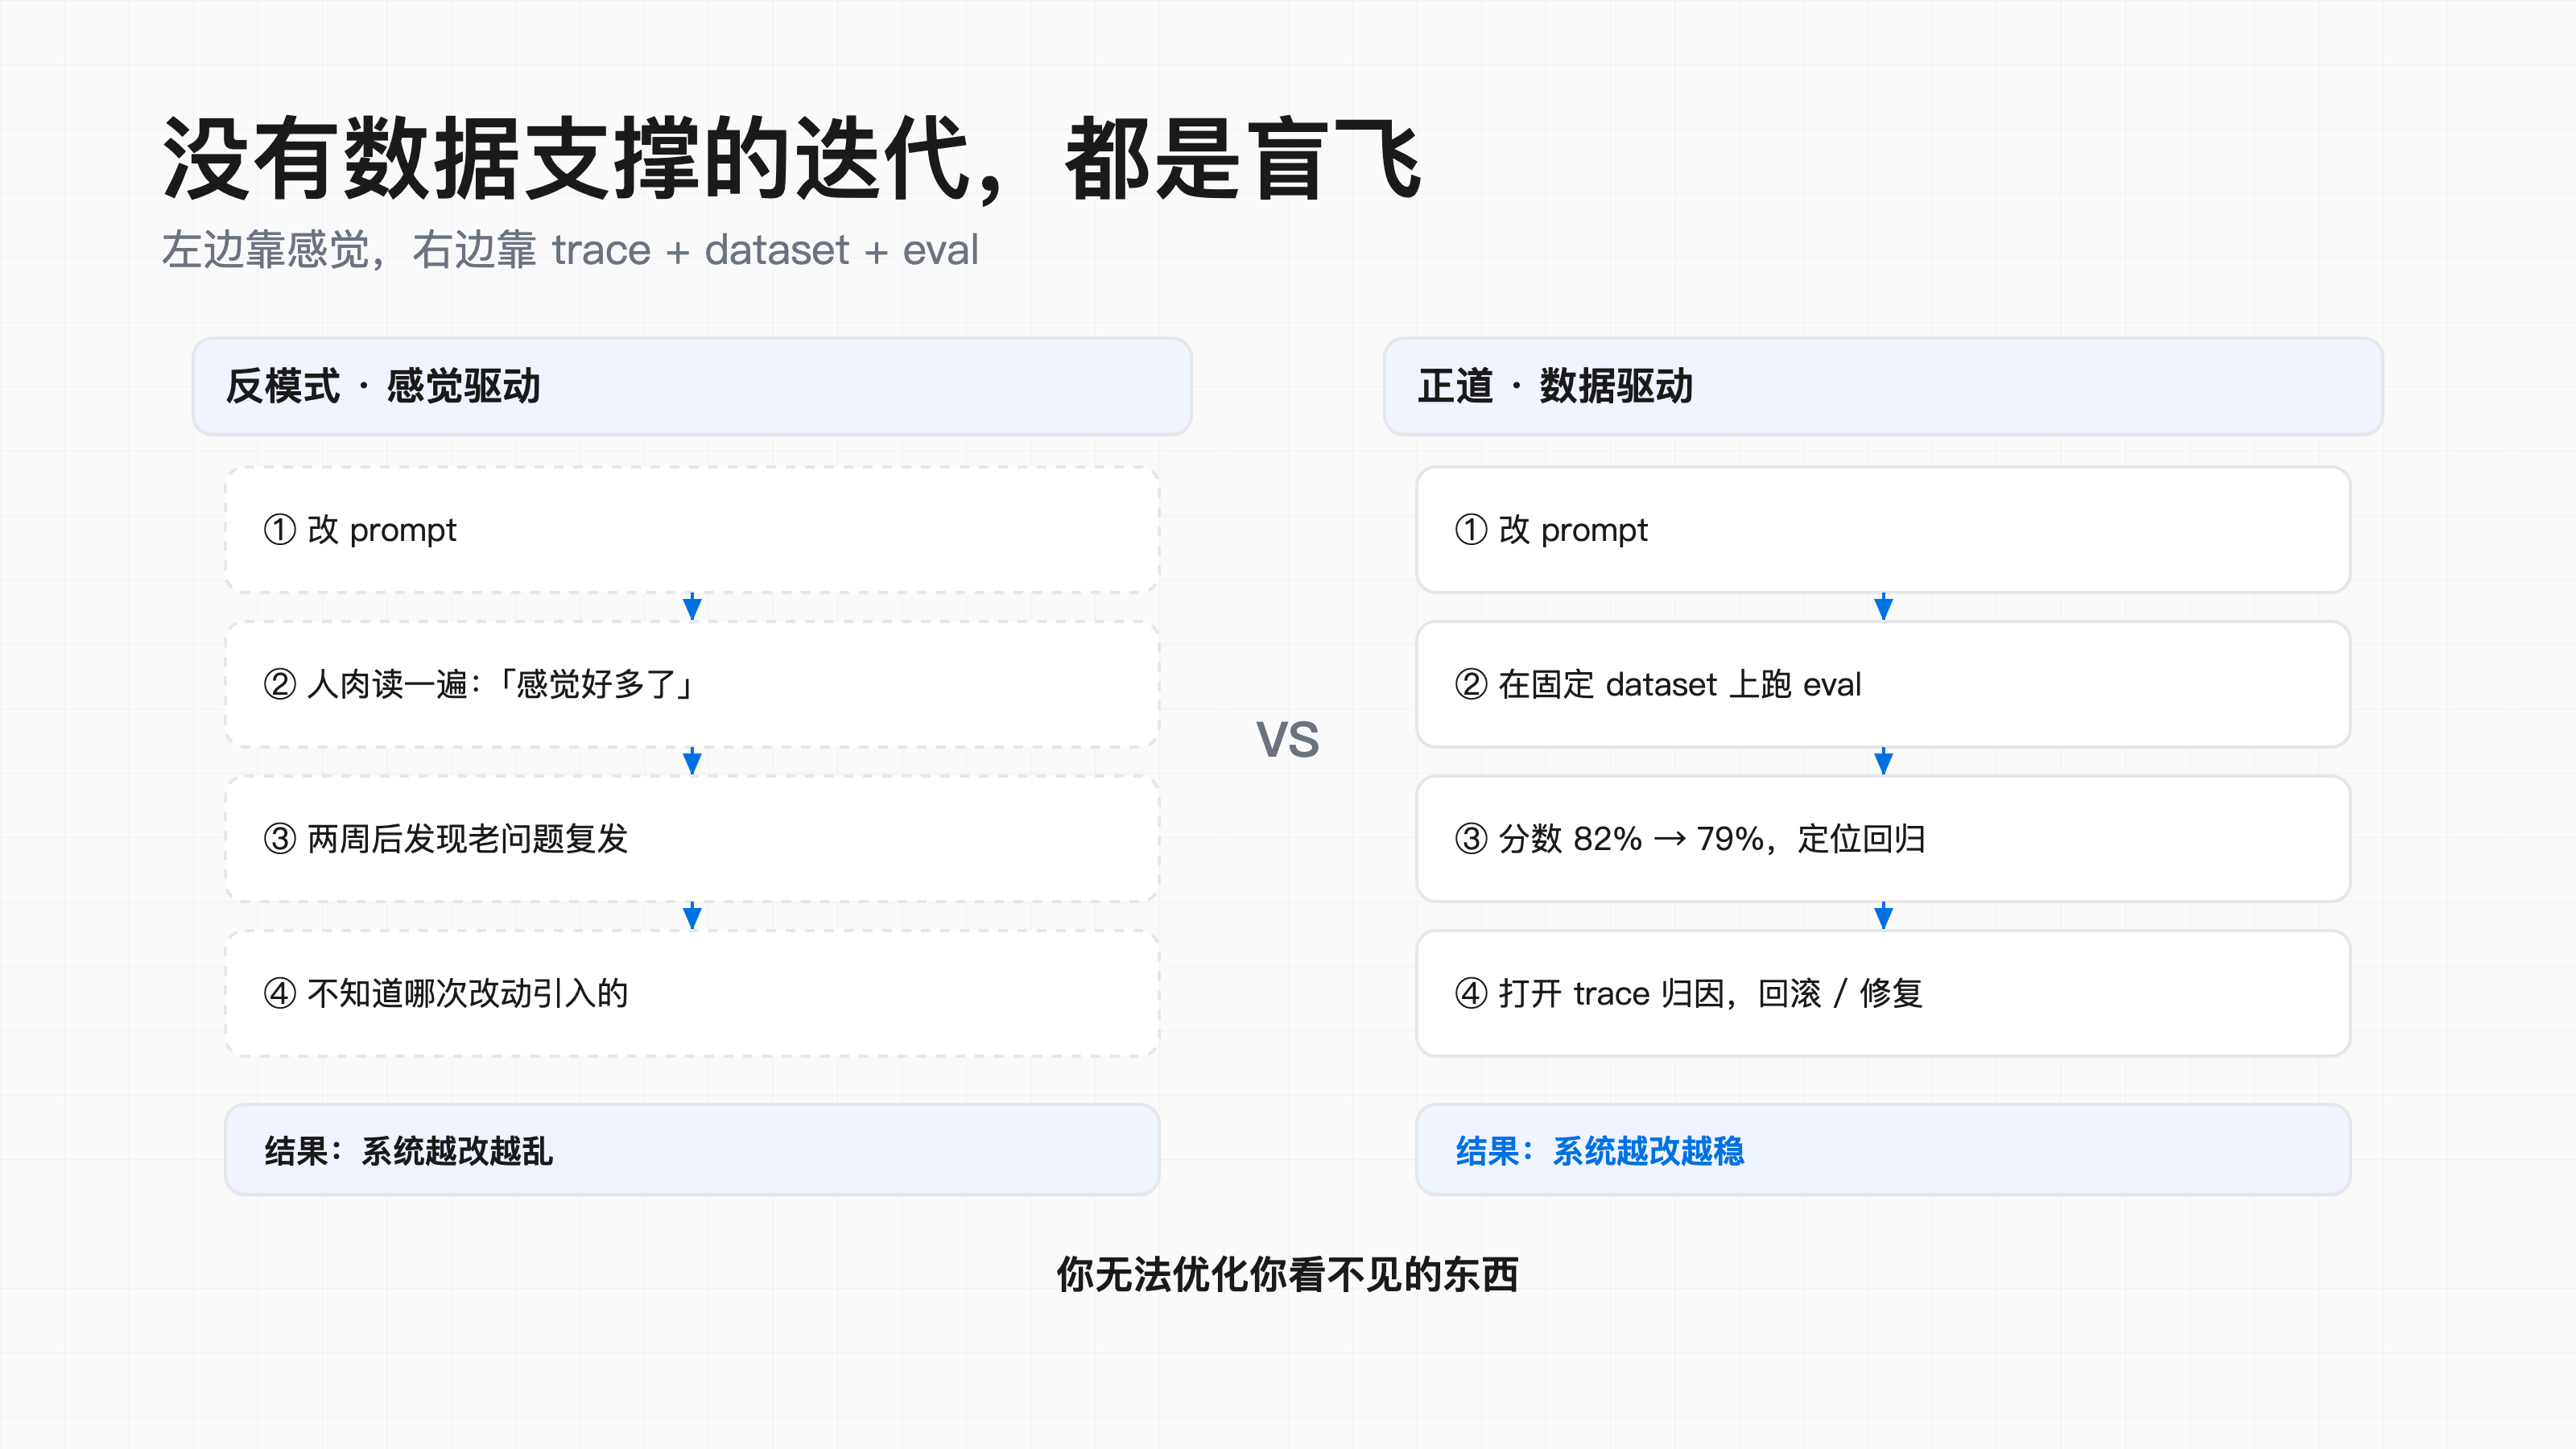
你有没有过这种体验:上周线上一个 RAG 问答答得挺好,这周用同样的问法再问,回答却跑题了。你去翻日志,只看到一行 HTTP 200 和模型吐出的字符串,至于它当时检索了哪些文档、套了哪个版本的 prompt、为什么拐进那条工具调用路径,一律查不到。问题就出在这里——LLM 应用是**非确定性系统**,同样的输入在不同时刻、不同温度、不同检索结果下会产生不同输出。传统日志记的是"发生了什么",而你需要的是"为什么发生"以及"每一步的中间态"。这正是可观测性要先于优化的根因:你没法优化一个看不见的过程。 ![](https://developer.qcloudimg.com/http-save/yehe-2775261/0e50d8220d66a1d05494a290347e5850.png) ## 非确定性:同样输入,下一秒可能是另一个答案 把 LLM 应用当成普通后端服务来排障,是很多人踩的第一个坑。一个普通的 CRUD 接口,同样的请求两次,执行路径完全一致;但 LLM 应用的每一步都带着随机性。 造成差异的来源至少有这几处: - **采样温度** temperature 不为 0 时,decode 本来就是按概率分布抽样,两次生成天然不同。 - **检索漂移** 向量库的召回结果会随数据更新、索引重建而变动,retriever 这一步本身就不稳定。 - **工具副作用** 同一个工具在不同时间返回的数据可能不同(实时行情、库存、天气),下游 prompt 拿到的上下文随之改变。 - **隐式版本** 你以为 prompt 没动,其实上游拼接逻辑、few-shot 样例、系统指令哪天被悄悄改了一行,自己都忘了。 所以当你说"这次回答好像比上次好",你其实是在拿**两个不可复现的随机样本**做主观对比。没有把每次运行的完整链路固定下来,你的"好"没有任何可比基线。 ![](https://developer.qcloudimg.com/http-save/yehe-2775261/200bb496d9e35a4971f92518c8e22449.png) ## 一次 trace 里到底装了什么 LangSmith 的核心动作叫 tracing:把一次运行(run)从头到尾的每一步都结构化记录下来。一个 run 不是一条日志行,而是一棵树,树上的每个节点是一个 span,span 之间还有父子关系。 用 `@traceable` 注解你的函数,调用时就会自动生成 span: ``` from langsmith import traceable from langchain_openai import ChatOpenAI @traceable(name="retrieve", run_type="retriever") def retrieve(query: str) -> list: # 召回相关文档,并保留 score 方便复盘 return vectorstore.similarity_search_with_score(query, k=4) @traceable(name="generate", run_type="llm") def generate(query: str, docs: list) -> str: llm = ChatOpenAI(model="gpt-4o", temperature=0.2) return llm.invoke(build_prompt(query, docs)).content ``` 一个完整的 trace 至少该包含这些字段: - **Input / Output** 这一步真实的入参和返回,已渲染好的最终 prompt 全文。 - **Model 与参数** 具体模型、temperature、top_p,杜绝"我以为是那个版本"。 - **Retriever 结果** 召回的文档片段和对应的相似度分数。 - **Tool Calls** 调用了哪个工具、传了什么参数、拿到什么结果。 - **Token 用量** prompt_tokens / completion_tokens,直接挂钩成本。 - **延迟与成本** 每一步和整体的 latency、单次花费。 这些字段合在一起,某次回答变差时你不用猜——直接点开那条 trace,看是 retriever 召回错了文档,还是 model 抽到了一个低概率 token。 ![](https://developer.qcloudimg.com/http-save/yehe-2775261/b9d223d3ab53687f7f9a00001116f527.png) ## 三件套不是功能清单,是一个飞轮 很多人把 LangSmith 当成一个"能看 trace 的面板",这是把它用小了。Tracing、Dataset、Evaluation 三者的关系不是并列功能,而是一个**自我强化的飞轮**。 - **Tracing 是原料** 每一次线上/线下的运行都在产生 trace,这是最真实的系统行为样本。 - **Dataset 是沉淀** 你从 trace 里挑出有价值的 case(典型问题、边界场景、历史事故),固化成可复现的测试用例集。 - **Evaluation 是度量** 在新 prompt / 新模型 / 新检索策略上把这个 dataset 跑一遍,得到可量化的分数,作为这次改动好坏的判据。 关键点在于闭环:eval 的结果告诉你哪里还不行,你针对性改完,再跑 eval 验证——**改动的每一轮都有数据兜底**。没有 dataset,eval 就是空转;没有 eval,你根本不知道这次改动是前进还是倒车。 开启 tracing 只需要几行环境变量,之后任意 LangChain 调用自动上报: ``` import os os.environ["LANGCHAIN_TRACING_V2"] = "true" os.environ["LANGCHAIN_API_KEY"] = "lsv2_xxx" os.environ["LANGCHAIN_PROJECT"] = "rag-prod-monitor" # 此后所有调用自动产生 trace ``` 沉淀测试集并在其上评估,同样几行就能跑起来: ``` from langsmith import Client from langsmith.evaluation import evaluate client = Client() # 从复盘过的 trace 中固化回归集 dataset = client.create_dataset( "rag-qa-regression", description="RAG 回归集:覆盖多跳、拒答、幻觉高风险场景", ) client.create_examples( inputs=[{"question": "A 和 B 谁先成立?"}], outputs=[{"answer": "A 先于 B,依据在公司年报第 3 页"}], dataset_id=dataset.id, ) def predict(inputs: dict) -> dict: return {"output": generate(inputs["question"])} evaluate( predict, data="rag-qa-regression", evaluators=["exact_match", correctness_with_llm], experiment_prefix="v0.3-prompt-tune", ) ``` ![](https://developer.qcloudimg.com/http-save/yehe-2775261/97d421a0838ee517abcab4c9b1e19c0d.png) ## 反模式:靠"感觉好点了"驱动迭代 我见过太多团队,prompt 改一版就发到群里说"感觉好多了",然后过两周发现老问题又冒出来,却没人能说清是哪次改动引入的。这就是典型的**盲飞式迭代**。 看一段反模式代码: ``` # 反模式:没有 trace,没有 baseline,纯靠肉眼 def chat(user_msg): reply = llm.invoke(user_msg).content print(reply) # 人肉读一遍,觉得"还行" return reply # 什么都没留下,无法回归 ``` 它的危害不是"这次答错了",而是: - **没有基线** 你不知道改动前的得分是多少,自然判断不了"变好还是变坏"。 - **无法回归** 老问题复发时,你手里没有一份能复现它的测试用例。 - **归因失效** 多个改动叠在一起,出事了你分不清是哪个坑。 - **协作崩塌** 团队里每个人都在"感觉",结论互相矛盾,谁也说服不了谁。 对照之下,有数据支撑的迭代是另一条路径:改 prompt → 在固定 dataset 上跑 eval → 分数从 82% 掉到 79%,立刻知道**这次改动引入了回归** → 打开对应 trace 定位是 retriever 召回退化还是 model 抽样偏移 → 回滚或针对性修复。两种做法的差距,在一次两次改动里看不出,十次八次之后就是"系统越改越稳"和"系统越改越乱"的天壤之别。 ![](https://developer.qcloudimg.com/http-save/yehe-2775261/ebf5285ad67ff2feed912a884f6961a8.png) ## LangSmith 坐在你开发闭环的哪一站 把视角拉到整个开发生命周期,LangSmith 不是某个环节的工具,而是**横穿开发闭环的一条主线**。 从你写代码那一刻起,`@traceable` 就把可观测性织进了函数;本地调试时 trace 实时可见;你把复盘过的 case 沉淀成 Dataset;每次提交用 Evaluation 当门禁,分数不达标不让合并;上线后生产环境的 trace 继续回流,新的失败 case 又被捞进 dataset。这样 Tracing、Dataset、Evaluation 三件事在同一个数据平面上循环转动。 所以回到开头那句话——**你无法优化你看不见的东西**。LangSmith 给你的不是"一个看日志的面板",而是一套让 LLM 应用从玄学调参走向工程迭代的基础设施。先把可观测性立起来,优化才有锚点;先有 dataset 和 eval,每一次改动才走得踏实。

优秀的个人博客,低调大师

OmniRoute 本地模型代理快速入门指南

> 📖 版本:v3.8.51 | 更新时间:2026-09-27 🎯 目标:5 分钟内搭建本地免费 AI 网关 --- ## 1️⃣ 安装运行 ### 方式 A:npm(推荐) ``` # 全局安装 npm install -g omniroute # 启动服务 omniroute ``` ### 方式 B:Docker ``` docker run -d --name omniroute \ -p 127.0.0.1:20128:20128 \ -v omniroute-data:/app/data \ diegosouzapw/omniroute:latest ``` ### 访问地址 - **Dashboard(Web 界面)**:[http://localhost:20128](http://localhost:20128/) - **API 端点**:[http://localhost:20128/v1](http://localhost:20128/v1) --- ## 2️⃣ 连接免费提供商(零配置) 首次启动后,在 Dashboard 中连接免费提供商: 1. 访问 [http://localhost:20128](http://localhost:20128/) 1. 点击左侧 **Providers** 菜单 1. 点击 **Connect** 按钮选择免费提供商: - **OpenCode Free**:无需认证 - **Z.AI / Zhipu (glm-cn)**:GLM-4-Flash / 4.5-Flash / 4.7-Flash 永久免费 + 20M 注册奖励 - **NVIDIA NIM**:GLM, MiniMax ~40 RPM 免费 - **Mistral**:~1B tokens/月 --- ## 3️⃣ 配置编码工具 在 Claude Code、Codex、Cursor、OpenCode 等工具中配置 OmniRoute: |配置项|值| | --- | --- | |Base URL|http://localhost:20128/v1| |API Key|从 Dashboard → Endpoints 复制| |Model|auto(智能路由)或指定提供商模型| ### 示例(Claude Code) ``` # 在 Claude Code 配置文件中设置 export ANTHROPIC_BASE_URL="http://localhost:20128/v1" export ANTHROPIC_API_KEY="YOUR_OMNIROUTE_API_KEY" ``` --- ## 4️⃣ 验证安装 ``` curl http://localhost:20128/v1/models \ -H "Authorization: Bearer YOUR_OMNIROUTE_API_KEY" ``` 如果返回模型列表,说明配置成功 ✅ --- ## 5️⃣ 多手机号注册免费 API(简略说明) ### Z.AI (智谱) 1. 访问 Z.AI 官网注册账号 1. 在控制台获取 API Key 1. 在 OmniRoute Dashboard → Providers → 添加自定义提供商: - **Provider Name**: `glm-cn` - **API Key**: `YOUR_ZHIPU_API_KEY` - **Base URL**: `https://open.bigmodel.cn/api/paas/v4` ### NVIDIA NIM 1. 注册 NVIDIA 开发者账号 1. 在 NVIDIA NIM 控制台申请免费层 1. 获取 API Key 并在 OmniRoute 中配置 ### 注意事项 - 各提供商通常有每月免费额度,建议注册多个账号分散使用 - 部分提供商需要实名认证(如 ModelScope) - 查看详细免费层级:[http://localhost:20128/dashboard/free-tiers](http://localhost:20128/dashboard/free-tiers) --- ## 6️⃣ Combos 多提供商组合 OmniRoute 支持 19 种路由策略,自动实现负载均衡和故障回退: - **auto/coding**:智能编码路由(默认) - **auto/fast**:优先快速响应 - **auto/cheap**:优先低成本模型 - **auto/smart**:综合智能路由 - **fusion**:并行调用多个模型,通过 judge 综合答案 - **pipeline**:模型链式调用 配置路径:Dashboard → Combos → 创建新 Combo ### 示例:新建 aotoFree 组合(智能路由) 1. 访问 Dashboard → Combos → 创建新 Combo 1. 组合名称填写 `aotoFree` 1. 路由策略选择 **智能路由(auto)** 1. 添加所需提供商后保存 --- ## 7️⃣ 压缩功能(可选) OmniRoute 内置 RTK + Caveman 压缩引擎,可节省 15–95% tokens: 1. 访问 Dashboard → Context & Cache 1. 启用 Caveman 或 RTK 压缩 1. 设置压缩组合(如 `rtk → caveman`) --- ## 8️⃣ 常用命令 ``` # 查看提供商列表 omniroute providers # 查看组合配置 omniroute combos # 诊断健康状态 omniroute doctor # 重置配置 omniroute setup ``` --- ## 📊 免费层级概览 |提供商|每月免费额度|备注| | --- | --- | --- | |Mistral|~1B tokens|首选通用模型| |Nara|~210M tokens|多模态支持| |LLM7|~150M tokens|代码模型| |Z.AI (glm-cn)|永久免费 + 20M|GLM-4/4.5/4.7 Flash| |NVIDIA NIM|~40 RPM|GLM, MiniMax| **总计**:~1.37B 每月免费 tokens(不含注册奖励) --- ## 🎉 完成 现在您已拥有本地免费 AI 网关,支持 359 个提供商、1200+ 模型,自动负载均衡和故障回退。 **下一步**: - 查看 Dashboard → Usage 监控使用情况 - 探索 Combos → 配置多提供商组合 - 启用压缩 → 节省 tokens 成本 --- **文档来源**: - OmniRoute GitHub:[https://github.com/diegosouzapw/OmniRoute](https://github.com/diegosouzapw/OmniRoute) - 免费层级文档:[https://github.com/diegosouzapw/OmniRoute/blob/release/v3.8.51/docs/reference/FREE_TIERS.md](https://github.com/diegosouzapw/OmniRoute/blob/release/v3.8.51/docs/reference/FREE_TIERS.md) - 特性画廊:[https://github.com/diegosouzapw/OmniRoute/blob/release/v3.8.51/docs/guides/FEATURES.md](https://github.com/diegosouzapw/OmniRoute/blob/release/v3.8.51/docs/guides/FEATURES.md)

优秀的个人博客,低调大师

基于 LlamaIndex 实现RAG向量检索入门

本章将通过多个案例实现私有数据集检索功能,虽然 LangChain 也可以实现向量检索,但在企业级项目中,通常会选用 LlamaIndex 这类专门面向检索场景的框架。LlamaIndex 是 MIT 协议开源、以 RAG 为核心的大模型应用开发框架。它充当大模型与私有数据之间的中间层,能够接入 PDF、Word 等各类本地或内网文档,对原始数据构建索引,以此解决大模型无法读取私有资料、容易产生幻觉的问题,可用于搭建知识问答、AI 智能体等应用。 - 项目地址:[https://github.com/run-llama/llama_index](https://github.com/run-llama/llama_index) # 一、环境部署 本项目需要部署两个轻量化GGUF量化模型,分别承担对话交互与语义向量检索能力,适配本地低资源部署场景。其中对话大模型负责承接用户提问、逻辑推理、文本生成等通用对话任务;Embedding向量嵌入模型负责将文本、语句等非结构化数据转化为低维稠密向量,让计算机能够量化计算文本间的语义相似度,实现精准检索、内容匹配、知识库召回等功能。 - 对话模型:[https://www.modelscope.cn/models/LoveSeaW/Qwen2.5-1.5b-instruct-gguf](https://www.modelscope.cn/models/LoveSeaW/Qwen2.5-1.5b-instruct-gguf) - 向量模型:[https://www.modelscope.cn/models/guweigui/Qwen3-Embedding-0.6B-Q8_0-GGUF](https://www.modelscope.cn/models/guweigui/Qwen3-Embedding-0.6B-Q8_0-GGUF) 我们通过`llama-server`分别启动两个模型服务,绑定不同本地端口,独立提供对话推理和向量生成能力。 加载通义千问对话量化模型,绑定`127.0.0.1`本地`11433`端口,设置`4096`上下文窗口,满足日常对话、文本生成、问答推理需求。 ``` CMD> llama-server.exe -m qwen2.5-1.5b-instruct-q4_k_m.gguf --host 127.0.0.1 --port 11433 -c 4096 load_model: loading model 'qwen2.5-1.5b-instruct-q4_k_m.gguf' llama_server: model loaded llama_server: listening on http://127.0.0.1:11433 ``` 加载向量量化模型,需额外配置专属参数开启向量生成能力 `--embeddings` 开启向量嵌入功能,`--pooling mean` 采用均值池化策略聚合文本向量,保证语义表征精准;同时限制批次参数提升本地部署稳定性。 ``` CMD> llama-server.exe -m Qwen3-Embedding-0.6B-Q8_0.gguf --host 127.0.0.1 --port 11434 -c 4096 --embeddings --pooling mean -b 512 -ub 512 load_model: loading model 'Qwen3-Embedding-0.6B-Q8_0.gguf' llama_server: model loaded llama_server: listening on http://127.0.0.1:11434 ``` 批量安装RAG项目所需核心依赖,包含框架、向量数据库、文档解析、接口适配等全量包。 ``` # 配置国内PIP源 CMD> pip config set global.index-url https://mirrors.tuna.tsinghua.edu.cn/pypi/web/simple CMD> pip config set global.trusted-host mirrors.tuna.tsinghua.edu.cn CMD> pip config list # 安装核心包 CMD> pip install llama-index # 或安装完整版本(包含所有依赖) CMD> pip install llama-index[complete] # 向量数据库支持 CMD> pip install chromadb CMD> pip install pinecone-client CMD> pip install weaviate-client # 文档解析支持 CMD> pip install pypdf CMD> pip install docx2txt CMD> pip install python-pptx # 检索接口通信包 CMD> pip install llama-index-core llama-index-llms-openai-like CMD> pip install llama-index-embeddings-openai CMD> pip list Package Version ---------------------------------------- ----------- llama-index 0.14.24 llama-index-core 0.14.24 llama-index-embeddings-openai 0.6.0 llama-index-instrumentation 0.6.0 llama-index-llms-openai 0.7.10 llama-index-llms-openai-like 0.8.0 llama-index-workflows 2.23.3 ``` ## 测试Chat对话接口 通过`LlamaIndex`的`OpenAI`兼容接口,对接本地`11433`端口对话服务,实现基础大模型问答调用,验证对话服务可用性。本地`llama-server`兼容`OpenAI`接口格式,可直接通过通用类适配调用,无需额外改造服务端。 ``` import os from llama_index.core import Settings from llama_index.llms.openai_like import OpenAILike os.environ["OPENAI_API_KEY"] = "dummy" os.environ["OPENAI_BASE_URL"] = "http://127.0.0.1:11433/v1" llm = OpenAILike( model="qwen2.5-1.5b-instruct-q4_k_m.gguf", api_base=os.environ["OPENAI_BASE_URL"], api_key=os.environ["OPENAI_API_KEY"], is_chat_model=True, context_window=4096 ) if __name__ == "__main__": Settings.llm = llm resp = llm.complete("你好,大模型!") print(resp) ``` 代码运行输出提示信息: ``` 你好!我是阿里云的大规模语言模型,我叫通义千问。 ``` ## 测试Embedding向量接口 LlamaIndex无默认的本地`llama-server`向量模型适配接口,因此需要自定义`Embedding`调用类,对接11434端口向量服务,搭建完整的「文档加载-分块向量化-索引存储-语义检索-大模型生成」RAG流程。 在项目根目录新建 `data` 文件夹,创建 `test.txt` 测试文档,写入RAG相关测试语料,用于后续检索验证 ``` 1. 人工智能大模型能够理解人类自然语言 2. 大模型基于海量文本数据进行预训练 3. 向量数据库用来存储文本对应的向量嵌入 4. 向量检索通过计算向量相似度找到相似内容 5. 文本嵌入模型可以把句子转为多维向量 6. 语义检索不依赖关键词匹配,理解句子含义 7. 关键词检索只匹配字面文字,无法理解语义 8. RAG检索增强生成依靠检索外部知识库 9. RAG可以降低大模型产生幻觉的概率 10. 分块策略会影响知识库检索的效果 ``` 使用向量检索代码,先自定义对接本地 `embedding` 服务`LocalLlamaServerEmbedding`实现文本向量化,配置`OpenAILike`接入本地大模型作为LLM,设置全局 `Settings` 指定模型,运行时读取文档,加载文档后构建内存向量索引,生成查询引擎,最后发起查询让大模型基于检索到的文档片段总结文档核心内容。 - **运行逻辑:**自定义本地向量模型调用类 → 绑定本地对话LLM与向量Embedding模型 → 加载本地文档构建向量索引 → 语义检索+大模型总结生成答案 ``` import os import requests from typing import List from llama_index.core import Settings, SimpleDirectoryReader, VectorStoreIndex from llama_index.core.embeddings import BaseEmbedding from llama_index.llms.openai_like import OpenAILike # 自定义Embedding模型 class LocalLlamaServerEmbedding(BaseEmbedding): api_base: str api_key: str = "dummy" def _get_embedding(self, text: str) -> List[float]: url = f"{self.api_base}/embeddings" payload = { "input": text, "model": "Qwen3-Embedding-0.6B-Q8_0.gguf" } headers = {"Authorization": f"Bearer {self.api_key}"} resp = requests.post(url, json=payload, headers=headers) resp.raise_for_status() return resp.json()["data"][0]["embedding"] def _get_text_embedding(self, text: str) -> List[float]: return self._get_embedding(text) def _get_query_embedding(self, query: str) -> List[float]: return self._get_embedding(query) async def _aget_query_embedding(self, query: str) -> List[float]: return self._get_embedding(query) async def _aget_text_embedding(self, text: str) -> List[float]: return self._get_embedding(text) # 对话模型地址 os.environ["OPENAI_API_KEY"] = "dummy" os.environ["OPENAI_BASE_URL"] = "http://127.0.0.1:11433/v1" llm = OpenAILike( model="qwen2.5-1.5b-instruct-q4_k_m.gguf", api_base=os.environ["OPENAI_BASE_URL"], api_key=os.environ["OPENAI_API_KEY"], is_chat_model=True, context_window=1024 ) # 向量模型地址 Settings.llm = llm Settings.embed_model = LocalLlamaServerEmbedding(api_base="http://127.0.0.1:11434/v1") if __name__ == "__main__": # 构建RAG索引 过滤出pdf.docx.txt文件 documents = SimpleDirectoryReader( "./data/", required_exts=[".pdf", ".docx", ".txt"] ).load_data() # 创建索引 index = VectorStoreIndex.from_documents(documents) # 创建查询引擎 query_engine = index.as_query_engine() # 进行查询 response = query_engine.query("请总结文档里面的核心内容,使用汉语回复") print("\n回答:") print(response) ``` 代码运行输出提示信息: ``` 回答: 文档的核心内容是关于人工智能大模型如何理解和处理自然语言 以及如何通过向量数据库和向量检索技术来处理和查找文本内容。 ``` # 二、实际应用 ## 使用向量数据库 该代码基于 Llama Index 框架,自定义对接本地 Qwen3 嵌入模型的 Embedding 类,使用本地 OpenAI 兼容接口的 Qwen2.5 大模型,实现向量索引的创建、持久化存储与加载,读取 pdf、docx、txt 文档构建向量库,通过查询引擎检索 top3 相关文本片段并交由大模型回答用户问题。 ``` import os import requests from typing import List from llama_index.core.embeddings import BaseEmbedding from llama_index.llms.openai_like import OpenAILike from llama_index.core import ( VectorStoreIndex, SimpleDirectoryReader, Settings, StorageContext, load_index_from_storage ) # 自定义Embedding模型 class LocalLlamaServerEmbedding(BaseEmbedding): api_base: str api_key: str = "dummy" def _get_embedding(self, text: str) -> List[float]: url = f"{self.api_base}/embeddings" payload = { "input": text, "model": "Qwen3-Embedding-0.6B-Q8_0.gguf" } headers = {"Authorization": f"Bearer {self.api_key}"} resp = requests.post(url, json=payload, headers=headers) resp.raise_for_status() return resp.json()["data"][0]["embedding"] def _get_text_embedding(self, text: str) -> List[float]: return self._get_embedding(text) def _get_query_embedding(self, query: str) -> List[float]: return self._get_embedding(query) async def _aget_query_embedding(self, query: str) -> List[float]: return self._get_embedding(query) class IndexManager: """索引管理器:负责向量索引的创建、持久化与加载""" def create_index(self, data_dir="./data/", persist_dir="./storage/"): """创建并持久化向量索引""" try: documents = SimpleDirectoryReader( data_dir, required_exts=[".pdf", ".docx", ".txt"], recursive=False ).load_data() except Exception as err: print(f"[文档读取解析失败]错误信息:{err}") raise err print(f"成功读取文档片段数量:{len(documents)}") index = VectorStoreIndex.from_documents(documents) index.storage_context.persist(persist_dir=persist_dir) return index def load_index(self, persist_dir="storage"): """加载磁盘上已持久化的索引""" storage_context = StorageContext.from_defaults(persist_dir=persist_dir) index = load_index_from_storage(storage_context) return index if __name__ == "__main__": # 对话模型地址 os.environ["OPENAI_API_KEY"] = "dummy" os.environ["OPENAI_BASE_URL"] = "http://127.0.0.1:11433/v1" llm = OpenAILike( model="qwen2.5-1.5b-instruct-q4_k_m.gguf", api_base=os.environ["OPENAI_BASE_URL"], api_key=os.environ["OPENAI_API_KEY"], is_chat_model=True, context_window=1024 ) # 向量模型地址 Settings.llm = llm Settings.embed_model = LocalLlamaServerEmbedding(api_base="http://127.0.0.1:11434/v1") # 初始化管理器 manager = IndexManager() index = None try: index = manager.load_index() print("索引加载成功") except Exception as e: print(f"索引加载失败:{e},创建新索引...") index = manager.create_index() # 查询索引 返回相似度最高的前3个文档片段 query_engine = index.as_query_engine( similarity_top_k=3, response_mode="compact" ) resp = query_engine.query("简单概述文档内容,并回答中文简体。") print(f"回答:{resp}\n") ``` 代码运行输出提示信息: ``` 索引加载成功 回答: 文档内容主要介绍了人工智能大模型如何理解和处理自然语言,以及如何通过预训练和向量数据库来存储和检索文本数据。 文档中提到的步骤包括: 1. 人工智能大模型能够理解人类自然语言 2. 大模型基于海量文本数据进行预训练 3. 向量数据库用来存储文本对应的向量嵌入 ``` ## 使用文档检索 这段代码在向量数据库基础上做了封装优化,新增句子文本分片器,在 IndexManager 类中统一完成本地大模型与自定义 Embedding 的初始化,加载或重建向量索引,对外提供问答接口,返回问题答案同时附带检索到的文档源元数据,并且设置系统提示词约束大模型基于文档作答。 ``` import os import requests from typing import List from llama_index.core.embeddings import BaseEmbedding from llama_index.llms.openai_like import OpenAILike from llama_index.core.node_parser import SentenceSplitter from llama_index.core import ( VectorStoreIndex, SimpleDirectoryReader, Settings, StorageContext, load_index_from_storage ) # 自定义Embedding模型 class LocalLlamaServerEmbedding(BaseEmbedding): api_base: str api_key: str = "dummy" def _get_embedding(self, text: str) -> List[float]: url = f"{self.api_base}/embeddings" payload = { "input": text, "model": "Qwen3-Embedding-0.6B-Q8_0.gguf" } headers = {"Authorization": f"Bearer {self.api_key}"} resp = requests.post(url, json=payload, headers=headers) resp.raise_for_status() return resp.json()["data"][0]["embedding"] def _get_text_embedding(self, text: str) -> List[float]: return self._get_embedding(text) def _get_query_embedding(self, query: str) -> List[float]: return self._get_embedding(query) async def _aget_query_embedding(self, query: str) -> List[float]: return self._get_embedding(query) async def _aget_text_embedding(self, text: str) -> List[float]: return self._get_embedding(text) class IndexManager: def __init__(self, data_dir="./data/", persist_dir="./storage/"): self.data_dir = data_dir self.persist_dir = persist_dir self.setup_llm() self.index = self.load_database() def setup_llm(self): os.environ["OPENAI_API_KEY"] = "dummy" os.environ["OPENAI_BASE_URL"] = "http://127.0.0.1:11433/v1" llm = OpenAILike( model="qwen2.5-1.5b-instruct-q4_k_m.gguf", api_base=os.environ["OPENAI_BASE_URL"], api_key=os.environ["OPENAI_API_KEY"], is_chat_model=True, context_window=1024, temperature=0.1, system_prompt="""你是一个企业文档助手。 请基于提供的文档内容回答问题,如果文档中没有相关信息,请明确说明。 回答要准确、简洁、专业。""" ) # Embedding模型 embed_model = LocalLlamaServerEmbedding( api_base="http://127.0.0.1:11434/v1" ) # 全局设置 Settings.llm = llm Settings.embed_model = embed_model # 分段器配置 分片大小 512 重叠 50 个字符 Settings.node_parser = SentenceSplitter(chunk_size=512, chunk_overlap=50) def load_database(self): if os.path.exists(self.persist_dir): try: storage_context = StorageContext.from_defaults( persist_dir=self.persist_dir ) index = load_index_from_storage(storage_context) print("[+] 索引加载成功") return index except Exception as e: print(f"[-] 索引加载失败,原因:{e},重新创建...") # 不存在目录 加载失败 则新建索引 documents = SimpleDirectoryReader( self.data_dir, required_exts=[".pdf", ".docx", ".txt"], recursive=False ).load_data() print(f"[+] 读取文档片段数量:{len(documents)}") index = VectorStoreIndex.from_documents(documents) index.storage_context.persist(persist_dir=self.persist_dir) print("[+] 索引创建并持久化完成") return index def get_query_engine(self, similarity_top_k=3): """获取默认查询引擎,可后续替换为混合检索引擎""" return self.index.as_query_engine(similarity_top_k=similarity_top_k) def query(self, question, top_k=3): query_engine = self.index.as_query_engine( similarity_top_k=top_k, response_mode="compact" ) response = query_engine.query(question) return { "question": question, "answer": str(response), "sources": [node.metadata for node in response.source_nodes] } if __name__ == "__main__": manager = IndexManager(data_dir="./data/", persist_dir="./storage/") res = manager.query("请简单概述文章内容,15个字以内。") print("问题:", res["question"]) print("回答:", res["answer"]) print("来源:", res["sources"]) query_engine = manager.get_query_engine() response = query_engine.query("请简述文档内容,中文回答。") print(f"回答:{response}") ``` 代码运行输出提示信息: ``` [+] 索引加载成功 问题: 请简单概述文章内容,15个字以内。 回答: RAG检索增强生成依靠检索外部知识库,可以降低大模型产生幻觉的概率,分块策略会影响知识库检索的效果。 来源: [ { 'file_path': 'C: \\Users\\Admin\\data\\test.txt', 'file_name': 'test.txt', 'file_type': 'text/plain', 'file_size': 562, 'creation_date': '2026-09-17', 'last_modified_date': '2026-09-17' } ] 回答:文档内容描述了人工智能大模型能够理解人类自然语言,大模型基于海量文本数据进行预训练,向量数据库用来存储文本对应的向量嵌入。 ``` ## 使用文档摘要 代码改用 LlamaIndex 的 SummaryIndex 摘要索引,复用本地 Qwen 大模型与自定义嵌入模型,读取本地文档后支持生成简洁摘要、详细摘要以及提取文档关键要点,采用 tree_summarize 模式对文档内容做汇总,适合对文档整体内容进行归纳提取。 ``` import os import requests from typing import List from llama_index.core.embeddings import BaseEmbedding from llama_index.llms.openai_like import OpenAILike from llama_index.core.node_parser import SentenceSplitter from llama_index.core import ( SummaryIndex, SimpleDirectoryReader, Settings ) class LocalLlamaServerEmbedding(BaseEmbedding): api_base: str api_key: str = "dummy" def _get_embedding(self, text: str) -> List[float]: url = f"{self.api_base}/embeddings" payload = { "input": text, "model": "Qwen3‑Embedding‑0.6B‑Q8_0.gguf" } headers = {"Authorization": f"Bearer {self.api_key}"} resp = requests.post(url, json=payload, headers=headers) resp.raise_for_status() return resp.json()["data"][0]["embedding"] def _get_text_embedding(self, text: str) -> List[float]: return self._get_embedding(text) def _get_query_embedding(self, query: str) -> List[float]: return self._get_embedding(query) async def _aget_query_embedding(self, query: str) -> List[float]: return self._get_embedding(query) class DocumentSummarizer: def __init__(self): self.setup_llm() def setup_llm(self): os.environ["OPENAI_API_KEY"] = "dummy" os.environ["OPENAI_BASE_URL"] = "http://127.0.0.1:11433/v1" llm = OpenAILike( model="qwen2.5-1.5b-instruct-q4_k_m.gguf", api_base=os.environ["OPENAI_BASE_URL"], api_key=os.environ["OPENAI_API_KEY"], is_chat_model=True, context_window=1024, temperature=0.3, system_prompt="你是一个专业的文档摘要助手,请提供准确、简洁的摘要。" ) embed_model = LocalLlamaServerEmbedding(api_base="http://127.0.0.1:11434/v1") Settings.llm = llm Settings.embed_model = embed_model Settings.node_parser = SentenceSplitter(chunk_size=512, chunk_overlap=50) def summarize_documents(self, documents, summary_type="brief"): try: summary_index = SummaryIndex.from_documents(documents) except Exception as e: print(f"[构建SummaryIndex失败]{e}") raise e # 三个选择摘要类型 if summary_type == "brief": prompt = "请为这些文档生成一个简洁的摘要,突出主要观点。" elif summary_type == "detailed": prompt = "请为这些文档生成一个详细的摘要,包括关键信息和重要细节。" else: prompt = "请为这些文档生成摘要。" query_engine = summary_index.as_query_engine( response_mode="tree_summarize" ) response = query_engine.query(prompt) return str(response) def extract_key_points(self, documents): try: summary_index = SummaryIndex.from_documents(documents) except Exception as e: print(f"[构建SummaryIndex失败]{e}") raise e query_engine = summary_index.as_query_engine() response = query_engine.query( "请列出这些文档中的关键要点,以项目符号的形式呈现。" ) return str(response) if __name__ == "__main__": summarizer = DocumentSummarizer() try: documents = SimpleDirectoryReader( "./data/", required_exts=[".pdf", ".docx", ".txt"], recursive=False ).load_data() except Exception as err: print(f"[文档读取解析失败]错误信息:{err}") raise err print(f"读取文档片段数:{len(documents)}") brief_summary = summarizer.summarize_documents(documents, "brief") print("[简洁摘要]") print(brief_summary) detailed_summary = summarizer.summarize_documents(documents, "detailed") print("[详细摘要]") print(detailed_summary) key_points = summarizer.extract_key_points(documents) print("[关键要点]") print(key_points) ``` 代码运行输出提示信息: ``` 读取文档片段数:1 [简洁摘要] 这些文档的主要观点包括: 1. 人工智能大模型能够理解人类自然语言。 2. 大模型基于海量文本数据进行预训练。 3. 向量数据库用来存储文本对应的向量嵌入。 4. 向量检索通过计算向量相似度找到相似内容。 5. 文本嵌入模型可以把句子转为多维向量。 6. 语义检索不依赖关键词匹配,理解句子含义。 7. 关键词检索只匹配字面文字,无法理解语义。 8. RAG检索增强生成依靠检索外部知识库。 9. RAG可以降低大模型产生幻觉的概率。 10. 分块策略会影响知识库检索的效果。 [详细摘要] 这些文档主要讨论了人工智能大模型的几个关键点,包括:1. 人工智能大模型能够理解人类自然语言;2. 大模型基于海量文本数据进行预训练;3. 向量数据库用来存储文本对应的向量嵌入;4. 向量检索通过计算向量相似度 找到相似内容;5. 文本嵌入模型可以把句子转为多维向量;6. 语义检索不依赖关键词匹配,理解句子含义;7. 关键词检索只匹配字面文字,无法理解语义;8. RAG检索增强生成依靠检索外部知识库;9. RAG可以降低大模型产 生幻觉的概率;10. 分块策略会影响知识库检索的效果。 [关键要点] 1. 分块策略会影响知识库检索的效果 ```

优秀的个人博客,低调大师

新手卖家入门指南?

从事跨境业务的卖家大多了解PayPal,它在全球的使用范围广,覆盖了二百多个国家和地区,支持美元、欧元和日元等多种货币收付款。不管是通过独立站、在Instagram或WhatsApp上销售商品,还是接外贸小单,海外买家对PayPal的接受程度都非常高,付款流程也非常简单。所以**很多新手做跨境时,开通的第一个收款工具就是PayPal**。 如果是个人卖家,直接使用身份证注册就可以,若卖家持有营业执照则可以注册企业账户,后续收款额度较高,对接平台也比较顺畅。用户在注册时需要填写邮箱和手机号并设置密码,按照提示完成实名认证即可。完成注册之后,需要绑定一张信用卡或者借记卡,并且开启双重验证,账户更安全。 ![](https://developer.qcloudimg.com/http-save/12667226/74bed52e0ac0a28988511c8340bdac25.jpg) 账户开好了,怎么收款?常见的方式有两种。一种是在电商平台(比如Shopify、TikTok、Depop)后台直接绑定PayPal,货款到账后手动或自动进入卖家的PayPal余额。另一种是做私域或社媒带货的,通过邮箱或在PayPal后台“30秒生成一个付款链接或二维码”,在Instagram、WhatsApp直接发给客户,对方点开就能付。买家可以用PayPal余额、信用卡、借记卡,甚至Apple Pay和先买后付来支付。 收款会产生手续费。**中国大陆收款固定费用是4.4%+固定费用**。新手卖家在收款时,注意要把这部分费用算上。 新手最容易踩的坑是风控。PayPal对账户行为很敏感,新账户如果前期没什么流水,突然进来几千几万美金,很容易触发审核甚至冻结。前期建议先小额、稳定收款,让账户慢慢积累交易记录。如果是新账户,资金可能会进入最多21天的“暂缓”状态,这是PayPal常见的安全机制,按要求上传物流信息或等买家确认收货后,资金会逐步释放。另外,**不要频繁更换登录IP、修改账户资料,这些行为在PayPal系统里都属于高风险操作**。 ![](https://developer.qcloudimg.com/http-save/12667226/22ac877d616410e3478a0141739ceaf0.webp) 钱到账了,怎么提回国内?直接绑定国内银行卡提现,每笔35美元固定手续费。国内部分银行不接收PayPal汇款,提现失败手续费也不退。个人每年还有5万美元的外汇额度限制。如果是流水比较大、绑不上个人银行卡或提现失败的卖家,可以用第三方提现回到国内。 今天的内容就到这里,如果还有什么其他收款问题,可以大家一起讨论看看有没有解决方法,或联系PayPal官方客服解决也可以。

优秀的个人博客,低调大师

Dockerfile 构建镜像:从入门到实践

## 1. 引言 使用 Dockerfile 构建镜像,本质就是把你的应用环境“写”进一个文件,再通过一条命令生成镜像。本文将从最核心的流程讲起,带你掌握常用指令和实用技巧,帮助你快速上手 Docker 镜像构建。 ## 2. 核心流程 下面通过流程图来直观展示整个构建过程: ``` flowchart TD A["编写 Dockerfile"] --> B["执行 docker build"] B --> C["Docker 守护进程解析指令"] C --> D["逐层构建镜像层"] D --> E["输出最终镜像"] ``` ### 2.1 编写 Dockerfile Dockerfile 是一个文本文件,里面包含了一条条构建镜像所需的指令。下面是一个基于 Node.js 应用的示例: ``` # 基础镜像 FROM node:18-alpine # 设置工作目录 WORKDIR /app # 复制依赖文件 COPY package*.json ./ RUN npm install # 复制源码 COPY . . # 声明端口 EXPOSE 3000 # 启动命令 CMD ["node", "app.js"] ``` ### 2.2 构建镜像 在 Dockerfile 所在目录执行以下命令即可构建镜像: ``` docker build -t my-app:v1 . ``` - `-t`:给镜像起名字和标签(`name:tag`) - 末尾的 `.`:指定构建上下文为当前目录 如果文件名不叫 `Dockerfile`,可以用 `-f` 指定: ``` docker build -f MyDockerfile -t my-app . ``` ## 3. 常用指令速览 下表列出了 Dockerfile 中最常用的指令及其作用: |指令|说明| | --- | --- | |FROM|指定基础镜像| |WORKDIR|设定工作目录,后续命令都在此目录下执行| |COPY|把宿主机文件复制到镜像中| |RUN|在构建时执行命令,例如安装依赖| |CMD|容器启动时的默认命令,一个 Dockerfile 中只能有一个有效 CMD| |ENTRYPOINT|容器入口点,常与 CMD 配合使用| |ENV|设置环境变量| |EXPOSE|声明容器监听的端口| ## 4. 实用技巧 ### 4.1 多阶段构建 多阶段构建允许你先在一个中间阶段编译或构建应用,再将最终产物复制到更精简的运行镜像中,从而大幅减小最终镜像的体积。 ``` # 第一阶段:构建 FROM node:18-alpine AS builder WORKDIR /app COPY package*.json ./ RUN npm install COPY . . RUN npm run build # 第二阶段:运行 FROM node:18-alpine WORKDIR /app COPY --from=builder /app/dist ./dist COPY --from=builder /app/node_modules ./node_modules EXPOSE 3000 CMD ["node", "dist/main.js"] ``` ### 4.2 利用构建缓存 Docker 会逐层缓存构建结果。把不经常变动的层(如 `npm install`)放在前面,把改动频繁的 `COPY . .` 往后放,可以充分利用缓存,加快后续构建速度。 ### 4.3 `.dockerignore` 文件 类似于 `.gitignore`,`.dockerignore` 文件用于忽略不需要打包进镜像的文件或目录,例如 `node_modules`、`.git` 等。这不仅能加快构建速度,还能避免敏感文件泄露。 示例 `.dockerignore`: ``` node_modules .git .env Dockerfile .dockerignore ``` ## 5. 总结问题与排查 在 Dockerfile 构建过程中,难免会遇到一些让人头疼的报错。下面整理了 4 个高频错误,并给出排查思路和解决方案。 ### 5.1 COPY 路径错误 **错误信息示例**: ``` COPY failed: file not found in build context or excluded by .dockerignore ``` **常见原因**: - 源路径是相对于构建上下文(build context)的,而不是 Dockerfile 所在目录。 - 目标文件被 `.dockerignore` 排除。 - 路径拼写错误或目录层级不对。 **排查步骤**: 1. 确认 `docker build` 命令末尾的上下文路径(`.`)指向了正确的目录。 1. 检查目标文件是否存在于该目录下(可使用 `ls` 或 `dir` 验证)。 1. 查看 `.dockerignore` 文件,确认没有误排除该文件。 **解决方案**: - 将源路径修改为相对于构建上下文的正确路径,例如:`COPY ./src/app.js /app/` 中 `./src/app.js` 必须相对于构建上下文存在。 - 如果文件确实不在当前上下文,可以调整构建上下文路径,例如 `docker build -f docker/Dockerfile -t my-app .` 将上下文设为父目录,然后 Dockerfile 中使用相对路径 `COPY src/app.js /app/`。 ### 5.2 RUN 命令执行失败 **错误信息示例**: ``` The command '/bin/sh -c apt-get install -y curl' returned a non-zero code: 100 ``` **常见原因**: - 网络不通,导致包管理器无法下载。 - 依赖包版本冲突或仓库索引过期。 - 命令本身语法错误(如多行命令未用 `&&` 连接)。 **排查步骤**: 1. 查看构建日志中 `RUN` 命令输出的详细错误信息。 1. 尝试在本地相同环境(如相同基础镜像的容器内)手动执行该命令,看是否复现。 1. 检查网络连通性(特别是国内访问官方源)。 **解决方案**: - 对于 `apt-get` 等包管理器,构建前先执行 `apt-get update`,并合并为一条 `RUN` 指令以减少层数:RUN apt-get update && apt-get install -y curl - 使用国内镜像源加速(如阿里云、清华源),例如:RUN sed -i 's/deb.debian.org/mirrors.aliyun.com/g' /etc/apt/sources.list && apt-get update && apt-get install -y curl - 强制不使用缓存重新构建:`docker build --no-cache -t my-app .`。 ### 5.3 缓存导致依赖未更新 **错误现象**:修改了 `package.json` 或 `requirements.txt`,但 `npm install` / `pip install` 没有重新执行,镜像中依然是旧依赖。 **原因**: Docker 按层缓存。如果 `COPY package*.json ./` 这层没有变化(因为 Docker 认为文件内容未变),后续的 `RUN npm install` 就会直接使用缓存,不会重新运行。 **排查步骤**: 1. 确认 `package.json` 是否真的被修改(检查文件内容或时间戳)。 1. 检查 Dockerfile 中 `COPY` 指令是否正确复制了依赖文件,且该指令在 `RUN install` 之前。 1. 使用 `docker history ` 查看镜像构建历史,确认缓存命中情况。 **解决方案**: - 确保 Dockerfile 中先复制依赖文件,再执行安装,且 `COPY` 指令中的文件列表与依赖文件完全一致。 - 在需要强制更新时,使用 `--no-cache` 构建:`docker build --no-cache -t my-app .`。 - 更精细的做法:在 `RUN` 命令中加入版本号变量或构建参数,使其每次变化:ARG CACHEBUST=1 RUN npm install构建时传入 `--build-arg CACHEBUST=$(date +%s)` 可强制跳过该层缓存。 ### 5.4 Docker 守护进程未运行或权限不足 **错误信息示例**: ``` Cannot connect to the Docker daemon at unix:///var/run/docker.sock. Is the docker daemon running? ``` 或 ``` Got permission denied while trying to connect to the Docker daemon socket ``` **常见原因**: - Docker 服务未启动。 - 当前用户不在 `docker` 用户组,没有权限访问 Docker 守护进程。 - 在 Windows/Mac 上 Docker Desktop 未运行。 **排查步骤**: 1. 检查 Docker 服务状态: - Linux:`systemctl status docker` 或 `service docker status` - macOS/Windows:查看 Docker Desktop 是否在运行。 1. 确认当前用户权限: - `docker ps` 能否正常执行?若报权限错误,说明用户不在 `docker` 组。 - 使用 `groups` 查看当前用户所属组,是否包含 `docker`。 **解决方案**: - 启动 Docker 服务: - Linux:`sudo systemctl start docker` - macOS/Windows:启动 Docker Desktop 应用程序。 - 将当前用户加入 `docker` 组(需重新登录生效):sudo usermod -aG docker $USER newgrp docker - 若仍无法连接,检查 `DOCKER_HOST` 环境变量是否设置正确,通常无需设置,保持默认即可。5. 总结 通过 Dockerfile 构建镜像,你可以将应用环境标准化、版本化,实现“一次构建,到处运行”。本文介绍了 Dockerfile 的核心编写流程、常用指令以及多阶段构建等实用技巧。

优秀的个人博客,低调大师

HarmonyOS NEXT 应用开发快速入门案例

踏入鸿蒙世界的敲门砖,标志着您在技术征途上的全新起点,提升就业竞争力,获得行业认可,点亮职业成长先机,快人一步抢占未来应用开发赛道!https://developer.huawei.com/consumer/cn/training/dev-cert-detail/101666948302721398?ha_source=hmosclass-bokeyuan&ha_sourceId=89000444 项目代码gitee地址 (https://gitee.com/li-yangshui-and-jiaolong/HarmonyOS-Next-App/tree/master/MyApplication) 开源协议使用:Apache License 2.0 ,代码包支持免费使用,可进行二次开发后选择开源或闭源。 一、创建项目 1.创建项目,选择Application 2.配置项目 3.在AppScope文件下修改自定义项目配置 在resources>base>element>string.json中修改“app_name”值,该值表示“应用名称”。 在app.json5中修改“vender”值,该值表示“应用程序供应商”。 4.在项目下的resource>base>media下添加图片 二、创建卡片widget 1.创建微、小、中、大卡片 2.依次创建卡片 3.卡片创建完成,修改卡片配置代码 4.卡片代码如下: widget_wk代码: widget代码 widget_zk代码 widget_dk代码: 三、创建应用page 1.修改pages/Index.ets中的代码,代码如下: 2.创建新的page 3.新的page写入代码如下: 四、项目效果 1.预览器效果 Widget: ! Page: 五、更换为OpenHarmony应用 打开entry下的build-profile.json5文件,更换“targets”字段中的“runtimeOS”属性值,点击右上方的Sync Now同步就。 (文章转载自51CTO,作者鸿蒙时代)

优秀的个人博客,低调大师

Spring Cloud Alibaba AI 入门与实践

一、概述 Spring AI 是 Spring 官方社区项目,旨在简化 Java AI 应用程序开发,让 Java 开发者像使用 Spring 开发普通应用一样开发 AI 应用。 可参考文章《SpringAI:Java 开发的智能新利器》 Spring Cloud Alibaba AI 是一个将 Spring Cloud 微服务生态与阿里巴巴 AI 能力无缝集成的框架,帮助开发者快速构建具备 AI 功能的现代化应用。本文将介绍 Spring Cloud Alibaba AI 的基本概念、主要特性和功能,并演示如何完成一个 在线聊天 和 在线画图 的 AI 应用。 二、主要特性和功能 Spring Cloud Alibaba AI 目前基于 Spring AI 0.8.1 版本 API 完成通义系列大模型的接入。通义接入是基于阿里云 阿里云百炼 服务;而 阿里云百炼 建立在 模型即服务(MaaS) 的理念基础之上,围绕 AI 各领域模型,通过标准化的 API 提供包括模型推理、模型微调训练在内的多种模型服务。 主要提供以下核心功能: 2.1. 简单易用的集成 通过 Spring Boot 风格的自动配置机制,开发者只需少量代码配置,即可快速接入阿里云的 AI 服务。 2.2. 丰富的 AI 服务支持 支持以下核心能力: 自然语言处理(NLP):文本分析、智能问答、翻译。 计算机视觉(CV):图像生成、图像识别、目标检测。 语音处理:语音识别、语音合成。 数据分析与预测:数据建模、趋势分析。 2.3. 高度扩展性 通过配置中心和注册中心(如 Nacos)实现动态扩展,支持微服务架构的扩展需求。 提供接口定义,方便接入第三方 AI 平台。 三、构建 AI 应用 Spring Cloud Alibaba AI 对 Java 版本有要求,所以需要提前预装好 Java 17 环境。 3.1. 申请 API-KEY 登录阿里云,进入 阿里云百炼 的页面: https://bailian.console.aliyun.com/?apiKey=1#/api-key 创建自己的 API-KEY 3.2. 添加依赖 在 Spring Boot 项目的 pom.xml 中添加 alibaba-ai 依赖 <dependency> <groupId>com.alibaba.cloud</groupId> <artifactId>spring-cloud-starter-alibaba-ai</artifactId> </dependency> <repositories> <repository> <id>alimaven</id> <url>https://maven.aliyun.com/repository/public</url> </repository> <repository> <id>spring-milestones</id> <url>https://repo.spring.io/milestone</url> <snapshots> <enabled>false</enabled> </snapshots> </repository> <repository> <id>spring-snapshots</id> <url>https://repo.spring.io/snapshot</url> <snapshots> <enabled>false</enabled> </snapshots> </repository> </repositories> 3.3. 配置 API-KEY 在 application.yml 中配置 Kafka 的相关属性,包括服务器地址、认证信息等。 spring: cloud: ai: tongyi: connection: api-key: sk-xxxxxx api-key 配置在阿里云百炼里申请的api-key 3.4. 创建模型调用服务 @Service @Slf4j public class TongYiSimpleService { @Resource private TongYiChatModel chatClient; @Resource private TongYiImagesModel imageClient; public String chat(String message) { Prompt prompt = new Prompt(new UserMessage(message)); return chatClient.call(prompt).getResult().getOutput().getContent(); } public String image(String message) { ImagePrompt prompt = new ImagePrompt(message); Image image = imageClient.call(prompt).getResult().getOutput(); return image.getB64Json(); } } 聊天和图片的服务,分别通过注入 TongYiChatModel 和 TongYiImagesModel 对象来实现,屏蔽底层通义大模型交互细节。 3.5. 创建controller @RestController @RequestMapping("/ai") public class TongYiController { @Resource private TongYiSimpleService tongYiSimpleService; @GetMapping("/chat") public String chat(@RequestParam(value = "message") String message) { return tongYiSimpleService.chat(message); } @GetMapping("/image") public ResponseEntity<byte[]> image(@RequestParam(value = "message") String message) { String b64Str = tongYiSimpleService.image(message); byte[] imageBytes = Base64.getDecoder().decode(b64Str); HttpHeaders headers = new HttpHeaders(); headers.setContentType(MediaType.IMAGE_JPEG); return new ResponseEntity<>(imageBytes, headers, HttpStatus.OK); } } 3.6. 测试效果 3.6.1. 聊天接口 在浏览器输入:http://localhost:8009/ai/chat?message=你是谁 3.6.2. 图片接口 在浏览器输入:http://localhost:8009/ai/image?message=意大利面拌42号混凝土 3.6.3. 搭配聊天页面 四、总结 当前版本的 Spring Cloud Alibaba AI 主要完成了几种常见生成式模型的适配,涵盖对话、文生图、文生语音等。在未来的版本中将继续推进 VectorStore、Embedding、ETL Pipeline、RAG 等更多 AI 应用开发场景的建设。 完整的样例代码下载: https://gitee.com/zlt2000/spring-cloud-ai-sample 扫码关注有惊喜!

优秀的个人博客,低调大师

GitLab CI/CD 快速入门

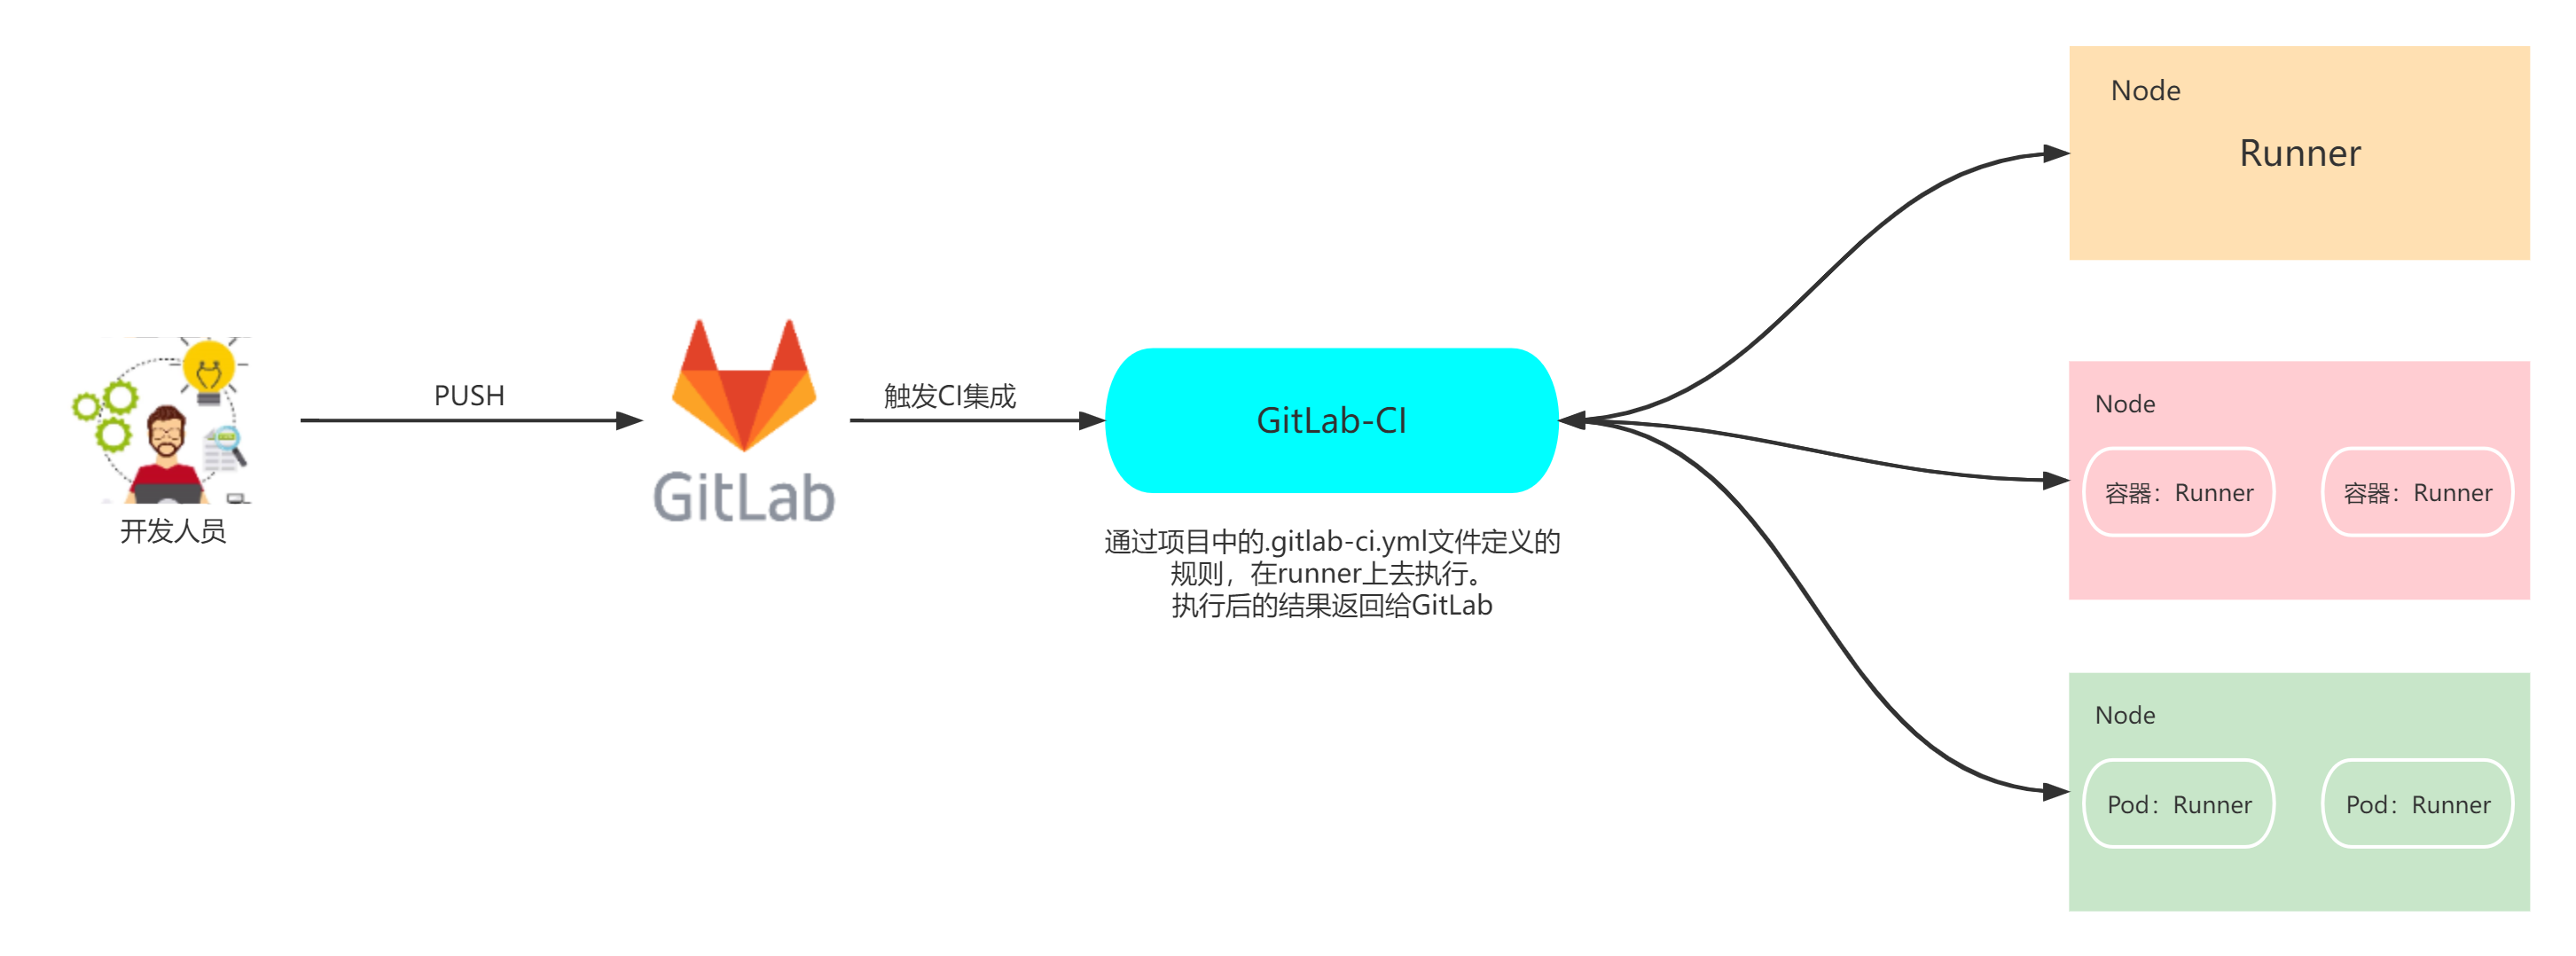
用过 GitLab 的同学肯定也对 GitLab CI/CD 不陌生,GitLab CI/CD 是一个内置在 GitLab 中的工具,它可以帮助我们在每次代码推送时运行一系列脚本来构建、测试和验证代码的更改以及部署。 Rainbond 本身默认集成了 CI/CD 的整套流程,用户只需提供源代码,后续构建、运行完全交给 Rainbond 处理,整个过程是由 Rainbond 定义的,无需用户干预。这样有利也有弊,利就是简化用户的操作和无需学习 CI/CD 相关知识;弊是用户无法在 CI/CD 过程中自定义,比如想集成代码检测或运行个脚本,这在 Rainbond 的源码构建流程中是不可自定义的。 本文给大家讲述如何使用 GitLab CI/CD 构建、测试、部署 Spring Boot 应用,将产物运行在 Rainbond 上。 GitLab CI 介绍 使用 GitLab CI 需要在仓库根目录下创建 .gitlab-ci.yml 文件。在这个文件中,你可以定义需要运行的编译、测试、部署脚本。 在添加了 .gitlab-ci.yml 文件后,当推送代码时,GitLab Runner 自动执行你定义的 Pipeline,并在 GitLab CI 页面上展示 CI 过程以及结果。 GitLab CI 的基本流程如下: 开发人员推送代码 触发 GitLab CI 启动 runner 执行预定义脚本 GitLab CI/CD 快速开始 部署 GitLab 和 Runner 通过开源应用商店一键部署 GitLab 和 Runner ,新增 -> 基于应用商店创建组件 -> 在开源应用商店中搜索 GitLab 依次安装 GitLab 和 Runner 到指定应用中。 在 Rainbond 上配置 Runner 在 Rainbond v5.8 版本之前,Rainbond 对 Runner 类型的组件支持的并不是很好。因为 Runner 若以容器的形式去运行的话,本身它需要去挂载宿主机的docker.sock 文件,使它可以调度宿主机的 docker 环境,创建容器执行任务。在 Rainbond v5.8 版本中,支持修改组件的 YAML,就可以自定义 Volumes 并挂载本地的 docker.sock。 在通过应用商店安装了 Runner 之后,可以在 Runner 组件内 -> 其他设置中看到 Kubernetes 属性,Rainbond 的应用模型已兼容了 Kubernetes 属性。 注册 Runner 到 GitLab : 进入编排模式,将 runner 连接到 GitLab 并更新 runner 组件。(如提示 GitLab 未开启对内端口,则选择 80 端口) 首先访问 GitLab,Menu -> Admin -> Overview -> Runners -> Register an instance runner -> 复制 Registration token。 进入 runner 组件内,点击右上角 web 终端进入,执行以下命令进行注册,<token> 换成上一步复制的 Registration token。 gitlab-runner register \ --non-interactive \ --executor "docker" \ --docker-image alpine:latest \ --url "http://127.0.0.1" \ --registration-token "NxNuoRXuzYy3GnFbkhtK" \ --description "docker-runner" \ --tag-list "newdocker" \ --run-untagged="true" \ --locked="false" \ --docker-volumes /var/run/docker.sock:/var/run/docker.sock \ --docker-privileged="true" \ --access-level="not_protected" 参数说明 Parameter Value Describe --executor docker 执行器类型为docker。 --url http://127.0.0.1 GitLab addr --registration-token <token> GitLab token --tag-list newdocker 定义runner的标签/名字 --locked false runner为启用状态 --run-untagged true 运行没有指定标签的Job --docker-volumes file_path 挂载文件到runner中 --docker-privileged true runner运行模式:特权模式 注册完成后就可以在 GitLab 页面中看到 online 的 runner GitLab CI/CD To Rainbond 整个流程可以分为: 开发人员提交代码到GitLab仓库。 触发GitLab 流水线创建,Runner 执行 .gitlab-ci.yml 定义的 stages。 将制作好的镜像推送到已有的镜像仓库,供后续的Deploy流程使用。 通过Rainbond自定义API的方法,触发平台组件的自动构建,进入Deploy阶段。 实践步骤 前提: 已有 Rainbond 环境 准备镜像仓库,本文使用的DockerHub 本文所使用到代码项目为 Java-Maven-Demo 1.在Rainbond上有已经基于镜像部署好的组件 2.将示例代码导入到 GitLab中。 3.编写 .gitlab-ci.yml 文件: 在项目根目录下创建 .gitlab-ci.yml 内容如下: # 定义 job 的执行顺序 stages: - test - package - push # 定义基础镜像 image: maven:3.6.3-jdk-8 job-test: stage: test tags: - newdocker script: - echo "===============开始执行代码测试任务===============" - mvn test job-package: stage: package tags: - newdocker script: - echo "===============开始执行打包任务===============" - ls - mvn clean package - cp Dockerfile target/Dockerfile cache: key: devops paths: - target/ job-push: stage: push image: docker:dind cache: key: devops paths: - target/ tags: - newdocker script: - docker login -u ${DOCKER_USERNAME} -p ${DOCKER_PASSWORD} - docker build -t ${IMAGE_DOMAIN}/java-maven:latest . - docker push ${IMAGE_DOMAIN}/java-maven:latest after_script: - curl -d '{"secret_key":"${RAINBOND_SECRET}"}' -H "Content-type:application/json" -X POST http://${RAINBOND_IP}:7070/console/custom/deploy/3321861bcadf0789af71898f23e8e740 after_script 是在推送镜像完成后执行,通过 Rainbond API 构建组件,Rainbond 会获取最新镜像构建运行。<RAINBOND_SECRET> 可在组件 -> 构建源 -> 自动构建中看到。详情可参阅文档 配置组件自动构建部署 4.提交代码测试自动构建, 修改代码并提交,提交后可在项目的 CI/CD -> Jobs 可以看到正在执行的以及执行完成的任务详情。 5.查看 Rainbond 组件构建 可以在组件的操作记录中看到自动构建信息。 写在最后 GitLab CI 扩展性很好,可以集成很多第三方工具,结合 Rainbond 作为 CD,将产物运行到 Rainbond 上,即可形成适用于自身代码项目的 Pipeline。 Rainbond 会在未来的 v5.9.x 版本中实现 Pipeline,对 Rainbond 实现 Pipeline 有想法的同学可以在 issue 上提出 Proposal https://github.com/goodrain/rainbond/issues

优秀的个人博客,低调大师

Rancher2.6全新Monitoring快速入门

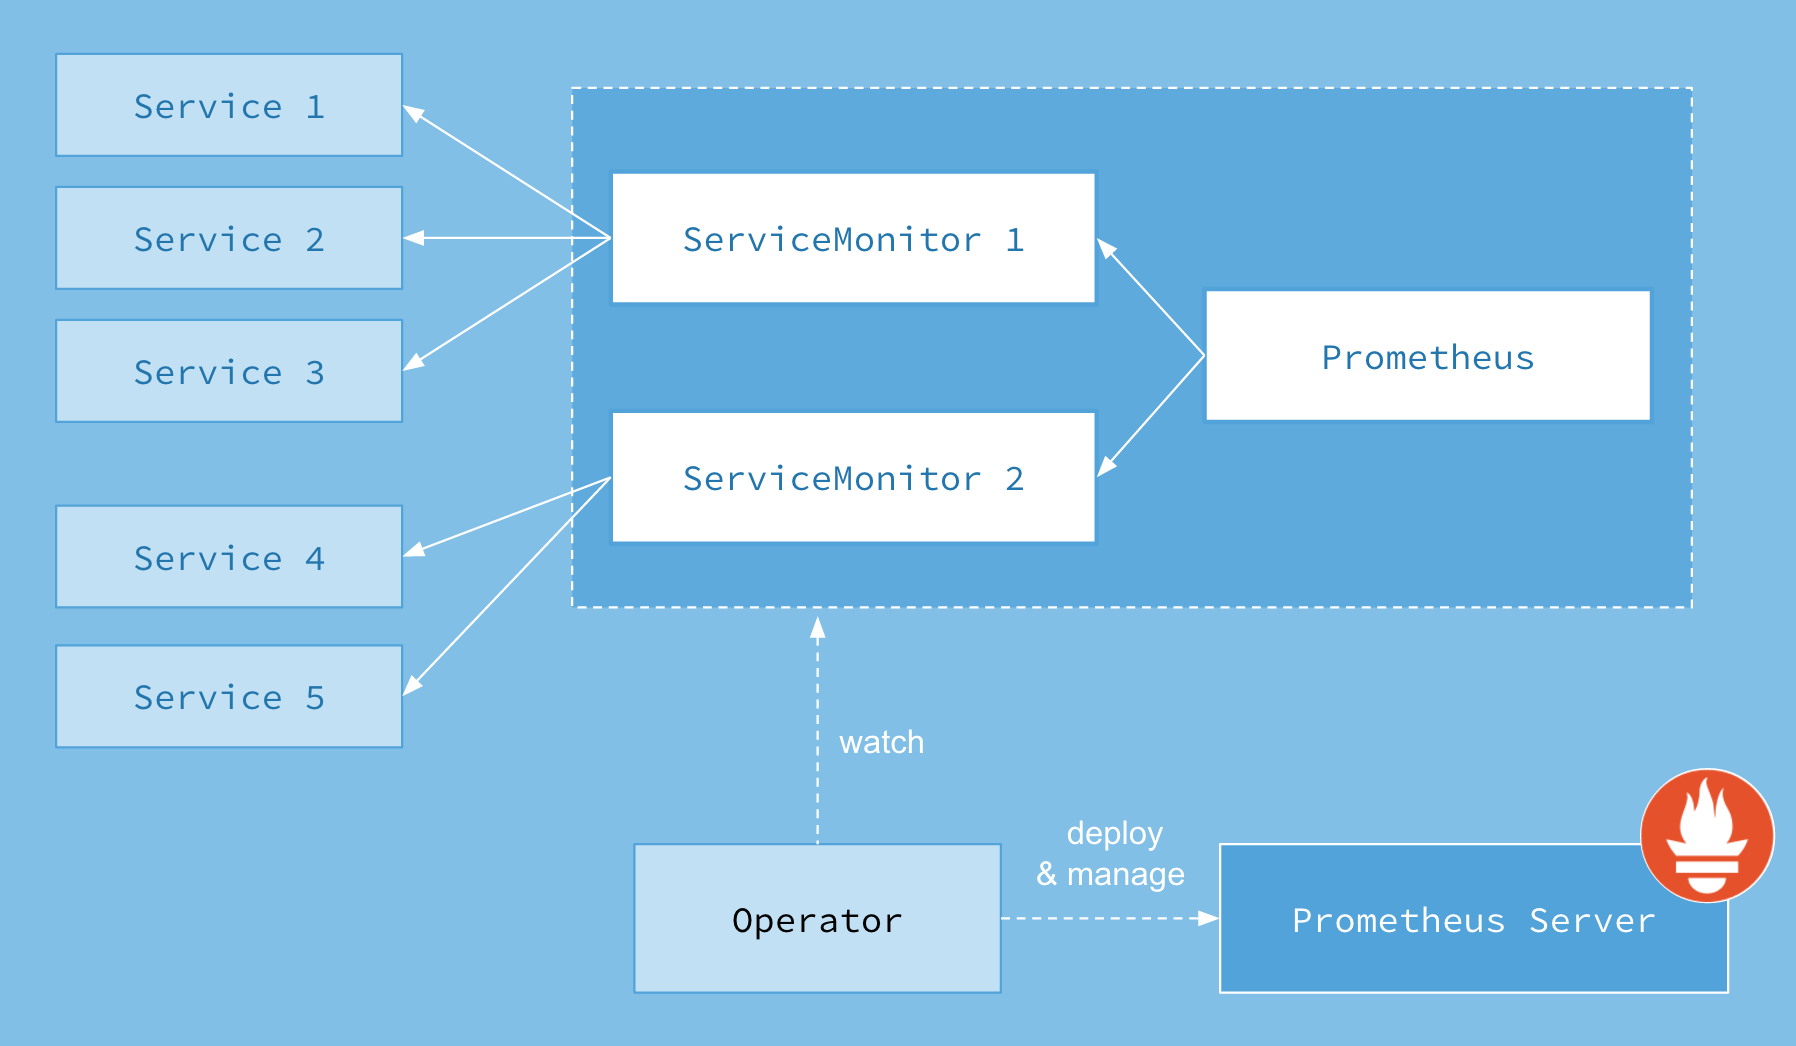
作者简介 万绍远,CNCF 基金会官方认证 Kubernetes CKA&CKS 工程师,云原生解决方案架构师。对 ceph、Openstack、Kubernetes、prometheus 技术和其他云原生相关技术有较深入的研究。参与设计并实施过多个金融、保险、制造业等多个行业 IaaS 和 PaaS 平台设计和应用云原生改造指导。 软件 版本 Rancher 2.6.4 Kubernetes 1.22.7+rke2r2 概 述 Rancher 2.6 监控启用方式与之前版本存在较大差异,属于原生的 Prometheus-Operator,通过抽象化一些 Kubernetes CRD 资源,可以更好地把监控告警功能整合起来,提高易用性。Prometheus-operator 包括以下 CRD 资源对象: PrometheusRules:定义告警规则 Alert Managers:Altermanager 启动 CRD,用于 Altermanager 启动副本 Receivers:配置告警接收媒介 CRD Routers:将告警规则和告警媒介进行匹配 ServiceMonitor:定义 Prometheus 采集的监控指标地址 Pod Monitor:更细粒化的对 POD 进行监控 配置使用 启用监控 切换到对应集群,选择左下角 clusterTools 启用 Prometheus: 部署到 System 项目中,勾选自定义 helm 参数: 根据实际需求修改部署要求: 如果需要对接远端存储(如 infuxdb),就需要修改 yaml 配置,并配置指向 influxdb: remoteRead: - url: http://192.168.0.7:8086/api/v1/prom/read?db=prometheusremoteWrite: - url: http://192.168.0.7:8086/api/v1/prom/write?db=prometheus 默认 node-exporter 资源 limit 配置较低,长时间运行后容易被 OOM KILL 掉,需要修改默认的内存限制为 150Mi: podLabels: jobLabel: node-exporter resources: limits: cpu: 200m memory: 150Mi requests: cpu: 100m memory: 30Mi 可以点击如下页面进入对应的组件配置页面,如: Altermanager:进入的是告警信息查看页 Grafana:查看监控数据图标 Prometheus Graph:Prometheus 表达式执行页 Prometheus Rules:查看 Prometheus 配置的告警表达式页 Prometheus Targets:监控采集数据采集 在集群概览页可以看见对应的指标监控项: 集群层面: cpu 使用情况 集群节点负载情况 内存使用情况 磁盘使用率 磁盘 IO Network Traffic Network IO Kubernetes 组件: ApiServer 请求速率 Controller-Manager 队列深度 POD scheduler 调度状态 Ingress-Controller 连接数 ETCD 监控: Leader 选举状态 Leader 选举次数 GRPC Client Traffic ETCD 数据使用容量 Active Streams RPC 速率 磁盘数据同步时间 同时在每个部署的 POD 也都包含对应的监控项: 配置自定义监控指标 默认启用监控会会自动添加一些 ServiceMonitor 监控规则和 Prometheus Rules 告警规则,主要是针对平台组件监控和集群内节点状态监控和告警。 如果这些监控指标不满足你的需求,你可以手动添加。比如针对 java 应用的 jmx 监控,Jmx 有官方的 prometheus-export,我们只需要将其 jar 包下载让 java 应用程序加载 jar 包和加载其配置即可。 以一个应用为例,整体流程如下: 利用 JMX exporter,在 Java 进程内启动一个小型的 Http server 配置 Prometheus 抓取那个 Http server 提供的 metrics 配置 Grafana 连接 Prometheus,配置 Dashboard 首先,需要创建文件夹: mkdir -p /Dockerfile/jmx-exporter/ 然后,下载 jmx-export.jar 包放到这个目录: https://github.com/prometheus/jmx_exporter https://repo1.maven.org/maven2/io/prometheus/jmx/jmx_prometheus_javaagent/0.12.0/jmx_prometheus_javaagent-0.12.0.jar 随后,编写 jvm-export 配置文件放置/root/jmx-exporter/目录,创建 simple-config.yml 内容如下: --- rules: - pattern: ".*" 这里意思表示将全部监控信息抓取出来。将 jvm-export 集成到 tomcat 中,重新编写 Dockerfile: FROM tomcat COPY ./jmx_prometheus_javaagent-0.12.0.jar /jmx_prometheus_javaagent-0.12.0.jar ENV CATALINA_OPTS="-Xms64m -Xmx128m -javaagent:/jmx-exporter/jmx_prometheus_javaagent-0.12.0.jar=6060:/jmx-exporter/simple-config.yml" 重新 docker build,build 后执行以下 docker run 命令可以查看收集的监控指标,这里 6060 端口就是我们的 jmx-export 端口: docker build -t tomcat:v1.0 . docker run -itd -p 8080:8080 -p 6060:6060 tomcat:v1.0 访问查看:http://host_ip:6060 部署到 Rancher 平台: 给 Service 打上 label,用于 ServiceMonitor 关联: kubectl label svc tomcat app=tomcat 创建 ServiceMonitor: apiVersion: monitoring.coreos.com/v1 kind: ServiceMonitor metadata: name: tomcat-app namespace: defaultspec: endpoints: - port: exporter selector: matchLabels: app: tomcat 创建成功后通过 Prometheus 可以查看到对应的 Target: 对应的监控指标也已经抓取: 进入 grafana 页面添加 dashboard,默认账号密码为 admin/prom-operator: 添加 dashboard,输入 dashboard-id,8878,离线环境需要提前将 Dashboard 下载好,通过 json 方式导入: 配置告警 PrometheusRule 用于定义告警规则,默认已经包含针对平台组件和节点的一些告警策略。可以通过配置 Root 和 Receivers 配置告警媒介将对应告警通知到相应的人员。采用 Routing Tree 的告警结构能够快速的将告警进行分类,然后发送到指定的人员进行处理。 Receivers 配置告警媒介,例如填写 SMTP 地址和配置的账号/密码,默认接收的邮箱: Routes 配置用于告警媒介和告警规则进行匹配,默认创建的 root 规则,用于匹配全部的告警规则,配置上对应创建的告警媒介: 此时全部的告警规则都会发送给配置的告警媒介,若要细分告警规则创建新的 Routes 通过 Label 与 Prometheus Rules 内对应的 Alter name 对接。 如匹配 alert:etcdNoLeader 这条告警规则: 也可以使用正则表达式匹配多个规则如: Grouping 配置主要用于告警规则分类、抑制避免大量无用告警的干扰: group_by:用于配置告警分组,达到告警抑制效果,同一个 group 的告警只会聚合到一起发送一次。例如 host01 上运行了数据库,那么对应的告警包含了 host down、mysql down。他们配置在一个 group 内,那么如果 host down 了对应的 mysql 肯定也是 down 了,那么因为他们配置在一个 group 中,所以 host down 和 mysql down 的告警会聚合到一起发送出去。 group_wait:新建的 AlterGroup 等待多久后触发第一次告警。 group_interval:AlterGroup 内产生的不同告警触发间隔时间。 repeat_interval:AlterGroup 内如果一直是同样的告警,Altermanager 为了避免长时间的干扰,进行告警去重的等待时间。 匹配后,告警触发,可以收到对应的告警邮件: 自定义告警 当默认的告警规则不能满足需求时,可以根据实际情况添加自定义告警,实际就是添加对应的 PrometheusRule。如以下例子,添加 pod 非 running 状态的告警。 UI 配置: 对应 yaml 配置: apiVersion: monitoring.coreos.com/v1 kind: PrometheusRule metadata: name: podmonitor namespace: cattle-monitoring-system spec: groups: - name: pod_node_ready rules: - alert: pod_not_ready annotations: message: '{ { $labels.namespace }}/{ { $labels.pod }} is not ready.' expr: 'sum by (namespace, pod) (kube_pod_status_phase{phase!~"Running|Succeeded"}) > 0 ' for: 180s labels: severity: 严重 for:表示持续时间 message:表示告警通知内的信息 label.severity:表示告警级别 expr:指标获取表达式 配置告警接收者: 根据标签匹配到这个 PrometheusRule: 参考链接: https://mp.weixin.qq.com/s/fT-AXnPP8rrWxTposbi-9A https://github.com/prometheus-operator/prometheus-operator https://rancher.com/docs/rancher/v2.6/en/monitoring-alerting/guides/enable-monitoring/

优秀的个人博客,低调大师

16个核心概念带你入门 Kubernetes

Kubernetes是Google开源的容器集群管理系统,是Google多年⼤规模容器管理技术Borg的开源版本,主要功能包括: 基于容器的应用部署、维护和滚动升级 负载均衡和服务发现 跨机器和跨地区的集群调度 自动伸缩 无状态服务和有状态服务 广泛的Volume支持 插件机制保证扩展性 Kubernetes发展非常迅速,已经成为容器编排领域的领导者,接下来我们将讲解Kubernetes中涉及到的一些主要概念。 1、Pod Pod是一组紧密关联的容器集合,支持多个容器在一个Pod中共享网络和文件系统,可以通过进程间通信和文件共享这种简单高效的方式完成服务,是Kubernetes调度的基本单位。Pod的设计理念是每个Pod都有一个唯一的IP。 Pod具有如下特征: 包含多个共享IPC、Network和UTC namespace的容器,可直接通过localhost通信 所有Pod内容器都可以访问共享的Volume,可以访问共享数据 优雅终止:Pod删除的时候先给其内的进程发送SIGTERM,等待一段时间(grace period)后才强制停止依然还在运行的进程 特权容器(通过SecurityContext配置)具有改变系统配置的权限(在网络插件中大量应用) 支持三种重启策略(restartPolicy),分别是:Always、OnFailure、Never 支持三种镜像拉取策略(imagePullPolicy),分别是:Always、Never、IfNotPresent 资源限制,Kubernetes通过CGroup限制容器的CPU以及内存等资源,可以设置request以及limit值 健康检查,提供两种健康检查探针,分别是livenessProbe和redinessProbe,前者用于探测容器是否存活,如果探测失败,则根据重启策略进行重启操作,后者用于检查容器状态是否正常,如果检查容器状态不正常,则请求不会到达该Pod Init container在所有容器运行之前执行,常用来初始化配置 容器生命周期钩子函数,用于监听容器生命周期的特定事件,并在事件发生时执行已注册的回调函数,支持两种钩子函数:postStart和preStop,前者是在容器启动后执行,后者是在容器停止前执行 2、Namespace Namespace(命名空间)是对一组资源和对象的抽象集合,比如可以用来将系统内部的对象划分为不同的项目组或者用户组。常见的pod、service、replicaSet和deployment等都是属于某一个namespace的(默认是default),而node, persistentVolumes等则不属于任何namespace。 常用namespace操作: kubectlgetnamespace, 查询所有namespace kubectl createnamespacens-name,创建namespace kubectldeletenamespacens-name, 删除namespace 删除命名空间时,需注意以下几点: 删除一个namespace会自动删除所有属于该namespace的资源。 default 和 kube-system 命名空间不可删除。 PersistentVolumes是不属于任何namespace的,但PersistentVolumeClaim是属于某个特定namespace的。 Events是否属于namespace取决于产生events的对象。 3、Node Node是Pod真正运行的主机,可以是物理机也可以是虚拟机。Node本质上不是Kubernetes来创建的, Kubernetes只是管理Node上的资源。为了管理Pod,每个Node节点上至少需要运行container runtime(Docker)、kubelet和kube-proxy服务。 常用node操作: kubectlgetnodes,查询所有node kubectl cordon $nodename, 将node标志为不可调度 kubectl uncordon $nodename, 将node标志为可调度 taint(污点) 使用kubectl taint命令可以给某个Node节点设置污点,Node被设置上污点之后就和Pod之间存在了一种相斥的关系,可以让Node拒绝Pod的调度执行,甚至将Node已经存在的Pod驱逐出去。每个污点的组成:key=value:effect,当前taint effect支持如下三个选项: NoSchedule:表示k8s将不会将Pod调度到具有该污点的Node上 PreferNoSchedule:表示k8s将尽量避免将Pod调度到具有该污点的Node上 NoExecute:表示k8s将不会将Pod调度到具有该污点的Node上,同时会将Node上已经存在的Pod驱逐出去 常用命令如下: kubectl taint node node0 key1=value1:NoShedule,为node0设置不可调度污点 kubectl taint node node0 key-,将node0上key值为key1的污点移除 kubectl taint node node1 node-role.kubernetes.io/master=:NoSchedule,为kube-master节点设置不可调度污点 kubectl taint node node1 node-role.kubernetes.io/master=PreferNoSchedule,为kube-master节点设置尽量不可调度污点 容忍(Tolerations) 设置了污点的Node将根据taint的effect:NoSchedule、PreferNoSchedule、NoExecute和Pod之间产生互斥的关系,Pod将在一定程度上不会被调度到Node上。但我们可以在Pod上设置容忍(Toleration),意思是设置了容忍的Pod将可以容忍污点的存在,可以被调度到存在污点的Node上。 4、Service Service是对一组提供相同功能的Pods的抽象,并为他们提供一个统一的入口,借助 Service 应用可以方便的实现服务发现与负载均衡,并实现应用的零宕机升级。Service通过标签(label)来选取后端Pod,一般配合ReplicaSet或者Deployment来保证后端容器的正常运行。 service 有如下四种类型,默认是ClusterIP: ClusterIP: 默认类型,自动分配一个仅集群内部可以访问的虚拟IP NodePort: 在ClusterIP基础上为Service在每台机器上绑定一个端口,这样就可以通过NodeIP:NodePort来访问该服务 LoadBalancer: 在NodePort的基础上,借助cloud provider创建一个外部的负载均衡器,并将请求转发到 NodeIP:NodePort ExternalName: 将服务通过DNS CNAME记录方式转发到指定的域名 另外,也可以将已有的服务以Service的形式加入到Kubernetes集群中来,只需要在创建 Service 的时候不指定Label selector,而是在Service创建好后手动为其添加endpoint。 5、Volume 存储卷 默认情况下容器的数据是非持久化的,容器消亡以后数据也会跟着丢失,所以Docker提供了Volume机制以便将数据持久化存储。Kubernetes提供了更强大的Volume机制和插件,解决了容器数据持久化以及容器间共享数据的问题。 Kubernetes存储卷的生命周期与Pod绑定 容器挂掉后Kubelet再次重启容器时,Volume的数据依然还在 Pod删除时,Volume才会清理。数据是否丢失取决于具体的Volume类型,比如emptyDir的数据会丢失,而PV的数据则不会丢 目前Kubernetes主要支持以下Volume类型: emptyDir:Pod存在,emptyDir就会存在,容器挂掉不会引起emptyDir目录下的数据丢失,但是pod被删除或者迁移,emptyDir也会被删除 hostPath:hostPath允许挂载Node上的文件系统到Pod里面去 NFS(Network File System):网络文件系统,Kubernetes中通过简单地配置就可以挂载NFS到Pod中,而NFS中的数据是可以永久保存的,同时NFS支持同时写操作。 glusterfs:同NFS一样是一种网络文件系统,Kubernetes可以将glusterfs挂载到Pod中,并进行永久保存 cephfs:一种分布式网络文件系统,可以挂载到Pod中,并进行永久保存 subpath:Pod的多个容器使用同一个Volume时,会经常用到 secret:密钥管理,可以将敏感信息进行加密之后保存并挂载到Pod中 persistentVolumeClaim:用于将持久化存储(PersistentVolume)挂载到Pod中 ... 6、PersistentVolume(PV) 持久化存储卷 PersistentVolume(PV)是集群之中的一块网络存储。跟 Node 一样,也是集群的资源。PersistentVolume (PV)和PersistentVolumeClaim (PVC)提供了方便的持久化卷: PV提供网络存储资源,而PVC请求存储资源并将其挂载到Pod中。 PV的访问模式(accessModes)有三种: ReadWriteOnce(RWO):是最基本的方式,可读可写,但只支持被单个Pod挂载。 ReadOnlyMany(ROX):可以以只读的方式被多个Pod挂载。 ReadWriteMany(RWX):这种存储可以以读写的方式被多个Pod共享。 不是每一种存储都支持这三种方式,像共享方式,目前支持的还比较少,比较常用的是 NFS。在PVC绑定PV时通常根据两个条件来绑定,一个是存储的大小,另一个就是 访问模式。 PV的回收策略(persistentVolumeReclaimPolicy)也有三种 Retain,不清理保留Volume(需要手动清理) Recycle,删除数据,即 rm -rf /thevolume/* (只有NFS和HostPath支持) Delete,删除存储资源 7、Deployment 无状态应用 一般情况下我们不需要手动创建Pod实例,而是采用更高一层的抽象或定义来管理Pod,针对无状态类型的应用,Kubernetes使用Deloyment的Controller对象与之对应。其典型的应用场景包括: 定义Deployment来创建Pod和ReplicaSet 滚动升级和回滚应用 扩容和缩容 暂停和继续Deployment 常用的操作命令如下: kubectl run www--image=10.0.0.183:5000/hanker/www:0.0.1--port=8080生成一个Deployment对象 kubectlgetdeployment--all-namespaces查找Deployment kubectl describe deployment www查看某个Deployment kubectl edit deployment www编辑Deployment定义 kubectldeletedeployment www删除某Deployment kubectl scale deployment/www--replicas=2扩缩容操作,即修改Deployment下的Pod实例个数 kubectlsetimage deployment/nginx-deployment nginx=nginx:1.9.1更新镜像 kubectl rollout undo deployment/nginx-deployment回滚操作 kubectl rollout status deployment/nginx-deployment查看回滚进度 kubectl autoscale deployment nginx-deployment--min=10--max=15--cpu-percent=80启用水平伸缩(HPA - horizontal pod autoscaling),设置最小、最大实例数量以及目标cpu使用率 kubectl rollout pause deployment/nginx-deployment暂停更新Deployment kubectl rollout resume deploy nginx恢复更新Deployment 更新策略 .spec.strategy指新的Pod替换旧的Pod的策略,有以下两种类型 RollingUpdate 滚动升级,可以保证应用在升级期间,对外正常提供服务。 Recreate 重建策略,在创建出新的Pod之前会先杀掉所有已存在的Pod。 Deployment和ReplicaSet两者之间的关系 使用Deployment来创建ReplicaSet。ReplicaSet在后台创建pod,检查启动状态,看它是成功还是失败。 当执行更新操作时,会创建一个新的ReplicaSet,Deployment会按照控制的速率将pod从旧的ReplicaSet移 动到新的ReplicaSet中 8、StatefulSet 有状态应用 Deployments和ReplicaSets是为无状态服务设计的,那么StatefulSet则是为了有状态服务而设计,其应用场景包括: 稳定的持久化存储,即Pod重新调度后还是能访问到相同的持久化数据,基于PVC来实现 稳定的网络标志,即Pod重新调度后其PodName和HostName不变,基于Headless Service(即没有Cluster IP的Service)来实现 有序部署,有序扩展,即Pod是有顺序的,在部署或者扩展的时候要依据定义的顺序依次进行操作(即从0到N-1,在下一个Pod运行之前所有之前的Pod必须都是Running和Ready状态),基于init containers来实现 有序收缩,有序删除(即从N-1到0) 支持两种更新策略: OnDelete:当 .spec.template更新时,并不立即删除旧的Pod,而是等待用户手动删除这些旧Pod后自动创建新Pod。这是默认的更新策略,兼容v1.6版本的行为 RollingUpdate:当 .spec.template 更新时,自动删除旧的Pod并创建新Pod替换。在更新时这些Pod是按逆序的方式进行,依次删除、创建并等待Pod变成Ready状态才进行下一个Pod的更新。 9、DaemonSet 守护进程集 DaemonSet保证在特定或所有Node节点上都运行一个Pod实例,常用来部署一些集群的日志采集、监控或者其他系统管理应用。典型的应用包括: 日志收集,比如fluentd,logstash等 系统监控,比如Prometheus Node Exporter,collectd等 系统程序,比如kube-proxy, kube-dns, glusterd, ceph,ingress-controller等 指定Node节点 DaemonSet会忽略Node的unschedulable状态,有两种方式来指定Pod只运行在指定的Node节点上: nodeSelector:只调度到匹配指定label的Node上 nodeAffinity:功能更丰富的Node选择器,比如支持集合操作 podAffinity:调度到满足条件的Pod所在的Node上 目前支持两种策略 OnDelete: 默认策略,更新模板后,只有手动删除了旧的Pod后才会创建新的Pod RollingUpdate: 更新DaemonSet模版后,自动删除旧的Pod并创建新的Pod 10、Ingress Kubernetes中的负载均衡我们主要用到了以下两种机制: Service:使用Service提供集群内部的负载均衡,Kube-proxy负责将service请求负载均衡到后端的Pod中 Ingress Controller:使用Ingress提供集群外部的负载均衡 Service和Pod的IP仅可在集群内部访问。集群外部的请求需要通过负载均衡转发到service所在节点暴露的端口上,然后再由kube-proxy通过边缘路由器将其转发到相关的Pod,Ingress可以给service提供集群外部访问的URL、负载均衡、HTTP路由等,为了配置这些Ingress规则,集群管理员需要部署一个Ingress Controller,它监听Ingress和service的变化,并根据规则配置负载均衡并提供访问入口。 常用的ingress controller: nginx traefik Kong Openresty 11、Job & CronJob 任务和定时任务 Job负责批量处理短暂的一次性任务 (short lived>CronJob即定时任务,就类似于Linux系统的crontab,在指定的时间周期运行指定的任务。 12、HPA(Horizontal Pod Autoscaling) 水平伸缩 Horizontal Pod Autoscaling可以根据CPU、内存使用率或应用自定义metrics自动扩展Pod数量 (支持replication controller、deployment和replica set)。 控制管理器默认每隔30s查询metrics的资源使用情况(可以通过 --horizontal-pod-autoscaler-sync-period 修改) 支持三种metrics类型 预定义metrics(比如Pod的CPU)以利用率的方式计算 自定义的Pod metrics,以原始值(raw value)的方式计算 自定义的object metrics 支持两种metrics查询方式:Heapster和自定义的REST API 支持多metrics 可以通过如下命令创建HPA:kubectl autoscale deployment php-apache--cpu-percent=50--min=1--max=10 13、Service Account Service account是为了方便Pod里面的进程调用Kubernetes API或其他外部服务而设计的 授权 Service Account为服务提供了一种方便的认证机制,但它不关心授权的问题。可以配合RBAC(Role Based Access Control)来为Service Account鉴权,通过定义Role、RoleBinding、ClusterRole、ClusterRoleBinding来对sa进行授权。 14、Secret 密钥 Sercert-密钥解决了密码、token、密钥等敏感数据的配置问题,而不需要把这些敏感数据暴露到镜像或者Pod Spec中。Secret可以以Volume或者环境变量的方式使用。有如下三种类型: Service Account:用来访问Kubernetes API,由Kubernetes自动创建,并且会自动挂载到Pod的 /run/secrets/kubernetes.io/serviceaccount 目录中; Opaque:base64编码格式的Secret,用来存储密码、密钥等; kubernetes.io/dockerconfigjson: 用来存储私有docker registry的认证信息。 15、ConfigMap 配置中心 ConfigMap用于保存配置数据的键值对,可以用来保存单个属性,也可以用来保存配置文件。ConfigMap跟secret很类似,但它可以更方便地处理不包含敏感信息的字符串。ConfigMap可以通过三种方式在Pod中使用,三种分别方式为:设置环境变量、设置容器命令行参数以及在Volume中直接挂载文件或目录。 可以使用 kubectl create configmap从文件、目录或者key-value字符串创建等创建 ConfigMap。也可以通过 kubectl create-f value.yaml 创建。 16、Resource Quotas 资源配额 资源配额(Resource Quotas)是用来限制用户资源用量的一种机制。 资源配额有如下类型: 计算资源,包括cpu和memory cpu, limits.cpu, requests.cpu memory, limits.memory, requests.memory 存储资源,包括存储资源的总量以及指定storage class的总量 requests.storage:存储资源总量,如500Gi persistentvolumeclaims:pvc的个数 storageclass.storage.k8s.io/requests.storage storageclass.storage.k8s.io/persistentvolumeclaims 对象数,即可创建的对象的个数 pods, replicationcontrollers, configmaps, secrets resourcequotas, persistentvolumeclaims services, services.loadbalancers, services.nodeports 它的工作原理为: 资源配额应用在Namespace上,并且每个Namespace最多只能有一个 ResourceQuota 对象 开启计算资源配额后,创建容器时必须配置计算资源请求或限制(也可以 用LimitRange设置默认值),用户超额后禁止创建新的资源

优秀的个人博客,低调大师

Python Type Hints 从入门到实践

Python 想必大家都已经很熟悉了,甚至关于它有用或者无用的论点大家可能也已经看腻了。但是无论如何,它作为一个将加入高考科目的语言还是有它独到之处的,今天我们就再展开聊聊 Python。 Python 是一门动态强类型语言 《流畅的 Python》一书中提到,如果一门语言很少隐式转换类型,说明它是强类型语言,例如 Java、C++ 和 Python 就是强类型语言。 同时如果一门语言经常隐式转换类型,说明它是弱类型语言,PHP、JavaScript 和 Perl 是弱类型语言。 当然上面这种简单的示例对比,并不能确切的说 Python 是一门强类型语言,因为 Java 同样支持 integer 和 string 相加操作,且 Java 是强类型语言。因此《流畅的 Python》一书中还有关于静态类型和动态类型的定义:在编译时检查类型的语言是静态类型语言,在运行时检查类型的语言是动态类型语言。静态语言需要声明类型(有些现代语言使用类型推导避免部分类型声明)。 综上所述,关于 Python 是动态强类型语言是比较显而易见没什么争议的。 Type Hints 初探 Python 在 PEP 484(Python Enhancement Proposals,Python 增强建议书)[https://www.python.org/dev/peps/pep-0484/]中提出了 Type Hints(类型注解)。进一步强化了 Python 是一门强类型语言的特性,它在 Python3.5 中第一次被引入。使用 Type Hints 可以让我们编写出带有类型的 Python 代码,看起来更加符合强类型语言风格。 这里定义了两个 greeting 函数: 普通的写法如下: name = "world" def greeting(name): return "Hello " + name greeting(name) 加入了 Type Hints 的写法如下: name: str = "world" def greeting(name: str) -> str: return "Hello " + name greeting(name) 以 PyCharm 为例,在编写代码的过程中 IDE 会根据函数的类型标注,对传递给函数的参数进行类型检查。如果发现实参类型与函数的形参类型标注不符就会有如下提示: 常见数据结构的 Type Hints 写法 上面通过一个 greeting 函数展示了 Type Hints 的用法,接下来我们就 Python 常见数据结构的 Type Hints 写法进行更加深入的学习。 默认参数 Python 函数支持默认参数,以下是默认参数的 Type Hints 写法,只需要将类型写到变量和默认参数之间即可。 def greeting(name: str = "world") -> str: return "Hello " + name greeting() 自定义类型 对于自定义类型,Type Hints 同样能够很好的支持。它的写法跟 Python 内置类型并无区别。 class Student(object): def __init__(self, name, age): self.name = name self.age = age def student_to_string(s: Student) -> str: return f"student name: {s.name}, age: {s.age}." student_to_string(Student("Tim", 18)) 当类型标注为自定义类型时,IDE 也能够对类型进行检查。 容器类型 当我们要给内置容器类型添加类型标注时,由于类型注解运算符 [] 在 Python 中代表切片操作,因此会引发语法错误。所以不能直接使用内置容器类型当作注解,需要从 typing 模块中导入对应的容器类型注解(通常为内置类型的首字母大写形式)。 from typing import List, Tuple, Dict l: List[int] = [1, 2, 3] t: Tuple[str, ...] = ("a", "b") d: Dict[str, int] = { "a": 1, "b": 2, } 不过 PEP 585[https://www.python.org/dev/peps/pep-0585/]的出现解决了这个问题,我们可以直接使用 Python 的内置类型,而不会出现语法错误。 l: list[int] = [1, 2, 3] t: tuple[str, ...] = ("a", "b") d: dict[str, int] = { "a": 1, "b": 2, } 类型别名 有些复杂的嵌套类型写起来很长,如果出现重复,就会很痛苦,代码也会不够整洁。 config: list[tuple[str, int], dict[str, str]] = [ ("127.0.0.1", 8080), { "MYSQL_DB": "db", "MYSQL_USER": "user", "MYSQL_PASS": "pass", "MYSQL_HOST": "127.0.0.1", "MYSQL_PORT": "3306", }, ] def start_server(config: list[tuple[str, int], dict[str, str]]) -> None: ... start_server(config) 此时可以通过给类型起别名的方式来解决,类似变量命名。 Config = list[tuple[str, int], dict[str, str]] config: Config = [ ("127.0.0.1", 8080), { "MYSQL_DB": "db", "MYSQL_USER": "user", "MYSQL_PASS": "pass", "MYSQL_HOST": "127.0.0.1", "MYSQL_PORT": "3306", }, ] def start_server(config: Config) -> None: ... start_server(config) 这样代码看起来就舒服多了。 可变参数 Python 函数一个非常灵活的地方就是支持可变参数,Type Hints 同样支持可变参数的类型标注。 def foo(*args: str, **kwargs: int) -> None: ... foo("a", "b", 1, x=2, y="c") IDE 仍能够检查出来。 泛型 使用动态语言少不了泛型的支持,Type Hints 针对泛型也提供了多种解决方案。 TypeVar 使用 TypeVar 可以接收任意类型。 from typing import TypeVar T = TypeVar("T") def foo(*args: T, **kwargs: T) -> None: ... foo("a", "b", 1, x=2, y="c") Union 如果不想使用泛型,只想使用几种指定的类型,那么可以使用 Union 来做。比如定义 concat 函数只想接收 str 或 bytes 类型。 from typing import Union T = Union[str, bytes] def concat(s1: T, s2: T) -> T: return s1 + s2 concat("hello", "world") concat(b"hello", b"world") concat("hello", b"world") concat(b"hello", "world") IDE 的检查提示如下图: TypeVar 和 Union 区别 TypeVar 不只可以接收泛型,它也可以像 Union 一样使用,只需要在实例化时将想要指定的类型范围当作参数依次传进来来即可。跟 Union 不同的是,使用 TypeVar 声明的函数,多参数类型必须相同,而 Union 不做限制。 from typing import TypeVar T = TypeVar("T", str, bytes) def concat(s1: T, s2: T) -> T: return s1 + s2 concat("hello", "world") concat(b"hello", b"world") concat("hello", b"world") 以下是使用 TypeVar 做限定类型时的 IDE 提示: Optional Type Hints 提供了 Optional 来作为 Union[X, None] 的简写形式,表示被标注的参数要么为 X 类型,要么为 None,Optional[X] 等价于 Union[X, None]。 from typing import Optional, Union # None => type(None) def foo(arg: Union[int, None] = None) -> None: ... def foo(arg: Optional[int] = None) -> None: ... Any Any 是一种特殊的类型,可以代表所有类型。未指定返回值与参数类型的函数,都隐式地默认使用 Any,所以以下两个 greeting 函数写法等价: from typing import Any def greeting(name): return "Hello " + name def greeting(name: Any) -> Any: return "Hello " + name 当我们既想使用 Type Hints 来实现静态类型的写法,也不想失去动态语言特有的灵活性时,即可使用 Any。 Any 类型值赋给更精确的类型时,不执行类型检查,如下代码 IDE 并不会有错误提示: from typing import Any a: Any = None a = [] # 动态语言特性 a = 2 s: str = '' s = a # Any 类型值赋给更精确的类型 可调用对象(函数、类等) Python 中的任何可调用类型都可以使用 Callable 进行标注。如下代码标注中 Callable[[int], str],[int] 表示可调用类型的参数列表,str 表示返回值。 from typing import Callable def int_to_str(i: int) -> str: return str(i) def f(fn: Callable[[int], str], i: int) -> str: return fn(i) f(int_to_str, 2) 自引用 当我们需要定义树型结构时,往往需要自引用。当执行到 init 方法时 Tree 类型还没有生成,所以不能像使用 str 这种内置类型一样直接进行标注,需要采用字符串形式“Tree”来对未生成的对象进行引用。 class Tree(object): def __init__(self, left: "Tree" = None, right: "Tree" = None): self.left = left self.right = right tree1 = Tree(Tree(), Tree()) IDE 同样能够对自引用类型进行检查。 此形式不仅能够用于自引用,前置引用同样适用。 鸭子类型 Python 一个显著的特点是其对鸭子类型的大量应用,Type Hints 提供了 Protocol 来对鸭子类型进行支持。定义类时只需要继承 Protocol 就可以声明一个接口类型,当遇到接口类型的注解时,只要接收到的对象实现了接口类型的所有方法,即可通过类型注解的检查,IDE 便不会报错。这里的 Stream 无需显式继承 Interface 类,只需要实现了 close 方法即可。 from typing import Protocol class Interface(Protocol): def close(self) -> None: ... # class Stream(Interface): class Stream: def close(self) -> None: ... def close_resource(r: Interface) -> None: r.close() f = open("a.txt") close_resource(f) s: Stream = Stream() close_resource(s) 由于内置的 open 函数返回的文件对象和 Stream 对象都实现了 close 方法,所以能够通过 Type Hints 的检查,而字符串“s”并没有实现 close 方法,所以 IDE 会提示类型错误。 Type Hints 的其他写法 实际上 Type Hints 不只有一种写法,Python 为了兼容不同人的喜好和老代码的迁移还实现了另外两种写法。 使用注释编写 来看一个 tornado 框架的例子(tornado/web.py)。适用于在已有的项目上做修改,代码已经写好了,后期需要增加类型标注。 使用单独文件编写(.pyi) 可以在源代码相同的目录下新建一个与 .py 同名的 .pyi 文件,IDE 同样能够自动做类型检查。这么做的优点是可以对原来的代码不做任何改动,完全解耦。缺点是相当于要同时维护两份代码。 Type Hints 实践 基本上,日常编码中常用的 Type Hints 写法都已经介绍给大家了,下面就让我们一起来看看如何在实际编码中中应用 Type Hints。 dataclass——数据类 dataclass 是一个装饰器,它可以对类进行装饰,用于给类添加魔法方法,例如 init() 和 repr() 等,它在 PEP 557[https://www.python.org/dev/peps/pep-0557/]中被定义。 from dataclasses import dataclass, field @dataclass class User(object): id: int name: str friends: list[int] = field(default_factory=list) data = { "id": 123, "name": "Tim", } user = User(**data) print(user.id, user.name, user.friends) # > 123 Tim [] 以上使用 dataclass 编写的代码同如下代码等价: class User(object): def __init__(self, id: int, name: str, friends=None): self.id = id self.name = name self.friends = friends or [] data = { "id": 123, "name": "Tim", } user = User(**data) print(user.id, user.name, user.friends) # > 123 Tim [] 注意:dataclass 并不会对字段类型进行检查。 可以发现,使用 dataclass 来编写类可以减少很多重复的样板代码,语法上也更加清晰。 Pydantic Pydantic 是一个基于 Python Type Hints 的第三方库,它提供了数据验证、序列化和文档的功能,是一个非常值得学习借鉴的库。以下是一段使用 Pydantic 的示例代码: from datetime import datetime from typing import Optional from pydantic import BaseModel class User(BaseModel): id: int name = 'John Doe' signup_ts: Optional[datetime] = None friends: list[int] = [] external_data = { 'id': '123', 'signup_ts': '2021-09-02 17:00', 'friends': [1, 2, '3'], } user = User(**external_data) print(user.id) # > 123 print(repr(user.signup_ts)) # > datetime.datetime(2021, 9, 2, 17, 0) print(user.friends) # > [1, 2, 3] print(user.dict()) """ { 'id': 123, 'signup_ts': datetime.datetime(2021, 9, 2, 17, 0), 'friends': [1, 2, 3], 'name': 'John Doe', } """ 注意:Pydantic 会对字段类型进行强制检查。 Pydantic 写法上跟 dataclass 非常类似,但它做了更多的额外工作,还提供了如 .dict() 这样非常方便的方法。 再来看一个 Pydantic 进行数据验证的示例,当 User 类接收到的参数不符合预期时,会抛出 ValidationError 异常,异常对象提供了 .json() 方法方便查看异常原因。 from pydantic import ValidationError try: User(signup_ts='broken', friends=[1, 2, 'not number']) except ValidationError as e: print(e.json()) """ [ { "loc": [ "id" ], "msg": "field required", "type": "value_error.missing" }, { "loc": [ "signup_ts" ], "msg": "invalid datetime format", "type": "value_error.datetime" }, { "loc": [ "friends", 2 ], "msg": "value is not a valid integer", "type": "type_error.integer" } ] """ 所有报错信息都保存在一个 list 中,每个字段的报错又保存在嵌套的 dict 中,其中 loc 标识了异常字段和报错位置,msg 为报错提示信息,type 则为报错类型,这样整个报错原因一目了然。 MySQLHandler MySQLHandler[https://github.com/jianghushinian/python-scripts/blob/main/scripts/mysql_handler_type_hints.py]是我对 pymysql 库的封装,使其支持使用 with 语法调用 execute 方法,并且将查询结果从 tuple 替换成 object,同样也是对 Type Hints 的应用。 class MySQLHandler(object): """MySQL handler""" def __init__(self): self.conn = pymysql.connect( host=DB_HOST, port=DB_PORT, user=DB_USER, password=DB_PASS, database=DB_NAME, charset=DB_CHARSET, client_flag=CLIENT.MULTI_STATEMENTS, # execute multi sql statements ) self.cursor = self.conn.cursor() def __del__(self): self.cursor.close() self.conn.close() @contextmanager def execute(self): try: yield self.cursor.execute self.conn.commit() except Exception as e: self.conn.rollback() logging.exception(e) @contextmanager def executemany(self): try: yield self.cursor.executemany self.conn.commit() except Exception as e: self.conn.rollback() logging.exception(e) def _tuple_to_object(self, data: List[tuple]) -> List[FetchObject]: obj_list = [] attrs = [desc[0] for desc in self.cursor.description] for i in data: obj = FetchObject() for attr, value in zip(attrs, i): setattr(obj, attr, value) obj_list.append(obj) return obj_list def fetchone(self) -> Optional[FetchObject]: result = self.cursor.fetchone() return self._tuple_to_object([result])[0] if result else None def fetchmany(self, size: Optional[int] = None) -> Optional[List[FetchObject]]: result = self.cursor.fetchmany(size) return self._tuple_to_object(result) if result else None def fetchall(self) -> Optional[List[FetchObject]]: result = self.cursor.fetchall() return self._tuple_to_object(result) if result else None 运行期类型检查 Type Hints 之所以叫 Hints 而不是 Check,就是因为它只是一个类型的提示而非真正的检查。上面演示的 Type Hints 用法,实际上都是 IDE 在帮我们完成类型检查的功能,但实际上,IDE 的类型检查并不能决定代码执行期间是否报错,仅能在静态期做到语法检查提示的功能。 要想实现在代码执行阶段强制对类型进行检查,则需要我们通过自己编写代码或引入第三方库的形式(如上面介绍的 Pydantic)。下面我通过一个 type_check 函数实现了运行期动态检查类型,来供你参考: from inspect import getfullargspec from functools import wraps from typing import get_type_hints def type_check(fn): @wraps(fn) def wrapper(*args, **kwargs): fn_args = getfullargspec(fn)[0] kwargs.update(dict(zip(fn_args, args))) hints = get_type_hints(fn) hints.pop("return", None) for name, type_ in hints.items(): if not isinstance(kwargs[name], type_): raise TypeError(f"expected {type_.__name__}, got {type(kwargs[name]).__name__} instead") return fn(**kwargs) return wrapper # name: str = "world" name: int = 2 @type_check def greeting(name: str) -> str: return str(name) print(greeting(name)) # > TypeError: expected str, got int instead 只要给 greeting 函数打上 type_check 装饰器,即可实现运行期类型检查。 附录 如果你想继续深入学习使用 Python Type Hints,以下是一些我推荐的开源项目供你参考: Pydantic [https://github.com/samuelcolvin/pydantic] FastAPI [https://github.com/tiangolo/fastapi] Tornado [https://github.com/tornadoweb/tornado] Flask [https://github.com/pallets/flask] Chia-pool [https://github.com/Chia-Network/pool-reference] MySQLHandler [https://github.com/jianghushinian/python-scripts/blob/main/scripts/mysql_handler_type_hints.py] 推荐阅读 TypeScript 枚举指南 实战经验分享:使用 PyO3 来构建你的 Python 模块
资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册