首页 文章 精选 留言 我的

精选列表

搜索[快直播],共10005篇文章
优秀的个人博客,低调大师

特性快闪:使用 Databend 玩转 Iceberg

作者:尚卓燃(PsiACE) 澳门科技大学在读硕士,Databend 研发工程师实习生 Apache OpenDAL(Incubating) Committer https://github.com/PsiACE 几周前,Databricks 和 Snowflake 召开了各自的年度大会,除了今年一路持续走红的 AI ,数据湖/数据仓库技术的发展仍然值得关注,毕竟数据才是基本盘。Apache Iceberg 无疑是数据湖方案的大赢家,Databricks 新推出的 UniForm 为以 Apache Iceberg 和 Hudi 表格式读取 Delta 中的数据提供了进一步的支持。而 Snowflake 也适时推出了 Iceberg Tables 更新,宣称要进一步打破数据孤岛。 Databend 最近几个月正在推动的重要新特性之一就是支持读取 Apache Iceberg 表格式的数据,尽管还没有完全落地,但已经取得了不错的进展。 今天这篇文章旨在为大家提前演示这一新特性 —— 使用 Databend 挂载并查询 Iceberg Catalog ,我们将介绍 Iceberg、表格式的一些核心概念,并且试图介绍 Databend 的解决方案(包括 Databend 的多源数据目录能力和以 Rust 从头实现的 IceLake)。当然,作为演示,我们将会提供完整的 workshop ,供大家尝鲜体验。 Apache Iceberg 时至今日,越来越多的数据进入云端,并且存储在对象存储之中,但这并不能完全适应现代分析的需求。这里有两个问题需要解决:第一个是数据以何种形式组织,也就是说,如何得到更结构化的数据存储。第二个问题还要更进一步,如何为用户提供更广泛的一致性保证以及业务中需要的模式信息,以及更多适应现代分析负载的高级特性。 数据湖往往会关注并解决第一个问题,而表格式则会致力于为第二个问题提供解决方案。 Apache Iceberg 是一种高性能的开放表格式,专为大规模分析工作负载而设计,简单而又可靠。同时支持 Spark、Trino、Flink、Presto、Hive 和 Impala 等查询引擎,并且具备模式演变(Full Schema Evolution)、时间旅行和回滚等杀手级特性。另外,Apache Iceberg 的数据分片和明确定义的数据结构还使得对数据源进行并发访问更加安全、可靠和方便。 如果你对 Iceberg 感兴趣,我们也推荐阅读像 Docker, Spark, and Iceberg: The Fastest Way to Try Iceberg! 这样的文章进行探索。 表格式初探 表格式(Table Format)是一种利用文件集合存储数据的规范。它主要包含以下三个部分的定义: 如何将数据存储在文件中 如何存储相关文件的元数据 如何存储有关表本身的元数据 表格式的文件通常存储在 HDFS、S3 或 GCS 这样的底层存储服务中,上层则会对接 Databend、Snowflake 等数据仓库。相比 CSV 或 Parquet ,表格式提供了表形式的标准的结构化数据定义,无需加载到数据仓库中就可以使用。 尽管表格式领域还有像 Delta Lake 和 Apache Hudi 这样的强劲对手,但这篇文章是关于 Apache Iceberg 的,所以,还是让我们把目光转向 Apache Iceberg ,一起了解一下它的底层文件组织结构。 上图中的 s0 、s1 代表的是表的快照信息(snapshot),也就是表在某个时刻的状态。每次 commit 都会生成一个快照,每个快照都会对应一个清单列表(manifest list),而每个清单列表可以维护多个清单文件(manifest file)的地址与统计信息,包括路径和分区范围等。清单文件中会记录当前操作生成数据文件(data file)的地址和统计信息,比如列中的最大值最小值和数据行数等。 Databend 多源数据目录 要想在 Databend 中实现 Iceberg 集成,头一件是 Databend 的多源数据目录能力。多源数据目录将会允许将原本由其他数据分析系统所管理的数据挂载到 Databend 。 从设计之初,Databend 的目标就是成为云原生的 OLAP 数据仓库,并考虑到多源数据处理的问题。Databend 中的数据按三层进行组织:catalog -> database -> table ,catalog 作为数据最大一层,会包含所有的数据库和表。 团队在此基础上设计并实现对 Hive 和 Iceberg 数据目录的支持,提供配置文件和 CREATE CATALOG 语句多种挂载形式,从而支持对相关数据进行查询。 要想挂载数据位于 S3 中的 Iceberg Catalog,只需要执行下面的 SQL 语句: CREATE CATALOG iceberg_ctl TYPE=ICEBERG CONNECTION=( URL='s3://warehouse/path/to/db' AWS_KEY_ID='admin' AWS_SECRET_KEY='password' ENDPOINT_URL='your-endpoint-url' ); IceLake - Apache Iceberg 的纯 Rust 实现 尽管 Rust 生态中近年来涌现出不少数据库、大数据分析相关的新项目,但 Rust 生态中仍然缺乏成熟的 Apache Iceberg 绑定,这为 Databend 集成 Iceberg 制造了不少困难。 Databend Labs 支持并发起的 IceLake 旨在填补这一空白,并致力于建立一个开放生态系统: 用户可以从 任何 存储服务(如 s3、gcs、azblob、hdfs 等)读写 Iceberg 表。 任何 数据库都可以集成 icelake,以支持读写 Iceberg 表。 提供原生的 arrow 格式互转换的能力。 提供多种语言绑定,使其他语言可以享有 Rust 核心带来的 Iceberg 生态支持。 当前 IceLake 已经支持读取 Apache Iceberg 存储服务中的数据(Parquet 格式)。而 Databend 的 Iceberg 数据目录能力正是由 IceLake 支撑的,其设计与实现在和 Databend 集成中得到了验证。 此外,我们还与 Iceberg 社区成员携手发起并参与 iceberg-rust 项目,旨在将 icelake 中 iceberg 相关的实现贡献给上游,目前第一个版本正紧锣密鼓的开发中,欢迎关注https://github.com/apache/iceberg-rust 。 Workshop:体验 Databend 的 Iceberg 能力 在这个 Workshop 中,我们将会展示如何准备 Iceberg 表格式的数据,并以 Catalog 的形式将其挂载到 Databend 上,并执行一些基本的查询。相关的文件和配置可以在 PsiACE/databend-workshop 中找到。 如果你本身有一些符合 Iceberg 表格式的数据存放在 OpenDAL 支持的存储服务中,我们更推荐使用 Databend Cloud ,这样你就可以跳过繁琐的服务部署和数据准备流程,轻松上手 Iceberg Catalog 。 启动服务 为了简化 Iceberg 的服务部署和数据准备问题,我们将会使用 Docker 和 Docker Compose ,你需要先安装这些组件,然后编写 docker-compose.yml 文件。 version: "3" services: spark-iceberg: image: tabulario/spark-iceberg container_name: spark-iceberg build: spark/ networks: iceberg_net: depends_on: - rest - minio volumes: - ./warehouse:/home/iceberg/warehouse - ./notebooks:/home/iceberg/notebooks/notebooks environment: - AWS_ACCESS_KEY_ID=admin - AWS_SECRET_ACCESS_KEY=password - AWS_REGION=us-east-1 ports: - 8888:8888 - 8080:8080 - 10000:10000 - 10001:10001 rest: image: tabulario/iceberg-rest container_name: iceberg-rest networks: iceberg_net: ports: - 8181:8181 environment: - AWS_ACCESS_KEY_ID=admin - AWS_SECRET_ACCESS_KEY=password - AWS_REGION=us-east-1 - CATALOG_WAREHOUSE=s3://warehouse/ - CATALOG_IO__IMPL=org.apache.iceberg.aws.s3.S3FileIO - CATALOG_S3_ENDPOINT=http://minio:9000 minio: image: minio/minio container_name: minio environment: - MINIO_ROOT_USER=admin - MINIO_ROOT_PASSWORD=password - MINIO_DOMAIN=minio networks: iceberg_net: aliases: - warehouse.minio ports: - 9001:9001 - 9000:9000 command: ["server", "/data", "--console-address", ":9001"] mc: depends_on: - minio image: minio/mc container_name: mc networks: iceberg_net: environment: - AWS_ACCESS_KEY_ID=admin - AWS_SECRET_ACCESS_KEY=password - AWS_REGION=us-east-1 entrypoint: > /bin/sh -c " until (/usr/bin/mc config host add minio http://minio:9000 admin password) do echo '...waiting...' && sleep 1; done; /usr/bin/mc rm -r --force minio/warehouse; /usr/bin/mc mb minio/warehouse; /usr/bin/mc policy set public minio/warehouse; tail -f /dev/null " networks: iceberg_net: 在上述的配置文件中,我们使用 MinIO 作为底层存储,Iceberg 提供表格式能力,至于 spark-iceberg ,可以帮助我们准备一些预置数据并执行转换操作。 接下来,我们在 docker-compose.yml 文件对应的目录下启动所有服务: docker-compose up -d 数据准备 在这个 Workshop 中,我们计划使用 NYC Taxis 数据集(纽约出租车搭乘数据),在 spark-iceberg 中已经内置了 Parquet 数据,我们只需要将其转化为 Iceberg 格式。 首先启用 pyspark-notebook : docker exec -it spark-iceberg pyspark-notebook 接下来我们就可以在 http://localhost:8888 使用 Jupyter Notebook : 这里我们需要运行一小段程序,实施数据转换的操作: df = spark.read.parquet("/home/iceberg/data/yellow_tripdata_2021-04.parquet") df.write.saveAsTable("nyc.taxis", format="iceberg") 第一行将会读取 Parquet 数据,而第二行将会将其转储为 Iceberg 格式。 为了验证数据是否成功转换,我们可以访问位于 http://localhost:9001 的 MinIO 实例,可以看到数据是按之前描述的 Iceberg 底层文件组织形式进行管理的。 部署 Databend 这里我们使用手动部署单节点 Databend 服务的形式,总体上部署过程可以参考 Databend 官方文档 ,需要注意的一些细节如下: 首先是需要为日志和 Meta 数据准备相关的目录 sudo mkdir /var/log/databend sudo mkdir /var/lib/databend sudo chown -R $USER /var/log/databend sudo chown -R $USER /var/lib/databend 其次,因为默认的 admin_api_address 已经被前面的服务占用掉,所以需要编辑 databend-query.toml 进行一些修改避免冲突: admin_api_address = "0.0.0.0:8088" 另外,我们还需要根据 Docs | Configuring Admin Users 配置管理员用户,由于只是一个 workshop ,这里选择最简单的方式,只是取消 [[query.users]] 字段以及 root 用户的注释: [[query.users]] name = "root" auth_type = "no_password" 由于我们本地部署 MinIO ,没有设置证书加密,需要使用不安全的 HTTP 协议加载数据,所以还需要更改 databend-query.toml 配置文件以允许这一行为。在生产服务中请尽可能避免开启它: ... [storage] ... allow_insecure = true ... 接下来就可以正常启动 Databend : ./scripts/start.sh 我们强烈推荐你使用 BendSQL 作为客户端,当然,我们也支持像 MySQL Client 和 HTTP API 等多种访问形式。 挂载 Iceberg Catalog 根据之前的配置文件,只需要执行下述 SQL 就可以一键挂载 Iceberg Catalog 。 CREATE CATALOG iceberg_ctl TYPE=ICEBERG CONNECTION=( URL='s3://warehouse/' AWS_KEY_ID='admin' AWS_SECRET_KEY='password' ENDPOINT_URL='http://localhost:9000' ); 为了验证是否成功,我们可以执行 SHOW CATALOGS 查看: 当然,我们也支持了 SHOW DATABASES 和 SHOW TABLES 语句,之前转换数据时的 nyc.taxis 对应在 MinIO 中是二级目录,而在 Databend 则会映射到数据库和表。 执行查询 数据已经挂载,那么就让我们执行一些简单的查询: 首先是对数据进行行数统计,可以看到一共挂载了 200 万行数据到 Databend: SELECT count(*) FROM iceberg_ctl.nyc.taxis; 让我们从其中几列试着取一些数据出来: SELECT tpep_pickup_datetime, tpep_dropoff_datetime, passenger_count FROM iceberg_ctl.nyc.taxis LIMIT 5; 下面的查询可以帮助我们探索乘客数量和旅程距离之间的相关性,这里只取其中 10 条结果: SELECT passenger_count, to_year(tpep_pickup_datetime) AS year, round(trip_distance) AS distance, count(*) FROM iceberg_ctl.nyc.taxis GROUP BY passenger_count, year, distance ORDER BY year, count(*) DESC LIMIT 10; 总结 在这篇文章中,我们介绍到 Apache Iceberg 表格式和 Databend 的相关解决方案,并且提供了一个相对完整的 workshop 供大家探索。 不难看出,尽管目前我们只为 Iceberg Catalog 提供了单机模式的目录挂载能力,但 Databend 可以胜任一些基本的查询处理任务。也欢迎大家在自己感兴趣的数据上进行尝试,并给我们提供一些反馈。

优秀的个人博客,低调大师

Windows Terminal 已上架,快尝鲜

Windows Terminal 早期预览版本已经上架 Microsoft Store。 Windows Terminal是微软今年在 Build 2019 上宣布推出的全新开源终端应用,它带来了许多强大的特性,比如多标签页、Unicode 和 UTF-8 字符支持、GPU 加速文本渲染引擎与自定义主题、样式和配置等。 Windwos Terminal 采用 C++ 开发,基于现代 Windows 应用平台和 UI 框架,同时整合共享的现代化组件,这些共享组件可以在 Windows 任何终端上使用,比如有一个全新的基于 DirectWrite 的文本布局和渲染引擎、一个能够存储 UTF-16 和 UTF-8 的文本缓冲区以及一个 VT 解析器/发射器。 此外,Windows Terminal 渲染器和输入栈被构建成了可重用的 Windows UI 控件,方便其他开发者将其整合到他们自己的应用中。 除了新特性,其实可以看到Windows Terminal 的 logo 也更新了,我们前两天才报导过,新的圆角 logo 继承了微软目前一贯的现代化图标风格,基于 Fluent Design System,该风格包含五大核心元素:Light(光感)、Depth(深度)、Motion(动画)、Material(材质)和 Scale(缩放)。 Windows Terminal 项目经理 Kayla Cinnamon在博客中介绍了终端的各种设置方法,详情查看: https://devblogs.microsoft.com/commandline/windows-terminal-microsoft-store-preview-release 应用下载地址: https://www.microsoft.com/en-us/p/windows-terminal-preview/9n0dx20hk701#

优秀的个人博客,低调大师

Redis为何这么快--数据存储角度

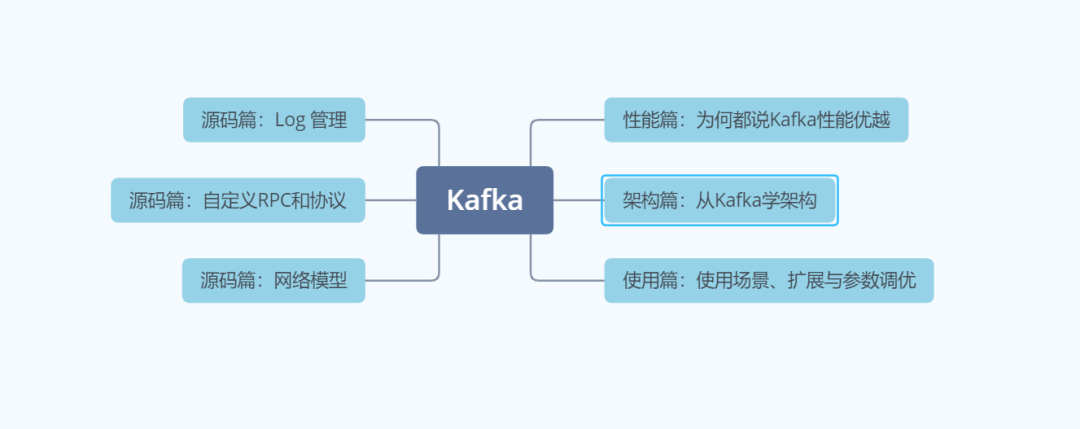
本文内容思维导图如下: 一、简介和应用 Redis是一个由ANSIC语言编写,性能优秀、支持网络、可持久化的K-K内存数据库,并提供多种语言的API。它常用的类型主要是 String、List、Hash、Set、ZSet 这5种 Redis在互联网公司一般有以下应用: String:缓存、限流、计数器、分布式锁、分布式Session Hash:存储用户信息、用户主页访问量、组合查询 List:微博关注人时间轴列表、简单队列 Set:赞、踩、标签、好友关系 Zset:排行榜 再比如电商在大促销时,会用一些特殊的设计来保证系统稳定,扣减库存可以考虑如下设计: 上图中,直接在Redis中扣减库存,记录日志后通过Worker同步到数据库,在设计同步Worker时需要考虑并发处理和重复处理的问题。 通过上面的应用场景可以看出Redis是非常高效和稳定的,那Redis底层是如何实现的呢? 二、Redis的对象redisObject 当我们执行set hello world命令时,会有以下数据模型: dictEntry:Redis给每个key-value键值对分配一个dictEntry,里面有着key和val的指针,next指向下一个dictEntry形成链表,这个指针可以将多个哈希值相同的键值对链接在一起,由此来解决哈希冲突问题(链地址法)。 sds:键key“hello”是以SDS(简单动态字符串)存储,后面详细介绍。 redisObject:值val“world”存储在redisObject中。实际上,redis常用5中类型都是以redisObject来存储的;而redisObject中的type字段指明了Value对象的类型,ptr字段则指向对象所在的地址。 redisObject对象非常重要,Redis对象的类型、内部编码、内存回收、共享对象等功能,都需要redisObject支持。这样设计的好处是,可以针对不同的使用场景,对5中常用类型设置多种不同的数据结构实现,从而优化对象在不同场景下的使用效率。 无论是dictEntry对象,还是redisObject、SDS对象,都需要内存分配器(如jemalloc)分配内存进行存储。jemalloc作为Redis的默认内存分配器,在减小内存碎片方面做的相对比较好。比如jemalloc在64位系统中,将内存空间划分为小、大、巨大三个范围;每个范围内又划分了许多小的内存块单位;当Redis存储数据时,会选择大小最合适的内存块进行存储。 前面说过,Redis每个对象由一个redisObject结构表示,它的ptr指针指向底层实现的数据结构,而数据结构由encoding属性决定。比如我们执行以下命令得到存储“hello”对应的编码: redis所有的数据结构类型如下(重要,后面会用): 三、String 字符串对象的底层实现可以是int、raw、embstr(上面的表对应有名称介绍)。embstr编码是通过调用一次内存分配函数来分配一块连续的空间,而raw需要调用两次。 int编码字符串对象和embstr编码字符串对象在一定条件下会转化为raw编码字符串对象。embstr:<=39字节的字符串。int:8个字节的长整型。raw:大于39个字节的字符串。 简单动态字符串(SDS),这种结构更像C++的String或者Java的ArrayList<Character>,长度动态可变: struct sdshdr { // buf 中已占用空间的长度 int len; // buf 中剩余可用空间的长度 int free; // 数据空间 char buf[]; // ’\0’空字符结尾 }; get:sdsrange---O(n) set:sdscpy—O(n) create:sdsnew---O(1) len:sdslen---O(1) 常数复杂度获取字符串长度:因为SDS在len属性中记录了长度,所以获取一个SDS长度时间复杂度仅为O(1)。 预空间分配:如果对一个SDS进行修改,分为一下两种情况: SDS长度(len的值)小于1MB,那么程序将分配和len属性同样大小的未使用空间,这时free和len属性值相同。举个例子,SDS的len将变成15字节,则程序也会分配15字节的未使用空间,SDS的buf数组的实际长度变成15+15+1=31字节(额外一个字节用户保存空字符)。 SDS长度(len的值)大于等于1MB,程序会分配1MB的未使用空间。比如进行修改之后,SDS的len变成30MB,那么它的实际长度是30MB+1MB+1byte。 惰性释放空间:当执行sdstrim(截取字符串)之后,SDS不会立马释放多出来的空间,如果下次再进行拼接字符串操作,且拼接的没有刚才释放的空间大,则那些未使用的空间就会排上用场。通过惰性释放空间避免了特定情况下操作字符串的内存重新分配操作。 杜绝缓冲区溢出:使用C字符串的操作时,如果字符串长度增加(如strcat操作)而忘记重新分配内存,很容易造成缓冲区的溢出;而SDS由于记录了长度,相应的操作在可能造成缓冲区溢出时会自动重新分配内存,杜绝了缓冲区溢出。 四、List List对象的底层实现是quicklist(快速列表,是ziplist 压缩列表 和linkedlist 双端链表 的组合)。Redis中的列表支持两端插入和弹出,并可以获得指定位置(或范围)的元素,可以充当数组、队列、栈等。 typedef struct listNode { // 前置节点 struct listNode *prev; // 后置节点 struct listNode *next; // 节点的值 void *value; } listNode; typedef struct list { // 表头节点 listNode *head; // 表尾节点 listNode *tail; // 节点值复制函数 void *(*dup)(void *ptr); // 节点值释放函数 void (*free)(void *ptr); // 节点值对比函数 int (*match)(void *ptr, void *key); // 链表所包含的节点数量 unsigned long len; } list; rpush: listAddNodeHead ---O(1) lpush: listAddNodeTail ---O(1) push:listInsertNode ---O(1) index : listIndex ---O(N) pop:ListFirst/listLast ---O(1) llen:listLength ---O(N) 4.1 linkedlist(双端链表) 此结构比较像Java的LinkedList,有兴趣可以阅读一下源码。 从图中可以看出Redis的linkedlist双端链表有以下特性:节点带有prev、next指针、head指针和tail指针,获取前置节点、后置节点、表头节点和表尾节点的复杂度都是O(1)。len属性获取节点数量也为O(1)。 与双端链表相比,压缩列表可以节省内存空间,但是进行修改或增删操作时,复杂度较高;因此当节点数量较少时,可以使用压缩列表;但是节点数量多时,还是使用双端链表划算。 4.2 ziplist(压缩列表) 当一个列表键只包含少量列表项,且是小整数值或长度比较短的字符串时,那么redis就使用ziplist(压缩列表)来做列表键的底层实现。 ziplist是Redis为了节约内存而开发的,是由一系列特殊编码的连续内存块(而不是像双端链表一样每个节点是指针)组成的顺序型数据结构;具体结构相对比较复杂,有兴趣读者可以看 Redis 哈希结构内存模型剖析。在新版本中list链表使用 quicklist 代替了 ziplist和 linkedlist: quickList 是 zipList 和 linkedList 的混合体。它将 linkedList 按段切分,每一段使用 zipList来紧凑存储,多个 zipList之间使用双向指针串接起来。因为链表的附加空间相对太高,prev 和 next 指针就要占去 16 个字节 (64bit 系统的指针是 8 个字节),另外每个节点的内存都是单独分配,会加剧内存的碎片化,影响内存管理效率。 quicklist 默认的压缩深度是 0,也就是不压缩。为了支持快速的 push/pop 操作,quicklist 的首尾两个 ziplist 不压缩,此时深度就是 1。为了进一步节约空间,Redis 还会对 ziplist 进行压缩存储,使用 LZF 算法压缩。 五、Hash Hash对象的底层实现可以是ziplist(压缩列表)或者hashtable(字典或者也叫哈希表)。 Hash对象只有同时满足下面两个条件时,才会使用ziplist(压缩列表):1.哈希中元素数量小于512个;2.哈希中所有键值对的键和值字符串长度都小于64字节。 hashtable哈希表可以实现O(1)复杂度的读写操作,因此效率很高。源码如下: typedef struct dict { // 类型特定函数 dictType *type; // 私有数据 void *privdata; // 哈希表 dictht ht[2]; // rehash 索引 // 当 rehash 不在进行时,值为 -1 int rehashidx; /* rehashing not in progress if rehashidx == -1 */ // 目前正在运行的安全迭代器的数量 int iterators; /* number of iterators currently running */ } dict; typedef struct dictht { // 哈希表数组 dictEntry **table; // 哈希表大小 unsigned long size; // 哈希表大小掩码,用于计算索引值 // 总是等于 size - 1 unsigned long sizemask; // 该哈希表已有节点的数量 unsigned long used; } dictht; typedef struct dictEntry { void *key; union {void *val;uint64_t u64;int64_t s64;} v; // 指向下个哈希表节点,形成链表 struct dictEntry *next; } dictEntry; typedef struct dictType { // 计算哈希值的函数 unsigned int (*hashFunction)(const void *key); // 复制键的函数 void *(*keyDup)(void *privdata, const void *key); // 复制值的函数 void *(*valDup)(void *privdata, const void *obj); // 对比键的函数 int (*keyCompare)(void *privdata, const void *key1, const void *key2); // 销毁键的函数 void (*keyDestructor)(void *privdata, void *key); // 销毁值的函数 void (*valDestructor)(void *privdata, void *obj); } dictType; 上面源码可以简化成如下结构: 这个结构类似于JDK7以前的HashMap<String,Object>,当有两个或以上的键被分配到哈希数组的同一个索引上时,会产生哈希冲突。Redis也使用链地址法来解决键冲突。即每个哈希表节点都有一个next指针,多个哈希表节点用next指针构成一个单项链表,链地址法就是将相同hash值的对象组织成一个链表放在hash值对应的槽位。 Redis中的字典使用hashtable作为底层实现的话,每个字典会带有两个哈希表,一个平时使用,另一个仅在rehash(重新散列)时使用。随着对哈希表的操作,键会逐渐增多或减少。为了让哈希表的负载因子维持在一个合理范围内,Redis会对哈希表的大小进行扩展或收缩(rehash),也就是将ht【0】里面所有的键值对分多次、渐进式的rehash到ht【1】里。 六、Set Set集合对象的底层实现可以是intset(整数集合)或者hashtable(字典或者也叫哈希表)。 intset(整数集合)当一个集合只含有整数,并且元素不多时会使用intset(整数集合)作为Set集合对象的底层实现。 typedef struct intset { // 编码方式 uint32_t encoding; // 集合包含的元素数量 uint32_t length; // 保存元素的数组 int8_t contents[]; } intset; sadd:intsetAdd---O(1) smembers:intsetGetO(1)---O(N) srem:intsetRemove---O(N) slen:intsetlen ---O(1) intset底层实现为有序,无重复数组保存集合元素。intset这个结构里的整数数组的类型可以是16位的,32位的,64位的。如果数组里所有的整数都是16位长度的,如果新加入一个32位的整数,那么整个16的数组将升级成一个32位的数组。升级可以提升intset的灵活性,又可以节约内存,但不可逆。 7.ZSet ZSet有序集合对象底层实现可以是ziplist(压缩列表)或者skiplist(跳跃表)。 当一个有序集合的元素数量比较多或者成员是比较长的字符串时,Redis就使用skiplist(跳跃表)作为ZSet对象的底层实现。 typedef struct zskiplist { // 表头节点和表尾节点 struct zskiplistNode *header, *tail; // 表中节点的数量 unsigned long length; // 表中层数最大的节点的层数 int level; } zskiplist; typedef struct zskiplistNode { // 成员对象 robj *obj; // 分值 double score; // 后退指针 struct zskiplistNode *backward; // 层 struct zskiplistLevel { // 前进指针 struct zskiplistNode *forward; // 跨度---前进指针所指向节点与当前节点的距离 unsigned int span; } level[]; } zskiplistNode; zadd---zslinsert---平均O(logN), 最坏O(N) zrem---zsldelete---平均O(logN), 最坏O(N) zrank--zslGetRank---平均O(logN), 最坏O(N) skiplist的查找时间复杂度是LogN,可以和平衡二叉树相当,但实现起来又比它简单。跳跃表(skiplist)是一种有序数据结构,它通过在某个节点中维持多个指向其他节点的指针,从而达到快速访问节点的目的。 参考: 《Redis设计与实现》--黄健宏

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册