首页 文章 精选 留言 我的

精选列表

搜索[初体验],共248篇文章
优秀的个人博客,低调大师

TiDB 之 TiCDC6.0 初体验

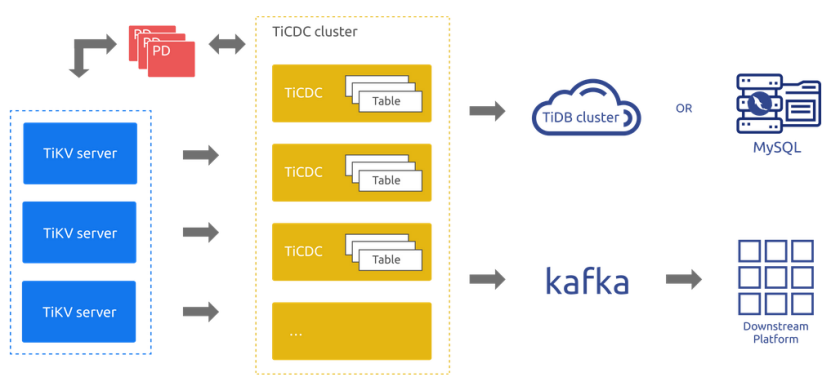
作者: JiekeXu 原文来源:https://tidb.net/blog/2dc4482b TiCDC 是一款 TiDB 增量数据同步工具,通过拉取上游 TiKV 的数据变更日志,具有将数据还原到与上游任意时刻一致的能力,同时提供开放数据协议(TiCDC Open Protocol),支持其他系统订阅数据变更,TiCDC 可以将数据解析为有序的行级变更数据输出到下游。 TiCDC 的系统架构如下图所示: TiCDC 运行时是一种无状态节点,通过 PD 内部的 etcd 实现高可用。TiCDC 集群支持创建多个同步任务,向多个不同的下游进行数据同步。 系统角色 TiKV CDC 组件:只输出 key-value (KV) change log。 o内部逻辑拼装 KV change log。 o提供输出 KV change log 的接口,发送数据包括实时 change log 和增量扫的 change log。 capture:TiCDC 运行进程,多个 capture 组成一个 TiCDC 集群,负责 KV change log 的同步。 o每个 capture 负责拉取一部分 KV change log。 o对拉取的一个或多个 KV change log 进行排序。 o向下游还原事务或按照 TiCDC Open Protocol 进行输出。 原理 原理:TiDB Server 负责接收 SQL,然后调用 TiKV 各个节点,然后输出自己节点的改变日志,然后将日志传到 TiCDC 集群,每个集群的 Capture 实际上为 TiCDC 节点,TiCDC 在内部逻辑拼装接收到的日志,提供输出日志的接口,发送到下游的 MySQL、Kafka 等。 每个 Capture 负责拉取一部分日志,然后自己排序,各个 capture 协同将自己接收的日志发送给capture 选择出来的owner,owner 进一步将日志排序,发送给目标下游端。 TiCDC 适用场景 TiCDC 适合源数据库为 TiDB,目标数据库支持 MySQL 兼容的任何数据库和 Kafka,同时 TiCDC Open Protocol 是一种行级别的数据变更通知协议,为监控、缓存、全文索引、分析引擎、异构数据库的主从复制等提供数据源。 数据库灾备:TiCDC 可以用于同构数据库之间的灾备场景,能够在灾难发生时保证主备集群数据的最终一致性,目前该场景仅支持 TiDB 作为主备集群。 数据集成:TiCDC 提供 TiCDC Canal-JSON Protocol,支持其他系统订阅数据变更,能够为监控、缓存、全文索引、数据分析、异构数据库的主从复制等场景提供数据源。 生产环境推荐配置 一般生产环境最低需要两台 16c 64G SSD 硬盘 万兆网卡的机器资源,如果是测试、学习环境,配置不需要这么高,也可以使用一个节点。 TiCDC环境部署 一般分两种情况:可以前期随 TiDB 一起部署,也可以后期进行扩容部署。 前期使用 tiup 部署 可以在 topology.yaml 文件中增加 tiup cluster deploy jiekexu-tidb v6.0.0 ./topology.yaml --user root -p cdc_servers 约定了将 TiCDC 服务部署到哪些机器上,同时可以指定每台机器上的服务配置。 gc-ttl:TiCDC 在 PD 设置的服务级别 GC safepoint 的 TTL (Time To Live) 时长,单位为秒,默认值为 86400,即 24 小时。 port:TiCDC 服务的监听端口,默认 8300 后期扩容 TiCDC 根据 保姆级分布式数据库 TiDB 6.0 集群安装手册 检查集群状态 tiup cluster status jiekexu-tidb 如果没有启动集群,需要先启动 tiup cluster start jiekexu-tidb 编辑扩容配置文件,准备将 TiCDC 节点 192.168.75.15/16 加入到集群中去. vim scale-out.yaml cdc_servers: - host: 192.168.75.15 gc-ttl: 86400 data_dir: /tidb-data/cdc-data/cdc-8300 - host: 192.168.75.16 gc-ttl: 86400 data_dir: /tidb-data/cdc-data/cdc-8300 加入 2 个 TiCDC 节点,IP 为 192.168.75.15/16,端口默认 8300,软件部署默认在 /tidb-deploy/cdc-8300 中,日志部署在 /tidb-deploy/cdc-8300/log 中,数据目录在 /tidb-data/cdc-data/cdc-8300 中。 使用 tiup 为原有 TiDB 数据库集群扩容 TiCDC 节点。 tiup cluster scale-out jiekexu-tidb scale-out.yaml -uroot -p [root@jiekexu1 ~]# tiup cluster scale-out jiekexu-tidb scale-out.yaml -uroot -p tiup is checking updates for component cluster ... Starting component `cluster`: /root/.tiup/components/cluster/v1.10.2/tiup-cluster scale-out jiekexu-tidb scale-out.yaml -uroot -p Input SSH password: + Detect CPU Arch Name - Detecting node 192.168.75.15 Arch info ... Done - Detecting node 192.168.75.16 Arch info ... Done + Detect CPU OS Name - Detecting node 192.168.75.15 OS info ... Done - Detecting node 192.168.75.16 OS info ... Done Please confirm your topology: Cluster type: tidb Cluster name: jiekexu-tidb Cluster version: v6.0.0 Role Host Ports OS/Arch Directories ---- ---- ----- ------- ----------- cdc 192.168.75.15 8300 linux/x86_64 /tidb-deploy/cdc-8300,/tidb-data/cdc-data/cdc-8300 cdc 192.168.75.16 8300 linux/x86_64 /tidb-deploy/cdc-8300,/tidb-data/cdc-data/cdc-8300 Attention: 1. If the topology is not what you expected, check your yaml file. 2. Please confirm there is no port/directory conflicts in same host. Do you want to continue? [y/N]: (default=N) y + [ Serial ] - SSHKeySet: privateKey=/root/.tiup/storage/cluster/clusters/jiekexu-tidb/ssh/id_rsa, publicKey=/root/.tiup/storage/cluster/clusters/jiekexu-tidb/ssh/id_rsa.pub + [Parallel] - UserSSH: user=tidb, host=192.168.75.16 + [Parallel] - UserSSH: user=tidb, host=192.168.75.14 + [Parallel] - UserSSH: user=tidb, host=192.168.75.15 + [Parallel] - UserSSH: user=tidb, host=192.168.75.13 + [Parallel] - UserSSH: user=tidb, host=192.168.75.12 + [Parallel] - UserSSH: user=tidb, host=192.168.75.11 + [Parallel] - UserSSH: user=tidb, host=192.168.75.17 + [Parallel] - UserSSH: user=tidb, host=192.168.75.17 + [Parallel] - UserSSH: user=tidb, host=192.168.75.17 + [Parallel] - UserSSH: user=tidb, host=192.168.75.17 + Download TiDB components - Download cdc:v6.0.0 (linux/amd64) ... Done + Initialize target host environments + Deploy TiDB instance - Deploy instance cdc -> 192.168.75.15:8300 ... Done - Deploy instance cdc -> 192.168.75.16:8300 ... Done + Copy certificate to remote host ……………………省略中间信息…………………… + Refresh components conifgs - Generate config pd -> 192.168.75.12:2379 ... Done - Generate config pd -> 192.168.75.13:2379 ... Done - Generate config pd -> 192.168.75.14:2379 ... Done - Generate config tikv -> 192.168.75.15:20160 ... Done - Generate config tikv -> 192.168.75.16:20160 ... Done - Generate config tikv -> 192.168.75.17:20160 ... Done - Generate config tidb -> 192.168.75.11:4000 ... Done - Generate config cdc -> 192.168.75.15:8300 ... Done - Generate config cdc -> 192.168.75.16:8300 ... Done - Generate config prometheus -> 192.168.75.17:9090 ... Done - Generate config grafana -> 192.168.75.17:3000 ... Done - Generate config alertmanager -> 192.168.75.17:9093 ... Done + Reload prometheus and grafana - Reload prometheus -> 192.168.75.17:9090 ... Done - Reload grafana -> 192.168.75.17:3000 ... Done + [ Serial ] - UpdateTopology: cluster=jiekexu-tidb Scaled cluster `jiekexu-tidb` out successfully 部署完成后检查集群状态,发现 TiCDC 已经部署到两节点了。我们看到 TiCDC 集群的 ID 为 192.168.75.15:8300, 192.168.75.16:8300,Status(状态)为 UP,表示 TiCDC 部署成功。 执行缩容操作 tiup cluster scale-in jiekexu-tidb --node 192.168.75.15:8300 这里仅下掉 75.15其中 --node 参数为需要下线节点的 ID。预期输出 Scaled cluster jiekexu-tidb in successfully 信息,表示缩容操作成功。 TiCDC 管理工具初尝试 cdc cli 是指通过 cdc binary 执行 cli 子命令,在以下接口描述中,通过 cdc binary 直接执行 cli 命令,PD 的监听 IP 地址为 192.168.75.12,端口2379。 使用 tiup ctl:v6.0.0 cdc 检查 TiCDC 的状态,如下: tiup ctl:v6.0.0 cdc capture list --pd=http://192.168.75.12:2379 命令中 --pd==http://192.168.75.12:2379,可以是任何一个 PD 节点,“is-owner”: true 代表当 TiCDC 节点为 owner 节点。为 false 代表备节点。 如果使用 TiUP 工具部署 TiCDC,那么则使用 TiUP 管理,命令可以写成 tiup cdc cli 数据同步准备 首先下游需要 MySQL 数据库,并为 MySQL 数据库( 端口号为 3306 )加入时区信息,创建数据库 jiekexu,并创建表 T1 ,注意不插入数据,如下操作: 192.168.75.12 已经安装好 MySQL5.7.38 数据库实例。 su – mysql mysql_tzinfo_to_sql /usr/share/zoneinfo | mysql -u root -p mysql -S /mysql/data/mysql3306/socket/mysql3306.sock mysql -uroot -p -P 3306 -S /mysql/data/mysql3306/socket/mysql3306.sock create database jiekexu; use jiekexu; create table T1(id int primary key, name varchar(20)); select * from T1; 然后 TiDB 端数据库准备 create database jiekexu; use jiekexu; create table T1(id int primary key, name varchar(20)); select * from T1; 创建同步任务 cd /tidb-deploy/cdc-8300/bin ./cdc cli changefeed create --pd=http://192.168.75.12:2379 --sink-uri="mysql://root:root@192.168.75.12:3306/" --changefeed-id="simple-replication-task" --sort-engine="unified" [WARN] some tables are not eligible to replicate, []model.TableName{model.TableName{Schema:"test", Table:"t1", TableID:0, IsPartition:false}} Could you agree to ignore those tables, and continue to replicate [Y/N] Y Create changefeed successfully! ID: simple-replication-task Info: {"sink-uri":"mysql://root:root@192.168.75.12:3306/","opts":{"_changefeed_id":"sink-verify"},"create-time":"2022-06-30T00:14:25.821140534+08:00","start-ts":434246584426037251,"target-ts":0,"admin-job-type":0,"sort-engine":"unified","sort-dir":"","config":{"case-sensitive":true,"enable-old-value":true,"force-replicate":false,"check-gc-safe-point":true,"filter":{"rules":["*.*"],"ignore-txn-start-ts":null},"mounter":{"worker-num":16},"sink":{"dispatchers":null,"protocol":"","column-selectors":null},"cyclic-replication":{"enable":false,"replica-id":0,"filter-replica-ids":null,"id-buckets":0,"sync-ddl":false},"scheduler":{"type":"table-number","polling-time":-1},"consistent":{"level":"none","max-log-size":64,"flush-interval":1000,"storage":""}},"state":"normal","error":null,"sync-point-enabled":false,"sync-point-interval":600000000000,"creator-version":"v6.0.0"} 说明: –changefeed-id:同步任务的 ID,格式需要符合正则表达式 [1]+(-[a-zA-Z0-9]+)*$。如果不指定该 ID,TiCDC 会自动生成一个 UUID(version 4 格式)作为 ID。 –sink-uri:同步任务下游的地址,需要按照以下格式进行配置,目前 scheme 支持 mysql/tidb/kafka/pulsar。 –sort-engine:指定 changefeed 使用的排序引擎。因 TiDB 和 TiKV 使用分布式架构,TiCDC 需要对数据变更记录进行排序后才能输出。该项支持 unified(默认)/memory/file: unified:优先使用内存排序,内存不足时则自动使用硬盘暂存数据。该选项默认开启。 memory:在内存中进行排序。 不建议使用,同步大量数据时易引发 OOM。 file:完全使用磁盘暂存数据。已经弃用,不建议在任何情况使用。 查看同步任务 ./cdc cli changefeed list --pd=http://192.168.75.12:2379 [ { "id": "simple-replication-task", "summary": { "state": "normal", "tso": 434246659203137537, "checkpoint": "2022-06-30 00:19:03.469", "error": null } } ] 注意:“state”: “normal” : 表示任务状态正常。 “tso”: 434246659203137537: 表示同步任务的时间戳信息。 “checkpoint”: “2022-06-30 00:19:03.469” :表示同步任务的时间。 详细查询复制任务信息 { "info": { "sink-uri": "mysql://root:root@192.168.75.12:3306/", "opts": { "_changefeed_id": "sink-verify" }, "create-time": "2022-06-30T00:14:25.821140534+08:00", "start-ts": 434246584426037251, "target-ts": 0, "admin-job-type": 0, "sort-engine": "unified", "sort-dir": "", "config": { "case-sensitive": true, "enable-old-value": true, "force-replicate": false, "check-gc-safe-point": true, "filter": { "rules": [ "*.*" ], "ignore-txn-start-ts": null }, "mounter": { "worker-num": 16 }, "sink": { "dispatchers": null, "protocol": "", "column-selectors": null }, "cyclic-replication": { "enable": false, "replica-id": 0, "filter-replica-ids": null, "id-buckets": 0, "sync-ddl": false }, "scheduler": { "type": "table-number", "polling-time": -1 }, "consistent": { "level": "none", "max-log-size": 64, "flush-interval": 1000, "storage": "" } }, "state": "normal", "error": null, "sync-point-enabled": false, "sync-point-interval": 600000000000, "creator-version": "v6.0.0" }, "status": { "resolved-ts": 434246739838369793, "checkpoint-ts": 434246739313819649, "admin-job-type": 0 }, "count": 0, "task-status": [ { "capture-id": "9163a533-97e2-4b64-838a-139c70ea89f3", "status": { "tables": null, "operation": null, "admin-job-type": 0 } }, { "capture-id": "6155ee47-1e22-4369-b2b7-670c43b11b46", "status": { "tables": null, "operation": null, "admin-job-type": 0 } } ] } 数据同步测试 对于同步任务进行验证,登录 TiDB 数据库,查询刚刚创建的 jiekexu 数据库下面的表 T1,并且插入三行数据,如下所示: 源端插入数据 insert into T1 values(1,'jiekexu'); insert into T1 values(2,'jiekexu dba'); insert into T1 values(2,'jiekexu tidb'); select * from T1; 登录 MySQL 数据库,查询 jiekexu 数据库下面的表 T1,发现数据库已经同步过去,如下所示: mysql> select * from T1; +----+--------------+ | id | name | +----+--------------+ | 1 | jiekexu | | 2 | jiekexu dba | | 3 | jiekexu tidb | +----+--------------+ 3 rows in set (0.00 sec) 源端更新、删除数据 mysql> update T1 set name='jiekexu tidb dba' where id=3; Query OK, 1 row affected (0.01 sec) Rows matched: 1 Changed: 1 Warnings: 0 mysql> select * from T1; +----+------------------+ | id | name | +----+------------------+ | 1 | jiekexu | | 2 | jiekexu dba | | 3 | jiekexu tidb dba | +----+------------------+ 3 rows in set (0.00 sec) mysql> delete from T1 where id=1; Query OK, 1 row affected (0.01 sec) mysql> select * from T1; +----+------------------+ | id | name | +----+------------------+ | 2 | jiekexu dba | | 3 | jiekexu tidb dba | +----+------------------+ 2 rows in set (0.01 sec) 目标端 MySQL 端查看 mysql> select * from T1; +----+------------------+ | id | name | +----+------------------+ | 1 | jiekexu | | 2 | jiekexu dba | | 3 | jiekexu tidb dba | +----+------------------+ 3 rows in set (0.00 sec) mysql> select * from T1; +----+------------------+ | id | name | +----+------------------+ | 2 | jiekexu dba | | 3 | jiekexu tidb dba | +----+------------------+ 2 rows in set (0.00 sec) 源端添加、修改、删除列 alter table T1 add addr varchar(50); alter table T1 modify name varchar(32); alter table t1 add changeTime datetime default now(); Alter table t1 drop column changeTime; 目标端查看也能正常同步。 源端新建表数据插入测试 CREATE TABLE `Test` ( `id` int(11) NOT NULL, `name` varchar(32) DEFAULT NULL, `addr` varchar(50) DEFAULT NULL, PRIMARY KEY (`id`) ); insert into Test values(1,'jiekexu','beijing'); 目标端 MySQL 端查看 停止同步任务 ./cdc cli changefeed --help Manage changefeed (changefeed is a replication task) Usage: cdc cli changefeed [flags] cdc cli changefeed [command] Available Commands: create Create a new replication task (changefeed) cyclic (Experimental) Utility about cyclic replication list List all replication tasks (changefeeds) in TiCDC cluster pause Pause a replication task (changefeed) query Query information and status of a replication task (changefeed) remove Remove a replication task (changefeed) resume Resume a paused replication task (changefeed) statistics Periodically check and output the status of a replication task (changefeed) update Update config of an existing replication task (changefeed) ./cdc cli changefeed pause --pd=192.168.75.12:2379 --changefeed-id simple-replication-task ./cdc cli changefeed pause --pd=http://192.168.75.12:2379 --changefeed-id simple-replication-task 注意:pause 停止任务时,pd 后面也可以不跟 http:// 协议,不会报错。 恢复同步任务 ./cdc cli changefeed resume --pd=http://192.168.75.12:2379 --changefeed-id simple-replication-task 注意:Pd 后面需要跟 http 协议,不然会报错。 删除同步任务 ./cdc cli changefeed remove --pd=http://192.168.75.12:2379 --changefeed-id simple-replication-task TiCDC 的限制 有效索引的相关要求 TiCDC 只能同步至少存在一个有效索引的表,有效索引的定义如下: 主键 (PRIMARY KEY) 为有效索引。 同时满足下列条件的唯一索引 (UNIQUE INDEX) 为有效索引: 索引中每一列在表结构中明确定义非空 (NOT NULL)。 索引中不存在虚拟生成列 (VIRTUAL GENERATED COLUMNS)。 TiCDC 从 4.0.8 版本开始,可通过修改任务配置来同步没有有效索引的表,但在数据一致性的保证上有所减弱。具体使用方法和注意事项参考同步没有有效索引的表。 暂不支持的场景 目前 TiCDC 暂不支持的场景如下: 暂不支持单独使用 RawKV 的 TiKV 集群。 暂不支持在 TiDB 中创建 SEQUENCE 的 DDL 操作和 SEQUENCE 函数。在上游 TiDB 使用 SEQUENCE 时,TiCDC 将会忽略掉上游执行的 SEQUENCE DDL 操作/函数,但是使用 SEQUENCE 函数的 DML 操作可以正确地同步。 对上游存在较大事务的场景提供部分支持,详见 TiCDC 是否支持同步大事务?有什么风险吗? 参考链接: https://docs.pingcap.com/zh/tidb/v6.0/ticdc-overview https://learn.pingcap.com/learner/course/30002

优秀的个人博客,低调大师

Android DataBinding使用(一):DataBinding初体验

目录 前言 MVVM ( Model — View — ViewModel )最初是在2005年由微软提出的一个UI架构概念 。 相比MVP模式,MVVM将Presenter改为了 ViewModel,同时实现View和VievvModel的双向绑定。 View层的变化会自动导致ViewMmlel发生变化,ViewModel的数据变化也会自动实现View的 刷新,开发者可以不用直接处理View和数据的更新操作,MVVM框架会完成这一切,MVVM 模式不同层之间关系如图所示。 在Google I/O 2015大会上,Android幵发闭队发布了官方 的MVVM模式支持函数库 Data Binding Library。Data Binding Library 是一个兼容函数库,可以在 Android 2.1 ( API Level 7 )及之 后的Android系统上面使用在使用Data Binding之前 , 需要确保Gradle的Android Studio插 件 版本大于或等于1.5.0-alphal,而且Amlmid Studio的版本号应该大于或等于1.3。 使用步骤 首先需要在module的build.gradle文件中添加如下代码,Android Studio会自动为我们集成需要的依赖库。 android { ... dataBinding { enabled = true } } 新建一个JavaBean对象,这里我把它命名为UserBean。 public class UserBean { private String userName; private int age; public UserBean(String userName, int age) { this.userName = userName; this.age = age; } public String getUserName() { return userName; } public void setUserName(String userName) { this.userName = userName; } public int getAge() { return age; } public void setAge(int age) { this.age = age; } } 编辑使用了DataBinding的Activity布局文件(这里是activity_main.xml),它与普通的布局文件有些不同,它的根标签是layout里面包含了data和以前常用的布局,其中data标签是用来实现数据绑定的,在data标签内定义了一个名为user的属性变量,类型是UserBean,并在控件中使用@{user.userName}的方式将数据绑定到控件上。 <?xml version="1.0" encoding="utf-8"?> <layout xmlns:android="http://schemas.android.com/apk/res/android" xmlns:app="http://schemas.android.com/apk/res-auto" > <data> <variable name="user" type="com.itfitness.databindingdemo.bean.UserBean"/> </data> <LinearLayout android:layout_width="match_parent" android:orientation="vertical" android:layout_height="match_parent"> <TextView android:layout_width="wrap_content" android:text="@{user.userName}" android:layout_gravity="center_horizontal" android:layout_height="wrap_content" /> <TextView android:layout_width="wrap_content" android:text='@{user.age+""}' android:layout_gravity="center_horizontal" android:layout_height="wrap_content" /> </LinearLayout> </layout> 在Activity中添加数据 public class MainActivity extends AppCompatActivity { @Override protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); ActivityMainBinding binding = DataBindingUtil.setContentView(this, R.layout.activity_main); binding.setUser(new UserBean("<张三>",18)); } } 这里的ActivityMainBinding是自动生成的,它是根据布局文件的名字来生成的:如activity_main-->ActivityMainBinding 、fragment-->FragmentBinding。 运行结果 技术博客:https://myml666.github.io

优秀的个人博客,低调大师

Docker初体验,关于Dockerfile那点事

一、Dockerfile的格式 Dockerfile的格式如下: # Comment 以“#”开头的行为注释行。跨行注释也必须加“#”,Dockerfile不支持连续字符“”。命令解析指令也是以“#”开头,命令解析器是一个可选项,位于Dockerfile的首行,只允许出现一次,第二次出现则被认为是注释,在解析器中换行符同样是不被支持的,但是其中的非断行空格是允许的。 #directive=value # directive =value # directive= value # directive = value # escap Escape在dockerfile中被用作转义字符和换行符,如果不特别指定,系统默认的转义字符为: (反斜杠)。转义不能在RUN命令中执行,除非位于行末进行格式换行。作为换行符时,escape允许Dockerfile指令跨行执行。反引号在Windows下非常有用(举例可以参阅官方文档) # escape=\ (反斜杠) 或 # escape=` (反引号) INSTRUCTION arguments INSTRUCTION一般被称为指令或者命令,对大小写不敏感,为了与其他参数区别开,习惯大写。 .dockerfileignore file 使用Dockerfile构建镜像时最好是将Dockerfile放置在一个新建的空目录下。然后将构建镜像所需要的文件添加到该目录中。为了提高构建镜像的效率,你可以在目录下新建一个.dockerignore文件来指定要忽略的文件和目录。.dockerignore文件的排除模式语法和 Git的.gitignore文件相似。 二、相关指令详解 FROM 每个Dockerfile必须以FROM指令开头,FROM指明了当前镜像创建的基镜像,也就是说每个镜像必须基于一个已存在的镜像进行创建。FROM指令后直接跟基镜像的名称或者镜像名称加标签。镜像的名称和标签可以去Docker Hub或者使用命令docker search keyword 进行搜索。用法如下: FROM <image> 或 FROM <image>[:<tag>] ARG ARG指令定义了用户可以在创建镜像时或者运行时传递的变量,申明于调用类似于shell中的变量申明与定义。 ARG CODE_VERSION=latest FROM base:${CODE_VERSION} ENV ENV指令用来定义镜像的环境变量,并且可以引用已经存在的环境变量,例如:HOME、HOSTNAME、PATH。ENV的值跟ARG指令申明的变量一样可以传递、被引用,定义方法也基本一致。 FROM busybox ENV foo /bar # WORKDIR /bar WORKDIR ${foo} Dockerfile中的ENV支持以下变量的访问:ADD、COPY、ENV、EXPOSE、FROM、LABEL、STOPSIGNAL、USER、VOLUME、WORKDIR。 RUN RUN指令在当前镜像的顶层中执行命令并提交结果,新产生的镜像用于下一步的Dockerfile。分层执行指令和生成提交符号Docker的核心概念,提交很方便,容器可以从镜像历史中的任意点创建,类似于源码控制。在shell形式中,可以使用(反斜杠)将单个RUN指令继续到下一行。RUN指令有两种使用格式: RUN <command>(shell形式,该命令在shell中运行,默认情况下/bin/sh -c在Linux中运行,cmd /S /CWindows中运行) RUN ["executable", "param1", "param2"](exec执行形式) [root@ChatDevOps ~]# cat Dockerfile FROM centos RUN mkdir /chatdevops RUN ["touch","/chatdevops/chatdevops.log"] RUN /bin/bash [root@ChatDevOps ~]# docker run -it --name chatdevops chatdevops /bin/bash [root@99484f802e71 /]# ll /chatdevops/chatdevops.log -rw-r--r--. 1 root root 0 May 29 03:00 /chatdevops/chatdevops.log CMD CMD的主要是为一个正运行的容器提供默认执行命令。如果存在多个CMD指令,那么只有最后一个会被执行。如果在容器运行时指定了命令,则CMD指定的默认内容会被替代。CMD一共有三种格式: CMD ["executable","param1","param2"] #(执行形式,这是比较常见的一种形式) CMD ["param1","param2"] #(以json数组的形式将两个参数存储下来,在指定了ENTRYPOINT 指令后,用CMD指定具体的参数,此处必须用双引号将涉及到的变量引起来) CMD command param1 param2 #(shell形式) [root@ChatDevOps ~]# cat Dockerfile FROM centos CMD echo "chatdevops" CMD ["echo","Hello world"] [root@ChatDevOps ~]# docker run -it --rm --name chatdevops chatdevops Hello world ENTRYPOINT ENTRYPOINT的格式和RUN指令格式一样,分为exec格式和shell格式。ENTRYPOINT的目的和CMD一样,都是在指定容器启动程序及参数。ENTRYPOINT在运行时 也可以替代,不过比CMD要略显繁琐,需要通过docker run的参数--entrypoint来指定。当指定了ENTRYPOINT后,CMD的含义就发生了改变,不再是直接的运行其命令,而是将CMD的内容作为参数传给ENTRYPOINT指令。 [root@ChatDevOps ~]# cat Dockerfile FROM ubuntu:18.04 RUN apt-get update \ && apt-get install -y curl \ && rm -rf /var/lib/apt/lists/* ENTRYPOINT [ "curl","-s","http://ip.cn" ] [root@ChatDevOps ~]# docker run e317e4042076 当前 IP:71.184.25.21 来自:北京市 [root@ChatDevOps ~]# docker run e317e4042076 -i HTTP/1.1 200 OK Date: Tue, 29 May 2018 09:00:10 GMT Content-Type: text/html; charset=UTF-8 Transfer-Encoding: chunked Connection: keep-alive Set-Cookie: __cfduid=d4439884e43e37c36aac129e9f4d0507f1527584410; expires=Wed, 29-May-19 09:00:10 GMT; path=/; domain=.ip.cn; HttpOnly Server: cloudflare CF-RAY: 4227c4e460886d9c-SJC LABEL LABEL指令用于添加一个元数据到镜像,键和值配对存在。例如可以给容器添加辅助说明信息。值中支持换行字符斜杠()。如果Docker中出现重复的键,则新的值会覆盖原来的值。为了减少Docker的层数,可以在单一LABEL指令中指定多个标签: LABEL multi.label1="value1" \ multi.label2="value2" \ other="value3" MAINTAINER MAINTAINER在新版本中已经废弃,可以使用LABEL来替代MAINTAINER进行声明。 EXPOSE EXPOSE指定容器在运行中监听的端口。默认情况下,EXPOSE指定的是TCP端口,若要指定监听udp端口: EXPOSE 80/udp COPY COPY能够从构建上下文中复制文件到新的一层中镜像中,COPY指令有两种形式: COPY [--chown=<user>:<group>] <src>... <dest> COPY [--chown=<user>:<group>] ["<src>",... "<dest>"] chown属性只支持Linux容器的构建。COPY命令支持通配符,可以把多个源文件复制到目标文件下。 ADD ADD的格式和用法基本与COPY一致,并在COPY的基础上新增了一些功能。ADD的源文件可以是一个URL。如果本地源路径的文件为一个tar压缩文件的话,压缩格式为gzip,bzip2以及xz的情况 下,ADD指令将会自动解压缩这个压缩文件到目标路径,来自于URL的远程文件则不会被解压。 VOLUME VOLUME旨在创建一个具有名称的挂载点。容器在运行时尽量保持存储层不发生数据写入操作。一个卷可以存在于一个或多个容器的特定目录,这个目录可以绕过联合文件系统,并提供数据共享或数据持久化功能。卷可以在容器间共享或重用,对卷的修改是及时生效的。对卷的修改不会对新的镜像产生影响,卷会一直存在直到没有容器使用它。可以使用数组的形式指定多个卷。使用方式如下: VOLUME /data VOLUME ["/data"] VOLUME ["data","test","chatdevops"] VOLUME也可以在创建容器时进行声明: [root@ChatDevOps docker]# docker run -it -v /myvolume --name myvolume chatdevops 以上命令创建一个名为myvolume的容器,同时挂载/myvolume。/myvolume在之前并不存在,在创建myvolume时同时创建了该目录。 USER USER指令为Dockerfile中全部RUN,CMD,ENTRYPOINT设置运行Image时使用的用户名或UID。这个用户或组必须事先在系统中存在。若不存在则下一层镜像以root用户进行执行。 USER <user>[:<group>] USER <UID>[:<GID>] WORKDIR WORKDIR用来为Dockerfile下文中的RUN, CMD, ENTRYPOINT, COPY和ADD等指令指定当前工作目录。如果存在多个WORKDIR则以指令钱最近的一条为参考。如果该目录不存在,则系统会自动创建该目录。如果要改变当前的工作目录,不能使用cd命令来切换,需要使用WORKDIR来进行切换。 ONBUILD 这是一个特殊的指令,它后面跟的是其它指令,比如 RUN , COPY等,而这些指令,在当前镜像构建时并不会被执行。只有当以当前镜像为基础镜像,去构建下一级镜像的时候才会被执行。 STOPSIGNAL STOPSIGNAL指令设置唤醒信号并将其发送到容器后退出。后跟信号值(无符号整数)或者SIGNAME格式的信号名称,例如SIGKILL。 STOPSIGNAL signal HEALTHCHECK Docker提供了HEALTHCHECK指令,通过该指令指定一行命令,用这行命令来判断容器主进程的服务状态是否还正常,从而比较真实的反应容器实际状态。当在一个镜像指定了HEALTHCHECK指令后,用其启动容器,初始状态会为 starting ,在HEALTHCHECK指令检查成功后变为healthy,如果连续一定次数失败,则会变为unhealthy。格式如下: HEALTHCHECK [OPTIONS] CMD command (check container health by running a command inside the container) HEALTHCHECK NONE (disable any healthcheck inherited from the base image) HEALTHCHECK 支持下列选项: --interval=<间隔> :两次健康检查的间隔,默认为 30 秒; --timeout=<时长> :健康检查命令运行超时时间,如果超过这个时间,本次健康检查就被视为失败,默认 30 秒; --retries=<次数> :当连续失败指定次数后,则将容器状态视为 unhealthy ,默认3次。 HEALTHCHECK在Dockerfile中只能出现一次,如果出现多次则最后一个生效。 SHELL SHEELL指令允许默认的shell形式被命令形式覆盖。在Linux系统中默认shell形式为 [“/bin/sh”, “-c”], 在 Windows上是[“cmd”, “/S”, “/C”]。SHELL指令必须用Dockerfile中的JSON格式写入。SHELL指令在Windows上特别有用,其中有两个常用的和完全不同的本机shell:cmd和powershell,以及包括sh的备用shell。 SHELL指令可以出现多次。每个SHELL指令都会覆盖所有以前的SHELL指令,并影响所有后续指令。 三、参考文献 https://docs.docker.com/engine/reference/builder/#usage

优秀的个人博客,低调大师

SQL自动化审核初体验

一、缘起 2015.12.5,广州,ACOUG Asia Tour 广州站 第一次参加ACOUG论坛,会上盖老师分享道:“云时代的DBA将自后向前置、DevOps势在必行—最佳实践是SQL审核”,当时心头一股狂热,原来数据库还能这样玩。 后来也在公司试水SQL审核,制定SQL开发规范、培训开发人员、人肉审核、人肉发布,乐此不疲,以为这就是传说中的数据库DevOps最佳实践;试水一段时间后,发现效果甚微,整个SQL审核过程都是人工,效率很低,而且可笑的是,开发人员也有同样的DB操作权限,干啥要听你DBA的呢?当时很天真的认为,只要DBA在SQL方面比开发更专业,人家就会自觉遵守游戏规则。现在回头看,当时站的太高,过于理想,不够踏实。 2017.5.11-13,北京,DTCC-数据库技术大会 第一次参加DTCC,这应该是转型专职DBA以来,收获最大的3天,全场超过一半讲师都讲到DB自动化运维,自此自动化运维在心里埋下一颗种子。 后来也在公司试水自动化运维,尝试用Python开发了几个小工具,切身感受到自动化带来的便利,自动化确实能避免很多低价值、重复繁琐的劳动。同时也一直在思考,能否借助自动化来实现SQL审核呢?也算是机缘巧合吧,偶然在github上发现一个SQL审核的开源项目archer,折腾试用一番后,两年前的那种狂热又冒出来了。 二、平台介绍 archer 基于inception的自动化SQL操作平台,支持工单、审核、认证、邮件、OSC等功能。 github地址:https://github.com/jly8866/archer 如果对archer做一个分解的话,个人觉得可以分为inception和django inception是内在,负责审核 django是外在,负责展示 ps:这种理解,不知道原作者会不会很郁闷,哈哈 inception 一个集审核、执行、备份及生成回滚语句于一身的MySQL自动化运维工具 github地址:https://github.com/mysql-inception/inception Django Django是一个开放源代码的Web应用框架,由Python写成。采用了MT'V的框架模式,即模型M,模板T和视图V。 三、二次开发 在archer的基础上也做了一些简单的二次开发: 屏蔽单点登录 修复邮件发送bug 显示中文全名 为工程师分配指定的数据库实例 接下来,计划在archer集成更多的功能: MSDB 数据归档 数据库备份 性能报告 巡检报告 四、小结 目前,已经将archer部署到生产环境,也为新上线的某x项目成功发布DB脚本,后续准备逐步铺开。 总的来说,个人觉得效果还是ok的,起码在数据库自动化和DevOps走出了一步,对比两年前的人工审核SQL,总结两点感受最深的经验: 一定要借助自动化工具/平台,纯人工效率实在低 一定要找到合适的审核点,让大家都来遵守,对于SQL审核来说,就是要把DB操作权限掌握在DBA手里,不能对外开放,这点一定要掐死了!!!是的,掐死了,要狠!!!哈哈 五、附录: 最后附上几张平台截图: 原文发布时间为:2018-01-29 本文作者:蓝剑锋 本文来自云栖社区合作伙伴“老叶茶馆”,了解相关信息可以关注“老叶茶馆”微信公众号

优秀的个人博客,低调大师

我的 OpenStack 代码贡献初体验

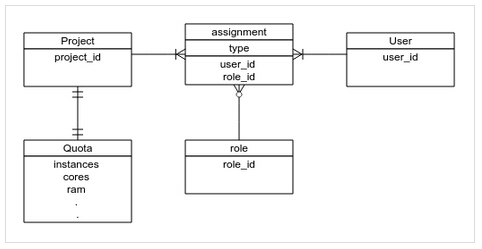
OpenStack如今已成为开源云平台中的明星项目,得到广泛关注。OpenStack的优秀出众依赖于众多开发者的努力,在享受其带来的便利与快捷的同时,为其做一份贡献也是一个开发者的义务。在前段时间的OpenStack的测试过程中,我发现Nova项目中的一个Bug,于是向社区提交了Bug报告,并提交代码修复了该Bug,从提交报告到代码入库经历近一月,下面重现整个过程。 一.发现Bug: Nova中的虚拟机软删除(soft-delete)功能,是指在一段时间内,仅将数据库中的某虚拟机记录做一个标记 (status='SOFT-DELETE'),然后将虚拟化平台(kvm等)中对应的虚拟机实例置为关机状态,当超过某一时间段后才将虚拟机实例真正删除;该功能为云平台用户提供了“后悔时间”,可以在一定程度上挽回误操作。默认情况下,软删除功能是关闭的,其开启方式是在nova配置文件中添加"reclaim_instance_interval"选项,并将其值设置为"后悔时间"的毫秒数。 在描述具体Bug前,需要对openstack中的用户管理方面的基本概念简单介绍一下。 上图是openstack用户模型的简化版本,为了便于理解将不属于keystone管理的quota也拿了过来。 Bug就与软删除相关。具体场景是这样的:假设OpenStack中有两个项目和两个用户:普通项目A其用户a,管理员项目Admin其用户为 admin(用户管理相关概念可以查阅keystone文档),用户a不慎将自己的一台虚拟机删除了,这时求助系统管理员看看有没有办法恢复,好在系统开启的软删除功能,而且被删除的虚拟机还在可回收的时间范围内,这时管理员便以admin的身份登录系统,为用户a恢复了虚拟机,但是细心的管理员却发现了一些不对:其Admin项目下并没有任何虚拟机,但是其配额却被使用了,难道这和刚才的操作有关?再来重试一下:普通用户删除虚拟机,admin用户来为其恢复,这时配额又发生了变化,果然如此:被恢复的虚拟机的配额错误的添加到了Admin项目下。该Bug在最新的kilo版本中仍然存在,感兴趣的同学可以实验一下。 二.定位Bug: 发现了Bug的存在,那就更进一步,到代码中找一下原因吧。 如何确定问题代码的位置呢?这需要对Nova的项目结构有大体的了解,我们来简单了解一下:上图是nova架构的极简版本,与本问题无关的组件都没有画上去,恢复虚拟机的操作过程大致是这样: nova api接收到用户请求,到数据库中查询虚拟机详情,将该虚拟机所在的主机、名称等数据发送到消息队列中; nova compute服务在监听到相关消息后,开始执行具体操作,将虚拟机在数据库中的记录做些调整,调用底层驱动恢复虚拟机。 既然软删除的功能层面没有任何问题,虚拟机的删除和恢复过程都很顺利,可见不会是驱动的问题,顺着API层的代码调用往下找,很快就可以定位了。直接看出问题的代码片段: defrestore(self,context,instance): #该代码做了删减 flavor=instance.get_flavor() #获取quotas对象 num_instances,quotas=self._check_num_instances_quota( context,flavor,1,1) self._record_action_start(context,instance,instance_actions.RESTORE) try: ifinstance.host: instance.task_state=task_states.RESTORING instance.deleted_at=None instance.save(expected_task_state=[None]) self.compute_rpcapi.restore_instance(context,instance) else: instance.vm_state=vm_states.ACTIVE instance.task_state=None instance.deleted_at=None instance.save(expected_task_state=[None]) #更新quotas quotas.commit() 上面的这段代码就是API层面上进行虚拟机回收的主要方法,可以看到其中有明显的配额操作(quotas),在解读这段代码前有必要先对nova 中"context"的概念做个简介。不仅是nova,在openstack其他项目中都随处可见这个"context",它是一个包装了用户请求信息的对象,包含用户的项目和认证信息等,通过它可以简便的进行各项目之间的API调用和用户信息的查询,API服务接收到用户的每一次HTTP请求,都会创建一个新的context。 回到这段代码,我们重点关注对quotas所作的操作:在方法的第二行,通过了一个方法获取了quotas,有在方法的结尾执行了 quotas.commit(),能够获取到的信息不多,我们再看一下获取quotas的方法:_check_num_instances_quota #这里只截取一部分 def_check_num_instances_quota(self,context,instance_type,min_count, max_count): req_cores=max_count*instance_type['vcpus'] vram_mb=int(instance_type.get('extra_specs',{}).get(VIDEO_RAM,0)) req_ram=max_count*(instance_type['memory_mb']+vram_mb) try: quotas=objects.Quotas(context) quotas.reserve(context,instances=max_count, cores=req_cores,ram=req_ram) ... returnmax_count,quotas 这里可以看到获取quotas的过程:通过当前的context创建quotas对象,并且执行了reserve操作; 我们知道context是由HTTP请求而来,里面保存的是发请求的用户的信息,所以这里的quotas对象的“所有者”也就是context中的用户。 结合Bug发生的场景来看:管理员还原用户a的虚拟机,发请求的是管理员,当前context中记录的是管理员的信息,这里的quotas理所当然的就是管理员的,然后操作了用户a的虚拟机,更新的却是管理员的quotas。嗯,真相大白! 三.修复Bug: Bug的原因是获取的quotas并不属于期望的用户,但是直接修改context显然不合适(会影响后续的操作),先了解一下quotas对象自身吧: classQuotas(base.NovaObject): #部分代码 def__init__(self,*args,**kwargs): super(Quotas,self).__init__(*args,**kwargs) #Setupdefaults. self.reservations=[] self.project_id=None self.user_id=None self.obj_reset_changes() ... defreserve(self,context,expire=None,project_id=None,user_id=None, **deltas): reservations=quota.QUOTAS.reserve(context,expire=expire, project_id=project_id, user_id=user_id, **deltas) self.reservations=reservations self.project_id=project_id self.user_id=user_id self.obj_reset_changes() defcommit(self,context=None): ifnotself.reservations: return ifcontextisNone: context=self._context quota.QUOTAS.commit(context,self.reservations, project_id=self.project_id, user_id=self.user_id) self.reservations=None self.obj_reset_changes() 注意看reserve方法的参数,默认为None的project_id和user_id,这正是改变quotas属主的方便入口! 修改后的代码这里就不贴了,感兴趣的同学可以到这次提交中看:Code Review 四.代码提交和Review: openstack社区有着整套项目管理流程,这里有一张图能够较详细的描述工作流程: 由图可见bugfix是其中最简单的流程。 关于如何提交代码,这篇文章有详细的介绍: 向 OpenStack 贡献您的代码。另外需要注意一点,在国内向社区提交代码,经常会因为网络问题导致无法提交,幸好找到了大牛的博客介绍了该类问题的解决办法。 修改完代码的单元测试和pep8本地测试当然不能少,早就知道社区对单元测试要求很严格,这次才真正领教了,三行代码的修改,单元测试却写了30 行,review期间多次因为单元测试的问题重提代码(哭)。社区里面的开发者,尤其是项目的core,对待项目有着像对自己孩子般的认真与细致:他们会在一个自己根本不会在意的地方提醒你、面对当前的问题他们会延伸的考虑类似的问题。他们的态度让我首先感受到的吃惊,然后是敬佩! 经历八次review、历时近一个月,我的代码总算是入库了!希望我的这篇记录能对你有帮助。 感谢休伦公司技术总监 孙琦 提供的英文支持,社区大牛Alex Xu给出的修改建议。 Launchpad上面的bug提交:Abnormal changes of quota usage after instance restored by admin 代码审查过程:Fix abnormal quota usage after restore by admin Git@OSC中的代码:Fix abnormal quota usage after restore by admin 博文出处:http://my.oschina.net/zyzzy/blog/509315 关于OpenStack OpenStack是一个由NASA(美国国家航空航天局)和Rackspace合作研发并发起的,是一个开源的云计算管理平台项目,由几个主要的组件组合起来完成具体工作。OpenStack支持几乎所有类型的云环境,项目目标是提供实施简单、可大规模扩展、丰富、标准统一的云计算管理平台。 OpenStack除了有Rackspace和NASA的大力支持外,还有包括戴尔、Citrix、Cisco、Canonical等重量级公司的贡献和支持,致力于简化云的部署过程并为其带来良好的可扩展性。 本文作者:YueZheng 来源:51CTO

优秀的个人博客,低调大师

DockerCon 2017: Docker新特性初体验

DockerCon2017已经结束了,从去年的版本到现在,Docker产生了很多的变化。Docker的开发者们一直强调他们希望Docker的体验越简单越好。观察下最近几个月Docker的新特性,你会发现所言非虚,DockerCon2017大会也向我们展示了这一点。下面介绍下Docker最近几个月发布的新特性 多阶段构建 构建一个镜像一般需要多个阶段。 编译你的应用 然后跑测试 当测试通过时,你将你的应用打包成可部署的软件包 最后你把软件包添加到镜像里面 你可以将这些步骤都放进一个Dockerfile中,但是这会导致镜像膨胀,加入了很多最终产品不需要的内容。例如编译和构建的框架,Docker镜像存储需要的空间也会变得很大。一个解决方法是在Docker外面编译测试打包应用程序,或者使用多个Dockerfile。你可以用一个Dockerfile来编译

优秀的个人博客,低调大师

每日一博 | RocketMQ 事务消息初体验

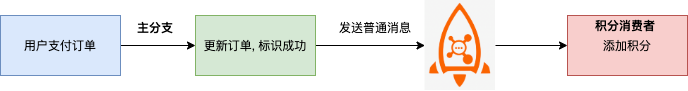
事务消息是 RocketMQ 的高级特性之一 。这篇文章,笔者会从应用场景、功能原理、实战例子三个模块慢慢为你揭开事务消息的神秘面纱。 1 应用场景 举一个电商场景的例子:用户购物车结算时,系统会创建支付订单。 用户支付成功后支付订单的状态会由未支付修改为支付成功,然后系统给用户增加积分。 通常我们会使用普通消费方案,该方案能够发挥 MQ 的优势:异步和解耦 , 同时架构设计非常简单。 用户购物车结算时,系统创建支付订单; 支付成功后,更新订单的状态从未支付修改为支付成功; 发送一条普通消息到消息队列服务端; 积分服务消费消息,添加积分记录。 但该方案有个非常直观的缺点:容易出现不一致的现象。 假如先发送消息,后修改订单状态,消息发送成功,订单没有执行成功,需要回滚整个事务(订单数据事务回滚,积分服务消费时,需要先反查事务状态,若事务提交,才插入积分记录)。 假如先修改订单状态,后发送消息,订单状态修改成功,但消息发送失败,需要补偿操作才能保持最终一致。 假如先修改订单,后发送消息,订单状态修改成功,但消息发送超时,此时无法判断需要回滚订单还是提交订单变更。 我们看到,为了完善普通消费方案,业务层还需要做到两点:补偿机制和提供事务状态查询接口。 要做到这两点,难不难呢? 不难,但是业务层代码会比较混乱,更优的方案还是得从中间件层面解决。 2 功能原理 RocketMQ 事务消息是支持在分布式场景下保障消息生产和本地事务的最终一致性。交互流程如下图所示: 1、生产者将消息发送至 Broker 。 2、Broker 将消息持久化成功之后,向生产者返回 Ack 确认消息已经发送成功,此时消息被标记为"暂不能投递",这种状态下的消息即为半事务消息。 3、生产者开始执行本地事务逻辑。 4、生产者根据本地事务执行结果向服务端提交二次确认结果( Commit 或是 Rollback ),Broker 收到确认结果后处理逻辑如下: 二次确认结果为 Commit :Broker 将半事务消息标记为可投递,并投递给消费者。 二次确认结果为 Rollback :Broker 将回滚事务,不会将半事务消息投递给消费者。 5、在断网或者是生产者应用重启的特殊情况下,若 Broker 未收到发送者提交的二次确认结果,或 Broker 收到的二次确认结果为 Unknown 未知状态,经过固定时间后,服务端将对消息生产者即生产者集群中任一生产者实例发起消息回查。 生产者收到消息回查后,需要检查对应消息的本地事务执行的最终结果。 生产者根据检查到的本地事务的最终状态再次提交二次确认,服务端仍按照步骤4对半事务消息进行处理。 笔者认为事务消息的精髓在于: 本地事务执行成功,消费者才能消费事务消息; 消息回查本身就是补偿机制的实现,事务生产者需提供了事务状态查询接口。 3 实战例子 为了便于大家理解事务消息 ,笔者新建一个工程用于模拟支付订单创建、支付成功、赠送积分的流程。 首先,我们创建一个真实的订单主题:order-topic 。 然后在数据库中创建三张表 订单表、事务日志表、积分表。 最后我们创建一个 Demo 工程,生产者模块用于创建支付订单、修改支付订单成功,消费者模块用于新增积分记录。 接下来,我们展示事务消息的实现流程。 <strong style="font-size: 15px;line-height: inherit;color: black;">1、创建支付订单</strong> 调用订单生产者服务创建订单接口 ,在 t_order 表中插入一条支付订单记录。 <strong style="font-size: 15px;line-height: inherit;color: black;">2、调用生产者服务修改订单状态接口</strong> 接口的逻辑就是执行事务生产者的 sendMessageInTransaction 方法。 生产者端需要配置事务生产者和事务监听器。 发送事务消息的方法内部包含三个步骤 : 事务生产者首先发送半事务消息,发送成功后,生产者才开始执行本地事务逻辑。 事务监听器实现了两个功能:执行本地事务和供 Broker 回查事务状态 。 执行本地事务的逻辑内部就是执行 orderService.updateOrder 方法。 方法执行成功则返回 LocalTransactionState.COMMIT_MESSAGE , 若执行失败则返回 LocalTransactionState.ROLLBACK_MESSAGE 。 需要注意的是: orderService.updateOrder 方法添加了事务注解,并将修改订单状态和插入事务日志表放进一个事务内,避免订单状态和事务日志表的数据不一致。 最后,生产者根据本地事务执行结果向 Broker 提交二次确认结果。 Broker 收到生产者确认结果后处理逻辑如下: 二次确认结果为 Commit :Broker 将半事务消息标记为可投递,并投递给消费者。 二次确认结果为 Rollback :Broker 将回滚事务,不会将半事务消息投递给消费者。 <strong style="font-size: 15px;line-height: inherit;color: black;">3、积分消费者消费消息,添加积分记录</strong > 当 Broker 将半事务消息标记为可投递时,积分消费者就可以开始消费主题 order-topic 的消息了。 积分消费者服务,我们定义了消费者组名,以及订阅主题和消费监听器。 在消费监听器逻辑里,幂等非常重要 。当收到订单信息后,首先判断该订单是否有积分记录,若没有记录,才插入积分记录。 而且我们在创建积分表时,订单编号也是唯一键,数据库中也必然不会存在相同订单的多条积分记录。 4 总结 RocketMQ 事务消息是支持在分布式场景下保障消息生产和本地事务的最终一致性。 编写一个实战例子并不复杂,但使用事务消息时需要注意如下三点: 1、事务生产者和消费者共同协作才能保证业务数据的最终一致性; 2、事务生产者需要实现事务监听器,并且保存事务的执行结果(比如事务日志表) ; 3、消费者要保证幂等。消费失败时,通过重试、告警+人工介入等手段保证消费结果正确。 本文涉及到的工程源码,笔者已上传到 Github ,感兴趣的同学可以了解一下,若有疑问直接加笔者好友,一起交流技术,一起成长。 笔者会在后续的文章里,详细解析事务消息的实现原理,敬请期待。 实战代码地址: https://github.com/makemyownlife/rocketmq4-learning 如果我的文章对你有所帮助,还请帮忙点赞、在看、转发一下,你的支持会激励我输出更高质量的文章,非常感谢!

优秀的个人博客,低调大师

开源认证授权管理平台Keycloak初体验

上一篇文章简单介绍了Keycloak,反响不错。看来大家都对这个东西感兴趣,今天就来进一步的体验Keycloak,让我们对它有一个直观的认识,然后逐步深入,把它的设计理念和概念各个击破。 总体思路 因为事先已经知道Keycloak提供了Spring Security的适配器。先独立把Keycloak的核心概念弄清楚,然后再去研究它如何结合Spring Security的。 安装Keycloak 本文的Keycloak版本为 14.0.0。 我向来不喜欢在安装上浪费时间,研究阶段能用Docker来安装是最省心的: docker run -d -p 8011:8080 --name keycloak-server -e KEYCLOAK_USER=admin -e KEYCLOAK_PASSWORD=admin jboss/keycloak 执行上述命令安装Keycloak,成功后打开http://localhost:8011/auth/admin输入账号admin和密码admin,就进入了管理控制台。如果你感觉英文不爽可以根据下图改成中文: 改完之后你随便点点栏目了解一下,想象一下它们各自的功能和作用,这时候你要放轻松点不用想的太深就是了解一下全貌。 Realm 如果你接触过知名安全框架Shiro相信对这个概念不会陌生。realm是管理用户和对应应用的空间,有点租户的味道,可以让不同realm之间保持逻辑隔离的能力。 默认情况下,Keycloack提供了一个叫Master的realm,这个Master不承担具体应用和用户的管理,它只用来管理其它realm的生命周期。 登入Master的realm创建一个自定义域felord.cn。 User User是能够登录到应用系统的实体,其实可以理解为账户。他们可以拥有与自己相关的属性,例如电子邮件、用户名、地址、电话号码和生日。可以为他们分配组成员身份并为其分配特定的角色。Keycloak中的User都有他们从属的realm。接下来在我上面的自定义域felord.cn中新建一个用户,步骤为: 菜单栏找到管理->用户,然后打开添加用户。 键入唯一的必填项用户名(username)。 开启(ON)邮件认证(Email Verified),然后保存。 点击凭据(Credentials)选项卡为新用户设置临时密码。此密码是临时的,用户将需要在第一次登录时更改它。如果您更喜欢创建永久密码,请将临时开关切换到关闭并单击设置密码。 然后注销当前用户admin并到http://localhost:8011/auth/realms/felord.cn/account以刚创建的用户felord的身份登录到felord.cn域。 有没有发现登录链接的特点? 到这里一个创建realm和账户的流程就熟悉完了,不过我相信大多数同学看到这里还是懵逼的。怎么就手动了呢?不要急后面会结合代码来实现上述的流程以及更加符合应用场景的流程。 Keycloak的核心概念 接下来是我们在使用Keycloak时需要掌握的一些概念,上面已经提到了realm和user,这里就不再赘述了 authentication 识别和验证用户的过程。证明“你说的这个你就是你”。 authorization 授予用户访问权限的过程。标明“你可以干什么、不可以干什么”。 credentials 证明用户身份的凭证。可能是密码、一次性密码、数字证书以及指纹。 roles 角色是RBAC的重要概念,用于表明用户的身份类型。 user role mapping 用户角色映射关系。通常一个用户可能有多个角色,一个角色也可以对应不同的人。 composite roles 复合角色,听起来很玄乎,其实就是角色的从属关系或者说继承关系。 B角色从属于A角色,那么你拥有了A角色就一定拥有B角色的权限。 groups 用户组,你可以将一系列的角色赋予定义好的用户组,一旦某用户属于该用户组,那么该用户将获得对应组的所有角色权限。 clients 客户端。通常指一些需要向keycloak请求以认证一个用户的应用或者服务,甚至可以说寻求keycloak保护并在keycloak上注册的请求实体都是客户端。 client adapters keycloak为了支持多语言和跨平台而设计的适配器,比如适配Java的、适配Python的。有些是内置的实现,有些需要我们按照keycloak的抽象定义来实现。后续我们主要和Spring Boot Adapter打交道。 identity provider 用来认证用户的服务,简称IDP。keycloak本身就是一个IDP。这个类似Spring Security中的AuthenticationProvider接口。 还有一些概念等遇到了会再补充,有点多,先消化消化。 总结 今天这一篇主要对keycloak进行一个初步的体验,搭建了一个开发环境供后续的学习,同时对keycloak的一些核心概念进行了汇总。不过由于篇幅限制没有完全的去梳理一些概念,不过学习都是循序渐进的,急不得。自定义realm和用户都建好了,下一篇我将尝试用keycloak来保护Spring Boot应用。业余时间,码字不易,还请多多关注,大力支持一下作者。 关注公众号:Felordcn获取更多资讯 个人博客:https://felord.cn

优秀的个人博客,低调大师

containerd 与安全沙箱的 Kubernetes 初体验

作者 | 易立 阿里云资深技术专家 containerd 是一个开源的行业标准容器运行时,关注于简单、稳定和可移植,同时支持 Linux 和 Windows。 2016 年 12 月 14 日,Docker 公司宣布将 Docker Engine 的核心组件 containerd 捐赠到一个新的开源社区独立发展和运营。阿里云、AWS、 Google、IBM 和 Microsoft 作为初始成员,共同建设 containerd 社区; 2017 年 3 月,Docker 将 containerd 捐献给 CNCF(云原生计算基金会)。containerd 得到了快速的发展和广泛的支持; Docker 引擎已经将 containerd 作为容器生命周期管理的基础,Kubernetes 也在 2018 年 5 月,正式支持 container

优秀的个人博客,低调大师

Groovy初体验:构建高性能JVM应用

为什么要学Groovy Groovy运行于JVM之上,然而其对动态语言、函数式编程范式以及元编程功能的加持所带来的表现力和简洁性可以说甩了Java几条街。我们可以利用Groovy的所有动态功能构建高性能的JVM应用、将开发效率提高几个数量级! 这就是我们为什么要学它! Groovy环境部署 本文实验所用OS为CentOS7,这里介绍使用sdk工具来安装Groovy的方法。 首先在命令行下执行: curl -s get.sdkman.io | bash 接下来执行: source "$HOME/.sdkman/bin/sdkman-init.sh" 然后我们就可以使用sdk工具来安装Groovy: 一句话搞定! sdk install groovy 完成之后我们来检查Groovy安装状态 groovy -v 一切就绪 Hello World From Groovy [root@localhost ~]# vim Hello.groovy [root@localhost ~]# more Hello.groovy println "Hello World From Groovy !" [root@localhost ~]# groovy Hello Hello World From Groovy ! Groovy语言特性 Groovy是轻量级的Java Groovy的信噪比比Java高:较少的代码获得更多结果 GDK = Groovy JDK:通过向JDK的各种类中添加便捷方法,Groovy扩展了JDK形成了GDK库 return语句可选,分号结尾可选 方法和类默认public 导航操作符可帮助实现对象引用不为空时方法才会被调用 Groovy不强迫捕获自己不关心的异常,没捕获的异常自动传到高层 静态方法内可使用this来引用Class对象,因此可以链式调用! 两大优点:表现力 + 简洁!!! 从Java到Groovy 用Java写一段代码如下: public class Greetingss { public static void main( String[] args ) { for( int i=0; i<3; i++ ) { System.out.println("ho "); } System.out.println("Merry Groovy"); } } 用Groovy重构一遍如下: for(i in 0..2) { print 'ho ' } print 'Merry Groovy' 看看两种语言的信噪比对比,真是给人不可估量的感动! 安全导航操作符 ?. 可以避免代码中的大量null引用的判断 def foo( str ) { str?.reverse() // 仅当str不为null时reverse才会执行 } 这可以帮我们省多少个if啊!!! 异常处理 与Java相比,Groovy的异常处理少了很多繁文缛节 对于那些不想处理或者不适合在代码当前层次处理的异常,Groovy对用户不做任何要求,任何用户未处理的异常会自动传递到高一层,我们啥也不用写: def openfile( fileName ) { // 无需throws new FileInputStream( fileName ) // 无需try...catch... 处理 } 异常可以放到其调用代码中处理: try { openFile("nonexistfile") } catch( FileNotFoundException ex ) { print "Oops: " + ex } 若捕获所有异常(Exception),则上面catch中异常的类型都可省略: try { openFile("nonexistfile") } catch( ex ) { // 省略类型表示可捕获所有异常 print "Oops: " + ex } 链式调用 静态方法内可使用this来引用Class对象,因此可以链式调用 class Wizard { def static learn( trick, action ) { //... this } } Wizard.learn('xxxx', {...}) .learn('yyyy', {...}) .learn('zzzz', {...}) 后记 作者更多的原创文章在此: https://www.jianshu.com/u/d19536b0189b

优秀的个人博客,低调大师

Exchange2013 RTM安装初体验(一)

前期微软发布了一系列的新产品,Office2013、Exchange2013、Lync2013,其中我最感兴趣的还是Exchange2013和Lync2013。当前我们同样得知前期是Preview version,可现在已经是RTM version了,无奈前段时间工作繁忙,没有抽出时间做,这两天终于腾出些时间,赶紧进行了安装测试;简单说下Exchange2013的改进,硬件方面变化很大,在测试中发现为虚拟机分配的动态内存4096-8192MB之间看,在初安装的时候占用内存不高,可在安装好后直接占用内存资源到7454MB了,结果告诉我们对内存的要求也越来越高了。活动目录DC和GC最低要求windows 2008 standard。最值得关注的是Exchange 2013 在角色上发生了重大改变,只有Client Access和Mailbox两种角色,邮箱服务器包含了典型的服务器组件和客户端访问服务器角色,用来处理所有的身份验证和代理等服务,同时只支持windows 2008 R2及windows server 2012系统。Exchange 2013 已不支持outlook 2003客户端。Exchange管理中心将取代于以前的EMC,Exchange 2013 的所有管理工作全部都迁移到了Web界面的管理中心当中;微软本来是将Exchange 2007之后的版本已经慢慢的开始启用了公用文件夹,但是现在在 Exchange 2013 中微软又启用了它。可以使用EAC来管理他们,并且现代公用文件夹将作为灾难恢复和数据库可用性组的一部分 初步了解后,我们开始安装Exchange 2013 RTM。基本信息如下: http://technet.microsoft.com/nl-NL/library/aa996719.aspx 安装步骤: 1. 环境架构---AD环境准备 2.安装DHCP服务,配置(授权及新建作用域) 3.部署命名为Ex2013-01的成员服务器, 4.下载Exchange2013必备应用程序(3个),具体见下 http://www.microsoft.com/en-us/download/details.aspx?id=34992 http://www.microsoft.com/en-us/download/details.aspx?id=17062 http://www.microsoft.com/en-us/download/details.aspx?id=26604 5.安装Exchange2013必备应用程序及安装 6.Exchange2013安全前准备,安装所需角色及功能 7.安装Exchange2013应用程序 环境介绍: Domain Name:abc.com Hostname:ABC-DC IP:192.168.100.3 Roles:DC、DHCP、DNS Hostname:MDT2012 IP:192.168.100.100 Roles:MDT Server2012 Hostname:EX2013-01 IP:192.168.100.10 Roles:Exchange Server 2013 Hostname:EX2013-02 IP:192.168.100.11 Roles:Exchange Server 2013 Hostname:TMG01 IP:192.168.100.1 Roles:Gateway Hostname:Test IP:192.168.100.x Roles:Test computer 一、环境架构---AD准备 首先是安装一台独立服务器,并且命名为:ABC-DC;同时安装ADDS服务及所需功能 开始安装ADDS服务 安装完后通过GUI来将安装了ADDS的独立服务器提升为域控制器 添加新林,域名为:ABC.COM 域及林的功能级别为:Windows server 2012;输入目录还原密码 森林中第一台DC担任DNS、GC角色 配置好信息后开始安装。 已成功将该服务器提升为DC,提升后重启即可 通过运行DSA.MSC打开用户和计算机管理控制台 为了方便管理,新建用户gaowenlong并且赋予最大的域权限 二、安装DHCP服务及配置(授权及新建作用域) 安装后,开始完成DHCP配置—授权 通过运行dhcpmgmt.msc打开DHCP控制台,新建作用域 定义地址分发范围;192.168.100.150----192.168.100.200 定义网关:192.168.100.1 DHCP服务配置完成 三、安装及部署Exchange Server2013(Ex2013-01)独立服务器;并且将该独立服务器命名为:Ex2013-01同时加入到abc.com域内 四、下载及安装Exchange2013前所需应用程序 http://www.microsoft.com/en-us/download/details.aspx?id=34992 http://www.microsoft.com/en-us/download/details.aspx?id=17062 http://www.microsoft.com/en-us/download/details.aspx?id=26604 五、将Exchange2013必备应用软件拷贝到Ex2013-01的桌面上准备安装; 安装应用所需程序; 安装以上应用程序后,需要卸载Unified安装后所附带应用程序:microsoft visual c+++++ 然后,因为运行windows server2012系统,然后安装Exchange2013所以需要安装一下角色 7.安装Exchange2013前准备;安装Exchange2013必需的角色及功能;通过powershell安装 Install-windowsfeature RSAT-ADDS 安装所需角色及功能;以管理员身份运行Powershell Install-WindowsFeature AS-HTTP-Activation, Desktop-Experience, NET-Framework-45-Features, RPC-over-HTTP-proxy, RSAT-Clustering, Web-Mgmt-Console, WAS-Process-Model, Web-Asp-Net45, Web-Basic-Auth, Web-Client-Auth, Web-Digest-Auth, Web-Dir-Browsing, Web-Dyn-Compression, Web-Http-Errors, Web-Http-Logging, Web-Http-Redirect, Web-Http-Tracing, Web-ISAPI-Ext, Web-ISAPI-Filter, Web-Lgcy-Mgmt-Console, Web-Metabase, Web-Mgmt-Console, Web-Mgmt-Service, Web-Net-Ext45, Web-Request-Monitor, Web-Server, Web-Stat-Compression, Web-Static-Content, Web-Windows-Auth, Web-WMI, Windows-Identity-Foundation–Restart 角色安装成功并且重启 7.安装exchange2013程序;不更新,直接下一步 开始拷贝所需文件 初始化设置 同意安装 开始正式安装Exchange 2013,选择所要安装的Exchange 2013的角色,本例安装所有角色(正如前面提到Exchange2013只有CAS和Mailbox两种角色),点击“next” Exchange organization Name:再次默认即可 警告再次可忽略,因为提示安装Exchange2013会对AD的架构进行扩展,忽略即可 开始安装,在此过程需要30分钟左右,具体时间可根据机器的性能来计算 在30分钟的等待中,我们看到了成功安装完成。 运行开始我们可以看见有两个Exchange控制台;一个为EMS一个是Exchange toolbox Exchange2013配置下节再做详细介绍 本文转自 高文龙 51CTO博客,原文链接:http://blog.51cto.com/gaowenlong/1059553,如需转载请自行联系原作者

优秀的个人博客,低调大师

Microsoft Band初体验:功能没有很大创新

微软在10月30号发布了全新的硬件产品Microsoft Band智能手环,这款产品在发布第二天就能在微软线上和线上的直营店购买,售价199美元。微软出品的智能手环到底如何呢?来看看国外媒体的上手体验。 之前并没有提到的是,微软这款手环拥有大小尺寸可选,不过目前有存货的都是小尺寸的。Gigaom的作者Kevin C. Tofel一早买了一台,并很快写了一篇初上手体验。 外观 Microsoft Band让人联想起Fitibit Force,但是感觉更加扎实,重量为60克。矩形屏幕则与三星Gear Fit有些类似。搭扣可以很容易调整松紧。 心率传感器在腕带搭扣的一端,不管屏幕在手腕内侧还是外侧它都能使用。整只手环只有两个按键。类Windows Phone的界面设计使用起来很直观。 手环佩戴起来最好屏幕放在手腕内侧,这样信息读取更容易,也

优秀的个人博客,低调大师

小白用户MaxCompute数据同步初体验

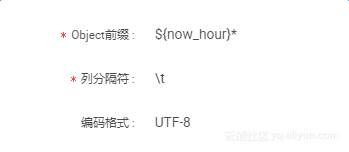
作为一个运营人员,工作中经常性地需要对大量业务数据进行分析,使用阿里云的MaxCompute可以非常方便的进行海量数据的处理。基于工作的特殊性,日常处理的都是CSV/TXT等碎片化的文件(比如用OSS存储的生产数据),如何将大文本文件写入到MaxCompute(原ODPS)是一件很头疼的事情。好在,阿里云大数据开发套件提供了非常强大的数据同步的工具。 近期体验了一下阿里云的数据同步工具,发现非常简单易用,同时又十分强大。作为非技术同学,借助文档,基本实现了从OSS到ODPS以及从OSS到本地自建FTP的数据同步,期间也碰到了许多问题。本文主要介绍自己作为一个小白用户,在使用过程中遇到的问题以及解决办法。 要解决的问题:OSS对象存储文件定时同步到ODPS 应用到的阿里云产品:OSS 数据同步组件 MaxCompute 1. 阿里云的数据同步为向导模式和脚本模式两种方式。向导模式是可视化操作,非常方便,不过有些类型的数据同步不支持。脚本模式通过Json脚本实现,功能更强大。OSS数据同步到ODPS,两种方式是均支持的。分为数据源读取、数据传输、写入目标数据三部分。具体操作,先添加数据源后,按照向导可一步步操作,不在赘述。 2. 数据同步的调度任务,无法自动识别OSS是否有文件增加,因此,如果OSS中的Object是不断增加的,调度任务需要设定为分钟或者小时级别的周期调度。 3. OSS的读取支持形如example*的通配符匹配: 同时,OSS的文件名可以用日期时间命名,这样调度任务可以通过时间参数来读取最新写入的Object。 4.调度任务执行的时候,数据源Object必须已经存在,可以调整时间参数的先后关系,例如: 该例子是延时一小时的。 5. 阿里云的文档非常详尽,基本可能遇到的问题通过查找文档都可以解决。数据同步文档

优秀的个人博客,低调大师

视频直播Android推流SDK初体验

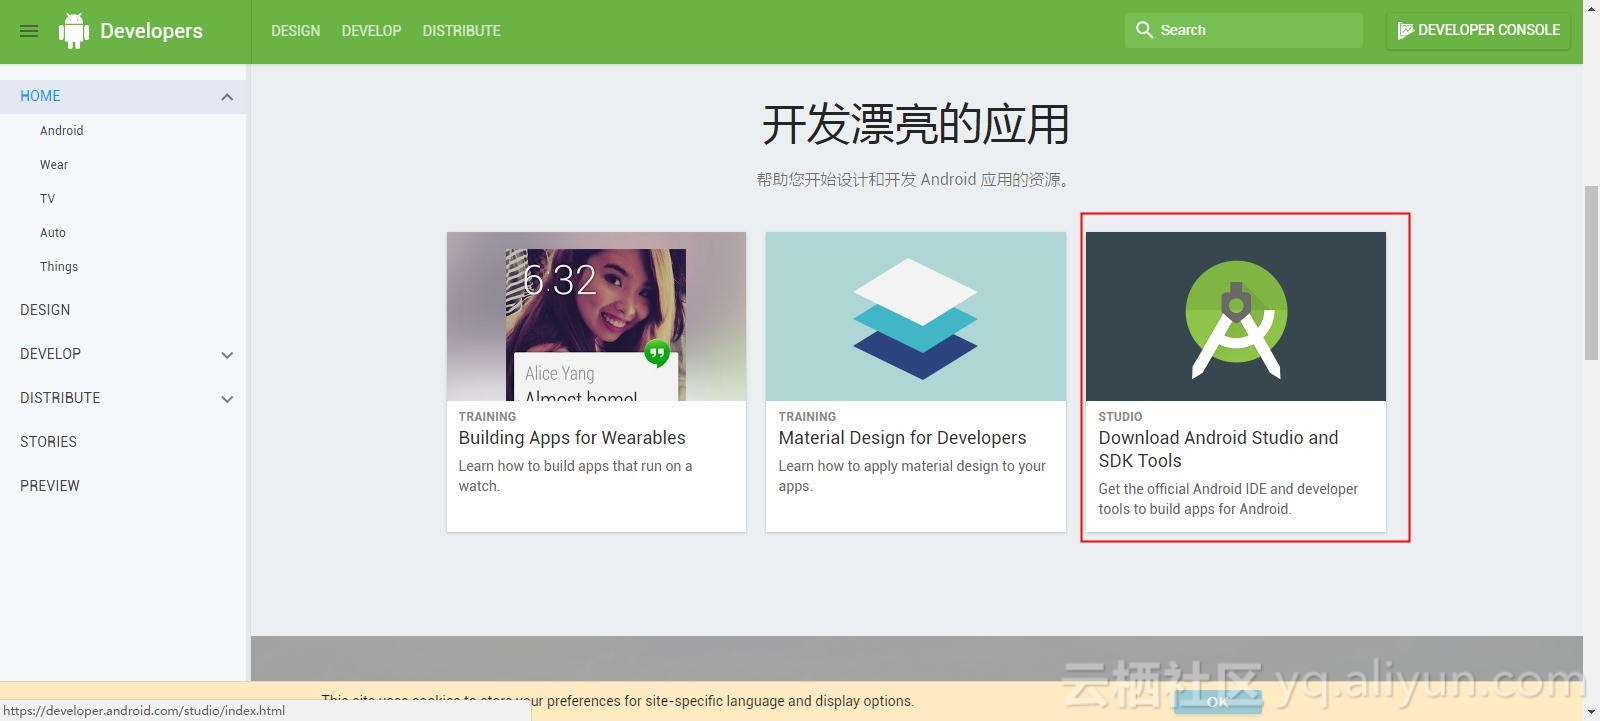
场景:使用阿里云直播产品如何进行推流播流,可以参考视频直播快速开始进行创建直播域名推流播流。那么移动端要如何进行推流呢,视频直播提供了Android、IOS推流SDK,用户可以使用对应的SDK进行推流,本文旨在让读者可以按照文章快速的应用Android推流SDK进行推流并且了解常见推流参数的设置。 1)Android Studio安装,下载Android Studio打开https://developer.android.com/index.html 2) 安装Android Studio 3) 下载Android推流sdk 工程:https://help.aliyun.com/document_detail/45270.html?spm=5176.doc50101.6.609.3CsXTp 4) Android Stu

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册