首页 文章 精选 留言 我的

精选列表

搜索[初体验],共248篇文章
优秀的个人博客,低调大师

RocketMQ 事务消息初体验

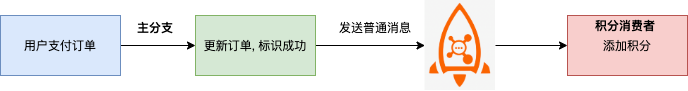
事务消息是 RocketMQ 的高级特性之一 。这篇文章,笔者会从应用场景、功能原理、实战例子三个模块慢慢为你揭开事务消息的神秘面纱。 1 应用场景 举一个电商场景的例子:用户购物车结算时,系统会创建支付订单。 用户支付成功后支付订单的状态会由未支付修改为支付成功,然后系统给用户增加积分。 通常我们会使用普通消费方案,该方案能够发挥 MQ 的优势:异步和解耦 , 同时架构设计非常简单。 用户购物车结算时,系统创建支付订单; 支付成功后,更新订单的状态从未支付修改为支付成功; 发送一条普通消息到消息队列服务端; 积分服务消费消息,添加积分记录。 但该方案有个非常直观的缺点:容易出现不一致的现象。 假如先发送消息,后修改订单状态,消息发送成功,订单没有执行成功,需要回滚整个事务(订单数据事务回滚,积分服务消费时,需要先反查事务状态,若事务提交,才插入积分记录)。 假如先修改订单状态,后发送消息,订单状态修改成功,但消息发送失败,需要补偿操作才能保持最终一致。 假如先修改订单,后发送消息,订单状态修改成功,但消息发送超时,此时无法判断需要回滚订单还是提交订单变更。 我们看到,为了完善普通消费方案,业务层还需要做到两点:补偿机制和提供事务状态查询接口。 要做到这两点,难不难呢? 不难,但是业务层代码会比较混乱,更优的方案还是得从中间件层面解决。 2 功能原理 RocketMQ 事务消息是支持在分布式场景下保障消息生产和本地事务的最终一致性。交互流程如下图所示: 1、生产者将消息发送至 Broker 。 2、Broker 将消息持久化成功之后,向生产者返回 Ack 确认消息已经发送成功,此时消息被标记为"暂不能投递",这种状态下的消息即为半事务消息。 3、生产者开始执行本地事务逻辑。 4、生产者根据本地事务执行结果向服务端提交二次确认结果( Commit 或是 Rollback ),Broker 收到确认结果后处理逻辑如下: 二次确认结果为 Commit :Broker 将半事务消息标记为可投递,并投递给消费者。 二次确认结果为 Rollback :Broker 将回滚事务,不会将半事务消息投递给消费者。 5、在断网或者是生产者应用重启的特殊情况下,若 Broker 未收到发送者提交的二次确认结果,或 Broker 收到的二次确认结果为 Unknown 未知状态,经过固定时间后,服务端将对消息生产者即生产者集群中任一生产者实例发起消息回查。 生产者收到消息回查后,需要检查对应消息的本地事务执行的最终结果。 生产者根据检查到的本地事务的最终状态再次提交二次确认,服务端仍按照步骤4对半事务消息进行处理。 笔者认为事务消息的精髓在于: 本地事务执行成功,消费者才能消费事务消息; 消息回查本身就是补偿机制的实现,事务生产者需提供了事务状态查询接口。 3 实战例子 为了便于大家理解事务消息 ,笔者新建一个工程用于模拟支付订单创建、支付成功、赠送积分的流程。 首先,我们创建一个真实的订单主题:order-topic 。 然后在数据库中创建三张表 订单表、事务日志表、积分表。 最后我们创建一个 Demo 工程,生产者模块用于创建支付订单、修改支付订单成功,消费者模块用于新增积分记录。 接下来,我们展示事务消息的实现流程。 <strong style="font-size: 15px;line-height: inherit;color: black;">1、创建支付订单</strong> 调用订单生产者服务创建订单接口 ,在 t_order 表中插入一条支付订单记录。 <strong style="font-size: 15px;line-height: inherit;color: black;">2、调用生产者服务修改订单状态接口</strong> 接口的逻辑就是执行事务生产者的 sendMessageInTransaction 方法。 生产者端需要配置事务生产者和事务监听器。 发送事务消息的方法内部包含三个步骤 : 事务生产者首先发送半事务消息,发送成功后,生产者才开始执行本地事务逻辑。 事务监听器实现了两个功能:执行本地事务和供 Broker 回查事务状态 。 执行本地事务的逻辑内部就是执行 orderService.updateOrder 方法。 方法执行成功则返回 LocalTransactionState.COMMIT_MESSAGE , 若执行失败则返回 LocalTransactionState.ROLLBACK_MESSAGE 。 需要注意的是: orderService.updateOrder 方法添加了事务注解,并将修改订单状态和插入事务日志表放进一个事务内,避免订单状态和事务日志表的数据不一致。 最后,生产者根据本地事务执行结果向 Broker 提交二次确认结果。 Broker 收到生产者确认结果后处理逻辑如下: 二次确认结果为 Commit :Broker 将半事务消息标记为可投递,并投递给消费者。 二次确认结果为 Rollback :Broker 将回滚事务,不会将半事务消息投递给消费者。 <strong style="font-size: 15px;line-height: inherit;color: black;">3、积分消费者消费消息,添加积分记录</strong > 当 Broker 将半事务消息标记为可投递时,积分消费者就可以开始消费主题 order-topic 的消息了。 积分消费者服务,我们定义了消费者组名,以及订阅主题和消费监听器。 在消费监听器逻辑里,幂等非常重要 。当收到订单信息后,首先判断该订单是否有积分记录,若没有记录,才插入积分记录。 而且我们在创建积分表时,订单编号也是唯一键,数据库中也必然不会存在相同订单的多条积分记录。 4 总结 RocketMQ 事务消息是支持在分布式场景下保障消息生产和本地事务的最终一致性。 编写一个实战例子并不复杂,但使用事务消息时需要注意如下三点: 1、事务生产者和消费者共同协作才能保证业务数据的最终一致性; 2、事务生产者需要实现事务监听器,并且保存事务的执行结果(比如事务日志表) ; 3、消费者要保证幂等。消费失败时,通过重试、告警+人工介入等手段保证消费结果正确。 本文涉及到的工程源码,笔者已上传到 Github ,感兴趣的同学可以了解一下,若有疑问直接加笔者好友,一起交流技术,一起成长。 笔者会在后续的文章里,详细解析事务消息的实现原理,敬请期待。 实战代码地址: https://github.com/makemyownlife/rocketmq4-learning 如果我的文章对你有所帮助,还请帮忙点赞、在看、转发一下,你的支持会激励我输出更高质量的文章,非常感谢!

优秀的个人博客,低调大师

docker微服务初体验

1. 什么是微服务 在介绍微服务时,首先得先理解什么是微服务, 顾名思义,微服务得从两个方面去理解,什么是"微"、什么是"服务", 微 狭义来讲就是体积小、单个服务的设计。 而所谓服务,一定要区别于系统, 服务一个或者一组相对较小且独立的功能单元,是用户可以感知最小功能集。 微服务,关键其实不仅仅是微服务本身,而是系统要提供一套基础的架构,这种架构使得微服务可以独立的部署、运行、升级, 不仅如此,这个系统架构还让微服务与微服务之间在结构上“松耦合”, 而在功能上则表现为一个统一的整体。这种所谓的“统一的整体”表现出来的是统一风格的界面,统一的权限管理, 统一的安全策略,统一的上线过程,统一的日志和审计方法,统一的调度方式,统一的访问入口等等。 2. 微服务由来 微服务最早由Martin Fowler与James Lewis于2014年共同提出,微服务架构风格是一种使用一套小服务来开发单个应用的方式途径,每个服务运行在自己的进程中,并使用轻量级机制通信,通常是HTTP API,这些服务基于业务能力构建,并能够通过自动化部署机制来独立部署,这些服务使用不同的编程语言实现,以及不同数据存储技术,并保持最低限度的集中式管理。 3. 微服务的优势 IT架构一直从all in one到近两年热门的微服务架构,技术不断进步,微服务架构模式(Microservice Architect Pattern)开始被越来越多的企业所接受,那么究竟什么是微服务架构?微服务架构模式有什么优点呢? 从整个IT技术发展趋势来看,我们可以看到无论是硬件、还是软件、还是基础架构都在朝着轻量化的方向发展。云计算的发展更让资源的调控灵活性和部署速度都有所提高,微服务就是一项在云中部署应用和服务的技术。采用化整为零的概念,将复杂的IT部署,通过功能化、原子化分解,形成一种松散耦合的组件,让其更容易升级和扩展。 ThoughtWorks的首席科学家,马丁·福勒先生对微服务做出了这样的定义:“微服务架构是一种架构模式,它提倡将单一应用程序划分成一组小的服务,服务之间互相协调、互相配合,为用户提供最终价值。每个服务运行在其独立的进程中,服务与服务间采用轻量级的通信机制互相沟通(通常是基于HTTP协议的RESTful API)。每个服务都围绕着具体业务进行构建,并且能够被独立的部署到生产环境、类生产环境等。另外,应当尽量避免统一的、集中式的服务管理机制,对具体的一个服务而言,应根据业务上下文,选择合适的语言、工具对其进行构建。” 微服务架构是一项在云中部署应用和服务的技术 总的来说,可以将微服务架构的优势归结为以下几点: 1、复杂度可控 在all in one的状态下,容易造成盲人摸象的状态,造成不必要的数据孤岛。而微服务架构通过分解单体式应用为多个服务方法,让复杂性可控。为了实现同一功能,应用被分解为多个可管理的分支或服务,通过微服务架构模式,让复杂的功能,通过模块化的方式呈现出来,让单个服务更容易开发和维护。 避免“盲人摸象” 2、灵活可扩展 灵活性是基于微服务架构模式使得每个服务独立扩展。微服务架构下,技术选型是去中心化的。在这种模式下,每个团队都可以根据自身服务的需求和行业发展状况做出自己的判断,选择适合的技术栈。 3、独立部署 由于微服务具备独立的运行进程,所以每个微服务也可以独立部署。这样,当某个微服务发生变更时无需编译、部署整个应用,让发布更高效,右下缩短应用交付周期。UI团队可以采用AB测试,快速的部署变化。微服务架构模式使得持续化部署成为可能。 4、开发针对性更强 众所周知,在单块架构系统下,新人的培养周期很长,需要花费大量时间了解本地开发环境。而微服务架构模式使得每个服务独立扩展,开发运维人员也不需要在花费一个月的时间去熟悉本地环境,而只需要了解自己所处的模块状态即可。 5、降低TCO 在传统IT架构中,即单块架构系统中,是以技术分层,譬如逻辑层、数据层等。但随着市场需求的不断变化,用户需求住家个性化,开发周期需要越来越短,产品的生命周期也开始变短,单块架构系统开始面临挑战。无论是开发还是维护成本太高。 相较而言,微服务架构模式下,当某一组件发生故障时,不会发现单块架构系统的进程内扩散等弊端,故障会被隔离在单个服务中。 Docker微服务 Docker 是一个容器工具,提供虚拟环境。docker改变了我们对软件的认识。 站在 Docker 的角度,软件就是容器的组合:业务逻辑容器、数据库容器、储存容器、队列容器......Docker 使得软件可以拆分成若干个标准化容器,然后像搭积木一样组合起来。 这正是微服务(microservices)的思想:软件把任务外包出去,让各种外部服务完成这些任务,软件本身只是底层服务的调度中心和组装层。 微服务很适合用 Docker 容器实现,每个容器承载一个服务。一台计算机同时运行多个容器,从而就能很轻松地模拟出复杂的微服务架构。 配置文件 - Dockerfile DockerFile分为四部分组成:基础镜像信息、维护者信息、镜像操作指令和容器启动时执行指令。例如: #第一行必须指令基于的基础镜像 From ubutu #维护者信息 MAINTAINER docker_user docker_user@mail.com #镜像的操作指令 RUN apt-get update && apt-get install -y ngnix RUN echo "\ndaemon off;">>/etc/ngnix/nignix.conf #容器启动时执行指令 CMD /usr/sbin/ngnix 介绍一下一些常用的命令: 1、From指令 From 或者From : DockerFile第一条必须为From指令。如果同一个DockerFile创建多个镜像时,可使用多个From指令(每个镜像一次) 2、MAINTAINER 格式为maintainer ,指定维护者的信息 3、RUN 格式为Run 或者Run [“executable” ,”Param1”, “param2”] 前者在shell终端上运行,即/bin/sh -C,后者使用exec运行。例如:RUN [“/bin/bash”, “-c”,”echo hello”] 每条run指令在当前基础镜像执行,并且提交新镜像。当命令比较长时,可以使用“/”换行。 4、CMD指令 支持三种格式: CMD [“executable” ,”Param1”, “param2”]使用exec执行,推荐 CMD command param1 param2,在/bin/sh上执行 CMD [“Param1”, “param2”] 提供给ENTRYPOINT做默认参数。 每个容器只能执行一条CMD命令,多个CMD命令时,只最后一条被执行。 5、EXPOSE 格式为 EXPOSE […] 。 告诉Docker服务端容器暴露的端口号,供互联系统使用。在启动Docker时,可以通过-P,主机会自动分配一个端口号转发到指定的端口。使用-P,则可以具体指定哪个本地端口映射过来 例如: EXPOSE 22 80 8443 6、ENV 格式为 ENV 。 指定一个环境变量,会被后续 RUN 指令使用,并在容器运行时保持。 ENV PG_MAJOR 9.3 ENV PG_VERSION 9.3.4 RUN curl -SL http://example.com/postgres-$PG_VERSION.tar.xz | tar -xJC /usr/src/postgress && … ENV PATH /usr/local/postgres-$PG_MAJOR/bin:$PATH1234 7、ADD 格式为 ADD 。 该命令将复制指定的 到容器中的 。 其中 可以是Dockerfile所在目录的一个相对路径;也可以是一个URL;还可以是一个tar文件(自动解压为目录)。则。 8、COPY 格式为 COPY 。 复制本地主机的 (为Dockerfile所在目录的相对路径)到容器中的 。 当使用本地目录为源目录时,推荐使用 COPY 。 9、ENTRYPOINT 两种格式: ENTRYPOINT [“executable”, “param1”, “param2”] ENTRYPOINT command param1 param2 (shell中执行)。 配置容器启动后执行的命令,并且不可被 docker run 提供的参数覆盖。 每个Dockerfile中只能有一个 ENTRYPOINT ,当指定多个时,只有最后一个起效。 10、VOLUME 格式为 VOLUME [“/data”] 。 创建一个可以从本地主机或其他容器挂载的挂载点,一般用来存放数据库和需要保持的数据等。 11、USER 格式为 USER daemon 。 指定运行容器时的用户名或UID,后续的 RUN 也会使用指定用户。 当服务不需要管理员权限时,可以通过该命令指定运行用户。并且可以在之前创建所需要的用户,例如: RUN groupadd -r postgres && useradd -r -g postgres postgres 。要临时获取管理员权限可以使用 gosu ,而不推荐 sudo 。 12、WORKDIR 格式为 WORKDIR /path/to/workdir 。 为后续的 RUN 、 CMD 、 ENTRYPOINT 指令配置工作目录。 可以使用多个 WORKDIR 指令,后续命令如果参数是相对路径,则会基于之前命令指定的路径。例如 WORKDIR /a WORKDIR b WORKDIR c RUN pwd 则最终路径为 /a/b/c 。 13、ONBUILD 格式为 ONBUILD [INSTRUCTION] 。 配置当所创建的镜像作为其它新创建镜像的基础镜像时,所执行的操作指令。 例如,Dockerfile使用如下的内容创建了镜像 image-A 。 […] ONBUILD ADD . /app/src ONBUILD RUN /usr/local/bin/python-build –dir /app/src […] 如果基于A创建新的镜像时,新的Dockerfile中使用 FROM image-A 指定基础镜像时,会自动执行 ONBUILD 指令内容,等价于在后面添加了两条指令。 FROM image-A #Automatically run the following ADD . /app/src RUN /usr/local/bin/python-build --dir /app/src 使用 ONBUILD 指令的镜像,推荐在标签中注明,例如 ruby:1.9-onbuild 。 1234567 compose 编排 编排(orchestration),指自动配置、协作和管理服务的过程,在 Docker 中,编排用来描述一组实践过程,这个过程会管理运行在多个 Docker 里的应用,这些 Docker 容器也可能运行在不同的宿主机上。 docker-compose Docker 编排工具 Docker Compose ,由 Python 编写。使用 Docker Compose ,可以用一个 YAML 文件定义一组要启动的容器,以及容器运行时的属性。Docker Compose 称这些容器为“服务”: 容器通过某些方法并制定一些运行时的属性来和其他容器产生交互。 默认的模板文件是 docker-compose.yml,其中定义的每个服务都必须通过 image 指令指定镜像或 build 指令(需要 Dockerfile)来自动构建。 其它大部分指令都跟 docker run 中的类似。 如果使用 build 指令,在 Dockerfile 中设置的选项(例如:CMD, EXPOSE, VOLUME, ENV 等) 将会自动被获取,无需在 docker-compose.yml 中再次设置。 image 指定为镜像名称或镜像 ID。如果镜像在本地不存在,Compose 将会尝试拉去这个镜像。 docker-compose.yml配置文件 先看例子: version: '2' services: web: image: dockercloud/hello-world ports: - 8080 networks: - front-tier - back-tier redis: image: redis links: - web networks: - back-tier lb: image: dockercloud/haproxy ports: - 80:80 links: - web networks: - front-tier - back-tier volumes: - /var/run/docker.sock:/var/run/docker.sock networks: front-tier: driver: bridge back-tier: driver: bridge versionn, services、networks 三大部分,其中最关键的就是 services 和 networks 两个部分,下面先来看 services 的书写规则。 1. image services: web: image: hello-world 在 services 标签下的第二级标签是 web,这个名字是用户自己自定义,它就是服务名称。 image 则是指定服务的镜像名称或镜像 ID。如果镜像在本地不存在,Compose 将会尝试拉取这个镜像。 例如下面这些格式都是可以的: image: redis image: ubuntu:14.04 image: tutum/influxdb image: example-registry.com:4000/postgresql image: a4bc65fd 2. build 服务除了可以基于指定的镜像,还可以基于一份 Dockerfile,在使用 up 启动之时执行构建任务,这个构建标签就是 build,它可以指定 Dockerfile 所在文件夹的路径。Compose 将会利用它自动构建这个镜像,然后使用这个镜像启动服务容器。 build: /path/to/build/dir 也可以是相对路径,只要上下文确定就可以读取到 Dockerfile。 build: ./dir 设定上下文根目录,然后以该目录为准指定 Dockerfile。 build: context: ../ dockerfile: path/of/Dockerfile 注意 build 都是一个目录,如果你要指定 Dockerfile 文件需要在 build 标签的子级标签中使用 dockerfile 标签指定,如上面的例子。 如果你同时指定了 image 和 build 两个标签,那么 Compose 会构建镜像并且把镜像命名为 image 后面的那个名字。 build: ./dir image: webapp:tag 既然可以在 docker-compose.yml 中定义构建任务,那么一定少不了 arg 这个标签,就像 Dockerfile 中的 ARG 指令,它可以在构建过程中指定环境变量,但是在构建成功后取消,在 docker-compose.yml 文件中也支持这样的写法: build: context: . args: buildno: 1 password: secret 下面这种写法也是支持的,一般来说下面的写法更适合阅读。 build: context: . args: - buildno=1 - password=secret 与 ENV 不同的是,ARG 是允许空值的。例如: args: - buildno - password 这样构建过程可以向它们赋值。 注意:YAML 的布尔值(true, false, yes, no, on, off)必须要使用引号引起来(单引号、双引号均可),否则会当成字符串解析。 3. command 使用 command 可以覆盖容器启动后默认执行的命令。 command: bundle exec thin -p 3000 也可以写成类似 Dockerfile 中的格式: command: [bundle, exec, thin, -p, 3000] 4.container_name 前面说过 Compose 的容器名称格式是:<项目名称><服务名称><序号> 虽然可以自定义项目名称、服务名称,但是如果你想完全控制容器的命名,可以使用这个标签指定: container_name: app 这样容器的名字就指定为 app 了。 5.depends_on 在使用 Compose 时,最大的好处就是少打启动命令,但是一般项目容器启动的顺序是有要求的,如果直接从上到下启动容器,必然会因为容器依赖问题而启动失败。 例如在没启动数据库容器的时候启动了应用容器,这时候应用容器会因为找不到数据库而退出,为了避免这种情况我们需要加入一个标签,就是 depends_on,这个标签解决了容器的依赖、启动先后的问题。 例如下面容器会先启动 redis 和 db 两个服务,最后才启动 web 服务: version: '2' services: web: build: . depends_on: - db - redis redis: image: redis db: image: postgres 注意的是,默认情况下使用 docker-compose up web 这样的方式启动 web 服务时,也会启动 redis 和 db 两个服务,因为在配置文件中定义了依赖关系。 6.dns 和 --dns 参数一样用途,格式如下: dns: 8.8.8.8 也可以是一个列表: dns: - 8.8.8.8 - 9.9.9.9 此外 dns_search 的配置也类似: dns_search: example.com dns_search: - dc1.example.com - dc2.example.com 7. tmpfs 挂载临时目录到容器内部,与 run 的参数一样效果: tmpfs: /run tmpfs: - /run - /tmp 8. entrypoint 在 Dockerfile 中有一个指令叫做 ENTRYPOINT 指令,用于指定接入点,第四章有对比过与 CMD 的区别。 在 docker-compose.yml 中可以定义接入点,覆盖 Dockerfile 中的定义: entrypoint: /code/entrypoint.sh 格式和 Docker 类似,不过还可以写成这样: entrypoint: - php - -d - zend_extension=/usr/local/lib/php/extensions/no-debug-non-zts-20100525/xdebug.so - -d - memory_limit=-1 - vendor/bin/phpunit 9.env_file 还记得前面提到的 .env 文件吧,这个文件可以设置 Compose 的变量。而在 docker-compose.yml 中可以定义一个专门存放变量的文件。 如果通过 docker-compose -f FILE 指定了配置文件,则 env_file 中路径会使用配置文件路径。 如果有变量名称与 environment 指令冲突,则以后者为准。格式如下: env_file: .env 或者根据 docker-compose.yml 设置多个: env_file: - ./common.env - ./apps/web.env - /opt/secrets.env 注意的是这里所说的环境变量是对宿主机的 Compose 而言的,如果在配置文件中有 build 操作,这些变量并不会进入构建过程中,如果要在构建中使用变量还是首选前面刚讲的 arg 标签。 10. environment 与上面的 env_file 标签完全不同,反而和 arg 有几分类似,这个标签的作用是设置镜像变量,它可以保存变量到镜像里面,也就是说启动的容器也会包含这些变量设置,这是与 arg 最大的不同。 一般 arg 标签的变量仅用在构建过程中。而 environment 和 Dockerfile 中的 ENV 指令一样会把变量一直保存在镜像、容器中,类似 docker run -e 的效果。 environment: RACK_ENV: development SHOW: 'true' SESSION_SECRET: environment: - RACK_ENV=development - SHOW=true - SESSION_SECRET 11. expose 这个标签与Dockerfile中的EXPOSE指令一样,用于指定暴露的端口,但是只是作为一种参考,实际上docker-compose.yml的端口映射还得ports这样的标签。 expose: - "3000" - "8000" 12. external_links 在使用Docker过程中,我们会有许多单独使用docker run启动的容器,为了使Compose能够连接这些不在docker-compose.yml中定义的容器,我们需要一个特殊的标签,就是external_links,它可以让Compose项目里面的容器连接到那些项目配置外部的容器(前提是外部容器中必须至少有一个容器是连接到与项目内的服务的同一个网络里面)。 格式如下: external_links: - redis_1 - project_db_1:mysql - project_db_1:postgresql 13. extra_hosts 添加主机名的标签,就是往/etc/hosts文件中添加一些记录,与Docker client的--add-host类似: extra_hosts: - "somehost:162.242.195.82" - "otherhost:50.31.209.229" 启动之后查看容器内部hosts: 162.242.195.82 somehost 50.31.209.229 otherhost 14. labels 向容器添加元数据,和Dockerfile的LABEL指令一个意思,格式如下: labels: com.example.description: "Accounting webapp" com.example.department: "Finance" com.example.label-with-empty-value: "" labels: - "com.example.description=Accounting webapp" - "com.example.department=Finance" - "com.example.label-with-empty-value" 15. links 还记得上面的depends_on吧,那个标签解决的是启动顺序问题,这个标签解决的是容器连接问题,与Docker client的--link一样效果,会连接到其它服务中的容器。 格式如下: links: - db - db:database - redis 使用的别名将会自动在服务容器中的/etc/hosts里创建。例如: 172.12.2.186 db 172.12.2.186 database 172.12.2.187 redis 相应的环境变量也将被创建。 16. logging 这个标签用于配置日志服务。格式如下: logging: driver: syslog options: syslog-address: "tcp://192.168.0.42:123" 默认的driver是json-file。只有json-file和journald可以通过docker-compose logs显示日志,其他方式有其他日志查看方式,但目前Compose不支持。对于可选值可以使用options指定。 有关更多这方面的信息可以阅读官方文档:https://docs.docker.com/engine/admin/logging/overview/ 17. pid pid: "host" 将PID模式设置为主机PID模式,跟主机系统共享进程命名空间。容器使用这个标签将能够访问和操纵其他容器和宿主机的名称空间。 18. ports 映射端口的标签。 使用HOST:CONTAINER格式或者只是指定容器的端口,宿主机会随机映射端口。 ports: - "3000" - "8000:8000" - "49100:22" - "127.0.0.1:8001:8001" 注意:当使用HOST:CONTAINER格式来映射端口时,如果你使用的容器端口小于60你可能会得到错误得结果,因为YAML将会解析xx:yy这种数字格式为60进制。所以建议采用字符串格式。 19. security_opt 为每个容器覆盖默认的标签。简单说来就是管理全部服务的标签。比如设置全部服务的user标签值为USER。 security_opt: - label:user:USER - label:role:ROLE 20. stop_signal 设置另一个信号来停止容器。在默认情况下使用的是SIGTERM停止容器。设置另一个信号可以使用stop_signal标签。 stop_signal: SIGUSR1 21. volumes 挂载一个目录或者一个已存在的数据卷容器,可以直接使用 [HOST:CONTAINER] 这样的格式,或者使用 [HOST:CONTAINER:ro] 这样的格式,后者对于容器来说,数据卷是只读的,这样可以有效保护宿主机的文件系统。 Compose的数据卷指定路径可以是相对路径,使用 . 或者 .. 来指定相对目录。 数据卷的格式可以是下面多种形式: volumes: // 只是指定一个路径,Docker 会自动在创建一个数据卷(这个路径是容器内部的)。 - /var/lib/mysql // 使用绝对路径挂载数据卷 - /opt/data:/var/lib/mysql // 以 Compose 配置文件为中心的相对路径作为数据卷挂载到容器。 - ./cache:/tmp/cache // 使用用户的相对路径(~/ 表示的目录是 /home/<用户目录>/ 或者 /root/)。 - ~/configs:/etc/configs/:ro // 已经存在的命名的数据卷。 - datavolume:/var/lib/mysql 如果你不使用宿主机的路径,你可以指定一个volume_driver。 volume_driver: mydriver 22. volumes_from 从其它容器或者服务挂载数据卷,可选的参数是 :ro或者 :rw,前者表示容器只读,后者表示容器对数据卷是可读可写的。默认情况下是可读可写的。 volumes_from: - service_name - service_name:ro - container:container_name - container:container_name:rw 23. cap_add, cap_drop 添加或删除容器的内核功能。详细信息在前面容器章节有讲解,此处不再赘述。 cap_add: - ALL cap_drop: - NET_ADMIN - SYS_ADMIN 24. cgroup_parent 指定一个容器的父级cgroup。 cgroup_parent: m-executor-abcd 25. devices 设备映射列表。与Docker client的--device参数类似。 devices: - "/dev/ttyUSB0:/dev/ttyUSB0" 26. extends 这个标签可以扩展另一个服务,扩展内容可以是来自在当前文件,也可以是来自其他文件,相同服务的情况下,后来者会有选择地覆盖原有配置。 extends: file: common.yml service: webapp 用户可以在任何地方使用这个标签,只要标签内容包含file和service两个值就可以了。file的值可以是相对或者绝对路径,如果不指定file的值,那么Compose会读取当前YML文件的信息。 更多的操作细节在后面的12.3.4小节有介绍。 27. network_mode 网络模式,与Docker client的--net参数类似,只是相对多了一个service:[service name] 的格式。 例如: network_mode: "bridge" network_mode: "host" network_mode: "none" network_mode: "service:[service name]" network_mode: "container:[container name/id]" 可以指定使用服务或者容器的网络。 28. networks 加入指定网络,格式如下: services: some-service: networks: - some-network - other-network 关于这个标签还有一个特别的子标签aliases,这是一个用来设置服务别名的标签,例如: services: some-service: networks: some-network: aliases: - alias1 - alias3 other-network: aliases: - alias2 相同的服务可以在不同的网络有不同的别名。 29. 其它 还有这些标签:cpu_shares, cpu_quota, cpuset, domainname, hostname, ipc, mac_address, mem_limit, memswap_limit, privileged, read_only, restart, shm_size, stdin_open, tty, user, working_dir 上面这些都是一个单值的标签,类似于使用docker run的效果。 cpu_shares: 73 cpu_quota: 50000 cpuset: 0,1 user: postgresql working_dir: /code domainname: foo.com hostname: foo ipc: host mac_address: 02:42:ac:11:65:43 mem_limit: 1000000000 memswap_limit: 2000000000 privileged: true restart: always read_only: true shm_size: 64M stdin_open: true tty: true docker compose使用 Define and run multi-container applications with Docker. Usage: docker-compose [-f <arg>...] [options] [COMMAND] [ARGS...] docker-compose -h|--help Options: -f, --file FILE Specify an alternate compose file (default: docker-compose.yml) -p, --project-name NAME Specify an alternate project name (default: directory name) --verbose Show more output --log-level LEVEL Set log level (DEBUG, INFO, WARNING, ERROR, CRITICAL) --no-ansi Do not print ANSI control characters -v, --version Print version and exit -H, --host HOST Daemon socket to connect to --tls Use TLS; implied by --tlsverify --tlscacert CA_PATH Trust certs signed only by this CA --tlscert CLIENT_CERT_PATH Path to TLS certificate file --tlskey TLS_KEY_PATH Path to TLS key file --tlsverify Use TLS and verify the remote --skip-hostname-check Don't check the daemon's hostname against the name specified in the client certificate --project-directory PATH Specify an alternate working directory (default: the path of the Compose file) --compatibility If set, Compose will attempt to convert deploy keys in v3 files to their non-Swarm equivalent Commands: build Build or rebuild services bundle Generate a Docker bundle from the Compose file config Validate and view the Compose file create Create services down Stop and remove containers, networks, images, and volumes events Receive real time events from containers exec Execute a command in a running container help Get help on a command images List images kill Kill containers logs View output from containers pause Pause services port Print the public port for a port binding ps List containers pull Pull service images push Push service images restart Restart services rm Remove stopped containers run Run a one-off command scale Set number of containers for a service start Start services stop Stop services top Display the running processes unpause Unpause services up Create and start containers version Show the Docker-Compose version information docker-compose ps 列出本地 docker-compose.yml 文件定义的正在运行的所有服务,查看服务运行状态 docker-compose logs docker-compose stop
优秀的个人博客,低调大师

使用Docker for Windows初体验

这是第二次使用Docker for Windows了。 最近准备研究一下Docker的一些高级特性如Swarm Clusters,需要用到docker-machine,docker-machine目前仅支持Mac 或 Windows,由于没有Mac所以需要在Windows上运行Docker。官方声称Docker for Windows是一个在Windows系统中创建容器化App的完整开发平台。看完这篇文章,或许你会对Docker和Windows有重新的认识,一改之前对Windows的那些“不好感”。 先放几个截图供查阅: 1.docker 引擎信息 2.容器基本操作 3.容器镜像基本操作: Docker for Windows运行环境要求: 1.当前Docker for Windows版本需要64位Windows 10 Pro、Enterprise或Education(1511 November update, Build 10586 or later)系统,后续版本可能会支持更多Windows 10,Windows Server 2016同样被支持 2.必须启用CPU虚拟化和Hyper-V功能,Hyper-V角色可以在Docker for Windows安装过程中自动安装,可能会重启Windows,一旦安装Docker for Windows,将无法再使用VMware虚拟化产品以及其他虚拟化产品,如无法再使用VMware Workstation和Virtualbox等 Docker for Windows一些基本知识: Docker for Windows运行原理远比现有了解的复杂的多得多,只是简单描述一些已经获得的知识: 1.Docker for Windows的组成部分有多个,不仅包含Windows平台上的一些bin程序供用户使用,也包含了一个基于Hyper-V的虚拟机,虚拟机采用Alpine Linux v3.5操作系统 2.docker volume create指令创建出的数据卷存在在虚拟机中,不易与主机进行交互(Hyper-V虚拟机运行期间无法将磁盘中的数据暴露到主机上),因此数据卷这个功能或许会被-v选项所替代 3.Docker for Windows与PowerShell联用,通过PowerShell来操作docker行为,当然cmd也可以 4.Docker for Windows支持两种容器,Linux container和Windows Container,默认是Linux container,依赖于运行在Hyper-V中的虚拟机。Windows Container并不依赖于虚拟机,但也同样依赖于Hyper-V。两种模式的切换会导致重启Windows,而且显而易见的两种模式下的数据并不共享,它们的配置和数据都是独立存在的。令人意外的是Windows container无法运行依赖Linux环境的容器,如nginx等。 Docker for Windows使用小技巧: 与Linux平台上安装的docker环境基本一样,Docker for Windows同样支持一些共有的特性: 1.配置不安全的registry地址和registry镜像(加速)地址 2.支持数据卷和主机存储路径映射(-v选项),数据卷的支持在Docker for Windows中用起来不方便(参考上文的基本知识),推荐使用-v选项 3.在使用-v选项之前,个人建议在磁盘管理中创建一个vhd虚拟磁盘挂载到主机,比如标记成E盘,然后将这个虚拟磁盘共享给Docker for Windows: 需要注意的是,重启后vhd虚拟磁盘将会不再挂载,需要手动"附加vhd"。 借助Docker for Windows做几件有意思的事儿: 1.重新定义app,将运行在Linux上的app,原生的“放到”Windows中,轻松获得心理上的“原生感” 2.操作容器简单化,不再需要打开VMware等虚拟化产品也不需要再使用端口映射,启动Linux再启动容器这样麻烦,只需要双击运行Docker for Windows,即可使用,外部访问轻松配置 3.开始玩转docker-machine和Swarm Clusters等 开始安装吧!因为一点也不难! 参考链接: 开始使用Docker for Windowshttps://docs.docker.com/docker-for-windows/ 安装Docker for Windowshttps://docs.docker.com/docker-for-windows/install/ tag:Docker for Windows --end-- 本文转自 urey_pp 51CTO博客,原文链接:http://blog.51cto.com/dgd2010/1914864,如需转载请自行联系原作者

优秀的个人博客,低调大师

Objective-C 初体验

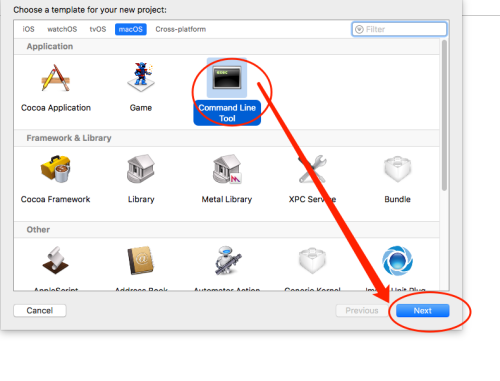
因为要接SDK的原因,现在搞搞OC,本人是以控制台程序入手学的。 本片主要知识点: 一:创建控制台项目 二:创建类(h文件与m文件分开) 三:类成员的编写,坑啊 1创建控制台项目: 1,打开XCode , File -》 New -》 Project... 2,在打开的界面中如下操作: 3,选择项目的保存位置。。。 2,新建类(h文件和m文件) 1,File-》New -》File... 2,进入创建界面后如下操作(这样会生成h文件和m文件): 3,选择文件保存的位置。。。。。 代码: Aonaufly.h如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 // //Aonaufly.h //Ainy_Console // //CreatedbyAppleon2017/9/7. //Copyright2017年Apple.Allrightsreserved. // #import<Foundation/Foundation.h> @interfaceAonaufly:NSObject @property int _a,_b; -( int )sum_one:( int )csum_b:( int )d; //带参数名的方法 -( int )sum:( int )i:( int )j; //不带参数名的方法 @end Aonaufly.m代码如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 // //Aonaufly.m //Ainy_Console // //CreatedbyAppleon2017/9/7. //Copyright2017年Apple.Allrightsreserved. // #import"Aonaufly.h" @implementationAonaufly @synthesize_a,_b; -( int )sum_one:( int )csum_b:( int )d { return [selfsum:c:d]; //调用本类的方法sum } -( int )sum:( int )i:( int )j { return i+j; } @end 入口main调用如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 // //main.m //Ainy_Console // //CreatedbyAppleon2017/9/6. //Copyright2017年Apple.Allrightsreserved. // #import"Aonaufly.h" int main( int argc, const char *argv[]){ @autoreleasepool{ Aonaufly*myAonaufly; myAonaufly=[[Aonauflyalloc]init]; int sum=[myAonauflysum_one:1sum_b:2]; //调用方法(带参数) NSLog(@ "thisis1+2SUM:%i" ,sum); //为属性_a,_b赋值 myAonaufly._a=3; myAonaufly._b=5; //调用不带参数名的sum方法如下 sum=[myAonauflysum:myAonaufly._a:myAonaufly._b]; NSLog(@ "this%i+%ivalueis:%i" ,myAonaufly._a,myAonaufly._b,sum); } return 0; } 结果: 解析如下: 1,头文件 @property 实际声明的是seter 和 geter , 在m文件中直接用@synthesize直接实现 2,关于方法-》 -(int)定义的是返回值类型 sum_one : ( int) c sum_b : (int) d;的调用方式[ myAonaufly sum_one:1 sum_b:2] sum :(int) i : (int) j;的调用方式[myAonaufly sum:myAonaufly._a :myAonaufly._b] 很坑 ,独树一帜和很多主流编程语言都不一样。。。。 本文转自Aonaufly51CTO博客,原文链接:http://blog.51cto.com/aonaufly/1963502,如需转载请自行联系原作者

优秀的个人博客,低调大师

JAVA性能测试初体验

序言:做自动化测试的时候,一直没想过要去做性能,等到现在做性能的时候,才明白这本身就是一个必须都要经历的过程,就像编程一样,编写小型软件的时候,我们不用过多关注架构和性能,但是等成长到一定时候,就会需要关注软件的可复用性(这是由开发成本决定,这点可以在软件架构上去改善,常说的自动化框架也是为了增强脚本的可复用性和可维护性)、性能瓶颈(这是由系统资源成本决定,空间和时间的调配)、可测试行(这能大大提高测试人员的测试效率,很多时候我们要求开发提供一种测试的接口来方便测试人员进行测试)、可部署性(利用make、ant或者maven,能够大大提高软件发布效率,这也是持续集成中的一种手段)等,因此,测试中的发展其实可以有很多的,不仅关注测试手段,还要关注如何在更多的途径上提高测试效率。下面是对本次性能测试项目至今的一些简单总结,欢迎指正。 一、性能测试项目的背景 性能测试缘起于产品存在大量背景数据时,程序响应时间过慢,而且在特定的情况下有可能会造成一些数据上报丢失,所以需要定位。 产品为C/S架构,采用的协议是snmp协议,运行在jvm上。 二、性能测试的策略 1、测试目的的确定 1)系统监控,包括cpu、内存、线程使用情况,在大数据情况下,发现问题,帮助修正代码结构,系统结构,提高系统的运行效率。 2)确定软件运行资源需求指标。 2、性能测试指标确定 1)确定指标来源,主要包括:产品规格、行业标准、客户需求与故障场景等 2)确定测试特性,例如:系统容量、及时性、稳定性、抗压性、资源利用性等,这些特性可以根据行业性能测试特性以及产品的相关特性来决定。 3)确定具体指标,包括数目和单位。 3、性能测试技术储备 其实性能测试可以算得上是自动化测试的一种大数据测试 1)测试场景准备:准备测试场景,可以理解为对背景数据的构造,其实可以将这种构造理解为另类的接口测试,例如:我们的软件服务器是应用SNMP协议进行通信,设备端有一个agent,专门用来与软件服务器端通信,那么可以虚拟出这么一个agent,保存相应的设备信息,虚拟过程可以通过对在网的实际设备进行录制,然后生成。 互联网中,客户端与服务器的交涉是基于http接口协议,其一般的性能测试都是发送大量的http请求,其实这种过程有一个问题就是无法模拟真实的背景数据,因为报文过于单一,而印象很深的是新浪一位朋友开发的tcpcopy工具,在传输层,将线上数据复制到测试场景下,从而成功模拟了真实场景环境,这是一种很好的测试方法。 (还有一种准备工作就是对测试服务器的选型,包括操作系统类型、CPU内核数目、内存数目等) 2)测试数据准备:这其实就是接口数据,在互联网中,这方面的模拟比较简单,用很多工具,例如LR、jmeter、soaupi等都可以成功构造模拟http报文,从而查看服务器的响应。因为我们采用的是snmp协议,所以业内没有这样的snmp接口工具,所以就自己基于snmp协议包开发了其snmp报文模拟工具。 3)性能测试监控:性能测试过程中,对软件系统服务器的监控是关键,例如:web测试中,往往会对web服务器和数据库服务器、操作系统的指标性能进行监控,因为我们的软件是运行在jvm上,所以直接采用jconsole或者jprofiler监控服务器的内存使用、cpu使用、各个线程使用情况,还有对数据库和操作系统的监控等。 4、性能测试方法 1)基于指标,进行测试数据构造测试,查看系统是否工作正常以及监测是否没有问题。 2)基于指标,在基于测试数据测试的同时,由测试人员参与进行操作,测试在特定环境下的系统工作情况。 3)客户场景模拟测试。 4)随机测试,利用算法进行大量随机数据构造。 三、性能测试调优 1、性能测试是一个不断探索和不断完善的一个测试过程。 调优步骤:衡量系统现状、设定调优目标、寻找性能瓶颈、性能调优、衡量是否到达目标(如果未到达目标,需重新寻找性能瓶颈)、性能调优结束 2、衡量现状,系统性能主要存在问题 1)内存泄露 2)内存占用过大,响应速率慢 3)线程数不断增加,出现死锁或空闲线程 4)某些类实例化数目过多,占用多余的内存空间 3、内存泄露 1)检验方式:内存泄露需要进行时长测试,既将监控界面及系统界面全部打开,进行长时间运行(如12小时),观察系统类的增长情况。 2)问题定位:若出现JVM的Heap持续增长或者Memory views经过时长测试,出现较大规模的红色部分(增长部分),且无法GC。 4、系统内存占用大 1)检验方式:进行某些特定的操作,系统进行大量内存占用或者数据读写操作。 2)问题定位:若系统内存数突发性的增长,且之后不回落,说明某些模块在持续性的占用系统资源。或者出现JVM的Heap有增长,虽不是持续增长,但一直无法回落。 5、线程数目过多或死锁 1)检验方式:进行某些特定的操作,可以使系统产生大量线程操作。 2)问题定位:若系统线程数突发性的增长或持续增长,且之后不回落,说明某些模块在持续性的占用线程。或者观察是否有许多线程来自同一个模块、长期处于waiting或block状态 6、性能调优原则 调优过程中,充分而不过分使用硬件资源、不要一遇到问题就去改善资源环境,然后,合理调整JVM,需要重点掌握一些JVM的参数,并且要善于分析系统架构和JVM的底层工作机制。 总结:性能测试是一个很漫长的过程,不管是做JVM性能测试、WEB架构方面的性能测试,其实道理是相通的,个人觉得,要做好性能测试,不仅要对测试理解,更要对软件架构和底层的服务器工作机制特别理解,不然,往往,你只能去简单做一些所谓的性能测试操作,但是却无法针对很多场景提供有效的测试策略和调优建议。好的性能测试工程师应该是能够快速搭建场景定位问题、提供指标,并且能够对软件系统架构提出有效建议。共勉之 ====================================分割线================================ 最新内容请见作者的GitHub页:http://qaseven.github.io/

优秀的个人博客,低调大师

OpenStack代码贡献初体验

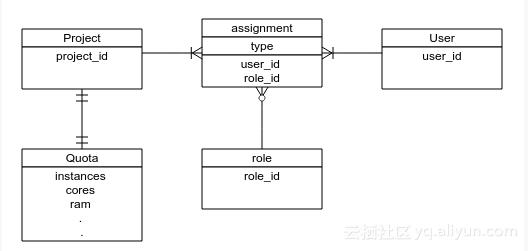
OpenStack如今已成为开源云平台中的明星项目,得到广泛关注。OpenStack的优秀出众依赖于众多开发者的努力,在享受其带来的便利与快捷的同时,为其做一份贡献也是一个开发者的义务。 在前段时间的OpenStack的测试过程中,我发现Nova项目中的一个Bug,于是向社区提交了Bug报告,并提交代码修复了该Bug,从提交报告到代码入库经历近一月,下面重现整个过程。 一.发现Bug: Nova中的虚拟机软删除(soft-delete)功能,是指在一段时间内,仅将数据库中的某虚拟机记录做一个标记(status='SOFT-DELETE'),然后将虚拟化平台(kvm等)中对应的虚拟机实例置为关机状态,当超过某一时间段后才将虚拟机实例真正删除;该功能为云平台用户提供了“后悔时间”,可以在一定程度上挽回误操作。默认情况下,软删除功能是关闭的,其开启方式是在nova配置文件中添加"reclaim_instance_interval"选项,并将其值设置为"后悔时间"的毫秒数。 在描述具体Bug前,需要对openstack中的用户管理方面的基本概念简单介绍一下。 上图是openstack用户模型的简化版本,为了便于理解将不属于keystone管理的quota也拿了过来。 Bug就与软删除相关。具体场景是这样的:假设OpenStack中有两个项目和两个用户:普通项目A其用户a,管理员项目Admin其用户为admin(用户管理相关概念可以查阅keystone文档),用户a不慎将自己的一台虚拟机删除了,这时求助系统管理员看看有没有办法恢复,好在系统开启的软删除功能,而且被删除的虚拟机还在可回收的时间范围内,这时管理员便以admin的身份登录系统,为用户a恢复了虚拟机,但是细心的管理员却发现了一些不对:其Admin项目下并没有任何虚拟机,但是其配额却被使用了,难道这和刚才的操作有关?再来重试一下:普通用户删除虚拟机,admin用户来为其恢复,这时配额又发生了变化,果然如此:被恢复的虚拟机的配额错误的添加到了Admin项目下。该Bug在最新的kilo版本中仍然存在,感兴趣的同学可以实验一下。 二.定位Bug: 发现了Bug的存在,那就更进一步,到代码中找一下原因吧。 如何确定问题代码的位置呢?这需要对Nova的项目结构有大体的了解,我们来简单了解一下: 上图是nova架构的极简版本,与本问题无关的组件都没有画上去,恢复虚拟机的操作过程大致是这样: nova api接收到用户请求,到数据库中查询虚拟机详情,将该虚拟机所在的主机、名称等数据发送到消息队列中; nova compute服务在监听到相关消息后,开始执行具体操作,将虚拟机在数据库中的记录做些调整,调用底层驱动恢复虚拟机。 既然软删除的功能层面没有任何问题,虚拟机的删除和恢复过程都很顺利,可见不会是驱动的问题,顺着API层的代码调用往下找,很快就可以定位了。直接看出问题的代码片段: def restore(self, context, instance): # 该代码做了删减 flavor = instance.get_flavor() # 获取quotas对象 num_instances, quotas = self._check_num_instances_quota( context, flavor, 1, 1) self._record_action_start(context, instance, instance_actions.RESTORE) try: if instance.host: instance.task_state = task_states.RESTORING instance.deleted_at = None instance.save(expected_task_state=[None]) self.compute_rpcapi.restore_instance(context, instance) else: instance.vm_state = vm_states.ACTIVE instance.task_state = None instance.deleted_at = None instance.save(expected_task_state=[None]) # 更新quotas quotas.commit() 上面的这段代码就是API层面上进行虚拟机回收的主要方法,可以看到其中有明显的配额操作(quotas),在解读这段代码前有必要先对nova中"context"的概念做个简介。不仅是nova,在openstack其他项目中都随处可见这个"context",它是一个包装了用户请求信息的对象,包含用户的项目和认证信息等,通过它可以简便的进行各项目之间的API调用和用户信息的查询,API服务接收到用户的每一次HTTP请求,都会创建一个新的context。 回到这段代码,我们重点关注对quotas所作的操作:在方法的第二行,通过了一个方法获取了quotas,有在方法的结尾执行了quotas.commit(),能够获取到的信息不多,我们再看一下获取quotas的方法:_check_num_instances_quota # 这里只截取一部分 def _check_num_instances_quota(self, context, instance_type, min_count, max_count): req_cores = max_count * instance_type['vcpus'] vram_mb = int(instance_type.get('extra_specs', {}).get(VIDEO_RAM, 0)) req_ram = max_count * (instance_type['memory_mb'] + vram_mb) try: quotas = objects.Quotas(context) quotas.reserve(context, instances=max_count, cores=req_cores, ram=req_ram) ... return max_count, quotas 这里可以看到获取quotas的过程:通过当前的context创建quotas对象,并且执行了reserve操作; 我们知道context是由HTTP请求而来,里面保存的是发请求的用户的信息,所以这里的quotas对象的“所有者”也就是context中的用户。 结合Bug发生的场景来看:管理员还原用户a的虚拟机,发请求的是管理员,当前context中记录的是管理员的信息,这里的quotas理所当然的就是管理员的,然后操作了用户a的虚拟机,更新的却是管理员的quotas。嗯,真相大白! 三.修复Bug: Bug的原因是获取的quotas并不属于期望的用户,但是直接修改context显然不合适(会影响后续的操作),先了解一下quotas对象自身吧: class Quotas(base.NovaObject): # 部分代码 def __init__(self, *args, **kwargs): super(Quotas, self).__init__(*args, **kwargs) # Set up defaults. self.reservations = [] self.project_id = None self.user_id = None self.obj_reset_changes() ... def reserve(self, context, expire=None, project_id=None, user_id=None, **deltas): reservations = quota.QUOTAS.reserve(context, expire=expire, project_id=project_id, user_id=user_id, **deltas) self.reservations = reservations self.project_id = project_id self.user_id = user_id self.obj_reset_changes() def commit(self, context=None): if not self.reservations: return if context is None: context = self._context quota.QUOTAS.commit(context, self.reservations, project_id=self.project_id, user_id=self.user_id) self.reservations = None self.obj_reset_changes() 注意看reserve方法的参数,默认为None的project_id和user_id,这正是改变quotas属主的方便入口! 修改后的代码这里就不贴了,感兴趣的同学可以到这次提交中看:Code Review 四.代码提交和Review: openstack社区有着整套项目管理流程,这里有一张图能够较详细的描述工作流程: 由图可见bugfix是其中最简单的流程。 关于如何提交代码,这篇文章有详细的介绍: 向 OpenStack 贡献您的代码。另外需要注意一点,在国内向社区提交代码,经常会因为网络问题导致无法提交,幸好找到了大牛的博客介绍了该类问题的解决办法。 修改完代码的单元测试和pep8本地测试当然不能少,早就知道社区对单元测试要求很严格,这次才真正领教了,三行代码的修改,单元测试却写了30行,review期间多次因为单元测试的问题重提代码(哭)。社区里面的开发者,尤其是项目的core,对待项目有着像对自己孩子般的认真与细致:他们会在一个自己根本不会在意的地方提醒你、面对当前的问题他们会延伸的考虑类似的问题。他们的态度让我首先感受到的吃惊,然后是敬佩! 经历八次review、历时近一个月,我的代码总算是入库了!希望我的这篇记录能对你有帮助。 感谢休伦公司技术总监 孙琦 提供的英文支持,社区大牛Alex Xu给出的修改建议。 Launchpad上面的bug提交: Abnormal changes of quota usage after instance restored by admin 代码审查过程: Fix abnormal quota usage after restore by admin Git@OSC中的代码: Fix abnormal quota usage after restore by admin 文章转载自 开源中国社区[https://www.oschina.net]

优秀的个人博客,低调大师

Ubuntu 20.04 ZFS 快照初体验

借助 Canonical 的 Zsys 计划,Ubuntu 20.04 的 ZFS 改进的一部分是能够自动对 APT 操作进行快照,以便在软件包管理更改后根据需要进行系统回滚/还原。 在 Ubuntu 19.10 中,Canonical向其 Ubiquity 桌面安装程序添加了 ZFS 根文件系统安装选项,Ubuntu 20.04 的桌面安装程序则提供了简化的安装选项。 在 Ubiquity 的“高级功能”中,可以选择安装 ZFS 根文件系统,但该选项仍是实验性的,EXT4 还是默认的文件系统。 试用中可以看到,在继续使用带有 ZFS 的 Ubuntu 20.04 每日构建 ISO 并重新启动系统后,执行任何 APT 事务时,都会出现新的“正在保存系统状态”的消息。如果软件包升级/安装/删除出现问题,运行 APT 将触发 Zsys 拍摄 ZFS 快照。 引导加载程序 GRUB 中出现一个“历史记录”菜单。 从该历史记录菜单中,可以选择一个较早的快照进行引导。 快照的行为和 GRUB 处理类似于十年前的 Fedora Btrfs 系统回滚选项,以及 SUSE/openSUSE 上提供的功能。 消息来自:https://www.phoronix.com/scan.php?page=news_item&px=Trying-Ubuntu-20.04-ZFS-Snaps

优秀的个人博客,低调大师

Link Develop平台之初体验

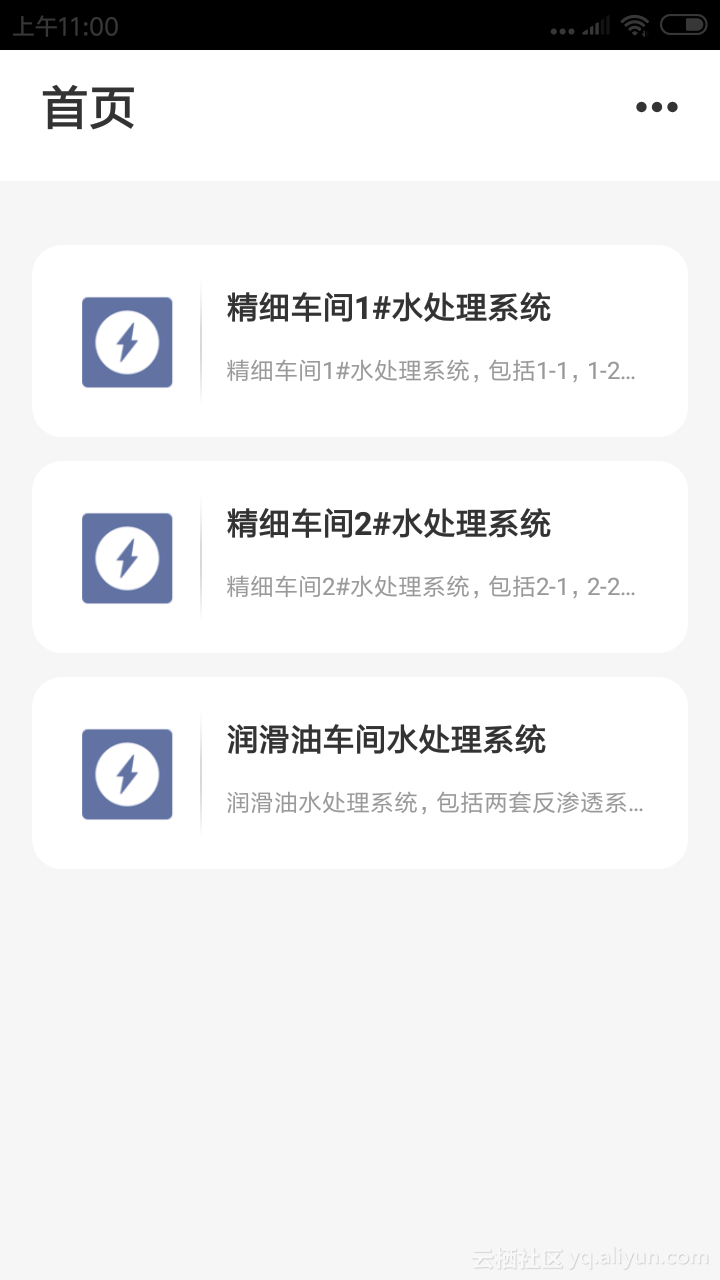
最近拿公司的一个项目体验了一下阿里云lot的link develop平台,使用起来还是很方便的,创建设备模型,定义功能,接入设备,数据就上来了,展示方面平台也提供了很方便的工具,先上图看下结果。 实现方式 通过网关把服务现场PLC的数据接入阿里云Link Develop平台,然后通过移动应用将获取到的数据根据需要做页面分类展示,2个网关接入了三个设备的数据。

优秀的个人博客,低调大师

Android测试之Monkey初体验

什么是Monkey? Monkey是Android中自带的用来进行压力测试的一个命令行工具。 用Monkey进行App压力测试的结果有三种 正常 Crash :程序崩溃 ANR:程序无响应 Monkey简单测试步骤 1.手机与电脑进行USB连接,并在开发者选项中选中USB调试 2.确认手机与电脑连接:打开cmd命令行或者使用Android Studio的朋友可以打开Terminal视图,输入adb devices查看已连接的设备。 如果设备连接成功会显示 注意:如果输入命令显示adb 不是内部或外部命令,也不是可运行的程序或批处理文件的话,就需要配置环境变量。 3.安装Apk到手机上 adb install package.apk 4.执行Monkey指令: monkey 500 结果我们发现这样执行的结果是对手机上的所有APP随机进行操作的并没有对特定的APP进行操作,那么下一步我们就以计算器APP来演示下如何对于特定的APP进行测试。 1)获取手机计算器的包名:需要在adb shell模式下输入logcat | grep START,会显示出当前启动的APP的信息 2)划到最底部,然后打开手机的计算器应用 在打印出的信息里我们可以查看到计算器的包名为com.android.calculator2 3)输入monkey -p com.android.calculator2 500(表示对计算器APP执行500次的随机事件) 我们会发现所有的操作都在计算器里执行的 补充 如果存在多个手机连接,输入adb shell会有如下提示。 如果想进入某一个设备需要执行adb -s 设备名 shell 个人博客:https://myml666.github.io

优秀的个人博客,低调大师

Spark2.1.0之初体验

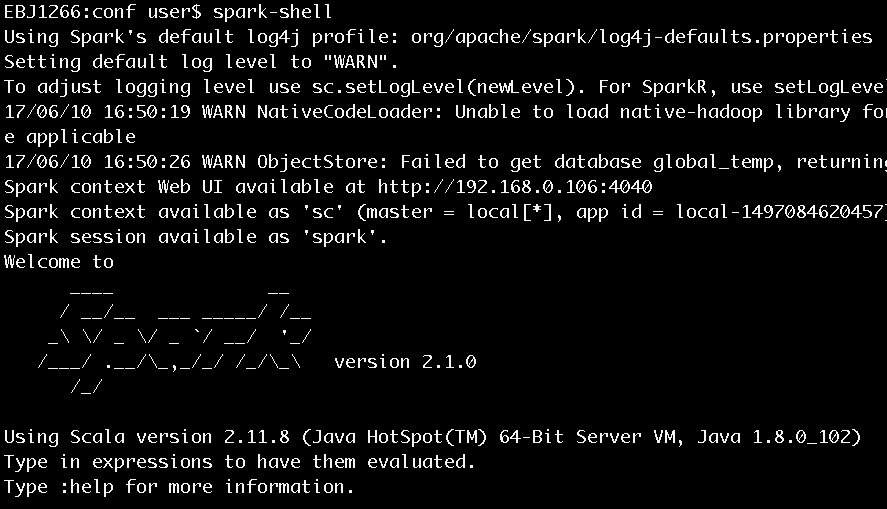
版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/beliefer/article/details/80042366 在《Spark2.1.0之运行环境准备》一文中,已经介绍了如何准备好基本的Spark运行环境,现在是时候实践一下,以便于在使用过程中提升读者对于Spark最直接的感触!本文通过Spark的基本使用,让读者对Spark能有初步的认识,便于引导读者逐步深入学习。 运行spark-shell 在《Spark2.1.0之运行环境准备》一文曾经简单运行了spark-shell,并用下图进行了展示(此处再次展示此图)。 图1执行spark-shell进入Scala命令行 图1中显示了很多信息,这里进行一些说明: 在安装完Spark 2.1.0后,如果没有明确指定log4j的配置,那么Spark会使用core模块的org/apache/spark/目录下的log4j-defaults.properties作为log4j的默认配置。log4j-defaults.properties指定的Spark日志级别为WARN。用户可以到Spark安装目录的conf文件夹下从log4j.properties.template复制一份log4j.properties文件,并在其中增加自己想要的配置。 除了指定log4j.properties文件外,还可以在spark-shell命令行中通过sc.setLogLevel(newLevel)语句指定日志级别。 SparkContext的Web UI的地址是:http://192.168.0.106:4040。192.168.0.106是笔者安装Spark的机器的ip地址,4040是SparkContext的Web UI的默认监听端口。 指定的部署模式(即master)为local[*]。当前应用(Application)的ID为local-1497084620457。 可以在spark-shell命令行通过sc使用SparkContext,通过spark使用SparkSession。sc和spark实际分别是SparkContext和SparkSession在Spark REPL中的变量名,具体细节已在《Spark2.1.0之剖析spark-shell》一文有过分析。 由于Spark core的默认日志级别是WARN,所以看到的信息不是很多。现在我们将Spark安装目录的conf文件夹下的log4j.properties.template以如下命令复制出一份: cp log4j.properties.template log4j.properties 并将log4j.properties中的log4j.logger.org.apache.spark.repl.Main=WARN修改为log4j.logger.org.apache.spark.repl.Main=INFO,然后我们再次运行spark-shell,将打印出更丰富的信息,如图2所示。 图2 Spark启动过程打印的部分信息 从图2展示的启动日志中我们可以看到SecurityManager、SparkEnv、BlockManagerMasterEndpoint、DiskBlockManager、MemoryStore、SparkUI、Executor、NettyBlockTransferService、BlockManager、BlockManagerMaster等信息。它们是做什么的?刚刚接触Spark的读者只需要知道这些信息即可,具体内容将在后边的博文给出。 执行word count 这一节,我们通过word count这个耳熟能详的例子来感受下Spark任务的执行过程。启动spark-shell后,会打开Scala命令行,然后按照以下步骤输入脚本: 步骤1 输入val lines =sc.textFile("../README.md", 2),以Spark安装目录下的README.md文件的内容作为word count例子的数据源,执行结果如图3所示。 图3 步骤1执行结果 图3告诉我们lines的实际类型是MapPartitionsRDD。 步骤2 textFile方法对文本文件是逐行读取的,我们需要输入val words =lines.flatMap(line => line.split(" ")),将每行文本按照空格分隔以得到每个单词,执行结果如图4所示。 图4 步骤2执行结果 图4告诉我们lines在经过flatMap方法的转换后得到的words的实际类型也是MapPartitionsRDD。 步骤3 对于得到的每个单词,通过输入val ones = words.map(w => (w,1)),将每个单词的计数初始化为1,执行结果如图5所示。 图5 步骤3执行结果 图5告诉我们words在经过map方法的转换后得到的ones的实际类型也是MapPartitionsRDD。 步骤4 输入val counts = ones.reduceByKey(_ + _),对单词进行计数值的聚合,执行结果如图6所示。 图6 步骤4执行结果 图6告诉我们ones在经过reduceByKey方法的转换后得到的counts的实际类型是ShuffledRDD。 步骤5 输入counts.foreach(println),将每个单词的计数值打印出来,作业的执行过程如图7和图8所示。作业的输出结果如图9所示。 图7 步骤5执行过程第一部分 图8 步骤5执行过程第二部分 图7和图8展示了很多作业提交、执行的信息,这里挑选关键的内容进行介绍: SparkContext为提交的Job生成的ID是0。 一共有四个RDD,被划分为ResultStage和ShuffleMapStage。ShuffleMapStage的ID为0,尝试号为0。ResultStage的ID为1,尝试号也为0。在Spark中,如果Stage没有执行完成,就会进行多次重试。Stage无论是首次执行还是重试都被视为是一次Stage尝试(Stage Attempt),每次Attempt都有一个唯一的尝试号(AttemptNumber)。 由于Job有两个分区,所以ShuffleMapStage和ResultStage都有两个Task被提交。每个Task也会有多次尝试,因而也有属于Task的尝试号。从图中看出ShuffleMapStage中的两个Task和ResultStage中的两个Task的尝试号也都是0。 HadoopRDD则用于读取文件内容。 图9 步骤5输出结果 图9展示了单词计数的输出结果和最后打印的任务结束的日志信息。 笔者在本文介绍的word count例子是以SparkContext的API来实现的,读者朋友们也可以选择在spark-shell中通过运用SparkSession的API来实现。 有了对Spark的初次体验,下面可以来分析下spark-shell的实现原理了,请看——《Spark2.1.0之剖析spark-shell》 关于《Spark内核设计的艺术 架构设计与实现》经过近一年的准备,基于Spark2.1.0版本的《 Spark内核设计的艺术 架构设计与实现》一书现已出版发行,图书如图: 纸质版售卖链接如下: 京东: https://item.jd.com/12302500.html 电子版售卖链接如下: 京东: https://e.jd.com/30389208.html

优秀的个人博客,低调大师

Java10 初体验(实战)

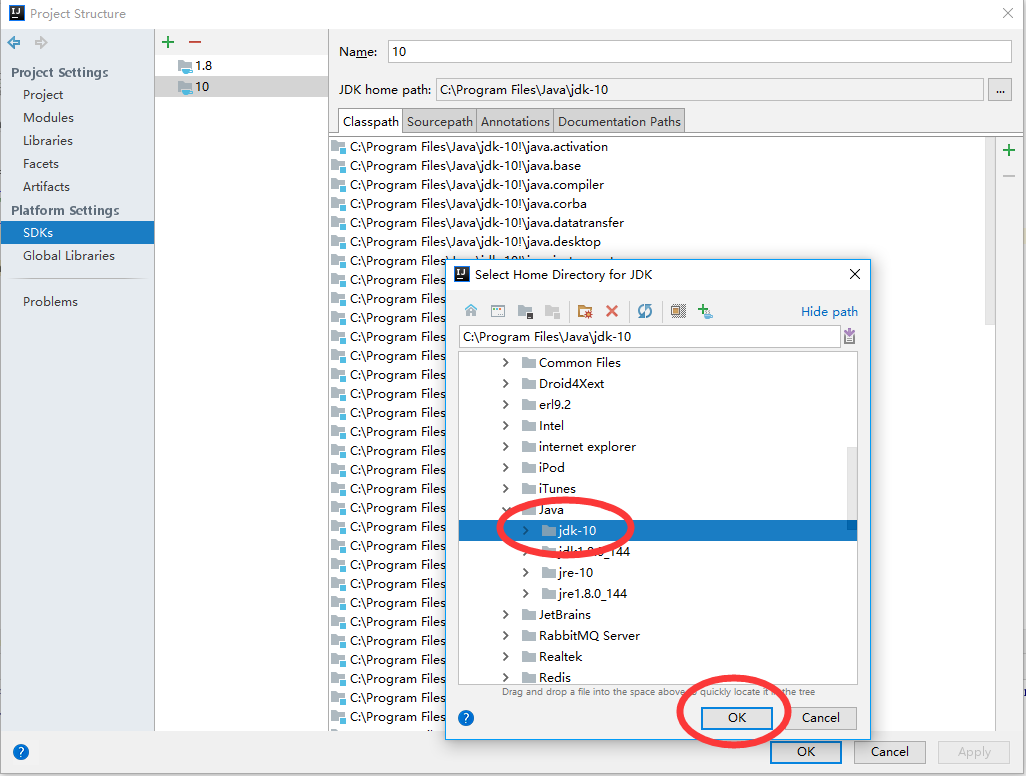
最近 IDEA 发布支持 java10的新版本。 Java10 简介: 详细版本更新特性请查看国外的一篇文章:https://www.azul.com/109-new-features-in-jdk-10/ 我在这里只简单的介绍 最热的一个特性:局部变量的类型推断 简单demo: var list = new ArrayList<String>(); // infers ArrayList<String> var stream = list.stream(); // infers Stream<String> 是不是很像js?但是我们要知道,java依旧是强类型语言,只是jvm帮助我们做了变量类型推断。 好了开始正文,java10需要最新版本的IDEA支持。否则JDK你都加不进去。 所以我们先下载最新版的idea: 最新IDEA下载地址:https://www.jetbrains.com/idea/download/#section=windows 安装好后,启动IDEA。 随便进一个项目,然后打开项目架构 快捷键 ctrl + shift + alt + s 添加SDK 给项目适配JDK10 测试 我们都听说过java10的新特性吧。最热的一个特性是 用var 来声明变量,是的,就像js一样。 那接下来直接进入让java粉迫不及待的场面。 /** * Created by Fant.J. */ public class NewJavaTest { public static void main(String[] args) { var list = new ArrayList<>(); list.add(1); list.add("fantj"); list.add(1.00); list.forEach(System.out::println); } } 控制台输出: 1 fantj 1.0 我在这里故意不给ArrayList 赋泛型,因为它默认就是Object,这样我可以给list赋任意类型的变量,给人感觉很像弱类型语言,但是我们应该清楚是因为jvm帮我们猜测了类型。 最后附上java10的官方更新文档:http://openjdk.java.net/jeps/286

优秀的个人博客,低调大师

VDI架构—Remote FX 初体验

引言 随着微软的VDI架构在企业中的实施原来越多,企业相关的需求也在随着市场的需要而在变化,声音、图像等多媒体元素在VDI中的展现,也称为了当今虚拟化所关注的主题之一。 VDI-RemoteFX概览 随着Windows 2008 R2以及Windows 7的SP1 Beta包的发布,我得以在虚拟化的VDI部署上使用新的功能来进行测试,其中尤为关注的就是最新的Remote FX的特性。 Windows 7 SP1是面向消费级用户和IT专业人员的累积更新,包含先前通过Windows Update提供的更新,以及根据客户和合作伙伴的反馈意见为Windows 7平台持续开发的增量式更新。它可以为PC提供支持,为操作系统提供持续改进,并且便于组织以单一更新集的形式进行部署。 Windows Server 2008 R2 SP1则是面向企业和IT专业人员的累积更新,包含虚拟化增强功能(动态内存和RemoteFX)、先前通过Windows Update提供的改进,并解决了客户反馈的问题。RemoteFX描述了一组富媒体功能,使用远程桌面服务平台的用户可利用它们来部署基于虚拟机或会话的远程桌面基础结构。具体而言,RemoteFX增强了远程桌面服务中的远程桌面协议(RDP),使远程办公人员可以访问任意类型的应用程序或屏幕内容,包括富媒体和3D应用程序,从而提高最终用户的工作效率。 根据微软官方的文档显示Remote FX在硬件方面有着那么几项很关键的要求,而我的测试也是因为我的CPU不满足其中的EPT技术而宣告失败。不过整个架构是能实现的,就先展示给大伙看看啦。 RemoteFX server hardware requirements There are several hardware requirements that must be met when deploying a RemoteFX server: SLAT-enabled processor – The processor in the RemoteFX server must support Second-Level Address Translation (SLAT). In virtualization scenarios, hardware-based SLAT support improves performance. On Intel-based processors, this is called Extended Page Tables (EPT), and on AMD-based processors, it is called Nested Page Tables (NPT). GPU - At least one graphics processing unit (GPU) is required on the RemoteFX server. The GPU driver must support DirectX 9.0c and DirectX 10.0. If more than one GPU is installed in the RemoteFX server, the GPUs must be identical. The GPU must have sufficient dedicated video memory that is separate from system memory. RemoteFX encoder - The RemoteFX encoder is optional and can be installed for additional scalability on the RemoteFX server. The hardware encoder card must be installed in an x4 speed PCI-express slot or greater. Hyper-V – The Hyper-V hardware requirements must be supported on the server. The Hyper-V hardware requirements for Windows Server 2008 R2 are available on the Windows Server 2008 Technical Library (http://go.microsoft.com/fwlink/?LinkID=180919). Streaming SIMD Extensions (SSE2) processor – If you are using RemoteFX on an RD Session Host server, the processor on the RD Session Host server must support SSE2. Remote FX测试架构示意 本次测试的架构图: VDI-Remote部署测试 1.部署Remote FX服务器 根据微软的原文步骤,在VDI的基础上部署Remote FX: In this step, you will do the following: lEnable RemoteFX. lConfigure the custom RDP settings. lInstall the RemoteFX 3D video adapter on the personal virtual desktop. First, you must enable RemoteFX on the RDVH-SRV computer. To enable RemoteFX 1.Log on to RDVH-SRV as CONTOSO\Administrator. 2.Open Server Manager. To open Server Manager, click Start, point to Administrative Tools, and then click Server Manager. 3.Under the Roles Summary heading, click Add Roles. 4.On the Before You Begin page of the Add Roles Wizard, click Next. 5.On the Select Server Roles page, select the Remote Desktop Services check box, and then click Next. 6.On the Introduction to Remote Desktop Services page, click Next. 7.On the Select Role Services page, select the RemoteFX check box. The Core Services check box will be automatically selected and installed when RemoteFX is installed. 8.On the Confirm Installation Selections page, verify that the RD Virtualization Host role service will be installed, and then click Install. 9.On the Installation Results page, you are prompted to restart the server to finish the installation process. Click Close, and then click Yes to restart the server. 10.After the server restarts and you log on to the computer as CONTOSO\Administrator, the remaining steps of the installation finish. When the Installation Results page appears, confirm that installation of the RD Virtualization Host role service succeeded, and then close Server Manager. 2. 配置Remote FX 接下来还有比较重要的这几步: Next, you must configure the custom RDP settings for the virtual desktop pool to always use a LAN connection speed. To configure the custom RDP settings 1.Log on to RDCB-SRV as the CONTOSO\Administrator user account. 2.Click Start, point to Administrative Tools, point to Remote Desktop Services, and then click Remote Desktop Connection Manager. 3.Expand RD Virtualization Host Servers. 4.Right-click Personal Virtual Desktops, and then click Properties. 5.Click the Custom RDP Settings tab. 6.In the Custom RDP settings box, type connection type:i:6 and then click OK. Instead of configuring the custom RDP settings, you can also give your users the option to configure their connection speed when logging on to the RD Web Access server. This is configured by editing the web.config file on the RDCB-SRV server. To show the connection speed check box 1.Log on to RDCB-SRV as the CONTOSO\Administrator user account. 2.Navigate to C:\Windows\Web\RDWeb\Pages. 3.Double-click the web.config file. 4.Under AppSettings, change the following settings to true. <add key="ShowOptimizeExperience" value="true" /> <add key="OptimizeExperienceState" value="true" /> 5.Save the file, and then close Notepad. Finally, install the 3D video adapter on the personal virtual desktop. To install the 3D video adapter 1.Shut down the PVD1-CLNT virtual desktop. 2.Open Hyper-V Manager. To open Hyper-V Manager, click Start, point to Administrative Tools, and then click Hyper-V Manager. 3.Under Virtual Machines, right-click pvd1-clnt.contoso.com, and then click Settings. 4.Click Add Hardware. 5.In the Select the devices you want to add box, click Synthetic 3D Video Adapter, and then click Add. 6.Click OK to add the 3D Video Adapter. 7.Under Virtual Machines, right-click pvd1-clnt.contoso.com, and then click Start. 8.Under Virtual Machines, right-click pvd1-clnt.contoso.com, and then click Connect. 9.Log on to the PVD1-CLNT computer as a member of the local Administrators group. 10.The RemoteFX 3D Video Adapter driver will install. When you dialog box asking you to restart the computer appears, Restart Now. 就这样,可以在VDI的架构前提下安装成功Remote FX,可是由于我的CPU不支持Intel的EPT技术,所以没有办法开启虚拟机展示给大家,听说只有i7的全系列以及至强的X5500以上的CPU才支持此技术,也不知道是真是假。 相关报错的截图如下: 微软的问题解答描述也是如我所料,是因为CPU不支持EPT技术所导致的,如下: Q:An error occurred while attempting to start the selected virtual machine(s): Failed to Power on with Error ‘Unspecified error’ A:It is likely that you are attempting to start RemoteFX virtual machines on a server that does not have a SLAT-enabled processor. PS:SLAT-enabled processor – The processor in the RemoteFX server must support Second-Level Address Translation (SLAT). In virtualization scenarios, hardware-based SLAT support improves performance. On Intel-based processors, this is called Extended Page Tables (EPT), and on AMD-based processors, it is called Nested Page Tables (NPT). 若在将来在VDI架构中彻底的都部署了Remote FX,那么很多企业的Call Center或者是研发、设计的部门,都可以顺利地运行在Hyper-V上了,而无需借助WYSE或者思杰等第三方来完成声音、视频的高性能双向传输啦,这是节省成本的有效途径,也是一大创举啊!我们都将拭目以待!! 本文转自xury 51CTO博客,原文链接:http://blog.51cto.com/xury007/351497,如需转载请自行联系原作者

优秀的个人博客,低调大师

Windows Phone 8 开发初体验

Windows Phone 8 是当前除了Android、IPhone之外,第3大智能手机运行平台。作为微软技术的忠实fans,一直关注和跟进微软技术的最新进展。这里就给大家简单介绍一下,如何进行Windows Phone 8 的开发。 开发Windows Phone 8应用或者游戏,首先得搭建开发环境。 操作系统必须为64位Windows 8或以上,开发工具VS版本为VS2012或以上。这里的VS推荐安装VS2012 Ultimate版本,http://www.microsoft.com/zh-cn/download/details.aspx?id=30678。当然你也可以安装VS2013,对应操作系统Windows 8.1。 安装好VS2012 Ultimate之后,我们找到Windows平台安装程序,如果本机没有找到,也可以从这里下载安装:http://www.microsoft.com/web/downloads/。 安装好Windows平台安装程序之后我们运行它,显示如下界面。 我们在产品—工具里面选择Windows Phone SDK 8.0进行安装。当然这里面有很多其它的工具,感兴趣的可以自行添加。 安装好之后我们打开VS2012。 选择Windows Phone,可以看到里面已经安装好了各种类型的项目选项。 好的, 赶紧体验一下Windows Phone 8开发吧。我们选择Windows Phone应用程序,点击确定。VS会自动为我们创建一个可运行的默认的Windows Phone 8应用程序。 可以看到项目的结构。这不就是我们所熟悉的WPF项目的风格吗?是的,Windows Phone 8 也是采用XAML语言进行页面的布局配合C#等后台语言进行编程。如果有过WPF或者SilverLight开发经验的程序员能够很平滑的过渡到Windows Phone 8开发。因此WPF(桌面)—SilverLight(浏览器)—Windows Phone 8(智能手机),一下子掌握3门技术,而且从桌面到浏览器到智能手机,3大平台的技术都掌握了,是不是很有成就感?呵呵。 好了,创建好的默认的项目我们直接运行,即可运行手机模拟器。吐槽一下,这个Windows Phone 8 模拟器运行可比Android等运行快多了,而且感觉很流畅。 呵呵,这不是我们所熟悉的Metro风格吗?和Windows 8 一样吧?可以理解为Windows 8 的移动版,呵呵。 下面我们赶紧准备一个例子吧? 这个例子,我选择微软官方的例子来演示。源码地址为:http://code.msdn.microsoft.com/wpapps/Local-Database-Sample-57b1614c。可以自行下载,有C#和VB两种语言的版本。 这是一个本地数据库操作的例子,我们用VS2012打开这个项目。 看到了吗?设计器默认为我们进行了分栏,左侧是显示效果,右侧是代码区域。 好,我们运行这个程序。 如果你要安装到真机,可以找到这个项目Bin\Debug目录下的Xap文件(类似于Android的Apk以及IPhone的Ipa),拷贝到你的真机上或者放到微软的云盘SkyDriver上下载安装即可。 这就是这个例子所带给我们的。还有很多小例子可以从官方网站下载,感兴趣的读者赶紧动手试一试激动人心的Windows Phone 8 开发吧。 本文转自 guwei4037 51CTO博客,原文链接:http://blog.51cto.com/csharper/1356949

优秀的个人博客,低调大师

CloudDBA初体验:SQL优化建议

数据库诊断和优化过程具有相当的复杂性,通常需要专业的DBA来解决。但在云计算的今天,人力运维和支撑已经变得不可能,自动化,智能化运维和服务支持日益迫切。 阿里云数据库团队在这方面不断的探索和积累,产出了CloudDBA。其目的就是要把我们已知问题和最佳实践能够以最简单的方式告诉用户,把我们多年使用数据库的经验传承给用户,方便客户使用云上数据库,给客户带来直接的价值。CloudDBA同时也在服务着内部业务,4000+的数据库实例之前需要一个team的运维人员,到现在我们只有一个同学,运维效率大幅提升。 CloudDBA一期给客户输出的功能包含数10项,迫不及待先给大家介绍SQL优化建议功能。 SQL优化方法 SQL对技术人员来说再熟悉不过,但开发人员和数据库人员对其却有不同的理解。比如开发人员看到的如下SQL语句, 在数据库中却是另外一种视图: CloudDBA的优化功能就帮助数据库寻找最佳执行路径,将其优化成更为简洁和高效的视图: 示例1 SQL条件下推是多数开发人员忽视的问题,详细介绍及解法说明参见MySQL · 性能优化 · 条件下推到物化表 以及 MySQL · 性能优化 · MySQL常见SQL错误用法。 该例子中的SQL在开发人员工作中经常出现: 聚合子查询其实是先定义的一个视图,之后用的时候再加条件出结果(SQL看起来简洁^^); 条件是拼接出来的,或许还出了bug,匹配符号位置放错了; 这样的写法性能肯定是好不了的。 有了CloudDBA后,开发人员会得到直接的提示: 根据提示,创建索引,重写SQL性能大幅提升: 示例2 再贴一个复杂点SQL语句。继续体验一下CloudDBA的自动化建议: CloudDBA是数据库自动化运维的一个分水岭。我们会不断努力,致力于阿里云数据库用户体验的提升!CloudDBA等待你的加入,实现更多闪耀的功能 。

优秀的个人博客,低调大师

Macaca初体验-Android端(Python)

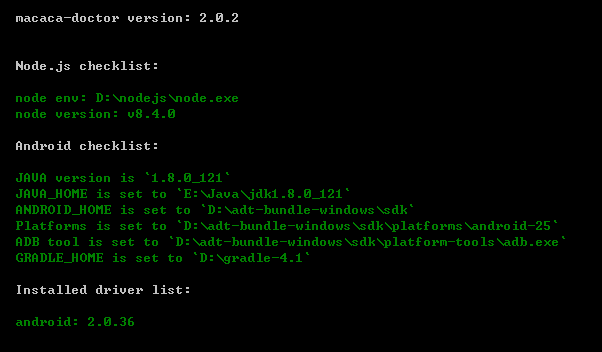
前言: Macaca 是一套面向用户端软件的测试解决方案,提供了自动化驱动,周边工具,集成方案。由阿里巴巴公司开源:http://macacajs.github.io/macaca/ 特点: 同时支持PC端和移动端(Android、iOS)自动化测试。 支持JavaScript(Node.js)、Java、Python。 周边工具:支持用例录制的UI Recorder。 本次教程将介绍如何使用Macaca进行Android端自动化测试。使用编程语言为Python3.5(Macaca只支持Python3.4以上版本) 环境安装: 1、Macaca环境+Android SDK环境+Java环境+Node环境见:Android环境配置 2、通过macaca doctor可以检查环境是否配置成功,如下图所示则表示环境均配置正常,如果有标红提示,则需要对应处理。 >>macaca doctor 3、安装Macaca Python Client,支持pip安装。 >>python3 -m pip install wd 用例编写: 项目目录F:\workspace\macaca-android\macaca-test下创建测试用例:macaca-android-sample.test.py,其中macaca-test为测试目录集。 https://github.com/macaca-sample/sample-python/blob/master/tests/macaca-android-sample.test.py 代码如下: API详解: driver.init() 初始化 driver.quit() 退出 driver.back() 返回上一步 driver.element_by_id 根据id来查找元素 driver.element_by_name 跟据name来查找元素 driver.elements_by_class_name 跟据class_name来查找元素 driver.accept_alert() alert弹框确认 driver.touch('tap', {'x':100,'y':100}) 在设备上应用触摸操作,例如:tap/doubleTap/press/pinch/rotate/drag ,操作后面填写对应坐标x,y值 driver.save_screenshot 保存截图 备注:与appium的API极为相似,熟悉appium的同学可以快速上手,定位元素的方法一致。 详细API见官网:https://macacajs.github.io/wd.py/api.html 执行用例: 1、启动macaca服务: >>macaca server --verbose //加--verbose可以看到详细的执行过程 2、执行用例: >>python3 macaca_test\macaca-android-sample.test.py 以上 作者:搁浅 出处: http://www.cnblogs.com/xiaoxi-3-/ 如果对您有帮助,请关注我的同名简书:https://www.jianshu.com/u/da1677475c27 本文版权归作者和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文连接,否则保留追究法律责任的权利。

优秀的个人博客,低调大师

安装运行Appium初体验

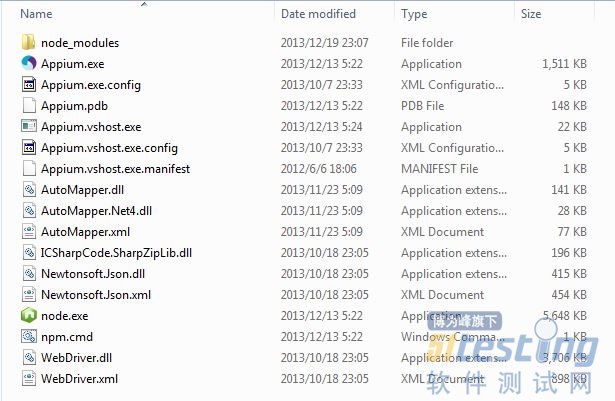
最近有空玩了一下 Appium,记录一下 1.下载Appium for windows,现在是0.12.3版本 解压后如下图 双击Appium.exe就能启动Appium界面 点击Launch开启服务 2. 下载AndroidSDK 解压后 3. 配置系统环境变量 ANDROID_HOME: C:\adt-bundle-windows-x86_64-20131030\sdk Path添加: %ANDROID_HOME%\tools;%ANDROID_HOME%\platform-tools 4. 启动AVD,耗资源啊,这时候我T400的CPU已经100%了 5. 编写Test,使用ADT安装好Maven插件,创建一个Maven项目,添加一个文件夹apps用来存放被测的app,这里测试的是ContactManager.apk pom.xml添加如下依赖 1 <dependencies> 2 <dependency> 3 <groupId>junit</groupId> 4 <artifactId>junit</artifactId> 5 <version>4.11</version> 6 <scope>test</scope> 7 </dependency> 8 <dependency> 9 <groupId>org.seleniumhq.selenium</groupId> 10 <artifactId>selenium-java</artifactId> 11 <version>LATEST</version> 12 <scope>test</scope> 13 </dependency> 14 </dependencies> 编写AndroidContactsTest 1 package com.guowen.appiumdemo; 2 3 import org.junit.After; 4 import org.junit.Before; 5 import org.junit.Test; 6 import org.openqa.selenium.*; 7 import org.openqa.selenium.interactions.HasTouchScreen; 8 import org.openqa.selenium.interactions.TouchScreen; 9 import org.openqa.selenium.remote.CapabilityType; 10 import org.openqa.selenium.remote.DesiredCapabilities; 11 import org.openqa.selenium.remote.RemoteTouchScreen; 12 import org.openqa.selenium.remote.RemoteWebDriver; 13 import java.io.File; 14 import java.net.URL; 15 import java.util.List; 16 17 public class AndroidContactsTest { 18 private WebDriver driver; 19 20 @Before 21 public void setUp() throws Exception { 22 // set up appium 23 File classpathRoot = new File(System.getProperty("user.dir")); 24 File appDir = new File(classpathRoot, "apps/ContactManager"); 25 File app = new File(appDir, "ContactManager.apk"); 26 DesiredCapabilities capabilities = new DesiredCapabilities(); 27 capabilities.setCapability("device","Android"); 28 capabilities.setCapability(CapabilityType.BROWSER_NAME, ""); 29 capabilities.setCapability(CapabilityType.VERSION, "4.4"); 30 capabilities.setCapability(CapabilityType.PLATFORM, "WINDOWS"); 31 capabilities.setCapability("app", app.getAbsolutePath()); 32 capabilities.setCapability("app-package", "com.example.android.contactmanager"); 33 capabilities.setCapability("app-activity", ".ContactManager"); 34 driver = new SwipeableWebDriver(new URL("http://127.0.0.1:4723/wd/hub"), capabilities); 35 } 36 37 @After 38 public void tearDown() throws Exception { 39 driver.quit(); 40 } 41 42 @Test 43 public void addContact(){ 44 WebElement el = driver.findElement(By.name("Add Contact")); 45 el.click(); 46 List<WebElement> textFieldsList = driver.findElements(By.tagName("textfield")); 47 textFieldsList.get(0).sendKeys("Some Name"); 48 textFieldsList.get(2).sendKeys("Some@example.com"); 49 driver.findElement(By.name("Save")).click(); 50 } 51 52 public class SwipeableWebDriver extends RemoteWebDriver implements HasTouchScreen { 53 private RemoteTouchScreen touch; 54 55 public SwipeableWebDriver(URL remoteAddress, Capabilities desiredCapabilities) { 56 super(remoteAddress, desiredCapabilities); 57 touch = new RemoteTouchScreen(getExecuteMethod()); 58 } 59 60 public TouchScreen getTouch() { 61 return touch; 62 } 63 } 64 } 6. 运行Test,注意AVD里的Android如果没有解锁需要先解锁 这时候我们可以看到AVD在运行了, 同时Appium的命令行有对应的输出 7. 更多信息请参考Appium的Github 最新内容请见作者的GitHub页:http://qaseven.github.io/

资源下载

更多资源
Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册