首页 文章 精选 留言 我的

精选列表

搜索[boot],共8307篇文章
优秀的个人博客,低调大师

《Spring Boot + JPA 实战》第6招 方法名查询边界

上周我在评审一个订单查询接口,PR 里躺着一行方法名: `List findByCustomerIdAndStatusAndCreatedAtBetweenAndOrderNoContainingOrderByCreatedAtDesc(Long customerId, OrderStatus status, LocalDateTime start, LocalDateTime end, String orderNo);` 我是老李,看到这行代码的时候,脑子里先想的不是业务,而是这个方法的拼写到底有没有错。更要命的是,这还只是开始。 现在为什么讲这个?因为太多团队把 Spring Data JPA 的 Derived Query 当成了唯一查询手段。早期确实爽,方法名越长、条件越动态,后面维护成本就越高。 ## 01、痛点 上面这行方法名不是段子。它对应的是订单中心一个很常见的查询:根据客户、状态、创建时间区间、订单号模糊搜索,再按创建时间倒序。需求本身不复杂,但被 Derived Query 一路带飞后,代码看起来像在玩拼字游戏。 这类查询有三个典型痛点。第一,方法名失控。只要加一个条件,方法名就多一截。开发一开始觉得省事,三个月后自己都不敢确认 `Between` 后面到底接了几个参数。第二,动态条件无法表达。真实业务里,客户号可能为空,状态可能为空,创建时间可能只传开始或者只传结束。Derived Query 没法优雅地跳过 null,只能写一堆组合方法,2 个条件 4 个方法,3 个条件 8 个,4 个条件 16 个,指数级爆炸。第三,修改成本高。字段一旦改名,所有相关方法名都要重写;条件组合有变化,方法签名也要变;接口一旦发布,这些长名字还会渗透到调用方和测试用例里。 更难受的是,这类代码往往出现在核心 Repository 里,和业务强绑定。它既不是标准 SQL,也不是清晰的业务语言,时间一久,新同事会把它当成模板继续复制,于是 Repository 里堆满了一百多个长得差不多的方法。 ## 02、是什么 Spring Data JPA 的 Derived Query 不是魔法。它是在 Repository 接口方法名上定义查询规则,框架启动时解析方法名,自动生成对应查询。本质是一种声明式查询 DSL。 常用前缀有:`findBy`、`readBy`、`queryBy`、`getBy` 用于查询;`existsBy` 判断存在;`countBy` 计数;`deleteBy`、`removeBy` 删除。条件关键字包括:`And`、`Or`、`Between`、`In`、`NotIn`、`Containing`、`StartingWith`、`EndingWith`、`IgnoreCase`、`OrderBy` 等。属性名直接拼接,比如 `findByCustomerId` 就是根据 `customerId` 查询。 举几个最基础的例子: ```java Optional findByOrderNo(String orderNo); List findByCustomerIdOrderByCreatedAtDesc(Long customerId); List findByStatusAndCreatedAtBetween(OrderStatus status, LocalDateTime start, LocalDateTime end); boolean existsByOrderNo(String orderNo); long countByStatus(OrderStatus status); ``` 这些方法没有额外注解,没有 XML,甚至没有 SQL。只要属性名和关键字对得上,Spring Data 就能在启动时自动校验,查错早。 Derived Query 的能力边界也很清晰。它适合单表查询、简单条件、固定组合。一旦涉及多表关联、聚合统计、子查询、复杂排序,它很难表达;即便能拼出来,方法名也会变得极不友好。 ## 03、为什么 Derived Query 之所以受欢迎,是因为它把查询成本压得很低。新建方法只写一行,不用写 JPQL,不用注入 EntityManager,不用维护 SQL 文件;实体属性变了,方法名会在启动时报错,而不是等到线上 SQL 执行失败。对于稳定、明确的小查询,它的开发效率确实高。 但它有两个容易被忽视的代价。 第一,方法名就是接口契约。方法名越长,契约越脆弱。你以为只是内部实现,实际上它暴露了字段、条件、顺序,甚至排序方向。一旦条件增多,调用方需要理解的信息量直线上升。 第二,它不处理动态性。Derived Query 的每个条件都是必填的。如果客户号可空、状态可空、时间区间可空,你就没法用 null 来表示“忽略这个条件”。框架不会帮你跳过 null,于是只能靠组合方法覆盖所有情况。 为什么现在尤其要讲?因为订单、用户、商品这类核心业务,查询条件天然是动态的。后端接口往往要在同一个搜索框里兼容各种筛选,前端可能只传一个关键字,也可能传五个筛选条件。这种情况下,继续堆 Derived Query 已经不是效率问题,而是设计问题。 ## 04、架构 从分层上看,Repository 是持久化层的入口,Service 负责业务编排,Controller 负责协议转换。查询规则应该被限制在 Repository 内部,不让它污染业务层。 ``` Controller -> Service -> Repository -> Entity ``` 查询 DSL 可以按复杂度分层: - 简单、稳定、明确:Derived Query - 固定但复杂:JPQL - 动态组合:Specification / QueryDSL - 报表、聚合、原生能力:Native SQL 这里的核心不是选哪个技术,而是给团队建立一条清晰边界:什么样的查询写在方法名里,什么样的查询必须升级。 Repository 的职责是表达业务查询意图,而不是翻译 SQL。一个方法名应该能读成一句业务问题,比如“根据订单号查订单”“根据客户和时间查订单列表”。如果方法名读出来像 SQL 拼接,就说明放错了层。 另外,Projection 也属于查询架构的一部分。当接口只需要订单号、状态、创建时间三个字段时,不应该把整个 Order 实体查出来。用接口投影或者类投影只取需要的字段,既减少 IO,也让接口边界更清晰。 ## 05、实战 以订单查询为例,假设 Order 实体如下: ```java @Entity public class Order { @Id private Long id; private String orderNo; private Long customerId; private OrderStatus status; private LocalDateTime createdAt; // getter / setter } ``` 基础查询可以这样写: ```java public interface OrderRepository extends JpaRepository { Optional findByOrderNo(String orderNo); List findByCustomerIdOrderByCreatedAtDesc(Long customerId); List findByStatusAndCreatedAtBetween(OrderStatus status, LocalDateTime start, LocalDateTime end); List findByCustomerIdAndStatusAndCreatedAtBetweenOrderByCreatedAtDesc( Long customerId, OrderStatus status, LocalDateTime start, LocalDateTime end); boolean existsByOrderNo(String orderNo); long countByStatus(OrderStatus status); void deleteByCustomerId(Long customerId); } ``` 这三个字段组合起来还可以接受,但现实中往往还要加上订单号模糊搜索、金额区间、是否加急等条件。方法名会迅速变成: ```java List findByCustomerIdAndStatusAndCreatedAtBetweenAndOrderNoContainingOrderByCreatedAtDesc( Long customerId, OrderStatus status, LocalDateTime start, LocalDateTime end, String orderNo); ``` 到这里已经超过 80 个字符,可读性很差。更要命的是,这个查询的四个条件通常是可选的:可能只传 customerId,可能只传 orderNo,可能只传 status 和时间。用 Derived Query 只能写一堆组合,或者写一个超长方法然后拼 null,但框架不会自动忽略 null。 这时候应该升级到 Specification。 ```java public interface OrderRepository extends JpaRepository, JpaSpecificationExecutor { } ``` ```java Specification spec = (root, query, cb) -> { List predicates = new ArrayList<>(); if (customerId != null) { predicates.add(cb.equal(root.get("customerId"), customerId)); } if (status != null) { predicates.add(cb.equal(root.get("status"), status)); } if (start != null && end != null) { predicates.add(cb.between(root.get("createdAt"), start, end)); } if (orderNo != null && !orderNo.isBlank()) { predicates.add(cb.like(root.get("orderNo"), "%" + orderNo + "%")); } return cb.and(predicates.toArray(new Predicate[0])); }; Page page = orderRepository.findAll(spec, PageRequest.of(0, 20, Sort.by(Sort.Direction.DESC, "createdAt"))); ``` 如果查询固定但复杂,也可以用 JPQL: ```java @Query("select o from Order o where o.customerId = :customerId and o.status = :status and o.createdAt between :start and :end order by o.createdAt desc") Page search(@Param("customerId") Long customerId, @Param("status") OrderStatus status, @Param("start") LocalDateTime start, @Param("end") LocalDateTime end, Pageable pageable); ``` 如果只返回少量字段,建议使用 Projection: ```java public interface OrderSummary { String getOrderNo(); OrderStatus getStatus(); LocalDateTime getCreatedAt(); } List findByCustomerIdOrderByCreatedAtDesc(Long customerId); ``` 这样,订单号、状态、创建时间的查询就有了三条路径:简单且固定用方法名,动态组合用 Specification,固定复杂或统计用 JPQL。 ## 06、洞见 Derived Query 的最佳位置是简单、稳定、明确的查询。它像一把快刀,适合切豆腐,不适合剁骨头。 一旦出现以下信号,就不该继续堆方法名: - 方法名超过 35 到 40 个字符,读起来已经需要换气; - 参数超过 3 个,且未来还可能增加; - 任意条件可空,需要动态组合; - 涉及多表关联、聚合、子查询; - 返回字段与实体差异很大。 这些信号的本质是:查询复杂度已经超过声明式方法名的表达能力。继续硬写,不只是长,而是把查询逻辑散布在方法名、参数顺序、关键字组合里,变得不可测试、不可复用。 真正稳定的查询,往往业务语义非常清晰,比如“根据订单号查订单”“根据客户查订单列表”。这种查询几年都不变,写在方法名里效率最高。而“按条件搜索订单”本身就是动态需求,应该用 Specification 之类的工具去表达。 我的判断很简单:方法名是业务语言,不是 SQL 的拼音。能读出业务问题,就留在方法名;读出来像筛选器拼接,就升级。 ## 07、行动 我给自己和团队定了一条 Query Complexity Rule,包含六个停止点。 | 场景 | 决策 | |------|------| | 条件数 ≤2,且全部必填 | 使用 Derived Query | | 条件数 3~4,且稳定明确 | 可以继续用,但方法名必须读得通 | | 条件数 >4,或任一条件可选 | 升级 Specification | | 多表关联、统计、报表 | 使用 JPQL 或原生 SQL | | 只返回部分字段 | 使用 Projection | | 方法名超过 40 个字符 | 停止,重构为 JPQL 或 Specification | 具体到订单查询: - `findByOrderNo` 继续用 Derived Query; - `findByCustomerIdAndStatusAndCreatedAtBetweenOrderByCreatedAtDesc` 虽然长,但条件是固定的,可以保留; - 一旦加上 orderNo 模糊搜索,或让条件可空,就改为 Specification; - 统计每日订单量、按状态汇总金额,直接用 JPQL; - 列表页只展示订单号、状态、创建时间,定义 OrderSummary 投影。 这套规则不难,关键是执行。代码评审时看到超长方法名,应该直接打回;新需求进来,先问条件是固定还是动态,再决定写在哪个层。 如果你现在正在维护一个方法名已经失控的 Repository,不需要一次性重写。新建查询时遵守规则,老查询在修改时顺手重构,慢慢就能把边界拉回来。 ## 08、小结 Derived Query 是 Spring Data JPA 中非常高效的能力,但它不是唯一的查询手段。简单、稳定、明确的查询用它没问题;当方法名越来越长、条件越来越动态时,失控的不是框架,而是我们的边界意识。 给自己立一条 Query Complexity Rule,比记住所有方法名规则更重要。知道什么时候继续写方法名,什么时候升级到 JPQL、Specification 或 Projection,才能让订单查询既好写,又好维护。 ## 09、链接与概念说明 概念说明: - Derived Query:通过解析 Repository 方法名生成查询的机制,适合单表单条件或固定组合。 - JPQL:面向实体的查询语言,类似 SQL 但操作的是实体和属性,适合固定但复杂的查询。 - Specification:JPA Criteria API 的动态查询封装,适合条件可选、组合多变的查询。 - Projection:只查询实体部分字段的机制,可以用接口或类接收结果,适合列表页和读多写少场景。 - QueryDSL:类型安全的动态查询框架,可以作为 Specification 的替代方案。 参考链接: - Spring Data JPA 官方文档:派生查询与关键字列表 - JPA 2.2 Specification 文档 - Baeldung 的 Spring Data JPA Derived Query 教程 - Thorben Janssen 的 JPA 性能与查询建议

优秀的个人博客,低调大师

《Spring Boot + JPA 实战》第12招 动态查询怎么写

最近一个做交易系统的同事找过来,说订单后台的筛选条件已经从最早的 4 个加到了 11 个。运营今天要按租户和状态查,明天要按金额区间和支付方式查,后天又要按关键字、渠道和是否开票查。开发一开始还很勤快,每来一个组合就写一个 Repository 方法,后来方法名越来越长: ```java List findByTenantIdAndStatusAndCustomerNameContainingAndCreatedAtBetween(...); ``` 再后来,连自己都分不清该调哪个方法。我是老李,今天把 Spring Data JPA 里处理动态筛选的 Specification 思路完整拆一遍。 ## 01、痛点 企业后台的订单查询通常有这些条件:tenant、status、customer、amount、time、keyword,还有 channel、payType、invoiced 等。它们不是固定出现,而是自由组合。理论上,10 个布尔条件能产生 1024 种组合,不可能为每种组合建立 Repository 方法。 常见的错误做法有两种:一是继续在 Service 里写大量 if-else 拼接 JPQL 字符串,条件多了以后括号、空字符串、like 特殊字符、时间边界、null 判断都非常容易出错。二是为高频组合新增专用查询方法,导致方法数量膨胀,语义混乱,后面维护的人根本不敢改。 这带来的不只是代码丑,而是测试覆盖难、SQL 问题延迟到线上、每次新增条件都牵一发动全身。我们需要一种可组合、可复用、可测试的查询抽象,这正是 Specification 的用武之地。 ## 02、是什么 Specification 是 Spring Data JPA 提供的一个接口,用来把 JPA Criteria API 的查询条件封装成一个可组合对象。核心方法只有一个: ```java Predicate toPredicate(Root root, CriteriaQuery query, CriteriaBuilder cb); ``` 三个参数各司其职: - Root:当前查询的实体根,可以把它理解成实体在查询里的别名,通过 `root.get("字段名")` 拿路径。 - CriteriaQuery:整体查询结构,动态筛选里一般不需要动它。 - CriteriaBuilder:构造谓词的工具,提供 equal、like、greaterThan、lessThan、between、and、or、in 等方法。 Predicate 就是一个个条件表达式,比如“状态等于已支付”“金额在 100 到 500 之间”。多个 Predicate 用 `cb.and(...)`、`cb.or(...)` 组合。 Repository 只要继承 `JpaSpecificationExecutor`,就能获得 `findAll(Specification, Pageable)`、`findAll(Specification, Sort)` 等方法。这样,DAO 层不再为动态条件写一堆方法,而是接收一个 Specification 对象,由它描述筛选规则。 Spring Data JPA 4.x 里更强调 PredicateSpecification 这种链式组合思路:每个筛选条件是一个独立的规格,空条件返回 null 表示不加谓词,非空条件返回 Predicate;然后用 `Specification.where(...).and(...).or(...)` 串联。相比自己 new Specification 匿名类,链式写法更贴近业务规则,也更方便测试。 ## 03、为什么 为什么推荐用 Specification 处理这类问题,而不是继续堆 Repository 方法? 第一,动态筛选本质是规则集合。租户、状态、时间范围这些条件不是固定的查询签名,而是可选的过滤规则。把每个规则封装成 Specification,符合业务的自然表达。 第二,关注点分离。Repository 只关心“执行查询”,Service 只关心“从请求参数生成筛选条件”,Specification 只关心“构造谓词”。三层各干各的,不会出现 Service 里拼 SQL 字符串的坏味道。 第三,条件可复用。租户隔离、状态过滤、时间范围过滤不仅订单模块会用,售后单、结算单也可能需要类似规则。独立成方法后,可以复用到不同查询场景。 第四,组合测试更容易。单个 Specification 可以单独验证;组合后的 Builder 可以用参数化测试覆盖空条件、单条件、多条件、边界值等主要路径。相比之下,如果逻辑藏在 Repository 方法名或 JPQL 拼串里,测试成本会高很多。 第五,和分页排序天然兼容。后台列表几乎都需要分页,`findAll(spec, pageable)` 直接支持 `PageRequest.of(page, size, Sort.by(...))`,不需要额外封装。 当然,Specification 也不是万能钥匙,这一点放到第 06 节展开。 ## 04、架构 先给出推荐的分层结构: ``` Controller ↓ 接收 Query 参数并转成 SearchCriteria Service ↓ 调用 Builder 生成 Specification Repository ↓ 执行 findAll(spec, pageable) Database ``` 关键点是:不要让 HttpServletRequest 或 Controller 的 Query 对象直接穿透到数据层。应该用一个独立 SearchCriteria 接收筛选意图,这样后续条件来源从 HTTP 请求变成 RPC 消息、导出任务、定时任务时,查询逻辑不用改。 订单 SearchCriteria 可以这样设计: ```java public class OrderSearchCriteria { private Long tenantId; private OrderStatus status; private Long customerId; private String keyword; private BigDecimal minAmount; private BigDecimal maxAmount; private LocalDateTime startTime; private LocalDateTime endTime; private String channel; private String payType; private Boolean invoiced; // 省略 getter/setter 或使用 builder } ``` 这里一共有 11 个条件,去掉 min/max amount 合并、start/end time 合并,最终会落地成 9 个左右独立 Specification,完全满足 8~10 个条件自由组合的需求。 Builder 的职责是:根据 SearchCriteria 里哪些字段非空,决定启用哪些 Specification。Builder 内部一般不写复杂条件逻辑,只做非空判断和链式组合。这样每个条件规则保持单一职责,后续新增条件只是新增一个方法和一行 and。 需要注意,单实体动态筛选可以放心用 Specification;一旦涉及复杂多表 Join、聚合报表,就应该重新评估,不要让 Builder 变成垃圾桶。 ## 05、实战 下面以订单实体为例,展示具体实现。订单实体包含这些字段:id、tenantId、orderNo、status、customerId、customerName、amount、channel、payType、invoiced、createdAt、remark。 首先,Repository 继承 JpaSpecificationExecutor: ```java public interface OrderRepository extends JpaRepository, JpaSpecificationExecutor { } ``` 然后,把每个条件写成独立 Specification 工厂方法: ```java public final class OrderSpecifications { public static Specification tenantEq(Long tenantId) { return (root, query, cb) -> tenantId == null ? null : cb.equal(root.get("tenantId"), tenantId); } public static Specification statusEq(OrderStatus status) { return (root, query, cb) -> status == null ? null : cb.equal(root.get("status"), status); } public static Specification customerEq(Long customerId) { return (root, query, cb) -> customerId == null ? null : cb.equal(root.get("customerId"), customerId); } public static Specification keywordLike(String keyword) { return (root, query, cb) -> { if (!StringUtils.hasText(keyword)) { return null; } String pattern = "%" + keyword.trim().toLowerCase() + "%"; return cb.or( cb.like(cb.lower(root.get("orderNo")), pattern), cb.like(cb.lower(root.get("customerName")), pattern), cb.like(cb.lower(root.get("remark")), pattern) ); }; } public static Specification amountBetween(BigDecimal min, BigDecimal max) { return (root, query, cb) -> { if (min == null && max == null) { return null; } if (min != null && max != null) { return cb.between(root.get("amount"), min, max); } if (min != null) { return cb.greaterThanOrEqualTo(root.get("amount"), min); } return cb.lessThanOrEqualTo(root.get("amount"), max); }; } public static Specification createdBetween(LocalDateTime start, LocalDateTime end) { return (root, query, cb) -> { if (start == null && end == null) { return null; } if (start != null && end != null) { return cb.between(root.get("createdAt"), start, end); } if (start != null) { return cb.greaterThanOrEqualTo(root.get("createdAt"), start); } return cb.lessThanOrEqualTo(root.get("createdAt"), end); }; } // channelEq、payTypeEq、invoicedEq 与 tenantEq 类似,都是简单等值判断,这里不再重复。 } ``` 这里每个方法都遵循同一条约定:条件无效时返回 null,条件有效时返回 Predicate。返回 null 会让 Spring Data 在组合时忽略这个条件。这样处理比在 Builder 里写一堆 if 更内聚。 接下来是 Builder: ```java public final class OrderSpecificationBuilder { public static Specification from(OrderSearchCriteria c) { return Specification .where(OrderSpecifications.tenantEq(c.getTenantId())) .and(OrderSpecifications.statusEq(c.getStatus())) .and(OrderSpecifications.customerEq(c.getCustomerId())) .and(OrderSpecifications.keywordLike(c.getKeyword())) .and(OrderSpecifications.amountBetween(c.getMinAmount(), c.getMaxAmount())) .and(OrderSpecifications.createdBetween(c.getStartTime(), c.getEndTime())) .and(OrderSpecifications.channelEq(c.getChannel())) .and(OrderSpecifications.payTypeEq(c.getPayType())) .and(OrderSpecifications.invoicedEq(c.getInvoiced())); } } ``` Service 层变得很薄: ```java @Service public class OrderQueryService { private final OrderRepository orderRepository; public OrderQueryService(OrderRepository orderRepository) { this.orderRepository = orderRepository; } public Page search(OrderSearchCriteria criteria, Pageable pageable) { Specification spec = OrderSpecificationBuilder.from(criteria); return orderRepository.findAll(spec, pageable); } } ``` 测试不能只写一两个 happy path,建议用参数化测试覆盖主要组合。比如: ```java @ParameterizedTest @MethodSource("orderQueryCases") void shouldBuildSpecificationFromCriteria(OrderSearchCriteria criteria, long expectedCount) { Specification spec = OrderSpecificationBuilder.from(criteria); long count = orderRepository.count(spec); assertEquals(expectedCount, count); } ``` 测试数据设计要覆盖:全空条件、单租户、单状态、金额区间、时间区间、关键字模糊匹配、租户加状态加金额三条件组合、只有 maxAmount 没有 minAmount、只有 startTime 没有 endTime、非法关键字无结果等。参数化测试的好处是,新增条件后只需补充一条 case,不用重写整套测试。 ## 06、洞见 Specification 最擅长的是动态筛选,不是所有复杂查询的终极方案。 如果需求是列表页的“按条件筛订单”,单实体或少量简单 Join,用 Specification 合适。但如果需求是“生成一张多表关联的月度经营报表”,包含多个 group by、聚合函数、子查询、union、窗口函数,那么 Specification 和 Criteria API 会变得非常啰嗦,写出来的代码可读性差,维护成本高。 尤其是把大量 Join 放进 Specification 后,有两个常见坑:第一,一对多 Join 会导致结果集膨胀,分页时出现重复行,需要 distinct 或重新设计查询口径;第二,fetch join 用于解决 N+1 的写法,和分页一起使用时容易触发内存分页或条数错误,需要额外处理。 因此,我的判断标准很简单:如果查询主要是“过滤条件自由组合”,用 Specification;如果查询核心已经是“多表聚合、报表统计、复杂关系图”,就改成原生 SQL、专用报表模型或数仓方案。不要为了技术统一而把 Specification 当成唯一的查询入口。真正成熟的架构,是让动态筛选归动态筛选,复杂报表归复杂报表。 ## 07、行动 如果今天就开始改订单高级查询,建议按下面顺序落地。 第一,建立 OrderSearchCriteria。先别碰 Repository,把 Controller 传入的条件收口到一个对象里,字段只保留筛选相关数据,不包含请求上下文。 第二,把 status、tenant、timeRange 等做成独立 Specification。每个方法只做一件事:无效返回 null,有效返回 Predicate。文件可以叫 OrderSpecifications,逐步替换 Service 里的 if-else 拼查询逻辑。 第三,建立 OrderSpecificationBuilder。用 `Specification.where(...).and(...)` 链式组合,Builder 只做条件非空判断和顺序组合,不写具体谓词。 第四,Repository 继承 JpaSpecificationExecutor。保留必要的简单 JPA 方法,但动态筛选统一走 `findAll(spec, pageable)`。 第五,用参数化测试覆盖主要组合。至少覆盖空条件、单条件、多条件、边界金额、时间边界、like 特殊字符等。测试通过后再把旧查询方法删掉,避免新旧逻辑并存。 第六,评估复杂查询边界。如果后续出现多表报表、复杂聚合需求,单独建报表查询通道,不要把复杂逻辑塞回 Specification。 ## 08、小结 企业后台订单查询的难点不在 SQL 本身,而在条件组合如何维护。Repository 方法名穷举法在条件少时看似简单,一旦条件超过五六个就会迅速失控。Specification 把动态筛选变成一个个可组合、可复用、可测试的谓词规则,配合 `JpaSpecificationExecutor` 和分页排序,非常适合列表页的高级筛选。 但也要认识到它的边界:单实体动态筛选是主场,复杂 Join、聚合、报表不是它的强项。把动态筛选做干净,把复杂报表放对位置,才是后端查询层更稳妥的架构选择。 ## 09、链接与概念说明 - Criteria API:JPA 提供的类型安全查询构建 API,通过 `CriteriaBuilder` 创建查询条件。 - Predicate:JPA 查询中的条件表达式,多个 Predicate 可以通过 `and/or` 组合。 - Specification:Spring Data JPA 提供的动态查询接口,核心方法是 `toPredicate`。 - JpaSpecificationExecutor:Repository 继承该接口后,可执行 `findAll(Specification, Pageable)` 等查询。 - PredicateSpecification:Spring Data JPA 4.x 中链式组合 Specification 的思路,常用 `Specification.where(...).and(...)` 表达。 - 官方文档:https://docs.spring.io/spring-data/jpa/reference/

优秀的个人博客,低调大师

《Spring Boot + JPA 实战》第15招 JPA也要懂索引

我是老李,最近被问到一个问题:为什么在订单 Entity 上加了几个 @Index,查询还是慢?我让他把慢 SQL 发来,一看,租户隔离的订单列表,过滤 tenant_id 和 status,再按 created_at 倒序分页。SQL 大概长这样: ```sql SELECT id, tenant_id, status, created_at, amount FROM orders WHERE tenant_id = 10001 AND status = 'PAID' ORDER BY created_at DESC LIMIT 20; ``` 表里几百万行,tenant_id 有索引,status 也有索引,但 MySQL 依然全表扫描或 filesort。这时候说“JPA 可以生成 SQL,但不能替你设计 MySQL 索引和执行计划”,就不是一句正确的废话,而是线上事故总结出的结论。 ## 01、痛点 在 ORM 里,加索引往往变成给实体类字段加注解,比如 @Table(indexes = @Index(...))。但注解只是建表 DDL 的一部分,不感知组合查询、排序方向、回表代价。MySQL 优化器可能选择错误的路径,因为多个单列索引不如一个联合索引。问题经常出现在分页查询、租户隔离系统、订单状态流转等核心链路。注解索引造成“有索引”的假象,线上慢查询依然发生。 更麻烦的是,JPA 生成 SQL 时可能对实体关系进行意外 join、distinct、in 展开等,进一步偏离开发者印象。你以为会走 idx_tenant,实际执行计划却走了 idx_status,甚至全表扫描。慢查询不是一个固定 SQL,而是随数据分布、参数变化、优化器统计信息变化而漂移。 ## 02、是什么 先厘清几个概念。JPA 或者具体到 Hibernate,会根据方言把 JPQL、Criteria 或方法名派生的查询转换成数据库 SQL,同时处理分页、批量、缓存。Hibernate 打印出来的 SQL 只是最终字符串,真正执行在数据库。SQL 生成不等于 SQL 执行,中间隔着编译器、优化器和存储引擎。 MySQL 侧的核心概念有这些。 B+Tree 是 InnoDB 的默认索引结构,叶子节点按索引键排序,叶子间有双向链表。主键索引是聚簇索引,整行数据存在叶子节点;二级索引叶子节点存索引键和主键值。 联合索引是多个列组成一个 B+Tree 键,先按第一列排序,第一列相同再按第二列,依次类推。最左匹配要求查询条件包含联合索引最左连续列才能有效利用。例如 (tenant_id, status, created_at) 可以支持 tenant_id= ?,也可以支持 tenant_id=? AND status=? 以及三列全给;但如果只给 status 而没有 tenant_id,就不能有效利用这个联合索引。 覆盖索引指查询需要的所有列都在索引里,直接从索引叶子拿到数据,不再回表。执行计划的 Extra 会出现 Using index。回表是指二级索引找到主键后,还要回到主键索引查完整行,成本随行数线性增加。 Cardinality 是索引列或索引组合中不同值的估计数量,优化器用它估算选择性。数据倾斜会导致估算偏差,需要 ANALYZE TABLE 更新统计信息。EXPLAIN 展示优化器估计的执行计划,包括 type、possible_keys、key、rows、filtered、Extra。EXPLAIN ANALYZE 是 MySQL 8.0.18 起支持的实际执行分析,会真实执行查询并返回每步实际行数、耗时。 ## 03、为什么 为什么在 Entity 上随便加几个 @Index 不叫索引设计?因为索引设计必须与查询模式对齐,必须观察真实 SQL 和真实执行计划。注解只是建表选项,不会根据 Repository 方法的组合条件、排序方向、分页大小动态调整。你写的 @Index(columnList = "tenant_id") 和 @Index(columnList = "status"),是两根单列索引,不等于联合索引。数据库优化器很难同时利用两个单列索引完成等值过滤和排序。 为什么必须捕捉真实 SQL?JPA 可能生成不是你印象中的 SQL。自动分页可能改写成 limit/offset,实体关联可能引入 join,多态查询可能生成 union。参数绑定类型、会话变量、方言差异都会影响最终 SQL 和优化器行为。凭 JPQL 猜索引常常是刻舟求剑。 为什么 ORM 改变不了物理成本?ORM 省去手写 SQL 和结果集映射的力气,但没有消除数据库访问数据页、判断键范围、排序、回表、加锁的成本。无论 SQL 是手写还是框架生成,执行计划都会落到 InnoDB 的 B+Tree 上。框架只能决定发送什么 SQL,不能决定存储引擎怎么执行。 ## 04、架构 可以把一次查询的路径拆成:Repository 方法 -> Hibernate 生成 SQL -> JDBC 发送 -> MySQL 解析/优化 -> 选择索引 -> InnoDB 读取 B+Tree -> 回表/排序 -> 返回结果集。每一层都可能出问题,但最容易忽略的是优化器选择索引和 InnoDB 扫描范围。 针对 tenant_id + status + created_at 的订单查询,如果只有 idx_tenant 和 idx_status 两根单列索引,优化器通常会选择选择性更高的一列,先用索引扫出一批主键,再回表过滤另一列,最后对 created_at 做 filesort。这个 filesort 可能成为灾难,因为每一页查询都要把一个大租户的所有订单捞出来排序,再取前 20 条。由于 ORDER BY 和过滤条件无法同时被一个索引覆盖,性能随数据量增长而急剧下降。 如果建立联合索引 (tenant_id, status, created_at),执行路径会完全不同。tenant_id 和 status 是等值条件,命中前两列;created_at 在第三列,索引天然按 created_at 升序排列。查询要求 ORDER BY created_at DESC,MySQL 可以反向扫描索引,从最后一个满足 tenant_id 和 status 的索引条目开始向回读取,直接得到有序结果,不再需要 filesort。如果查询只需要索引里的列,还能变成覆盖扫描,连回表都省了。 ## 05、实战 先拿真实 SQL。打开 Hibernate 日志,可以用 show_sql、format_sql,或者把 org.hibernate.SQL 的日志级别调到 DEBUG。看到 SQL 后,把绑定参数替换成具体值。慢查询示例: ```sql SELECT id, tenant_id, status, created_at, amount FROM orders WHERE tenant_id = 10001 AND status = 'PAID' ORDER BY created_at DESC LIMIT 20; ``` 初始表结构: ```sql CREATE TABLE orders ( id BIGINT PRIMARY KEY AUTO_INCREMENT, tenant_id BIGINT NOT NULL, status VARCHAR(32) NOT NULL, created_at DATETIME NOT NULL, amount DECIMAL(10,2), INDEX idx_tenant (tenant_id), INDEX idx_status (status) ) ENGINE=InnoDB; ``` 对这 SQL 执行 EXPLAIN,结果类似: | id | select_type | table | type | possible_keys | key | key_len | rows | Extra | | --- | --- | --- | --- | --- | --- | --- | --- | --- | | 1 | SIMPLE | orders | ref | idx_tenant | idx_tenant | 8 | 180000 | Using where; Using filesort | type=ref 表示用了非唯一索引,但 rows 还是 18 万,说明一个租户下订单很多。status 过滤发生在回表之后,所以 Extra 是 Using where;排序无法利用索引,所以 Using filesort。 建立联合索引: ```sql ALTER TABLE orders ADD INDEX idx_tenant_status_created (tenant_id, status, created_at); ``` 再执行 EXPLAIN,结果可能变成: | id | select_type | table | type | possible_keys | key | key_len | rows | Extra | | --- | --- | --- | --- | --- | --- | --- | --- | --- | | 1 | SIMPLE | orders | ref | idx_tenant_status_created | idx_tenant_status_created | 70 | 20 | Using index condition; Backward index scan | rows 从 18 万降到 20,不再有 Using filesort。Backward index scan 表示优化器反向扫描联合索引来满足 ORDER BY created_at DESC。Using index condition 表示使用索引条件下推,减少回表行数。 如果业务查询只需要 id、tenant_id、status、created_at、amount 五列,可以把 amount 也加入索引,做成覆盖索引: ```sql ALTER TABLE orders ADD INDEX idx_tenant_status_created_cover (tenant_id, status, created_at, id, amount); ``` 在执行计划中 Extra 可能出现 Using index,表示直接从二级索引取数,不再回表。代价是索引变大,写入性能略微下降。需要根据读写比例权衡。 再用 EXPLAIN ANALYZE 看真实耗时: ```sql EXPLAIN ANALYZE SELECT id, tenant_id, status, created_at, amount FROM orders WHERE tenant_id = 10001 AND status = 'PAID' ORDER BY created_at DESC LIMIT 20; ``` 输出可能包含 actual time、rows、loops,例如: ```text -> Limit: 20 row(s) (actual time=0.213..0.221 rows=20 loops=1) -> Index lookup on orders using idx_tenant_status_created (tenant_id=10001, status='PAID') (actual time=0.210..0.216 rows=20 loops=1) ``` 这说明实际只扫描了 20 行,而不是估计值。 有时优化器不选联合索引,可以检查 Cardinality。执行: ```sql ANALYZE TABLE orders; SHOW INDEX FROM orders WHERE Key_name = 'idx_tenant_status_created'; ``` 重点关注 Cardinality 一列,它不是精确值,但用于估算选择性。如果租户数据倾斜,某些 tenant_id 下有大量订单,优化器可能认为过滤性不足而放弃索引。此时需要结合 query 类型和实际排序需求决定是否使用 force index 或调整索引列顺序。 ## 06、洞见 ORM 改变 SQL 的生成方式,却不会改变数据库执行 SQL 的物理成本。这是整件事的核心。很多团队把性能问题归咎于 JPA 不行,或者怪 Hibernate 生成 SQL 难看,但实际上多数慢查询的根子在索引和执行计划。框架可以替你写 SQL,但不能替你决定数据怎么存、怎么扫、怎么排序。 索引设计是数据库侧的工程,不是注解层面的工程。它要回答的是:这条查询会访问多少行?能不能靠索引完成过滤和排序?会不会回表?索引维护成本能否接受?这些问题只有对着真实 SQL 和 EXPLAIN 才答得出来。 另一个容易被忽视的点是,执行计划不是一劳永逸。表数据增长、统计信息过期、查询参数改变,都会导致优化器改变决策。因此核心查询需要持续监测,而不是上线后就不再回头。 ## 07、行动 为 5 条核心 Repository 查询建立“方法 → SQL → Plan → Index”对照表。这是最小可行动作。示例: | Repository 方法 | 生成 SQL 摘要 | 初始 EXPLAIN | 索引设计 | 优化后 EXPLAIN | | --- | --- | --- | --- | --- | | findPageByTenantAndStatusOrderByCreatedAtDesc | select ... where tenant_id=? and status=? order by created_at desc limit ? | type=ref, key=idx_tenant, rows=180000, Using filesort | (tenant_id, status, created_at) | type=ref, key=idx_tenant_status_created, rows=20, Backward index scan | | findByIdList | select ... where id in (?, ?, ?) | type=range, key=PRIMARY, rows=取决于列表长度 | 保持主键索引 | type=range, key=PRIMARY | | countByTenantAndStatus | select count(*) ... where tenant_id=? and status=? | type=ref, key=idx_tenant, rows=大 | (tenant_id, status) | type=ref, key=idx_tenant_status_created | | findRecentByTenant | select ... where tenant_id=? order by id desc limit ? | type=ref, key=idx_tenant, rows=大, Using filesort | (tenant_id, id) 或依赖主键顺序 | type=ref, key=复合索引, Backward index scan | | findExpiredOrders | select ... where status='EXPIRED' and created_at < ? order by created_at | type=ref 或 range,但排序差 | (status, created_at) | type=range, key=idx_status_created, rows=小 | 对照表要落到代码仓库,贴在仓库文档或评审模板里。具体步骤: 1. 打开 SQL 日志,收集 5 条核心方法的真实 SQL。 2. 对每条 SQL 执行 EXPLAIN,记录 type、key、rows、Extra。 3. 设计联合索引,遵循最左匹配,把等值条件列放前面,排序列放后面。 4. 在从库或预发环境执行 ALTER TABLE,观察写放大和锁等待。 5. 执行 EXPLAIN ANALYZE,确认真实行数和耗时。 6. 将方法、SQL、Plan、Index 写入对照表,随代码评审一起合并。 7. 定期查看慢日志,当数据分布变化或查询模式变化时重新生成对照表。 ## 08、小结 JPA 能给你生成 SQL,但不能替你设计 MySQL 索引和执行计划。索引设计必须从真实 SQL 出发,结合 B+Tree、联合索引、最左匹配、覆盖索引、回表和 Cardinality 来判断。EXPLAIN 是侦查,EXPLAIN ANALYZE 是验证。对核心查询建立方法到 SQL 到 Plan 到 Index 的对照表,比在实体上加一堆注解有用得多。数据库的物理成本不会因为 ORM 而消失,它只会在你忽略执行计划时,在线上慢慢累积。 ## 09、链接与概念说明 B+Tree:InnoDB 使用的平衡多路搜索树,叶子节点有序并携带数据或主键。 联合索引:多列按序构成的索引键,能同时加速等值过滤和排序,但需满足最左匹配。 最左匹配:查询条件必须包含联合索引的最左连续列,否则索引不能完整使用。 覆盖索引:索引包含查询需要的所有列,Extra 可看到 Using index,避免回表。 回表:通过二级索引定位主键后,再回聚簇索引读取完整行的过程。 Cardinality:优化器用于估算索引选择性的统计量,可用 SHOW INDEX 和 ANALYZE TABLE 查看或更新。 EXPLAIN:输出优化器估计的执行计划,关注 type、key、rows、Extra。 EXPLAIN ANALYZE:MySQL 8.0.18 起支持,实际执行查询并输出每步真实行数和耗时。 更多细节见 MySQL 官方手册中关于 InnoDB 索引、优化器统计信息、EXPLAIN 和 EXPLAIN ANALYZE 的章节。

优秀的个人博客,低调大师

《Spring Boot + JPA 实战》第22招 JPA遇上向量检索

## 01、痛点 我是老李,后端团队最近在做商品搜索。以前用户搜“冰箱”,条件查询按名称、分类、价格过滤,很丝滑。后来用户输入“适合小户型的静音冰箱”,like 和属性条件完全失效:没有“小户型”字段,没有“静音”标签,也没有精确型号。运营希望搜索能理解语义,而不是只做关键词命中。与此同时,团队已经用 Embedding 给商品描述生成了向量,但问题来了:现有 Spring Data JPA 体系里怎么存、怎么查、怎么和原来的租户隔离、上下架状态、权限过滤混在一起?数据库厂商开始宣布支持 Vector 类型,很多同学第一反应是:既然 MySQL / JPA 支持了,是不是可以直接替代向量数据库?我们先别急着下结论。 ## 02、是什么 Spring Data JPA 覆盖 Vector Search,本质不是新出一个数据库,而是在数据访问层引入了向量字段类型映射和相似度查询方法。传统 JPA Query 解决的是“精确匹配”:tenant_id = ?、status = ?、price between ?。向量查询解决的是“语义相似”:给定一段文本或图片的 Embedding,找出最接近的若干行。二者不是一个替代关系,而是组合关系。 比如 Product 实体之前只有 id、name、category、price、tenantId、acl、status 等结构化字段。现在增加一个 description_embedding 向量字段,类型可能是 float[] 或数据库原生 vector。Spring Data 允许你声明类似 findTop10ByTenantIdAndStatusAndAclInAndDescriptionEmbeddingSimilarityOrderBy... 的方法,或者用原生 SQL 调用数据库的向量距离函数 vec_cosine_distance。这里的关键是:过滤条件走传统索引,相似度排序走向量计算,最终返回兼顾业务约束和语义相关性的结果。 Embedding 是模型对文本/图片输出的一组高维浮点数组,语义相近的对象在向量空间中距离更近。常见相似度有余弦相似度、内积、欧氏距离。Spring Data 通过方言把相似度函数翻译到具体数据库,比如 pgvector 的 ,MySQL 的 DISTANCE(),Redis 的 FT.SEARCH 等。 ## 03、为什么 为什么关系型数据访问与 AI/Embedding 会产生交集?因为现实业务很少只做纯语义搜索。一个商品搜索请求通常包含:tenant_id=?、status='ON_SHELF'、acl IN (...),同时还要按语义相似度排序。如果向量数据放在独立向量库,应用层需要先在某处取业务过滤后的候选集,再跑到向量库做相似度检索,或者拿向量结果回到业务库过滤,这会带来数据同步、事务一致性、网络开销和两套查询逻辑。 当 MySQL、PostgreSQL 或 Redis 开始支持向量数据类型和相似度函数时,最直接的好处是:同一张表里既可以做结构化过滤,也可以做向量排序,一次 SQL/命令完成混合查询,复用现有数据访问栈、事务和权限模型。Spring Data JPA 封装后,开发体验接近普通 Repository 方法。这就是为什么“未来常见模式可能是 tenant + ACL + status + vector similarity 的混合查询”。它既不是放弃传统条件查询,也不是把一切交给向量,而是新增一个查询维度。 ## 04、架构 架构上,可以把混合查询拆成四条路径: 1. 写入路径:业务数据落库后,对商品描述异步或同步生成 Embedding,写入同一条记录或扩展表。 2. 过滤路径:tenant、ACL、status 继续走 B+ 树或普通索引,先圈定可见数据。 3. 召回路径:向量列使用向量索引或暴力扫描做相似度计算,返回 Top-K。 4. 排序路径:结合业务权重(销量、价格、距离)做最终排序。 Spring Data 位于应用层,负责把方法名或 @Query 翻译成底层 SQL/命令。它的价值是统一编程模型,而不是替代数据库执行引擎。数据库引擎的向量索引能力、Top-K 召回精度、过滤条件下的性能表现,决定了这套架构的上限。 一个常见的错误是:看到 JPA 方法能调用 vec_cosine_distance,就以为底层一定走了高效向量索引。实际上很多关系型数据库在混合过滤 + 向量排序时,可能退化为“先过滤出所有行,再对每行计算向量距离”,数据量一大就是灾难。专业向量数据库通常针对“过滤后向量检索”做了索引裁剪、预过滤/后过滤策略、标量索引与向量索引融合,而普通关系库仍可能停留在函数计算层面。 ## 05、实战 以商品搜索为例,下面是我们的简化实现。 Product 表结构: ``` id BIGINT PRIMARY KEY, tenant_id BIGINT, name VARCHAR, category VARCHAR, price DECIMAL, status VARCHAR, acl VARCHAR, description TEXT, description_embedding VECTOR(768) ``` 商品描述 Embedding 由模型生成,写入 description_embedding。我们保留 description 原文本用于展示和审计,向量用于语义检索。 Repository 接口中,传统条件查询仍然保留: ``` List findByTenantIdAndStatusAndCategory(...) ``` 新增向量混合查询,用原生 SQL 显式声明距离排序: ``` @Query(nativeQuery = true, value = SELECT * FROM product WHERE tenant_id = :tenantId AND status = :status AND acl IN (:acls) ORDER BY vec_cosine_distance(description_embedding, :queryVector) LIMIT :topN) List searchMixed(...); ``` vec_cosine_distance 根据数据库方言替换,例如 pgvector 使用 description_embedding :queryVector。 实际测试时,我们用“适合小户型的静音冰箱”生成查询向量,带上 tenant_id = 1001、status = 'ON_SHELF'、acl IN ('public','vip'),数据库返回语义相近且当前租户可见、在架、有权限的商品。如果没有向量列,这个查询只能靠关键词命中,召回率很差。 从这个案例可以看清 Spring Data Vector Search 与传统 JPA Query 的关系:传统 JPA Query 负责“能不能看、能不能卖、属于谁”,向量查询负责“像不像用户想要的”。前者缩小范围,后者提供语义排序,二者不是二选一,而是同一个 Repository 里的组合拳。 ## 06、洞见 为什么不能因为 MySQL 或 JPA 开始支持 Vector 就直接把它等同于成熟向量数据库? 第一,“支持向量类型和距离函数”不等于“成熟向量索引”。很多数据库的向量支持是从扫描计算开始的,甚至没有 HNSW、IVF 等近似最近邻索引。没有索引时,百万级向量全表扫描的延迟完全不可用。 第二,JPA 只是访问抽象,无法补齐底层索引、召回策略、分片和压缩能力。Spring Data 提供的相似度方法,底层可能仍走精确扫描,也可能走有损索引,对应用并不透明。你以为的 Top-K 可能不稳定,或者过滤后召回缺失。 第三,混合查询的性能陷阱。精确过滤 + 向量相似度排序,最容易出现“先过滤出几十万行,再逐行算距离”的退化。专业向量数据库会针对标量过滤做位图索引、倒排索引,再与向量索引融合,控制候选集规模。关系库目前主要擅长精确过滤,向量索引与标量索引混合执行计划还不够成熟。 第四,规模、索引、召回和过滤需求不同。如果向量数据只有几十万、请求量低,MySQL/pgvector 完全可行;如果向量数据上亿、QPS 很高、需要高召回率,专用向量库在生产环境更稳妥。成熟的向量数据库除了索引,还提供分片、副本、增量写入、压缩量化、监控和调优工具。 因此,向量检索确实正在成为普通数据访问的一种新查询维度,但数据库选型仍然取决于规模、索引、召回和过滤需求。JPA 的支持降低了开发门槛,却提高了对底层引擎的认知要求。 ## 07、行动 我把几种常见存储的适用边界做了一个对比: | 存储 | 适用场景 | 优势 | 注意点 | |---|---|---|---| | MySQL | 小规模向量、已有 MySQL 栈、向量只是辅助排序 | 无额外系统、事务一致、运维简单 | 向量索引较弱,过滤+相似度排序易退化 | | pgvector (PostgreSQL) | 中等规模、强一致、复杂过滤与向量混合 | 原生扩展、支持 HNSW/IVFFlat、事务、SQL 混合查询 | 数据量特别大时索引构建/查询性能需测试,部署较专业库重 | | Redis Vector | 低延迟在线召回、缓存/实时链路已有 Redis | 内存快、RediSearch 向量查询简单 | 内存成本高、持久化和大规模成本需评估 | | 专用向量库 | 大规模高维、高吞吐、复杂召回/重排、独立运维 | HNSW/IVF 索引成熟、分片副本、标量过滤融合好 | 多一套系统、数据同步、一致性、运维成本 | 建议按四个维度评估:数据规模、索引需求、召回要求、过滤复杂度。如果只是给现有商品搜索加一个语义相似排序,数据量百万以内,pgvector 或 MySQL Vector 是很实际的起点;如果已经是 Redis 重度用户,用 Redis Vector 做在线召回也顺理成章;如果向量规模很快过亿,或需要精排、多路召回、高可用,建议直接上专用向量库。不要让 JPA 的便利掩盖底层引擎差异。 ## 08、小结 Spring Data JPA 覆盖 Vector Search,标志着向量检索不再只是专用系统里的特殊能力,而是普通关系型数据访问的一个新查询维度。它让我们可以在同一个 Repository 中同时处理 tenant + ACL + status + vector similarity 这类混合查询,这对业务搜索、推荐、内容风控等场景非常实用。但我们必须清楚,JPA 提供的是访问抽象,不是向量数据库的替代品。MySQL、Redis、pgvector 和专业向量库各有边界,选型要基于规模、索引、召回和过滤需求,而不是看到了“支持 Vector”就迁移。 ## 09、链接与概念说明 概念说明: - Embedding:将文本、图片等非结构化数据映射成高维浮点向量,语义相近的对象距离更近。 - 余弦相似度:衡量两个向量方向相似程度,常见于文本 Embedding 检索。 - ANN(近似最近邻):以轻微精度损失换取远优于暴力扫描的查询速度。 - HNSW:分层可导航小世界图,是当前主流的向量索引结构之一。 - IVFFlat:倒排文件索引,适合中等规模向量,需要预先聚类训练。 - pgvector:PostgreSQL 的开源向量扩展,提供向量类型和 HNSW/IVFFlat 索引。 - Redis Vector:Redis Stack 提供的向量查询能力,基于 RediSearch 实现。 - 专用向量库:如 Milvus、Qdrant、Weaviate 等,面向大规模向量检索提供索引、分片、过滤、召回等完整能力。 参考入口: - Spring Data JPA 官方文档中与向量类型映射、相似度函数相关的章节。 - 各数据库对应向量能力文档:MySQL Vector、pgvector、Redis Vector。 - 生产选型前建议在目标数据量和 QPS 下做基准测试,重点关注过滤后向量检索的 P95 延迟与召回率。

优秀的个人博客,低调大师

每日一博 | 我在前端写 Java Spring Boot 项目

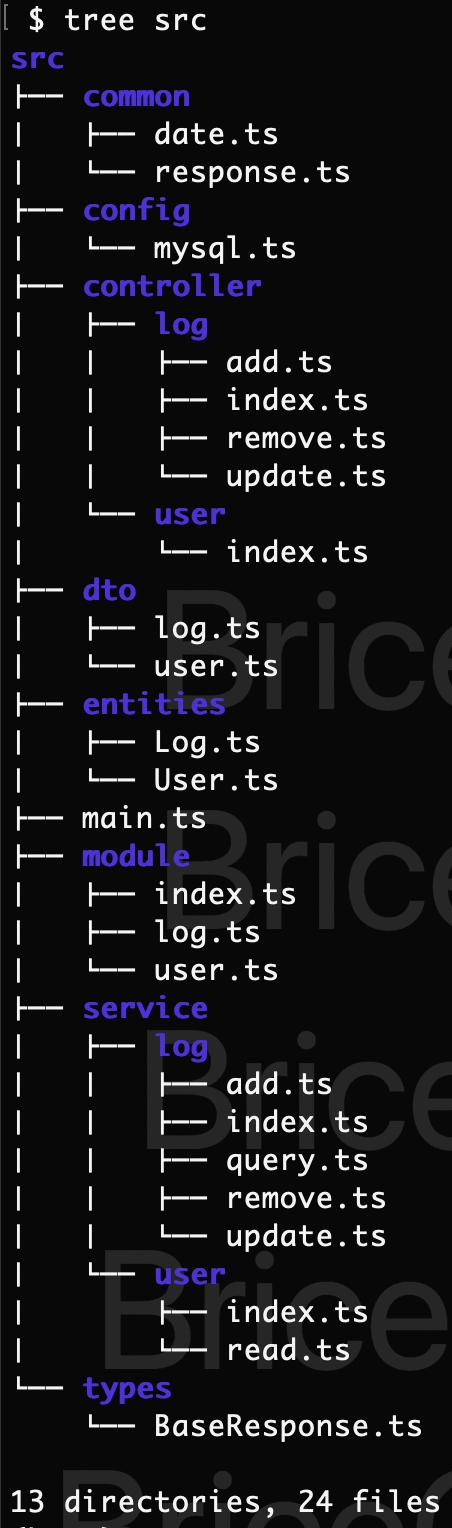
前言 玩归玩,闹归闹,别拿 C端 开玩笑! 这里不推荐大家把Node服务作为C端服务,毕竟它是单线程多任务 机制。 这一特性是 Javascript 语言设计之初,就决定了它的使命 - Java >>>【Script】,这里就不多解释了,大家去看看 JavaScript 的历史就知道啦~这也就决定了,它不能像后端语言那样 多线程多任务,用户访问量小还能承受,一旦承受访问量大高并发,就得凉凉~ 那为什么我们还要去写 Node 服务? 主要是方便快捷,对于小项目可以迅速完成建设,开发成本小。 其次,主要通过写 Nest 完成下面收获: 学习装饰器语法,感受其简洁优美; 自己学习一门新的开发框架,感受不同框架的优缺点,为以后开发选型打基础; 感受服务端排查问题的复杂性,找找前端设计的灵感。 本篇文章主要是使用 NestJs + Sequelize + MySQL 完成基础运行, 带大家了解 Node 服务端的基础搭建,也可以顺便看看 Java SpringBoot 项目的基础结构,它俩真的非常相似,不信你去问服务端开发同学。 养成好习惯,看文章先一键三连~【点赞,关注,转发】,评论可以看完再吐槽~继续完善填坑~ 第一步、项目跑起来 在选择服务端的时候,我之前使用过 Egg.js ,所以这次就不选它了。其次,Egg 也是继承了 Koa 的开发基础,加上 Express 也是基于 Koa 上创新的,两者应该差不多,就不选择 Koa 和 Express 。 所以,我想尝试下 Nest.js 看语法跟 Java 是一样的,加上之前也自己开发过 Java + SpringBoot 的项目,当然更古老的 SSH 2.0 也从无到有搭建过,即:Spring2.0 + Struts2+ Hibernate3.2,想想应该会很容易上手,顺便怀旧下写写。 参考文档: https://www.geeksforgeeks.org/best-nodejs-frameworks-for-app-development/ https://anywhere.epam.com/business/best-node-js-frameworks 说下我的想法,首先我们刚入门,估计会有一堆不清楚的坑,我们先简单点,后续我们再继续加深。既然要搞服务端,要搞就多搞点,我们都去尝鲜玩玩。我们打算使用 Nest 作为前端框架,Graphql 作为中间处理层。底层数据库我们用传统的 MySQL,比较稳定可靠,而且相对比较熟悉,这个就不玩新的了,毕竟数据库是一切的基石 。 说下我们具体实现步骤: 1. 【必须】没有任何数据库,完成接口请求运行,能够跑起来; 2. 【必须】创建基础数据库 MySQL ,接入 @nestjs/sequelize 库 完成 增删改查 功能即:CRUD 3. 【可选】打算采取 Graphql 处理 API 查询,做到精确数据查询,这个已经火了很多了,但是真正使用的很少,我们打算先感受下,后续可以直接用到业务。 4. 【可选】接入 Swagger 自动生成 API 文档,快捷进行前端与后端服务联调测试。 ◦ Swagger是一个开源工具,用于设计、构建、记录和使用RESTful web服务。 5. 【可选】接口请求,数据库优化处理 ◦ 请求分流,数据库写入加锁,处理并发流程 ◦ 增加 middleware 中间件统一处理请求及响应,进行鉴权处理,请求拦截等操作 ◦ 数据库分割备份,数据库融灾处理,分为:主、备、灾 ◦ 数据库读写分离,数据双写,建立数据库缓存机制,使用 redis 处理 也欢迎大家补充更多的优化点,我们一起探讨~有兴趣可以帮忙补充代码哈~ 确定了大概方向,我们就开始整。先不追求一步到位,否则越多越乱,锦上添花的东西,我们可以后续增加,基础功能我们要优先保障完成。Nest.js 官网:https://docs.nestjs.com/ ,话不多说,我们直接开整。 # 进入文件夹目录 cd full-stack-demo/packages # 安装脚手架 npm i -g @nestjs/cli # 创建基础项目 nest new node-server-demo # 进入项目 cd new node-server-demo # 运行项目测试 npm run start:dev 我们移除一些不需要的东西,先简单再复杂,别把自己搞晕了。接下来写一个简单示例感受下这个框架,之后完整的代码,我会公布在后面。废话不多说,开整!调整后目录结构: • common - 公用方法类 • config - 配置类文件 • controller - 控制器,用于处理前端发起的各类请求 • service - 服务类,用于处理与数据库交互逻辑 • dto - DTO(Data Transfer Object)可以用于验证输入数据、限制传输的字段或格式。 • entities - 实体类,用于描述对象相关的属性信息 • module - 模块,用于注册所有的服务类、控制器类,类似 Spring 里面的 bean ◦ 这里不能完全等同哈,两个实现机制上就不同,只是帮助大家理解。 • main.ts - nest 启动入口 • types - typescript 相关声明类型   只是写 demo, 搞快点就没有怎么写注释了,我感觉是一看就懂了,跟 Java SpringBoot 的写法非常一致,部分代码展示: 控制器 controller // packages/node-server-demo/src/controller/user/index.ts import { Controller, Get, Query } from '@nestjs/common'; import UserServices from '@/service/user'; import { GetUserDto, GetUserInfoDto } from '@/dto/user'; @Controller('user') export class UserController { constructor(private readonly userService: UserServices) {} // Get 请求 user/name?name=bricechou @Get('name') async findByName(@Query() getUserDto: GetUserDto) { return this.userService.read.findByName(getUserDto.name); } // Get 请求 user/info?id=123 @Get('info') async findById(@Query() getUserInfoDto: GetUserInfoDto) { const user = await this.userService.read.findById(getUserInfoDto.id); return { gender: user.gender, job: user.job }; } } // packages/node-server-demo/src/controller/log/add.ts import { Controller, Post, Body } from '@nestjs/common'; import { AddLogDto } from '@/dto/log'; import LogServices from '@/service/log'; @Controller('log') export class CreateLogController { constructor(private readonly logServices: LogServices) {} // post('/log/add') @Post('add') create(@Body() createLogDto: AddLogDto) { return this.logServices.create.create(createLogDto); } } 数据转换 Data Transfer Object // packages/node-server-demo/src/dto/user.ts export class CreateUserDto { name: string; age: number; gender: string; job: string; } // 可以分开写,也可以合并 export class GetUserDto { id?: number; name: string; } // 可以分开写,也可以合并 export class GetUserInfoDto { id: number; } service 数据库交互处理类 // packages/node-server-demo/src/service/user/read.ts import { Injectable } from '@nestjs/common'; import { User } from '@/entities/User'; @Injectable() export class ReadUserService { constructor() {} async findByName(name: string): Promise<User> { // 可以处理判空,从数据库读取/写入数据,可能会被多个 controller 进行调用 console.info('ReadUserService findByName > ', name); return Promise.resolve({ id: 1, name, job: '程序员', gender: 1, age: 18 }); } async findById(id: number): Promise<User> { console.info('ReadUserService findById > ', id); return Promise.resolve({ id: 1, name: 'BriceChou', job: '程序员', gender: 1, age: 18, }); } } module 模块注册,服务类/控制类 // packages/node-server-demo/src/module/user.ts import { Module } from '@nestjs/common'; import UserService, { ReadUserService } from '@/service/user'; import { UserController } from '@/controller/user'; @Module({ providers: [UserService, ReadUserService], controllers: [UserController], }) export class UserModule {} // packages/node-server-demo/src/module/index.ts 根模块注入 import { Module } from '@nestjs/common'; import { UserModule } from './user'; import { LogModule } from './log'; @Module({ imports: [ UserModule, LogModule, ], }) export class AppModule {} main.js 启动注册的所有类 // packages/node-server-demo/src/main.ts import { AppModule } from '@/module'; import { NestFactory } from '@nestjs/core'; import { NestExpressApplication } from '@nestjs/platform-express'; async function bootstrap() { const app = await NestFactory.create<NestExpressApplication>(AppModule); // 监听端口 3000 await app.listen(3000); } bootstrap(); 这样一个单机的服务器就启动起来了,我们可以使用 Postwoman [https://hoppscotch.io/] 进行请求,瞅瞅看返回效果。   控制台也收到日志了,后面可以把这些日志请求保留成 .log 文件,这样请求日志也有了,完美!下一步,我们开始连接数据库,这样就不用单机玩泥巴了~ 第二步、配置 MySQL MySQL 安装其实很简单,我电脑是 Mac 的,所以下面的截图都是以 mac 为例,先下载对应的数据库。 下载地址:https://dev.mysql.com/downloads/mysql/ 至于其他系统的,可以网上找教程,这个应该烂大街了,我就不重复搬运教程了。 注意:安装的数据库,一定要设置密码,连接数据库必须要有密码,否则会导致连接数据库失败。 MySQL 我们只安装数据库就行,熟悉指令的童鞋,就直接命令行操作就行。 不熟悉的话,那就下载图形化管理工具。 ◦ Mysql 官方控制台 https://dev.mysql.com/downloads/workbench/ ◦ Windows 也可以使用 https://www.heidisql.com/download.php?download=installer PS:安装 workbench 时发现要求 MacOS 13以上,我的电脑是 MacOS 12。 白白下载,所以只能 https://downloads.mysql.com/archives/workbench/ 从归档里面找低版本 8.0.31。对于数据库服务也有版本要求,大家按照自己电脑版本,选择支持的版本即可。 https://downloads.mysql.com/archives/community/。我这边选择的是默认最新版本:8.0.34,下载好直接安装,一路 Next 到底,记住自己输入的 Root 密码!!! 确认好当前数据库是否已经运行起来了,启动 Workbench 查看状态。  1.创建数据库 数据库存在字符集选择,不同的字符集和校验规则,会对存储数据产生影响,所以大家可以自行查询,按照自己存储数据原则选择,我这里默认选最广泛的。确认好,就选择右下角的应用按钮。 2. 创建表和属性  选项解答: • PRIMARY KEY 是表中的一个或多个列的组合,它用于唯一标识表中的每一行。 • Not NULL 和 Unique 就不解释,就是直译的那个意思。 • GENERATED 生成列是表中的一种特殊类型的列,它的值不是从插入语句中获取的,而是根据其他列的值通过一个表达式或函数生成的。 CREATE TABLE people ( first_name VARCHAR(100), last_name VARCHAR(100), full_name VARCHAR(200) AS (CONCAT(first_name, ' ', last_name)) ); UNSIGNED 这个数值类型就只能存储正数(包括零),不会存储负数。 ZEROFILL 将数值类型的字段的前面填充零,他会自动使字段变为 UNSIGNED,直到该字段达到声明的长度,如:00007 BINARY 用于存储二进制字符串,如声明一个字段为 BINARY(5),那么存储在这个字段中的字符串都将被处理为长度为 5 的二进制字符串。 ◦ 如尝试存储一个长度为 3 的字符串,那么它将在右侧用两个空字节填充。 ◦ 如果你尝试存储一个长度为 6 的字符串,那么它将被截断为长度为 5 ◦ 主要用途是存储那些需要按字节进行比较的数据,例如加密哈希值 此外也可顺手传创建一个索引,方便快速查找。 CREATE TABLE `rrweb`.`test_sys_req_log` ( `id` INT UNSIGNED NOT NULL AUTO_INCREMENT, `content` TEXT NOT NULL, `l_level` INT UNSIGNED NOT NULL, `l_category` VARCHAR(255) NOT NULL, `l_created_at` TIMESTAMP NOT NULL DEFAULT CURRENT_TIMESTAMP, `l_updated_at` TIMESTAMP NOT NULL DEFAULT CURRENT_TIMESTAMP, PRIMARY KEY (`id`), UNIQUE INDEX `id_UNIQUE` (`id` ASC) VISIBLE, INDEX `table_index` (`l_level` ASC, `l_category` ASC, `l_time` ASC) VISIBLE); 3. 连接数据库 由于目前 node-oracledb 官方尚未提供针对 Apple Silicon 架构的预编译二进制文件。导致我们无法在 Mac M1 芯片上使用 TypeORM 链接数据库操作,它目前只支持 Mac x86 芯片。哎~折腾老半天,查阅各种文档,居然有这个坑,没关系我们换个方式打开。 我们不得不放弃,从而选用 https://docs.nestjs.com/techniques/database#sequelize-integration 哐哐哐~一顿操作猛如虎,盘它! 安装 Sequelize # 安装连接库 npm install --save @nestjs/sequelize sequelize sequelize-typescript mysql2 # 安装 type npm install --save-dev @types/sequelize 配置数据库基础信息 // packages/node-server-demo/src/module/index.ts import { Module } from '@nestjs/common'; import { UserModule } from './user'; import { LogModule } from './log'; import { Log } from '@/entities/Log'; import { SequelizeModule } from '@nestjs/sequelize'; @Module({ imports: [ SequelizeModule.forRoot({ dialect: 'mysql', // 按数据库实际配置 host: '127.0.0.1', // 按数据库实际配置 port: 3306, // 按数据库实际配置 username: 'root', // 按数据库实际配置 password: 'hello', // 按数据库实际配置 database: 'world', synchronize: true, models: [Log], autoLoadModels: true, }), LogModule, UserModule, ], }) export class AppModule {} 实体与数据库一一映射处理 import { getNow } from '@/common/date'; import { Model, Table, Column, PrimaryKey, DataType, } from 'sequelize-typescript'; @Table({ tableName: 'test_sys_req_log' }) export class Log extends Model<Log> { @PrimaryKey @Column({ type: DataType.INTEGER, autoIncrement: true, field: 'id', }) id: number; @Column({ field: 'content', type: DataType.TEXT }) content: string; @Column({ field: 'l_level', type: DataType.INTEGER }) level: number; // 3严重,2危险,1轻微 @Column({ field: 'l_category' }) category: string; // 模块分类/来源分类 @Column({ field: 'l_created_at', type: DataType.NOW, defaultValue: getNow(), }) createdAt: number; @Column({ field: 'l_updated_at', type: DataType.NOW, defaultValue: getNow(), }) updatedAt: number; } module 注册实体 // packages/node-server-demo/src/module/log.ts import { Module } from '@nestjs/common'; import { SequelizeModule } from '@nestjs/sequelize'; import { Log } from '@/entities/Log'; import LogServices, { CreateLogService, UpdateLogService, DeleteLogService, ReadLogService, } from '@/service/log'; import { CreateLogController, RemoveLogController, UpdateLogController, } from '@/controller/log'; @Module({ imports: [SequelizeModule.forFeature([Log])], providers: [ LogServices, CreateLogService, UpdateLogService, DeleteLogService, ReadLogService, ], controllers: [CreateLogController, RemoveLogController, UpdateLogController], }) export class LogModule {} service 操作数据库处理数据 import { Log } from '@/entities/Log'; import { Injectable } from '@nestjs/common'; import { AddLogDto } from '@/dto/log'; import { InjectModel } from '@nestjs/sequelize'; import { ResponseStatus } from '@/types/BaseResponse'; import { getErrRes, getSucVoidRes } from '@/common/response'; @Injectable() export class CreateLogService { constructor( @InjectModel(Log) private logModel: typeof Log, ) {} async create(createLogDto: AddLogDto): Promise<ResponseStatus<null>> { console.info('CreateLogService create > ', createLogDto); const { level = 1, content = '', category = 'INFO' } = createLogDto || {}; const str = content.trim(); if (!str) { return getErrRes(500, '日志内容为空'); } const item = { level, category, // Tips: 为防止外部数据进行数据注入,我们可以对内容进行 encode 处理。 // content: encodeURIComponent(str), content: str, }; await this.logModel.create(item); return getSucVoidRes(); } } 一路操作猛如虎,回头一看嘿嘿嘿~终于,我们收到了来自外界的第一条数据! hello world!   连接及创建数据成功!此时已经完成基础功能啦~ 第三步、实现 CRUD 基础功能 剩下的内容,其实大家可以自行脑补了,就是调用数据库的操作逻辑。先说说什么是 CRUD C create 创建 R read 读取 U update 更新 D delete 删除 下面给个简单示例,大家看看,剩下就去找文档,实现业务逻辑即可: import { Injectable } from '@nestjs/common'; import { InjectModel } from '@nestjs/sequelize'; import { User } from './user.model'; @Injectable() export class UserService { constructor( @InjectModel(User) private userModel: typeof User, ) {} // 创建新数据 async create(user: User) { const newUser = await this.userModel.create(user); return newUser; } // 查找所有数据 async findAll() { return this.userModel.findAll(); } // 按要求查找单个 async findOne(id: string) { return this.userModel.findOne({ where: { id } }); } // 按要求更新 async update(id: string, user: User) { await this.userModel.update(user, { where: { id } }); return this.userModel.findOne({ where: { id } }); } // 按要求删除 async delete(id: string) { const user = await this.userModel.findOne({ where: { id } }); await user.destroy(); } } Tips: 进行删除的时候,我们可以进行假删除,两个数据库,一个是备份数据库,一个是主数据库。主数据库可以直接删除或者增加标识表示删除。备份数据库,可以不用删除只写入和更新操作,这样可以进行数据还原操作。 此外,为了防止 SQL 数据库注入,大家需要对数据来源进行统一校验处理或者直接进行 encode 处理,对于重要数据可以直接进行 MD5 加密处理,防止数据库被直接下载泄露。关于 SQL 数据库的安全处理,网上教程有很多,大家找一找就可以啦~ 部署就比较简单了,我们就不需要一一赘述了,数据库可以用集团提供的云数据库,而 Nest 就是普通的 node 部署。 作者:京东零售 周明亮 来源:京东云开发者社区 转载请注明来源
资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册