首页 文章 精选 留言 我的

精选列表

搜索[扩展更新],共10000篇文章
优秀的个人博客,低调大师

轻松扩展机器学习能力:如何在Rancher上安装Kubeflow

随着机器学习领域不断发展,对于处理机器学习的团队来说,在1台机器上训练1个模型已经有些难以为继,并且现在业界的共识是机器学习已经不仅仅是简单的模型训练。 在模型训练之前、过程中和之后,需要进行许多活动,对于要生成自己的ML模型的团队来说尤其如此。下图常常被引用来说明此类情况: 对于许多团队来说,将机器学习的模型从研究环境应用到生产环境这一过程困难重重,背负很大的压力。糟糕的是,市面上处理每类问题的工具都数量惊人,而这些海量工具都有望解决你所有的机器学习难题。 但是整个团队学习新工具通常很耗时,并且将这些工具集成到你当前的工作流程中也并不容易。这时,或许可以考虑Kubeflow,这是为需要建立机器学习流水线的团队而打造的一个机器学习平台,它包括许多其他工具,可以用于服务模型和调整超参数。Kubeflow尝试做的是将同类最好用的ML工具整合在一起,并将它们集成到一个平台中。 来源:https://www.kubeflow.org/docs/started/kubeflow-overview/ 顾名思义,Kubeflow应该部署在Kubernetes上,既然你是通过Rancher的平台阅读到这篇文章,那么你大概率已经在某个地方部署了Kubernetes集群。 值得注意的是,Kubeflow中的“flow”并不是表示Tensorflow。Kubeflow也能够与PyTorch一起使用,甚至可以与任何ML框架一起使用(不过支持得最好的框架还是Tensorflow和PyTorch)。 在本文中,我将向你展示如何尽可能简单地安装Kubeflow。如果在你的集群上已经有GPU设置,则过程将更为简单。如果尚未设置,那么你需要执行一些额外的设置步骤,因为许多机器学习需要运行在NVIDIA GPU上。 在Kubeflow上设置GPU支持 假设你已经安装了Docker 19.x。 1、 安装NVIDIA 容器运行时 在所有带有GPU的节点上: % distribution=$(. /etc/os-release;echo $ID$VERSION_ID) % curl -s -L https://nvidia.github.io/nvidia-docker/gpgkey | sudo apt-key add - % curl -s -L https://nvidia.github.io/nvidia-docker/$distribution/nvidia-docker.list | sudo tee /etc/apt/sources.list.d/nvidia-docker.list % sudo apt-get update && sudo apt-get install -y nvidia-container-toolkit % sudo apt-get install nvidia-container-runtime 现在,修改Docker守护进程(Daemon)运行时字段: % sudo vim /etc/docker/daemon.json 粘贴以下内容: { "default-runtime": "nvidia", "runtimes": { "nvidia": { "path": "/usr/bin/nvidia-container-runtime", "runtimeArgs": [] } } } 现在重启Docker守护进程: % sudo systemctl restart docker 2、 安装NVIDIA设备插件 在master节点上,创建NVIDIA设备插件: % kubectl create -f https://raw.githubusercontent.com/NVIDIA/k8s-device-plugin/1.0.0-beta/nvidia-device-plugin.yml 接下来,正式开始安装Kubeflow。 安装Kubeflow 注意:在撰写本文时,Kubeflow的最新版本是1.0。它与Kubernetes 1.14和1.15版本兼容。 Step0:设置动态Volume配置 在我们安装Kubeflow之前,我们需要设置动态配置。 一种方法是使用Rancher的local-path-provisioner,其中使用了基于hostPath的节点持久卷。设置非常简单:将其指向节点上的路径并部署YAML文件。缺点是无法控制volume容量限制。 另一种方法是使用网络文件系统(NFS),我将在下文展示具体步骤。 在Master节点上设置网络文件系统 假设你将大部分数据存储在本地,那么你需要设置NFS。在这里,我假设 NFS server位于master节点10.64.1.163上。 首先,为NFS安装依赖项: % sudo apt install -y nfs-common nfs-kernel-server 然后,创建一个根目录: % sudo mkdir /nfsroot 将以下条目添加到/etc/exports: /full/path/to/nfsroot 10.64.0.0/16(rw,no_root_squash,no_subtree_check) 请注意,10.64.0.0是节点的CIDR,而不是Kubernetes Pod CIDR。 接下来,通过以下命令将共享目录导出为sudo: % sudo exportfs -a 最后,要使所有配置生效,请按如下所示重新启动NFS内核服务器: % sudo systemctl restart nfs-kernel-server 另外,确保nfs-kernel-server在服务器(重新)启动时启动: % sudo update-rc.d nfs-kernel-server enable 在worker节点上设置NFS 为NFS安装依赖项: % sudo apt install -y nfs-common 安装NFS Client Provisioner 现在,我们可以安装NFS Client Provisioner——并且终于可以向你们安利我最爱的Rancher功能之一:应用商店! 默认情况下,Rancher自带了许多已经经过测试的应用程序。此外,我们还可以自行添加整个Helm Chart到应用商店里。 点击Apps,然后点击【Manage Catalogs】 然后选择【Add Catalog】: 填写以下值: 点击【Create】,回到【Apps】页面。稍微等待一会儿,你将看到helm部分有了许多应用程序。你可以点击【Refresh】来查看进程: 现在,在搜索框内输入nfs,然后你将看到2个条目: 其中一个正是我们要找的:nfs-client-provisioner。点击它,然后你将看到: 这是可用于nfs-client-provisioner的chart的所有选项,你将需要使用它们来填写以下内容: 填写完毕后,你可以点击【Launch】按钮。等待一会儿,让Kubernetes下载Docker镜像,并将一切设置完毕。所有操作都完成后,你将看到以下页面: 我真的太喜欢应用商店这个功能了,它是我最喜欢的功能之一,因为它的存在,使得在集群上安装和监控应用程序变得简单和方便。 Step1:下载并安装kfctl 这是Kubeflow的控制工具,与kubectl类似。你可以从Kubeflow的release页面下载它。 然后,解压文件并将二进制文件放入你的$PATH中。 Step2:安装Kubeflow 首先,指定一个文件夹存储所有的Kubeflow YAML文件。 $ export KFAPP=~/kfapp 下载kfctl配置文件: wget https://raw.githubusercontent.com/kubeflow/manifests/v1.0-branch/kfdef/kfctl_k8s_istio.v1.0.2.yaml 请注意:如果你已经安装了Istio,则需要编辑kfctl_k8s_istio.v1.0.2.yaml并删除istio-crds和istio-install应用程序条目。 然后,导出CONFIG_URI: $ export CONFIG_URI="/path/to/kfctl_k8s_istio.v1.0.2.yaml" 接下来,你需要指定一堆环境变量,这些环境变量将指示Kubeflow配置文件下载到的位置: export KF_NAME=kubeflow-deployment export BASE_DIR=/opt export KF_DIR=${BASE_DIR}/${KF_NAME} 安装Kubeflow: % mkdir -p ${KF_DIR} % cd ${KF_DIR} % kfctl apply -V -f ${CONFIG_URI} 你需要一些时间等待一切都设置完毕。 访问Kubeflow UI 要访问UI,我们需要知道Web UI所在的端口: % kubectl -n istio-system get svc istio-ingressgateway 返回以下内容: NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE istio-ingressgateway NodePort 10.43.197.63 <none> 15020:30585/TCP,**80:31380/TCP**,443:31390/TCP,31400:31400/TCP,15029:32613/TCP,15030:32445/TCP,15031:30765/TCP,15032:32496/TCP,15443:30576/TCP 61m 在本例中,它是80:31380,这意味着你可以通过http://localhost:31380 访问Kubeflow UI: 如果你成功地看到了这个页面,那么恭喜你,你已经成功设置Kubeflow🎉 结 论 在本文中,我们首先探讨了为什么需要诸如Kubeflow这类工具——以控制机器学习本身的复杂性。接下来,我们按照步骤为集群进行机器学习工作做好了准备,尤其需要确保该集群可以利用可用的NVIDIA GPU。 在设置NFS时,我们探索了Rancher的应用商店,并将Helm Chart添加到应用商店中。它为我们提供了在Kubernetes集群上可以安装的所有Kubernetes应用程序。最后,我们完成了在集群上安装Kubeflow的步骤。
优秀的个人博客,低调大师

Java并发编程(02):线程核心机制,基础概念扩展

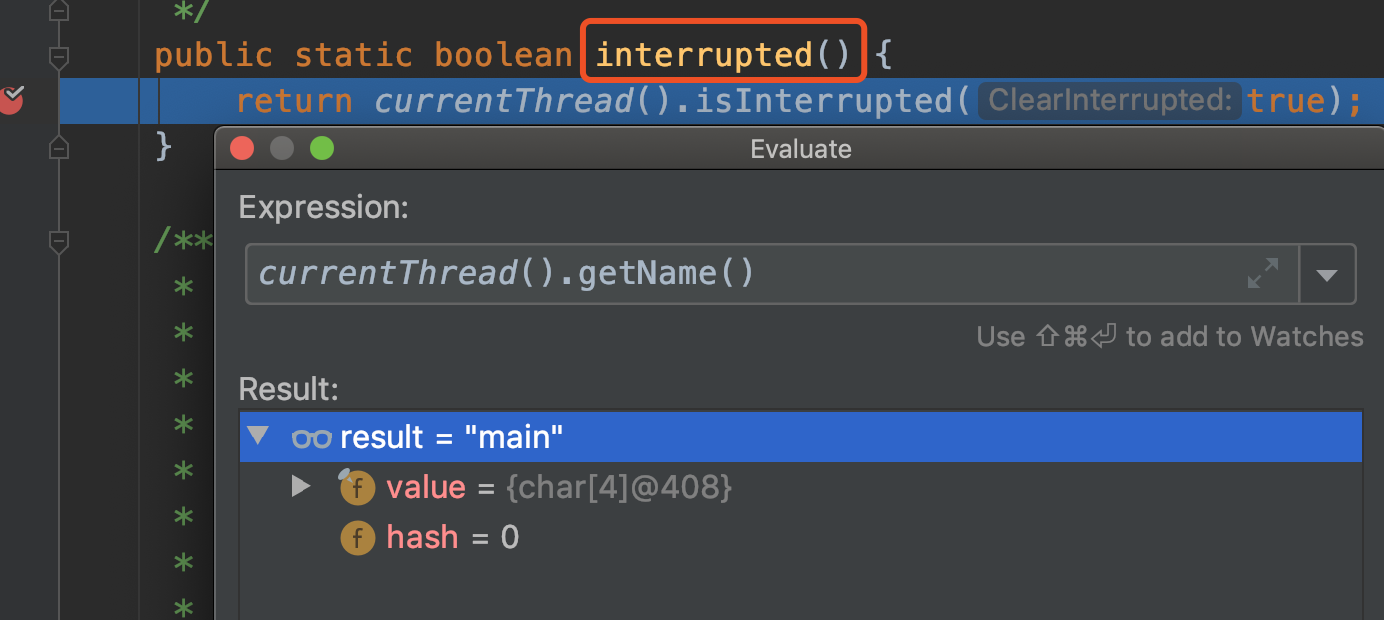
一、线程基本机制 1、概念描述 并发编程的特点是:可以将程序划分为多个分离且独立运行的任务,通过线程来驱动这些独立的任务执行,从而提升整体的效率。下面提供一个基础的演示案例。 2、应用案例 场景:假设有一个容器集合,需要拿出容器中的每个元素,进行加工处理,一般情况下直接遍历就好,如果数据偏大,可以根据线程数量对集合切割,每个线程处理一部分数据,这样处理时间就会减少很多。 public class ExtendThread01 { public static void main(String[] args) { List<Object> dataList = new ArrayList<>() ; dataList.add("A"); dataList.add("B"); dataList.add("C"); // 把一个大的集合按照每个子集合的2个元素切割 List<List<Object>> splitList = splitList(dataList,2); for (List<Object> list:splitList){ System.out.println(list); } // 多线程处理 for (List<Object> childList:splitList){ ListTask listTask = new ListTask(childList) ; Thread runThread = new Thread(listTask); runThread.start(); } } /** * List 集合切割 */ private static List<List<Object>> splitList (List<Object> list, int childSize) { if (list == null || list.size() == 0 || childSize < 1) { return null; } List<List<Object>> result = new ArrayList<>(); int size = list.size(); int count = (size + childSize - 1) / childSize ; for (int i = 0; i < count; i++) { List<Object> subList = list.subList(i * childSize, ((i + 1) * childSize > size ? size : childSize * (i + 1))); result.add(subList); } return result; } } class ListTask implements Runnable { private List<Object> list ; public ListTask (List<Object> list){this.list=list;} @Override public void run() { for (Object object:list){ System.out.println(Thread.currentThread().getName()+"=="+object); } } } 注意:这里案例只是对场景原理的实现,在开发中,是不允许这种操作的,需要使用线程池处理,后续会说。如果集合没有控制好,导致大量创建Thread线程,导致内存溢出。 二、线程停止启动 1、基础流程 线程启动后执行任务方法,在执行过程中可以被阻塞,休眠,唤醒,停止等一系列状态操作。 线程休眠作用:当线程一部分任务执行完毕后进入休眠(阻塞)状态,线程调度器可以切换到另外线程,这对分布任务的执行相对公平。 2、使用案例 public class ExtendThread02 { public static void main(String[] args) { StopThread stopThread = new StopThread() ; stopThread.start(); // 标记当前线程停止信号,且抛出中断异常,但没有停止 stopThread.interrupt(); // 判断当前线程是否已经是终止状态 System.out.println("1=="+stopThread.isInterrupted()); // 清除当前线程的终止信号 System.out.println("2=="+stopThread.interrupted()); // 再次判断当前线程状态 System.out.println("3=="+stopThread.isInterrupted()); System.out.println("main end ..."); } } class StopThread extends Thread { @Override public void run() { for (int i = 0 ; i < 10 ; i++){ try { System.out.println(Thread.currentThread().getId()+"="+i); // 线程阻塞1秒 Thread.sleep(1000); } catch (InterruptedException e){ e.printStackTrace(); } } } } 3、核心方法 sleep(long millis):线程休眠指定的时间,进入阻塞状态; interrupt():切换线程为中断状态,抛出中断异常,不会停止线程,可以监视线程的中断状态并定义执行策略。 interrupted():清除调用该方法线程的中断状态,也不会影响线程的执行,且返回当前执行‘stopThread.interrupted()’的线程是否中断,这里就是指main线程是否中断。 isInterrupted():判断调用该方法的线程是否已经是中断状态。 补刀一句:线程的这几个方法极其容易混淆,需要断点源码追踪一下看看,进入源码方法,调用相关API查看一下状态。(附断点图一张:) 三、线程优先级 1、基础概念 CPU执行和处理线程的顺序是不确定的,但是线程调度器倾向执行线程优先级高的线程,线程优先级高说明获取CPU资源的概率高,或者获取的执行时间分片多,但不代表优先级低的一定最后执行。 2、使用案例 public class ExtendThread03 { public static void main(String[] args) { Priority01 priority01 = new Priority01(); priority01.start(); System.out.println("priority01="+priority01.getPriority()); Priority02 priority02 = new Priority02(); priority02.start(); System.out.println("priority02="+priority02.getPriority()); priority01.setPriority(10); priority02.setPriority(1); } } class Priority01 extends Thread { @Override public void run() { for (int i = 0 ; i < 100 ; i++){ System.out.println(Thread.currentThread().getName()+";i="+i); } } } class Priority02 extends Thread { @Override public void run() { for (int a = 0 ; a < 100 ; a++){ System.out.println(Thread.currentThread().getName()+";a="+a); } } } 注意:优先级范围[MAX_PRIORITY=10,MIN_PRIORITY=1],如果超出范围会抛出IllegalArgumentException异常。 建议:通常实际开发中,是不允许轻易修改线程运行的参数,容易引发认知之外的异常。 四、线程加入 1、基本概念 如果在线程A中,执行线程B的加入方法,那么A线程就会等待线程B执行完毕再返回继续执行。 2、使用案例 public class ExtendThread04 { public static void main(String[] args) { JoinThreadA joinThreadA = new JoinThreadA() ; joinThreadA.start(); } } class JoinThreadA extends Thread { @Override public void run() { System.out.println("缺水中..."); JoinThreadB joinThreadB = new JoinThreadB() ; joinThreadB.start(); try{ joinThreadB.join(); } catch (Exception e){ e.printStackTrace(); } System.out.println("喝水中..."); } } class JoinThreadB extends Thread { @Override public void run() { System.out.println("买水中..."); try{ TimeUnit.SECONDS.sleep(2); } catch (Exception e){ e.printStackTrace(); } System.out.println("买到水..."); } } 注意:可以设置线程的加入时间join(long),毕竟等不到雪月风花,人生都是有时差,只能后会无期了。 五、本地线程 1、基本概念 本地的线程变量,底层维护ThreadLocalMap存储值: static class Entry extends WeakReference<ThreadLocal<?>> { Object value; Entry(ThreadLocal<?> k, Object v) { super(k); value = v; } } 即以Key-Value键值对的方式存储数据。如果对集合容器的源码熟悉的话,这个Entry就是似曾相识感觉。 2、使用案例 public class ExtendThread05 { private static final ThreadLocal<Long> threadLocal = new ThreadLocal<>() ; private static void initBegin (){ threadLocal.set(System.currentTimeMillis()); } private static Long overTime (){ return System.currentTimeMillis()-threadLocal.get(); } public static void main(String[] args) throws Exception { ExtendThread05.initBegin(); TimeUnit.SECONDS.sleep(3); System.out.println(ExtendThread05.overTime()); } } ThreadLocal提供线程内存储变量的能力,并且绑定到当前线程,通过get和set方法就可以得到和设置当前线程对应的值。这个在web开发中是常见的应用。 六、守护线程 1、基本概念 守护线程是支持辅助型线程,主要在程序中起到调度和支持性作用,当Jvm中非守护线程全部结束,守护线程也就会结束。 2、使用案例 public class ExtendThread06 { public static void main(String[] args) throws Exception { InputStreamReader is = new InputStreamReader(System.in); BufferedReader br = new BufferedReader(is); String value = br.readLine(); CheckThread checkThread = new CheckThread(value) ; checkThread.setDaemon(true); checkThread.start(); System.out.println("Main End ..."); } } class CheckThread extends Thread { private String spell ; public CheckThread (String spell){ this.spell = spell ; } @Override public void run() { if (spell.startsWith("cs")){ System.out.println(spell+":输入正确"); } else { System.out.println(spell+":输入错误"); } try { TimeUnit.SECONDS.sleep(10); } catch (InterruptedException e){ e.printStackTrace(); } } } 注意:守护线程需要显式调用setDaemon(true);方法,这里可以看到main线程结束,整合程序就结束了,丝毫理会休眠中的守护线程。如果打断非守护线程的休眠,试试会不会抛你一脸异常? 七、线程异常处理 1、机制描述 按照Java中异常处理机制,抛异常逐级降低,线程的任务方法run没有抛异常,那重写或者实现的方法自然不能直接throws异常出去。多线程中推荐捕获异常,可以针对性处理机制。 2、使用案例 public class ExtendThread07 { public static void main(String[] args) { TryThread tryThread = new TryThread(); tryThread.setName("try-name"); // 定义运行中异常处理策略 MyExe myExe = new MyExe() ; tryThread.setUncaughtExceptionHandler(myExe); tryThread.start(); } } class TryThread extends Thread { @Override public void run() { try { Thread.sleep(1000); } catch (InterruptedException e){ e.printStackTrace(); } // 如何处理这里异常? Integer.parseInt("cicada") ; } } class MyExe implements Thread.UncaughtExceptionHandler { @Override public void uncaughtException(Thread t, Throwable e) { System.out.println(t.getName()+";异常:"+e.getMessage()); } } 通过实现UncaughtExceptionHandler接口,并且线程要指定自定义异常处理对象,也可以处理未检查的异常。 八、源代码地址 GitHub·地址 https://github.com/cicadasmile/java-base-parent GitEE·地址 https://gitee.com/cicadasmile/java-base-parent

优秀的个人博客,低调大师

码良后端代码正式开源 —— 高扩展网页制作平台

源码部署 码良项目目前(2019/11/1)已经完全开源。因此这里说明下如何使用源码将整个项目运行起来。 项目构成 码良系统由3个项目构成,分别是gods-pen-server 码良服务端、gods-pen-admin 码良管理后台以及于7月份就已经开源的gods-pen码良编辑器。 从上述项目的名称上很容易看出各部分之功能,这里不再赘述。 其中码良编辑器和码良管理后台是 vue 项目,码良服务端是基于 egg 的 nodejs 项目。 开发环境运行 鉴于项目略多,我们开发了一个小工具来帮助您完成大部分工作,比如项目拉取、依赖安装、dev 运行等。 # 全局安装 gods-pen-cli 工具 npm install gods-pen-cli -g 运行gods-pen serve help可以看到有三个子命令。 gods-pen serve fetch 使用gods-pen serve fetch拉取代码并安装依赖。工具自动在当前目录(cwd)目录拉取项目源码(如果 git 可用,则使用git),然后依次安装项目依赖。 当然,你也可以不借助这个工具,从 github clone 项目即可。安装依赖也很简单,分别在三个项目根目录下yarn搞定。 项目配置 码良依赖了 es、redis、mysql、邮件、oss服务,因此需要配置这些服务的信息。 如果你有读过前一篇文档“docker 部署”部分,您应该知道我们在 docker 部署方式下默认提供了 es、redis、mysql 服务。但是在源码部署方式下,很难为您准备好这一切第三方服务,您需要选用云服务商提供的服务或者自建服务(安装 mysql、es、redis),这里不再详细叙述。对了,目前仅支持阿里云的 oss 服务(使用了对应的api)。 在获得了上述第三方服务之后,除 mysql 外,您无需对这些服务进行额外的初始化操作。当然,建立 oss bucket 这种操作就不提了。 mysql 需要提前使用gods-pen-server/sql/init.sql来初始化表结构和表数据。 mysql -h <host> -u<user> -p<password> < sql/init.sql # 请将<host> <user> <password> 换成实际值 至此,配置准备工作完成。 我们有三个项目,但是实际上,您无需逐一配置,我们已经提供了合适的默认配置,你只需要配置好第三方服务的信息即可,将信息填入gods-pen-server/config/config.dev.js gods-pen serve start 在当前目录(记得从 gods-pen-server 返回上一级)下运行gods-pen serve start,即可启动所有服务。 启动成功后访问http://127.0.0.1:8567注册用户、登陆系统 生产环境部署 生产环境的部署分两部分,前端静态资源的部署和 nodejs 服务的部署。 nodejs 服务 将 gods-pen-server 项目 clone 到服务器内,这一步您也可以通过 gods-pen 工具完成,类似上面开发环境的操作。 依赖安装好后,将第三方 es、redis、mysql、邮件、oss 服务信息配置到gods-pen-server/config/config.production.js内。 运行npm run serve启动服务,服务启动后,服务地址为http://127.0.0.1:7051/api 您应该使用 nginx 或其他服务器软件对 api 服务进行合理配置,使得外网能方便访问,比如将abc.com/api转发到 127.0.0.1:7051/api server { listen 80; server_name abc.com; # 您的实际 ip 或者域名 root /usr/share/nginx/html; # api 反向代理 location ^~ /api { proxy_pass http://127.0.0.1:7051; } } 前端项目部署 将 gods-pen-admin 和 gods-pen 项目 clone 下来,或者通过 gods-pen 工具也行。 安装依赖,然后在gods-pen-admin/src/config/production.js和gods-pen/src/config/production.js中添加配置API_PATH module.exports = { API_PATH: 'http://abc.com/api' # 配置为实际 nodejs api 服务外网可访问的路径 } 在当前目录(gods-pen-admin 的上一级)运行gods-pen serve build开始构建项目,完成后所有输出文件集中在当前目录下的 gods-pen-dist 下。 使用 nginx 或者其他服务器软件启动静态资源服务,将 gods-pen-dist 下所有文件复制到服务器软件指定目录下,您可以通过http://abc.com/admin访问到码良系统的入口页面 以下是一个 nginx 配置文件示例 server { listen 80; server_name abc.com; # 您的实际 ip 或者域名 root /usr/share/nginx/html; # 静态资源文件存放路径 # gzip gzip on; gzip_min_length 256; gzip_vary on; gzip_types *; # 所有静态资源及缓存 location ~* .*\.(jpg|gif|jpeg|css|png|js|wasm) { expires 10d; } # view路径,即渲染器,需要开启 history 模式 location ~* ^\/view\/[a-zA-Z0-9]+(\/|\?.*|)$ { index index.html; try_files $uri $uri/ /view/index.html; } # api 反向代理 location ^~ /api { proxy_pass http://godspen:7051; } } troubleshooting 拉取代码失败 由于一些众所周知的原因,github 的服务在某些时间某些网络环境下是不稳定的,如果出现了代码拉取失败的情况,请为你的命令行环境设置代理后再运行gods-pen serve fetch 安装依赖失败 这是由于缺少 c++ 编译环境造成部分 npm包编译失败,则通常发生在 window 系统上,您可以尝试全局安装 windows-build-tools windows-build-tools 是一个 npm 包,可以一键安装 c++ 编译所需的 python27、Visual Studio、C++ Build Tool 等。 Both installations are conflict-free, meaning that they do not mess with existing installations of Visual Studio, C++ Build Tools, or Python 另外上述问题在 python2 命令不可用时也会发生,如果您的机器没有安装 python 或者只安装了 python3 时,请安装 python27,或使用 pyenv 将 python 版本切换至 python2

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册