首页 文章 精选 留言 我的

精选列表

搜索[搜索引擎平台],共10000篇文章
优秀的个人博客,低调大师

22、Python快速开发分布式搜索引擎Scrapy精讲—scrapy模拟登陆和知乎倒立文字验证码识别

转自: http://www.bdyss.cn http://www.swpan.cn 第一步。首先下载,大神者也的倒立文字验证码识别程序 下载地址:https://github.com/muchrooms/zheye 注意:此程序依赖以下模块包 Keras==2.0.1 Pillow==3.4.2 jupyter==1.0.0 matplotlib==1.5.3 numpy==1.12.1 scikit-learn==0.18.1 tensorflow==1.0.1 h5py==2.6.0 numpy-1.13.1+mkl 我们用豆瓣园来加速安以上依赖装如: pipinstall-ihttps://pypi.douban.com/simpleh5py==2.6.0 如果是win系统,可能存在安装失败的可能,如果那个包安装失败,就到 http://www.lfd.uci.edu/~gohlke/pythonlibs/ 找到win对应的版本下载到本地安装,如: pipinstallh5py-2.7.0-cp35-cp35m-win_amd64.whl 第二步,将者也的,验证码识别程序的zheye文件夹放到工程目录里 第三步,爬虫实现 start_requests()方法,起始url函数,会替换start_urls Request()方法,get方式请求网页 url=字符串类型url headers=字典类型浏览器代理 meta=字典类型的数据,会传递给回调函数 callback=回调函数名称 scrapy.FormRequest()post方式提交数据 url=字符串类型url headers=字典类型浏览器代理 meta=字典类型的数据,会传递给回调函数 callback=回调函数名称 formdata=字典类型,要提交的数据字段 response.headers.getlist('Set-Cookie')获取响应Cookiesresponse.request.headers.getlist('Cookie')获取请求Cookies #-*-coding:utf-8-*- importscrapy fromscrapy.httpimportRequest,FormRequest importre classPachSpider(scrapy.Spider):#定义爬虫类,必须继承scrapy.Spider name='pach'#设置爬虫名称 allowed_domains=['zhihu.com']#爬取域名 #start_urls=['']#爬取网址,只适于不需要登录的请求,因为没法设置cookie等信息 header={'User-Agent':'Mozilla/5.0(WindowsNT10.0;WOW64;rv:54.0)Gecko/20100101Firefox/54.0'}#设置浏览器用户代理 defstart_requests(self):#起始url函数,会替换start_urls """第一次请求一下登录页面,设置开启cookie使其得到cookie,设置回调函数""" return[Request( url='https://www.zhihu.com/#signin', headers=self.header, meta={'cookiejar':1},#开启Cookies记录,将Cookies传给回调函数 callback=self.parse )] defparse(self,response): #响应Cookies Cookie1=response.headers.getlist('Set-Cookie')#查看一下响应Cookie,也就是第一次访问注册页面时后台写入浏览器的Cookie print('后台首次写入的响应Cookies:',Cookie1) #获取xsrf密串 xsrf=response.xpath('//input[@name="_xsrf"]/@value').extract()[0] print('获取xsrf密串:'+xsrf) #获取验证码 importtime t=str(int(time.time()*1000)) captcha_url='https://www.zhihu.com/captcha.gif?r={0}&type=login&lang=cn'.format(t)#构造验证码请求地址 yieldRequest(url=captcha_url,#请求验证码图片 headers=self.header, meta={'cookiejar':response.meta['cookiejar'],'xsrf':xsrf},#将Cookies和xsrf密串传给回调函数 callback=self.post_tj ) defpost_tj(self,response): withopen('yzhm.jpg','wb')asf:#打开图片句柄 f.write(response.body)#将验证码图片写入本地 f.close()#关闭句柄 #---------------------------者也验证码识别----------------------- fromzheyeimportzheye#导入者也倒立文字验证码识别模块对象 z=zheye()#实例化对象 positions=z.Recognize('yzhm.jpg')#将验证码本地路径传入Recognize方法识别,返回倒立图片的坐标 #print(positions)#默认倒立文字的y坐标在前,x坐标在后 #知乎网要求的倒立文字坐标是x轴在前,y轴在后,所以我们需要定义一个列表来改变默认的,倒立文字坐标位置 pos_arr=[] iflen(positions)==2: ifpositions[0][1]>positions[1][1]:#判断列表里第一个元祖里的第二个元素如果大于,第二个元祖里的第二个元素 pos_arr.append([positions[1][1],positions[1][0]]) pos_arr.append([positions[0][1],positions[0][0]]) else: pos_arr.append([positions[0][1],positions[0][0]]) pos_arr.append([positions[1][1],positions[1][0]]) else: pos_arr.append([positions[0][1],positions[0][0]]) print('处理后的验证码坐标',pos_arr) #-------------者也验证码识别结束-------- iflen(pos_arr)==2: data={#设置用户登录信息,对应抓包得到字段 '_xsrf':response.meta['xsrf'], 'password':'279819', 'captcha':'{"img_size":[200,44],"input_points":[[%.2f,%f],[%.2f,%f]]}'%( pos_arr[0][0]/2,pos_arr[0][1]/2,pos_arr[1][0]/2,pos_arr[1][1]/2),#因为验证码识别默认是400X88的尺寸所以要除以2 'captcha_type':'cn', 'phone_num':'15284816568' } else: data={#设置用户登录信息,对应抓包得到字段 '_xsrf':response.meta['xsrf'], 'password':'279819', 'captcha':'{"img_size":[200,44],"input_points":[[%.2f,%f]]}'%( pos_arr[0][0]/2,pos_arr[0][1]/2), 'captcha_type':'cn', 'phone_num':'15284816568' } print('登录提交数据',data) print('登录中....!') """第二次用表单post请求,携带Cookie、浏览器代理、用户登录信息,进行登录给Cookie授权""" return[scrapy.FormRequest( url='https://www.zhihu.com/login/phone_num',#真实post地址 meta={'cookiejar':response.meta['cookiejar']},#接收第传过来的Cookies headers=self.header, formdata=data, callback=self.next )] defnext(self,response): #请求Cookie Cookie2=response.request.headers.getlist('Cookie') print('登录时携带请求的Cookies:',Cookie2) jieg=response.body.decode("utf-8")#登录后可以查看一下登录响应信息 print('登录响应结果:',jieg) print('正在请需要登录才可以访问的页面....!') """登录后请求需要登录才能查看的页面,如个人中心,携带授权后的Cookie请求""" yieldRequest( url='https://www.zhihu.com/people/lin-gui-xiu-41/activities', headers=self.header, meta={'cookiejar':True}, callback=self.next2 ) defnext2(self,response): #请求Cookie Cookie3=response.request.headers.getlist('Cookie') print('查看需要登录才可以访问的页面携带Cookies:',Cookie3) leir=response.xpath('/html/head/title/text()').extract()#得到个人中心页面 print('最终内容',leir) #print(response.body.decode("utf-8")) 【转载自:http://www.lqkweb.com】

优秀的个人博客,低调大师

JeeSite 平台 Spring Boot 3 体验版发布,一个 Java 快速开发平台

引言 是时候为 Spring Boot 3 做准备了,2018年2月 Spring Boot 进入 2.0 时代,距今已经 5 年了。2022 年 11 月 Spring Boot 3.0 正式发布,它将基于 Spring Framework 6.0,并且需要 Java 17 版本,同时它也将是 Jakarta EE 9 的第一个 Spring Boot 版本。如今 Spring Boot 3.1 已经发布,也带来了非常好的新特性,同时也支持了 Java 20。 为跟近技术时代,周边生态依赖库大部分也对 Spring Boot 3 做了相应支持,所以JeeSite 是时候发布Spring Boot 3 版本了。 同时 JeeSite 对 Spring Boot 2 的版本将持续更新,请大家放心使用。 技术栈 JDK 17+ Servlet 5.0+ Jakarta 6.0.0 Spring Boot 3.1.1 Apache Shiro 2.0.0 Spring Cloud 2022.0.3 Spring Cloud Alibaba 2022.0.0 Spring Framework 6.0.10 OpenAPI 3 and Springdoc 2.0 Atomiko Transactions 6.0 Spring Boot Admin 3.1 Flowable 7.0.0 等等众多依赖更新 Vue分离端 Ant Design Vue 4.0.0 功能国际化语言包完善 等等众多依赖更新 下载地址 JeeSite:https://gitee.com/thinkgem/jeesite4/tree/v5.springboot3/ JeeSite Cloud:https://gitee.com/thinkgem/jeesite4-cloud/tree/v5.springboot3.cloud/ JeeSite Vue:https://gitee.com/thinkgem/jeesite-vue/tree/next/ 我可以升级上来吗? 可以,自JeeSite 4版本开始,JeeSite团队就非常重视从旧版本升级的问题,除了向下兼容,我们也抛弃一些必要的变更。如果你对JeeSite改动不大,业务代码上升级是比较容易的,后面我们将在官方文档补充升级方法。

优秀的个人博客,低调大师

Java 利用SpringBoot为Android,iOS等移动平台搭建简单的Restful后台接口平台

作为移动端开发者来说,一般情况下,我们是不需要管理后台接口,只需要调用就可以了;但有时候,我们想要自己来实现接口,就得需要搭建自己的后台接口 当然实现方式有很多,我对Java比较熟悉,这里就说下用Java等框架来实现Restful接口。大学的时候,我们学过利用较为原始的Servelet来实现,当然会显得很臃肿,写起来也很麻烦,所以这里就利用SpringBoot框架来实现,大量的注解会让我们实现起来很方便,也省去了很多配置 这里我使用Intellij Idea编译器来创建工程,这里的选项有很多,现在一步步来创建工程 如果没有Spring Initializr这个选项,就在插件配置中安装即可,这里就不再赘述 接下来就直接下一步,现在我们到项目中的结构看一下 重点来看下TestController.java这个类 package springdemo; import org.springframework.web.bind.annotation.RequestMapping; import org.springframework.web.bind.annotation.RequestMethod; import org.springframework.web.bind.annotation.RestController; /** * Created by on 2018/5/7. */ @RequestMapping //是一个用来处理请求地址映射的注解,可用于类或方法上。用于类上,表示类中的所有响应请求的方法都是以该地址作为父路径 @RestController //用来返回Json public class TestController { /** * 注解中的第一个参数是访问的路径,第二个参数是请求方式 * @return */ @RequestMapping(value = "/info",method = RequestMethod.GET) public Info getInfo(){ Info info = new Info(); info.id = "59192"; info.data = "It's name is too complaint..."; return info; } } 代码很简单,省去了很多配置 运行来看下效果: 本地访问没有问题,结果也是JSON数据。 如果要部署到自建的Tomcat容器中也很简单,将项目打成.jar或者.war即可,需要访问数据库,利用现有的ORM框架,也只需要配置一下就可以了 以上就是很简单的后台接口开发,如今很多项目已经开发向微服务靠拢了(或者直接利用AWS等,开发者只管自己的业务,其他的都是现成的,工作量少了很多),或者是直接node.js实现后台接口,所以技术的发展很快,但是只要掌握基本的原理,一门新技术也是手到擒来 当然大部分业务都是简单的CURD(增删改查),上手很容易的,初学者很快就能掌握 PS:补一个很简单的demo,我会定时更新Springboot的各种用法 https://github.com/helang1991/springboot

优秀的个人博客,低调大师

微信公众平台开发模式 微信 语音识别 公众平台 消息接口 语音识别

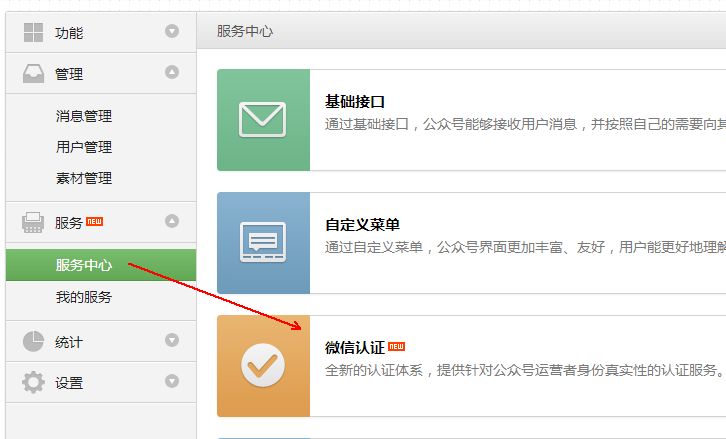
一、申请微信认证 微信认证后将自动开通高级接口,获得高级接口中所有接口权限,无需二次申请。 高级接口含有获取用户基本信息、客服接口、语音识别等高级接口权限。 二、获取语音识别结果 开通语音识别功能,且该功能设置处于开启状态的公众帐号,用户每次发送语音给公众号时,微信会在推送的语音消息XML数据包中,增加一个Recongnition字段。 开启语音识别后的语音XML数据包如下: <xml> <ToUserName><![CDATA[toUser]]></ToUserName> <FromUserName><![CDATA[fromUser]]></FromUserName> <CreateTime>1357290913</CreateTime> <MsgType><![CDATA[voice]]></MsgType> <MediaId><![CDATA[media_id]]></MediaId> <Format><![CDATA[Format]]></Format> <Recognition><![CDATA[深圳天气怎么样]]></Recognition> <MsgId>1234567890123456</MsgId> </xml> 参数说明: 参数 描述 ToUserName 开发者微信号 FromUserName 发送方帐号(一个OpenID) CreateTime 消息创建时间 (整型) MsgType 语音为voice MediaID 语音消息媒体id,可以调用多媒体文件下载接口拉取该媒体 Format 语音格式:amr Recognition 语音识别结果,UTF8编码 MsgID 消息id,64位整型 三、使用中文分词提取关键特征 中文分词 (Chinese Word Segmentation) 指的是将一个汉字序列切分成一个一个单独的词。分词就是将连续的字序列按照一定的规范重新组合成词序列的过程。我们知道,在英文的行文中,单词之间是以空格作为自然分界符的,而中文只是字、句和段能通过明显的分界符来简单划界,唯独词没有一个形式上的分界符,虽然英文也同样存在短语的划分问题,不过在词这一层上,中文比之英文要复杂的多、困难的多。通过分词可以提取其中关键词语进行搜索。 打个比方: 例如,识别结果为”深圳天气怎么样”,可分词为”深圳”,”怎么样”,三个词。我们提取出“天气”作为名词,“深圳”作为地点名词, 以下是SAE上的分词代码示例: <?php $str = "深圳天气怎么样"; $seg = new SaeSegment(); $ret = $seg->segment($str, 1); print_r($ret); //输出 if ($ret === false) var_dump($seg->errno(), $seg->errmsg()); ?> 识别结果如下: Array ( [0] => Array ( [word] => 深圳 [word_tag] => 102 [index] => 0 ) [1] => Array ( [word] => 天气 [word_tag] => 95 [index] => 1 ) [2] => Array ( [word] => 怎么样 [word_tag] => 40 [index] => 2 ) ) //词性对应关系 POSTAG_ID_N = 95 (line 322) 名词 POSTAG_ID_NS_Z = 102 (line 357) 地名(名处词专指:“中国”) POSTAG_ID_D = 40 (line 207) 副词 三、程序实现 判断是否开启语音识别 private function receiveVoice($object) { if (isset($object->Recognition) && !empty($object->Recognition)){ $contentStr = "你发送的是语音,内容为:".$object->Recognition; }else{ $contentStr = "未开启语音识别功能或者识别内容为空"; } if (is_array($contentStr)){ $resultStr = $this->transmitNews($object, $contentStr); }else{ $resultStr = $this->transmitText($object, $contentStr); } return $resultStr; } 效果如下: 调用SAE分词 var_dump(segment("明天长沙天气怎么样")); function segment($str) { $seg = new SaeSegment(); $ret = $seg->segment($str, 1); if ($ret === false){ return; } $category = ""; $keyword = ""; foreach ($ret as $key => $value) { if ($value["word_tag"] == 95){ $category = $value["word"]; } if ($value["word_tag"] == 102){ $keyword = $value["word"]; } } if (!empty($category) && !empty($keyword)){ return array('category'=>$category, 'keyword'=>$keyword); }else{ return; } } 返回结果如下: array(2) { ["category"]=>string(6) "天气" ["keyword"]=>string(6) "长沙" } 这样就获知晓了用户要查询的功能是天气,城市名称是长沙。 功能查询 根据获得的功能类别及关键字,我们可以查询相应的城市天气预报。 include("segment.php"); $result = sinasegment($content); if (is_array($result)){ switch ($result['category']) { case "天气": $url = "http://api100.duapp.com/weather/?appkey=trialuser&city=".urlencode($result['keyword']); $output = file_get_contents($url); $contentStr = json_decode($output, true); break; case "空气": $url = "http://api100.duapp.com/airquality/?appkey=trialuser&city=".urlencode($result['keyword']); $output = file_get_contents($url); $contentStr = json_decode($output, true); break; default: $contentStr = "还不支持这一功能:".$result['category']; break; } }else{ $contentStr = "不能理解你的内容:".$content; } 四、效果演示 本文转自左正博客园博客,原文链接:http://www.cnblogs.com/soundcode/p/4906860.html ,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册