首页 文章 精选 留言 我的

精选列表

搜索[面试],共5090篇文章
优秀的个人博客,低调大师

那些年面试官问你的红黑树----->(浅谈)

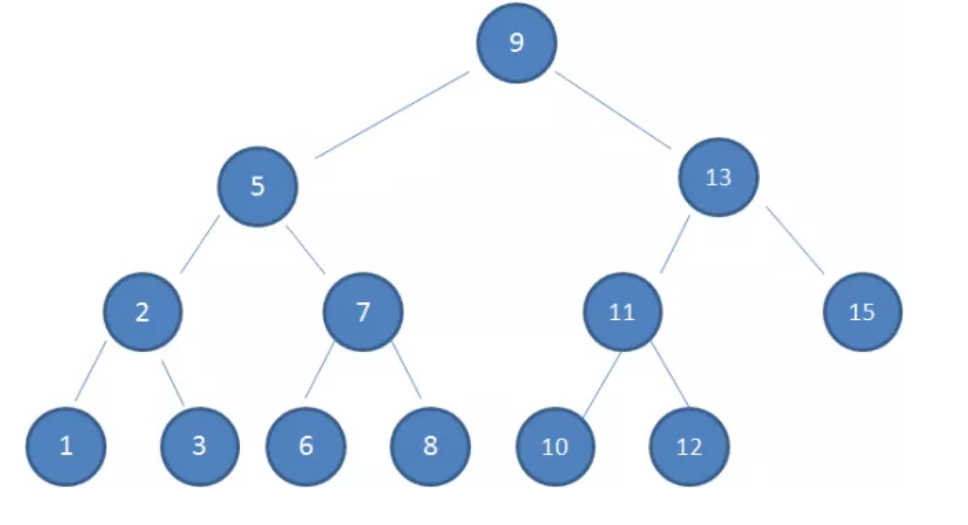
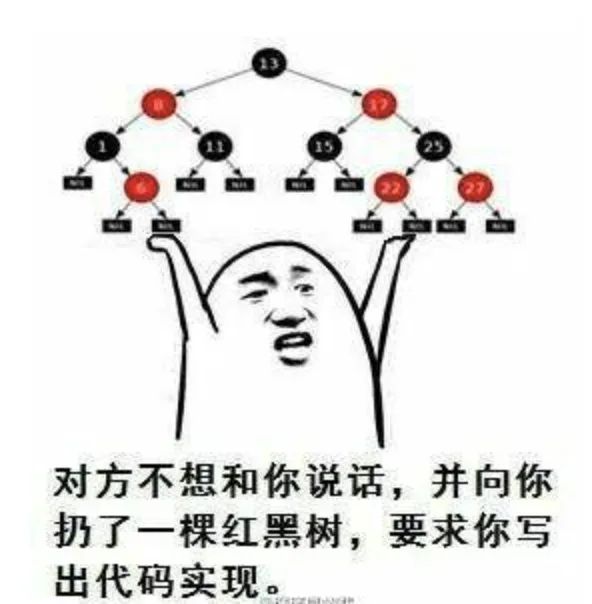
在了解红黑树之前,先要了解二叉树,又叫二叉查找树、二叉搜索树、二叉排序树。二叉树顾名思义: 是一种每个节点最多有两个子节点的树,同时遵循 左节点的值<父节点的值<右节点的值 这样的规律。 二叉树有如下几个特点: 节点的左子节点小于节点本身 节点的右子节点大于节点本身 左右节点同样为二叉搜索树 下图就是一棵典型的二叉树: 它是一种查找次数小于等于树高的数据结构。如图中树有4层,即树高为4,当我们需要查找8时,经过的路线是这样的: 1、8<9,往左查找 2、8>5,往右查找 3、8>7,往右查找 4、8=8,找到结果 总共查找4次,等于树高。这棵树不管怎么找,查找次数总是小于等于树高。 二叉树的插入同样遵循上述规则,会一步一步对比,从而找到插入的位置,可以想象上图中的8不存在,而是需要插入一个8,结果与上述路线一致。 二叉树的删除会涉及到无子节点和有子节点两种情况,无子节点直接删除即可,有子节点会需要用左边最大值或右边最小值替换当前删除节点,具体不细聊。 当二叉树插入数值不均衡时,会出现树结构的变形与查找性能的损耗,比如现在二叉树有8,9,12三个值,然后需要插入7,6,5,4,3这五个值时,产生的结构如下图所示: 树高会不合理的增高,查找效率也无法得到保证。红黑树就是为了解决这种情况而诞生的。 红黑树又称为自平衡二叉树,它符合二叉树的规则同时比它的规则更加的复杂,具体规则如下: 1、所有节点都是红色或黑色 2、根节点为黑色 3、所有叶子都是黑色(NIL节点) 4、每个红色节点必须有两个黑色的子节点。(不能有两个连续的红色节点。) 5、从任一节点到其每个叶子的所有简单路径(不要回退)都包含相同数目的黑色节点。 具体样子如下图所示: 解释一下几个规则的含义: 1和2很好理解,节点都是红和黑,根节点是黑色的。 3所有叶子都是黑色的,叶子与叶子节点是两个概念,叶子不是一个节点,可以理解为没有数值的空节点,也就是图中的NIL。 4也很好理解,红色节点的子节点都是黑色的,这就保证了没有两个连续的红色节点。 5稍微解释一下,简单路径就是说一次到底,不要回退,叶子就是NIL,比如从8这个节点出发,不管是去1下面的叶子,11下面的叶子,还是6下面的叶子,都是经过一个黑色节点,从任何节点出发都是一样的规则,经过相同数量的黑色节点。 以上5个规则,加上二叉树的规则,就组成了红黑树这一极具特点的树型数据结构。

优秀的个人博客,低调大师

设计模式常见面试知识点总结(Java版)

设计模式 这篇总结主要是基于我设计模式系列的文章而形成的的。主要是把重要的知识点用自己的话说了一遍,可能会有一些错误,还望见谅和指点。谢谢 更多详细内容可以到我的cdsn博客上查看: https://blog.csdn.net/a724888 最后,如果想要更好地完成这部分内容的学习,建议大家还是去看一下原文。 创建型模式 创建型模式 创建型模式的作用就是创建对象,说到创建一个对象,最熟悉的就是 new 一个对象,然后 set 相关属性。但是,在很多场景下,我们需要给客户端提供更加友好的创建对象的方式,尤其是那种我们定义了类,但是需要提供给其他开发者用的时候。 单例 单例模式保证全局的单例类只有一个实例,这样的话使用的时候直接获取即可,比如数据库的一个连接,Spring里的bean,都可以是单例的。 单例模式一般有5种写法。 第一种是饿汉模式,先把单例进行实例化,获取的时候通过静态方法直接获取即可。缺点是类加载后就完成了类的实例化,浪费部分空间。 第二种是饱汉模式,先把单例置为null,然后通过静态方法获取单例时再进行实例化,但是可能有多线程同时进行实例化,会出现并发问题。 第三种是逐步改进的方法,一开始可以用synchronized关键字进行同步,但是开销太大,而后改成使用volatile修饰单例,然后通过一次检查判断单例是否已初始化,如果未初始化就使用synchronized代码块,再次检查单例防止在这期间被初始化,而后才真正进行初始化。 第四种是使用静态内部类来实现,静态内部类只在被使用的时候才进行初始化,所以在内部类中进行单例的实例化,只有用到的时候才会运行实例化代码。然后外部类再通过静态方法返回静态内部类的单例即可。 第五种是枚举类,枚举类的底层实现其实也是内部类。枚举类确保每个类对象在全局是唯一的。所以保证它是单例,这个方法是最简单的。 工厂模式 简单工厂一般是用一个工厂创建多个类的实例。 工厂模式一般是指一个工厂服务一个接口,为这个接口的实现类进行实例化 抽象工厂模式是指一个工厂服务于一个产品族,一个产品族可能包含多个接口,接口又会包含多个实现类,通过一个工厂就可以把这些绑定在一起,非常方便。 原型模式 一般通过一个实例进行克隆从而获得更多同一原型的实例。使用实例的clone方法即可完成。 建造者模式 建造者模式中有一个概念叫做链式调用,链式调用为一个类的实例化提供便利,一般提供系列的方法进行实例化,实际上就是将set方法改造一下,将原本返回为空的set方法改为返回this实例,从而实现链式调用。 建造者模式在此基础上加入了builder方法,提供给外部进行调用,同样使用链式调用来完成参数注入。 结构型模式 结构型模式 前面创建型模式介绍了创建对象的一些设计模式。 这节介绍的结构型模式旨在通过改变代码结构来达到解耦的目的,使得我们的代码容易维护和扩展。 桥接模式 有点复杂。建议参考原文 适配器模式 适配器模式用于将两个不同的类进行适配。 适配器模式和代理模式的异同 比较这两种模式,其实是比较对象适配器模式和代理模式,在代码结构上, 它们很相似,都需要一个具体的实现类的实例。 但是它们的目的不一样,代理模式做的是增强原方法的活; 适配器做的是适配的活,为的是提供“把鸡包装成鸭,然后当做鸭来使用”, 而鸡和鸭它们之间原本没有继承关系。 适配器模式可以分为类适配器,对象适配器等。 类适配器通过继承父类就可以把自己适配成父类了。 而对象适配器则需要把对象传入另一个对象的构造方法中,以便进行包装。 享元模式 享元模式的核心在于享元工厂类, 享元工厂类的作用在于提供一个用于存储享元对象的享元池, 用户需要对象时,首先从享元池中获取, 如果享元池中不存在,则创建一个新的享元对象返回给用户, 在享元池中保存该新增对象。 代理模式 我们发现没有,代理模式说白了就是做 “方法包装” 或做 “方法增强”。 在面向切面编程中,算了还是不要吹捧这个名词了,在 AOP 中, 其实就是动态代理的过程。比如 Spring 中, 我们自己不定义代理类,但是 Spring 会帮我们动态来定义代理, 然后把我们定义在 @Before、@After、@Around 中的代码逻辑动态添加到代理中。 外观模式 外观模式一般封装具体的实现细节,为用户提供一个更加简单的接口。 通过一个方法调用就可以获取需要的内容。 组合模式 组合模式用于表示具有层次结构的数据,使得我们对单个对象和组合对象的访问具有一致性。 直接看一个例子吧,每个员工都有姓名、部门、薪水这些属性, 同时还有下属员工集合(虽然可能集合为空), 而下属员工和自己的结构是一样的, 也有姓名、部门这些属性, 同时也有他们的下属员工集合。 class Employee { private String name; private String dept; private int salary; private List<Employee> subordinates; // 下属 } 装饰者模式 装饰者 装饰者模式把每个增强类都继承最高级父类。然后需要功能增强时把类实例传入增强类即可,然后增强类在使用时就可以增强原有类的功能了。 和代理模式不同的是,装饰者模式每个装饰类都继承父类,并且可以进行多级封装。 行为型模式 行为型模式 行为型模式关注的是各个类之间的相互作用,将职责划分清楚,使得我们的代码更加地清晰。 策略模式 策略模式一般把一个策略作为一个类,并且在需要指定策略的时候传入实例,于是我们可以在需要使用算法的地方传入指定算法。 命令模式 命令模式一般分为命令发起者,命令以及命令接受者三个角色。 命令发起者在使用时需要注入命令实例。然后执行命令调用。 命令调用实际上会调用命令接收者的方法进行实际调用。 比如遥控器按钮相当于一条命令,点击按钮时命令运行,自动调用电视机提供的方法即可。 模板方法模式 模板方法一般指提供了一个方法模板,并且其中有部分实现类和部分抽象类,并且规定了执行顺序。 实现类是模板提供好的方法。而抽象类则需要用户自行实现。 模板方法规定了一个模板中方法的执行顺序,非常适合一些开发框架,于是模板方法也广泛运用在开源框架中。 观察者模式和事件监听机制 观察者模式一般用于订阅者和消息发布者之间的数据订阅。 一般分为观察者和主题,观察者订阅主题,把实例注册到主题维护的观察者列表上。 而主题更新数据时自动把数据推给观察者或者通知观察者数据已经更新。 但是由于这样的方式消息推送耦合关系比较紧。并且很难在不打开数据的情况下知道数据类型是什么。 知道后来为了使数据格式更加灵活,使用了事件和事件监听器的模式,事件包装的事件类型和事件数据,从主题和观察者中解耦。 主题当事件发生时,触发该事件的所有监听器,把该事件通过监听器列表发给每个监听器,监听得到事件以后,首先根据自己支持处理的事件类型中找到对应的事件处理器,再用处理器处理对应事件。 责任链模式 责任链通常需要先建立一个单向链表,然后调用方只需要调用头部节点就可以了,后面会自动流转下去。 比如流程审批就是一个很好的例子,只要终端用户提交申请,根据申请的内容信息,自动建立一条责任链,然后就可以开始流转了。 微信公众号 个人公众号:黄小斜 黄小斜是跨考软件工程的 985 硕士,自学 Java 两年,拿到了 BAT 等近十家大厂 offer,从技术小白成长为阿里工程师。 作者专注于 JAVA 后端技术栈,热衷于分享程序员干货、学习经验、求职心得和程序人生,目前黄小斜的CSDN博客有百万+访问量,知乎粉丝2W+,全网已有10W+读者。 黄小斜是一个斜杠青年,坚持学习和写作,相信终身学习的力量,希望和更多的程序员交朋友,一起进步和成长! 原创电子书:关注公众号【黄小斜】后回复【原创电子书】即可领取我原创的电子书《菜鸟程序员修炼手册:从技术小白到阿里巴巴Java工程师》 程序员3T技术学习资源: 一些程序员学习技术的资源大礼包,关注公众号后,后台回复关键字 “资料” 即可免费无套路获取。 考研复习资料: 计算机考研大礼包,都是我自己考研复习时用的一些复习资料,包括公共课和专业的复习视频,这里也推荐给大家,关注公众号后,后台回复关键字 “考研” 即可免费获取。 技术公众号:Java技术江湖 如果大家想要实时关注我更新的文章以及分享的干货的话,可以关注我的公众号【Java技术江湖】一位阿里 Java 工程师的技术小站,作者黄小斜,专注 Java 相关技术:SSM、SpringBoot、MySQL、分布式、中间件、集群、Linux、网络、多线程,偶尔讲点Docker、ELK,同时也分享技术干货和学习经验,致力于Java全栈开发! Java工程师必备学习资源: 一些Java工程师常用学习资源,关注公众号后,后台回复关键字 “Java” 即可免费无套路获取。

优秀的个人博客,低调大师

HashMap面试必问的6个点,你知道几个?

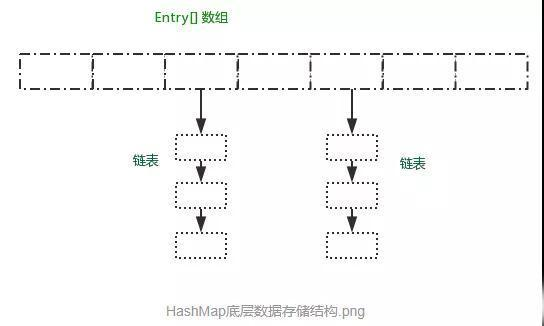
一、HashMap的实现原理? 此题可以组成如下连环炮来问 你看过HashMap源码嘛,知道原理嘛?为什么用数组+链表?hash冲突你还知道哪些解决办法?我用LinkedList代替数组结构可以么?既然是可以的,为什么HashMap不用LinkedList,而选用数组?1.你看过HashMap源码嘛,知道原理嘛? 针对这个问题,嗯,当然是必须看过HashMap源码。至于原理,下面那张图很清楚了: HashMap采用Entry数组来存储key-value对,每一个键值对组成了一个Entry实体,Entry类实际上是一个单向的链表结构,它具有Next指针,可以连接下一个Entry实体。 只是在JDK1.8中,链表长度大于8的时候,链表会转成红黑树! 2.为什么用数组+链表? 数组是用来确定桶的位置,利用元素的key的hash值对数组长度取模得到. 链表是用来解决hash冲突问题,当出现hash值一样的情形,就在数组上的对应位置形成一条链表。ps:这里的hash值并不是指hashcode,而是将hashcode高低十六位异或过的。至于为什么要这么做,继续往下看。 3.hash冲突你还知道哪些解决办法? 比较出名的有四种(1)开放定址法(2)链地址法(3)再哈希法(4)公共溢出区域法 ps:大家有兴趣拓展的,自己去搜一下就懂了,这个就不拓展了! 4.我用LinkedList代替数组结构可以么? 这里我稍微说明一下,此题的意思是,源码中是这样的 Entry[] table = new Entry[capacity]; ps:Entry就是一个链表节点。 那我用下面这样表示 List table = new LinkedList(); 是否可行? 答案很明显,必须是可以的。 5.既然是可以的,为什么HashMap不用LinkedList,而选用数组? 因为用数组效率最高! 在HashMap中,定位桶的位置是利用元素的key的哈希值对数组长度取模得到。此时,我们已得到桶的位置。显然数组的查找效率比LinkedList大。 那ArrayList,底层也是数组,查找也快啊,为啥不用ArrayList? (烟哥写到这里的时候,不禁觉得自己真有想法,自己把自己问死了,还好我灵机一动想出了答案) 因为采用基本数组结构,扩容机制可以自己定义,HashMap中数组扩容刚好是2的次幂,在做取模运算的效率高。 而ArrayList的扩容机制是1.5倍扩容,那ArrayList为什么是1.5倍扩容这就不在本文说明了。 欢迎关注我的公中浩【程序员追风】,文章都会在里面更新,整理的资料也都会放在里面。 二、HashMap在什么条件下扩容? 此题可以组成如下连环炮来问 HashMap在什么条件下扩容?为什么扩容是2的n次幂?为什么为什么要先高16位异或低16位再取模运算?1.HashMap在什么条件下扩容? 如果bucket满了(超过load factor*current capacity),就要resize。 load factor为0.75,为了最大程度避免哈希冲突 current capacity为当前数组大小。 2.为什么扩容是2的次幂? HashMap为了存取高效,要尽量较少碰撞,就是要尽量把数据分配均匀,每个链表长度大致相同,这个实现就在把数据存到哪个链表中的算法;这个算法实际就是取模,hash%length。 但是,大家都知道这种运算不如位移运算快。 因此,源码中做了优化hash&(length-1)。 也就是说hash%length==hash&(length-1) 那为什么是2的n次方呢? 因为2的n次方实际就是1后面n个0,2的n次方-1,实际就是n个1。 例如长度为8时候,3&(8-1)=3 2&(8-1)=2 ,不同位置上,不碰撞。 而长度为5的时候,3&(5-1)=0 2&(5-1)=0,都在0上,出现碰撞了。 所以,保证容积是2的n次方,是为了保证在做(length-1)的时候,每一位都能&1 ,也就是和1111……1111111进行与运算。 3.为什么为什么要先高16位异或低16位再取模运算? 我先晒一下,jdk1.8里的hash方法。1.7的比较复杂,咱就不看了。 hashmap这么做,只是为了降低hash冲突的几率。 打个比方,当我们的length为16的时候,哈希码(字符串“abcabcabcabcabc”的key对应的哈希码)对(16-1)与操作,对于多个key生成的hashCode,只要哈希码的后4位为0,不论不论高位怎么变化,最终的结果均为0。 如下图所示 而加上高16位异或低16位的“扰动函数”后,结果如下 可以看到: 扰动函数优化前:1954974080 % 16 = 1954974080 & (16 - 1) = 0 扰动函数优化后:1955003654 % 16 = 1955003654 & (16 - 1) = 6 很显然,减少了碰撞的几率。 三、讲讲hashmap的get/put的过程? 此题可以组成如下连环炮来问 知道hashmap中put元素的过程是什么样么?知道hashmap中get元素的过程是什么样么?你还知道哪些hash算法?说说String中hashcode的实现?(此题很多大厂问过)1.知道hashmap中put元素的过程是什么样么? 对key的hashCode()做hash运算,计算index; 如果没碰撞直接放到bucket里; 如果碰撞了,以链表的形式存在buckets后; 如果碰撞导致链表过长(大于等于TREEIFY_THRESHOLD),就把链表转换成红黑树(JDK1.8中的改动); 如果节点已经存在就替换old value(保证key的唯一性) 如果bucket满了(超过load factor*current capacity),就要resize。 2.知道hashmap中get元素的过程是什么样么? 对key的hashCode()做hash运算,计算index; 如果在bucket里的第一个节点里直接命中,则直接返回; 如果有冲突,则通过key.equals(k)去查找对应的Entry; 若为树,则在树中通过key.equals(k)查找,O(logn);若为链表,则在链表中通过key.equals(k)查找,O(n)。3.你还知道哪些hash算法? 先说一下hash算法干嘛的,Hash函数是指把一个大范围映射到一个小范围。把大范围映射到一个小范围的目的往往是为了节省空间,使得数据容易保存。 比较出名的有MurmurHash、MD4、MD5等等 4.说说String中hashcode的实现?(此题频率很高) public int hashCode() { int h = hash; if (h == 0 && value.length > 0) { char val[] = value; for (int i = 0; i < value.length; i++) { h = 31 * h + val[i]; } hash = h; } return h; }String类中的hashCode计算方法还是比较简单的,就是以31为权,每一位为字符的ASCII值进行运算,用自然溢出来等效取模。 哈希计算公式可以计为s[0]31^(n-1) + s[1]31^(n-2) + … + s[n-1] 那为什么以31为质数呢? 主要是因为31是一个奇质数,所以31i=32i-i=(i<<5)-i,这种位移与减法结合的计算相比一般的运算快很多。 四、为什么hashmap的在链表元素数量超过8时改为红黑树? 此题可以组成如下连环炮来问 知道jdk1.8中hashmap改了啥么?为什么在解决hash冲突的时候,不直接用红黑树?而选择先用链表,再转红黑树?我不用红黑树,用二叉查找树可以么?那为什么阀值是8呢?当链表转为红黑树后,什么时候退化为链表? 1.知道jdk1.8中hashmap改了啥么? 由数组+链表的结构改为数组+链表+红黑树。优化了高位运算的hash算法:h^(h>>>16)扩容后,元素要么是在原位置,要么是在原位置再移动2次幂的位置,且链表顺序不变。最后一条是重点,因为最后一条的变动,hashmap在1.8中,不会在出现死循环问题。 2.为什么在解决hash冲突的时候,不直接用红黑树?而选择先用链表,再转红黑树? 因为红黑树需要进行左旋,右旋,变色这些操作来保持平衡,而单链表不需要。 当元素小于8个当时候,此时做查询操作,链表结构已经能保证查询性能。当元素大于8个的时候,此时需要红黑树来加快查询速度,但是新增节点的效率变慢了。 因此,如果一开始就用红黑树结构,元素太少,新增效率又比较慢,无疑这是浪费性能的。 3.我不用红黑树,用二叉查找树可以么? 可以。但是二叉查找树在特殊情况下会变成一条线性结构(这就跟原来使用链表结构一样了,造成很深的问题),遍历查找会非常慢。 4.那为什么阀值是8呢? 不知道,等jdk作者来回答。 这道题,网上能找到的答案都是扯淡。 我随便贴一个牛客网的答案,如下图所示 看出bug没?交点是6.64?交点分明是4,好么。 log4=2,4/2=2。 jdk作者选择8,一定经过了严格的运算,觉得在长度为8的时候,与其保证链表结构的查找开销,不如转换为红黑树,改为维持其平衡开销。 5.当链表转为红黑树后,什么时候退化为链表? 为6的时候退转为链表。中间有个差值7可以防止链表和树之间频繁的转换。假设一下,如果设计成链表个数超过8则链表转换成树结构,链表个数小于8则树结构转换成链表,如果一个HashMap不停的插入、删除元素,链表个数在8左右徘徊,就会频繁的发生树转链表、链表转树,效率会很低。 五、HashMap的并发问题? 此题可以组成如下连环炮来问 HashMap在并发编程环境下有什么问题啊?在jdk1.8中还有这些问题么?你一般怎么解决这些问题的?HashMap在并发编程环境下有什么问题啊? (1)多线程扩容,引起的死循环问题(2)多线程put的时候可能导致元素丢失(3)put非null元素后get出来的却是null在jdk1.8中还有这些问题么? 在jdk1.8中,死循环问题已经解决。其他两个问题还是存在。 你一般怎么解决这些问题的? 比如ConcurrentHashmap,Hashtable等线程安全等集合类。 六、你一般用什么作为HashMap的key? 此题可以组成如下连环炮来问 健可以为Null值么?你一般用什么作为HashMap的key?我用可变类当HashMap的key有什么问题?如果让你实现一个自定义的class作为HashMap的key该如何实现?1.健可以为Null值么? 必须可以,key为null的时候,hash算法最后的值以0来计算,也就是放在数组的第一个位置。 2.你一般用什么作为HashMap的key? 一般用Integer、String这种不可变类当HashMap当key,而且String最为常用。 (1)因为字符串是不可变的,所以在它创建的时候hashcode就被缓存了,不需要重新计算。这就使得字符串很适合作为Map中的键,字符串的处理速度要快过其它的键对象。这就是HashMap中的键往往都使用字符串。(2)因为获取对象的时候要用到equals()和hashCode()方法,那么键对象正确的重写这两个方法是非常重要的,这些类已经很规范的覆写了hashCode()以及equals()方法。 3.我用可变类当HashMap的key有什么问题? hashcode可能发生改变,导致put进去的值,无法get出,如下所示 HashMap, Object> changeMap = new HashMap<>();List list = new ArrayList<>();list.add("hello");Object objectValue = new Object();changeMap.put(list, objectValue);System.out.println(changeMap.get(list));list.add("hello world");//hashcode发生了改变System.out.println(changeMap.get(list));输出值如下 java.lang.Object@74a14482null 4.如果让你实现一个自定义的class作为HashMap的key该如何实现? 此题考察两个知识点 重写hashcode和equals方法注意什么?如何设计一个不变类针对问题一,记住下面四个原则即可 (1)两个对象相等,hashcode一定相等 (2)两个对象不等,hashcode不一定不等 (3)hashcode相等,两个对象不一定相等 (4)hashcode不等,两个对象一定不等 针对问题二,记住如何写一个不可变类 (1)类添加final修饰符,保证类不被继承。 如果类可以被继承会破坏类的不可变性机制,只要继承类覆盖父类的方法并且继承类可以改变成员变量值,那么一旦子类以父类的形式出现时,不能保证当前类是否可变。 (2)保证所有成员变量必须私有,并且加上final修饰 通过这种方式保证成员变量不可改变。但只做到这一步还不够,因为如果是对象成员变量有可能再外部改变其值。所以第4点弥补这个不足。 (3)不提供改变成员变量的方法,包括setter 避免通过其他接口改变成员变量的值,破坏不可变特性。 (4)通过构造器初始化所有成员,进行深拷贝(deep copy) 如果构造器传入的对象直接赋值给成员变量,还是可以通过对传入对象的修改进而导致改变内部变量的值。例如: public final class ImmutableDemo { private final int[] myArray; public ImmutableDemo(int[] array) { this.myArray = array; // wrong } }这种方式不能保证不可变性,myArray和array指向同一块内存地址,用户可以在ImmutableDemo之外通过修改array对象的值来改变myArray内部的值。 为了保证内部的值不被修改,可以采用深度copy来创建一个新内存保存传入的值。正确做法: public final class MyImmutableDemo { private final int[] myArray; public MyImmutableDemo(int[] array) { this.myArray = array.clone(); } }(5)在getter方法中,不要直接返回对象本身,而是克隆对象,并返回对象的拷贝 这种做法也是防止对象外泄,防止通过getter获得内部可变成员对象后对成员变量直接操作,导致成员变量发生改变。 最后欢迎大家一起交流,喜欢文章记得点个赞哟,感谢支持!

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册