首页 文章 精选 留言 我的

精选列表

搜索[基础搭建],共10000篇文章
优秀的个人博客,低调大师

Android面试之Java基础

一、java面向对象的三大特性与含义 1、继承:从已有的类得到继承信息创建新类的过程,继承让变化中的软件系统有了一定的延续性,同时继承也是封装程序的可变因素的重要手段。 2、封装:通常认为封装是把数据和操作数据的方法绑定起来,对数据的访问只能通过已经定义的接口。面向对象的本质就是将现实世界描绘成一系列完全自制、封闭的对象。可以说,封装就是隐藏一切可隐藏的东西,只向外界提供简单的编程接口; 3、多态:允许不同子类型的对象对同一消息作出不同的响应。简单说就是用同样的对象引用调用同样的方法但是做了不同的事情。 4、实现多态需要做的两件事:①、方法重写;②、对象造型 二、java多态 1、多态定义:允许不同类的对象对同一消息作出响应,即同一消息可以根据发送对象的不同而表现出多种不同的行为方式。 2、多态的作用:消除类型间的耦合关系。 3、实现多态的技术:动态绑定 4、多态存在的必要条件:①有继承;②有重写;③父类引用指向子类对象。 5、多态的好处:①可替换性、②可扩充性、③接口性、④灵活性、⑤简化性。 6、多态的实现方式:接口实现、继承父类进行方法重写、同一个类内进行方法重载。 三、Java中的SoftReference是什么? 1、Java 中的 SoftReference 即对象的软引用。如果一个对象具有软引用,内存空间足够,垃圾回收器就不会回收它;如果内存空间不足了,就会回收这些对象的内存。只要垃圾回收器没有回收它,该对象就可以被程序使用。软引用可用来实现内存敏感的高速缓存。使用软引用能防止内存泄露,增强程序的健壮性。 2、SoftReference的特点:它的一个实例保存对一个Java对象的软引用,该软引用的存在不妨碍垃圾收集线程对该Java对象的回收。也就是说,一旦SoftReference保存了一个Java对象的软引用后,在垃圾线程对这个Java对象回收前,SoftReference类所提供的get()方法返回Java对象的强引用。但是,一旦垃圾线程回收该Java对象之后,get()方法将返回null。 四、abstract关键字 1、abstract可以修饰类、方法 2、如果一个类被abstract修饰,此类必须被继承使用,此类不可以生成对象,但是可以声明。 3、abstract可以 将子类的共性最大限度的抽取出来放在父类,以提高代码的简洁性。 4、abstract修饰方法时,方法为抽象方法,该方法不需要进行实现,实现留给子类,子类覆盖该方法之后才能生效。 5、abstract不能与static、final放在一起否则会出现错误 五、重写和重载 1、重写:如果子类中定义的某个方法与其父类有相同的名称和参数,则该方法被重写了。 2、重载:如果一个类内有多个重名的方法,它们或有不同的参数个数、或有不同的参数类型、或有不同的参数次序,则称为重载。 3、重载的规则:必须改变参数列表、可以改变返回类型、可以改变访问修饰符、可以声明新的或更广的检查异常、能够在同一个类中或者在一个子类中被重载、无法通过返回值类型来判断方法是否重载。 4、重写的规则:参数列表、返回值类型必须相同,访问权限不能低于父类的方法,被final修饰的方法不能被重写,static修饰的方法不能被重写但是可以再次声明,构造方法不能被重写,重写方法不能抛出更广泛的强制异常,访问权限不能下降。 六、Java中如何定义常量 1、接口中常量默认为static final; 2、Java 5.0 中引入类Enum类型; 3、在普通类中使用static final修饰的变量; 七、abstract、interface、final、static总结 abstract 1、只要含有抽象方法的类必须声明为抽象类; 2、抽象类可以有具体的实现方法; 3、抽象类内可以没有抽象方法; 4、抽象方法必须被子类实现,或者子类也是抽象的; 5、抽象类不可以被实例化,但是可以被声明; 6、若使用抽象类内部的方法,则必须有一个子类继承这个抽象类,并且实现抽象方法,通过子类实例化去调用; interface 1、接口内成员变量必须定义初始化; 2、接口内的成员方法只能是方法原型,不能有方法体; 3、接口内的成员变量和方法只能是public的; 4、实现接口的类必须全部实现接口的方法; final 1、可以修饰成员变量、非抽象类、非抽象类成员方法、方法参数; 2、final方法不能被子类重写,但是可以被继承; 3、final类不可以被继承,final类内部的方法也无法被继承; 4、final修饰的变量只能被赋值一次,赋值之后不能被修改; 5、final不能修饰构造方法; 6、final的参数:只能被使用,不能修改该参数的值 static 1、可以修饰成员变量和成员方法,但是不能修饰类(静态内部类除外)以及构造方法; 2、static修饰的成员变量和成员方法独立于这个类,被类的所有实例共享; 3、static修饰的类和成员方法可以通过类名直接访问,也可以通过实例来访问; 4、private修饰的static变量和static方法只能在声明的本类方法及静态块内访问,但不能使用this方法,因为this是非静态变量。 static+final同时修饰 1、该变量或者方法可以简单理解为全局常量; 2、对于变量一但给值就不可以修改,可以通过类名进行访问; 3、对于方法,表示不可覆盖,可以通过类名直接访问; switch是否可以使用string来作为参数? Java 5之后switch可以引用enum、byte、short、char、int作为参数 Java 7 之后引入string 八、Object有哪些公用方法 1、clone方法 保护方法,实现对象的浅复制,只有实现了Cloneable接口才可以调用该方法,否则会抛出CloneNotSupportException异常。 2、getClass()方法 final方法,获得运行时类型 3、toString()方法 不用多说了( ̄ ̄)~* 4、finalize方法 释放资源使用,很少使用; 5、equals()方法 只有在Object中equals方法和==是一样,其他时候两者不一样。 6、hashCode()方法 该方法用于哈希值的查找,可以减少equals方法的使用,提高代码运行效率。 7、wait()方法 wait方法就是使当前线程等待该对象的锁,当前线程必须是该对象的拥有者,也就是具有该对象的锁。wait方法一直等待,直到获得锁或者被中断。 调用该方法后当前线程进入睡眠状态,直到发生以下事件 ①、其他线程调用了该对象的notify方法; ②、其他线程调用该对象的notifyAll方法; ③、其他线程调用了interrupt方法中断该线程; ④、时间间隔到了。 八、int和integer的区别 1、int是基本数据类型 2、integer是int的封装类 3、int和integer都可以表示某一个数值 4、int和integer不能够互用,因为他们两种不同的数据类型 九、string是否可以被继承 不可以,因为String为final类 十、常量 final String str=“ab”可不可以编程“abc”,为什么? 不可以,因为使用final修饰的变量不可改变 十一、String、StringBuffer、StringBuilder之间的区别 三者执行效率为:StringBuilder>StringBuffer>String String字符串为常量,不可改变; StringBuilder字符串变量(非线程安全) StringBuffer字符串变量(线程安全) String类型进行改变的时候其实等同于生成 一个新的String对象,然后指针指向新的String对象。会导致jvm的gc开始工作导致速度变慢; StringBuffer一个类似于String的字符串缓冲区,但是不能修改。但是可以通过某些方法来改变该序列的长度和内容。 StringBuffer上主要操作的是append方法和insert方法,append方法是将任意类型的数据转换成字符串添加到缓存区末端,而insert方法是制定的添加字符串。 String s=new Sting(“abc”);new了几个对象? 两个 String源码分析 String对象是不可变类型,返回类型为String的String方法每次返回的都是新的String对象,除了某些方法的某些特定条件返回自身。 String对象的三种比较方式: 1、==内存比较:直接对比两个引用所指向的内存值,精确简洁直接明了。 2、equals字符串值比较:比较两个引用所指对象字面值是否相等。 3、hashCode字符串数值化比较:将字符串数值化。两个引用的hashCode相同,不保证内存一定相同,不保证字面值一定相同。 十二、内部类 静态内部类和非静态内部类的区别 1、静态内部类不持有外部类的引用,非静态内部类持有外部类的引用 2、静态内部类可以有静态成员,非静态内部类不能持有静态成员; 3、静态内部类只能访问外部类的静态成员和静态方法,非静态内部类可以访问外部类的所有成员和方法; 4、实例化一个静态内部类不需要外部类的实例;实例化一个非静态内部类需要通过外部类的实例生成内部类的实例; 5、调用静态内部类的方法或变量可以通过类名直接调用。 为什么内部类拥有外部类的所有元素的访问权? 内部类对象只能在与其外部类对象关联的情况下才能被创建,构建内部类需要一个外部类的引用,内部类正是通过这个引用去访问外部类的。 内部类的种类 成员内部类、方法内部类、匿名内部类、静态内部类 内部类的作用 1、内部类可以 用多个实例,每个实例都有自己的状态信息,并且与其他外围对象的信息相互独立; 2、单个外围类中,可以让多个内部类以不同的方式实现同一个接口,或者继承同一个类。 3、创建内部类对象的时刻并不依赖于外围类对象的创建; 4、内部类是一个独立的实体; 5、内部类提供了更好的封装,除了外围类,其他类都不能进行访问 静态内部类、内部类、匿名内部类,为什么内部类会持有外部类的引用?持有的引用是this?还是其它? 因为内部类的产生依赖于外部类,持有的引用是“类名.this”; 十三、抽象类和接口 抽象类的总结 1、抽象类不能被实例化 2、抽象类内部不一定包含抽象方法,有抽象方法的类一定是抽象类 3、抽象类内部的方法只是声明,不包含方法体,就是不给出具体的实现也就是方法的具体功能; 4、构造方法、类方法不能声明为抽象方法 5、抽象类的子类必须给出抽象类中抽象方法的具体实现,除非这类也是抽象类。 接口与类的区别 接口不能用于实例化对象; 接口没有构造方法; 接口内的方法必须是抽象方法; 接口不能包含成员变量,除非是static 和 final修饰的; 接口不是被类继承而是被类实现; 接口支持多重继承 接口特性 1、接口中的每一个方法都是隐式抽象的,接口中的方法会被隐式的指定为 public abstract; 2、接口内可以含有变量,但是接口中的变量会被隐式的指定为public static final 变量; 3、接口中的方法是不能在接口中实现的,只能由实现接口的类来实现接口内部的方法; 抽象类与接口的区别 1、抽象类内部的方法可以有方法体,但是接口内部的方法不行; 2、抽象类中的成员变量可以是各种类型的,而接口的成员变量只能是public static final类型的; 3、接口中不能有静态代码块以及静态方法,而抽象类内可以有静态代码块和静态方法,java8新特性允许接口内存在静态方法; 4、一个类只能继承一个抽象类,而一个类可以实现多个接口; 5、接口中不能有构造函数和main方法;抽象类内可以有; 6、接口是被实现;抽象类类是被继承。 接口的意义 1、提供一个规范,要求类必须实现指定的方法; 2、解决Java中的单继承问题,可以用接口来实现多继承的功能,简单化多重继承中继承树的复杂程度; 3、增强程序的扩展性。 抽象类的意义 为其子类提供一个公共的类型,封装子类中的重复内容,定义抽象方法,子类虽然有不同的实现,但是定义是一致的。 十四、接口是否可继承接口? 抽象类是否可实现(implements)接口? 抽象类是否可继承实体类(concreteclass)? 1、接口可以继承接口,使用关键字extends 2、抽象类可以实现接口。AbstractCollection类就实现了Collection接口; 3、抽象类可以继承实体类。 十五、abstract的方法是否可以同时是static,是否可同时是native,是否可同时是final? 都不行 abstract的方法不可以是static的,因为抽象的方法是要被子类实现的,而static与子类没有关系! native方法表示该方法要用另外一种依赖平台的编辑语言实现的,不存在者被子类实现的问题,所以,他也不能是抽象的,不能与abstract混用。 十六、final关键字 1、final修饰的类不能被继承,final类内部的方法都被隐式的指定为final方法; 2、final修饰的方法的原因:明确禁止该方法在子类中被覆盖; 3、修饰变量:①、基本数据类型的变量,数值一旦被初始化便不能更改;②、引用类型变量,初始化之后不能再让其指向另一个对象 4、final修饰的引用形变量其指向的对象内容可变。 十七、finally final finalize的作用? final用于声明属性、方法和类; finally是异常处理语句结构的一部分,表示总是执行; finalize是Object类的一个方法。 十八、Collection与Collections的区别 Collection是一个接口,它是Set、List等容器的父接口; Collections是一个工具类,提供了一系列的静态方法来辅助容器操作,这些方法包括对容器的搜索、排序、线程安全化等 十九、Set和List的区别 1、Set接口存储的是无序的、不重复的数据;List接口存储的是有序的、可以重复的数据; 2、Set检索效率低,删除和插入效率高、删除和插入不会引起元素位置变化,实现类有HashSet、TreeSet。 List检索效率高、插入和删除效率低,因为引起其他元素的位置变化,实现类有ArrayList、LinkdList、Vector。 二十、hashCode方法的作用 hashCode方法主要作用是为了配合基于散列的集合一起正常的运行,这样的散列的集合包括hashSet、HashMap、HashTable。 why?考虑到一种情况就是当向集合内部插入对象时,不允许有重复对象。 当向集合内部添加新对象时,首先调用对象的hashCode方法得到对象的哈希值,实际上在HashMap的具体实现中会用到一个table保存已经存进去的对象的hashCode,如果table内没有该哈希值,它就可以直接存进去不用进行比较了,如果存在则调用它的equals方法与新元素进行比较如果相同的话就不存了,不同的话存进去。这样的话就大大降低了equals方法的使用,提高了程序的运行效率。 如果equals方法得到的结果为true,则两个对象的hashcode值必定相等; 如果equals方法得到的结果为false,则两个对象的hashcode值不一定不同; 如果两个对象的hashcode值不等,则equals方法得到的结果必定为false; 如果两个对象的hashcode值相等,则equals方法得到的结果未知。 多线程环境中安全使用集合API 在集合API中最初设计的Vector和HashTable是多线程安全的。例如Vector,用来添加和删除元素的方法是同步的,如果只有一个线程与其进行交互,那么要求获取和释放对象锁是一种浪费,另外在不必要的时候滥用同步化也可能带来死锁现象。因此集合的本质上是非多线程安全的,当与多线程交互时,为了使它多线程安全,必须采取额外措施。 HashMap的实现原理 HashMap底层就是一个数组结构,数组中的每一项又是一个链表。当新建一个HashMap的时候就会初始化一个数组。 二十一、容器之间的区别 HashMap与HashTable的区别 1、继承不同 HashMap继承自Dictionary 、HashTable继承自AbstractMap 2、HashTable中的方法是同步的,HashMap的方法不是同步的; 3、HashTable内的key和value都不允许出现null,HashMap中的null可以作为键,这样的键只能有一个;可以有一个或者是多个键对应的值是null; 4、两个遍历方式不同 5、HashTable直接使用对象的哈希值、HashMap重新计算哈希值; ArrayMap和HashMap的区别 1、存储方式不同。ArrayMap使用的两个数组进行存储,HashMap使用链表进行存储; 2、扩容处理方法不一样。ArrayMap使用System.arraycopy()copy数组,而 HashMap 使用 new HashMapEntry 重新创建数组。 3、ArrayMap 提供了数组收缩的功能,在clear或remove后,会重新收缩数组,节省空间。 4、ArrayMap 采用二分法查找。 ArrayList Vector LinkedList 三者的区别 1、三者都实现了List 接口;但 LinkedList 还实现了 Queue 接口。 2、ArrayList 和 Vector 使用数组存储数据;LinkedList 使用双向链表存储数据。 3、ArrayList 和 LinkedList 是非线程安全的;Vector 是线程安全的。 4、ArrayList 数据增长时空间增长50%;而 Vector 是增长1倍; 5、LinkedList 在添加、删除元素时具有更好的性能,但读取性能要低一些。 6、LinkedList 与 ArrayList 最大的区别是 LinkedList 更加灵活,并且部分方法的效率比 ArrayList 对应方法的效率要高很多,对于数据频繁出入的情况下,并且要求操作要足够灵活,建议使用 LinkedList;对于数组变动不大,主要是用来查询的情况下,可以使用 ArrayList。 二十二、内存相关知识点 Java程序运行时的内存分配策略有三种,分别是静态分配、栈式分配和堆式分配。对应的就是静态存储区、栈区、堆区。 1、静态存储区:主要存放静态数据、全局static数据和常量。这块内存在程序编译时已经分配确定,并且在程序整个运行期间都会存在; 2、栈区:当方法执行时,方法体内部的局部变量都在栈上创建,并在方法执行结束时这些局部变量持有的内存将会自动释放 3、堆区:又称之为动态内存分配,通常指程序运行时直接new出来的内存,也就是对象的实例。这部分内存不使用时会由垃圾回收器进行回收 栈与堆的区别 栈:在方法体内定义的一些基本类型变量和对象引用的变量都是在方法的栈内存中进行分配的。 堆:用来存放所有由new创建的对象和数组。在堆中分配的内存,将由Java垃圾回收器自动管理。当在堆中产生一个数组或者对象后,还可以在栈中定义一个特殊的变量,这个变量取值等于数组或者对象在堆内存中的首地址,这个特殊变量就是引用变量。可以通过引用变量来访问堆中的对象或者是数组 结论: 1、局部变量的基本数据类型和引用存储于栈中,引用对象的实体存储于堆中。 2、成员变量存储于堆中。因为他们属于类,类对象终究是要被new出来使用的。 3、栈存取速度仅次于寄存器,存储效率比堆高,可以共享存储数据,但是其中数据大小和生存期必须在运行前确定。 4、堆是运行时可动态分配的数据区,从速度看比栈慢,堆里面的数据不共享大小和生存期都可以在运行时再确定。 Java如何管理内存? Java的内存管理就是对象的内存分配和释放问题。在Java中程序员通过new来为每个对象在堆中申请内存空间,所有的对象都在堆中分配空间。对象的释放由GC决定和执行,由于内存分配和释放由两条线来完成简化了程序员的工作,但是增加了jvm的工作。这也是Java运行速度较慢的原因之一。因为GC为了能够正确释放对象,GC必须监控每一个对象的运行状态,监视对象的目的是为了更加准确及时的释放对象,而释放对象的原则是该对象不被引用。 为了更好理解 GC 的工作原理,我们可以将对象考虑为有向图的顶点,将引用关系考虑为图的有向边,有向边从引用者指向被引对象。另外,每个线程对象可以作为一个图的起始顶点,例如大多程序从 main 进程开始执行,那么该图就是以 main 进程顶点开始的一棵根树。在这个有向图中,根顶点可达的对象都是有效对象,GC将不回收这些对象。如果某个对象 (连通子图)与这个根顶点不可达(注意,该图为有向图),那么我们认为这个(这些)对象不再被引用,可以被 GC 回收。 Java使用有向图的方式进行内存管理,可以消除引用循环的问题,例如有三个对象,相互引用,只要它们和根进程不可达的,那么GC也是可以回收它们的。这种方式的优点是管理内存的精度很高,但是效率较低。另外一种常用的内存管理技术是使用计数器,例如COM模型采用计数器方式管理构件,它与有向图相比,精度行低(很难处理循环引用的问题),但执行效率很高。 什么是Java内存泄漏? 这些对象具有如下两个特点。①、这些对象是可达的即在有向图内存在通路与其相连;②、这些对象是无用的,即以后程序不会再使用这些对象。如果对象满足这两个条件,那么我们就可以认为这些对象为Java中的内存泄漏,但是这些对象不会被GC回收,然而占用内存。 Java的内存回收机制 所有的编程语言的内存分配方式都需要返回分配内存的真实地址,也就是返回一个指针到内存块的首地址,Java中对象是采用new或者反射的方式创建的,这些对象的创建都是在堆中分配的,所有对象的回收都是由Java虚拟机通过垃圾回收机制完成的。GC为了能够准确的释放对象会监控每一个对象的运行状况(申请、引用、被引用、赋值),Java使用由向意图的方法进行管理内存,实时监控对象是否可以到达,如果不可到达则进行回收。这样也可以消除引用循环的问题。 判断内存空间是否符合垃圾回收标准? ①、对象被赋予了空值null,再也没有调用过; ②、给对象赋予了新值,这样重新分配了内存空间; Java内存泄漏引起的原因 内存泄漏的定义:无用的对象持续占有内存或无用对象的内存得不到及时释放,从而导致内存空间的浪费。严重的内存泄漏会导致内存溢出(OOM)。 内存泄漏的根本原因: 长生命周期的对象持有短生命周期对象的引用就很可能发生内泄漏。 具体导致内存泄漏的原因: 1、静态集合引起的内存泄漏 HashMap、Vector等的使用容易出现内存泄漏,这些静态变量的生命周期和应用程序一致,他们所引用的所有的对象Object也不能被释放,因为他们也将一直被Vector等引用着。 解决方法:及时将集合对象设置为null。 2、监听器 在释放对象的时候忘记删除对象的监听器,从而增加了内存泄漏的机会。 解决方法:及时删除监听器 3、各种连接 比如数据库连接(dataSourse.getConnection()),网络连接(socket)和io连接。 解决方法:显示调用close()方法,否则是不会自动被GC回收的。 4、内部类和外部模块的引用 解决方法:细节,时刻提醒提供相应方法去除引用 5、单例模式 不正确使用单例模式导致。单例对象在初始化后将在jvm的整个生命周期中存在,如果单例对象持有外部类的引用,那么这个对象将不能被JVM正常回收导致内存泄漏。 Java内存回收机制,GC 垃圾回收机制,垃圾回收的优点和原理,并说出3种回收机制。 优点: 1、Java语言显著的特点就是引入了垃圾回收机制,它使程序员在编写程序时不再考虑内存管理问题,直接解放了程序员的大脑; 2、由于有了垃圾回收机制,Java对象不再有“作用域的概念”,只有引用对象才有“作用域”的概念; 3、垃圾回收机制有效的防止了内存泄漏,可以有效的使用空闲的内存; 4、垃圾回收器通常作为一个单独的低级别的线程运行,在不可预知的情况下进行对内存堆中的已经死亡的或者长时间没有用过的对象进行清除和回收。 5、程序员实时的对某个对象调用垃圾回收器进行垃圾回收。 垃圾回收机制:分带复制垃圾回收、标记垃圾回收、增量垃圾回收 垃圾回收算法 1、引用计数算法:缺点是无法处理循环引用问题 2、标记-清除算法:标记所有从根节点开始的可达的对象。缺点是会造成空间不连续,导致不容易分配内存 3、标记-压缩算法:标记清除算法的升级版,原理:清除未标记对象时还将所有的存活对象压缩到内存的另一端,之后清理边界所有的空间既避免碎片产生,又不需要两块同样大小的内存块。适用于老年代。 4、复制算法:将内存空间分为两块,每次将正在使用的内存中存活对象复制到未使用的内存块中,之后清除正在使用的内存块。算法效率高,但是代价是系统内存折半。适用于新生代。 5、分代 Java虚拟机的特性 Java语言的一个非常重要的特性就是与平台无关性,而Java虚拟机是实现这一特性的关键。一般的高级语言在不同的平台上运行,至少需要编译成不同的目标代码。然而引入Java语言虚拟机之后,Java在不同平台运行的时不需要重新编译,Java语言使运行时Java虚拟机屏蔽了与具体平台相关的信息,使得Java语言编译程序只需生成在Java虚拟机上运行的目标代码(字节码),就可以在多种平台上不加修改地运行。Java虚拟机在执行字节码时,把字节码解释成具体平台上的机器指令执行。 哪些情况下的对象会被垃圾回收器回收掉 Java的回收机制最基本的做法就是分代回收。内存中的区域被划分为不同的世代,对象根据其存活时间被保存在在不同的世代内。一般被分为三个世代分别为:年轻、年老、永久。内存分配是发生在年轻世代内,对于不同的世代可以才用不同的垃圾回收算法。基于这一点针对世代的垃圾回收算法就很有针对性了。 二十三、多线程 一个线程的生命周期 新建状态:使用new关键字和Thread类或其子类建立一个线程对象,该线程对象就处于新建状态。它保持这个状态直达程序start()这个程序。 就绪状态:当线程对象调用start()方法之后,该线程就进入就绪状态。就绪状态的线程处于就绪队列中,等待JVM里线程调度器的调度。 运行状态:如果就绪状态的线程获取CPU资源,就可以执行run()方法,此时的线程处于运行状态。处于运行时的状态最为复杂,可以变为阻塞状态、就绪状态、死亡状态。 阻塞状态:线程执行了sleep(睡眠)、suspend(挂起)等方法,失去所占用资源之后,该线程从运行状态进入阻塞状态。在睡眠时间已到或获得设备资源后可以重新进入就绪状态。 阻塞状态可以分为三种:①、等待阻塞:运行状态中的线程执行wait()方法;②、同步阻塞:线程在获取synchronized同步锁失败; ③、其他阻塞 死亡状态:一个运行时状态的线程完成任务或者其他终止条件发生时,该线程切换到终止状态。 线程与进程的区别 程序是一段静态的代码,一个进程可以有一个或者多个线程,每个线程都有唯一的标识 区别:①、进程大体分为数据区、代码区、栈区、堆区。多个进程之间的内部数据和状态是完全独立的;线程共享进程的数据区、代码区、堆区、只有栈区是独立的。所以线程切换代价小于进程切换代价。 ②、一个程序至少有一个进程,一个进程至少有一个线程; ③、线程划分尺度小于进程、多线程的程序并发高; ④、进程在执行过程中拥有独立的内存单元,而多线程共享内存,从而极大地提高了程序运行效率; 什么导致线程阻塞 1、调用sleep(毫秒),使得线程进入睡眠状态; 2、调用suspend()暂停线程执行。除非线程收到resume()消息否则返回不可运行状态; 3、调用wait()方法暂停线程执行。除非调用notify()或者notifyAll()消息,否则不可运行; 4、线程正在等候IO操作的完成; 5、线程试图调用另一个对象的同步方法,但是那个对象处于锁定状态暂时无法使用。 多线程的实现方法 1、实现Runnable接口; 2、继承Thread类本身; 3、通过callable和Future创建线程(Java 5 之后出现); 实现Runnable接口相比继承Thread类有如下优势 1、可以避免Java单继承的特性带来的局限性; 2、增强程序的健壮性,代码可以被多个程序共享,代码与数据是独立的; 3、适合多个相同程序代码的线程区处理同一资源的情况 同步有几种实现方法,都是什么? 两种 synchronized wait和notify 锁的等级 方法锁、对象锁、类锁 同步和异步的区别? 同步:A线程请求某资源时,B线程占用该资源,则A只能等待下去 异步:A线程请求某个资源时,B线程占用该资源,则A无需等待可以请求。 sleep和wait的区别 ①、sleep:线程休息;wait:线程挂起。 ②、sleep方法属于Thread类的方法;wait属于Object类方法 ③、sleep:sleep正在执行的线程主动放出cpu,指定时间后cpu回到该线程继续向下执行。注意sleep只是让出CPU而并不是释放同步资源锁; wait:当前线程让自己暂时退让出同步资源锁,以便其他正在等待该资源的线程得到该资源而运行,只有调用notify方法之后调用wait方法的线程才会接触wait状态进而参与竞争同步资源锁,进而执行 Java线程池线程同步 同步操作产生的原因:当多个线程同时访问对象并要求操作相同资源时,分割了原子操作就有可能出现数据的不一致或数据不完整情况,为了避免发生这种情况,我们会采取同步机制。 synchronized修饰符实现的同步机制叫做互斥锁机制。 互斥锁:每个对象都有一个锁标记,当线程拥有锁机制的时候才可访问这个资源,没有锁标记便进入锁池。任何一个对象系统都会创建一个互斥锁,这个锁为了分配给线程,防止打断原子操作,每个对象锁只能分配给一个线程。 当一个线程进入一个对象的一个synchronized方法后,其他线程是否可进入此对象的其他方法? 可以调用此对象的其他非synchronized方法; 可以调用此对象synchronized static方法; 线程加锁的作用:互斥行为和内存可见性 内存可见性定义 某个线程正在使用对象状态而另一个线程在同时修改该状态,当该状态被修改之后可以立刻被其他线程感知该对象的状态改变了 Atomic、volatile、synchronized区别 1、synchronized是解决多线程共享资源的问题同步机制采用了“以时间换取空间”的做法,访问串行化、对象共享化。同步机制是提供一份变量,让所有线程都可以访问。 2、Atomic是通过原子操作指令+Look-Free完成,从而实现非阻塞的并发问题。 3、Volatile是为了多线程资源共享问题解决了部分需求,在非依赖自身的操作的情况下,对变量的改变将对任何线程可见。 4、ThreadLocal是为了解决多线程资源共享问题,用来提供线程内局部变量,省去参数传递这个不必要的麻烦,做到了“以空间换取时间”的方式。 5、如果是一个类的多个对象想公用对象内部的一个变量,而不想使用static,可以使用浅复制的方式。 并发编程实现内存可见性的方式- - - ->加锁和volatile变量 volatile变量 1、volatile变量是一种脆弱的同步机制,由于访问volatile变量时不会执行加锁操作,因此也就不会执行线程阻塞,因此volatile变量是一种比synchronized关键字轻量级的同步机制; 2、从内存可见度角度来看,写入volatile操作相对于退出同步代码块,读取volatile变量相对于进入同步代码块; 3、代码中过度使用volatile编写来控制可见性,通常会比使用锁更加脆弱和难以理解。 4、volatile只能保证可见性,不能保证原子性。 使用volatile的情景: 1、对变量的读写操作不依赖变量的当前值,或者可以保证只有单个线程更新变量的值; 2、该变量没有包含在具有其他变量的不变式中。 守护线程与阻塞线程的四种情况 用户线程:运行在前台的线程; 守护线程:运行在后台的线程,为其他前台线程的运行变量提供便利服务的,仅当非守护线程运行时,才需要守护线程例如垃圾回收线程; 可以人为创建守护线程,通过Thread的setDeamon(ture)方法设置当前线程为守护线程。 禁止在守护线程内创建耗时操作,比如IO操作 setDeamon(ture)方法必须在调用线程的start()方法之前设置,否则会抛出IllegalThreadStateException异常。 守护线程内产生的新线程也是守护线程。 死锁 线程A持有互斥锁lock1,线程B持有互斥锁lock2。当线程A持有lock1时,师徒获取lock2,因为B持有lock2,因此线程A会阻塞等待线程B对lock2的释放。如果此时B在持有lock2的时候也试图获取lock1,因为A持有lock1,因此线程B会阻塞等待A对lock1的释放。二者都在等待对方所持有的锁释放,而二者却又都没释放自己所持有的锁,这时二者会一直阻塞下去,这种情况为死锁现象。 如何避免死锁现象产生 1、只在必要的最短时间内持有锁,可以考虑使用同步语句块代替整个同步方法; 2、尽可能不编写在同一时刻需要持有多个锁的代码,如果不可避免则确保线程持有第二个锁的时间尽量短; 3、创建一个大锁来代替若干个小锁。 可重入内置锁 使用wait/notify/notifyAll实现线程间通信 可以通过调用Object对象的wait()方法和notify()方法或者说notifyAll方法来实现线程间通信。在线程中调用wait()方法,将阻塞等待其他线程的通知,在线程中调用notify()方法或notifyAll方法,将通知其他线程wait()方法处返回。 notify()、notifyAll()、wait()、wait(long)和wait(long,int),他们都被声明为final,因此在子类中不能覆写任何一个方法。 如果调用wait()时,没有持有适当的锁,则抛出IllegalMonitorStateException; 如果调用notify()时没有持有适当的锁,也会抛出IllegalMonitorStateException 如果线程调用了对象的wait方法,那么线程便会处于对该对象的等待池中,等待池中的线程不会去竞争该对象的锁; 当线程调用了对象的notiAll方法或者notify方法,被唤醒的线程便会进入该对象的锁池中,锁池中的线程会去竞争该对象锁; 优先级高的线程竞争到对象锁的概率大,如果没有竞争到对象锁那么他会留在锁池中只有线程再次调用wait方法的时候,它才会再次进入等待池中。竞争到对象锁的线程则会继续向下执行,直到执行完了synchronized代码块,才会释放掉对象锁,此时锁池内线程会继续竞争该对象锁。 Error和Exception的区别 Error是Throwable的子类用于标记严重错误,合理的应用程序不可以用try/catch这种错误。绝大多数错误都是非正常的,不应该出现的。 Exception是Throwable的子类,用于指示合理的程序想去catch的条件,即它仅仅是一种程序运行的条件,而非严重错误。 checked exceptions: 通常是从一个可以恢复的程序中抛出来的,并且最好能够从这种异常中使用程序恢复。比如FileNotFoundException, ParseException等。 unchecked exceptions:就是程序中的bug Java中的异常处理机制的简单原理和应用 Java中通过面向对象的方式,把各种异常进行了分类,并且提供了良好的接口,在Java中每一个异常就是一个的对象。当一个方法抛出异常的时候便抛出了一个异常对象,该对象内包含异常的信息,调用这个对象的方法就可以捕获到这个异常并进行处理。 try/catch的执行过程 一般情况由try来执行一段程序,如果出现异常,系统则会抛出一个异常,此时程序员可以通过他的类型进行捕捉(catch操作),或在最后(finally)由缺省处理器来进行处理。 用try来指定一块预防所有“异常”的程序。紧跟在try程序后面,应包含一个catch子句来指定你想要捕捉的“异常”的类型。throw语句用来明确地抛出一个“异常”。throws用来标明一个成员函可能抛出的各种“异常”。Finally为确保一段代码不管发生什么“异常”都被执行一段代码。 try{ return} catch{} finally{}; return 还是 finally 先执行? 任何执行try或者catch内的return语句之前,都会先执行finally语句,如果finally存在的话。 如果finally中有return语句,那么程序就return了,所以finally中的return是一定会被return的 在try语句中,在执行return语句时,要返回的结果已经准备好了,就在此时,程序转到finally执行了。在转去之前,try中先把要返回的结果存放到不同于x的局部变量中去,执行完finally之后,在从中取出返回结果,因此,即使finally中对变量x进行了改变,但是不会影响返回结果。 二十四、序列化 对象Object读写是哪两个流 ObjectInputStream ObjectOutputStream 什么是Java序列化,如何实现序列化? 序列化就是一种用来处理对象流的机制,所谓对象流就是讲对象的内容流化。可以对流化后的对象进行读写操作,也可将流化后的对象传输于网络之间。序列化是为了解决在对对象流进行读写操作时所引发的问题。 实现:Serializable接口和Parcelable接口 Serializable和Parcelable的区别 两者最大的区别在于存储媒介的不同,Serializable使用IO读写存储在硬盘上,而Parcelable是直接在内存中读写,很明显内存的读写速度通常大于IO读写,所以在Android中通常优先选择Parcelable。 二十五、反射 反射机制 运行状态中,对于任意一个类,都能够知道这类的所有属性和方法;对于任意一个对象,都能够调用它的任意一个方法和属性;这种动态获取的信息以及动态调用对象的方法的功能被称为Java语言的反射机制。 反射机制的用处 1、观察或者操作应程序的运行时行为; 2、调试或测试程序,因为可以直接访问方法、构造函数和成员字段; 3、通过名字调用不知道的方法并使用该信息来创建对象和调用方法。 二十六、泛型 泛型的优缺点 优点: 使用泛型可以最大限度的重用代码、保护类的安全以及提高性能。 缺点: 性能上不如数组快 二十七、网络 网络参考模型 四层分法:应用层、运输层、网络层、网络接口层 七层分法:应用层、表示层、会话层、运输层、网络层、数据链路层、网络层 Tcp与UDP的区别 1、tcp是面向有链接的通信服务;udp是面向无连接的通信服务 2、tcp传输可靠;udp传输不可靠、会丢包 3、tcp保证数据顺序;udp不保证数据顺序; 4、tcp无边界;udp有边界; 5、tcp传输速度慢;udp传输速度快; 6、tcp面向字节流;udp面向报文 7、tcp一对一;udp一对一或者一对多 TCP:面向连接、传输可靠(保证数据正确性,保证数据顺序)、用于传输大量数据(流模式)、速度慢,建立连接需要开销较多(时间,系统资源)。 UDP:面向非连接、传输不可靠、用于传输少量数据(数据包模式)、速度快。 get和post请求的区别 1、get请求能被缓存;post请求不能被缓存 2、get保存浏览器浏览记录;post不保存浏览器浏览记录; 3、get请求的url可以保存为浏览器书签;post的不可以; 4、get请求长度有限制;post请求长度无限制 5、get请求主要用以获取数据;post提交数据 6、post请求相对安全 Tcp的三次握手 1、客户端发送:SYN=1,SEQ=X,端口号 2、服务的回复:SYN=1,ACK=X+1,SEQ=Y 3、客户端发送:ACK=Y+1,SEQ=X+1 tcp的四次挥手 1、A向B提出停止连接请求,FIN = 1 2、B收到,ACK = 1 3、B向A提出停止连接请求,FIN = 1 4、A收到,ACK = 1 优点:稳定可靠 缺点:传输慢效率低、容易受攻击 udp传输的优缺点 优点:传输速率快,较安全 缺点:不可靠、不稳定 用udp进行通信如何知道目标机是否获得到数据包? 仿TCP的做法,每发一个UDP包,都在里面加一个SEQ序号,接收方收到包后,将SEQ序号回复给发送方。如果发送方在指定时间以内没有收到回应,说明丢包了。 为什么udp比tcp快? 1、无需三次握手 2、tcp有拥塞控制,控制流量等机制 为什么tcp比udp可靠? 1、TCP是面向有连接的,建立连接之后才发送数据;而UDP则不管对方存不存在都会发送数据。 2、TCP有确认机制,接收端每收到一个正确包都会回应给发送端。超时或者数据包不完整的话发送端会重传。UDP没有,因此可能丢包。 什么时候使用Tcp? 当对网络通信质量有要求的时候 例如 浏览器 什么时候使用udp? 当对网络通讯质量要求不高的时候,要求网络通讯速度能尽量的快,这时就可以使用UDP TCP无边界,UDP有边界 TCP:客户端分多次发送数据给服务器,若服务器的缓冲区够大,那么服务器端会在客户端发送完之后一次性接收过来,所以是无边界的; udp:客户端每发送一次,服务器端就会接收一次,也就是说发送多少次就会接收多少次,因此是有边界的。 scoket编程的步骤 1、 创建Socket; 2、 打开连接到Socket的输入/出流; 3、 按照一定的协议对Socket进行读/写操作; 4、关闭Socket.(在实际应用中,并未使用到显示的close,虽然很多文章都推荐如此,不过在我的程序中,可能因为程序本身比较简单,要求不高,所以并未造成什么影响。)

优秀的个人博客,低调大师

Hadoop零基础入门

转自:http://blog.csdn.net/column/details/13153.html 【Hadoop入门学习系列之一】Ubuntu下安装Hadoop(单机模式+伪分布模式) 【Hadoop入门学习系列之一】Ubuntu下安装Hadoop(完全分布模式) hadoop安装配置中的权限管理 【Hadoop入门学习系列之二】HDFS架构和编程 【Hadoop入门学习系列之三】YARN原理和资源调度 【Hadoop入门学习系列之四】MapReduce 2.0应用场景和原理、基本架构和编程模型 【Hadoop入门学习系列之五】MapReduce 2.0编程实战 【Hadoop入门学习系列之六】HBase基本架构、编程模型和应用案例

优秀的个人博客,低调大师

QTQuick控件基础(3)视图

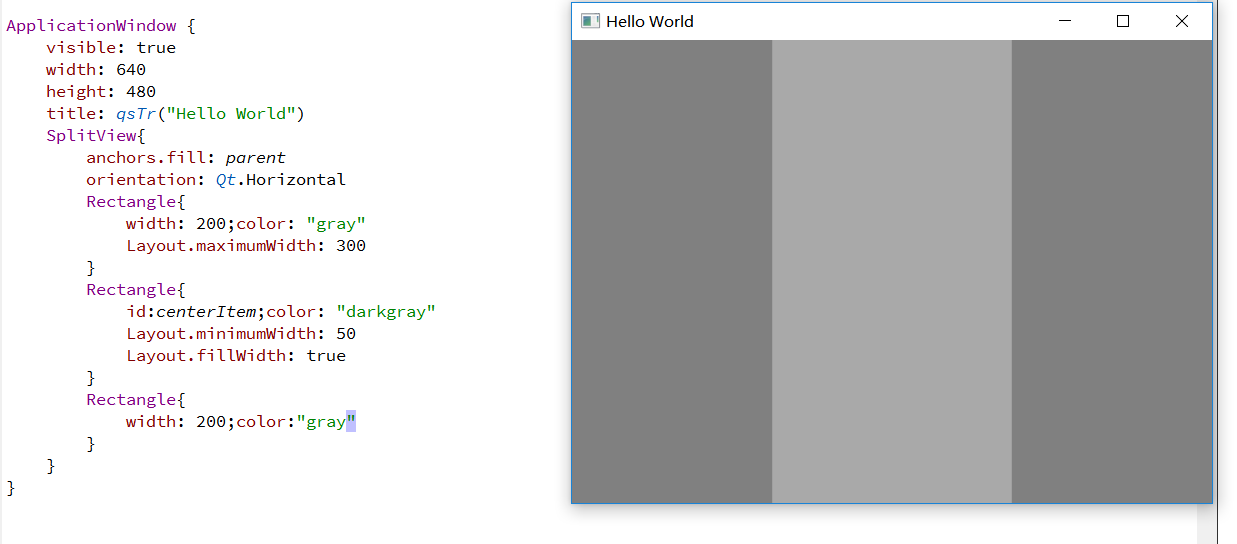
1、spliteview 2、stackview ApplicationWindow {visible:truewidth:640height:480MouseArea{anchors.fill:parentacceptedButtons:Qt.LeftButton|Qt.RightButton|Qt.MiddleButtononClicked:{if(mouse.button===Qt.LeftButton ){stackView.push([blueView,greenView,yellowView]);}elseif(mouse.button===Qt.RightButton){stackView.pop();}else{stackView.push({item:orangeView,replace:ture})}}}Rectangle {id:blueView;color:"blue"}Rectangle {id:greenView;color:"green"}Rectangle {id:yellowView;color:"yellow"}Rectangle {id:orangeView;color:"orange"}StackView{id:stackViewanchors.fill:parentinitialItem:Item{id:redViewRectangle{anchors.fill:parent;color:"red"}}}} 3、messagedialog ApplicationWindow {visible: truewidth: 640height: 480Button{id:windowwidth: 300height: 300anchors.centerIn: parentonClicked: messageDialog.open()}MessageDialog{id:messageDialogtitle:"注意注意"text: "欢迎使用QTQuick"detailedText: "这里是具体文字"icon:StandardIcon.QuestionstandardButtons: StandardButton.Yes|StandardButton.Help|StandardButton.OpenonYes: {}onHelp: {}onAccepted: {}}} 来自为知笔记(Wiz) 目前方向:图像拼接融合、图像识别 联系方式:jsxyhelu@foxmail.com

优秀的个人博客,低调大师

.NET Timer控件基础用法

使用C#的Timer控件来实现定时触发事件,其主要参数如下: Timer.Enabled属性用于设置是否启用定时器 Timer.Interval属性,事件的间隔,单位毫秒 Timer.Elapsed事件,达到间隔时发生 示例: [csharp]view plaincopy usingSystem; usingSystem.Collections.Generic; usingSystem.Linq; usingSystem.Text; usingSystem.Timers; namespaceConsoleApplication1 { classProgram { staticvoidMain(string[]args) { System.Timers.TimeraTimer=newSystem.Timers.Timer(); aTimer.Elapsed+=newElapsedEventHandler(OnTimedEvent); //SettheIntervalto5seconds. aTimer.Interval=5000; aTimer.Enabled=true; Console.WriteLine("Press/'q/'toquitthesample."); while(Console.Read()!='q'); } privatestaticvoidOnTimedEvent(objectsource,ElapsedEventArgse) { Console.WriteLine("HelloWorld!"); } } }

优秀的个人博客,低调大师

1.python基础阶段

#python输出 print("xubin") #python注释法 print("hello word") '''print("徐彬") print("xubin")''' #print("xubin") #python标识符 abc = 1111 _bc = 222 print(abc+_bc) #python变量 a=5 a=a+1 a+=1 print(a) #python数据类型 '''数、字符串、列表list、元组tuple、集合set、字典dictionary''' a=10 b="i am a boy" c=["my","you"] d=("my","you") print(c) print(c[1]) print(d) print(d[0]) #元组不支持修改 a="faretesdfbfhs" #集合中元素不能重复 b="safnkrlewjroiuoitn" c=set(a) d=set(b) print(c&d) print(d|c) #字典 #{key1:value1,key2:value2} a={"name":"xubin","sex":"man","age":25} print(a['sex']) #python运算符 a='xubin' b='is' c='a man' print(a+" "+b+c) a=9 b=2 print(a/b) print(a//b) print(a%b) #python缩进 a=10 b=9 if(a>9): print(a) if(b==9): print(b) elif(a<10): print(abc) #python控制流 #程序执行流程叫程序的控制流:顺序结构,条件分支结构,循环结构,(中断结构break continue) score=91 if(90>score>=60): #if score<60 print("成绩为及格") elif(score>=90): print("成绩为优秀") else: print("成绩不及格") i=5 while(i<10): print(i) i+=1 a=["a","b","c","d"] for s in a: print(s) for i in range(0,10): print(i) #终止循环一次continue,终止循环break for j in range(0,8): if(j==5): continue print(j) for j in range(0,8): if(j==5): break print(j) #python输出乘法口诀 for i in range(1,10): for j in range(1,i+1): print(str(i)+"*"+str(j)+"="+str(i*j)+" ",end="") print() for i in range(9,0,-1): for j in range(i,0,-1): print(str(i)+"*"+str(j)+"="+str(i*j)+" ",end="") print()

优秀的个人博客,低调大师

android—label窗口——基础编

今天写了一个关于label的显示窗口,代码量也挺简单的,大家一看就明白。不管在哪里我们做软件的都需要用到label 先让我们看一下图先。 packagecom.smart.widget; importandroid.content.Context; importandroid.util.AttributeSet; importandroid.view.LayoutInflater; importandroid.widget.LinearLayout; importandroid.widget.TextView; importcom.smart.acitivy.R; publicclassLabelEditextendsLinearLayout{ privateTextViewtextView; privateStringlabelText; privateintlabelFontSize; privateStringlabelPosition; publicLabelEdit(Contextcontext,AttributeSetattrs) { super(context,attrs); //读取labelText属性的资源ID intresourceId=attrs.getAttributeResourceValue(null,"labelText",0); //未获得资源ID,继续读取属性值 if(resourceId==0) labelText=attrs.getAttributeValue(null,"labelText"); //从资源文件中获得labelText属性的值 else labelText=getResources().getString(resourceId); //如果按两种方式都未获得labelTex属性的值,表示未设置该属性,抛出异常 if(labelText==null) { thrownewRuntimeException("必须设置labelText属性."); } //获得labelFontSize属性的资源ID resourceId=attrs.getAttributeResourceValue(null,"labelFontSize",0); //继续读取labelFontSize属性的值,如果未设置该属性,将属性值设为14 if(resourceId==0) labelFontSize=attrs.getAttributeIntValue(null,"labelFontSize", 14); //从资源文件中获得labelFontSize属性的值 else labelFontSize=getResources().getInteger(resourceId); //获得labelPosition属性的资源ID resourceId=attrs.getAttributeResourceValue(null,"labelPosition",0); //继续读取labelPosition属性的值 if(resourceId==0) labelPosition=attrs.getAttributeValue(null,"labelPosition"); //从资源文件中获得labelPosition属性的值 else labelPosition=getResources().getString(resourceId); //如果未设置labelPosition属性值,将该属性值设为left if(labelPosition==null) labelPosition="left"; StringinfService=Context.LAYOUT_INFLATER_SERVICE; LayoutInflaterli; //获得LAYOUT_INFLATER_SERVICE服务 li=(LayoutInflater)context.getSystemService(infService); LinearLayoutlinearLayout=null; //根据labelPosition属性的值装载不同的布局文件 if("left".equals(labelPosition)) linearLayout=(LinearLayout)li.inflate(R.layout.labeledittext_horizontal,this); elseif("top".equals(labelPosition)) linearLayout=(LinearLayout)li.inflate(R.layout.labeledittext_vertical,this); else thrownewRuntimeException("labelPosition属性的值只能是left或top."); //下面的代码从相应的布局文件中获得了TextView对象,并根据LabelTextView的属性值设置TextView的属性 textView=(TextView)findViewById(R.id.textview); textView.setTextSize((float)labelFontSize); textView.setTextSize(labelFontSize); textView.setText(labelText); } } 我看一下Label类 package com.smart.widget; import android.content.Context; import android.util.AttributeSet; import android.view.LayoutInflater; import android.widget.LinearLayout; import android.widget.TextView; import com.smart.acitivy.R; public class LabelEdit extends LinearLayout{ private TextView textView; private String labelText; private int labelFontSize; private String labelPosition; public LabelEdit(Context context, AttributeSet attrs) { super(context, attrs); // 读取labelText属性的资源ID int resourceId = attrs.getAttributeResourceValue(null, "labelText", 0); // 未获得资源ID,继续读取属性值 if (resourceId == 0) labelText = attrs.getAttributeValue(null, "labelText"); // 从资源文件中获得labelText属性的值 else labelText = getResources().getString(resourceId); // 如果按两种方式都未获得labelTex属性的值,表示未设置该属性,抛出异常 if (labelText == null) { throw new RuntimeException("必须设置labelText属性."); } // 获得labelFontSize属性的资源ID resourceId = attrs.getAttributeResourceValue(null, "labelFontSize", 0); // 继续读取labelFontSize属性的值,如果未设置该属性,将属性值设为14 if (resourceId == 0) labelFontSize = attrs.getAttributeIntValue(null, "labelFontSize", 14); // 从资源文件中获得labelFontSize属性的值 else labelFontSize = getResources().getInteger(resourceId); // 获得labelPosition属性的资源ID resourceId = attrs.getAttributeResourceValue(null, "labelPosition", 0); // 继续读取labelPosition属性的值 if (resourceId == 0) labelPosition = attrs.getAttributeValue(null, "labelPosition"); // 从资源文件中获得labelPosition属性的值 else labelPosition = getResources().getString(resourceId); // 如果未设置labelPosition属性值,将该属性值设为left if (labelPosition == null) labelPosition = "left"; String infService = Context.LAYOUT_INFLATER_SERVICE; LayoutInflater li; // 获得LAYOUT_INFLATER_SERVICE服务 li = (LayoutInflater) context.getSystemService(infService); LinearLayout linearLayout = null; // 根据labelPosition属性的值装载不同的布局文件 if("left".equals(labelPosition)) linearLayout = (LinearLayout)li.inflate(R.layout.labeledittext_horizontal, this); else if("top".equals(labelPosition)) linearLayout = (LinearLayout)li.inflate(R.layout.labeledittext_vertical, this); else throw new RuntimeException("labelPosition属性的值只能是left或top."); // 下面的代码从相应的布局文件中获得了TextView对象,并根据LabelTextView的属性值设置TextView的属性 textView = (TextView) findViewById(R.id.textview); textView.setTextSize((float)labelFontSize); textView.setTextSize(labelFontSize); textView.setText(labelText); } } 本文转自 llb988 51CTO博客,原文链接:http://blog.51cto.com/llb988/495893,如需转载请自行联系原作者

优秀的个人博客,低调大师

android登录窗口——基础编

大家一定在CS/BS的程序有登录窗口,ANDROID也应该是,下面我来做了一个界面欢迎大家参考! main 代码 packagenet.blogjava.mobile; importandroid.app.Activity; importandroid.app.AlertDialog; importandroid.content.DialogInterface; importandroid.os.Bundle; importandroid.view.View; importandroid.view.View.OnClickListener; importandroid.widget.Button; importandroid.widget.LinearLayout; publicclassMainextendsActivityimplementsOnClickListener { @Override publicvoidonClick(Viewv) { LinearLayoutloginLayout=(LinearLayout)getLayoutInflater().inflate( R.layout.login,null); newAlertDialog.Builder(this).setIcon(R.drawable.login) .setTitle("用户登录").setView(loginLayout).setPositiveButton("登录", newDialogInterface.OnClickListener() { publicvoidonClick(DialogInterfacedialog, intwhichButton) { //编写处理用户登录的代码 } }).setNegativeButton("取消", newDialogInterface.OnClickListener() { publicvoidonClick(DialogInterfacedialog, intwhichButton) { //取消用户登录,退出程序 } }).show(); } @Override publicvoidonCreate(BundlesavedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.main); Buttonbutton=(Button)findViewById(R.id.button); button.setOnClickListener(this); } } 本文转自 llb988 51CTO博客,原文链接:http://blog.51cto.com/llb988/491662,如需转载请自行联系原作者

优秀的个人博客,低调大师

C#基础知识

1.c#概述,c#语言及其特点;c#与.net框架关系 C#概述:C#是微软公司发布的一种面向对象的、运行于.NET Framework之上的高级程序设计语言,C#是一种安全的、稳定的、简单的、优雅的,由C和C++衍生出来的面向对象的编程语言 特点:1.简单 2.现代 3.面向对象 4.类型安全 5.相互兼容性 6.可伸缩性和可升级性 关系:.NET框架是由微软开发的,致力于敏捷软件开发、快速应用开发、平台无关性和网络透明化的软件开发平台。 C#只是用于编写运行在该平台上的一种语言。 2.编写第一个c#程序(注释,命名空间,类,Main方法,标识符,关键字,输入,输出语句,) [csharp] view plain copy using System; namespace ConsoleApp2 { class Program { static void Main(string[] args) { //输出 Hello word Console.WriteLine("Hello word"); //输入 Console.ReadLine(); } } } 3.变量与常量(值类型,引用类型,两者区别,枚举类型,类型转换,变量声明,变量作用域,变量赋值,常量) 值类型 引用类型 1、值类型的数据存储在内存的栈中;引用类型的数据存储在内存的堆中 2、值类型表示实际数据,引用类型表示指向存储在内存堆中的数据的指针或引用 枚举: 枚举使用enum关键字来声明,与类同级。 枚举是值类型,隐式继承自System.Enum,不能手动修改。System.Enum本身是引用类型,继承自System.ValueType。 枚举都是隐式密封的,不允许作为基类派生子类。 枚举类型的枚举成员均为静态,且默认为Int32类型。 每个枚举成员均具有相关联的常数值。 枚举成员不能相同,但枚举的值可以相同。 枚举最后一个成员的逗号和大括号后面的分号可以省略 类型转换: 1.(int)变量名[强制类型转换] 2.int.Parse(string 变量名) 3.int.TryParse(string s, out int result) Convert.ToInt32 变量赋值: 值类型变量的赋值:值类型变量中保存的是实际数据,在赋值的时候只是把数据复制一份,然后赋给另一个变量。 引用类型变量的赋值: 引用类型变量中保存的是“指向实际数据的引用指针”。在进行赋值操作的时候,它和值类型一样,也是先有一个复制的操作,不过它复制的不是实际的数据,而是引用(真实数据的内存地址)。所以引用类型的变量在赋值的时候,赋给另一变量的实际上是内存地址。这样赋值完成后,2个引用变量中保存的是同一引用,他们的指向完全一样。 变量声明: 数据类型 变量名=值; 常量: C#常量主要分为两种:编译时和运行时常量 1、编译时常量,在编译时便用该常量的值代替常量变量。 2、运行时常量,在运行时返回一个运行时常量的变量引用 4.表达式与运算符(表达式概念,运算符种类,运算符优先级) 表达式概念:变量常量运算符组成 1.带( )号,[ ]号, . 号的,new,typeof,sizeof,checked,x++,x--级别最高,先计算. 2.++x,--x,+,! 3.算术运算符,先,/,%,再+,- 4.关系运算符,先>,<,>=,<=,is ,as再==和!= 5.条件逻辑运算符&&和|| 6.条件运算符b?x:y 7,赋值运算符=,=,/=,+=,-= 5.字符与字符串(Char类,Char类的使用,String的基本使用,StringBulider的使用) 字符串是由多个字符组成,字符串是引用类型 字符:Char类在C#中表示一个Unicode字符。 3)ToUpper(转换为大写)和ToLower(转换为小写) string s="RaSer"; string s1=s.ToUpper();//s1="RASER"; string s2=s.ToLower();//s2="raser"; Trim() 出去两边的空格 string str=" dd "; string s=str.Trim();//s="dd"; Substring 截取字符<str>以index开始截取,并截取lenth个字符(string <str>.Substring(index,lenth)) string str="还在下雨"; string s=str.Substring(2,2);//s="下雨"; Remove删除字符串(字符) 在字符串中移除从startIndex开始,长度为length的字符串,剩下的字符合为一个新的字符串 、Insert 插入 在字符串的index位置上插入字符,原来的字符依次后移,变成一个新的字符串 string str="夜深了"; string s=str.Insert(1,"已经");// s="夜已经深了" Replace 字符串(字符也是可以的)替换,返回新的字符串 string str="好困呀"; string s=str.Replace("困","精神");//s="好精神呀"; 、Equals 比较两个字符串是否相等 6.流程控制语句(选择包括switch,迭代语句即循环(搞明白为什么可以循环),跳转(break,continue,goto,return)) [csharp] view plain copy int a=6; switch(a) { case:"4" console.writeline("4"); break; case:"5" console.writeline("5"); break; default console.writeline("666"); break; } break从循环体跳出 continue结束本次循环 goto无条件转移语句 return 跳出循环的同时也做函数返回 7.数组和集合(一维数组和二维数组的声明以及使用,ArrayList类,HashTable,List,Directory字典等常用集合(泛型和非泛型)) [csharp] view plain copy string[] names = new string[5];//动态初始化 string[] names1 = new string[3] { "张三", "李四", "王二" };//定义并且赋予初值 动态初始化 int[] array = { 1, 2, 3, 4, 5 };//静态初始化变量,系统会自动分配内存空间 int[,] array = new int[2, 3];//声明一个两行3列的数组 声明并且进行初始化 [csharp] view plain copy int[,] array = new int[2, 3] { { 1, 2, 3 }, { 1, 3, 4 } }; ArrayList类是一个特殊的数组。通过添加和删除元素,就可以动态改变数组的长度。 Dictionary表示键和值的集合。 8.属性和方法(属性和方法的概念以及使用,注意,新特性中的自动属性,方法的重载) 1、类的属性:对象所拥有的特征,在类中表示时称为类的属性。 2、类的方法:对象执行的操作称为类的方法。 重载: 方法名相同。 方法的参数类型、个数、顺序至少有一项不相同。 方法的返回类型可以不相同,但只有返回类型不同是不可以的。 方法的修饰符可以不相同,但只有修饰符不同是不可以的 9.结构和类(结构的概念,类的概念,声明,构造函数,对象的实例化,类和对象的关系,实例的和静态的) 10.密封类和密封方法 密封类使用sealed关键字进行修饰,它不能用作其他类的基类,并且他没有派生类,密封类的作用是防止其他类继承该类,密封方法是使用sealed关键字进行修饰的方法,他并不能影响类的继承,但它可以防止重写基类中特定的虚方法。 [csharp] view plain copy public sealed class SealClass { } public sealed override void MyMethod() { Console.WriteLine("这是一个密封方法!"); } 本文转自 宁金峰 51CTO博客,原文链接:http://blog.51cto.com/13243523/2047608,如需转载请自行联系原作者

优秀的个人博客,低调大师

Activity的基础知识

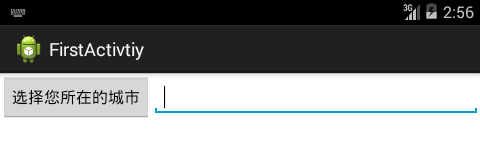
前言 长风破浪会有时,直挂云帆济沧海。 关于Activity的启动和关闭 一个Android应用程序通常都包含多个Activity,但只有一个Activity会作为程序的入口——当该Android应用运行时将会自动启动并执行该Activity。至于应用中的其他Activity,通常都由入口Activity启动,或由入口Activity启动的Activity启动。 Activity启动其他Activity有如下两个方法。 startActivity(Intent intent):启动其他Activity。 startActivityForResult(Intent intent,int requestCode):以指定的请求码(requestCode)启动Activity,而且程序将会获取新启动的Activity返回的结果(通过重写OnActivityResult(...)方法)。 上面两个方法都用到了Intent参数,Intent是Android应用里各组件之间同通信的重要方式,一个Activity通过Intent来表达自己“意图”——想要启动哪个组件,被启动的组件既可是Activity组件,也可是Service组件。 Android为关闭Activity准备了如下两个方法。 finish():结束当前Activity。 finishActivity(int requestCode):结束以startActivityForResult(Intent intent,int requestCode)方法启动的Activity。 代码示例 FirstActivity.java public class FirstActivity extends Activity { @Override protected void onCreate(Bundle savedInstanceState) { // TODO Auto-generated method stub super.onCreate(savedInstanceState); setContentView(R.layout.first_layout); Button bt = (Button) findViewById(R.id.bt); bt.setOnClickListener(new OnClickListener() { @Override public void onClick(View v) { //创建需要启动的Activity对应的Intent Intent intent = new Intent(FirstActivity.this,SecondActivity.class); //启动intent对应的Activity startActivity(intent); } }); } } SecondActivity.java public class SecondActivity extends Activity { @Override protected void onCreate(Bundle savedInstanceState) { // TODO Auto-generated method stub super.onCreate(savedInstanceState); setContentView(R.layout.seconde_layout); Button back = (Button) findViewById(R.id.back); Button back_finish = (Button) findViewById(R.id.back_finish); back.setOnClickListener(new OnClickListener() { @Override public void onClick(View v) { //创建需要启动的Activity对应的Intent Intent intent = new Intent(SecondActivity.this,FirstActivity.class); //启动intent对应的Activity startActivity(intent); } }); back_finish.setOnClickListener(new OnClickListener() { @Override public void onClick(View v) { //创建需要启动的Activity对应的Intent Intent intent = new Intent(SecondActivity.this,FirstActivity.class); //启动intent对应的Activity startActivity(intent); //结束当前Activity finish(); } }); } } 提示 上述程序的布局文件就只包含简单的按钮来实现跳转,第二个Activity唯一的区别就是finish()方法,它表明该Activity会结束自己。 使用Bundle在Activity之间交换数据 当一个Activity启动另一个Activity时,常常会有一些数据需要传过去。这时Intent就相当于一个“信使”,我们将需要传送的数据存入Intent中即可。、 Intent提供了多个方法来“携带”额外的数据,如下所示。 putExtras(Bundle data):向Intent中放入需要“携带”的数据包。 Bundle getExtras():取出Intent中所“携带”的数据包。 putExtra(String name,Xxx value):向Intent中按key-value对的形式存入数据。 getXxxExtra(String name):从Intent中按key取出指定类型的数据。 上述方法中的Bundle就是一个简单的数据携带包,该Bundle对象包含了多个方法来存入数据。 putXxx(String key, Xxx value):向Bundle中放入Int、Long等各种类型的数据。 putSerializable(String key, Serializable data):向Bundle中放入一个可序列化的对象。 getXxx(String key):从Bundle中取出Int、Long等各种类型的数据。 getSerializable(String key):从Bundle中取出一个可序列化的对象。 下面我通过一个实例来介绍Activity之间如何通过Bundle交换数据。 本程序包含两个Activity,其中第一个Activity用于收集用户的输入信息,当用户单击该Activity的“注册”按钮时,应用进入第二个Activity,第二个Activity将会获取第一个Activity中的数据。 代码示例 FirstActivity.java public class FirstActivity extends Activity { @Override protected void onCreate(Bundle savedInstanceState) { // TODO Auto-generated method stub super.onCreate(savedInstanceState); setContentView(R.layout.first_layout); Button bn = (Button) findViewById(R.id.bn); bn.setOnClickListener(new OnClickListener() { @Override public void onClick(View v) { EditText name = (EditText) findViewById(R.id.name); EditText passwd = (EditText) findViewById(R.id.passwd); RadioButton male = (RadioButton) findViewById(R.id.male); String gender = male.isChecked() ? "男" : "女"; Person p = new Person(); p.setName(name.getText().toString()); p.setPasswd(passwd.getText().toString()); p.setGender(gender); //创建一个Bundle对象 Bundle data = new Bundle(); data.putSerializable("person", p); //创建一个Intent Intent intent = new Intent(FirstActivity.this,SecondActivity.class); intent.putExtras(data); //启动intent对应的Activity startActivity(intent); } }); } } first_layout.xml <?xml version="1.0" encoding="utf-8"?> <TableLayout xmlns:android="http://schemas.android.com/apk/res/android" android:layout_width="match_parent" android:layout_height="match_parent" > <TextView android:layout_width="match_parent" android:layout_height="wrap_content" android:text="请输入您的注册信息" android:textSize="20sp" /> <TableRow> <TextView android:layout_width="match_parent" android:layout_height="wrap_content" android:text="用户名:" android:textSize="16sp" /> <EditText android:id="@+id/name" android:layout_width="match_parent" android:layout_height="wrap_content" android:hint="请填写想注册的账号" android:selectAllOnFocus="true" /> </TableRow> <TableRow> <TextView android:layout_width="match_parent" android:layout_height="wrap_content" android:text="密码:" android:textSize="16sp" /> <EditText android:id="@+id/passwd" android:layout_width="match_parent" android:layout_height="wrap_content" android:password="true" android:selectAllOnFocus="true" /> </TableRow> <TableRow> <TextView android:layout_width="match_parent" android:layout_height="wrap_content" android:text="性别:" android:textSize="16sp" /> <RadioGroup android:layout_width="match_parent" android:layout_height="wrap_content" android:orientation="horizontal" > <RadioButton android:id="@+id/male" android:layout_width="wrap_content" android:layout_height="wrap_content" android:text="男" android:textSize="16sp" /> <RadioButton android:id="@+id/female" android:layout_width="wrap_content" android:layout_height="wrap_content" android:text="女" android:textSize="16sp" /> </RadioGroup> </TableRow> <Button android:id="@+id/bn" android:layout_width="wrap_content" android:layout_height="wrap_content" android:text="注册" android:textSize="16sp" /> </TableLayout> SecondActivity.java public class SecondActivity extends Activity { @Override protected void onCreate(Bundle savedInstanceState) { // TODO Auto-generated method stub super.onCreate(savedInstanceState); setContentView(R.layout.seconde_layout); TextView name = (TextView) findViewById(R.id.name); TextView passwd = (TextView) findViewById(R.id.passwd); TextView gender = (TextView) findViewById(R.id.gender); //获取启动该Activity的Intent Intent intent = getIntent(); //直接通过Intent取出它所携带的Bundle数据包中的数据 Person p = (Person) intent.getSerializableExtra("person"); name.setText("您的用户名为:" + p.getName()); passwd.setText("您的密码为:" + p.getPasswd()); gender.setText("您的性别为:" + p.getGender()); } } seconde_layout.xml <?xml version="1.0" encoding="utf-8"?> <LinearLayout xmlns:android="http://schemas.android.com/apk/res/android" android:layout_width="match_parent" android:layout_height="match_parent" android:orientation="vertical" android:gravity="center_horizontal" > <TextView android:id="@+id/name" android:layout_width="match_parent" android:layout_height="wrap_content" android:textSize="18sp" /> <TextView android:id="@+id/passwd" android:layout_width="match_parent" android:layout_height="wrap_content" android:textSize="18sp" /> <TextView android:id="@+id/gender" android:layout_width="match_parent" android:layout_height="wrap_content" android:textSize="18sp" /> </LinearLayout> 效果 [图片上传失败...(image-e4b6ea-1514096470518)] [图片上传失败...(image-2ca6b1-1514096470519)] 提示 需要传送数据如果是对象,这个对象应该实现Serializable接口。 启动其他Activity并返回结果 前面已经提到,Activity还提供了一个startActivityForResult(Intent intent,int requestCode)方法来启动其他Activity。该方法用于启动指定Activity,而且期望获取指定Activity返回的结果。这种情况很常见,例如应用程序第一个界面需要用户进行选择,但需要选择的列表数据比较复杂,必须启动另一个Activity让用户选择。当用户在第二个Activity中选择完成后,程序返回第一个Actvity,第一个Activity必须能获取并显示用户在第二个Activity中选择的结果。在这种应用场景下,也通过Bundle进行数据交换的。 为了获取被启动的Activity所返回的结果,需要从两方面着手。 当前Activity需要重写onActivityResult(int requestCode,int resultCode,Intent intent),当被启动的Activity返回结果时,该方法会被触发,其中requestCode代表请求码,而resultCode代表Activtiy返回的结果码,由开发者自行设定。 被启动的Activtiy需要调用setResult()方法设置处理结果。 一个Activity中可能包含多个按钮,并调用多个startActivityForResult()方法来打开多个不同的Activity处理不同的业务,当这些新Activity关闭后,系统将回调前面Activity的onActivityResult(int requestCode,int resultCode,Intent data)方法。为了知道该方法是由哪个请求的结果所触发的,可利用requestCode请求码;为了知道返回的数据来自于哪个新的Activity,可利用resultCode结果码。 代码示例 FirstActivity.java public class FirstActivity extends Activity { Button bt; EditText city; @Override protected void onCreate(Bundle savedInstanceState) { // TODO Auto-generated method stub super.onCreate(savedInstanceState); setContentView(R.layout.first_layout); bt = (Button) findViewById(R.id.bt); city = (EditText) findViewById(R.id.city); bt.setOnClickListener(new OnClickListener() { @Override public void onClick(View v) { //创建需要对应于目标Activity的Intent Intent intent = new Intent(FirstActivity.this, SelectCityActivity.class); //启动指定Activity并等待返回的结果,其中0是请求码,用于标识该请求 startActivityForResult(intent, 0); } }); } //重写该方法,该方法以回调的方式来获取指定Activity返回的结果 @Override protected void onActivityResult(int requestCode, int resultCode, Intent intent) { //当requestCode、resultCode同时为0时,也就是处理特定的结果 if(requestCode == 0 && resultCode == 0) { //取出Intent里德Extras数据 Bundle data = intent.getExtras(); //取出Bundle中的数据 String resultCity = data.getString("city"); //修改city文本框的内容 city.setText(resultCity); } } } SelectCityActivity.java public class SelectCityActivity extends ExpandableListActivity { //定义省份数组 private String[] provinces = new String[] {"广西","广东","湖南","云南"}; private String[][] cities = new String[][] { {"桂林","柳州","南宁","北海"}, {"广州","深圳","珠海","中山"}, {"长沙","岳阳","衡阳","株洲"}, {"昆明","玉溪","大理","丽江"} }; @Override protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); ExpandableListAdapter adapter = new BaseExpandableListAdapter() { @Override public boolean isChildSelectable(int groupPosition, int childPosition) { return true; } @Override public boolean hasStableIds() { return true; } private TextView getTextView() { AbsListView.LayoutParams lp = new AbsListView.LayoutParams(ViewGroup.LayoutParams.MATCH_PARENT, 64); TextView textView = new TextView(SelectCityActivity.this); textView.setLayoutParams(lp); textView.setGravity(Gravity.CENTER_VERTICAL|Gravity.LEFT); textView.setPadding(36, 0, 0, 0); textView.setTextSize(20); return textView; } @Override public View getGroupView(int groupPosition, boolean isExpanded, View convertView, ViewGroup parent) { LinearLayout ll = new LinearLayout(SelectCityActivity.this); ll.setOrientation(LinearLayout.HORIZONTAL); ImageView logo = new ImageView(SelectCityActivity.this); logo.setImageResource(R.drawable.ic_launcher); ll.addView(logo); TextView textView = getTextView(); textView.setText(getGroup(groupPosition).toString()); ll.addView(textView); return ll; } @Override public long getGroupId(int groupPosition) { return groupPosition; } @Override public int getGroupCount() { return provinces.length; } @Override public Object getGroup(int groupPosition) { return provinces[groupPosition]; } @Override public int getChildrenCount(int groupPosition) { return cities[groupPosition].length; } @Override public View getChildView(int groupPosition, int childPosition, boolean isLastChild, View convertView, ViewGroup parent) { TextView textView = getTextView(); textView.setText(getChild(groupPosition, childPosition).toString()); return textView; } @Override public long getChildId(int groupPosition, int childPosition) { // TODO Auto-generated method stub return childPosition; } @Override public Object getChild(int groupPosition, int childPosition) { // TODO Auto-generated method stub return cities[groupPosition][childPosition]; } }; setListAdapter(adapter); //为列表项设置监听 getExpandableListView().setOnChildClickListener(new OnChildClickListener() { @Override public boolean onChildClick(ExpandableListView parent, View v, int groupPosition, int childPosition, long id) { //获取启动该Activity之前的Activity对应的Intent Intent intent = getIntent(); intent.putExtra("city", cities[groupPosition][childPosition]); //设置该SelectCityActivity的结果码,并设置结束之后退回的Activity SelectCityActivity.this.setResult(0, intent); //结束SelectCityActivity SelectCityActivity.this.finish(); return false; } }); } } 效果 Screenshot_20171101-145622.png Screenshot_20171101-145711.png Screenshot_20171101-145743.png 提示 别忘记每创建一个新的Activity,都要去清单文件里注册这个Activity。

优秀的个人博客,低调大师

Android 基础操作 git操作

Git 操作 git 命令 创建本地仓库 git init 获取远程仓库 git clone [url] 例:git clone https://github.com/you/yourpro.git 创建远程仓库 // 添加一个新的 remote 远程仓库 git remote add [remote-name] [url] 例:git remote add origin https://github.com/you/yourpro.git origin:相当于该远程仓库的别名 // 列出所有 remote 的别名 git remote // 列出所有 remote 的 url git remote -v // 删除一个 renote git remote rm [name] // 重命名 remote git remote rename [old-name] [new-name] 从本地仓库中删除 git rm file.txt // 从版本库中移除,删除文件 git rm file.txt -cached // 从版本库中移除,不删除原始文件 git rm -r xxx // 从版本库中删除指定文件夹 从本地仓库中添加新的文件 git add . // 添加所有文件 git add file.txt // 添加指定文件 提交,把缓存内容提交到 HEAD 里 git commit -m "注释" 撤销 // 撤销最近的一个提交. git revert HEAD // 取消 commit + add git reset --mixed // 取消 commit git reset --soft // 取消 commit + add + local working git reset --hard 把本地提交 push 到远程服务器 git push [remote-name] [loca-branch]:[remote-branch] 例:git push origin master:master 查看状态 git status 从远程库中下载新的改动 git fetch [remote-name]/[branch] 合并下载的改动到分支 git merge [remote-name]/[branch] 从远程库中下载新的改动 pull = fetch + merge git pull [remote-name] [branch] 例:git pull origin master 分支 // 列出分支 git branch // 创建一个新的分支 git branch (branch-name) // 删除一个分支 git branch -d (branch-nam) // 删除 remote 的分支 git push (remote-name) :(remote-branch) 切换分支 // 切换到一个分支 git checkout [branch-name] // 创建并切换到该分支 git checkout -b [branch-name] ##与github建立ssh通信,让Git操作免去输入密码的繁琐。 首先呢,我们先建立ssh密匙。 ssh key must begin with 'ssh-ed25519', 'ssh-rsa', 'ssh-dss', 'ecdsa-sha2-nistp256', 'ecdsa-sha2-nistp384', or 'ecdsa-sha2-nistp521'. -- from github 根据以上文段我们可以知道github所支持的ssh密匙类型,这里我们创建ssh-rsa密匙。 在command line 中输入以下指令:``ssh-keygen -t rsa``去创建一个ssh-rsa密匙。如果你并不需要为你的密匙创建密码和修改名字,那么就一路回车就OK,如果你需要,请您自行Google翻译,因为只是英文问题。 $ ssh-keygen -t rsa Generating public/private rsa key pair. //您可以根据括号中的路径来判断你的.ssh文件放在了什么地方 Enter file in which to save the key (/c/Users/Liang Guan Quan/.ssh/id_rsa): 到https://github.com/settings/keys这个地址中去添加一个新的SSH key,然后把你的xx.pub文件下的内容文本都复制到Key文本域中,然后就可以提交了。 添加完成之后 我们用ssh git@github.com命令来连通一下github,如果你在response里面看到了你github账号名,那么就说明配置成功了。let's enjoy github ;) gitignore 在本地仓库根目录创建 .gitignore 文件。Win7 下不能直接创建,可以创建 ".gitignore." 文件,后面的标点自动被忽略; /.idea // 过滤指定文件夹 /fd/* // 忽略根目录下的 /fd/ 目录的全部内容; *.iml // 过滤指定的所有文件 !.gitignore // 不忽略该文件

优秀的个人博客,低调大师

Elasticsearch 性能监控基础(转载)

转自:http://blog.csdn.net/yangwenbo214/article/details/74000458 转自:https://www.datadoghq.com/blog/monitor-elasticsearch-performance-metrics/#metrics-to-watch Cloud Insight Elastic Search 监控,默认监控以下性能指标 elasticsearch.active_primary_shards elasticsearch.active_shards elasticsearch.cache.filter.evictions elasticsearch.cache.filter.size elasticsearch.cluster_status elasticsearch.docs.count elasticsearch.docs.deleted elasticsearch.fielddata.evictions elasticsearch.fielddata.size elasticsearch.flush.total elasticsearch.flush.total.time elasticsearch.get.current elasticsearch.get.exists.time elasticsearch.get.exists.total elasticsearch.get.missing.time elasticsearch.get.missing.total elasticsearch.get.time elasticsearch.get.total elasticsearch.http.current_open elasticsearch.http.total_opened elasticsearch.id_cache.size elasticsearch.indexing.delete.current elasticsearch.indexing.delete.time elasticsearch.indexing.delete.total elasticsearch.indexing.index.current elasticsearch.indexing.index.time elasticsearch.indexing.index.total elasticsearch.initializing_shards elasticsearch.merges.current elasticsearch.merges.current.docs elasticsearch.merges.current.size elasticsearch.merges.total elasticsearch.merges.total.docs elasticsearch.merges.total.size elasticsearch.merges.total.size elasticsearch.number_of_nodes elasticsearch.pending_tasks_priority_high elasticsearch.pending_tasks_priority_urgent elasticsearch.pending_tasks_total elasticsearch.process.open_fd elasticsearch.refresh.total elasticsearch.refresh.total.time elasticsearch.relocating_shards elasticsearch.search.fetch.current elasticsearch.search.fetch.open_contexts elasticsearch.search.fetch.time elasticsearch.search.fetch.total elasticsearch.search.query.current elasticsearch.search.query.time elasticsearch.search.query.total elasticsearch.store.size elasticsearch.thread_pool.bulk.active elasticsearch.thread_pool.bulk.queue elasticsearch.thread_pool.bulk.threads elasticsearch.thread_pool.flush.active elasticsearch.thread_pool.flush.queue elasticsearch.thread_pool.flush.threads elasticsearch.thread_pool.generic.active elasticsearch.thread_pool.generic.queue elasticsearch.thread_pool.generic.threads elasticsearch.thread_pool.get.active elasticsearch.thread_pool.get.queue elasticsearch.thread_pool.get.threads elasticsearch.thread_pool.index.active elasticsearch.thread_pool.index.queue elasticsearch.thread_pool.index.threads elasticsearch.thread_pool.management.active elasticsearch.thread_pool.management.queue elasticsearch.thread_pool.management.threads elasticsearch.thread_pool.merge.active elasticsearch.thread_pool.merge.queue elasticsearch.thread_pool.merge.threads elasticsearch.thread_pool.percolate.active elasticsearch.thread_pool.percolate.queue elasticsearch.thread_pool.percolate.threads elasticsearch.thread_pool.refresh.active elasticsearch.thread_pool.refresh.queue elasticsearch.thread_pool.refresh.threads elasticsearch.thread_pool.search.active elasticsearch.thread_pool.search.queue elasticsearch.thread_pool.search.threads elasticsearch.thread_pool.snapshot.active elasticsearch.thread_pool.snapshot.queue elasticsearch.thread_pool.snapshot.threads elasticsearch.transport.rx_count elasticsearch.transport.rx_size elasticsearch.transport.server_open elasticsearch.transport.tx_count elasticsearch.transport.tx_size elasticsearch.unassigned_shards

优秀的个人博客,低调大师

python基础知识(集合)

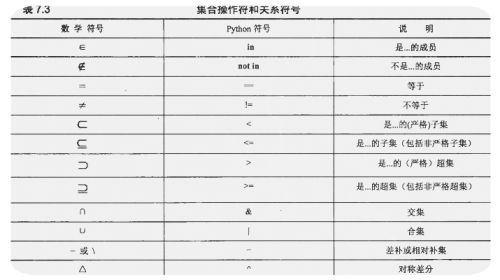
在python中集合set是一种基本数据的类型,它有可变集合(set())和不可变集合(frozenset)两种。创建集合set、集合set添加、集合删除、交集、并集、差集的操作都是非常实用的方法,接下来将介绍结合的相关知识。 一、集合特点 1、类似字典dict,但是只有key却没有value值; 2、集合的存储没有固定的顺序 3、由于集合里面的元素不能重复所以集合一般用来去重 二、集合的定义 常见的有两种方法 1 2 3 4 5 6 7 1 、直接定义类似字典但是没有value值,例如 set1 = { "openatck" , "and" , "list" , "dict" , "set" } 2 、创建一个 set ,提供一个 list 作为输入集合 set2 = set ([ "openatck" , "and" , "list" , "dict" , "set" ]) 两个的输出结果 { 'openatck' , 'list' , 'and' , 'set' , 'dict' } { 'openatck' , 'list' , 'and' , 'set' , 'dict' } 三、集合元素的操作 1、 增加元素可以使用add()方法增加元素 1 2 3 4 5 6 7 8 9 10 #!/usr/bin/envpython #_*_coding:utf-8_*_ set1 = { "openatck" , "and" , "list" , "dict" , "set" } set2 = set ([ "openatck" , "and" , "list" , "dict" , "set" ]) set2.add( "winnerlook" ) print (set1,set2) 结果: { 'set' , 'openatck' , 'and' , 'dict' , 'list' } { 'openatck' , 'winnerlook' , 'list' , 'and' , 'dict' , 'set' } 2、集合元素的增加update()方法 update()是把要传入的元素拆分,做为个体传入到集合中 1 2 3 4 5 6 7 8 9 10 11 12 13 #!/usr/bin/envpython #_*_coding:utf-8_*_ set1 = { "openatck" , "and" , "list" , "dict" , "set" } set2 = set ([ "openatck" , "and" , "list" , "dict" , "set" , "winnerlook" ]) set2.update( "winnerlook" , "MYSQlDBA" ) print (set2) 结果: { 'B' , 'M' , 'r' , 'S' , 'Y' , 'e' , 'winnerlook' , 'set' , 'i' , 'Q' ,' and ',' o ',' w ',' n ',' dict ',' k',t} 这时我们发现将我们更新传入的值全部按每个字符当做一个元素插入到当前的集合里面了 3、集合的删除 在前面列表的学习里面我们学习了clear()、pop()、remove()、del等方法可以删除列表中的元素,接下来我们分析一下集合删元素的方法。 clear()方法 clear()方法还是和列表中的一样直接会清空集合中的所有元素,例如: 1 2 3 4 5 6 7 8 9 10 #!/usr/bin/envpython #_*_coding:utf-8_*_ set1 = { "openatck" , "and" , "list" , "dict" , "set" } set2 = set ([ "openatck" , "and" , "list" , "dict" , "set" , "winnerlook" ]) #set2.update("winnerlook","MYSQlDBA") set2.clear() print (set1,set2) 结果: { 'set' , 'dict' , 'openatck' , 'list' , 'and' } set () 返回结果和是一个空的集合,而列表使用clear()方法后是返回空的列表 remove()方法 remove()方法是移除集合中的某个元素,但是元素必须存在,不然会报错 1 2 3 4 5 6 7 8 9 10 11 12 13 #!/usr/bin/envpython #_*_coding:utf-8_*_ list = [ "openatck" , "and" , "list" , "dict" , "set" ] set1 = { "openatck" , "and" , "list" , "dict" , "set" } set2 = set ([ "openatck" , "and" , "list" , "dict" , "set" , "winnerlook" ]) #set2.update("winnerlook","MYSQlDBA") set2.remove( "winnerlook" ) list .remove( "and" ) print ( list ,set2) 结果: [ 'openatck' , 'list' , 'dict' , 'set' ]{ 'openatck' , 'and' , 'dict' , 'list' , 'set' } pop()方法 集合的pop()方法和列表的pop()方法是不一样的,列表的可以带下标的去删除,列表是默认删除最后一个元素,由于集合的存储是没有固定顺序的所以删除的元素时随机的。我们看一下下面的示例,相同的程序多次执行结果却是不一致。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 #!/usr/bin/envpython #_*_coding:utf-8_*_ list = [ "openatck" , "and" , "list" , "dict" , "set" ] set1 = { "openatck" , "and" , "list" , "dict" , "set" } set2 = set ([ "openatck" , "and" , "list" , "dict" , "set" , "winnerlook" ]) #set2.update("winnerlook","MYSQlDBA") set2.pop() list .pop() print ( list ,set2) 结果 1 : [ 'openatck' , 'and' , 'list' , 'dict' ]{ 'dict' , 'winnerlook' , 'and' , 'set' , 'list' } #删除openstack 结果 2 : [ 'openatck' , 'and' , 'list' , 'dict' ]{ 'list' , 'set' , 'and' , 'openatck' , 'dict' } #删除winnerlook 结果 3 : [ 'openatck' , 'and' , 'list' , 'dict' ]{ 'list' , 'winnerlook' , 'openatck' , 'set' , 'and' } #删除dict 结果 4 : [ 'openatck' , 'and' , 'list' , 'dict' ]{ 'openatck' , 'dict' , 'winnerlook' , 'and' , 'list' } #删除set 这里为什么是随机删除的,个人猜想是因为集合里面存储顺序不是固定的原因吧,这样就会出现随机 删除的现象。 del 删除 在删除某个定义的集合时,我们还可以采用del方法,这样就可以将一个集合删除,但是这种删除会报没有定义这个集合的错。 1 2 3 4 5 6 7 8 9 10 11 12 #!/usr/bin/envpython #_*_coding:utf-8_*_ list = [ "openatck" , "and" , "list" , "dict" , "set" ] set1 = { "openatck" , "and" , "list" , "dict" , "set" } set2 = set ([ "openatck" , "and" , "list" , "dict" , "set" , "winnerlook" ]) #set2.update("winnerlook","MYSQlDBA") del set2 list .pop() print ( list ,set2) 结果: print ( list ,set2) NameError:name 'set2' is not defined discard()方法 discard() 接受一个单值作为参数,并从集合中删除该值。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 list2 [ 'winner' , 'mysql5.6' , 'mariadb' , 'redis' , 'tomcat' , 'redis' , 'DBA' , 'linuxSRA' ] >>>s3 = set (list2) >>>s3 { 'winner' , 'DBA' , 'linuxSRA' , 'mysql5.6' , 'mariadb' , 'tomcat' , 'redis' } >>>s3.discard( "DBA" ) >>>s3 { 'winner' , 'linuxSRA' , 'mysql5.6' , 'mariadb' , 'tomcat' , 'redis' } >>>s3.discard( "DBA" ) #删除没有的元素没有结果 再看看remove() >s3.remove( "winner" ) >>>s3.remove( "winner" ) Traceback(mostrecentcalllast): File "<pyshell#50>" ,line 1 , in <module> s3.remove( "winner" ) KeyError: 'winner' 小结: 1.discard() 接受一个单值作为参数,并从集合中删除该值。 2.如果针对一个集合中不存在的值调用 discard() 方法,它不进行任何操作。不产生错误;只是一条空指令。 3. remove() 方法也接受一个单值作为参数,也从集合中将其删除。 4. 区别在这里:如果该值不在集合中,remove() 方法引发一个 KeyError 例外。 4、集合的访问 由于集合本身是无序的,所以不能为集合创建索引或切片操作,只能循环遍历或使用in、not in来访问或判断集合元素。 5、元素与集合、集合与集合的关系 在我们高中学习集合相关的知识时,我们就学习到集合的交际、并集、补集等概念,而这部分概念在其python编程的数据类型集合里面还是适用的。 下面简单的演示以下上面的集合关系和相关的操作: 元素与集合的关系: in 一般是用来表示某个元素是否在某个集合里面,返回值为Ture和False 1 2 3 4 5 6 7 8 9 10 11 #!/usr/bin/envpython #_*_coding:utf-8_*_ list = [ "openatck" , "and" , "list" , "dict" , "set" ] set1 = { "openatck" , "and" , "list" , "dict" , "set" } set2 = set ([ "openstack" , "and" , "list" , "dict" , "set" , "winnerlook" ]) print ( "openstack" in set2) print ( "docker" in set2) 结果: True False 由于set2中包含openstack元素但是不包含docker元素,所以判断一个返回Ture,一个返回 False not in 其实和in表达的意思差不多 1 2 3 4 5 6 7 8 9 10 #!/usr/bin/envpython #_*_coding:utf-8_*_ list = [ "openatck" , "and" , "list" , "dict" , "set" ] set1 = { "openatck" , "and" , "list" , "dict" , "set" } set2 = set ([ "openstack" , "and" , "list" , "dict" , "set" , "winnerlook" ]) print ( "openstack" not in set2) print ( "docker" not in set2) 结果: False True == 等于关系 1 2 3 4 5 6 7 8 9 10 11 12 13 14 #!/usr/bin/envpython #_*_coding:utf-8_*_ set2 = set ([ "openstack" , "and" , "list" , "dict" , "set" , "winnerlook" ]) set3 = { "openstack" , "and" , "list" , "dict" , "set" , "winnerlook" } print (set2 = = set3) 结果: True 表示两个集合相等 set1 = { "openstack" , 9 + 8 , "list" , "dict" , "set" , "winnerlook" } set2 = set ([ "openstack" , "and" , "list" , "dict" , "set" , "winnerlook" ]) set3 = { "openstack" , 17 , "list" , "dict" , "set" , "winnerlook" } print (set1 = = set3) 结果: True 表示两个集合相等表达式和结果一样 != 不等于关系 表示两个集合的元素不一样 1 2 3 4 5 6 7 8 9 10 #!/usr/bin/envpython #_*_coding:utf-8_*_ set1 = { "openstack" , 9 + 8 , "list" , "dict" , "set" , "winnerlook" } set2 = set ([ "openstack" , "and" , "list" , "dict" , "set" , "winnerlook" ]) set3 = { "openstack" , 17 , "list" , "dict" , "set" , "winnerlook" } print (set1! = set2) print (set1! = set3) 结果: True False 集合与集合的关系 子集(<)与真子集(<=) 子集表示一个集合里面的元素被另一个集合包含,而真子集是说的一个集合的元素恰好和另一个集合相等。 1 2 3 4 5 6 7 8 9 10 11 12 13 #!/usr/bin/envpython #_*_coding:utf-8_*_ set1 = { "openstack" , 9 + 8 , "list" , "dict" , "set" , "winnerlook" } set2 = set ([ "openstack" , "and" , "list" , "dict" , "set" , "winnerlook" ]) set3 = { "openstack" , 17 , "list" , "dict" , "set" , "winnerlook" } set4 = { "openstack" , "list" , "dict" , "set" , "winnerlook" } print (set1< = set3) print (set4<set1) print (set4< = set3) 结果: True True True 严格超集(>)和非严格超集(>=) 这里的关系和上面的字迹关系是一样的,只不过是用的表示相反的关系 1 2 3 4 5 6 7 8 9 10 11 12 13 #!/usr/bin/envpython #_*_coding:utf-8_*_ set1 = { "openstack" , 9 + 8 , "list" , "dict" , "set" , "winnerlook" } set2 = set ([ "openstack" , "and" , "list" , "dict" , "set" , "winnerlook" ]) set3 = { "openstack" , 17 , "list" , "dict" , "set" , "winnerlook" } set4 = { "openstack" , "list" , "dict" , "set" , "winnerlook" } print (set1> = set3) print (set4>set1) print (set4> = set3) 结果: True False False 交集(&)或者用intersection() 表示两个集合中相同的元素 1 2 3 4 5 6 7 8 9 10 11 #!/usr/bin/envpython #_*_coding:utf-8_*_ set1 = { "openstack" , 9 + 8 , "list" , "dict" , "set" , "winnerlook" } set2 = set ([ "openstack" , "list" , "dict" , "winnerlook" , 99 , 100 , 0.99 ]) #set3={"openstack",17,"list","dict","set","winnerlook"} #set4={"openstack","list","dict","set","winnerlook"} print (set1&set2) print (set1.intersection(set2)) 结果: { 'openstack' , 'list' , 'dict' , 'winnerlook' } { 'openstack' , 'list' , 'dict' , 'winnerlook' } 并集 (|)或者用union()表示 表示两个集合中一共包含的元素 1 2 3 4 5 6 7 8 9 10 11 12 13 #!/usr/bin/envpython #_*_coding:utf-8_*_ set1 = { "openstack" , 9 + 8 , "list" , "dict" , "set" , "winnerlook" } set2 = set ([ "openstack" , "list" , "dict" , "winnerlook" , 99 , 100 , 0.99 ]) #set3={"openstack",17,"list","dict","set","winnerlook"} #set4={"openstack","list","dict","set","winnerlook"} #print(set1&set2) #print(set1.intersection(set2)) print (set1|set2) print (set1.union(set2)) 结果: { 0.99 , 99 , 100 , 'dict' , 'set' , 17 , 'winnerlook' , 'list' , 'openstack' } { 0.99 , 99 , 100 , 'dict' , 'set' , 17 , 'winnerlook' , 'list' , 'openstack' } 差补(-)或者difference() 相对补集 1 2 3 4 5 6 7 8 9 10 11 12 13 14 #!/usr/bin/envpython #_*_coding:utf-8_*_ set1 = { "openstack" , 9 + 8 , "list" , "dict" , "set" , "winnerlook" } set2 = set ([ "openstack" , "list" , "dict" , "winnerlook" , 99 , 100 , 0.99 ]) #set3={"openstack",17,"list","dict","set","winnerlook"} #set4={"openstack","list","dict","set","winnerlook"} #print(set1&set2) #print(set1.intersection(set2)) print (set1 - set2) print (set1.difference(set2)) 结果: { 17 , 'set' } { 17 , 'set' } set2相对sst1的补集即set2中有,但是set1中是没有的 对称差分(^)或者symmetric_difference() 对称差分是集合的XOR(‘异或’),取得的元素属于set1,set2但不同时属于set1和set2 1 2 3 4 5 6 7 8 9 10 11 12 13 #!/usr/bin/envpython #_*_coding:utf-8_*_ set1 = { "openstack" , 9 + 8 , "list" , "dict" , "set" , "winnerlook" } set2 = set ([ "openstack" , "list" , "dict" , "winnerlook" , 99 , 100 , 0.99 ]) #set3={"openstack",17,"list","dict","set","winnerlook"} #set4={"openstack","list","dict","set","winnerlook"} #print(set1&set2) #print(set1.intersection(set2)) print (set1^set2) print (set1.symmetric_difference(set2)) 结果: { 0.99 , 17 , 99 , 100 , 'set' } { 0.99 , 17 , 99 , 100 , 'set' } 6、集合之间的and与or关系 注意and关系是取值set2 or关系是取值set1 1 2 3 4 5 6 7 8 9 10 11 12 13 #!/usr/bin/envpython #_*_coding:utf-8_*_ set1 = { "openstack" , 9 + 8 , "list" , "dict" , "set" , "winnerlook" } set2 = set ([ "openstack" , "list" , "dict" , "winnerlook" , 99 , 100 , 0.99 ]) #set3={"openstack",17,"list","dict","set","winnerlook"} #set4={"openstack","list","dict","set","winnerlook"} #print(set1&set2) #print(set1.intersection(set2)) print (set1 and set2) print (set1 or set2) { 0.99 , 99 , 100 , 'dict' , 'winnerlook' , 'list' , 'openstack' } { 'dict' , 'set' , 'winnerlook' , 17 , 'list' , 'openstack' } 7、集合、列表、元组、字符串之间转换 我们可以将集合根据不同的数据类型转换成其他的格式 list(set1)将集合转换成列表 tuple(set1)将集合转换成元组 str(set1) 将集合转换成字符串 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 #!/usr/bin/envpython #_*_coding:utf-8_*_ set1 = { "openstack" , 9 + 8 , "list" , "dict" , "set" , "winnerlook" } set2 = set ([ "openstack" , "list" , "dict" , "winnerlook" , 99 , 100 , 0.99 ]) #set3={"openstack",17,"list","dict","set","winnerlook"} #set4={"openstack","list","dict","set","winnerlook"} #print(set1&set2) #print(set1.intersection(set2)) print ( str (set1), type ( str (set1))) print ( list (set1), type ( list (set1))) print ( tuple (set1), type ( tuple (set1))) 结果: { 'set' , 'list' , 'winnerlook' , 'dict' , 17 , 'openstack' }< class 'str' > [ 'set' , 'list' , 'winnerlook' , 'dict' , 17 , 'openstack' ]< class 'list' > ( 'set' , 'list' , 'winnerlook' , 'dict' , 17 , 'openstack' )< class 'tuple' > 8、集合的简单应用 由于集合的元素不能重复,所以可以用来去重 1 2 3 4 5 list2 = [ 2 , - 3 , - 8 , 0 , 100 , 5005 , 737737 , 10010 , - 3 , - 8 , 0 , 100 , 10010 ] set222 = set (list2) print (set222) 结果: { 0 , 2 , 100 , 737737 , 5005 , - 8 , 10010 , - 3 } 四、集合的内建函数与内建方法 1、len():返回集合元素个数 2、set()、frozenset()工厂函数 3、所有集合方法: 4、仅适合可变集合的 本文转自 tianya1993 51CTO博客,原文链接:http://blog.51cto.com/dreamlinux/1910566,如需转载请自行联系原作者

优秀的个人博客,低调大师

SQL Server内存架构基础

翻译自: https://mssqlwiki.com/sqlwiki/sql-performance/basics-of-sql-server-memory-architecture/ 1.32位SQL Server内存架构 在Win32内存架构里,每个进程有4GB的虚拟地址空间。默认情况下,2GB的地址空间可从用户模式访问(应用程序像SQL Server),剩下的2GB可从内核模式访问。 所以,在32位Windows架构里,SQL Server最大可用内存为2GB。 注意:当/3GB开关启用后,用户模式地址空间变为3GB,而内核模式变为1GB。当32位SQL Server运行在64位Windows下(WOW64),它获得4GB的用户地址空间。它也可以在WOW64模式下影响AWE,并可以使用多于4GB内存。 SQL Server“用户地址空间(User address space)”分为两个部分:MemToleave和Buffer Pool。 MemToLeave(MTL)和Buffer Pool(BPool)的大小由SQLServer在启动时决定,如下: MTL(Memory to Leave) = (Stack size * max worker threads) +Additional space(By default 256 MB and can be controlled by -g) Stack size = 512 KB per thread for 32 Bit SQL Server I.e = (256 * 512KB) + 256MB = 384MB 加载DLL的额外空间从SQL Server 2000开始为256MB。该空间用于存储: COM对象 扩展存储过程 进程中加载的链接服务器的内存分配或者在SQL Server进程中其他DLL的加载 SQL Server内存管理器的内存分配,如果分配大小大于8K需要持续内存(Multiple_pages_kb)。 SQLCLR 注意,加载DLL的额外空间可以使用-g启动参数修改。 在任何机器上,使用少于4个处理器时,最大工作线程(Maximum worker Thread)默认总是为256MB(除非,我们使用sp_configure修改该值)。 SQL Server Buffer Pool为“Phyiscal RAM”和“user modememory(2GB or 3GB) - MTL”的最小值- BUF structures: BPool = Minimum(Physical memory, User address space – MTL) –BUF structures 为了确保MemToLeave持续分配,SQL Server首先保留MTL,然后是所有的Buffer Pool区域,最后释放MemToLeave区域。 在BPOOL中是什么? 数据页/索引页和SQL Server内存管理器分配的内存,用于以下memory clerk之一。如果内存请求<=8KB。 CACHESTORE_PHDR CACHESTORE_XMLDBTYPE CACHESTORE_EVENTS MEMORYCLERK_SQLSTORENG MEMORYCLERK_XE CACHESTORE_XPROC OBJECTSTORE_SNI_PACKET CACHESTORE_BROKERRSB OBJECTSTORE_SERVICE_BROKER MEMORYCLERK_SQLSERVICEBROKERTRANSPORT MEMORYCLERK_XE_BUFFER CACHESTORE_XMLDBATTRIBUTE MEMORYCLERK_SQLOPTIMIZER USERSTORE_OBJPERM USERSTORE_TOKENPERM CACHESTORE_FULLTEXTSTOPLIST MEMORYCLERK_SQLGENERAL MEMORYCLERK_SQLHTTP CACHESTORE_NOTIF CACHESTORE_XMLDBELEMENT OBJECTSTORE_LOCK_MANAGER MEMORYCLERK_SQLBUFFERPOOL MEMORYCLERK_SQLSOAP MEMORYCLERK_TRACE_EVTNOTIF CACHESTORE_CONVPRI MEMORYCLERK_QSRANGEPREFETCH CACHESTORE_BROKERREADONLY MEMORYCLERK_SQLCLRASSEMBLY MEMORYCLERK_SOSNODE CACHESTORE_STACKFRAMES MEMORYCLERK_SQLCONNECTIONPOOL MEMORYCLERK_SQLSERVICEBROKER CACHESTORE_OBJCP MEMORYCLERK_SQLQUERYPLAN OBJECTSTORE_SECAUDIT_EVENT_BUFFER OBJECTSTORE_LBSS MEMORYCLERK_FULLTEXT CACHESTORE_TEMPTABLES CACHESTORE_BROKERTBLACS MEMORYCLERK_SQLXML USERSTORE_SXC MEMORYCLERK_BHF CACHESTORE_SQLCP CACHESTORE_SYSTEMROWSET USERSTORE_SCHEMAMGR MEMORYCLERK_SQLQUERYCOMPILE CACHESTORE_BROKERTO CACHESTORE_BROKERKEK MEMORYCLERK_SNI MEMORYCLERK_FULLTEXT_SHMEM CACHESTORE_BROKERUSERCERTLOOKUP USERSTORE_DBMETADATA CACHESTORE_VIEWDEFINITIONS MEMORYCLERK_SQLQUERYEXEC CACHESTORE_BROKERDSH MEMORYCLERK_SQLSOAPSESSIONSTORE MEMORYCLERK_SQLQERESERVATIONS MEMORYCLERK_HOST MEMORYCLERK_SQLXP MEMORYCLERK_SQLUTILITIES 在MTL(Non-BPool)中是什么? COM对象 SQL Server CLR 链接服务器OLEDB提供者分配的内存和在SQL Server进程里第三方DLL的加载 扩展存储过程 网络包 内存管理器消耗的内存。如果内存请求>8KB,并需要持续分配。 BUF Structures是什么? SQL Server对每一页维护着一个BUF结构。该结构用于跟踪与每个buffer相关的状态信息,像buffer latch,一个指向实际8KB页的指针,状态位表明该页是否为脏页,有IO处理。 注意,当AWE启用后,BUF structure维护对于整个RAM调整最大服务器内存不用重启SQL Server。 PAE是什么? PAE用于增加32位处理器寻址多于4GB物理内存的能力。在boot.ini中,启用/PAE使得操作系统利用多于4GB物理内存。 什么是SQL Server里的AWE? 当AWE启用,32位的SQL Server将能够使用AWE分配器API寻址多于4GB物理内存。 注意,在32位SQL Server里,只有数据页和索引页可以放在AWE内存里。因此,对于其他SQL Server内存对象的可用内存仍然被限制在用户地址空间。 使用AWE分配器API的内存分配不是进程工作集的一部分,因此不能被页交换,在任务管理和perfmon里private bytes或者working set部分不可见。 SQL Server启动账号需要内存中锁定页面权限来使用AWE分配器API。 在64位系统里,如果你有AWE分配器API用于分配内存的SQL Server启动账号的内存锁定页面权限,那sp_configure ‘awe enabled’没有任何作用。 /3GB开关是什么? /3GB开关用于Boot.ini文件。 当我们启用/3GB。SQL Server的用户地址空间或者任何使用IMAGE_FILE_LARGE_ADDRESS_AWARE的应用程序将会增加到3GB,而限制内核模式地址空间为1GB。 当系统中的物理内存超过16GB,并且使用/3GB开关,操作系统将会忽略额外的内存,直到/3GB开关被移除。这是因为内核增加的大小需要支持更多页面表条目(Page table Entries)。 AWE如何工作?AWE分配器API是什么? AWE API激活程序寻址多于通过标准32位寻址的4GB内存。 AWE API如何使用? 匹配AWE页面分配地址空间。 ADD=VirtualAlloc(lpaddress,size,MEM_RESERVE |MEM_PHYSICAL,PAGE_READWRITE); 分配不能被页交换的物理内存。 bResult=AllocateUserPhysicalPages(GetCurrentProcess(),&sizemap,aRAMPages); 匹配一个到你地址空间的页面视图。 bResult=MapUserPhysicalPages(ADD,sizemap,aRAMPages); 2.64位SQL Server内存架构 在64位Windows里,每个进程获得高达8TB的地址空间,因此SQL Server不需要预留一定的内存地址空间用于Non-Bpool分配。 在64位SQL Server里有三种内存模型: Conventional–普通物理页面大小(4/8KB),内存可以页交换,动态的 Locked–普通物理页面大小(4/8KB),Bpool不能被页交换,动态的,需要SQLServer启动账号有内存中锁定页面权限,内存通过使用AWE API分配 Large–大物理页面大小(>=2MB),不可页交换,静态,在启动时内存确定,推荐使用“Max server memory”,需要SQL Server启动账号有内存中锁定页面权限和TF834(只在企业版支持,使用>8GB内存)。 内存计算在64位SQL Server是非常明确的。 SQL Server在启动时计算内存大小并保留它,minimum(reserved space, “Max server memory”)用于Bpool。 类似于32位SQL Server,在64位SQL Server也有Bpool外的内存分配,被称为Non-Bpool分配。 在Bpool外谁分配内存? COM对象 SQL Server CLR 链接服务器OLEDB提供者和在SQL Server进程里第三方DLL加载的内存分配 扩展存储过程 网络包 通过内存管理器消耗的内存。如果内存请求大于8KB并且需要持续分配。 备份 线程的内存(在64位SQL Server里stack size是2MB) 最大服务器内存只控制了Bpool,它不控制Non-Bpool分配,这就是为什么SQLServer内存使用大于“Max server memory”的原因。 总结: 当“内存中锁定页面被使用”操作系统不能页交换出Bpool,而Non-Bpool分配仍可以被页交换。 Sp_configure “awe enabled”选项在64位SQL Server里没有用。 “Max server memory”只限制Bpool,因此SQL Server内存使用将会大于“Max server memory”。 如果你的操作系统是Windows 2003(Windows 2008的话随便你),确保先考虑被其他应用程序、操作系统、驱动、SQL Server Non-Bpool分配等需要的内存,然后设置合适的SQL Server最大服务器内存。 注意:以上架构适用于SQL Server2008 R2及以下版本。SQL Server 2012(Denali)与之前版本相比,内存管理器在有效地方式管理SQL Server内存消耗上做出了很多改变。点击这里,了解SQL Server 2012内存架构。 内存体系结构(SQL Server2008 R2) https://msdn.microsoft.com/zh-cn/library/ms187499.aspx 本文转自UltraSQL51CTO博客,原文链接:http://blog.51cto.com/ultrasql/1789618 ,如需转载请自行联系原作者

优秀的个人博客,低调大师

mysql基础(八)mysql日志

1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 mysql日志类型: 1 、查询日志(通常不会开启,也不建议开启) 2 、慢查询日志(建议开启) 3 、错误日志(建议开启) 4 、二进制日志(建议开启) 5 、中继日志 6 、事务日志(帮助事务型存储引擎完成ACID测试) mysql>SHOWGLOBALVARIABLESLIKE '%log%' ; #查看和日志相关的变量 查询日志: general_log = ON|OFF #是否开启查询日志 general_log_file = PATH #查询日志文件路径 log_output = FILE |TABLE|NONE #输出方式,默认为FILE 慢查询日志:执行时长超出指定时长的查询操作 mysql>SHOWGLOBALVARIABLESLIKE 'long_query_time' ; #查看超时时长 服务器变量: slow_query_log = ON|OFF #是否开启慢查询日志 log - slow - queries = PATH #慢查询日志存储路径,默为HOSTNAME-slow.log log_output = FILE |TABLE #输出方式,默认为FILE mysqldumpslow #慢查询日志分析工具 错误日志: 1 、记录mysql启动和关闭过程中产生的事件信息 2 、记录mysql运行过程中产生的错误信息 3 、在主从架构中,从服务器上启动从服务器线程产生的信息 服务器变量: log_error = OFF|ON|PATH #启动错误日志,如果不指定错误日志位置将使用默认位置 log_warnings = 0 | 1 #是否记录警告信息 二进制日志:记录导致数据改变或者有可能导致数据发生改变的SQL语句 功能:用于实现通过 "重放" 日志文件中的事件来生成数据副本 mysql>SHOWMASTERLOGS; #查看可使用的二进制日志文件列表 mysql>SHOWMASTERSTATUS; #查看正在使用的二进制日志文件 mysql>SHOWBINLOGEVENTS; #查看二进制日志文件内容 服务器变量: sql_log_bin = OFF|ON #是否开启二进制日志 log_bin = OFF|ON #是否开启二进制日志,必须同时启用才能生效 binlog_format = STATEMENT|ROW|MIXED #二进制日志格式 max_binlog_size = #单个二进制文件最大大小 1 、到达最大大小时自动滚动 2 、重启后自动滚动 sync_binlog = 0 | 1 #是否同步写入,默认为异步写入 1 、同步写入会影响服务器性能 2 、异步写入可能会造成数据丢失 二进制文件格式: 基于语句的记录:STATEMENT 优点:在相同体积下记录的数据更多 缺点:不能保证回放的数据和源数据完全相同 如:mysql>INSERTINTOtestVALUE( 1 ,now()); #每一次获取的系统时间都不相同 基于行(数据)的记录:ROW 优点:能保证回放的数据和源数据基本相同 缺点:在相同体积下记录的数据更少 混合模式:MIXED,由系统判定基于那种方式进行存储 二进制文件的构成: 日志文件:mysql - bin . 00000X #二进制文件 索引文件:mysql - bin .index #保存当前可用的二进制日志文件列表 二进制日志事件的格式: mysqlbinlog #二进制文件分析工具 使用格式:mysqlbinlog[ - - start - position = 事件开始位置]二进制日志文件 例:mysqlbinlogmysql - bin . 000003 #at655 #1702208:33:37serverid1end_log_pos731Querythread_id=12exec_time=0error_code=0 SET TIMESTAMP = 1487550817 / * ! * / ; BEGIN / * ! * / ; 事件的起始位置:at 655 事件发生的时间: 170220 8 : 33 : 37 server id 1 :server id ,在做mysql集群时必须保证server id 全局唯一 事件的结束位置:end_log_pos 731 事件的类型:Query 事件发生时所在服务器执行此事件的线程 ID :thread_id = 12 语句执行和将其写入二进制日志中的时间差 错误代码:error_code 中继日志:主从架构中实现主从复制的从服务日志,主要用于保存从二进制日志文件中读取事件 事务日志: 由事务型存储自行管理和使用 清理日志: PURGEBINARYLOGSTO 'mysql-bin.010' ; #清除指定日志之前的二进制日志 PURGEBINARYLOGSBEFORE '2008-04-0222:46:26' ; #清除指定时间之前的二进制日志 本文转自 红尘世间 51CTO博客,原文链接:http://blog.51cto.com/hongchen99/1933882

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册