首页 文章 精选 留言 我的

精选列表

搜索[mapreduce],共3589篇文章
优秀的个人博客,低调大师

如果遇到Hadoop集群正常,MapReduce作业运行出现错误,如何来查看作业运行日志(图文详解)

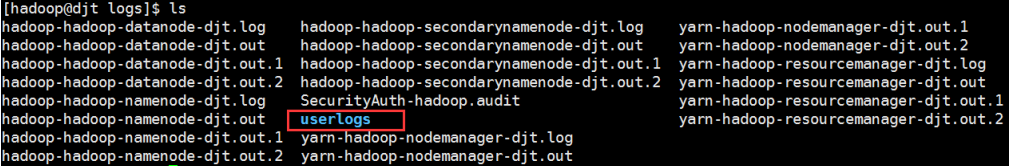
这个时候我们可以进入logs下的userlogs 备注:userlogs目录下有很多个以往运行的作业,我选择最新的最大编号的作业,就是我们当前运行作业的日志。然后找到stderr stdout syslog文件,stderr为作业错误日志,stdout作业输出日志,syslog为系统日志 本文转自大数据躺过的坑博客园博客,原文链接:http://www.cnblogs.com/zlslch/p/7643664.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

一脸懵逼学习Hive的安装(将sql语句翻译成MapReduce程序的一个工具)

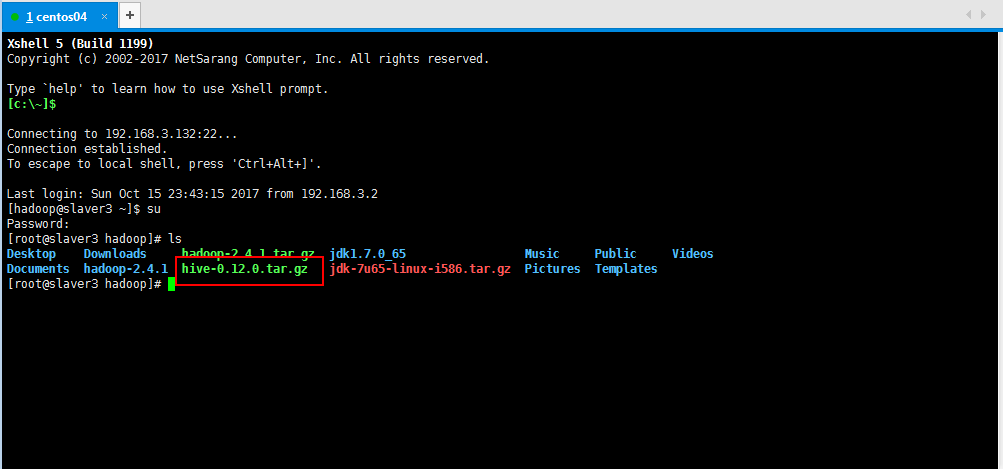
Hive只在一个节点上安装即可: 1.上传tar包:这个上传就不贴图了,贴一下上传后的,看一下虚拟机吧: 2.解压操作: [root@slaver3 hadoop]# tar -zxvf hive-0.12.0.tar.gz 解压后贴一下图: 3:解压缩以后启动一下hive: 4:开始操作sql: 好吧,开始没有启动集群,输入mysql创建数据库命令,直接不屌我,我也是苦苦等待啊; 5:启动我的集群,如下所示,这里最后帖一遍部署以后集群关了,重新开启集群的步骤,不能按照部署集群的时候进行格式化一些操作,如下所示: 第一先:启动zookeeper集群(分别在master、slaver1、slaver2上启动zookeeker) 第二步:启动journalnode(分别在master、slaver1、slaver2上启动): 运行jps命令检验,master、slaver1、slaver2上多了JournalNode进程; 第三步:启动HDFS(在slaver3上执行): 第四步:启动YARN(#####注意#####:是在weekend03上执行start-yarn.sh,把namenode和resourcemanager分开是因为性能问题,因为他们都要占用大量资源,所以把他们分开了,他们分开了就要分别在不同的机器上启动) 6:然后操作hive,开始居然还报错了,对于一个小白来说,每一个错都是刻骨铭心啊,下面贴一下错误,也许能帮助到他人; 错误如下所示: hive> create database user; FAILED: Execution Error, return code 1 from org.apache.hadoop.hive.ql.exec.DDLTask. MetaException(message:Got exception: org.apache.hadoop.ipc.RemoteException org.apache.hadoop.hdfs.server.namenode.SafeModeException: Cannot create directory /user/hive/warehouse/user.db. Name node is in safe mode. The reported blocks 0 needs additional 27 blocks to reach the threshold 0.9990 of total blocks 27. The number of live datanodes 0 has reached the minimum number 0. Safe mode will be turned off automatically once the thresholds have been reached. at org.apache.hadoop.hdfs.server.namenode.FSNamesystem.checkNameNodeSafeMode(FSNamesystem.java:1211) at org.apache.hadoop.hdfs.server.namenode.FSNamesystem.mkdirsInt(FSNamesystem.java:3590) at org.apache.hadoop.hdfs.server.namenode.FSNamesystem.mkdirs(FSNamesystem.java:3566) at org.apache.hadoop.hdfs.server.namenode.NameNodeRpcServer.mkdirs(NameNodeRpcServer.java:754) at org.apache.hadoop.hdfs.protocolPB.ClientNamenodeProtocolServerSideTranslatorPB.mkdirs(ClientNamenodeProtocolServerSideTranslatorPB.java:558) at org.apache.hadoop.hdfs.protocol.proto.ClientNamenodeProtocolProtos$ClientNamenodeProtocol$2.callBlockingMethod(ClientNamenodeProtocolProtos.java) at org.apache.hadoop.ipc.ProtobufRpcEngine$Server$ProtoBufRpcInvoker.call(ProtobufRpcEngine.java:585) at org.apache.hadoop.ipc.RPC$Server.call(RPC.java:928) at org.apache.hadoop.ipc.Server$Handler$1.run(Server.java:2013) at org.apache.hadoop.ipc.Server$Handler$1.run(Server.java:2009) at java.security.AccessController.doPrivileged(Native Method) at javax.security.auth.Subject.doAs(Subject.java:415) at org.apache.hadoop.security.UserGroupInformation.doAs(UserGroupInformation.java:1556) at org.apache.hadoop.ipc.Server$Handler.run(Server.java:2007) Caused by: org.apache.hadoop.hdfs.server.namenode.SafeModeException: Cannot create directory /user/hive/warehouse/user.db. Name node is in safe mode. The reported blocks 0 needs additional 27 blocks to reach the threshold 0.9990 of total blocks 27. The number of live datanodes 0 has reached the minimum number 0. Safe mode will be turned off automatically once the thresholds have been reached. at org.apache.hadoop.hdfs.server.namenode.FSNamesystem.checkNameNodeSafeMode(FSNamesystem.java:1207) ... 13 more ) 然后百度了一下,大眼一瞄,可能是防火墙的原因,先关防火墙,先从这种解决问题的方向为入口,不然都是大问题了,然后七台机器的防火墙都关了: 然后就可以了,具体的HIVE学习,待慢慢深学,至少现在入门了; 6:可以将hive配置环境变量,这样就可以在任何位置启动它了,不用每次都要切换到hive的目录了: 7:启动好hive可以查看数据库(show databases;),创建数据库(create database test;),删除数据库(drop database test;),使用数据库(use test;),创建数据表(create table tb_user(id int,name string);),将数据传输到hadoop分布式集群上面: 创建vim tb_user文件,写上几行数据: 然后将测试数据上传到集群上面:[root@master data_hadoop]# hadoop fs -put tb_user /user/hive/warehouse/test.db/tb_user可以在浏览器查看到已经上传成功了: 下面可以使用hive命令进行查询操作: 由于上传数据格式的差异化,这里查询需要注意对数据进行定义数据格式;不然无法解析 hive> select * from tb_user; OK NULL NULL NULL NULL NULL NULL NULL NULL NULL NULL Time taken: 5.338 seconds, Fetched: 5 row(s) hive> 清空一张表(清空以后还可以继续进行查询,看看是否清空即可):hive> truncate table tb_user; 详细hive的学习见下篇博客,完结; 待续......

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册