首页 文章 精选 留言 我的

精选列表

搜索[k8s],共4786篇文章
优秀的个人博客,低调大师

K8s集群又崩了,这次我终于搞清楚了原因

![](https://developer.qcloudimg.com/http-save/yehe-11081884/1c93470795634286b8f1fb34111171cf.jpg) 凌晨三点,刺耳的手机警报把你从梦中拽醒——“生产集群节点大面积NotReady”。你睡眼惺忪地爬起来,面对着一片飘红的监控大盘,`kubectl`命令像石沉大海,业务流量开始断崖式下跌。这种场景,是不是似曾相识? Kubernetes集群的崩溃,往往不是单一故障点引发的“雪崩”,而是多个系统性问题积累到临界点的“总爆发”。今天,我就结合多次“救火”经历,为你梳理出导致集群“暴毙”的几个最核心、也最容易被忽略的深层原因。下次再遇到,你就能直奔主题,而不是在黑暗中盲目试错。 --- ## **一、etcd:那个沉默的“心脏骤停者”** **问题现象**:`kubectl`命令超时或无响应,API Server间歇性报错,节点状态更新延迟,甚至整个集群控制平面“僵死”。 **根本原因**:etcd作为Kubernetes的“分布式数据库”,存储着所有集群状态。当它出问题时,整个集群的“大脑”就宕机了。常见死因包括: 1. **磁盘写满**:默认2GB的`quota-backend-bytes`在大型集群中很快耗尽,etcd进入只读模式,集群变为“植物人”。 etcd官方文档 1. **性能瓶颈**:低配硬件(机械硬盘、低内存)、未开启压缩导致历史版本堆积,使读写延迟飙升。 1. **网络分区或脑裂**:etcd集群节点间通信中断,无法达成共识,导致数据不一致。 1. **大对象冲击**:单个巨大的ConfigMap或Secret写入,超过默认的`max-request-bytes`(1.5MB),导致请求被拒绝。 **排查与止血**: ``` # 1. 检查etcd成员健康状态(需在etcd节点执行,并指定证书) ETCDCTL_API=3 etcdctl --endpoints=https://127.0.0.1:2379 \ --cacert=/etc/kubernetes/pki/etcd/ca.crt \ --cert=/etc/kubernetes/pki/etcd/healthcheck-client.crt \ --key=/etc/kubernetes/pki/etcd/healthcheck-client.key \ endpoint health # 2. 检查etcd存储空间使用情况 etcdctl --write-out=table endpoint status # 3. 查看etcd日志(通常与kubelet日志一起) journalctl -u etcd -f ``` **关键线索**:日志中出现“`database space exceeded`”、“`raft: stopped heartbeat`”、“`request too large`”等字样。 **根治建议**: - **扩容与调优**:参考上篇调优文章,增加`quota-backend-bytes`(如8GB),设置`auto-compaction-retention`(如8小时),提升`max-request-bytes`(如10MB)。 - **硬件隔离**:为etcd配备SSD、独立CPU和充足内存,绝不与计算节点混部。 - **定期备份与演练**:使用`etcdctl snapshot save`定期备份,并演练恢复流程。 --- ## **二、网络插件(CNI):那根被踩断的“大动脉”** **问题现象**:节点状态突然变为`NotReady`,Pod间网络不通,跨节点服务调用失败,但节点本身SSH可连,`kubelet`进程也在运行。 **根本原因**:Calico、Flannel、Cilium等CNI插件是集群的“神经系统”。其故障会导致Pod网络平面瘫痪。常见原因: 1. **DaemonSet Pod崩溃**:CNI插件的`DaemonSet` Pod(如`calico-node`)因资源不足、镜像拉取失败或配置错误而`CrashLoopBackOff`。 1. **IP地址池耗尽**:Pod数量增长导致分配给节点的IP子网(如Calico的`IPPool`)耗尽,新Pod无法获得IP。 1. **底层网络规则混乱**:`iptables`或`ipvs`规则被异常程序修改,或`netfilter`连接跟踪表`nf_conntrack`满,导致新连接无法建立。 1. **节点内核参数不兼容**:某些CNI插件(如Calico的IPIP模式)需要特定的内核模块或参数支持。 **排查与止血**: ``` # 1. 检查故障节点上的CNI插件Pod状态 kubectl get pods -n kube-system -o wide | grep | grep # 2. 查看CNI插件Pod的日志 kubectl logs -n kube-system --tail=50 # 3. 检查节点网络配置(以Calico为例,检查是否生成了网络接口和路由) ssh ip addr show | grep cali ssh route -n # 4. 检查系统连接跟踪表状态 ssh sysctl net.netfilter.nf_conntrack_count ssh sysctl net.netfilter.nf_conntrack_max ``` **关键线索**:CNI Pod状态异常、日志报错、节点上缺少`cali*`虚拟网卡或路由。 **根治建议**: - **资源保障**:为CNI DaemonSet设置合理的`resources.requests/limits`,防止因资源竞争被驱逐。 - **规划IP地址池**:根据集群规模预估Pod数量,预留足够的IP地址空间。 - **优化内核参数**:调整`nf_conntrack_max`、`net.ipv4.ip_forward=1`等参数。 - **选择稳定CNI**:生产环境选择经过大规模验证的CNI插件,并关注其版本兼容性。 --- ## **三、资源耗尽与组件竞争:无声的“内耗战争”** **问题现象**:集群响应变慢,调度延迟增加,部分节点`NotReady`,系统组件(如`kube-dns`)频繁重启,但监控显示整体CPU/内存使用率并不高。 **根本原因**:这是一种更隐蔽的问题。不是资源绝对不足,而是关键的系统组件(控制平面)与业务容器之间,或者不同系统组件之间,发生了资源竞争,导致“系统饥饿”。 1. **API Server过载**:大量`LIST/WATCH`请求(如来自众多Pod的日志收集组件)打满默认的并发连接数(`--max-requests-inflight=400`),阻塞了`kubelet`的心跳上报和调度器请求,引发连锁反应。 1. **节点内核资源耗尽**:进程号`PID`、文件描述符`fd`、内存页等底层资源被某个异常Pod耗尽,导致节点上所有容器(包括`kubelet`、`containerd`)不稳定。 1. **kubelet 内存泄漏**:旧版本`kubelet`可能存在内存泄漏,长时间运行后OOM,导致节点失联。 **排查与止血**: ``` # 1. 检查API Server监控指标(如有Prometheus) # 关注:request_rate, request_duration_seconds, inflight_requests # 2. 检查节点资源(SSH到节点) ssh top# 看整体和kubelet/containerd进程资源 ssh cat /proc/sys/kernel/pid_max ssh df -h /var/lib/kubelet # 检查kubelet数据盘 # 3. 查看kubelet日志 journalctl -u kubelet -f--tail=100 ``` **关键线索**:API Server延迟高、`kubelet`日志出现“`PLEG is not healthy`”、节点`/var/log/messages`中有`oom-killer`或`task fork failed`等日志。 **根治建议**: - **调优控制平面**:如上一篇调优文章所述,提升API Server的并发参数(`max-requests-inflight`,`max-mutating-requests-inflight`),为系统组件设置高优先级。 - **资源隔离与限制**:为所有Pod(包括系统组件)设置合理的资源限制,避免单个Pod吞噬所有资源。使用`LimitRange`和`ResourceQuota`。 - **升级与维护**:保持`kubelet`、`containerd`等基础组件为稳定版本,定期重启以释放潜在泄漏。 --- ## **总结** 集群崩溃后的排查固然重要,但最高明的运维是让故障不发生。基于以上分析,我为你总结了一份“集群健壮性清单”: 1. **监控先行**:不仅要监控CPU/内存,更要监控**etcd性能指标**(存储大小、读写延迟)、**API Server并发与延迟**、**CNI插件Pod状态**、**节点内核资源**(PID、fd、inotify)。 1. **容量规划**:定期评估集群容量,包括Pod数量、存储空间、IP地址池,提前扩容,避免触及极限。 1. **变更管控**:任何对集群的修改(升级、配置变更、应用部署)都要有回滚计划,并在非高峰期进行。 1. **混沌工程**:在测试集群定期模拟节点故障、网络分区、etcd压力等场景,验证系统的容错和恢复能力。 1. **知识沉淀**:将每次故障的排查过程、根因分析和解决方案记录成案,形成团队的“故障知识库”。 记住,Kubernetes集群的稳定性,不是一个开关,而是一个需要持续投入和精心维护的系统工程。从被动响应到主动防御,是你从“运维工程师”迈向“SRE”的关键一步。 “经一事,长一智”。希望这些用深夜和焦虑换来的经验,能帮你照亮下一次的排查之路。 **“无他,惟手熟尔”!**有需要的用起来! **如果你觉得这篇文章有用,欢迎点赞、转发、收藏、留言、推荐**❤!

优秀的个人博客,低调大师

TKE 体验升级:更快上手 K8s 的24个小技巧

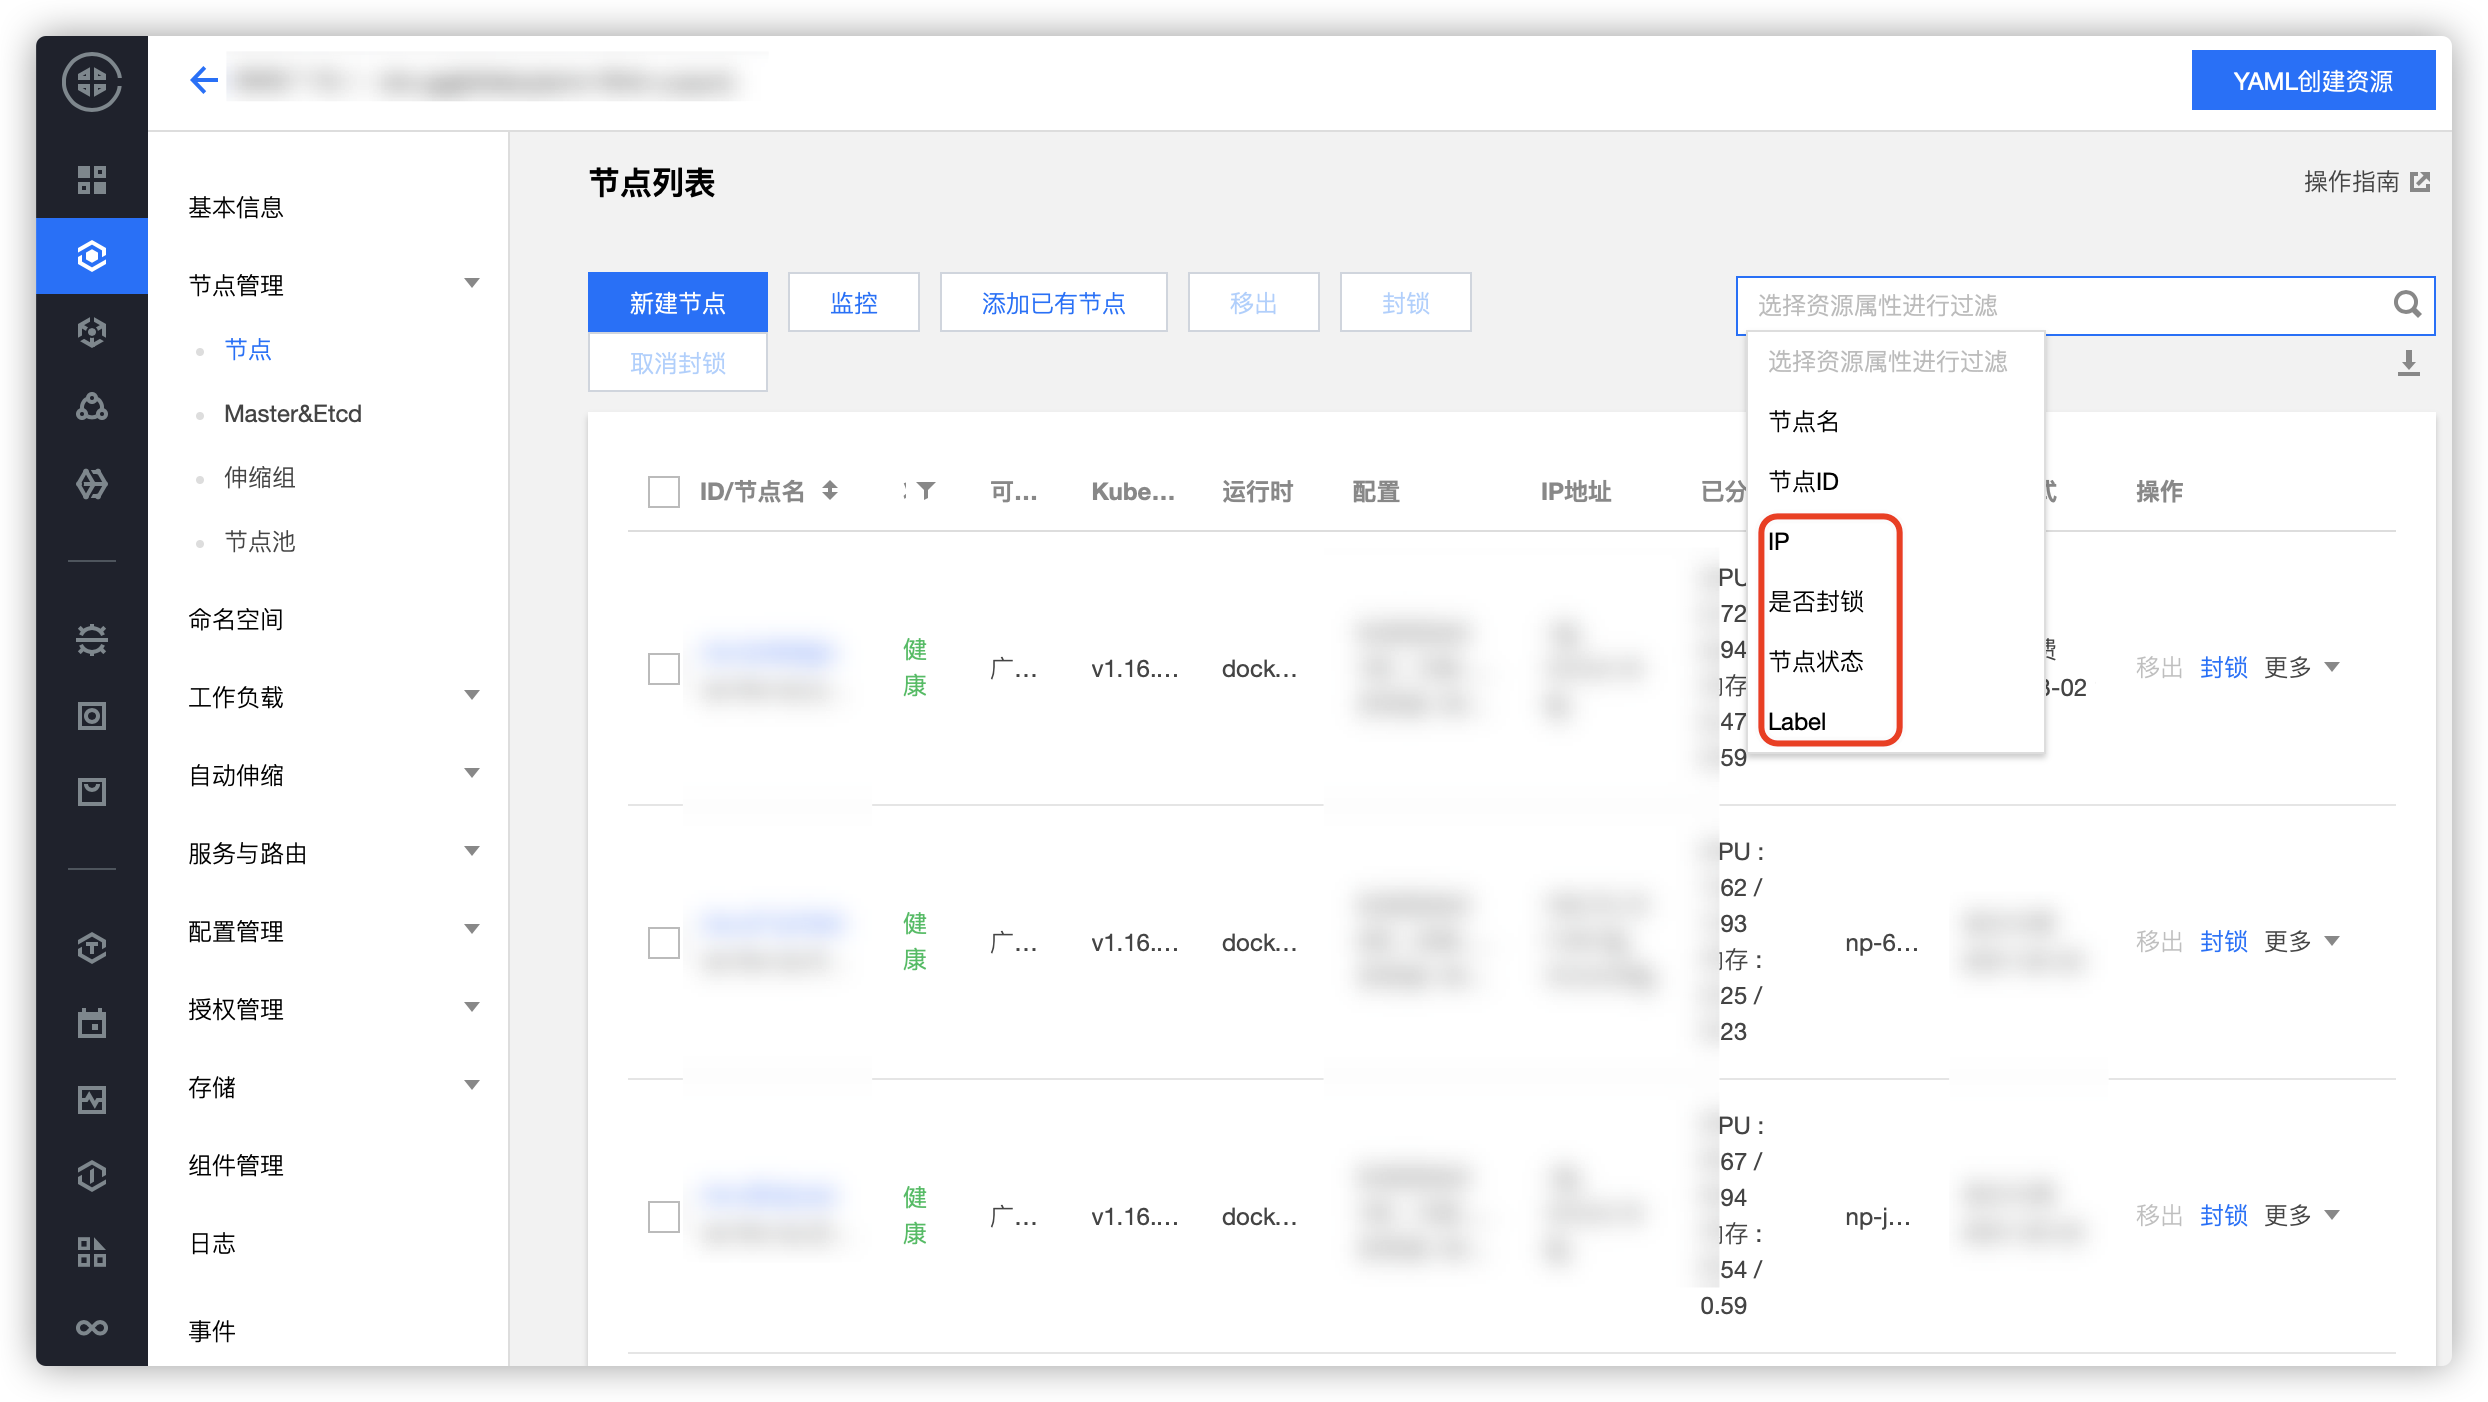
作者 王孝威,腾讯云容器产品经理,热衷于为客户提供高效的 Kubernetes 使用方式,为客户极致降本增效服务。 背景 “功能“解决是产品有或者没有一个能力的问题,有了“功能”之后,如何通过良好的引导、提示,以及交互来帮助用户更“流畅”的使用产品是一个值得思考的问题。 例如:乐高已经有了超过 3700 种不同的模块,这些模块可以拼出无限种模型。然而,不同模型的呈现完全不一样,有可能只是几个小模块的位置的改变就能带来意想不到的效果。 进过几年的努力,TKE 在功能层面提出了大量新特性:例如:通过 LB 直连 Pod 提升性能,集群原地升级,虚拟节点,动态调度器,更多可参考容器服务产品动态。 此外,TKE 也重视用户的整体使用体验,为此拜访了多家公司,收集了很多需求,并根据用户重视分层,进行了优化和工具的开发,用户可以利用这些优化的小技巧,更顺滑的来体验容器服务,更“接地气”的降低产品使用门槛,提升产品使用体验。 提升列表 集群/节点相关 推荐:节点搜索能力增强 节点搜索支持通过 Label/IP/是否封锁/节点状态 等多维度的搜索。 Label 搜索格式与原生 Kubernetes 相同:"k1=v1,k2=v2" IP 多值搜索时仅支持精确查询,单 IP 搜索支持模糊查询 使用方式:节点管理 -> 节点 -> 搜索 或者 节点池详情页 -> 下拉到节点列表 -> 搜索 ​ 推荐:节点初始化错误展示优化 【CVM 发货失败 相关错误细化展示】如果因为 CVM 发货失败导致节点购买失败,除了报 LAUNCH_FAILED(即发货失败), 还会显示详细发货失败的原因:比如 VPC 子网 IP 不足/磁盘资源不足/余额不足/置放群组配额不足等等。 【节点初始化 相关错误细化展示】会详细在节点列表展示节点初始化失败的步骤以及对应信息:比如挂盘失败、核心组件异常等等。 使用方式:节点管理 -> 节点 -> 在状态栏点击查看状态即可查看错误 ​ 节点池节点操作标准化:支持封锁/驱逐 节点池内节点操作支持封锁/驱逐,已与集群内节点列表操作保持完全同步,您可以在节点池内高效管理节点。 使用方式:节点池详情页 -> 下拉到节点列表 -> 在操作列对单节点进行操作 或者 选中批量节点后进行批量操作(点击上方【更多操作】按钮可批量封锁/取消封锁节点) ​ 删除保护逻辑优化 客户反映:如果创建集群时开启了误删选项,开启后假如创建失败,客户也无法删除。 现在您可以在【集群列表页】为集群关闭删除保护功能。 使用方式:集群管理 -> 集群操作列表 -> 更多 -> 关闭集群删除保护 ​ 公网 IP 展示优化 有些客户反馈公网IP的配置入口过于隐蔽,默认带宽值过小,无法满足业务需要。 我们采取图形化的形式(拖动条)来代替输入框,强化显示效果。 👉🏻 使用方式:新建节点/新建节点池 -> 选择机型 -> 拖拽到底部 -> 设置公网带宽 ​ 节点池展示信息结构化 / 高级参数展示 增加节点池核心定义/功能的概览,让客户快速了解节点池的使用场景 ​ 节点池信息结构化展示(按模块聚合展示,同时显示了更多的高级参数,提高了可观测性) 节点池基本信息(弹性伸缩相关配置、节点数量等信息) 节点配置详情(节点模板相关配置、节点池扩容节点自动继承的配置) ​ 节点直接跳转 CVM 优化 旧版本的跳转 CVM 按钮显示不稳定,并且入口不突出。 使用方式:鼠标悬浮到节点 ID 处(如果您直接点击节点 ID, 会跳转到 Node 详情页) -> 点击 “跳转到 CVM 实例详情页” -> 会跳转到 CVM 实例详情页。 ​ 创建节点时增加了容器网络 IP 校验 创建节点前,会根据您的容器网络配置(网络模式、网段等)来判断容器网络是否可以满足这批节点创建的要求。考虑到某些特殊场景下您可能不需要校验容器网络,我们提供了参数skip可以供您跳过校验。(参数的详细说明可参考API文档) 使用方式:新建节点/添加已有节点/新建节点池 -> 更多设置 -> 设置skip参数 ​ 集群添加已有节点时支持填写挂载分区/LVM 名 在添加已有节点时如果您对磁盘做了分区/LVM,请在挂载分区填写想要挂载的分区名/LVM名,如果磁盘未分区或 LVM,无需填写挂载分区,只需填写挂载点。 使用方式:添加已有节点 -> 选择节点 -> 勾选数据盘挂载 -> 填写挂载分区以及挂载点 ​ Kubernetes 对象相关 推荐:批量导入键值对:配置管理 & 环境变量优化 支持一次性从剪切板导入批量的键值对。变量名为空时,在变量名称中粘贴一行或多行 key=value 或 key: value 的键值对可以实现快速批量输入。 使用方式1:工作负载 -> 新建负载 -> 实例内容器 -> 环境变量 ​ 使用方式2:配置管理 -> 新建ConfigMap/Secret -> 内容 ​ ​ 推荐:CronJob 支持保留数量/暂停/手动触发/显示由 Cronjob 生成的 Job 列表 保留成功Job数:防止Job无限生成,影响集群性能 保留失败Job数:防止Job无限生成,影响集群性能 暂停:会停止 Cronjob 的运行,不再会生成新的 Job。支持恢复运行 手动触发:无需等到 Cronjob 设置的 Crontab 时间就支持利用 Cronjob 里的 Job 模板生成一个新的 Job 使用方式:工作负载 -> Cronjob -> 新建 -> 保留成功Job数/保留失败Job数 ​ 使用方式:工作负载 -> Cronjob 列表 -> 更多-> 手动触发/暂停 ​ 点击上图中的 CronJob 的名称,就可以查看到由 CronJob 生成的运行中的 Job 列表: ​ HostAliases 产品化 HostAliases 用于为 Pod 的 /etc/hosts 文件中添加条目,可以在 Pod 级别覆盖对主机名的解析。以增加 Pod 的 DNS 配置。 使用方式:工作负载 -> 新建负载 -> 高级设置 -> 主机别名 ​ lifecycle 产品化 lifecycle : 容器的生命周期事件挂接处理函数。 容器可以为每个事件指定一个处理程序,当一个容器启动后,Kubernetes 将立即发送 postStart 事件;在容器被终结之前, Kubernetes 将发送一个 preStop 事件。 使用方式:工作负载 -> 新建负载 -> 实例内容器 -> 生命周期 ​ Service 默认 “仅在集群内访问”;Service 类型解释增加对应英文名词 “仅在集群内访问”访问方式符合使用习惯 中英文名词对照减少用户的理解成本,符合 Kubernetes 原生使用习惯 ​ 一键“重新部署” 在 Deployment、StatefulSet 和 DaemonSet 上支持 和 Deployment 一样,StatefulSet 和 DaemonSet 现在支持一键重新部署了,免去删除后重新配置的烦恼。 使用方式:工作负载 -> 负载列表 -> 更多 -> 重新部署 ​ Ingress 证书支持继承 LB 的证书 支持直接使用 CLB 的证书自动创建 Ingress 的 HTTPS 证书,省去繁琐的 Secret 创建流程。 使用方式:服务与路由 -> Ingress -> 新建Ingress -> 监听端口勾选Https:443 -> 新建密钥 -> 选择服务器证书 ​ Secret 支持 TLS 类型 除了 CLB 证书,您有时会使用自己的证书,保存证书需要使用 TLS 类型的 Secret 使用方式1:配置管理 -> Secret -> 新建Secret -> TLS证书 ​ 使用方式2:服务与路由 -> Ingress -> 新建Ingress -> Nginx负载均衡器 -> 监听端口勾选Https:443 -> 新建密钥 ​ subPathExpr 在控制台上支持配置 subPathExpr,支持将环境变量映射到 Volume 里的一个子路径 使用方式:新建负载 -> 使用数据卷 -> 增加环境变量 -> 使用挂载点 -> 选择 subPathExpr ​ kube-system、kube-node-lease、kube-public 里的资源支持在控制台支持修改 以前为了防止用户误触,在控制台限制了这些命名空间里资源的修改,但事实上有些用户本身就具有这些命名空间的资源管理权限,因此新版本在控制台去掉了这些限制,权限逻辑交给后台判断,若您没有相关命名空间的权限,修改资源也会报错。 使用方式:新建负载 -> 选择命名空间 -> 修改资源配置 ​ 使用方式:授权管理 -> 选择任意一个入口 -> RBAC策略生成器 -> 选择子账号 -> 选择命名空间/权限 ​ 增加多处悬浮提示 所有的资源列表页的字段名增加悬浮提示,更适应屏幕较小的用户 ​ 工作负载里的日志入口容器名增加悬浮提示,更适应屏幕较小的用户 ​ 运维能力相关 推荐:日志采集支持根据日志样例自动提取正则表达式 当在日志采集规则中选择单行完全正则、多行完全正则的提取模式时,可根据用户自己的日志样例自动生成正则表达式,并自动提取相应的键值对,无需用户自己去学习并配置正则表达式 使用方式:1.集群运维 -> 2.日志规则 -> 3.新建 -> 4.输入日志采集规则名字 -> 5.提取方式选取“单行-完全正则” -> 6.输入日志样例 -> 7.点击正则表达式自动生成 -> 8.移动光标选取需要被正则的字符串 -> 9.输入key -> 10.确认 ​ ​ ​ ​ 推荐:日志采集支持根据日志样例自动验证是否可正常提取日志 对于用户自己填写的正则表达式、分隔符等,支持按照用户日志样例进行验证,自动提取所有value,以验证是否可以正常解析日志,避免在检索日志时发现表达式配置错误。 使用方式:1.集群运维 -> 2.日志规则 -> 3.新建 -> 4.输入日志采集规则名字 -> 5.提取方式选取“单行-完全正则” -> 6.输入日志样例 -> 7.手动输入正则表达式 -> 8. 验证 ​ ​ 日志采集支持多行正则提取模式 支持多行正则的解析模式(适用于java程序等多行日志以键值对去检索日志的需求) 注意:使用多行正则提取模式需要联系后端升级采集组件版本 使用方式:新建日志采集规则->第二步提取模式中选择“多行-完全正则模式” ​ 托管 Prometheus 支持新加坡、弗吉尼亚等地域 云原生监控(托管 Prometheus)灰度上线新加坡/弗吉尼亚等地域,欢迎使用。 ​ 总结 Kubernetes 本身功能强大,但模块复杂,上手成本较高,TKE 致力于功能和体验的升级,如果您有任何 【腾讯云原生】云说新品、云研新术、云游新活、云赏资讯,扫码关注同名公众号,及时获取更多干货!!

优秀的个人博客,低调大师

红帽发布 OpenShift 开发者沙盒,加速 K8s 应用开发

红帽近日发布了针对红帽 OpenShift 的开发者沙盒,这是一个基于 OpenShift 的开发环境,旨在让企业加快基于 Kubernetes 的应用从代码到生产的过程。OpenShift 沙盒为开发者提供了一种更简单、无成本的方式,让开发者可以使用将在生产环境中运行的相同基础结构和工具来开始构建应用程序,而不必担心配置问题。 通过 OpenShift 沙盒和我们最新更新的开发者工具,使开发者更容易为 Kubernetes 进行构建。 红帽开发者工具和项目部副总裁 Mithun Dharv 表示,如今开发人员面临着更快地交付应用程序的压力,同时要跟上快速变化的技术环境。数字化转型工作的加速推动了这一点,以将新的创新推向市场,而围绕 IT 现代化和应用开发的必要性也在不断增强。Kubernetes 是混合云架构的一个基础平台。通过消除开发人员为 Kubernetes 构建应用程序的障碍,红帽正在使开发人员能够加速开发过程。 OpenShift 开发者沙盒在一个共享的多租户集群中提供了一个私有的 OpenShift 环境,并预先配置了一套开发者工具。该基础设施和工具是紧密集成的,旨在为原型设计或构建新的应用程序、添加新的服务、从源代码或 Docker 文件创建容器等提供一个安全的环境。 结合红帽的开发者工具,这些新功能帮助开发者更好地应对提高应用速度的需求,并进一步巩固红帽 OpenShift 作为构建、部署和管理企业 Kubernetes 应用的领先平台。

优秀的个人博客,低调大师

K8S 太强了,我搞了这么多破坏居然还没宕机

作者 | Andrei Kvapil 编译|云原生计算编辑部 原文链接:https://itnext.io/breaking-down-and-fixing-kubernetes-4df2f22f87c3 Kubernetes 是当下最流行的容器编排平台,不管是生产环境的采用率,还是云原生生态都很强大。最近,Kubernetes 在功能,安全性和弹性方面取得了长足的进步,Kubernetes 架构使您可以轻松地应对各种故障并始终保持正常运行。 不相信它这么顽强?下面,我们将破坏集群,删除证书......一起来看看这些破坏性的动作会不会让运行的服务宕机。 在 Kubernetes 控制平面(主)节点上仅包含以下几个组件: etcd —用作数据库 kube-apiserver — 提供集群所的API服务,负责在Kubernetes节点和Kubernetes主组件之间建立通信。 kube-controller-manager —对Kubernetes资源执行操作 kube-scheduler —主调度程序 kubelet —负责容器的创建与起停 以上每个组件都受到一组针对客户端和服务器的TLS证书的保护。 它们用于对彼此之间的组件进行身份验证和授权。 它们一般不会存储在 Kubernetes 数据库中,而是以普通文件的形式存在: # tree /etc/kubernetes/pki/ /etc/kubernetes/pki/ ├── apiserver.crt ├── apiserver-etcd-client.crt ├── apiserver-etcd-client.key ├── apiserver.key ├── apiserver-kubelet-client.crt ├── apiserver-kubelet-client.key ├── ca.crt ├── ca.key ├── CTNCA.pem ├── etcd │ ├── ca.crt │ ├── ca.key │ ├── healthcheck-client.crt │ ├── healthcheck-client.key │ ├── peer.crt │ ├── peer.key │ ├── server.crt │ └── server.key ├── front-proxy-ca.crt ├── front-proxy-ca.key ├── front-proxy-client.crt ├── front-proxy-client.key ├── sa.key └── sa.pub 这些组件作为静态 pod 在 master 节点上运行,资源清单在/ etc / kubernetes / manifests目录下。 关于这一点,我们将不做详细介绍, 在本案例中,我们主要对如何从所有这些组件中获得一个有效运行的集群感兴趣。 首先,假设我们拥有上述 Kubernetes 组件,它们以某种方式相互通信。 通常如下所示: (箭头表示客户端到服务器的连接) 为了进行通信,他们需要TLS证书,部署工具可以是 kubeadm,kubespray 或其他任何工具。 在本文中,我们将使用kubeadm,因为它是最常见的 Kubernetes 部署工具,并且经常在其他解决方案中使用。 假设我们已经有一个部署好的集群。 让我们开始破坏行动吧: rm -rf /etc/kubernetes/ 在 master节点上,此目录包含: -etcd的一组证书和CA(在/ etc / kubernetes / pki / etcd中) -Kubernetes 的一组证书和CA(在/ etc / kubernetes / pki中) -用于cluster-admin,kube-controller-manager,kube-scheduler和kubelet使用的Kubeconfig文件(每个文件在/etc/kubernetes/*.conf中都有针对我们集群的base64编码的CA证书) -etcd,kube-apiserver,kube-scheduler和kube-controller-manager使用的static manifest文件(在/ etc / kubernetes / manifests中) 假设我们一下子把什么都删了...... 修复控制平面 为避免混淆,我们还要确保所有control-plane pods也已停止: crictl rm $(crictl ps -aq) 注意:默认情况下,kubeadm 不会覆盖现有证书和 kubeconfig,要重新发布它们,必须首先手动删除旧证书和 kubeconfig。 接下来,让我们从恢复 etcd开始。 如果您有一个 quorum(3个或更多主节点),则直到大多数节点都联机后,才能访问 etcd群集。 kubeadm init phase certs etcd-ca 上面的命令将为我们的 etcd 集群生成一个新的CA。 由于所有其他证书都必须由它签名,因此,我们还将其和私钥复制到其他 master节点: /etc/kubernetes/pki/etcd/ca.{key,crt} 现在,让我们在所有控制平面节点上为其重新生成其余的 etcd 证书和static-manifest: kubeadm init phase certs etcd-healthcheck-client kubeadm init phase certs etcd-peer kubeadm init phase certs etcd-server kubeadm init phase etcd local 此时,您应该已经了有一个可以正常工作的 etcd 集群: # crictl ps CONTAINER ID IMAGE CREATED STATE NAME ATTEMPT POD ID ac82b4ed5d83a 0369cf4303ffd 2 seconds ago Running etcd 0 bc8b4d568751b 然后,我们执行相同的任务,但是对于 Kubernetes 服务,在 master节点之一上执行: kubeadm init phase certs all kubeadm init phase kubeconfig all kubeadm init phase control-plane all cp -f /etc/kubernetes/admin.conf ~/.kube/config 如果您使用 kubeadm 来连接 kubeletes,则还需要更新kube-public namespace中的 cluster-info 配置,因为它仍然包含旧CA的哈希。 kubeadm init phase bootstrap-token 由于其他实例上的所有证书也必须由单个CA签名,因此我们将其复制到其他控制平面节点,然后在每个证书上重复上述命令。 /etc/kubernetes/pki/{ca,front-proxy-ca}.{key,crt} /etc/kubernetes/pki/sa.{key,pub} 顺便说一下,作为手动复制证书的替代方法,您还可以使用 Kubernetes API,例如以下命令: kubeadm init phase upload-certs --upload-certs 加密并上传证书到Kubernetes 需要2小时,因此您可以按以下方式注册 master 节点: kubeadm join phase control-plane-prepare all kubernetes-apiserver:6443 --control-plane --token cs0etm.ua7fbmwuf1jz946l --discovery-token-ca-cert-hash sha256:555f6ececd4721fed0269d27a5c7f1c6d7ef4614157a18e56ed9a1fd031a3ab8 --certificate-key 385655ee0ab98d2441ba8038b4e8d03184df1806733eac131511891d1096be73 kubeadm join phase control-plane-join all 请注意,Kubernetes API具有另一个配置,用于保存 front-proxy客户端的CA证书。 它用于验证从 apiserver 到 webhooks 和聚合层服务的请求。 幸运的是,kube-apiserver 会自动更新它。 但是,您可能需要手动从旧证书中清除它: kubectl get cm -n kube-system extension-apiserver-authentication -o yaml 无论如何,在这个阶段,我们已经有一个可以正常工作的控制平面。 修复工作节点 该命令将列出集群的所有节点,尽管当前所有节点的状态均为“NotReady”: kubectl get node 这是因为它们仍然使用旧证书,并期望来自由旧CA签名的 apiserver 的请求。 为了解决这个问题,我们将使用 kubeadm,并对群集执行重新加入节点。 当主节点可以访问主CA时,它们可以在本地加入: systemctl stop kubelet rm -rf /var/lib/kubelet/pki/ /etc/kubernetes/kubelet.conf kubeadm init phase kubeconfig kubelet kubeadm init phase kubelet-start 但是要加入工作节点,我们必须生成一个新token: kubeadm token create --print-join-command 并分别对它们运行以下命令: systemctl stop kubelet rm -rf /var/lib/kubelet/pki/ /etc/kubernetes/pki/ /etc/kubernetes/kubelet.conf kubeadm join phase kubelet-start kubernetes-apiserver:6443 --token cs0etm.ua7fbmwuf1jz946l --discovery-token-ca-cert-hash sha256:555f6ececd4721fed0269d27a5c7f1c6d7ef4614157a18e56ed9a1fd031a3ab8 注意:您不需要删除主节点上的/ etc / kubernetes / pki /目录,因为它已经包含所有需要的证书。 上面的操作会将您的所有 kubelet 重新加入集群。 它不会影响已经在其上运行的任何容器。 但是,如果集群中有多个节点并且不同时进行,则可能会遇到一种情况,即controller-manager开始从NotReady节点重新创建容器,并尝试在alive的节点上重新调度它们。 为了防止这种情况,我们可以暂时停止 master上的controller-manager pod: rm /etc/kubernetes/manifests/kube-controller-manager.yaml crictl rmp $(crictl ps --name kube-controller-manager -q) 仅需要最后一条命令即可确保controller-manager已真正停止。 一旦集群中的所有节点被加入,就可以为controller-manager生成一个static-manifest。 为此,请在所有 master节点上运行以下命令: kubeadm init phase control-plane controller-manager 请注意,您需要在已经生成join token的阶段执行这些步骤。 否则,join过程将继续尝试从cluster-info configmap读取token。 如果将kubelet配置为请求由您的CA签名的证书(选项serverTLSBootstrap:true),则还需要批准来自kubelet的CSR请求。 kubectl get csr kubectl certificate approve <csr> 修复ServiceAccounts 还有一件事,因为我们丢失了/etc/kubernetes/pki/sa.key。 该密钥用于为群集中所有 ServiceAccounts 的jwt令牌签名。 因此,我们必须为其重新创建token。 通过从kubernetes.io/service-account-token类型的Secret中删除token字段,可以非常简单地完成此操作: kubectl get secret --all-namespaces | awk '/kubernetes.io\/service-account-token/ { print "kubectl patch secret -n " $1 " " $2 " -p {\\\"data\\\":{\\\"token\\\":null}}"}' | sh -x 之后,kube-controller-manager将自动生成使用新密钥签名的新token。 不幸的是,并非所有的微服务都能即时更新token,因此很可能需要手动重新启动所有使用token的容器。 kubectl get pod --field-selector 'spec.serviceAccountName!=default' --no-headers --all-namespaces | awk '{print "kubectl delete pod -n " $1 " " $2 " --wait=false --grace-period=0"}' 例如,此命令将生成命令列表,以使用非默认 serviceAccount删除所有pod。 我建议从kube-system的namespace开始,因为在那里安装了kube-proxy和CNI插件。 它们对于处理微服务之间的通信至关重要。 此时,集群恢复就算完成了。 Kubernetes 在生产环境如何落地? 目前,Kubernetes 技术已然成为了容器编排领域的事实标准。百度从 2010 年开始探索容器和集群管理技术,2016年自主研发的 Matrix 集群管理系统已经管理了数十万台机器和服务。随着 Kubernetes 技术的成熟,百度看到了开源技术强大的生命力,从 2018 年开始尝试向 Kubernetes 架构演化。试点成功之后,启动了大规模 Kubernetes 架构融合项目。一方面保留百度在 Matrix 上积累的核心技术能力,另一方面让存量业务可以更低成本的迁移到 Kubernetes 之上。 百度于 2020 年获得 InfoQ 十大云原生创新技术方案,对百度云原生来说仅仅是个开始。目前大规模 Kubernetes 融合架构的业务正在百度云原生各产品技术架构中稳定运行并持续增长,百度云原生团队也将会在继续服务好客户的同时,利用Kubernetes技术实践经验不断优化产品,更好地助力各行各业的客户实现基于云原生架构的数字化转型。 百度智能云云原生平台,为客户建设容器化和无服务器化的基础设施,提供企业级的微服务治理能力,同时集成源自百度自身多年实践的DevOps工具链。保障开发者享受到高效、灵活、弹性的开发与运维体验,助力企业更高效率低风险地构建云原生应用,广泛应用于金融、互联网、制造等各行各业的云原生转型阶段。 了解更多百度云原生产品请访问: https://cloud.baidu.com/product/cnap.html 重磅!云原生计算交流群成立 扫码添加小助手即可申请加入,一定要备注:名字-公司/学校-地区,根据格式备注,才能通过且邀请进群。。 了解更多微服务、云原生技术的相关信息,请关注我们的微信公众号【云原生计算】!

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册
修改密码
忘记密码