首页 文章 精选 留言 我的

精选列表

搜索[编译原理],共10000篇文章
优秀的个人博客,低调大师

MAPREDUCE原理篇(2)

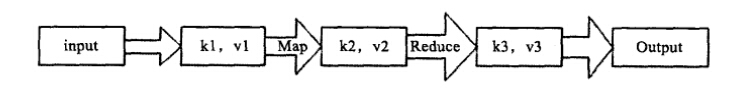
3.1mapreduce的shuffle机制 3.1.1概述: vmapreduce中,map阶段处理的数据如何传递给reduce阶段,是mapreduce框架中最关键的一个流程,这个流程就叫shuffle; vshuffle:洗牌、发牌——(核心机制:数据分区,排序,缓存); v具体来说:就是将maptask输出的处理结果数据,分发给reducetask,并在分发的过程中,对数据按key进行了分区和排序; 3.1.2主要流程: Shuffle缓存流程: shuffle是MR处理流程中的一个过程,它的每一个处理步骤是分散在各个map task和reduce task节点上完成的,整体来看,分为3个操作: 1、分区partition 2、Sort根据key排序 3、Combiner进行局部value的合并 3.1.3详细流程 1、maptask收集我们的map()方法输出的kv对,放到内存缓冲区中 2、从内存缓冲区不断溢出本地磁盘文件,可能会溢出多个文件 3、多个溢出文件会被合并成大的溢出文件 4、在溢出过程中,及合并的过程中,都要调用partitoner进行分组和针对key进行排序 5、reducetask根据自己的分区号,去各个maptask机器上取相应的结果分区数据 6、reducetask会取到同一个分区的来自不同maptask的结果文件,reducetask会将这些文件再进行合并(归并排序) 7、合并成大文件后,shuffle的过程也就结束了,后面进入reducetask的逻辑运算过程(从文件中取出一个一个的键值对group,调用用户自定义的reduce()方法) Shuffle中的缓冲区大小会影响到mapreduce程序的执行效率,原则上说,缓冲区越大,磁盘io的次数越少,执行速度就越快 缓冲区的大小可以通过参数调整, 参数:io.sort.mb 默认100M 3.1.4详细流程示意图 3.2. MAPREDUCE中的序列化 3.2.1概述 Java的序列化是一个重量级序列化框架(Serializable),一个对象被序列化后,会附带很多额外的信息(各种校验信息,header,继承体系。。。。),不便于在网络中高效传输; 所以,hadoop自己开发了一套序列化机制(Writable),精简,高效 3.2.2Jdk序列化和MR序列化之间的比较 简单代码验证两种序列化机制的差别: public class TestSeri { public static void main(String[] args) throws Exception { //定义两个ByteArrayOutputStream,用来接收不同序列化机制的序列化结果 ByteArrayOutputStream ba = new ByteArrayOutputStream(); ByteArrayOutputStream ba2 = new ByteArrayOutputStream(); //定义两个DataOutputStream,用于将普通对象进行jdk标准序列化 DataOutputStream dout = new DataOutputStream(ba); DataOutputStream dout2 = new DataOutputStream(ba2); ObjectOutputStream obout = new ObjectOutputStream(dout2); //定义两个bean,作为序列化的源对象 ItemBeanSer itemBeanSer = new ItemBeanSer(1000L, 89.9f); ItemBean itemBean = new ItemBean(1000L, 89.9f); //用于比较String类型和Text类型的序列化差别 Text atext = new Text("a"); // atext.write(dout); itemBean.write(dout); byte[] byteArray = ba.toByteArray(); //比较序列化结果 System.out.println(byteArray.length); for (byte b : byteArray) { System.out.print(b); System.out.print(":"); } System.out.println("-----------------------"); String astr = "a"; // dout2.writeUTF(astr); obout.writeObject(itemBeanSer); byte[] byteArray2 = ba2.toByteArray(); System.out.println(byteArray2.length); for (byte b : byteArray2) { System.out.print(b); System.out.print(":"); } } } 3.2.3自定义对象实现MR中的序列化接口 如果需要将自定义的bean放在key中传输,则还需要实现comparable接口,因为mapreduce框中的shuffle过程一定会对key进行排序,此时,自定义的bean实现的接口应该是: publicclassFlowBeanimplementsWritableComparable<FlowBean> 需要自己实现的方法是: /** *反序列化的方法,反序列化时,从流中读取到的各个字段的顺序应该与序列化时写出去的顺序保持一致 */ @Override public void readFields(DataInput in) throws IOException { upflow = in.readLong(); dflow = in.readLong(); sumflow = in.readLong(); } /** *序列化的方法 */ @Override public void write(DataOutput out) throws IOException { out.writeLong(upflow); out.writeLong(dflow); //可以考虑不序列化总流量,因为总流量是可以通过上行流量和下行流量计算出来的 out.writeLong(sumflow); } @Override public int compareTo(FlowBean o) { //实现按照sumflow的大小倒序排序 return sumflow>o.getSumflow()?-1:1; } 3.3. MapReduce与YARN 3.3.1 YARN概述 Yarn是一个资源调度平台,负责为运算程序提供服务器运算资源,相当于一个分布式的操作系统平台,而mapreduce等运算程序则相当于运行于操作系统之上的应用程序 3.3.2 YARN的重要概念 1、yarn并不清楚用户提交的程序的运行机制 2、yarn只提供运算资源的调度(用户程序向yarn申请资源,yarn就负责分配资源) 3、yarn中的主管角色叫ResourceManager 4、yarn中具体提供运算资源的角色叫NodeManager 5、这样一来,yarn其实就与运行的用户程序完全解耦,就意味着yarn上可以运行各种类型的分布式运算程序(mapreduce只是其中的一种),比如mapreduce、storm程序,spark程序,tez…… 6、所以,spark、storm等运算框架都可以整合在yarn上运行,只要他们各自的框架中有符合yarn规范的资源请求机制即可 7、Yarn就成为一个通用的资源调度平台,从此,企业中以前存在的各种运算集群都可以整合在一个物理集群上,提高资源利用率,方便数据共享 3.3.3Yarn中运行运算程序的示例 mapreduce程序的调度过程,如下图 本文转自yushiwh 51CTO博客,原文链接:http://blog.51cto.com/yushiwh/1913044,如需转载请自行联系原作者

优秀的个人博客,低调大师

OpenStack —— 原理架构介绍(一)

一、OpenStack 简介 Openstack是一个控制着大量计算能力、存储、乃至于整个数据中心网络资源的云操作系统,通过Dashboard这个Web界面,让管理员可以控制、赋予他们的用户去提供资源的权限(即:能够通过Dashboard控制整个Openstack云计算平台的运作)。 作为IaaS层的云操作系统,OpenStack为虚拟机提供并管理三大类资源:计算、网络和存储。 Openstack的发展非常快,而且由于其开源的本质,所以导致了即便是前后相隔的两个不同版本,也可能会出现比较大的区别。所以在我们初习Openstack的时候,应该考虑从一个体系相对成熟,资料相对丰富的版本入手。当然如果你拥有良好的英文阅读习惯的话,Openstack的官网就提供了非常完善的最新版本的文档资料。 二、OpenStack 组件 OpenStack包含了许多组件。有些组件会首先出现在孵化项目中,待成熟以后进入下一个OpenStack发行版的核心服务中。同时也有部分项目是为了更好地支持OpenStack社区和项目开发管理,不包含在发行版代码中,主要组件如下: Compute (Nova) 计算服务 Identity Service (Keystone) 认证服务 Image Service (Glance) 镜像服务 Networking (Neutron) 网络服务 Dashboard (Horizon) 仪表板 Object Storage (Swift) 对象存储 Block Storage (Cinder) 块存储 Orchestration (Heat) 编排 Telemetry (Ceilometer) 监控 Database Service (Trove) 数据库服务 Data Processing (Sahara) 数据处理 三、OpenStack 架构 OpenStack是由一系列具有RESTful接口的Web服务所实现的,是一系列组件服务集合。如下图为OpenStack的概念架构,我们看到的是一个标准的OpenStack项目组合的架构。这是比较典型的架构,但不代表这是OpenStack的唯一架构,我们可以选取自己需要的组件项目,来搭建适合自己的云计算平台。 OpenStack项目并不是单一的服务,其含有子组件,子组件内由模块来实现各自的功能,如下图为OpenStack的逻辑架构。通过消息队列和数据库,各个组件可以相互调用,互相通信。这样的消息传递方式解耦了组件、项目间的依赖关系,所以才能灵活地满足我们实际环境的需要,组合出适合我们的架构。每个项目都有各自的特性,大而全的架构并非适合每一个用户,譬如Glance在最早的A、B版本中并没有实际出现应用,Nova可以脱离镜像服务独立运行。当用户的云计算规模大到需要管理多种镜像时,才需要像Glance这样的组件。OpenStack的成长是在生产环境中不断被检验,然后再将需求反馈给社区,由社区来实现的一个过程,可以说OpenStack并非脱离实际的理想化开源社区项目,而是与生产实际紧密结合的,可以复制应用的云计算方案。 OpenStack 本身是一个分布式系统,不但各个服务可以分布部署,服务中的组件也可以分布部署。 这种分布式特性让 OpenStack 具备极大的灵活性、伸缩性和高可用性。 附录:其他图 概念架构图: 逻辑架构图: 参考:http://ken.pepple.info/openstack/2012/09/25/openstack-folsom-architecture/ https://ilearnstack.com/2013/04/23/introduction-to-openstack-2/ 本文转自 wzlinux 51CTO博客,原文链接:http://blog.51cto.com/wzlinux/1961337,如需转载请自行联系原作者

优秀的个人博客,低调大师

hadoop原理浅析及安装

第一:理论知识: 什么是hadoop: 由三部分组成:HDFS,MapReduce和Hbase。 维基百科这样说:一个分布式系统基础架构,由Apache基金会开发。用户可以在不了解分布式底层细节的情况下,开发分布式程序。充分利用集群的威力高速运算和存储。这里面关键就是高速运算和海量存储。我们首先讲海量存储,这个比较有意思,一会儿再说高速运算。 海量存储:HDFS<Hadoop Distributed File System> 前身来自google的一篇博文,所以自身带有浓厚的互联网色彩,比如读多于写的特性,高度的扩展性。具体说一下他的特性: 图1:HDFS结构示意图 <抄自 岑文初> 上图中展现了整个HDFS三个重要角色:NameNode、DataNode和Client。NameNode可以看作是分布式文件系统中的管理者,主要负责管理文件系统的命名空间、集群配置信息和存储块的复制等。NameNode会将文件系统的Meta-data存储在内存中,这些信息主要包括了文件信息、每一个文件对应的文件块的信息和每一个文件块在DataNode的信息等。DataNode是文件存储的基本单元,它将Block存储在本地文件系统中,保存了Block的Meta-data,同时周期性地将所有存在的Block信息发送给NameNode。Client就是需要获取分布式文件系统文件的应用程序。这里通过三个操作来说明他们之间的交互关系。 文件写入: Client向NameNode发起文件写入的请求。 NameNode根据文件大小和文件块配置情况,返回给Client它所管理部分DataNode的信息。 Client将文件划分为多个Block,根据DataNode的地址信息,按顺序写入到每一个DataNode块中。 文件读取: Client向NameNode发起文件读取的请求。 NameNode返回文件存储的DataNode的信息。 Client读取文件信息。 文件Block复制: NameNode发现部分文件的Block不符合最小复制数或者部分DataNode失效。 通知DataNode相互复制Block。 DataNode开始直接相互复制。 HDFS的几个设计特点: Block的放置:默认不配置。一个Block会有三份备份,一份放在NameNode指定的DataNode,另一份放在与指定 DataNode非同一Rack上的DataNode,最后一份放在与指定DataNode同一Rack上的DataNode上。备份无非就是为了数据安全,考虑同一Rack的失败情况以及不同Rack之间数据拷贝性能问题就采用这种配置方式。 心跳检测DataNode的健康状况,如果发现问题就采取数据备份的方式来保证数据的安全性。 数据复制(场景为DataNode失败、需要平衡DataNode的存储利用率和需要平衡DataNode数据交互压力等情况):这里先说一下,使用HDFS的balancer命令,可以配置一个Threshold来平衡每一个DataNode磁盘利用率。例如设置了Threshold为 10%,那么执行balancer命令的时候,首先统计所有DataNode的磁盘利用率的均值,然后判断如果某一个DataNode的磁盘利用率超过这个均值Threshold以上,那么将会把这个DataNode的block转移到磁盘利用率低的DataNode,这对于新节点的加入来说十分有用。 数据交验:采用CRC32作数据交验。在文件Block写入的时候除了写入数据还会写入交验信息,在读取的时候需要交验后再读入。 NameNode是单点:如果失败的话,任务处理信息将会纪录在本地文件系统和远端的文件系统中。 数据管道性的写入:当客户端要写入文件到DataNode上,首先客户端读取一个Block然后写到第一个DataNode上,然后由第一个DataNode传递到备份的DataNode上,一直到所有需要写入这个Block的NataNode都成功写入,客户端才会继续开始写下一个 Block。 安全模式:在分布式文件系统启动的时候,开始的时候会有安全模式,当分布式文件系统处于安全模式的情况下,文件系统中的内容不允许修改也不允许删除,直到安全模式结束。安全模式主要是为了系统启动的时候检查各个DataNode上数据块的有效性,同时根据策略必要的复制或者删除部分数据块。运行期通过命令也可以进入安全模式。在实践过程中,系统启动的时候去修改和删除文件也会有安全模式不允许修改的出错提示,只需要等待一会儿即可。 下面说高速计算: 上面的图片是计算这个文件中每个单词出现的次数,这个任务被分裂成三个子任务,然后映射到集群中JobTracker指定的TaskTracker上运行子任务,每个子任务都可以在指定的TaskTracker上运行,然后把运行的结果保存在当地,然后reduce程序被调用。然后进行的是结果的整合,整合完毕,就是最终结果了。这是计算向数据靠拢的计算方式。 好了,我们开始说安装,好多都在讲0.17和0.18的安装,hadoop这玩意儿因为最近很火,所以变动很厉害,变动的速度估计和nginx有一拼,所以在安装的时候得批判的继承他们安装过程。 环境: 首先:在这几台机器上安装CentOS5.4(最简化安装)并升级完毕。 保证计算机名的全局唯一性: hadoop1.diarc.com.cn-----192.168.0.3 hadoop2.diarc.com.cn-----192.168.0.4 hadoop3.diarc.com.cn-----192.168.0.5 hadoop4.diarc.com.cn-----192.168.0.18 hadoop5.diarc.com.cn-----192.168.0.20 修改方式:(5台服务器都设置) [root@hadoop5 ~]# hostname hadoop5.diarc.com.cn [root@hadoop5 ~]# cat /etc/hosts # Do not remove the following line, or various programs # that require network functionality will fail. 127.0.0.1 localhost.localdomain localhost ::1 localhost6.localdomain6 localhost6 192.168.0.20 hadoop5.diarc.com.cn hadoop5 [root@hadoop5 ~]# cat /etc/sysconfig/network NETWORKING=yes NETWORKING_IPV6=no HOSTNAME=hadoop5.diarc.com.cn GATEWAY=192.168.0.1 [root@hadoop5 ~]# 为了方便,关闭防火墙:(5台服务器都设置) [root@hadoop5 ~]# service iptables stop [root@hadoop5 ~]# chkconfig iptables off 方便起见,创建hadoop用户 [root@hadoop5 ~]# useradd hadoop 下载hadoop最新版:http://apache.freelamp.com/hadoop/core/hadoop-0.20.2/hadoop-0.20.2.tar.gz 下载JDK最新版:http://cds-esd.sun.com/ESD6/JSCDL/jdk/6u19-b04/jdk-6u19-linux-i586-rpm.bin?AuthParam=1270716768_db3a41353e2febaf6e98b124c7e4a54d&TicketId=B%2Fw6lhWJS1NMThBDO15fkQPk&GroupName=CDS&FilePath=/ESD6/JSCDL/jdk/6u19-b04/jdk-6u19-linux-i586-rpm.bin&File=jdk-6u19-linux-i586-rpm.bin 全部放入/home/hadoop目录。 [root@hadoop5 ~]# cp jdk-6u19-linux-i586.bin /usr/local/ [root@hadoop5 ~]# cd /usr/local/ [root@hadoop5 ~]# ./jdk-6u19-linux-i586.bin [root@hadoop5 ~]# rm -rf jdk-6u19-linux-i586.bin [root@hadoop5 ~]# cd /home/hadoop/ [root@hadoop5 hadoop]# tar zxvf hadoop-0.20.2.tar.gz [root@hadoop5 ~]# cat /etc/profile ##放入如下信息 export JAVA_HOME=/usr/local/jdk1.6.0_19 export CLASSPATH=$CLASSPATH:$JAVA_HOME/lib:$JAVA_HOME/jre/lib export PATH=$JAVA_HOME/lib:$JAVA_HOME/jre/bin:$PATH export HADOOP_HOME=/home/hadoop/hadoop-0.20.2 export PATH=$PATH:$HADOOP_HOME/bin 然后执行如下命令: [root@hadoop5 ~]# source /etc/profile 现在我们修改hadoop的配置文件:0.20以上的配置和以前的配置有些是不同的,我们以0.20.2为例做东西 [root@hadoop5 conf]# cat core-site.xml <?xml version="1.0"?> <?xml-stylesheet type="text/xsl" href="configuration.xsl"?> <!-- Put site-specific property overrides in this file. --> <configuration> <property> <name>fs.default.name</name> <value>hdfs://192.168.0.20:54310/</value> </property> <property> <name>hadoop.tmp.dir</name> <value>/home/hadoop/tmp/</value> </property> </configuration> =========================================================================== [root@hadoop5 conf]# echo "export JAVA_HOME=/usr/local/jdk1.6.0_19" >> hadoop-env.sh =========================================================================== [root@hadoop5 conf]# cat hdfs-site.xml <?xml version="1.0"?> <?xml-stylesheet type="text/xsl" href="configuration.xsl"?> <!-- Put site-specific property overrides in this file. --> <configuration> <property> <name>dfs.replication</name> <value>3</value> </property> </configuration> =========================================================================== [root@hadoop5 conf]# cat mapred-site.xml <?xml version="1.0"?> <?xml-stylesheet type="text/xsl" href="configuration.xsl"?> <!-- Put site-specific property overrides in this file. --> <configuration> <property> <name>mapred.job.tracker</name> <value>hdfs://192.168.0.20:54311/</value> </property> </configuration> [root@hadoop5 conf]# =========================================================================== [root@hadoop5 conf]# cat masters 192.168.0.20 [root@hadoop5 conf]# cat slaves 192.168.0.3 192.168.0.4 192.168.0.5 192.168.0.18 [root@hadoop5 conf]# ========================================================================== 现在我们做无密码的ssh登录: 建立Master到每一台Slave的SSH受信证书。由于Master将会通过SSH启动所有Slave的Hadoop,所以需要建立单向或者双向证书保证命令执行时不需要再输入密码。在Master和所有的Slave机器上执行:ssh-keygen -t rsa。执行此命令的时候,看到提示只需要回车。然后就会在/root/.ssh/下面产生id_rsa.pub的证书文件,通过scp将Master机器上的这个文件拷贝到Slave上(记得修改名称),例如:scp root@masterIP:/root/.ssh/id_rsa.pub /root/.ssh/46_rsa.pub,然后执行cat /root/.ssh/46_rsa.pub >>/root/.ssh/authorized_keys,建立authorized_keys文件即可,可以打开这个文件看看,也就是rsa的公钥作为key,user@IP作为value。此时可以试验一下,从master ssh到slave已经不需要密码了。由slave反向建立也是同样。为什么要反向呢?其实如果一直都是Master启动和关闭的话那么没有必要建立反向,只是如果想在Slave也可以关闭Hadoop就需要建立反向。 然后每台服务器上都修改ssh的配置文件: /etc/ssh/sshd_config 把GSSAPIAuthentication的值设置为no,然后: [root@hadoop5 conf]# service sshd restart [root@hadoop5 conf]# 我们从master向slave依次登录 [root@hadoop5 conf]#sshroot@192.168.0.3 [root@hadoop5 conf]#sshroot@192.168.0.4 [root@hadoop5 conf]#sshroot@192.168.0.5 [root@hadoop5 conf]#sshroot@192.168.0.18 然后压缩hadoop文件夹成为一个压缩包 [root@hadoop5 hadoop]# tar zcvf hadoop-0.20.2.tar.gz hadoop-0.20.2 然后在每台slave上执行如下命令 [root@hadoop1 hadoop]# cd /home/hadoop [root@hadoop1 hadoop]# scp -r root@192.168.0.20:/home/hadoop/hadoop-0.20.2.tar.gz /home/hadoop/ [root@hadoop1 hadoop]# tar zxvf hadoop-0.20.2.tar.gz 好,我们现在可以在master上执行如下命令: [root@hadoop5 hadoop]# hadoop namenode -format [root@hadoop5 hadoop]# cd /home/hadoop/hadoop-0.20.2/bin/ [root@hadoop5 bin]# ./start-all.sh 然后在地址栏输入: http://192.168.0.20:50070 可以查看master和slave的状态。 手写的有点木,不多写了 本文转自guoli0813 51CTO博客,原文链接:http://blog.51cto.com/guoli0813/293138,如需转载请自行联系原作者

优秀的个人博客,低调大师

MAPREDUCE原理篇(1)

Mapreduce是一个分布式运算程序的编程框架,是用户开发“基于hadoop的数据分析应用”的核心框架; Mapreduce核心功能是将用户编写的业务逻辑代码和自带默认组件整合成一个完整的分布式运算程序,并发运行在一个hadoop集群上; 1.1为什么要MAPREDUCE (1)海量数据在单机上处理因为硬件资源限制,无法胜任 (2)而一旦将单机版程序扩展到集群来分布式运行,将极大增加程序的复杂度和开发难度 (3)引入mapreduce框架后,开发人员可以将绝大部分工作集中在业务逻辑的开发上,而将分布式计算中的复杂性交由框架来处理 设想一个海量数据场景下的wordcount需求: 单机版:内存受限,磁盘受限,运算能力受限 分布式: 1、文件分布式存储(HDFS) 2、运算逻辑需要至少分成2个阶段(一个阶段独立并发,一个阶段汇聚) 3、运算程序如何分发 4、程序如何分配运算任务(切片) 5、两阶段的程序如何启动?如何协调? 6、整个程序运行过程中的监控?容错?重试? 可见在程序由单机版扩成分布式时,会引入大量的复杂工作。为了提高开发效率,可以将分布式程序中的公共功能封装成框架,让开发人员可以将精力集中于业务逻辑。 而mapreduce就是这样一个分布式程序的通用框架,其应对以上问题的整体结构如下: 1、MRAppMaster(mapreduce application master) 2、MapTask 3、ReduceTask 1.2 MAPREDUCE框架结构及核心运行机制 1.2.1结构 一个完整的mapreduce程序在分布式运行时有三类实例进程: 1、MRAppMaster:负责整个程序的过程调度及状态协调 2、mapTask:负责map阶段的整个数据处理流程 3、ReduceTask:负责reduce阶段的整个数据处理流程 1.2.2MR程序运行流程 1.2.2.1流程示意图 1.2.2.2流程解析 1、一个mr程序启动的时候,最先启动的是MRAppMaster,MRAppMaster启动后根据本次job的描述信息,计算出需要的maptask实例数量,然后向集群申请机器启动相应数量的maptask进程 2、maptask进程启动之后,根据给定的数据切片范围进行数据处理,主体流程为: a)利用客户指定的inputformat来获取RecordReader读取数据,形成输入KV对 b)将输入KV对传递给客户定义的map()方法,做逻辑运算,并将map()方法输出的KV对收集到缓存 c)将缓存中的KV对按照K分区排序后不断溢写到磁盘文件 3、MRAppMaster监控到所有maptask进程任务完成之后,会根据客户指定的参数启动相应数量的reducetask进程,并告知reducetask进程要处理的数据范围(数据分区) 4、Reducetask进程启动之后,根据MRAppMaster告知的待处理数据所在位置,从若干台maptask运行所在机器上获取到若干个maptask输出结果文件,并在本地进行重新归并排序,然后按照相同key的KV为一个组,调用客户定义的reduce()方法进行逻辑运算,并收集运算输出的结果KV,然后调用客户指定的outputformat将结果数据输出到外部存储 1.3MapTask并行度决定机制 maptask的并行度决定map阶段的任务处理并发度,进而影响到整个job的处理速度 那么,mapTask并行实例是否越多越好呢?其并行度又是如何决定呢? 1.3.1 mapTask并行度的决定机制 一个job的map阶段并行度由客户端在提交job时决定 而客户端对map阶段并行度的规划的基本逻辑为: 将待处理数据执行逻辑切片(即按照一个特定切片大小,将待处理数据划分成逻辑上的多个split),然后每一个split分配一个mapTask并行实例处理 这段逻辑及形成的切片规划描述文件,由FileInputFormat实现类的getSplits()方法完成,其过程如下图: 1.3.2FileInputFormat切片机制 1、切片定义在InputFormat类中的getSplit()方法 2、FileInputFormat中默认的切片机制: a)简单地按照文件的内容长度进行切片 b)切片大小,默认等于block大小 c)切片时不考虑数据集整体,而是逐个针对每一个文件单独切片 比如待处理数据有两个文件: file1.txt 320M file2.txt 10M 经过FileInputFormat的切片机制运算后,形成的切片信息如下: file1.txt.split1-- 0~128 file1.txt.split2-- 128~256 file1.txt.split3-- 256~320 file2.txt.split1-- 0~10M 3、FileInputFormat中切片的大小的参数配置 通过分析源码,在FileInputFormat中,计算切片大小的逻辑:Math.max(minSize, Math.min(maxSize, blockSize));切片主要由这几个值来运算决定 minsize:默认值:1 配置参数:mapreduce.input.fileinputformat.split.minsize maxsize:默认值:Long.MAXValue 配置参数:mapreduce.input.fileinputformat.split.maxsize blocksize 因此,默认情况下,切片大小=blocksize maxsize(切片最大值): 参数如果调得比blocksize小,则会让切片变小,而且就等于配置的这个参数的值 minsize(切片最小值): 参数调的比blockSize大,则可以让切片变得比blocksize还大 选择并发数的影响因素: 1、运算节点的硬件配置 2、运算任务的类型:CPU密集型还是IO密集型 3、运算任务的数据量 1.4 map并行度的经验之谈 如果硬件配置为2*12core + 64G,恰当的map并行度是大约每个节点20-100个map,最好每个map的执行时间至少一分钟。 l如果job的每个map或者reduce task的运行时间都只有30-40秒钟,那么就减少该job的map或者reduce数,每一个task(map|reduce)的setup和加入到调度器中进行调度,这个中间的过程可能都要花费几秒钟,所以如果每个task都非常快就跑完了,就会在task的开始和结束的时候浪费太多的时间。 配置task的JVM重用可以改善该问题: (mapred.job.reuse.jvm.num.tasks,默认是1,表示一个JVM上最多可以顺序执行的task 数目(属于同一个Job)是1。也就是说一个task启一个JVM) l如果input的文件非常的大,比如1TB,可以考虑将hdfs上的每个block size设大,比如设成256MB或者512MB 1.5ReduceTask并行度的决定 reducetask的并行度同样影响整个job的执行并发度和执行效率,但与maptask的并发数由切片数决定不同,Reducetask数量的决定是可以直接手动设置: //默认值是1,手动设置为4 job.setNumReduceTasks(4); 如果数据分布不均匀,就有可能在reduce阶段产生数据倾斜 注意: reducetask数量并不是任意设置,还要考虑业务逻辑需求,有些情况下,需要计算全局汇总结果,就只能有1个reducetask 尽量不要运行太多的reduce task。对大多数job来说,最好rduce的个数最多和集群中的reduce持平,或者比集群的 reduce slots小。这个对于小集群而言,尤其重要。 1.6MAPREDUCE程序运行演示 Hadoop的发布包中内置了一个hadoop-mapreduce-example-2.4.1.jar,这个jar包中有各种MR示例程序,可以通过以下步骤运行: 启动hdfs,yarn 然后在集群中的任意一台服务器上启动执行程序(比如运行wordcount): hadoop jar hadoop-mapreduce-example-2.4.1.jar wordcount /wordcount/data /wordcount/out 本文转自yushiwh 51CTO博客,原文链接:http://blog.51cto.com/yushiwh/1912972 ,如需转载请自行联系原作者

优秀的个人博客,低调大师

VMware VDS原理详解--20170922

本文纯属个人理解,如有错误请留言指正。 上图为vSpere中一个简单的结构拓扑图,借用这个拓扑图来解释一下为什么VDS能够逻辑上跨越ESXi。 首先说明一下整个架构 1. 在底层用三台ESXi表示一个底层的网络,另外用Storage代表存储,在最左边ESXi中的最左边一台VM表示为VC。 2. 每一台ESXi配置4块网卡,两两一组,左边一组表示业务网卡,连接APP Switch;右边一组网卡为Storage网卡,连接Storage交换机,两张网卡进行LACP捆绑 3. APP Switch和Storage Switch都是纯二层物理交换机,上联和下联接口都是Trunk模式 4. Core Switch上有所有VM的网关 好了,基本架构情况说完了,下面开始VDS的从建立到设置到维护管理的整个过程 ===================华丽分割线======================= 本文转自snc_snc 51CTO博客,原文链接:http://blog.51cto.com/netsyscode/1967792 ,如需转载请自行联系原作者

优秀的个人博客,低调大师

InstantRun原理(2)——更新逻辑

上一篇博客我们介绍了InstantRun的初始化逻辑,接下来我们来看下在运行时阶段,InstantRun是如何加载修改的代码的。 上一篇博客的末尾我们介绍了InstantRun在初始化完成后,会启动一个server。不难猜测,这个server就是在监听是否有代码更新。当用户更改代码后,AndroidStudio会将相关更新发送给server,server获取到更新后执行修复逻辑。 1 SocketServerReplyThread server的主要实现由其内部类SocketServerReplyThread,首先来看下其实现: private class SocketServerReplyThread extends Thread { private final LocalSocket mSocket; Sock

优秀的个人博客,低调大师

Marble原理之线程池

本章节依赖于【Marble使用】,阅读本章节前请保证已经充分了解Marble 线程池概述 由于Marble属于框架性项目,用户接入Marble不关心Marble的实现机制。因此Marble在做相关处理时对资源的消耗要可控,不能因为Marble的原因导致接入的应用不可用(比如资源耗尽)。此外,Marble-Agent每次收到RPC调度为了不阻塞都会新开线程进行JOB执行,对线程的使用非常频繁,因此必须使用同一的线程池进行Marble的资源使用收口。 对于线程池 Java已经做了很好的封装,大部分的使用场景都能覆盖,枚举如下: newCachedThreadPool创建一个可缓存线程池,如果线程池长度超过处理需要,可灵活回收空闲线程,若无可回收,则新建线程; newFixedThreadPool 创建一个定长线程池,可控制线程最大并发数,超出的线程会在队列中等待; newScheduledThreadPool 创建一个定长线程池,支持定时及周期性任务执行; newSingleThreadExecutor 创建一个单线程化的线程池,它只会用唯一的工作线程来执行任务,保证所有任务按照指定顺序(FIFO, LIFO, 优先级)执行; 线程池new线程的流程(网络盗图): Marble线程池 线程池定义 由于Marble线程池一个很大的作用是为了控制资源使用,给Marble资源占用设定上限,Java本身提供的线程池虽然有最大线程数设置,但阻塞队列用的都是无界的,不适合做资源限定使用。因此,Marble对java线程池做了定制化。 使用有界阻塞队列 executor = new ThreadPoolExecutor( tpConfig.getMaxSize(), tpConfig.getCoreSize(), 0, TimeUnit.SECONDS, new ArrayBlockingQueue<Runnable>(tpConfig.getBlockQueueSize()), tpConfig.getRejectPolicy() ); 线程池自配置支持 为了方便用户进行线程池自配置,Marble提供配置文件的方式支持用户自定义线程池配置,配置方式为:在项目根目录下建立文件marble-config.properties 。文件中进行参数赋值,如下: #线程池最大线程数 tpool_max_size=5 #线程池核心线程数 tpool_core_size=5 #线程池阻塞有界队列长度 tpool_bq_size=3 #线程池满后的处理策略。1-AbortPolicy(抛出RejectedExecutionException异常); 2-CallerRunsPolicy; 3-DiscardOldestPolicy 4-DiscardPolicy(不抛出异常) tpool_reject_policy=1 Marble会首先在根目录下查找此配置文件,找不到会用默认配置。tpool_max_size=20tpool_core_size=20tpool_bq_size=5tpool_reject_policy=1 Marble的配置解析类如下: /** * Marble 配置解析 * * @author <a href="dongjianxing@aliyun.com">jeff</a> * @version 2017/3/31 20:15 */ public class MarbleConfigParser { private static ClogWrapper logger = ClogWrapperFactory.getClogWrapper(MarbleConfigParser.class); private static final String CONFIG = "marble-config.properties"; private static Properties prop = new Properties(); //默认配置 private static final int TPOOL_MAX_SIZE = 20;//线程池最大线程数 private static final int TPOOL_CORE_SIZE = 20;//线程池核心线程数 private static final int TPOOL_BQ_SIZE = 5;//线程池阻塞队列大小 private static final int TPOOL_REJECT_POLICY = 1;//线程池满的处理策略. 1-AbortPolicy(抛出RejectedExecutionException异常); 2-CallerRunsPolicy; 3-DiscardOldestPolicy 4-DiscardPolicy private MarbleConfigParser() { try { InputStream stream = PropertyUtils.class.getClassLoader().getResourceAsStream(CONFIG); if (stream == null) { logger.MARK("PARSE_CONFIG").warn("no marbleConfig.properties.xml is exist in the root directory of classpath, so default the config will be used."); return; } prop.load(stream); } catch (Exception e) { logger.MARK("PARSE_CONFIG").error("parse the marbleConfig.properties.xml in the root directory exception, detail: {}", Throwables.getStackTraceAsString(e)); } } //解析出thread pool配置 ThreadPoolConfig parseTPConfig() { ThreadPoolConfig tpConfig = null; try { Integer tpms = getInteger(prop, "tpool_max_size"); Integer tpcs = getInteger(prop, "tpool_core_size"); Integer tpqs = getInteger(prop, "tpool_bq_size"); Integer tprp = getInteger(prop, "tpool_reject_policy"); //修正参数 tpcs = (tpcs == null || tpcs < 0 || tpcs > 500) ? TPOOL_CORE_SIZE : tpcs; tpms = (tpms == null || tpms < tpqs) ? tpcs : tpms; tpqs = (tpqs == null || tpqs < 0 || tpqs > 100) ? TPOOL_BQ_SIZE : tpqs; tprp = (tprp == null || tprp > 4) ? 1 : tprp; RejectedExecutionHandler handler = new ThreadPoolExecutor.AbortPolicy(); switch (tprp) { case 1: handler = new ThreadPoolExecutor.AbortPolicy(); break; case 2: handler = new ThreadPoolExecutor.CallerRunsPolicy(); break; case 3: handler = new ThreadPoolExecutor.DiscardOldestPolicy(); break; case 4: handler = new ThreadPoolExecutor.DiscardPolicy(); break; } tpConfig = new ThreadPoolConfig(tpms,tpcs,tpqs,handler); } catch (Exception e) { logger.MARK("PARSE_CONFIG").error("parse the thread-pool config from marbleConfig.properties.xml exception, detail: {}", Throwables.getStackTraceAsString(e)); } if (tpConfig == null) { tpConfig = new ThreadPoolConfig(TPOOL_MAX_SIZE,TPOOL_CORE_SIZE, TPOOL_BQ_SIZE, new ThreadPoolExecutor.DiscardPolicy()); } return tpConfig; } private Integer getInteger(Properties prop, String key) { Integer result = null; try { String value = prop.getProperty(key); if (value != null && value.trim().length() > 0) { result = Integer.parseInt(value); } } catch (Exception e) { } return result; } //单例 private static class SingletonHolder { private static final MarbleConfigParser CONFIG_HELPER = new MarbleConfigParser(); } public static MarbleConfigParser getInstance() { return MarbleConfigParser.SingletonHolder.CONFIG_HELPER; } //线程池配置 class ThreadPoolConfig { private int maxSize;//线程池最大线程数 private int coreSize;//线程池核心线程数 private int blockQueueSize;//线程池阻塞队列大小 private RejectedExecutionHandler rejectPolicy;//线程池拒绝策略 ThreadPoolConfig(int maxSize, int coreSize, int blockQueueSize, RejectedExecutionHandler rejectPolicy) { this.maxSize = maxSize; this.coreSize = coreSize; this.blockQueueSize = blockQueueSize; this.rejectPolicy = rejectPolicy; } int getCoreSize() { return coreSize; } int getBlockQueueSize() { return blockQueueSize; } public int getMaxSize() { return maxSize; } RejectedExecutionHandler getRejectPolicy() { return rejectPolicy; } @Override public String toString() { return "ThreadPoolConfig{" + "maxSize=" + StringUtils.safeString(maxSize) + ", coreSize=" + StringUtils.safeString(coreSize) + ", blockQueueSize=" + StringUtils.safeString(blockQueueSize) + ", rejectPolicy=" + StringUtils.safeString(rejectPolicy.getClass().getSimpleName()) + '}'; } } } 线程池使用示例 以如下线程池配置为例:tpool_max_size=5tpool_core_size=5tpool_bq_size=3tpool_reject_policy=1 下图中同一台机器(10.2.37.137)连续收到11次Marble调度 > 第1~5次Marble-Agent成功从线程池中启动了5个线程进行执行; 第6~8次调用,核心线程数已满,有界阻塞队列开始进行填充; 第9~10次调用有界阻塞队列已被填满,最大线程数也已满,由于采用了 拒绝策略Abort,直接拒绝了10~11次的调度请求; 手动进行了“线程中断”调用; 第11次又成功执行;

优秀的个人博客,低调大师

CAP原理和BASE思想

分布式领域CAP理论,Consistency(一致性), 数据一致更新,所有数据变动都是同步的Availability(可用性), 好的响应性能Partition tolerance(分区容错性) 可靠性 定理:任何分布式系统只可同时满足二点,没法三者兼顾。忠告:架构师不要将精力浪费在如何设计能满足三者的完美分布式系统,而是应该进行取舍。 关系数据库的ACID模型拥有 高一致性 + 可用性 很难进行分区:Atomicity原子性:一个事务中所有操作都必须全部完成,要么全部不完成。Consistency一致性. 在事务开始或结束时,数据库应该在一致状态。Isolation隔离层. 事务将假定只有它自己在操作数据库,彼此不知晓。Durability. 一旦事务完成,就不能返回。跨数据库事务:2PC (two-phase commit), 2PC is the anti-scalability pattern (Pat Helland) 是反可伸缩模式的,JavaEE中的JTA事务可以支持2PC。因为2PC是反模式,尽量不要使用2PC,使用BASE来回避。 BASE模型反ACID模型,完全不同ACID模型,牺牲高一致性,获得可用性或可靠性:Basically Available基本可用。支持分区失败(e.g. sharding碎片划分数据库)Soft state软状态 状态可以有一段时间不同步,异步。Eventually consistent最终一致,最终数据是一致的就可以了,而不是时时高一致。 BASE思想的主要实现有1.按功能划分数据库2.sharding碎片 BASE思想主要强调基本的可用性,如果你需要High 可用性,也就是纯粹的高性能,那么就要以一致性或容错性为牺牲,BASE思想的方案在性能上还是有潜力可挖的。 现在NOSQL运动丰富了拓展了BASE思想,可按照具体情况定制特别方案,比如忽视一致性,获得高可用性等等,NOSQL应该有下面两个流派:1. Key-Value存储,如Amaze Dynamo等,可根据CAP三原则灵活选择不同倾向的数据库产品。2. 领域模型 + 分布式缓存 + 存储 (Qi4j和NoSql运动),可根据CAP三原则结合自己项目定制灵活的分布式方案,难度高。 这两者共同点:都是关系数据库SQL以外的可选方案,逻辑随着数据分布,任何模型都可以自己持久化,将数据处理和数据存储分离,将读和写分离,存储可以是异步或同步,取决于对一致性的要求程度。 不同点:NOSQL之类的Key-Value存储产品是和关系数据库头碰头的产品BOX,可以适合非Java如PHP RUBY等领域,是一种可以拿来就用的产品,而领域模型 + 分布式缓存 + 存储是一种复杂的架构解决方案,不是产品,但这种方式更灵活,更应该是架构师必须掌握的 BASE讲究soft state,这种状态是一种非即时性的状态,是一种无连接,或者说是尽量短连接的状态,而ACID是讲究强的一致性,要求即时性的事务hard state,这是一种完全面向连接的状态。强的一致性就以牺牲性能和高可用性为代价,目前 JDON的风格是一种符合BASE策略的架构风格。 http://www.jdon.com/37625

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册